LInux+ollama的并发数,prompt和显存占用

ollama环境变量配置:修改ollama的数据路径(安装路径) ollama安装模型,如果很大,会占用C盘空间,影响系统运行速度,通过设置环境变量,来改变ollama放目录的地址。 阅读详情
AI摘要

本文对Linux+ollama环境下的qwq模型进行测试,主要调整num_ctx和OLLAMA_NUM_PARALLEL两个参数。测试了模型的高并发性能、长num_ctx对显存占用的影响。结果显示,不超并发数的请求响应快,初次请求模型启动时间长,num_ctx增大到超显卡显存数时,显存占用明显变大。

使用qwq模型进行测试,模型参数大小19GB

本机4090*8,有四张是其他模型占用,也就是4张空闲,默认参数qwq显存占用23GB

1.主要针对num_ctx和OLLAMA_NUM_PARALLEL两个参数进行调整

[Service]
Environment="OLLAMA_NUM_PARALLEL=4" # 并行数量,默认是1或者4
Environment="OLLAMA_KEEP_ALIVE=100h" # 运行模型保留时长,ollama有模型自动卸载功能,默认是5m,5分钟,初次的模型启动时间较长,7-8秒

1.1OLLAMA_NUM_PARALLEL的修改方式

把Environment="OLLAMA_NUM_PARALLEL=4"复制到指定位置,保存,退出,重启ollama

# 进入文件编辑,加入指定参数
sudo vim /etc/systemd/system/ollama.service
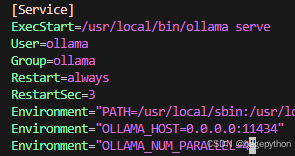
重启ollama

sudo systemctl daemon-reload && systemctl restart ollama

1.2num_ctx的修改方式

1.通过如下方式进行请求

curl http://192.168.80.41:11434/api/generate -d '{
  "model": "qwq",
  "prompt": "你认为9.11,9.2,9.9三者的大小顺序",
  "stream": true,
  "options": {"num_ctx": 12288}
}'

2.通过重写modelfile文件,然后注册模型的方式实现

#查看模型的信息
ollama show qwq --modelfile

#然后把--modelfile文件中的内容全部复制下来
vim modelfile_max
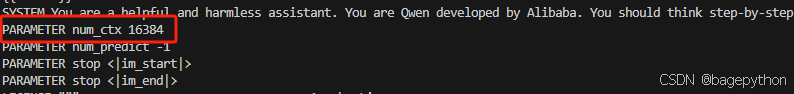
# 创建模型
ollama create qwq_max -f ./modelfile_max

2.测试qwq的高并发性能

2.1主要指标

response_time的时间计算假定为,从发出请求到收到信息的时间差

  
#请求总时间
total_duration: 38.990 s
#模型加载时间
load_duration: 37.943 ms
#prompt总token数
prompt_eval_count: 45 token(s)
#prompt处理时间
prompt_eval_duration: 118.000 ms
#prompt处理速度
prompt_eval_rate: 381.360 tokens/s
#回答内容总token
eval_count: 996 token(s)
#回答总耗时
eval_duration: 38.830 s
#回答速度
eval_rate: 25.650 tokens/s
#发出请求到收到第一个token时间
response_time: 0.160 s

2.2测试代码

通过使用subprocess.run(['ollama', 'run', 'qwq', '--verbose'], input=question, text=True, capture_output=True)命令获取到返回信息,主要是获取红色框中的数据
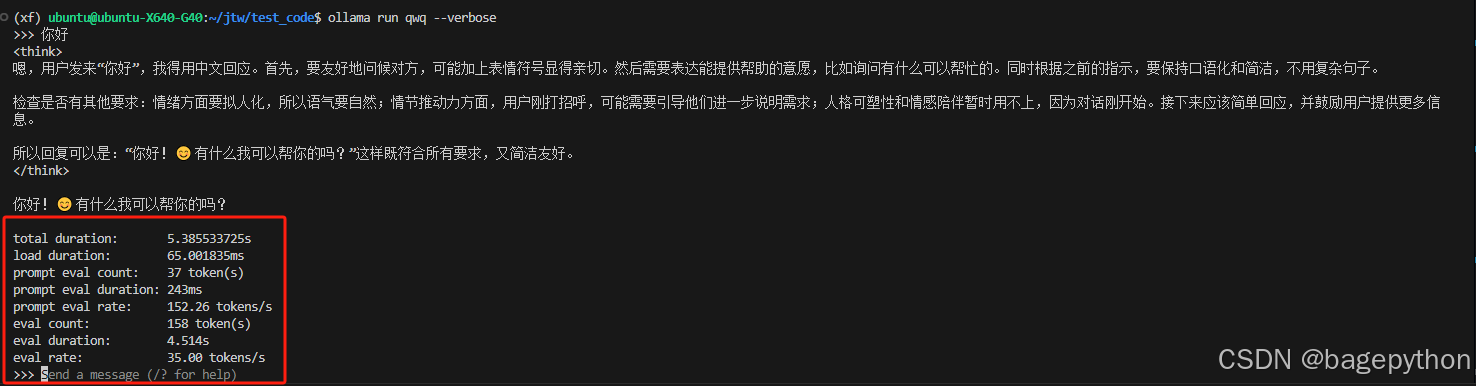
从返回的信息中通过使用正则表达式的方式获取模型的性能指标

直接上代码

需要新建ollama_parallel_log文件夹,来报错,异常结果的返回值,主要是查看红色框中的数据是否正常

import subprocess
import threading
import time
import re
import os
import tiktoken

# 并发线程数
thread_count = 4
# 存储每个线程的性能指标
llm_perf_metrics = []
# 存储每个线程的回答
llm_answers = []
# 线程锁
lock = threading.Lock()

question = "请以某AI技术公司近期发布新一代自动驾驶系统为例,编写一篇新闻稿,请使用中文。优化内容,重点描述这款驾驶系统如何利用深度学习等AI技术提高道路安全性,公司CEO表示,他们的目标是通过AI技术减少交通事故并减少碳排放。"
#  加载对应的 tokenizer
# 这里假设使用的模型是一个类似 OpenAI 的模型,你可能需要根据实际情况调整
encoding = tiktoken.encoding_for_model("gpt-3.5-turbo")
# 统计 token 数
token_count = len(encoding.encode(question))
print(f"Prompt 的 token 总数: {token_count}")


def run_ollama():
    try:
        start_time = time.time()
        # 调用ollama命令
        result = subprocess.run(['ollama', 'run', 'qwq', '--verbose'], input=question, text=True, capture_output=True)
        end_time = time.time()

        # 提取回答内容
        output = result.stdout
        answer_pattern = r'(?s)<\/think>\s*(.*?)$'
        answer_match = re.search(answer_pattern, output)
        answer = answer_ma

windows环境下配置ollama的一些进阶设置 ollama的一些高级环境变量配置 阅读详情

相关推荐

小模型时代来临~ 如何用ollama跑多个小模型提升并发性能, 用ollama吧

要想发挥OLLAMA的真正实力🎯, 还是要与JBoltAI搭配食用才能发挥其最大价值🤑😂, JBoltAI欢迎亲的随时关注哟🤩😚~

杂货铺 2046

8G显存本地跑27B Qwen模型:Ollama+GGUF量化部署与3D游戏代码实测

大模型本地化部署是当前开发者关注的热点,但显存容量往往成为硬件瓶颈。量化技术通过压缩模型权重,使得在有限显存上运行更大参数模型成为可能。GGUF作为高效的模型量化格式,配合Ollama这类轻量级推理工具,能够在普通消费级显卡上实现类GPT级模型的本地推理。本文从量化原理出发,介绍基于Ollama和llama.cpp的部署方案,详细讲解8G显存环境下27B级Qwen模型的参数配置、资源调优与API调用方法,并针对3D游戏代码生成这一典型场景进行实测验证。无论是代码辅助、离线问答还是私有化应用,该方案都能在保护

weixin_34232744的博客 440

8G显存本地部署27B大模型:量化配置与Ollama实战指南

大语言模型部署通常面临显存瓶颈,尤其当模型参数量达到数十亿级别。利用量化技术压缩模型体积,并借助GPU与CPU混合推理,可让入门级显卡突破资源限制,这是本地化运行大模型的常见原理。这种部署方式既能保障数据隐私,又能降低云端调用成本,适合搭建本地编码助手、私有知识库问答及Agent服务。本文围绕8G显存环境下的27B级模型部署,以Qwen3.8-27B为例,介绍基于Ollama的量化模型拉取、Modelfile参数配置以及API接口调用方法,并实测其在3D游戏代码生成任务上的表现。通过合理的量化级别与offl

weixin_34174105的博客 390

DeepSeek本地部署实践指南:显存规划、量化选型与Ollama/vLLM

大语言模型的本地部署正成为企业内部数据安全与离线推理的重要选择。核心思路是把开源权重放到自有GPU服务器上,通过显存预估与量化等级(如Q4_K_M)控制资源开销,再用Ollama或vLLM这类推理引擎提供OpenAI兼容接口。实际部署中,KV Cache会随上下文增长显著占用显存,因此显存、上下文长度与量化档位需要联动调优,才能获得稳定生成速度。这类方案适合私有知识库问答、内网工具集成以及Open WebUI/Dify等可视化落地场景,在断网环境下也能提供可靠的模型服务。围绕DeepSeek的本地化部署,可

weixin_34221276的博客 333

Cursor集成Claude 4.6免费版:本地IDE合规调用指南

大语言模型编程助手(LLM Copilot)已成为现代开发标配,其核心能力依赖于上下文理解、代码推理与结构化输出等关键技术原理。Anthropic官方提供的Claude系列模型,尤其Claude 4.6,凭借200K超长上下文、tool use函数调用和严格可控的API设计,在工程实践中展现出显著技术价值。该能力可无缝嵌入本地IDE环境,支撑代码解释、跨文件分析、单元测试生成等高频开发场景。本文聚焦Cursor这一开源可审计IDE,详解如何合规复用Anthropic免费tier接口(/v1/messages

weixin_34095889的博客 537

Gephi实战指南——从数据导入到可视化输出

本文详细介绍了Gephi数据可视化工具的使用方法,从数据导入到可视化输出的全流程实战指南。涵盖Gephi三大工作区功能、数据导入技巧、图形编辑进阶操作以及专业级可视化输出方案,帮助用户高效完成社交网络分析等复杂任务。

weixin_28731223的博客 481

liquibase介绍

1、Liquibase还是Flyway Flyway和Liquibase都支持专业数据库重构和版本控制所需的所有功能,因此您将始终知道要处理的数据库模式的版本以及它是否与软件版本匹配。两种工具都集成在Maven或Gradle构建脚本中以及Spring Boot生态系统中,因此您可以完全自动化数据库重构。 Flyway使用SQL定义数据库更改,因此您可以定制SQL脚本,使其与基础数据库技术(例如Oracle或PostgreSQL)良好地配合使用。另一方面,使用Liquibase,您可以通过使用XML,YA

赶路人儿 7534

CANoe LIN一致性测试之干扰测试Test moudle_LIN Disturbance Block

注意:相邻两个显隐性不同的bit不允许干扰,例如我同时选择bit6和bit7,相邻两个同显隐性的bit允许干扰,例如当我选择bit3和bit4,项,这里我选择ID:为0x2F(PID:0x6F)的frame。需按照具体测试规范实施干扰项,帧头和数据段都可以实现干扰。最近发现一个干扰测试模块,下面是一些具体使用方法。选择干扰项:PID的奇偶校验位(一致性测试干扰测试之手动测试。一个待测试frameD。

yuanyikangkang的博客 3410

Python 爬取网页文字并保存为 txt 文件教程

将要爬取的网页网址赋值给变量url。

2403_89537385的博客 2789

【雷达通信】雷达信号处理仿真【含Matlab源码 2509期】

雷达信号处理仿真 完整的代码,方可运行;可提供运行操作视频!适合小白!

订阅付费专栏Matlab(奶茶价版),可赠送奶茶价版付费专栏指定代码1份; 904

汽车信息安全--SHE中的密钥管理(二)

上一篇我们讲解了HTA基本概念,SHE和EVITA HSM区别以及SHE的架构,接下来我们聊一聊SHE中的密钥管理策略。

认真搞搞汽车MCU 2402

ABAP CDS Time Functions 全面解析:用 TIMS_IS_VALID 护航时刻字段的正确性

摘要:本文深入解析ABAP CDS时间函数TIMS_IS_VALID的应用,重点介绍其在企业系统时间字段校验中的关键作用。文章指出无效时间数据会导致业务流程混乱,而CDS层校验能有效减少重复逻辑。详细说明TIMS类型格式要求、空值处理规则,并提供两种工程实现方案:在CDS视图中直接派生校验列,或通过ABAP SQL在内存表中批量验证。最后给出可直接运行的代码示例,包括一个ABAP报表演示内存表验证,以及一个CDS View Entity实现系统时间自动映射与校验,帮助开发者在业务场景中快速落地时间校验功能。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 193

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

上一篇: ollama+qwq
bagepython
博客等级 码龄7年 20粉丝 5原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值