Xinference+Transformers+vLLM 部署qwen2.5-72B

加载预训练模型遇到transformers的问题 问题1: urllib.error.URLError: urlopen error [SSL: CERTIFICATE_VERIFY_FAILED] 这是由于ssl验证的问题,在.py 文件的开头导入ssl包,创建默认验证: import ssl ssl._create_default_https_context = ssl._create_unverified_context 问题2: ImportError: cannot import name ‘AutoModelWithHeads’ from ‘ 阅读详情
AI摘要

本文介绍使用Xinference部署qwen2.5-instruct-awq-72B-Int4时遇到的问题。涉及Linux环境下Xinference启动调试模式、模型下载错误、版本问题、显存不足等。还对比了Transformers和vLLM框架的响应速度,vLLM更快但对显卡要求更高。

在使用Xinference部署qwen2.5-instruct-awq-72B-Int4时遇到的问题

分别使用了Transformer和vLLM两种框架

1.LInux环境安装好Xinference后,可以使用--log-level debug启动xinference并且打开debug模式,方便跟踪问题。

xinference-local --host 0.0.0.0 --port 9998 --log-level debug
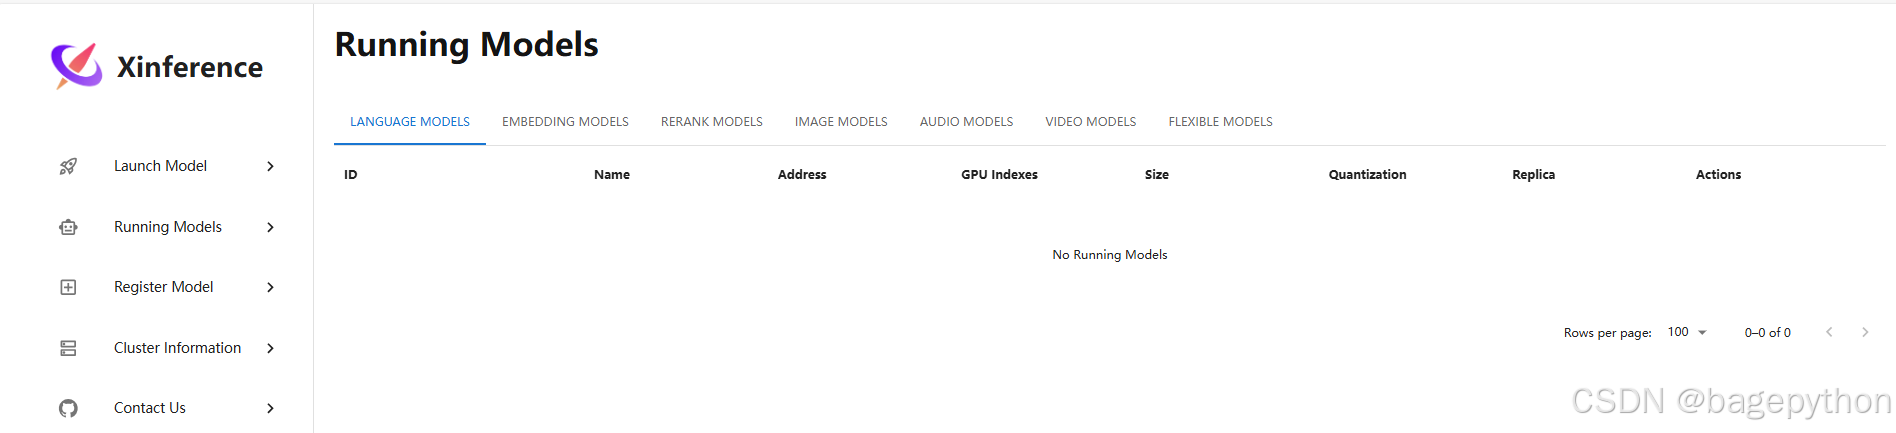
通过上述界面可以选择模型下载。

2.RuntimeError: [address=192.168.80.41:40325, pid=4188716] Failed to download model 'qwen-chat' (size: 1_8, format: pytorch) after multiple retries

在下载模型的时候如果显示上面错误可能是因为huggingface源问题

打开debug记录显示是访问huggingface的时候网络连接错误,在xinference启动之前,先运行:

export HF_ENDPOINT="https://hf-mirror.com"

3.下载过程根据模型大小可能长达5个小时。

在启动下载好的模型后cannot import name 'shard_checkpoint' from 'transformers.modeling_utils' (/root/miniconda3/envs/xinferen


Ollama、vLLM和Xinference三个框架的介绍和基本使用 Ollama, vLLM 和 Xinference框架的介绍和使用 阅读详情

相关推荐

本地大模型部署工具对比:OLLAMA、xInference与LocalAI全解析

大模型本地部署是当前AI工程实践的热点,其核心在于将开源模型高效、安全地运行在私有环境中。从技术原理看,这通常涉及模型量化、推理引擎优化和API服务化等关键技术,旨在平衡性能、资源消耗与易用性。其技术价值在于彻底解决数据隐私、网络延迟和API调用成本等问题,为开发者和企业提供自主可控的AI能力。应用场景广泛,涵盖个人开发测试、企业级服务中台以及定制化模型集成等。本文聚焦于OLLAMA、xInference和LocalAI这三款主流工具,它们分别代表了开箱即用、分布式生产级和高度灵活三种不同的部署范式,是实践

cunfuteng7334的博客 442

Qwen3.8 27B混合架构解析:非Transformer层如何优化长上下文与推理效率

在大型语言模型领域,Transformer架构凭借其强大的序列建模能力成为主流,但其在长上下文处理时面临的KV Cache显存爆炸和推理效率瓶颈,始终是工程实践中的核心挑战。为了解决这些问题,业界不断探索新的架构范式,其中混合架构(Hybrid Architecture)通过引入状态空间模型(SSM)、线性注意力等非Transformer层,旨在保持模型能力的同时,显著降低长序列下的计算与存储复杂度。这种技术路线的核心价值在于,它能更高效地管理注意力机制中的键值缓存,从而支持更长的上下文窗口,并提升推理吞吐

weixin_33766168的博客 352

Xinference:面向生产环境的大模型服务操作系统

大模型服务化不是简单运行一个推理脚本,而是涉及模型异构加载、GPU资源动态调度、统一API抽象与全生命周期管理的系统工程。Xinference 作为专为本地部署设计的模型服务操作系统,通过自动格式识别(如GGUF/PyTorch)、进程级沙盒隔离、OpenAI兼容协议层等核心能力,显著降低多模型、多任务、多角色协同的运维复杂度。它既支持非技术人员通过WebUI快速试用,也允许工程师深度调优n-gpu-layers、ctx-size等关键参数,在金融、政务等强合规场景中展现出优于Docker的可审计性与驱动兼

hck341204的专栏 446

Kubernetes+vLLM大模型推理服务部署实战:从GPU调度到弹性扩缩容

大模型推理服务从单机脚本走向生产环境时,常面临资源隔离、显存竞争和扩容困难等挑战。vLLM作为高性能推理引擎,通过PagedAttention机制将KV Cache分页管理,大幅提升显存利用率;continuous batching则能动态将并发请求插入当前批次,显著提高吞吐量。而Kubernetes提供容器编排能力,能将GPU视为可调度资源,实现自动扩缩容、故障自愈与滚动更新。将两者结合,即可构建弹性稳定的AI推理平台。本文从Kubernetes的GPU调度原理出发,讲解Device Plugin、显存配

weixin_34211761的博客 556

本地大模型部署实战:解析通义千问API调用403错误的排查与解决

在本地部署大语言模型(LLM)时,API调用是连接客户端与模型服务的核心环节。其原理是通过HTTP协议遵循类似OpenAI的接口规范进行通信,服务端通常内置认证机制以确保安全可控。这一设计的技术价值在于既能防止资源滥用,又能为后续云端部署提供一致的开发体验。在实际应用场景中,开发者常使用vLLM、FastChat等推理框架部署量化模型(如GPTQ-Int4),但在调用时易遭遇“403 Forbidden”错误。这往往并非简单的网络问题,而是涉及API密钥认证、网络代理配置或服务路由等多个层面。例如,当错误信

weixin_30388677的博客 340

Langchain-Chatchat Windows11本地部署实战指南

RAG(检索增强生成)是构建私有知识库的核心范式,其原理在于将外部知识实时注入大语言模型,提升回答准确性与可溯源性。技术价值体现在数据不出域、模型可替换、逻辑可审计,广泛应用于企业文档智能问答、合同条款检索、财务报告分析等强合规场景。在Windows11环境下,Langchain-Chatchat作为开源RAG框架代表,依托Apache License实现免费商用与深度定制自由,但需直面路径限制、DLL冲突、GPU显存管理等系统级挑战。本文聚焦真实硬件环境下的可复现部署路径,覆盖conda环境隔离、Olla

weixin_30682415的博客 345

AI Harness架构师——Runtime

├─→ Embedding:TEI(--dtype int8) 或 Triton(ONNX INT8 backend)├─→ LLM:vLLM 或 SGLang(DeepSeek/Agent) 或 TRT-LLM(挂Triton)├─→ 老 CV检测:Triton(ONNX/TensorRT backend, YOLO/ResNet)├─→ 推荐MLP:Triton(TF SavedModel/ONNX) 或 TF Serving。✅bge-m3/e5/gte FP16可自导ONNX INT8。

yabbijan的专栏 235

从零构建私有AI知识库:基于向量数据库与本地大模型的第二大脑实践

向量数据库作为AI时代的新型数据基础设施,其核心原理是通过嵌入模型将文本、图像等非结构化数据转换为高维向量,并利用相似度计算实现语义检索。这项技术解决了传统关键词匹配在理解上下文和意图上的局限,为智能应用提供了“记忆”与“关联”能力。在工程实践中,结合开源嵌入模型(如BGE-M3)与本地化部署的大语言模型,可以构建完全私有、安全可控的个人AI知识管理系统。此类系统能自动化处理散落在各处的文档、笔记与网页内容,通过语义理解而非简单匹配,实现信息的智能归集与即时调用。这为应对信息过载、提升个人与团队知识复用效率

weixin_30911451的博客 336

Java大模型开发实战:Spring AI与LangChain4j技术全景指南

大模型正从概念落地为工程化应用,Java后端开发者需要一套完整的工具链来构建AI服务。Spring AI作为统一抽象层,屏蔽了底层模型差异,让开发者可以用类似Spring Boot的方式接入OpenAI、通义千问等大模型;而LangChain4j则复刻了LangChain的设计模式,为Java生态补齐了Chain、Agent、Tool等核心能力。两者共同构成了Java领域的大模型应用开发底座,配合Agent编排与Function Calling技术,模型不再仅是对话工具,而是能自动执行任务、调用工具的智能体

weixin_34280237的博客 435

Xinference实战指南:全面解析LLM大模型部署流程,携手Dify打造高效AI应用实践案例,加速AI项目落地进程

Xinference实战指南:全面解析LLM大模型部署流程,携手Dify打造高效AI应用实践案例,加速AI项目落地进程

丨汀、的博客 9944

FastGPT + Xinference + OneAPI:一站式本地 LLM 私有化部署和应用开发

上述步骤已经利用 API 的返回拼装出了含有某个城市查询天气情况的所有信息,我们用 “AI对话” 模块来总结回复,记得将对话模型切换为 Qwen。

南七小僧的学海无涯 3808

RL调参侠之BipedalWalker BipedalWalkerHardcore SAC

前几天用PPO训练了个很一般的agent: RL调参侠之BipedalWalker PPO 我看SpinningUp上面说PPO和SAC是两个领域里各自的State_of_the_art的方法,所以就打算跑SAC试试看,之前因为Open AI Five的原因,一直感觉PPO很牛掰,实际上现在很多自动驾驶的算法也是用PPO在跑,毕竟有一个“必定能够提升期望”的理论保证在这里,我理解这对做项目很大的诱惑。 不过我跑出来的结果明显是SAC更好。 调参侠时间 策略熵的权重alpha用的0.2,我一开始没有看SAC的

weixin_48370148的博客 2101

避坑指南:ros2_control在Gazebo中的常见配置错误及解决方案

本文系统梳理了在Gazebo仿真环境中配置ros2_control框架时最常见的错误,并提供了详细的解决方案。重点解析了YAML配置文件的结构陷阱、URDF/XACRO中关键标签的正确写法、Launch文件的启动顺序管理,并分享了实用的调试命令与故障排查思路,帮助开发者高效避坑,实现流畅的关节运动控制。

q5r6s7的博客 971

Oracle VM VirtualBox虚拟机网络配置与静态IP设置实战

本文详细讲解了Oracle VM VirtualBox虚拟机的网络配置,特别是如何设置静态IP以实现稳定访问。文章对比了NAT、桥接、仅主机等网络模式,并提供了从VirtualBox管理界面到Linux系统内部的完整配置步骤,帮助用户解决IP变动问题,构建可靠的本地开发测试环境。

weixin_28365523的博客 511

【物联网毕设】多模态智能门禁系统设计(STM32+人脸识别+蓝牙联动)

本文详细介绍了基于STM32的多模态智能门禁系统设计,整合了人脸识别、蓝牙联动、RFID和密码等多种开锁方式。文章从硬件选型、电路设计、嵌入式软件编程到手机APP开发,提供了完整的毕设实现方案与调试指南,帮助物联网与嵌入式方向的学生构建一个功能全面、可扩展的智能门禁系统。

rain6的博客 247

基于DO-178C/331的飞控软件研发环境的研究

本研究提出了一套基于DO-178C/331标准的飞控系统软件开发和验证框架。通过优化模型库的设计、代码生成配置和测试验证流程,显著提升了飞控系统软件的开发效率和安全性。未来的研究可以进一步扩展模型库的功能,以适应更复杂的飞控系统需求。

qq_41854911的博客 561

4位无符号比较器设计

4位无符号比较器设计

好好学习,天天向上 7891

自私兽群优化器(SHO)详解:从生物本能到智能优化

自私兽群优化器(SHO)是一种受动物群体自私行为启发的智能优化算法。该算法模拟动物在捕食威胁下的两种行为:聚集行为(全局搜索)和自私行为(局部搜索),将优化问题的解空间映射为生存环境,候选解视为猎物个体。SHO通过安全性评估将猎物分为安全、危险和高危三类,分别采用不同的位置更新策略,并引入捕食者角色增加选择压力。相比传统优化算法,SHO具有无需梯度信息、自适应平衡探索与开发、参数简单等优势,特别适合高维复杂和多模态优化问题。算法通过马尔可夫链理论保证收敛性,已在工程设计和数据挖掘等领域展现出良好性能。

qq_42212808的博客 196

COSMO-RS理论:流体相热力学预测的核心模型与技术突破

摘要:COSMO-RS模型通过量子化学计算分子表面电荷分布,实现了从微观量子尺度到宏观化工过程的热力学预测。该模型基于介电连续介质理论,将分子表面片段化处理,通过σ-剖面描述电荷分布,并计算片段间的静电失配能和氢键能。其核心算法通过自洽化学势方程求解活度系数,克服了传统模型依赖实验参数的局限。随着技术进步,模型引入了高阶描述符和色散力修正,提升了预测精度。在药物研发、化工分离等领域广泛应用,但仍存在对长程有序结构预测不足等局限性。该模型为复杂体系的热力学性质预测提供了重要理论工具。

ASKCOS博客 974

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

下一篇: Linux+llama.cpp编译+DeepSeek-R1-UD-IQ1_S本地部署
bagepython
博客等级 码龄7年 20粉丝 5原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值