Ktransformers-0.2.2+DeepSeek-R1-Q4_K_M

Ktransformers实践-仅用14G显存就能跑Deepseek-R1 671B KTransformers 的原理主要基于以下核心技术:1. **异构计算与任务卸载**:通过混合专家(MoE)架构的稀疏性,将稀疏矩阵卸载到 CPU/DRAM 处理,稠密部分保留在 GPU 上,从而大幅降低显存需求。2. **高性能算子优化**:- 在 CPU 端,使用 Llamafile 内核结合多线程、任务调度和负载均衡优化,提升推理效率。- 在 GPU 端,引入 Marlin 内核,专门优化量化矩阵计算,相比传统库加速 3.87 倍。 阅读详情

官方连接https://github.com/kvcache-ai/ktransformers/blob/main/doc/zh/DeepseekR1_V3_tutorial_zh.md

来自官方的测试结果
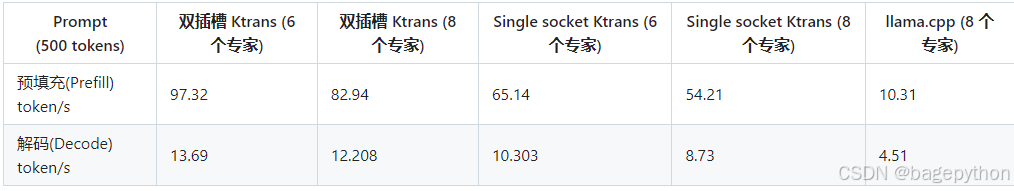
llama启动DeepSeek-R1-Q4_K_M 4090*2  decode token: 3.73token/s 速度太慢下面就没再测

1.运行环境,理论最低需求

CPU: 32Core

内存: 382G

GPU: 14G

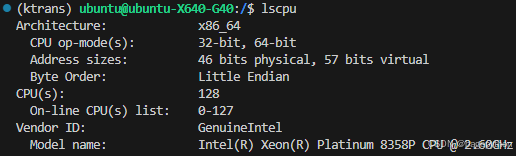
本次部署环境:

CPU: Intel(R) Xeon(R) Platinum 8358P CPU @ 2.60GHz * 2 共128G

内存: 1T

GPU: 4090*1 24G

ktransformers 0.2.2rc2+cu121torch25fancy

注意:如果你的CPU是英特尔,第四代,包含了AMX指令集,推荐安装V0.3版本ktransformers
wget https://github.com/kvcache-ai/ktransformers/releases/download/v0.1.4/ktransformers-0.3.0rc0+cu126torch26fancy-cp311-cp311-linux_x86_64.whl

pip install ./ktransformers-0.3.0rc0+cu126torch26fancy-cp311-cp311-linux_x86_64.whl

python -m ktransformers.local_chat --model_path <your model path> --gguf_path <your gguf path>  --prompt_file <your prompt txt file>  --cpu_infer 65 --max_new_tokens 1000

2.模型下载

从modelscope下载

2.1下载权重文件

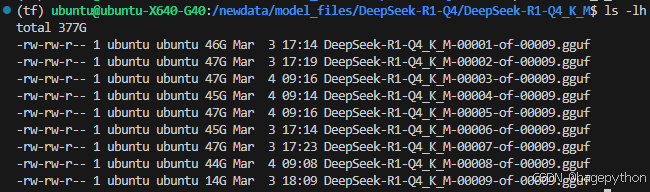
权重文件保存到/newdata/model_files/DeepSeek-R1-Q4

from modelscope import snapshot_download
 # 下载权重文件 
snapshot_download( repo_id = "unsloth/DeepSeek-R1-GGUF", 
local_dir = "/newdata/model_files/DeepSeek-R1-Q4", 
allow_patterns = ["*DeepSeek-R1-Q4_K_M-*"], #下载DeepSeek-R1-Q4_K_M-开头的文件
 )

2.2下载配置文件

配置文件保存到DeepSeek-R1-GGUF-parameter

from modelscope import snapshot_download 
# 下载模型参数文件
snapshot_download( 
repo_id="deepseek-ai/DeepSeek-R1", 
local_dir="DeepSeek-R1-GGUF-parameter", 
ignore_patterns=["*.safetensors"],#下载.safetensors之外的文件
 )
3.安装ktransformers

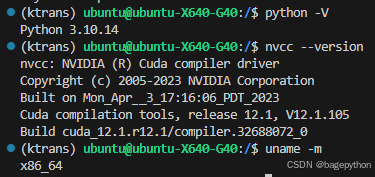
3.1前置依赖项

CUDA

LInux

Python
3.2ktransformers

git clone https://github.com/kvcache-ai/ktransformers --recursive 
cd ktransformers  
export USE_NUMA=1 
bash install.sh

4.启动服务

服务启动需要大概1分钟

ktransformers \ 
--model_name DeepSeek-R1-Q4_K_M \ 
--model_path /home/ubuntu/jtw/test_code/DeepSeek-R1-GGUF-parameter \ 
--gguf_path /newdata/model_files/DeepSeek-R1-Q4/DeepSeek-R1-Q4_K_M \ 
--host 0.0.0.0 \ 
--port 10002 \ 
--cpu_infer 65 \ 
--max_new_tokens 8192 


--model_name 重命名 
--cpu_infer 根据cpu核心数进行设置 
或者通过命令 vim ~/.ktransformers/config.yaml 修改模型名字

5.服务访问

5.1通过curl访问

DeepSeek-Coder-V2-Instruct是配置文件默认模型名字

curl -X POST "http://localhost:10002/v1/chat/completions" \ 
-H "Content-Type: application/json" \ 
-d '{ "model": "DeepSeek-Coder-V2-Instruct", "messages": [ { "role": "user", "content": "你是谁?" } ], "temperature": 0.7, "max_tokens": 512}'

5.2通过openai访问

import openai
import time
from transformers import AutoTokenizer


client = openai.Client(
    api_key="not can null",
    base_url="http://192.168.80.41:10002/v1"
)

# /v1/chat/completions
def stream_chat_response(client, model, messages):

    response = client.chat.completions.create(
        model=model,
        messages=messages,
        stream=True
    )
    full_content = ""

    for chunk in response:

        if chunk.choices[0].delta.content:

            content_chunk = chunk.choices[0].delta.content
            full_content += content_chunk

            print(content_chunk, end="", flush=True)

    return full_content

'''
question:
1,"How many ‘r’s are in the word ‘strawberry’?(单词 “strawberry” 中有多少个字母 “r”?)"
2,"9.8 和 9.11 哪个更大?"
3,"李白的风格写一首七言绝句"
'''
# Round 1
messages = [{"role": "user", "content": "李白的风格写一首七言绝句"}]
print(f"用户提问 Round 1: {messages[0]['content']}")
print("模型回复:")
# 确保 model 名称和服务器端一致
content = stream_chat_response(client, "DeepSeek-R1-Q4_K_M", messages)

参考:https://mp.weixin.qq.com/s/XIsVYxQgp2tCbWHFFb95xg

Ktransformers+Deepseek-R1量化指南:如何用4bit压缩让大模型跑在消费级显卡上 本文详细解析了Ktransformers+Deepseek-R1的4bit量化技术,通过GGUF格式实现显存优化,使消费级显卡也能运行千亿参数大模型。重点探讨了Q4_K_M等量化等级的选择策略、量化误差补偿机制,以及Ktransformers的智能任务卸载引擎和内存管理技术,为开发者提供实用的量化部署方案。 阅读详情

相关推荐

4090单卡部署671B DeepSeek,本地部署“成本骤降32倍”,助力R1真正落地「中小企业」中!

近期国内外都流行一股DeepSeek-R1部署热,大家都纷纷在自己的本地主机上面尝试着部署满血版本的DeepSeek-R1。然而,要部署一个完整的版本的DeepSeek-R1在本地,大概需要16张A800,大概会花费200百万左右的成本。产业界苦671B的大模型已久,希望能有一些低成本的满血版671B DeepSeek部署方案。小编今天给大家推荐一个框架-KTransformers,它支持在单台(24GB VRAM)/多gpu和382G DRAM上的Deepseek-R1和V3,速度提升3~28倍。

WZZ18191171661的博客 2757

DeepSeek-R1 本地部署教程(超简版)

DeepSeek-R1 本地部署教程(超简版)

一碗清深的博客 5105

DeepSeek R1部署方案选择

本文详细介绍了DeepSeek R1满血版模型的高性能部署方案。由于DeepSeek R1模型规模庞大(6710亿参数),部署满血版模型通常需要1200G显存,成本高昂。为此,提出了三种优化方案:1)采用“强推理、弱训练”的硬件配置,如国产芯片或Mac Mini集群,降低训练成本但牺牲训练性能;2)使用DeepSeek R1 Distill蒸馏模型,降低模型规模以适配不同硬件环境;3)采用CPU+GPU混合推理模式,降低硬件成本但牺牲推理速度。

llijjianmmin的博客 738

DeepSeek-R1-Distill-Qwen-7B 不同量化版本(Q4_K_M、Q5_K_M、Q6_K、Q8_0)的详细对比分析

以下是 DeepSeek-R1-Distill-Qwen-7B 不同量化版本(Q4_K_M、Q5_K_M、Q6_K、Q8_0)的详细对比分析,结合技术参数、性能表现和适用场景。

学亮编程手记 1万+

開機自動進入UEFI Interactive Shell無法正常開機怎麼辦?

BIOS/UEFI,啟動後進入UEFI Interactive Shell大多數人都告訴你沒有安裝系統去裝系統吧,但你明明昨天還在運行系統?今天就這樣?有沒有解決辦法?

sheaahhoi1的博客 7742

【Android 11】使用Android Studio调试系统应用之Settings移植(三):构建Settings、SettingsLib项目文件

基于android 11,本系列文章力争实用,讲解使用AS调试系统app的方法,并提供了配套源下载,供学习调试。上一篇文章[Android 11]使用Android Studio调试系统应用(二):依赖分析、android.bp、静态和动态依赖,讲解了如何搭建编译服务器,如何下载AOSP源码,如何切换到AOSP的指定分支(android-11-r39),以及如何编译、解决编译错误、运行模拟器,本文将开始讲解如何构建Settings的AS工程文件! 走过、路过,有用过的同学,记得给个赞O(∩_∩)O哈!

上周的博客 2680

重写万行代码+重构项目结构,KTransformers最新V0.24版部署与调用实战!

KTransformers(发音为“Quick Transformers”)旨在通过先进的内核优化和计算分布/并行化策略 来增强你使用Transformers的体验。KTransformers 是一个灵活、以 Python 为中心的框架,其核心设计理念是可扩展性。与 Transformers 兼容的接口符合 OpenAI 和 Ollama 规范的 RESTful API一个简化版的 ChatGPT 风格 Web UI(最新版已弃用)

fufan_LLM的博客 3075

ISP算法:宽动态HDR

动态范围(Dynamic Range):在很多领域来表示某个变量的最大值和最小值的比值。在数字图像处理领域里,动态范围也被称为图像对比度,表示图像可以显示范围内,像素最大亮度值和最小亮度值的比值。 高动态范围图像(High Dynamic Range Image): 可以反映真实场景中高动态范围亮度信息图像。 高动态技术:能自动调整图像动态范围的一种技术。该技术是一种利用计算机高速运算产生高

a200800170331的专栏 1万+

AI大模型企业应用实战:Prompt让LLM理解知识

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

2401_84204413的博客 3212

YOLOv11 改进 - 下采样 | 轻量化突破:ADown 下采样让 YOLOv11 参量减、精度升

本文介绍了一种轻量级的特征下采样模块 ADown,它结合平均池化与最大池化策略,实现更有效的信息保留与压缩。在传统卷积网络中,特征下采样常造成信息损失,而 ADown 通过双通道并行结构优化了下采样效果,提升了模型的表达能力。在 YOLOv11 中引入 ADown 替换原有的下采样模块后,网络在保持高效性的同时,显著提升了目标检测的精度与稳定性。文章详细介绍了 ADown 的核心代码实现、模块注册流程以及 YOLOv11-ADown 模型的配置和训练方法,为轻量化目标检测模型的优化提供了实用参考。

魔改工程师的博客 1480

人工智能训练师三级考试备考全攻略|报名条件+真题+补贴申领一站式通关(2026版)

本专栏是人工智能训练师三级考证最完整的备考指南,共77篇文章,覆盖从职业认知、报名实操、AI基础知识、数据标注、模型训练测试部署、考前冲刺到考后进阶的全链路。本导读按模块整理了全部文章链接,帮你快速定位所需内容。人工智能训练师是国家认定的正式职业,证书可在osta.mohrss.gov.cn查询,三级证书可申领最高3120元技能补贴。

白话机器学习 1798

一文速览DeepSeek-R1的本地部署——可联网、可实现本地知识库问答:包括671B满血版和各个蒸馏版的部署(含单卡4090部署671B)

自从deepseek爆火以后,真是应了“人红是非多”那句话,不但遭受各种大规模攻击,即便后来挡住了大部分攻击,但海内外大量闯入deepseek官网一探究竟的网友也把他们的服务器压得不堪重负导致一提问,要么频繁显示:服务器繁忙,请稍后再试,要么回答了 但无法联网,致使我朋友圈内一些不知情的朋友说:看把媒体给能的,各种瞎吹,但其实不过尔尔..怎么办呢?在huggingface上总共有以下几种参数的deepseek R1首先,看推理框架,目前主流的大模型推理框架主要有以下四种:其次,看硬件要求,很显然,不同参数的

结构之法 算法之道 7万+

【RT-DETR实战】RT-DETR实战手记(200):端侧实时目标检测,下一步往哪儿走?

昨天深夜调一个模型部署,在树莓派4B上跑RT-DETR-nano,帧率死活卡在8FPS上不去。量化也做了,算子也优化了,内存对齐也检查了,可就是离实时检测的底线还差一截。盯着终端里跳动的数字,突然意识到——我们可能正在接近当前技术路径的瓶颈。端侧实时目标检测的下一个突破口,恐怕不在现有框架的修修补补里。

企鹅码农的专属播客,分享10多年的实战案例和经验解读,包含YOLO、RT-DETR、AI等各个工作领域。 186

DeepSeek-R1:使用KTransformers部署(保姆级教程)

KTransformers作为一个开源框架,专门为优化大规模语言模型的推理过程而设计。它支持GPU/CPU异构计算,并针对MoE架构的稀疏性进行了特别优化,可以有效降低硬件要求,允许用户在有限的资源下运行像DeepSeek-R1这样庞大的模型。例如,KTransformers实现了24GB显存环境下本地运行DeepSeek-R1满血版的能力,大大降低了部署成本和技术门槛。

趋吉避凶的博客 1万+

通过理解 sk_buff 深入掌握 Linux 内核自定义协议族的开发实现

在。

数字人生 458

第21章—技术管理篇(上):身为技术人该怎样带好团队并做好管理者

上节讲了职业规划和学习提升这两个话题,随着职业规划的不断落地,或者自己能力的不断提升,大家也会逐渐被提拔成“职级更高”的人。企业规模扩张时,员工数量也会变多,意味着Boss需要更多的人来辅助管理,而管理者会从外部招聘吗?也许会,但大多企业更喜欢从内部选拔,毕竟人的天性更希望找的人值得信赖。此时,一些能力不错、做事靠谱的老员工,就会被“赶上”管理者的位子。作管理不难,但想要“”就需要一定情商。

运维老生常谈 1366

基于 KTransformers的DeepSeek-R1 本地部署方案,成本骤降32倍!

KTransformr:54.21(32核)→74.362(双插槽,2×32核)>255.26(基于AMX的优化MoE内核,仅V0.3)→ 286.55 (有选择地使用6位专家,仅V0.3)与2×32核的llama.cpp中的10.31个令牌/秒相比,:KTransformr:8.73(32个内核)→11.26(双插槽,2×32核)→13.69(选择性使用6个专家,仅V0.3)与2×32内核的llama.cpp中的4.51令牌/秒相比,,通过动态选择性激活专家模块,降低计算复杂度,提升计算资源的利用率。

civiljiao的博客 9830

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

RTX 4090单卡跑满血版DeepSeek-R1?清华&趋境科技联合推出KTransformers方案!

RTX 4090单卡跑满血版DeepSeek-R1?清华&趋境科技联合推出KTransformers方案!

hunteritself的博客 5375

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

大模型推理:Ktransformers单机Docker部署Deepseek-R1 671B量化版

本地单机ktransformers部署deepseek r1 671b量化版

sunny0121的博客 3692

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Ktransformers DeepSeek-R1 671B 部署

Ktransformers DeepSeek-R1 671B 部署

BENNY33333的博客 2416

ktransformers 上的 DeepSeek-R1 671B open-webui

ktransformers 上的 DeepSeek-R1 671B open-webui

mixboot 2761

60G内存+14G显存运行满血DeepSeek R1!Ktransformers+Unsloth联合部署方案实践!

采用KTransformers部署Unsloth动态量化DeepSeek R1满血模型的全网最高性价比部署方案!

fufan_LLM的博客 4293

LLMs之Inference:基于ktransformers 框架来部署DeepSeek-R1和DeepSeek-V3模型实现更快的本地推理速度(多种优化策略显著提升)之详细攻略

​ LLMs之Inference:基于ktransformers 框架来部署DeepSeek-R1和DeepSeek-V3模型实现更快的本地推理速度(多种优化策略显著提升)之详细攻略 目录 基于ktransformers 框架来部署DeepSeek R1 和 V3 模型实现更快的本地推理速度 概述 实现步骤 基于ktransformers 框架来部署DeepSeek R1 和 V3 模型实现更快的本地推理速度 概述 ktransformers 团队(之前以 DeepSeek-

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 4002

高效部署实战:Ktransformers单机Docker运行Deepseek-R1 671B 4bit量化模型

本文详细介绍了如何使用Ktransformers框架在单机Docker环境中高效部署Deepseek-R1 671B 4bit量化模型。通过清华团队优化的稀疏矩阵卸载策略和CUDA Graph加速技术,显存占用降低至传统方法的1/4,实现在RTX 4090上14 tokens/s的生成速度。文章涵盖硬件准备、Docker部署、模型下载、服务启动及性能调优全流程,为开发者提供大模型推理的实用解决方案。

weixin_33712987的博客 400

14G 显存跑动千亿大模型!基于 KTransformers 的 DeepSeek-R1‘满血版‘实战

相较于主流的 A100 等 GPU,H20 的 141 GB 显存只需 8 卡即可部署满血版 DeepSeek,同时 H20 拥有 296 TFLOPS 的 FP8 算力,而 A100 等 GPU 并不支持 FP8,因此对于部署 DeepSeek 来说则更具性价比。7. FAQ。

m0_59163425的博客 1812

利用ktransformers框架,本地运行671B DeepSeek-Coder-V3/R1教程。

使用其 Q4_K_M 版本,仅需 14GB VRAM 和 382GB DRAM 即可运行。支持在单个(24GB 显存)/多个 GPU 和 382GB 内存上运行 DeepseekR1 和 V3,速度提升高达 3~28 倍。我们在以下配置下进行了最佳性能测试(V0.2):CPU: Intel (R) Xeon (R) Gold 6454S 1T 内存 (2 NUMA 节点)GPU: 4090D 24G 显存内存: 标准 DDR5-4800 服务器内存 (1 TB)操作系统ubuntu22。

zxinglove999的博客 848
上一篇: Linux+llama.cpp编译+DeepSeek-R1-UD-IQ1_S本地部署
下一篇: ollama+qwq
bagepython
博客等级 码龄7年 20粉丝 5原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值