清华最新综述解读,大模型推理能力的进化之路!

大模型 | 初中一年级数学推理能力测试:DeepSeek -r1、Llama 3.3 和 Qwen 2.5 同一个初一数学题,三个大模型,他们会得出什么结果? 阅读详情
AI摘要

本文综述了大模型推理能力的发展,包括基础架构、数据构建、学习推理、测试时优化等关键技术突破。同时,介绍了开源社区的探索和未来挑战与机遇,并提供了AI大模型学习资源,帮助读者快速入门。

随着R1 模型的开源、OpenAI O3系列模型在数学奥林匹克竞赛中取得金牌水平的成绩,大模型的推理能力再次成为焦点。今天给家人们分享一篇综述,全文36页,《Towards Large Reasoning Models》,全面梳理了LLM推理能力的发展脉络。让我们深入了解其中的关键技术突破。

基础架构:从预训练到对齐

大模型的推理能力建立在三个关键阶段之上:预训练(Pre-training)、微调(Fine-tuning)和对齐(Alignment)。

在预训练阶段,模型通过海量文本语料获取基础语言能力和世界知识。特别值得注意的是,包含代码和数学内容的数据集对培养模型的推理能力起着关键作用。

微调阶段则通过指令数据集来优化模型的输出风格。最新的研究表明,包含推理链(Chain-of-Thought)的数据集能显著提升模型的推理表现。

对齐阶段使用强化学习技术来确保模型输出符合人类期望。这个阶段对于提升模型的推理能力尤为重要。

数据构建:从人工到自动化

高质量的推理数据是提升模型能力的关键。综述详细介绍了数据构建方法的演进:

  1. 人工标注:虽然质量高但成本昂贵,难以规模化

  2. 人机协作:通过LLM辅助加速标注过程

  3. LLM自动化:利用外部验证机制自动生成高质量数据

  4. 基于反馈的自动化:结合反馈信号持续优化数据质量

学习推理:从监督到强化

提升模型推理能力的训练方法也在不断演进:

监督微调(SFT)是最基础的方法,但过度依赖高质量标注数据。强化学习(RL)提供了一个更灵活的框架,允许模型通过试错来提升推理能力。特别是过程奖励模型(PRM)的引入,使得模型能够获得更细粒度的反馈信号。

直接偏好优化(DPO)则提供了一种更简单的方法,无需显式的奖励模型就能优化模型行为。这些方法的结合极大地提升了模型的推理表现。

测试时优化:深度思考的关键

研究发现,在测试阶段增加计算资源可以显著提升模型的推理能力。主要的优化方法包括:

  • 多数投票:通过多次推理取最常见答案

  • 树搜索:系统地探索不同的推理路径

  • 集束搜索:保留多个最优推理路径

  • 前瞻搜索:通过模拟未来步骤来优化当前决策

O1的技术突破

OpenAI的O1系列模型展现出了卓越的推理能力,关键技术包括:

  • 知识整合:能够有效整合和运用跨领域知识

  • 系统分解:保持稳定的问题分解能力

  • 一致推理:在复杂任务中保持推理链的连贯性

  • 新的扩展定律:通过优化测试时计算来提升性能

开源社区的探索

开源社区也在积极复现和改进O1的能力:

  • OpenR1:首个探索O1核心方法的开源框架

  • Rest-MCTS*:创新性地结合树搜索和自训练

  • Journey Learning:专注于全面的训练策略

  • LLaMA-Berry:优化推理时的决策过程

其他增强技术

除了PRM引导的搜索外,还有多种提升推理能力的方法:

  • 语言强化搜索:利用LLM的语言理解能力来优化搜索

  • 基于记忆的强化:通过经验积累来改进推理

  • Agent系统搜索:在不同层面优化推理系统

未来挑战与机遇

综述最后指出了几个关键的研究方向:

  1. 后训练阶段的扩展定律研究

  2. 通过搜索生成高质量数据

  3. 深入理解和模拟人类的慢思考过程

  4. 推理能力在下游应用中的实践

如何学习AI大模型 ?

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。【保证100%免费】🆓

优快云粉丝独家福利

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
在这里插入图片描述

读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈

(👆👆👆安全链接,放心点击)

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

👉1.大模型入门学习思维导图👈

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
在这里插入图片描述

👉2.AGI大模型配套视频👈

很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。

在这里插入图片描述
在这里插入图片描述

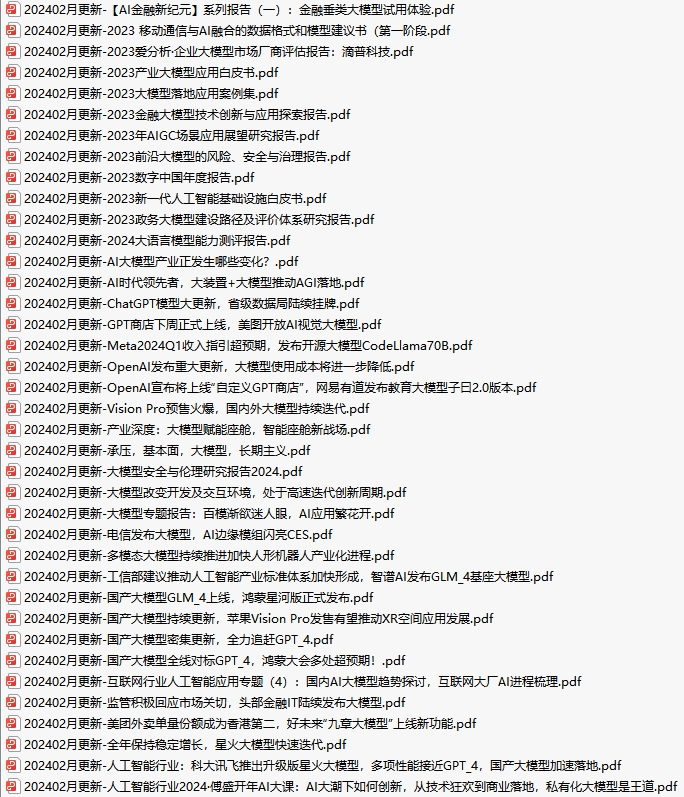
👉3.大模型实际应用报告合集👈

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
在这里插入图片描述

👉4.大模型落地应用案例PPT👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。(全套教程文末领取哈)

在这里插入图片描述

👉5.大模型经典学习电子书👈

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。(全套教程文末领取哈)

img

在这里插入图片描述

👉6.大模型面试题&答案👈

截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。(全套教程文末领取哈)

在这里插入图片描述
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习

优快云粉丝独家福利

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
在这里插入图片描述

读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈

(👆👆👆安全链接,放心点击)
清华大模型综合能力评测:237个原子能力项拆解AI真实实力 大语言模型的‘强’不应止于参数规模或单项benchmark高分,而需回归可解释、可归因、可落地的能力本体。本文基于认知任务分析与工业场景故障树,系统阐释如何将模糊的‘综合能力’解构为237个原子化能力单元,覆盖语言理解、逻辑推理、代码生成、多模态协同等核心维度;强调中文语境适配与合规性渐变测试等关键挑战,并揭示当前评测中普遍存在的领域漂移、任务耦合与评估静默三大失真陷阱。该框架不仅支撑学术归因,更直接映射至产品OKR与工程诊断,为AI产品经理、算法工程师及研究者提供面向产业落地的能力体检方法论。 阅读详情

相关推荐

清华大模型评测框架:聚焦多步推理与真实场景的综合能力评估

大模型评测正从静态知识匹配转向动态问题求解能力测量。核心在于理解模型如何在多步任务中保持逻辑一致性、维持长程上下文、迁移领域知识、解析模糊指令并抗干扰核查事实——这些能力直接决定AI在客服、法律、编程等真实场景中的工程可用性。清华团队构建的五维能力谱系,将‘推理能力’与‘真实场景迁移’作为可量化指标,通过动态难度调节、双盲三阶人工评估和Rust高可靠调度,使评测结果成为企业选型与模型优化的实操依据,而非单纯学术排名。

aibiba0894的博客 421

AI大模型2025实例测评--逻辑推理能力

本次测评旨在对当前主流的 AI 大模型进行客观、公正的逻辑推理能力测评。包括以下模型:1.文心一言2.豆包3.通义千问4.KIMI5.Copilot6.ChatGPT7.DeepSeek R1 , Grok 3

xyzcto的博客 1万+

Qwen2.5-Max 模型实测:阿里最强“非推理”大模型,能力如何?

Qwen2.5-Max 模型实测:阿里最强“非推理”大模型,能力如何?一起来看看吧!

Code_流苏:在代码中寻诗意,在实践中觅真知 2010

最新Meta AI的LIama 4大模型推理能力不及格的案例

你的模型名称和版本号,然后解答下面问题:两地A、B之间相距4000m;甲从A地以匀速60m/min向B出发,同时乙从B地出发以匀速260m/min向A出发。乙到达A地之后立即以同一匀速折返向B地,追上甲之后,甲和乙以相同的匀速175m/min到达B地。如果甲和乙分别从A、B两地相向出发的时刻是上午7:20,我测试大语言模型推理能力,只用了一个标准。所以,如果针对性训练过的可能占便宜。但大模型训练怎么可能关注我的测试标准?但我提示了一下,也能找到正确结果,但这不能说明问题啊。因为,大语言模型最擅长穿凿附会。

stereohomology 484

Uni-App推送踩坑实录:从云函数URL化到后台推送失效,我都经历了什么

本文详细记录了Uni-App开发者在接入uni-push 2.0时遇到的推送失效问题,从云函数URL化到后台推送失效的完整排查过程。通过系统化分析和与官方沟通,最终找到解决方案,并分享了预防措施与最佳实践,帮助开发者避免类似问题。

weixin_42552716的博客 487

Conda环境创建报错?教你快速解决Solving environment: failed和ResolvePackageNotFound问题

本文深入解析Conda环境创建中常见的'Solving environment: failed'和'ResolvePackageNotFound'报错原因,并提供从基础到高级的系统化解决方案。涵盖渠道配置、版本通配、环境文件编辑等实用技巧,帮助开发者快速解决conda环境创建问题,提升工作效率。

weixin_28677451的博客 258

大模型综合性能考题汇总

阅读下面这段短文,然后用简练的语言总结出主要观点,要求在 3-4 句话内完成。【短文】“随着全球气候变化问题的日益严峻,各国政府和科研机构正加大对可再生能源技术的研发投入。太阳能和风能等清洁能源由于其低碳排放和可持续性,正逐步取代传统化石燃料。与此同时,储能技术的突破也为可再生能源的普及提供了重要保障,推动着全球能源结构的转型。【要求】

hello! 4491

从零开始:PLUMED与GROMACS整合安装全攻略

本文详细介绍了如何从零开始整合安装PLUMED与GROMACS,包括系统环境检查、MPI配置、PLUMED编译安装、GROMACS补丁应用及常见问题解决方案。通过本教程,研究人员可以快速完成分子动力学模拟工具的整合安装,实现增强采样和自由能计算功能。

weixin_42520796的博客 292

揭秘LLM推理能力背后的秘密:一文读懂强化学习如何驱动大模型进化!

该综述系统梳理了强化学习在大推理模型领域的最新进展,提出RLVR(可验证奖励强化学习)是推动LLM向LRM转变的关键。文章解析了LRM能力进化的"三驾马车":可验证的奖励、无Critic优化和动态采样。研究表明,SFT倾向于记忆,而RL才能实现真正的泛化能力。最后,文章指出了未来九大研究方向,包括持续强化学习、基于模型的RL、潜空间推理等,为LRM发展提供了清晰路径。

libaiup的博客 1041

手把手教你用RK3568开发板实现FPGA与Linux的DMA通信(含完整代码解析)

本文详细介绍了如何在RK3568开发板上实现FPGA与Linux系统的DMA通信,包括硬件配置、软件环境搭建、DMA通信原理、驱动开发及性能优化。通过完整的代码解析和实战案例,帮助开发者快速掌握异构系统间的高效数据传输技术,适用于物联网和边缘计算等场景。

weixin_29174385的博客 201

清华最新综述!Agentic RAG与深度推理,从入门到前沿,看这篇就够了!

检索增强生成(Retrieval-Augmented Generation, RAG)通过注入外部知识提升了大语言模型的事实性,但在需要多步推理的问题上表现欠佳;反之,纯推理导向的方法则常出现生成幻觉内容(hallucination)或事实依据不足的问题。

xx_nm98的博客 1263

Spring AI Alibaba Graph进阶:如何用图算法优化你的推荐系统?

本文深入探讨了如何利用Spring AI Alibaba Graph的图算法优化推荐系统。通过分析用户行为数据的网络化特征,结合加权随机游走和社区发现算法,显著提升推荐精准度和用户点击率。文章还分享了混合推荐架构设计、性能优化技巧及生产环境中的实战经验,为开发者提供了一套完整的图算法推荐解决方案。

weixin_33738555的博客 128

清华学姐解读deepseek论文:「DeepSeek-R1:通过强化学习增强大语言模型推理能力的创新解析」

deepseek论文解读:近年来,大型语言模型(LLMs)在推理任务上的表现持续提升,但传统方法通常依赖监督微调(Supervised Fine-Tuning, SFT)和大规模标注数据。系列模型通过纯强化学习(Reinforcement Learning, RL)和多阶段训练,探索了一种无需监督数据即可提升推理能力的新范式。:首个通过纯强化学习(无需SFT)训练的模型,展示了RL在推理任务中的潜力。:结合冷启动数据和多阶段训练,解决了可读性和语言混合问题,性能对标OpenAI的顶级模型。知识蒸馏。

m0_63345182的博客 4406

手把手教你完成YOLOv8 PyQt5和PySide6目标检测界面搭建,前台系统+后台管理系统开发实战,可用于大论文凑工作量或毕设必备,全网最详细教程

目标检测是计算机视觉中的重要任务,广泛应用于安防监控、自动驾驶、智能家居等领域。YOLO系列模型由于其高效的检测速度和较高的准确率,成为目标检测任务的首选算法之一。本项目结合 YOLOv8 与 PyQt5,构建了一个图形化界面,便于用户进行目标检测的操作和展示,实现对图片、视频和摄像头的实时目标检测,不仅可以用于大论文的工作量展示,还可以作为毕业设计。支持目标检测、目标分割等模型进来检测

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 1万+

(第14天)Veritas NetBackup(NBU) 配合 RMAN 脚本备份 Oracle 数据库

NBU(Veritas Netbackup)是企业中比较常用的备份软件,通常用于备份企业使用中的系统,数据库,文件等等,通常是搭配 Oracle RMAN 来进行备份 Oracle 数据库。

LuciferLiu_DBA 1642

清华最新综述!200+文献全面凝练Agentic RAG最新进展~

此外,我们的分类框架(推理增强型RAG、RAG增强型推理、协同式RAG-推理)虽涵盖了多样化方法,但在简化设计模式的同时,可能掩盖了各类方法特有的细粒度权衡、假设与局限性。:ReAct及其衍生方法是该方向的先驱,通过引导LLM在推理步骤与外部工具交互(如数据库搜索)间明确切换实现——与ReAct将推理和动作分离(通过“搜索”等显式指令触发外部检索)不同,Self-Ask、IRCoT等方法提示模型递归生成并解答子问题,实现“思维链内交织检索”(逐步检索与推理)。:主要依赖图学习技术实现检索与推理。

CV_Autobot的博客 547

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Open-AutoGLM 架构深度剖析:解密清华如何实现GLM模型自进化

清华大学 Open-AutoGLM 实现GLM模型自进化,突破传统训练瓶颈。基于自动化架构搜索与持续学习机制,适用于多场景大模型优化,提升效率与泛化能力。技术前沿,值得收藏。

BytePerch的博客 1056

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Loop+Harness:清华大学自进化Agent论文解读(附下载)

当下Codex、Claude Code等各类Agent层出不穷,但绝大多数产品仍停留在预训练+固定提示词+静态工具的模式,模型上线后能力冻结,交互产生的经验无法沉淀复用,每一轮对话都是重复从零推理。

m0_59164520的博客 863

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

清华最新研究:强化学习竟是大模型的“应试教育”,并未突破原有潜力

不能只看“单次得分”,更要关注“潜力上限”。

具身机器人和通用AI 693

清华学姐解读deepseek-R1论文

DeepSeek-R1系列模型通过强化学习和知识蒸馏,在推理任务上达到了行业领先水平。纯RL训练验证了自进化推理的可能性;多阶段训练平衡了性能与可读性;蒸馏技术为小模型的高效部署提供了新思路。未来,结合更复杂的任务场景和算法优化(如异步RL、多模态输入),DeepSeek-R1有望进一步推动AGI的发展。参考文献与资源(全文完)

m0_63345182的博客 4563

自进化 AI 智能体全景:两篇综述阅读

自进化智能体使AI系统能利用交互数据与环境反馈持续自我优化。2025年两篇综述互补:一篇提出统一反馈闭环框架与三定律,梳理单/多智能体及领域方法;另一篇按4W分类,给出POMDP形式化与判据,覆盖方法、评估与安全,主张纵向评估。两篇共同勾勒该领域的架构与理论版图。注意字数不超过150。&lt

2201_75910862的博客 433

不只是概念!清华紫荆AI医院内部测试,看“AI大模型+医疗”如何落地!

清华大学"紫荆AI医院"系统启动内测,成为全国首个应用大模型智能体的医疗创新范例。该系统覆盖35个科室、上千种疾病,准确率达96%以上,支持AI分诊、预问诊、病历自动生成等智能诊疗功能,同时严格保障数据隐私与医疗合规性。该平台通过多端协同实现"AI+医疗+教育+科研"的生态闭环,为智慧医疗发展提供可落地的实践样本。

2401_85390073的博客 1023

强化学习真能提升大语言模型推理能力?研究发现可能并非如此!

在采样次数较少(k值较小)时,强化学习训练的模型表现优于基础模型,但在所有基准测试中,随着k值增大,基础模型始终超越它们,甚至能获得更高的pass@k分数。通过人工检查发现,基础模型可以通过生成多样化的推理路径来解决那些原本认为需要强化学习训练才能解决的问题,每个问题至少能找到一个正确的解决方案。这表明,与基础模型进行大量采样相比,强化学习训练并没有增强,甚至可能限制了大语言模型的推理潜力。

AI生成曾小健3 1047
上一篇: UC 伯克利等开源OpenThinker-32B,性能直逼 DeepSeek-R1-32B!
下一篇: 大模型|Perplexity推出免费AI研究工具Deep Research
大模型产品经理
博客等级 码龄3年 1万+粉丝 1120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值