如何在huggingface安装指定的版本的transformer

下载指定版本的transformers 如果你无法直接访问 GitHub,可以尝试使用镜像站点(如 Gitee)或其他工具(如代理)来下载代码。如果你下载的是 ZIP 文件,解压后进入解压后的目录。如果是通过 Git 克隆的,直接进入克隆的目录。文件可能不存在,具体取决于仓库的结构。如果没有该文件,可以直接跳过此步骤。手动安装可能会导致依赖项冲突,建议在虚拟环境中操作。如果你在某个步骤遇到问题,请提供具体的错误信息,我可以进一步帮助你解决!这会将当前目录中的代码作为 Python 包安装到你的环境中。命令直接安装,可以按照以下步骤操作。 阅读详情

1.安装最新,一般是这样

pip install git+https://github.com/huggingface/transformers accelerate

2.要安装指定版本,那么需要在 URL 加一个@加上commit id , 如

pip install git+https://github.com/huggingface/transformers@052e652d6d53c2b26ffde87e039b723949a53493  accelerate

3. commit id 到https://github.com/huggingface/transformers/tags ,如下图复制链接地址
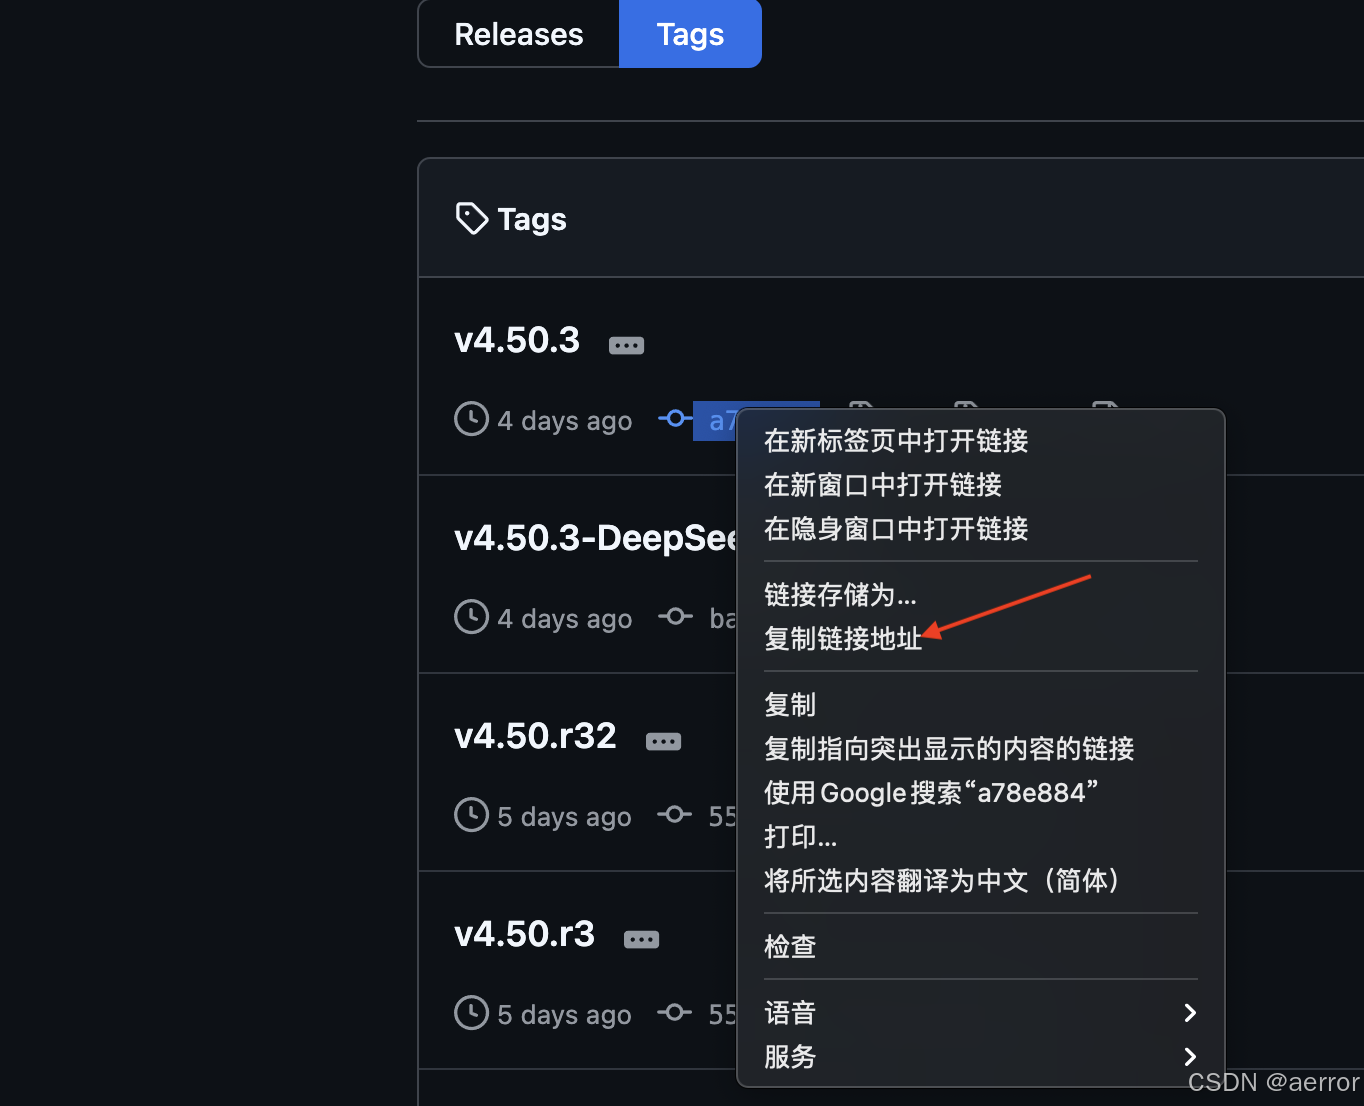
就会得到:

https://github.com/huggingface/transformers/commit/a78e884f31b2a7e67e5d3e11e9cef0ba9ade4f08

commit/后就是这个commit的id了。

pytorch安装GPU版本 (Cuda12.1)教程 使用本教程前,默认您已经安装并配置好了python3以上版本。 阅读详情

相关推荐

[预训练语言模型专题] 结合HuggingFace代码浅析Transformer

本文为预训练语言模型专题系列第九篇 快速传送门 1-4:[萌芽时代]、[风起云涌]、[文本分类通用技巧]、[GPT家族] 5-8:[BERT来临]、[浅析BERT代码]、[ERNIE合集]、[MT-DNN(KD)] 感谢清华大学自然语言处理实验室对预训练语言模型架构的梳理,我们将沿此脉络前行,探索预训练语言模型的前沿技术,红框中为已介绍的文章,本期将结合HuggingFace代码浅析Transformer代码,欢迎大家留言讨论交流。 前言 前面几期一起分享了这么多基于Tr...

yang191919的博客 2546

Transformers之环境安装

自定义安装,主要是为了在docker中使用conda虚拟环境。

qq_35215756的博客 4万+

Transformer模型原理与HuggingFace实践指南

自注意力机制是Transformer架构的核心创新,通过计算查询(Query)、键(Key)和值(Value)之间的关联权重,实现了对序列数据的并行处理和长距离依赖建模。这种机制不仅解决了传统RNN的梯度消失问题,还大幅提升了模型的可解释性。在工程实践中,HuggingFace生态提供了transformers库等丰富资源,支持从预训练模型到部署的全流程开发。针对Transformer在训练中常见的内存不足问题,可以采用梯度检查点和混合精度训练等技术优化。当前,Transformer已从最初的NLP领域扩展

weixin_33708432的博客 292

huggingface transformers安装及使用教程

huggingface transformers安装及使用教程

weixin_39663060的博客 2922

【Qwen2.5-VL环境搭建】Qwen2.5-VL环境搭建中的坑

Qwen刚出来的时候,没有发现环境搭建有坑,随着各个模型的更新,发现官方给的安装教程出现了问题。

m0_47867638的博客 504

【transformer(03/10) 】Hugging Face 安装环境

关于transformer库的安装环境的说明;因为transformer是一个不小的大型软件,安装的时候对环境还是需要一定规划,一般安装在虚拟环境中,以便与常规软件进行隔离。

gongdiwudu的专栏 4832

Huggingface中Transformer模型使用

2、如何培养模型的学习能力?自然语言处理就像我们读书一样,要训练它的阅读能力、学习能力、理解能力,给出的是一系列阅读材料,然后想办法让它理解语言,不仅仅是一个分类的专项技能,这里就涉及到注意力机制了。1、自然语言处理究竟要做一件什么事呢?自然语言处理最终解决的是分类问题,但是它不仅仅输出一个分类的预测结果,关键的在于构建一个聪明的模型,不光能学习不同数据集的问题,还能处理不同类别的问题。

苏云南雁的博客 6277

SPSS篇—卡方检验

今天依旧跟大家分享一个在SPSS中使用率比较高的分析方法:卡方检验。 在开始做分析之前,我们需要明白两件事情:卡方检验是什么?一般用来干什么?我们只有充分了解分析方法以后才能够正确的使用它。 卡方检验在百科中的解释是:卡方检验是用途非常广的一种假设检验方法,它在分类资料统计推断中的应用,包括:两个率或两个构成比比较的卡方检验;多个率或多个构成比比较的卡方检验以及分类资料的相关分析等。它的原理是...

小白数据营的博客 20万+

如何使用HuggingFace训练Transformer

对于这种batch_size = 3的场景,不同句子的长度是不同的,padding=True表示短句子的结尾会被填充[PAD]符号,return_tensors="pt"表示返回PyTorch格式的Tensor。token_type_ids主要用于句子对,比如下面的例子,两个句子通过[SEP]分割,0表示Token对应的input_ids属于第一个句子,1表示Token对应的input_ids属于第二个句子。其中,input_ids最容易理解,它表示的是句子中的每个Token在词表中的索引数字。

weixin_41699413的博客 1807

从网格划分到端口接地:一份给ADS新手的Momentum RF仿真避坑实操指南

本文为ADS新手提供Momentum RF仿真的实用指南,涵盖网格划分、端口接地、特殊结构处理等关键设置技巧。通过30-50 cells/λ原则、1/10波长限制等黄金法则,帮助用户平衡仿真精度与效率,避免常见错误,提升电磁仿真结果的准确性。

weixin_33692284的博客 506

Android 13/14/15 默认授权应用权限的实现方法

Android版本修改方式实现原理13/14修改Permission.java将所有权限标记为Normal权限15修改DeviceIdleController.java + DefaultPermissionGrantPolicy.java监听应用安装并主动授权。

m0_60898338的博客 2916

Huggingface训练Transformer

用Huggingface来对大模型进行强化学习训练

4781

uniapp - 详解使用高德地图在地图上实现绘制边界/点聚合/行政区域高亮等功能,Uniapp高德地图点聚合标记及绘制点线面示例代码(全端兼容H5网页、小程序、安卓app、苹果app、nvue)

uni-app,h5移动端网页,微信小程序,支付宝小程序,Android安卓,苹果ios,app,nvue,高德地图,uniAPP高德地图实现点聚合,地图区域描边、点标记、点信息详情弹窗,实现绘制边界区域,uniapp H5使用高德地图实现点聚合、行政区域高亮,实现高德地图的marker聚合功能,高德地图进行marker标点,点信息展示,点击标记点弹出对话框,点击聚合点后显示信息模态框,打标点,【Uniapp】高德地图的接入自定义标点与信息窗体使用,绘制行政区域边界,绘制多边形,电子围栏,高德行政区划边界,

✅ 精选推荐文章 1万+

HuggingFace Transformer库学习

attention_mask是一个布尔张量,用于指示哪些位置有实际的单词(对应于input_ids),哪些位置是填充的(用于使输入长度一致)。而较低的温度值则会使概率分布更加尖锐,模型更可能选择概率最高的token,导致生成的文本更加确定和可预测。这有助于增加生成文本的多样性和随机性。总之,这段代码的目的是从给定的model_path加载一个预训练的因果语言模型,并尝试优化CPU内存使用。model.generate() 是一个常用的函数,用于在给定的输入基础上生成一系列的token(即文本的基本单元)。

Jeremy_lf的博客 3237

拉曼光谱入门:7.拉曼光谱仪光学系统结构详解

本文系统拆解了拉曼光谱仪从激光器输出经聚焦照明、二向色镜/陷波滤光片组滤除瑞丽散射、衍射光栅色散至CCD探测的完整光路,阐述了各光学模块在微弱非弹性散射信号提取、杂散光抑制及高分辨光谱成像中的工程原理与技术参数要求。

qq_53529450的博客 224

PyTorch深度学习实战(7)——批大小对神经网络训练的影响

在神经网络中,批( batch )是指一次输入网络进行训练或推断的一组样本。批处理( batch processing )是指将这一组样本同时输入网络进行计算的操作。本节中首先介绍批( Batch )的基本概念,并且介绍批大小在神经网络训练过程中的影响。

盼小辉丶的博客 1万+

Transformer模型原理与HuggingFace实战指南

自注意力机制作为Transformer架构的核心突破,通过动态权重分配实现了全局依赖关系的并行计算,显著提升了模型训练效率。该技术配合位置编码和残差连接等设计,解决了传统RNN的顺序处理瓶颈,在自然语言处理领域引发革命性变革。HuggingFace生态通过Transformers库和Datasets工具链,为开发者提供了超过20万预训练模型的统一接口与高效数据处理能力。在实际应用中,工程师需要根据任务类型、硬件条件和语言特性进行模型选型,例如文本分类选用BERT系列、生成任务采用GPT架构。通过PyTorc

weixin_34408624的博客 527

rk3568 修改开机动画

bootanimation.zip是一个Android设备启动时播放的动画文件,它包含了一系列的图片和描述文件,用于描述动画的播放顺序和持续时间。

weixin_35723192的博客 2729

聊聊HuggingFace Transformer

如上概述了HuggingFace Transformer相关的项目组件及背景逻辑,比较基础,蛮重要的,这些相关的基础点都是通用的。在理解大模型与NLP上都是相辅相成。因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。作为一个普通人,无法全部学完,所以我们在提升技术的时候,首先需要明确一个目标,然后制定好完整的计划,同时找到好的学习方法,这样才能更快的提升自己。这份完整版的大模型 AI 学习资料已经上传优快云

2401_85327249的博客 2127

进阶篇第8节:寄存器压力——寄存器溢出对性能的影响及优化

**摘要:GPU寄存器是最快的存储单元(1周期访问),但数量有限。过高的寄存器使用会导致溢出(变量存入慢速本地内存)或降低占用率(减少并发线程数),严重影响性能。优化方法包括复用变量、使用共享内存替代寄存器数组、限制寄存器数量(--maxrregcount)等。实际测试显示,将寄存器使用从48个降至24个可使性能提升37%。分析工具如Nsight Compute可帮助检测寄存器压力。面试常见问题涉及寄存器溢出的检测与优化策略。

PeterPan的博客 95

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

如何在TensorFlow 2.9中加载HuggingFace的transformer模型

在TensorFlow 2.9中通过HuggingFace Transformers轻松加载预训练模型,实现高效NLP微调。结合Docker镜像确保环境一致性,利用TFAutoModel和AutoTokenizer无缝对接PyTorch发布的模型,全程使用Keras接口完成训练与部署,显著提升开发效率。

weixin_42103128的博客 951

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

【AI总结】别再傻傻分不清!一文带你彻底搞懂 Transformer、Transformers、Hugging Face 与 huggingface-hub

是根基,是理论突破。库是让理论落地开花的关键工具,是接触HF生态的主要入口。是以Transformers库为起点构建的完整AI开源平台和社区宇宙。它包含了Hub、Spaces、API等众多部分。是这个宇宙中的核心资源仓库(模型、数据集)。库是代码连接并操作Hub仓库的专用桥梁,通常与库协同工作。📌是思想(论文/架构),是实现了这个思想的流行工具库(Python包),是创造这个工具库并围绕它建立了庞大平台和生态的公司,而。

AlienProgrammer的博客 1440

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Transformer模型与HuggingFace生态实践指南

Transformer模型作为自然语言处理领域的革命性架构,通过自注意力机制解决了传统RNN的长距离依赖问题。其核心原理是基于Query-Key-Value的注意力计算,实现了并行处理和全局关系建模。这种架构不仅在机器翻译等NLP任务中表现出色,通过Vision Transformer等变体也成功应用于计算机视觉领域。HuggingFace生态提供了标准化的Transformer实现框架,包含统一的配置、分词器和模型接口,支持从文本分类到多模态任务的多种应用。在实际工程中,开发者常需处理内存优化和模型选择等

dianyin7770的博客 354

tensorflow2调用huggingface transformer预训练模型

tensorflow2调用huggingface transformer预训练模型一点废话huggingface简介传送门pipline加载模型设定训练参数数据预处理训练模型结语 一点废话 好久没有更新过内容了,开工以来就是在不停地配环境,如今调通模型后,对整个流程做一个简单的总结(水一篇)。 现在的NLP行业几乎都逃不过fune-tuning预训练的bert或者transformer这一关,按照传统方法,构建整个模型,在processer里传数据,在util里配路径,在bert_fine_tune.sh里

Aiur的博客 2997

安装anaconda下安装PyTorch、huggingface、tranceformers

安装anaconda下安装PyTorch、huggingface、tranceformers

weixin_54534636的博客 3013

Perplexica HuggingFace:Transformer嵌入模型应用

在当今信息爆炸的时代,传统的关键词匹配搜索已经无法满足用户对精准信息获取的需求。Perplexica作为开源AI搜索引擎,通过集成HuggingFace Transformer嵌入模型,实现了从关键词搜索到语义理解的革命性跨越。本文将深入探讨Perplexica如何利用Xenova Transformers构建强大的语义搜索能力,为开发者提供完整的嵌入模型应用解决方案。 ## 核心架构:Hugg...

gitblog_01174的博客 1030
上一篇: 如何在ms-swift 微调训练deepseekvl2时使用sageattention
下一篇: 解决PIP 安装出错ERROR: cp310-cp310-manylinux_2_28_x86_64.whl is not a supported wheel
aerror
博客等级 码龄23年 393粉丝 193原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值