sklearn决策树

sklearn机器学习之随机森林分类(红酒数据集) 本次使用随机森林通过十折交叉验证得到最大平均精度为99% 1.导入相应包 from sklearn.tree import DecisionTreeClassifier from matplotlib import pyplot as plt from sklearn.ensemble import RandomForestClassifier from sklearn.datasets import load_wine from sklearn.model_selection import train_t 阅读详情

调用方式

from sklearn.tree import DecisionTreeClassifier
# 创建样本
X, y = [[9], [8]], [1, 0]
# 建模
model = DecisionTreeClassifier()
# 训练
model.fit(X, y)
# 概率预测
print(model.predict_proba(X))

参数

参数注释默认值
criterion基尼系数或信息增益(gini or entropy)“gini”
splitter全部或随机选择特征(best or random)“best”
max_depth树最大深度None
min_samples_split节点样本数小于该值则不再切分2
min_samples_leaf叶子节点的最小样本数1
min_weight_fraction_leafThe minimum weighted fraction of the sum total of weights (of all the input samples) required to be at a leaf node.
样本权重默认相等
0.
max_features最大特征数None
random_state设置随机状态,默认用numpy.randomNone
max_leaf_nodes叶子节点的最大个数None
min_impurity_decreaseA node will be split if this split induces a decrease of the impurity greater than or equal to this value.0.
min_impurity_splitThreshold for early stopping in tree growth.
A node will split if its impurity is above the threshold, otherwise it is a leaf.
None
class_weight指定样本中各类别的权重None
presort是否预分类 以加快 在拟合过程中寻找最优切分 的速度(默认否)False

概率预测

import pandas as pd
from sklearn.tree import DecisionTreeClassifier
# 创建样本
df = pd.DataFrame({
    '高': [1, 0, 1, 1, 1, 1, 0, 0, 0, 0],
    '富': [1, 1, 0, 0, 0, 0, 0, 0, 0, 0],
    '帅': [1, 0, 1, 0, 0, 0, 1, 1, 1, 0],
    '约': [1, 1, 1, 1, 1, 0, 0, 0, 1, 0]}
)
X = df[['高', '富', '帅']].values
y = df[['约']].values
# 建模训练
model = DecisionTreeClassifier()
model.fit(X, y)
# 约会预测
men = {'高': [1, 0, 0],
       '富': [0, 1, 0],
       '帅': [0, 0, 1]}
for man in men:
    probability = model.predict_proba([men[man]])[0][1]
    print('【{}man】约到女神的概率是:{:.1f}%'.format(man, probability * 100))

【高man】约到女神的概率是:66.7%
【富man】约到女神的概率是:100.0%
【帅man】约到女神的概率是:33.3%

可视化

随机森林

import numpy as np, matplotlib.pyplot as mp
from sklearn.datasets import make_moons
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier

# 创建随机数据集、数据标准化、训练集测试集切分
X, y = make_moons(n_samples=200, noise=.2)
X = StandardScaler().fit_transform(X)

# 建模、训练、评分
clf = RandomForestClassifier(max_depth=4, min_samples_split=9)
clf.fit(X, y)

# 等高线图
x_min, x_max = X[:, 0].min() - .5, X[:, 0].max() + .5
y_min, y_max = X[:, 1].min() - .5, X[:, 1].max() + .5
xx, yy = np.meshgrid(np.arange(x_min, x_max, .01),
                     np.arange(y_min, y_max, .01))
Z = clf.predict_proba(np.c_[xx.ravel(), yy.ravel()])[:, 1].reshape(xx.shape)
mp.contourf(xx, yy, Z, alpha=.3)
# 散点图
mp.scatter(X[:, 0], X[:, 1], s=50, c=y)
mp.show()
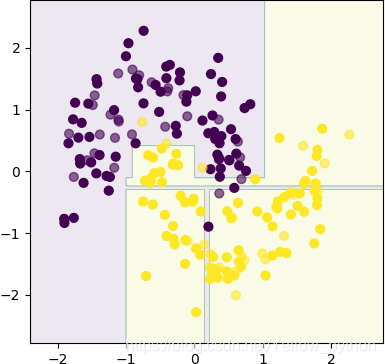
在这里插入图片描述

不同树深度的比较

import numpy as np, matplotlib.pyplot as mp
from sklearn.datasets import make_moons
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

X, y = make_moons(noise=.2)
X = StandardScaler().fit_transform(X)
X_train, X_test, y_train, y_test = train_test_split(X, y)

s, e = 3, 7
for i in range(s, e + 1):
    # 建模、训练、得分
    clf = DecisionTreeClassifier(max_depth=i)
    clf.fit(X_train, y_train)
    score = clf.score(X_test, y_test)
    print(score)
    # 可视化
    mp.subplot(1, e - s + 1, i - s + 1)
    x_min, x_max = X[:, 0].min() - .5, X[:, 0].max() + .5
    y_min, y_max = X[:, 1].min() - .5, X[:, 1].max() + .5
    xx, yy = np.meshgrid(np.arange(x_min, x_max, .01),
                         np.arange(y_min, y_max, .01))
    Z = clf.predict_proba(np.c_[xx.ravel(), yy.ravel()])[:, 1].reshape(xx.shape)
    mp.contourf(xx, yy, Z, alpha=.2)  # 等高线图
    mp.scatter(X_train[:, 0], X_train[:, 1], s=40, c=y_train)
    mp.scatter(X_test[:, 0], X_test[:, 1], s=40, c=y_test, alpha=0.6)
mp.tight_layout()  # 防止重叠
mp.show()
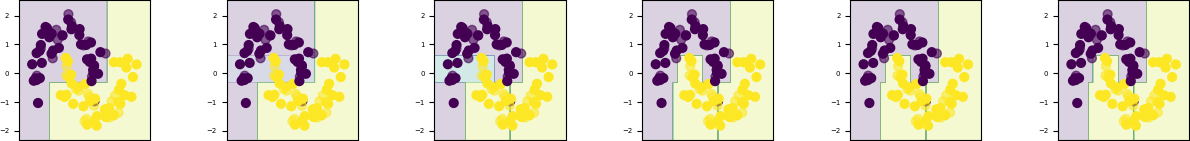
在这里插入图片描述

附录

sklearn版本:0.19.1

注释

encn
criterion准则
fraction分数;部分
probability概率
impurity杂质
presort预分类
featuren. 特征;vt. 特写
threshold门槛;阈值
contourn. 轮廓、等高线;vt. 画轮廓
mesh网眼
gridn. 网格;栅格;
meshgrid用于三维曲面的分格线座标;产生“格点”矩阵
tight密封的
layout布局;陈列
葡萄酒数据集的随机森林分类 我这里选择的是红酒样本数据的特征与标签特征:11个;标签:红酒质量0-10之间,11个类别2:查看数据集可以看到数据都在一列里,需要改一下。 阅读详情

相关推荐

Sklearn+Flask实现决策树模型及部署

Sklearn+Flask实现决策树模型及部署 sklearn和决策树 决策树 决策树是机器学习的一种算法,简要原理分析见上篇。 sklearn sklearn是python的一个机器学习框架,其中包含了很多机器学习算法的实现。sklearn.tree模块提供了决策树模型,用于解决分类问题和回归问题。本次模型的实现是使用的DecisionTreeClassifier来构建决策树。 对于sklearn.tree,可以看官网:https://scikit-learn.org/stable/modules/cla

hezhing 1918

scikit-lean 随机森林代码学习--红酒

代码笔记 %matplotlib inline from sklearn.tree import DecisionTreeClassifier from sklearn.ensemble import RandomForestClassifier from sklearn.datasets import load_wine wine = load_wine() from sklearn....

szfhy的博客 1354

sklearn之决策树参数详解

这篇文章将会详细的介绍sklearn.tree的模型参数,属性,方法;保证全面并且正确。

SKIp121whats112的博客 9046

Scikit-learn实现随机森林算法

随机森林指的是利用多棵树对样本进行训练并预测的一种分类器 随机森林的原理 在机器学习中,随机森林是一个包含多个决策树的分类器 根据下列算法而建造每棵树: 用N来表示训练用例(样本)的个数,M表示特征数目。 输入特征数目m,用于确定决策树上一个节点的决策结果;其中m应远小于M。 从N个训练用例(样本)中以有放回抽样的方式,取样N次,形成一个训练集(即bootstrap取样),并用未抽到的用例(样本)作预测,评估其误差。 对于每一个节点,随机选择m个特征,决策树上每个节点的决定都是基于这些特征确定的。根据这m

qq_44971458的博客 4692

sklearn决策树(Decision Tree)多分类问题

文章目录步骤建立模型特征选择预剪枝预处理训练测试+评价模型可视化不同的criterion和max_depth训练决策树结果 步骤 建立模型 class sklearn.tree.DecisionTreeClassifier(criterion=’gini’, splitter=’best’, max_depth=None, min_samples_split=2, min_samples_leaf=1, min_weight_fraction_leaf=0.0, max_features=None, ran

Yvesx的博客 1万+

机器学习案例实战:使用sklearn构造决策树模型

原创文章,如需转载请保留出处 本博客为唐宇迪老师python数据分析与机器学习实战课程学习笔记 一. 决策树复习 参考https://blog.youkuaiyun.com/qq_14815661/article/details/94838783 二. 决策树涉及参数 2.1 导入三大件 %matplotlib inline import matplotlib.pyplot as plt import pa...

qq_14815661的博客 1313

【机器学习】使用Scikit-Learn库实现随机森林

使用随机森林将弱分类器集成为强分类器 随机森林视为多棵决策树的集成。 集成学习的基本理念:将弱分类器集成为鲁棒性更强的模型(强分类器)。 分类器集成后具备更好的泛化误差,不容易过拟合。   使用随机森林步骤: 1、       使用bootstrap抽样法,随机选择n个样本用于训练 2、       使用第一步选择的样本构造决策树  1)       不重复的随机选择d个特征  

探索世界,改变世界 2545

SKlearn学习笔记——决策树

SKlearn学习笔记——决策树1. 概述1.1 决策树是如何工作的1.2 sklearn中的决策树2. DecisionTreeClassifier2.1 重要参数2.2 重要属性和接口 前言: scikit-learn,又写作sklearn,是一个开源的基于python语言的机器学习工具包。它通过NumPy, SciPy和Matplotlib等python数值计算的库实现高效的算法应用,并且涵盖了几乎所有主流机器学习算法。 以下内容整理自 菜菜的机器学习课堂. sklearn官网链接: 点击这里. 1

Stephen 5247

ID3决策树 Python实现 + sklearn库决策树模型的应用

本文介绍机器学习中决策树算法的python实现过程 (1)亲手实现Python ID3决策树经典算法 (2)利用sklearn库实现决策树算法

YJY131248的博客 3517

使用Sklearn和Flask实现决策树模型及部署

在本文中,我们将探讨如何使用Scikit-learn(Sklearn)和Flask框架来实现决策树模型并进行部署。函数中,我们获取请求中的特征,并使用我们之前训练的模型进行预测。接下来,我们将使用Flask来构建一个简单的Web API,以便我们可以部署我们的决策树模型。现在,我们可以使用任何可以发送HTTP请求的工具来测试我们的API。在上面的代码中,我们首先创建了一个特征矩阵X和一个目标向量y。在上面的代码中,我们首先定义了API的URL和要发送的特征数据。现在,我们可以运行我们的Flask应用程序。

RfqrScheme的博客 283

告别DLTS的模糊地带:手把手教你用拉普拉斯深能级瞬态光谱(LDLTS)精准揪出半导体缺陷

本文详细介绍了拉普拉斯深能级瞬态光谱(LDLTS)技术在半导体缺陷检测中的高分辨率解决方案。相比传统DLTS,LDLTS通过拉普拉斯变换和正则化算法,将分辨率提升至1meV,有效解析复杂重叠缺陷谱,适用于硅、GaN等材料的精确缺陷分析。文章涵盖LDLTS原理、系统搭建、测量流程及工业应用案例,为半导体工艺优化提供强大工具。

weixin_29238147的博客 193

使用sklearn构造决策树模型

决策树算法难点:如果构造决策树模型 %matplotlib inline import matplotlib.pyplot as plt import pandas as pd from sklearn.datasets.california_housing import fetch_california_housing housing = fetch_california_housi...

我思故我在! 919

FAST-LIO2实战:如何在无人机上部署并实现厘米级定位(附ROS配置全流程)

本文详细介绍了如何在无人机上部署FAST-LIO2激光雷达惯性里程计系统,以实现厘米级精确定位。内容涵盖从硬件选型(如激光雷达与机载计算机)、软件环境配置(ROS Noetic)、传感器标定,到FAST-LIO2参数调优、与PX4飞控集成以及实际飞行测试的全流程。重点解决了实时定位中的外参标定、数据同步等关键问题,为无人机在无GPS或复杂光照环境下提供稳定可靠的定位解决方案。

weixin_29062865的博客 251

利用sklearn库决策树模型对iris数据多分类并进行评估

本文用sklearn中的决策树实现iris数据集的多分类问题并介绍相关函数。

xst66666的博客 3613

systrace分析 之 问题初步定位

如下surfaceflinger空缺点,上面对应的bufferTX 中有buffer,但VSYNC-SF 过来后,SurfaceFlinger却没有去取,检查测试app “android.settings”, 也没有GPU completion 时间长的问题,所以该部分可以请SurfaceFlinger的owner 进一步确认为何不取buffer。. GPU拿的是acquireFence HWC拿的是releaseFence, GPU是绘图,HWC是合成显示,这两个是互相等待的关系,

yangzex的专栏 3197

机器学习入门基础 | 基于python的高光谱图像特征挖掘:PCA + 形态学属性处理可视化实战

本文介绍了一种基于PCA和形态学操作的高光谱图像特征提取方法。通过主成分分析降低数据维度,再运用面积开闭操作增强空间结构特征,有效去除噪声并填补孔洞。实验采用WHU-HI-HanChuan数据集,提供完整的Python实现代码,包括数据加载、PCA降维、形态学处理及结果可视化等步骤。该方法能够显著改善图像质量,为后续分类和变化检测任务提供更好的特征输入。实验结果表明,不同阈值的形态学处理能呈现不同程度的空间结构增强效果,对区域生长、分割和聚类等应用具有重要价值。

lestatlu的博客 1048

python sklearn 决策树模型

python sklearn 决策树模型 """ 决策树模型 相似的输入必会产生相似的输出 """ import sklearn.datasets as sd import sklearn.utils as su import sklearn.tree as st import sklearn.metrics as sm # 加载数据集 波士顿房价 boston = sd.load_boston() print(boston.data.shape) print(boston.target

廷益_飞鸟的博客 657

Spring Boot:如何快速搭建一个高性能微服务架构?

通过本文的详细步骤,我们成功搭建了一个高性能的微服务架构。Spring Boot 和 Spring Cloud 提供了强大的工具链,使得开发者能够快速实现服务注册与发现、负载均衡、熔断器与降级机制等功能。同时,通过数据库连接池、Redis 缓存和异步处理等优化手段,进一步提升了系统的性能和可靠性。希望本文能够帮助你快速入门 Spring Boot 微服务架构的搭建,并为实际项目提供参考。如果你有任何问题或建议,欢迎在评论区留言!

shrgegrb的博客 1013

使用sklearn建立决策树模型代码

使用sklearn训练模型并预测结果 定义数据 def loaddata(): dataSet = [[0, 0,0,0, 'no'], [0, 0,0,1,'no'], [0, 1,0,1, 'yes'], [0, 1,1,0, 'yes'], [0, 0,0,0, 'no'], [1, 0,0,0, 'no'], [1

袁钰琦的博客 1433

【Mode】微带传输线阻抗

微带线,英文名称为 (Microstrip) 是一种常见的平面传输线,主要用于传输微波频率信号(通常在射频和微波电路重中使用)。

u011699626的博客 245

Python爬虫教程:抓取社交媒体内容(以Facebook和Instagram为例)

为什么抓取社交媒体内容?品牌分析与监测:通过抓取品牌、产品或服务相关的社交媒体数据,可以获得公众对其的评价,识别市场趋势,制定营销策略。情感分析:分析用户在社交平台上的情感倾向,如对某事件、产品、服务的正面或负面情绪。舆情监控:通过抓取大量社交媒体内容,监测公众对热点事件的反应,发现潜在的社会问题。用户行为分析社交媒体的数据类型:帖子和内容:包括用户发布的文本、图片、视频等。用户互动用户信息:包括用户名、粉丝数、关注数等社交信息。社交媒体的反爬虫机制:API限制。

2201_76125261的博客 1340

【sklearn】使用sklearn实现决策树

1. 决策树介绍 1. 信息熵 2. 信息增益 3. 信息熵和信息增益 2. 使用sklearn实现决策树 1. 导入包和数据 2. 数据处理 3. 开始训练模型 4. 使用模型预测 决策树可视化 3. 附录 1. 关于 `DictVectorizer( )` 2. 关于 `dict(zip())` 3. 关于 `tree.DecisionTreeClassifier`

Eli_Code 1万+

无人机导航中的坐标系统详解与转换实现

本文系统介绍了无人机导航中常用的坐标系及其转换方法。主要内容包括:1) 四种关键坐标系(大地坐标系ECEF、经纬度LLA、北东天坐标系NED、机体坐标系)的定义和特点;2) 坐标系间的转换原理与实现,重点讲解LLA与ECEF的互转公式及ECEF与NED的转换方法;3) 提供可直接使用的C++实现代码,包括基于WGS84椭球模型的精确转换算法。这些内容为无人机导航系统开发提供了实用的坐标系处理方案,能够有效解决多源数据在不同坐标系下的统一表示问题。

电脑管家 380

python sklearn 绘制决策树模型的节点图

绘制决策树的图片可以使用sklearn.tree.plot_tree这个方法 详情可以参考官方文档:https://scikit-learn.org/stable/modules/generated/sklearn.tree.plot_tree.html 示例代码 import matplotlib.pyplot as plt import numpy as np from sklearn.tree import plot_tree # 树图 from sklearn.tree import Decisi

呆萌的代Ma 3523

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

sklearn函数总结十 —— 决策树

纯手打,代码整理中,持续更新中^-^序号延用总结九。

weixin_41072743的博客 1375

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

sklearn生成的决策树转换为规则树

使用sklearn调用DecisionTreeClassifier可以很简单的实现决策树算法,然而对于实现者而言并不知道树的结构是什么样子的,也不知道决策树模型如何做出的决策,本文将决策树模型以规则的形式展现出来,并且实现可视化,方便读者理解。 实现的代码如下: # -*- coding: utf-8 -*- from sklearn.externals.six import String...

little_yan的博客 7612

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

上一篇: sklearn详细总结
下一篇: Python3解析【\u】和【\\u】字符
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
