机器人技术与智能系统的工程化与应用 第十一章 Sim-to-Real 系统化迁移策略

从机器狗送水看具身智能测评:技术实现与工程实践全解析 具身智能(Embodied AI)是人工智能与物理世界交互的关键前沿,它通过赋予智能体“身体”,使其能感知、决策并执行物理任务。其核心原理在于将算法模型(大脑)与传感器、执行器紧密结合,通过与环境持续交互来涌现智能。这项技术的核心价值在于弥合虚拟智能与物理行动之间的鸿沟,是实现通用人工智能和实用机器人不可或缺的一环。其应用场景广泛,从工业自动化、家庭服务到自动驾驶和特种作业,都需要智能体在非结构化环境中稳健地完成任务。为了科学评估和推动该领域发展,业界建立了**具身测评基准(Benchmark)**,它通过 阅读详情

11.1 域随机化与对抗扰动设计

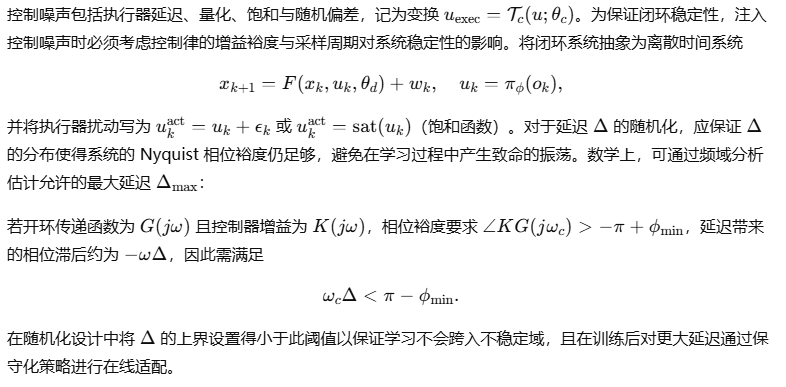
域随机化与对抗扰动的目标在于通过构造仿真域内的多样性和极端情形,使学习到的策略在现实中保持鲁棒性。理论上可将迁移问题表述为对参数不确定集和观测变换下性能的最小化风险问题,并通过随机化采样与最坏情形优化(min–max)两类方法分别降低偏差与提升极端稳健性。以下首先给出形式化的优化目标,然后逐项推导视觉、动力学与控制噪声注入的设计要点,最后推导对抗场景生成的数学框架与试验床构建准则。

11.1.1 视觉、动力学与控制噪声注入要点
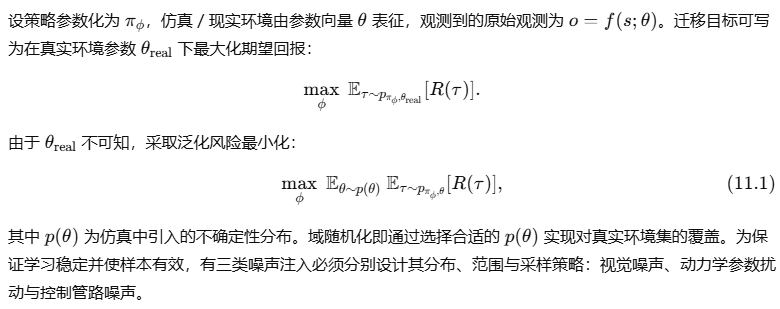
(一)视觉噪声的设计
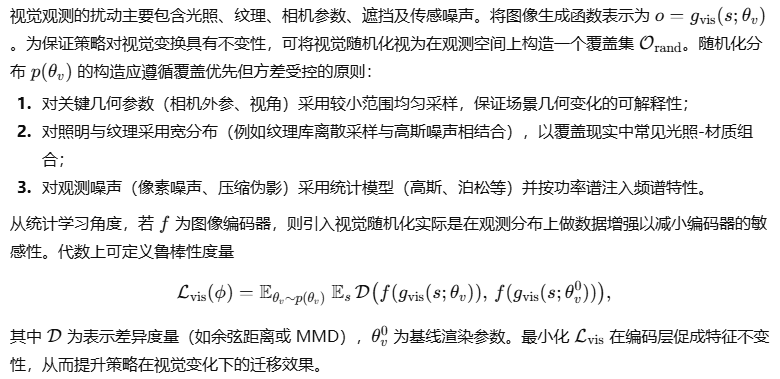
(二)动力学参数扰动的设计
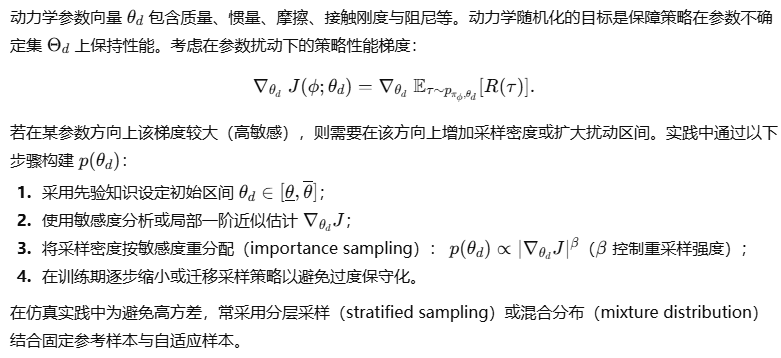
(三)控制噪声与执行管路不确定性的建模
11.1.2 对抗场景生成与鲁棒性试验床

域随机化覆盖的是“典型”变化,而对抗扰动寻求识别并强化“最差情况”。对抗场景生成以 min–max 形式刻画:对给定策略 πϕ\pi_\phiπϕ​,寻找参数 θ\thetaθ 使得损失(或负回报)最大化;对抗训练即交替求解该 min–max 问题。

(一)min–max 优化框架的推导
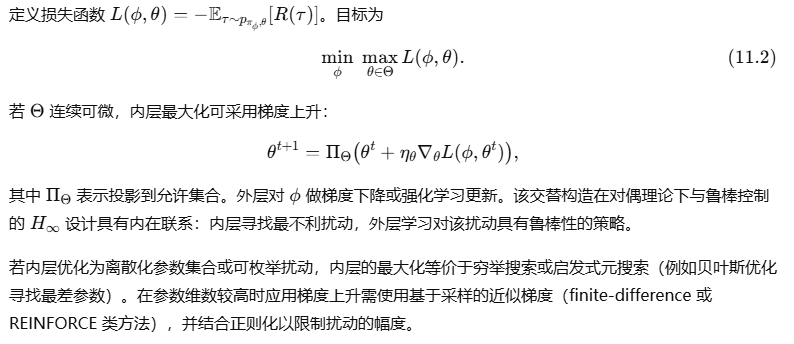
(二)对抗几何与场景扰动的构造
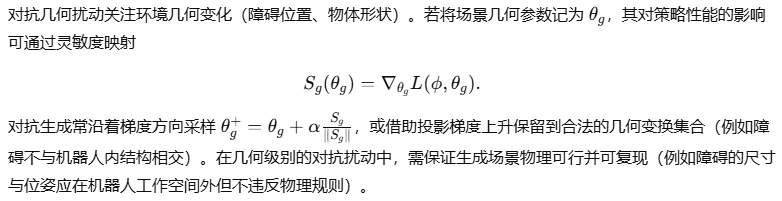
(三)鲁棒性试验床的组织原则
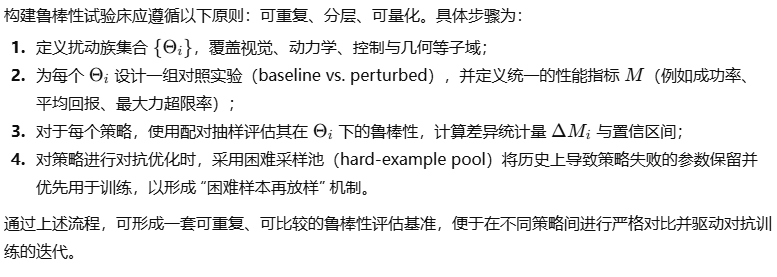

11.1.3 迁移损失、分布对齐与特征不变性

策略从仿真域迁移到现实域的性能差异可以被量化为在特征或行为分布上的偏移。系统化迁移需要定义明确的迁移损失、设计分布对齐方法并构造特征不变性约束,使得在仿真训练的表示空间中现实观测映射到相似的编码分布,从而保证策略输出的一致性。以下首先形式化迁移损失并给出分布距离的选择与性质,然后推导若干对齐算法(对抗对齐、最小均方差、Wasserstein 最小化)及其理论性保证,最后讨论在强化学习体系下的实用实现细节与收敛性考虑。

11.1.3.1 迁移损失的数学表述
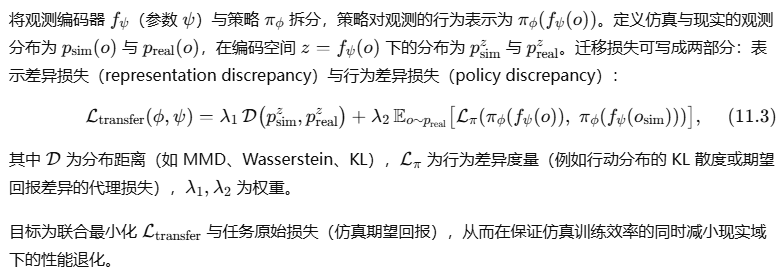
11.2.2 分布对齐方法与理论推导

分布对齐方法可分为三大类:统计距离最小化(MMD 等核方法)、对抗式对齐(GAN 风格)、以及基于运输代价的 Wasserstein 对齐。下面分别给出它们的形式化推导与适用性分析。

(一)核两样本检验与 MMD 对齐
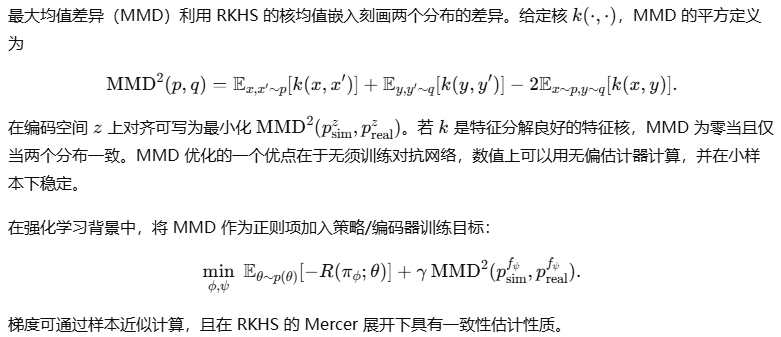
(二)对抗式分布对齐(Adversarial Alignment)
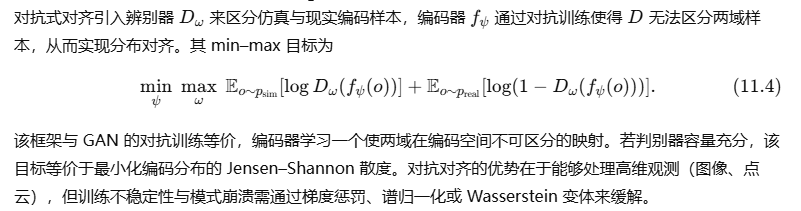
(三)Wasserstein 对齐与最优传输视角
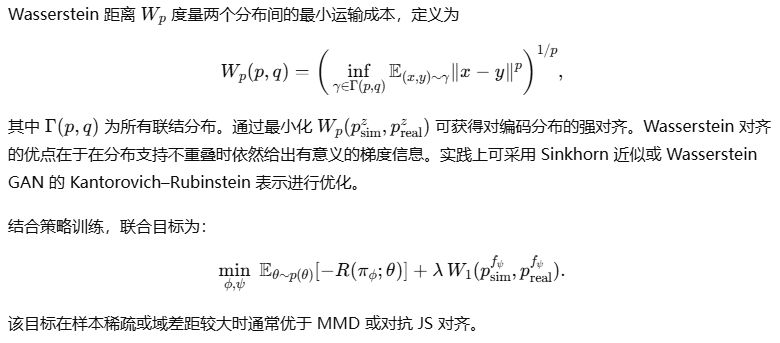
11.2.3 特征不变性与任务相关保持

对齐编码分布并不必然保证策略输出的不变性。应在编码训练中同时保持任务相关性,使编码既能去除域特有噪声,又保留对控制决策有判别性的信息。构造联合损失:
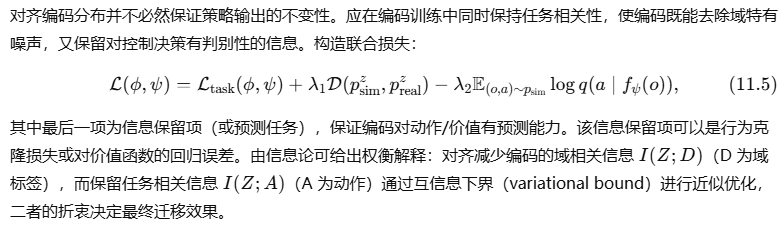
11.2.4 强化学习下的实现细节与收敛性

在强化学习体系中,通常采用异步或交替优化:在仿真中进行策略更新的同时收集现实数据用于对齐正则项或监督。为保证训练稳定与样本效率,实践中建议:

  1. 采用小步长的对齐正则化逐步引入,避免在训练早期破坏策略收敛性;

  2. 使用经验回放混合仿真与现实样本(比例调度)以稳定近似梯度;

  3. 对抗训练中对判别器采用梯度惩罚与谱归一化以保证训练稳定;

  4. 在对齐时保留任务相关的最小足够统计量(sufficient statistics),通过信息瓶颈正则或判别器辅助任务保留机制实现。

理论上,若对齐损失与任务损失均为凸并满足 Lipschitz 条件,则交替最小化具有局部收敛性保证。强化学习中由于非凸性与采样噪声,收敛性为局部性质,需借助经验验证与小样本微调校验最终迁移性能。


小结

本章建立了 Sim-to-Real 的系统化设计方法论:通过域随机化覆盖典型域差异、通过对抗扰动增强极端鲁棒性、并通过分布对齐与编码器正则构造特征不变性以降低迁移损失。在视觉、动力学与控制随机化时应基于敏感度分析与稳定性约束选择扰动分布;对抗生成则以 min–max 优化形式刻画最差场景并通过困难样本重采样驱动训练。分布对齐可采用 MMD、对抗对齐或 Wasserstein 最小化等方法,结合任务保留项以保持动作可判别性。理论推导与工程实现共同指向:在保证学习效率的前提下,通过有控制的随机化与对齐策略,系统性地降低仿真与现实的域差距,提升策略的可靠迁移性能。

11.2 在线校正与闭环自适应方法

在线校正与闭环自适应的目标在于在部署阶段以最小的真实数据代价修正仿真偏差或策略失配,保证控制器在面对模型误差、参数漂移或未建模扰动时仍能保持性能与安全性。在线校正包含两个相互耦合的子问题:一是在线系统辨识与参数自适配,用于实时估计环境或机器人动力学参数并将估计用于控制或仿真参数更新;二是在线微调策略与安全回退机制,用于在保证安全约束下对策略做渐进改进或回滚。下文从数学模型、辨识算法、收敛性条件、控制融合与安全保证出发,按步骤推导可实施的在线自适应框架并给出工程实现要点与验证方法。


11.2.1 在线系统辨识与参数自适配策略

一、问题形式化与线性参数化假设
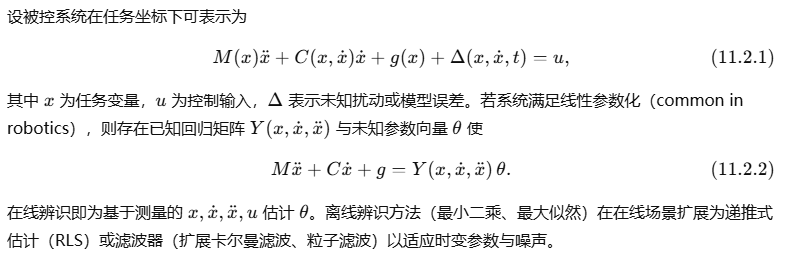
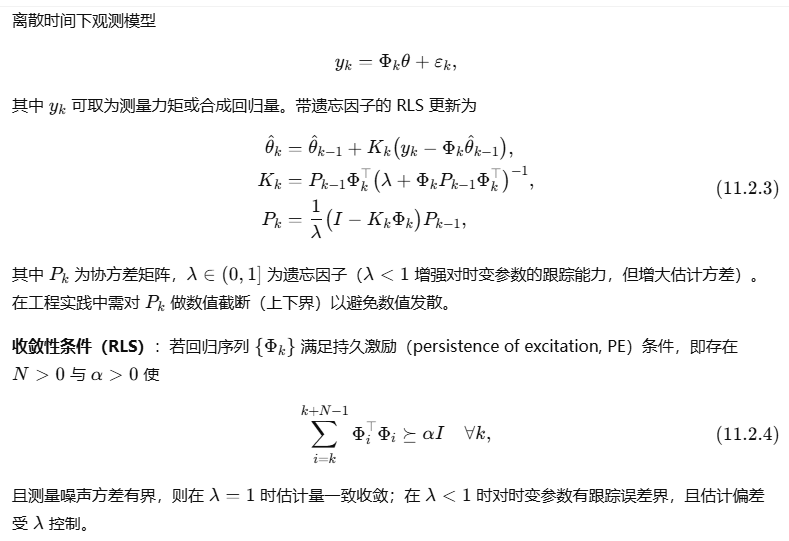
二、递推最小二乘(RLS)与遗忘因子
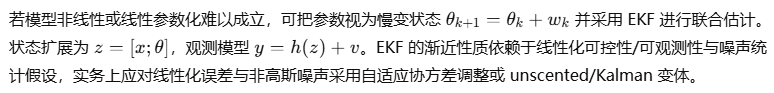
三、扩展卡尔曼滤波(EKF)与联合状态-参数估计
四、基于 Lyapunov 的自适应控制:Slotine–Li 框架
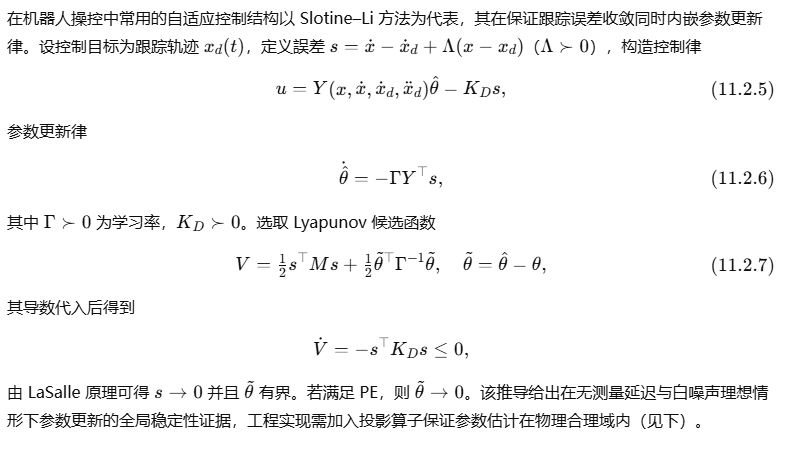
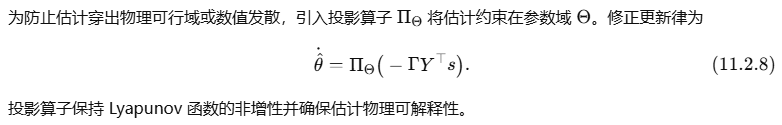
五、参数投影与约束更新
六、实际工程要点

  1. 激励设计:在线辨识需要在不破坏任务的前提下引入富激励(例如小幅探测性微动、调制控制参考轨迹),满足 PE 条件以保证参数收敛。

  2. 数值稳定:对 RLS 的 PPP 做上界/下界截断,使用单步正则化或退火因子避免协方差发散。

  3. 延迟与采样:考虑传感延迟与滤波器相位,采用预测补偿或在估计器中显式建模时间滞后。

  4. 混合估计:对高维或非线性参数采用 EKF/UKF,关键刚性参数用 RLS 联合估计以兼顾精度与效率。

  5. 验证环节:基于持久激励窗口计算 Fisher information 矩阵与估计方差,若信息不足则触发安全微动以获得更多数据。


11.2.2 在线微调、安全回退与实时验证机制

一、在线微调的目标与方法

在线微调(online fine-tuning)指在现实交互中以小批量真实数据对策略参数(或感知编码器)做增量优化,提升在真实环境下的性能。常见技术包括行为克隆微调、策略梯度少样本更新、以及基于元学习的快速适应(MAML)。在线微调必须在保证安全的前提下执行,通常采用保守更新策略与安全投影。

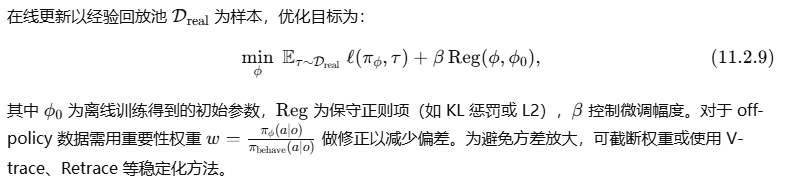
(一)增量优化与重要性重加权
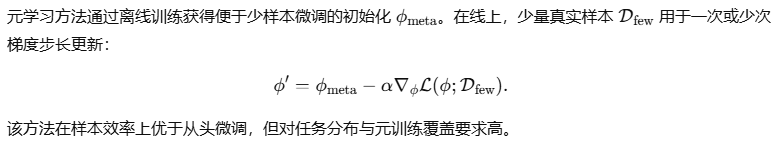
(二)元学习与快速适应
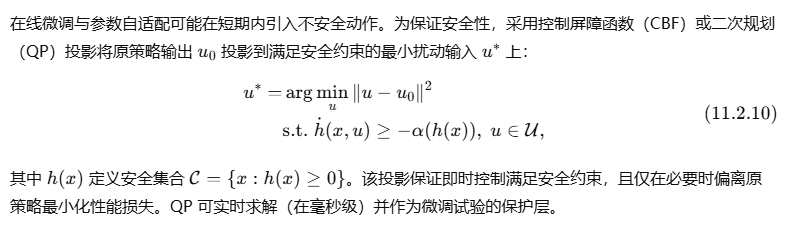
二、安全回退(Safe Fallback)与控制投影
三、实时验证与概念漂移检测

在线运行中需实时监测策略性能与环境分布变化,常用方法包括:
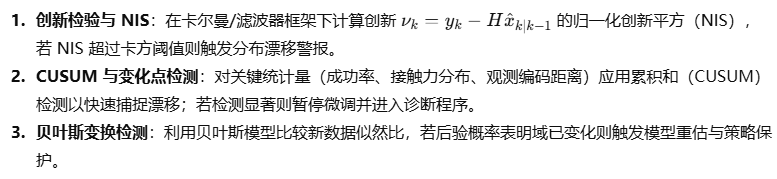
实时验证逻辑设定多级阈值以权衡误报与漏报。发生漂移时采取分层响应:轻微漂移触发保守增益调节与小量微调;显著漂移触发回退到上一个受验证的策略快照并进入离线诊断。

四、回滚与快照策略

为保证可追溯与快速恢复,所有在线更新应在受控事务中进行:在微调前创建策略快照并记录元数据(版本、采样种子、现场日志)。若实时验证检测到性能下降超阈,则自动回滚到最近的稳定快照并记录触发条件以供离线分析。快照策略需满足原子性:更新要么完全生效,要么完全回滚,避免半结构配置导致的不一致性。

五、在线微调的算法伪码

初始化: π ← π_0, snapshot ← save(π)
for each episode do
  collect trajectory τ_real
  append τ_real to D_real
  if detect_drift(D_real) then
    restore(snapshot); trigger offline_diagnosis()
    continue
  end
  if ready_for_finetune(D_real) then
    compute gradient g on small minibatch from D_real
    apply constrained update: φ_new = argmin ||φ-φ_old||^2 + α g^T(φ-φ_old) s.t. safety_QP
    if validate(φ_new) then
      snapshot ← save(φ_new)
      π ← π_new
    else
      restore(snapshot)
    end
  end
end

验证函数 validate 包括短期仿真回放、保守在线试探以及监测短窗内安全事件率。安全 QP 在更新后即时应用于动作输出作为最后保障。

六、工程实践要点

  1. 计算与延迟约束:在线估计与 QP 求解需在控制周期内完成,选择轻量级估计算法并在必要时将复杂估计下放至背景线程。

  2. 样本效率与稳定性:使用经验回放、重要性截断与小步长更新避免对策略造成剧烈变动。

  3. 审计与可追溯:记录每次在线更新的触发条件、数据样本、验证结果与快照以便事后分析。

  4. 分级权限:对完全自动化更新设置等级限制,关键任务场景应采用半自动或人工批准机制。


小结

在线校正与闭环自适应结合辨识、参数自适配、微调与安全投影,形成一套面向真实部署的迁移闭环。数学基础包括 RLS/EKF 的统计收敛性、Slotine–Li 自适应控制的 Lyapunov 稳定证明与 PE 条件下的参数一致性;工程实施须兼顾实时性、数值稳定与安全保护,采用参数投影、控制屏障函数与回滚快照来保证安全性与可追溯性。实时验证与漂移检测机制提供在线自适应触发与保护逻辑,从而在有限真实交互预算下实现稳健的 Sim-to-Real 自适应迁移。

11.3 迁移失败诊断与恢复流程

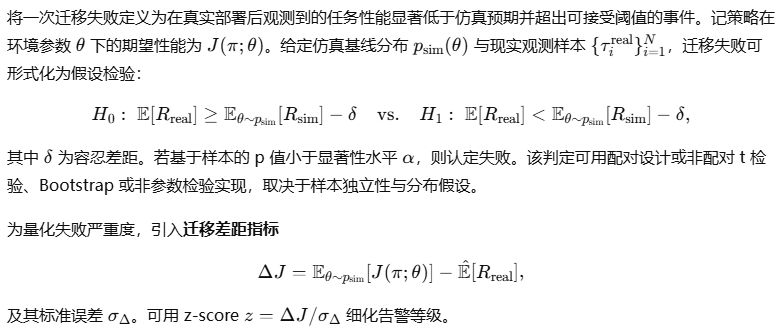
迁移失败诊断与恢复流程旨在构建从故障检测、根因定位到安全恢复与增量修复的一体化闭环。该流程要求日志与度量具有可追溯性、检测方法具有统计保证、恢复机制具备原子性与可回滚性、修复策略兼顾安全与收敛性。下文首先定义失败事件与度量框架,随后给出根因分析模板与必要日志字段,接着系统推导自动化探测算法(包含统计检验与变化点检测),最后描述回滚与增量修复的工程化实现与数学验证手段,并提供可直接实施的伪码与流程图式规范。


11.3.1 失败根因分析模板与日志要点

一、失败事件的形式化与度量
二、日志与元数据标准(必须字段)

成功的根因分析依赖于统一且详尽的日志 schema,建议每条相关试验/轨迹记录至少包含下列字段(机器可读 JSON):

  • experiment_id:唯一标识符(UUID)。

  • policy_version:策略模型版本(哈希)。

  • sim_baseline:基线仿真版本(MAJOR.MINOR.PATCH + commit)。

  • scene_id、scene_version:实际运行场景标识与版本。

  • timestamp_utc:统一时间戳(UTC,ISO8601)。

  • seed:若仿真迁移包含可复现部分,应记录随机种子。

  • observations:按时间序列记录的原始观测(视觉、触觉、力等)或其摘要引用。

  • actions:策略输出序列(时间对齐)。

  • rewards:即时或累计回报序列。

  • safety_events:安全阈值违约事件列表(时间、量值、类型)。

  • hardware_state:传感器/执行器健康状态(温度、电压、通信丢包率)。

  • deploy_config:运行时控制增益、滤波参数、延迟补偿等配置信息。

  • notes:人审注释(若有)。

  • provenance:指向仿真快照、训练数据包与版本控制的哈希引用。

日志应保证不可变性(append-only),并提供快速检索索引(按 experiment_id、policy_version、scene_id、时间窗)。

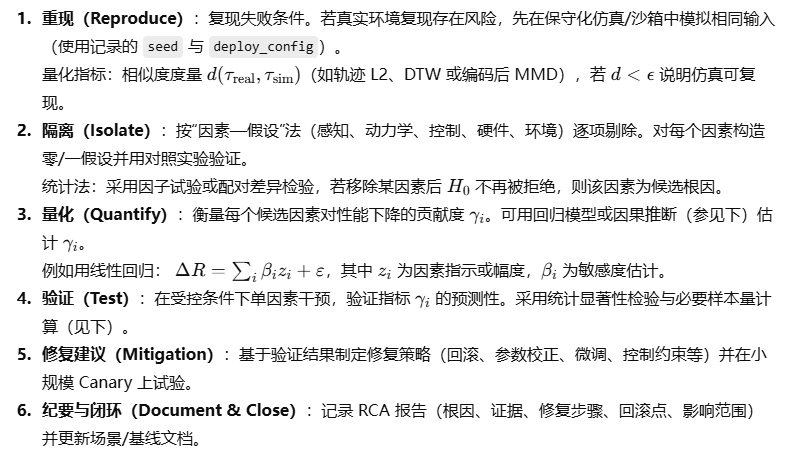
三、根因分析(RCA)模板与度量化流程

根因分析采用结构化流程并量化关键判断以降低人为偏差。模板步骤如下:
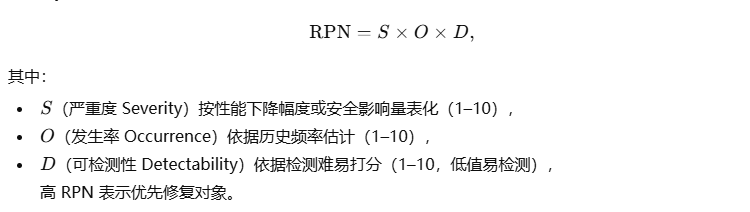
四、优先级量表与 FMEA 扩展

采用 FMEA(Failure Modes and Effects Analysis)方法对发现的故障类型做量化优先级(RPN,Risk Priority Number):

11.3.2 自动探测、回滚与增量修复实践

一、自动化故障检测:算法与阈值设定

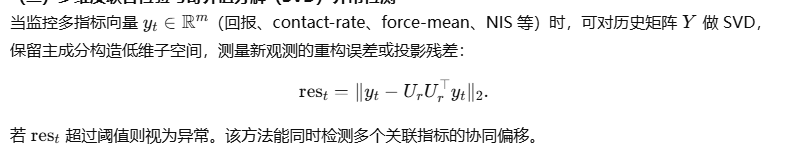
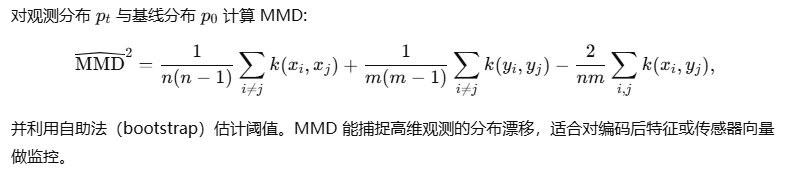
自动检测系统从流式指标中判断性能退化或异常。关键技术包括变化点检测(change point detection)、序列异常检测与多指标联合判决。

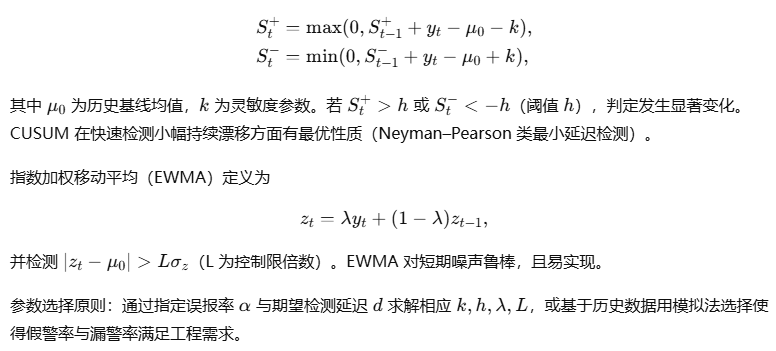
(一)CUSUM 与 EWMA 的变化点检测

对序列 yty_tyt​(如每 episode 回报或短窗成功率)使用累积和(CUSUM)检测上升/下降趋势。定义双向 CUSUM 统计:
(二)多维度联合检验与奇异值分解(SVD)异常检测
(三)基于分布距离的漂移检测(MMD / Wasserstein)
二、自动回滚策略与安全隔离

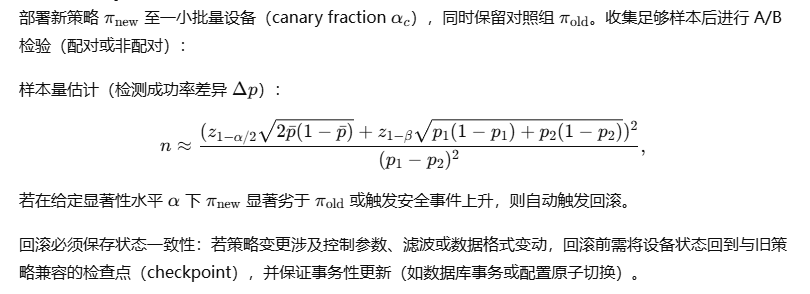
回滚策略要求原子性、最小中断与可追溯的恢复步骤。工程化实现通常采用 Canary / Blue–Green 模式与分阶段回滚。

(一)Canary 发布与自动回滚判据
(二)蓝绿部署(Blue–Green)与分段回滚

蓝绿部署维护两个全量环境(blue/green),切换流量时先将少量流量导向 green 并观测指标;若失败则直接回到 blue。分段回滚允许按设备组或场景回滚,减少总体中断。回滚决策应记录触发证据与回滚时间点以便后续 RCA。

三、增量修复策略与数学验证

增量修复指在回滚之外,通过最小改动逐步修正导致失败的原因,目标是快速恢复性能同时保持安全。

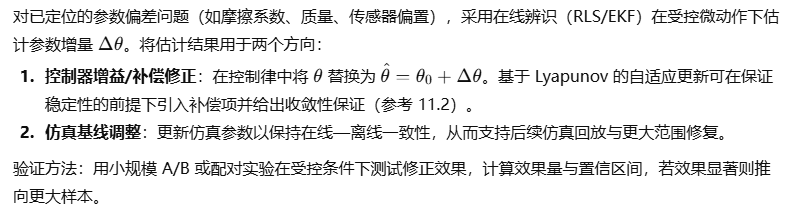
(一)参数再识别与增量校正
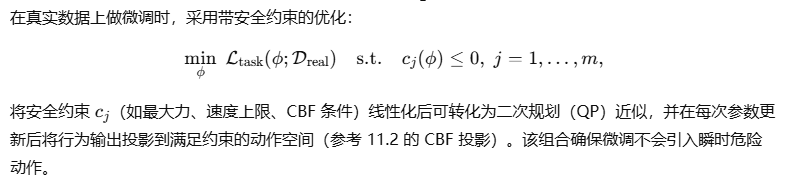
(二)安全约束下的策略微调(Constrained Fine-tuning)
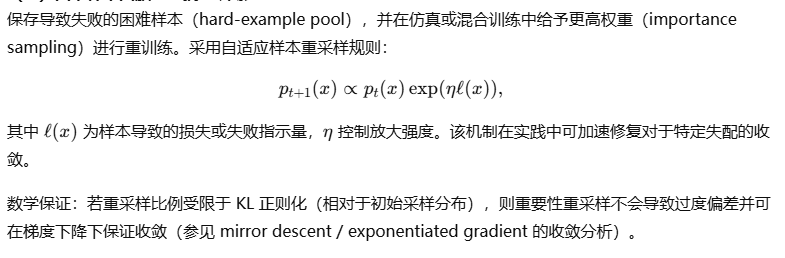
(三)困难样本回放与对抗重训练
四、自动化流程伪码


monitor_loop():
  while running:
    collect metrics batch M
    if detect_change(M):                       # CUSUM/EWMA/MMD
      alert RCA_pipeline with recent logs
      snapshot ← latest_stable_snapshot()
      run_canary(snapshot)                     # 小规模回放/仿真验证
      if canary_fails:
        rollback_to(snapshot)                  # Canary 回滚(atomic)
        start_incremental_repair(M)
      else:
        if auto_repair_enabled:
          delta = diagnose_and_estimate(M)    # RLS/EKF/GLM 估计偏差
          apply_patch(delta) with safety_QP
          validate_patch()
          if validate_success:
            promote_patch()
          else:
            rollback_to(snapshot)
    sleep(interval)

五、可视化与审计记录

每次检测—回滚—修复事件应生成审计条目,包括触发阈值、检测统计量、回滚时刻、修复动作与验证结果。为便于后续学习与工程改进,应将困难样本、RCA 报告与修复脚本纳入版本控制并与场景/快照建立血缘关系。


小结

迁移失败诊断与恢复流程以严谨的统计判定、结构化的根因分析、自动化的检测机制与原子化的回滚/修复操作为核心。理论工具包括假设检验、累积和检测(CUSUM)、分布距离 MMD/Wasserstein、多元残差分析(SVD)、因果回归与 FMEA 风险量表;工程手段涵盖日志 schema 设计、Canary/Blue–Green 部署、检查点事务性回滚、在线辨识与受约束微调、困难样本回放与对抗重训练。该流程在保证安全性的同时通过增量化修复最小化业务中断,并通过可追溯审计为长期仿真—现实一致性改进建立闭环证据链。

从PID控制到仿真环境:开发者入门具身智能技术栈实战指南 具身智能(Embodied AI)作为一种强调智能体通过物理身体与环境交互来学习决策的研究范式,其核心在于实现感知与行动的闭环。从技术原理上看,它融合了机器人学、控制理论、计算机视觉与强化学习等多领域知识,通过仿真环境(如MuJoCo)构建虚拟训练场,为算法验证和系统迭代提供了安全高效的平台。在工程实践中,开发者常从经典控制算法(如PID控制器)入手,理解状态观测、动作执行与奖励反馈的交互循环,进而逐步深入到基于强化学习的策略优化和视觉语言模型(VLM)的高层规划。这种从仿真到实物的技术路径,正推动着人形机 阅读详情

相关推荐

面向逻辑思维的程序设计方法——如何设计一双灵巧的手

本文提出基于LOPD七层模型的灵巧手系统设计方法,聚焦基因层(材料与模板)、肢体层(运动控制)、感觉层(触觉感知)和神经层(AI学习)四个核心层级。基因层构建了金属刚性、塑料柔性和DNA仿生三类材料谱系;肢体层设计了电机、液压、肌肉和磁动力四种驱动方案及动作原语系统;感觉层实现多模态触觉融合与容错机制;神经层建立手部控制网络与学习优化框架。通过分层解耦与标准化接口,系统解决了传统灵巧手设计中的跨学科耦合难题,并以国产金属灵巧手为例验证了工程可行性。 关键词:灵巧手;分层设计;材料谱系;动作原语;触觉感知;神

peakk918的博客 471

什么是域随机化(Domain Randomization)

通过在仿真环境中随机化各种因素,模型能够学会在更广泛的场景下执行任务,并且在现实世界中具有更好的适应性。因为在现实世界中训练机器人可能昂贵或不可行,所以可以在仿真环境中进行训练,而域随机化帮助模型在训练时不依赖于仿真环境的精确性,使得在真实环境中的适应性更强。域随机化的核心思想是通过大量随机化的模拟环境训练模型,使模型学会忽略非本质的环境变化,从而在训练时接触到尽可能多样的场景。泛化能力增强:通过在多种随机化的环境中训练,模型在应对未知的真实场景时表现更好,减少了对精确模拟环境的依赖。

x1haonan的博客 5108

从零理解域随机化:通过Isaac Lab的events.py掌握Sim-to-Real关键技术

本文深入解析域随机化技术如何通过Isaac Lab的events.py实现Sim-to-Real迁移,提升机器人策略在真实世界的鲁棒性。从刚体属性到环境条件的系统级随机化,详细介绍了工程实践中的关键参数配置与调试技巧,帮助开发者有效缩小仿真与现实的差距。

weixin_29062613的博客 263

域适应(DA)---域泛化(DG)

集成学习卷积神经网络通过激活与标签相关的显性特征来进行图像分类。当训练和测试数据处于类似的分布时,它们的主导功能类似,导致不错的测试性能。尽管如此,在用不同的分布测

专业主义 1万+

YOLOv11的域随机化(Domain Randomization)-(极端随机化模拟未知环境)

摘要 域随机化(Domain Randomization, DR)是一种通过在高度多样化的模拟环境中训练机器学习模型来增强其现实世界泛化能力的技术。YOLOv11在传统DR基础上进行了创新性改进: 理论创新:提出分层随机化策略(基础层、结构层、环境层、任务层)和对抗性随机化方法,通过识别模型薄弱环节针对性强化训练。 架构设计:构建模块化DR系统,包含参数空间定义、随机采样引擎、场景生成器等核心组件,实现从3D场景构建到2D渲染的完整流程。 参数扩展:设计包含6大类30+参数的扩展空间,支持极端条件模拟(如飓

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 472

active-domainrand:用于主动域随机化的代码库(CoRL 2019,https

主动域随机化 (ADR) 是一种用于改进机器人强化学习策略的零样本转移的新方法。 基于对随机空间进行统一采样的传统域随机化,我们表明,用对困难 MDP 实例的主动搜索代替它可以提高结果策略的泛化性和鲁棒性。 下面是我们重现论文中实验的代码。 如果您对并行进行域随机化的简单方法感兴趣,请查看我们的存储库。 实验 基线实验 纯基线 这里最重要的标志是--initial-svpg-steps=1e6 ,这将确保在达到该步数限制之前只建议随机环境(它永远不会)。 环境名称 ( randomized-env-id ) 处理随机化范围 - LunarLanderDefault-v0具有单值范围,因此randomize()调用将始终产生相同的默认环境。 同样, LunarLanderRandomized-v0具有完整的随机化范围(在一维中)。 在命令行上,从[lunar|pusher|ergo]指定

从虚拟到现实:利用熵最大化实现领域随机化

在强化学习(Reinforcement Learning, RL)领域,域随机化(Domain Randomization, DR)已成为缩小模拟环境与现实世界之间差距的重要方法。然而,传统的域随机化方法在选择动态参数的采样分布时常常面临挑战。过高的随机化可能导致过于保守的策略,而过低的随机化则可能导致政策无法泛化。本文将探讨一种新颖的方法——基于熵最大化的领域随机化(DORAEMON),它通过自动调整动态分布来提升策略的适应性和泛化能力。

步子哥的博客 1240

domrand:复制用于将深层神经网络从仿真转移到现实世界的域随机化结果https

模拟到真实的再现域随机化 再现 介绍 该存储库包含我在域随机化设置中的实现,用于在仿真中训练对象本地化模型以适应现实世界。 我将其作为一个较大的研究项目的一部分进行了实施,并决定将其发布,以防其他人发现它有用。 我使用KUKA LBR4臂(),而不是OpenAI初始域随机化工作中使用的Fetch机器人。 我证明,通过纯模拟训练的模型,我在现实世界中能够获得平均3.7cm的准确度。 我怀疑我可以通过对现实世界进行更好的校准并随机化视觉相关的一些方面来提高此精度,使其与原始论文中报告的1.5厘米相提并论。 但是我认为结果足以显示其效果,并且对于我正在使用的较大桌子(位置范围较大),3.7cm还是很不错的。 目录 结果 训练 我随机化纹理,光照,相机位置和方向(略微围绕现实世界),并训练模型以预测立方体XYZ坐标(具有固定高度,因此Z始终与本文相同)。 训练图像示例

干货 | 浅谈机器人强化学习--从仿真到真机迁移

“对于机器人的运动控制,强化学习是广受关注的方法。本期技术干货,我们邀请到了小米工程师——刘天林,为大家介绍机器人(以足式机器人为主)强化学习中的sim-to-real问题及一些主流方法。”一、前言设计并制造可以灵活运动的足式机器人,一直是工程师追逐的梦想。相比于轮式机器人,足式机器人凭借其腿部结构优势可以在离散非连续的路面行走。近年来,足式机器人技术发展迅速,涌现出了许多先进的足式机器人,如波士...

小米云技术 1万+

contrastive-domain-randomization:对比域随机化

对比域随机化

Petalinux实战:3种方法调试AXI UART Lite设备(含minicom/screen/直接寄存器操作对比)

本文详细介绍了在Zynq平台上使用Petalinux调试AXI UART Lite设备的三种实用方法:用户空间工具(minicom/screen)、应用层程序(termios配置)和底层寄存器直接操作。文章对比了各方法的优缺点与适用场景,并重点解析了设备树配置、驱动加载等关键环节,帮助开发者快速定位并解决串口通信中的常见问题。

weixin_29190169的博客 434

7天掌握具身智能:解锁机器人感知与决策的完整技术栈终极指南

Embodied-AI-Guide是一个系统化、百科全书式的具身智能技术指南,为技术爱好者和实践者提供从基础理论到实战应用的完整学习路径。这份由Lumina具身智能社区维护的开源项目,通过精心设计的7天学习方案,帮助开发者高效建立具身智能技术认知体系,掌握机器人感知、决策与控制的完整技术栈。 ## 具身智能的技术哲学:从虚拟到物理的智能跃迁 具身智能代表着人工智能从虚拟世界向物理世界的深刻跃迁

gitblog_00331的博客 412

保姆级避坑指南:在openEuler 22.03 LTS上用kubeadm 1.32.2部署K8s集群(含阿里云镜像加速)

本文提供在openEuler 22.03 LTS上使用kubeadm 1.32.2部署Kubernetes集群的详细指南,涵盖系统准备、容器运行时适配、kubeadm配置及集群初始化等关键步骤。特别针对openEuler系统的特殊性,解决软件源配置、cri-dockerd编译安装、阿里云镜像加速等常见问题,帮助用户高效完成K8s集群部署。

weixin_28312391的博客 274

机器人数据采集方案如何搭建?从 LeRobot 到移动操作机器人的完整实践

本文立足LeRobot最新版本技术特性、全球开发者通用落地经验,结合松灵机器人(AgileX Robotics)RANGER系列具身智能移动底盘、原生适配开源生态的具身智能数据采集解决方案,完整拆解标准化搭建流程、软硬件选型清单与落地避坑要点,为科研教学、算法研发、具身智能项目落地提供可直接复用的工程化参考。

松灵技术生态中心 1146

抖音用户评论和ID的采集方法

随着5G时代的普及,各大运营商的套餐纷纷推出,使得流量成本进一步降低。同时5G线路高宽带、低延迟的技术特性和手机普及,让视频用户访问量快速增加。 由于大量的视频工具和拍摄APP的提供,让短视频的拍摄、制作包括发行都变得更加简单便捷,越来越多的普通人可以投入视频创作,创造了更丰富的互联网内容,视频作者从视频推广中能获取粉丝和推广收益。 目前抖音就是目前最重要的短视频平台之一,要及时获取上面的用户评论和ID,需要结合爬虫代理实现采集方案,下面的代码就能快速采集相关信息: package htmlunit; i

ssbt_2020的博客 6793

手把手教你:基于STM32H7自制飞控,如何从零开始移植PX4固件(附避坑指南)

本文详细介绍了如何基于STM32H7自制飞控板并移植PX4固件的完整流程,包括硬件设计、开发环境搭建、关键配置文件移植、驱动开发与适配等关键步骤。特别针对PX4-AutoPilot的移植过程提供了实用技巧和避坑指南,帮助开发者高效完成飞控系统开发。

weixin_30271335的博客 145

工业具身智能落地的核心:从算法到工程化系统底座

在机器人技术与人工智能融合的领域,感知、决策与执行的协同是实现自主作业的基础。其核心原理在于构建一个统一的多模态感知与标准化技能框架,将视觉、力觉等传感信息与运动规划、控制指令深度融合。这一技术架构的工程价值在于,它能将前沿算法转化为稳定、可复用的工业能力,从而有效应对非结构化环境与长链条任务带来的挑战。具体到工业制造场景,如视觉引导的杂乱抓取与精密装配,这种底座能力通过抽象硬件差异、封装工艺知识,并融合仿真与数据闭环,使得智能系统能像熟练工人一样灵活适应产线变化,最终实现从实验室Demo到规模化可靠部署的

weixin_33847182的博客 367

倾向得分匹配的stata命令_政策评估方法引荐|广义倾向得分匹配(GPSM)

和大家分享一下最近学习的进展,在痛苦读完stata journal和练习OA程序,已经可以基本完成广义倾向得分的估计了,在国内这一方法还没有形成广泛运用,因此学习资源也是有点稀缺的,在文章最后给各位提供数据和代码以供练习。有问题可以随时文末留言或者联系我哦。人文社会科学中一般无法在实验室中控制样本个体的特征,我们一般采用“准自然实验”的研究路径,也就是不随机安排样本接受处理与否。但放弃随机分组假定...

weixin_39550258的博客 1万+

具身智能学习路径:从感知决策到运动控制的完整实战指南

具身智能是人工智能从数字空间走向物理世界的关键形态,它要求系统在真实环境中完成感知、决策与控制的一体化闭环。与纯数据驱动的大模型不同,机器人不仅需要识别物体,更要在噪声、延迟和不确定性中输出稳定动作。深度学习和强化学习为策略优化提供了工具,但工程化落地依赖对坐标变换、状态估计、PID控制等基础原理的扎实掌握。从仿真环境到实体硬件,领域随机化与系统辨识是弥合虚实鸿沟的有效手段。该技术广泛应用于工业视觉抓取、自主导航与柔性装配等场景,开发者可参照一套为期六个月的循序渐进路径,构建可验证的最小闭环系统,逐步成长为

weixin_29062255的博客 331

如何使用VNC对openEuler系统进行远程图形化操作

本文详细介绍了在openEuler系统中配置VNC远程图形化操作的方法。主要内容包括:1)服务端配置:安装GNOME图形界面和TigerVNC服务,创建VNC用户并设置密码,配置VNC服务启动脚本;2)客户端连接:使用VNC Viewer等工具连接服务器;3)常见问题解决方法。通过5901端口建立连接后,用户可远程操作openEuler图形界面,适用于需要图形化管理的场景。

2501_93651177的博客 316

GEE:本地影像上传到GEE的Assets中,并输入机器学习算法中作为特征变量

当我们在 Google Earth Engine(GEE)中应用机器学习算法时,会输入一些影像作为特征变量数据,进一步根据这些特征影像去推理未知区域的数据。但是 GEE 平台上计算特征变量的 API 函数并不是非常全面,我们希望获得更多的特征用于分类。这个时候,我们可以将本地计算的特征影像上传到 GEE 中进行后续处理。本文记录了从本地上传特征数据到 GEE 的 Assets 中的教程,用于后续在 GEE 中分类或者回归使用。本文也可作为《》一文的补充。

养乐多的博客 1733

【论文】Data-efficient Domain Randomization with Bayesian Optimization

基于域随机化的强化学习定义: 主要增加了一个域参数分布,它决定了动力学模型的概率转移函数P。 在某个确定的参数组合下,也就是生成一个特定的MDPs,此时的优化目标是在这个参数组合下的最大累积奖赏: 本文提出的贝叶斯域随机化(BayRn),优化目标可以写成上下两层公式: 这个目标方程怎么理解呢? 首先看下层,这是一个标准的域随机化强化学习过程,通俗来说就是给定一个域参数分布 fai,从中采样形成多个MDPs(这是用采样近似期望),然后在每个MDPs中训练Agent,期望学到一个策略,能够最大化所有MD.

qq_41614419的博客 725

Sigrity Power Tree如何进行直流压降仿真分析操作指导

Sigrity Power Tree模式可以用于前仿真,在没有layout文件的情况下对电源进行直流压降仿真分析,用于评估原理图设计以及器件选型是否合理。Model:设置为Equal Current,设置为等电源模型,意思该负载每个电源pin都是等电流的。Current:设置每个负载的电流,U30为3A,U3-U6各为1A。Nominal Current:设置能够承载的最大电流,设置为10A。Upper/ Lower Tol:设置为压降范围为5%Output Current:设置输出电流为10A。

weixin_54787054的博客 733

ECCV 2022 | 面向高光和透明物体感知与抓取的域随机化增强的深度仿真与修复

关键词:深度仿真 深度修复 高光透明物体导 读本文是计算机视觉顶级会议 ECCV 2022入选论文Domain Randomization-Enhanced Depth Simulation and Restoration for Perceiving and Grasping Specular and Transparent Objects的解读。该论文由北京大学王鹤课题组与阿里巴巴 XR...

Paper weekly 1295

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

元学习—Meta Learning的兴起

来源:专知【导读】元学习描述了训练深度神经网络相关的更高级别的元素。在深度学习文献中,“元学习”一词经常表示神经网络架构的自动化设计,经常引用“AutoML”,“少量学...

人工智能学家 1242

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

论文阅读笔记:Domain Randomization for Active Pose Estimation

摘要 本文主要提出一种基于域随机化的姿态估计方法。 通过训练神经网络,直接从环境的2D图像中预测机器人的姿态。关于提高基于域随机化的姿态估计的准确性,文章提出主动感知(active perception)方法:移动机器人以获得更好的姿态估计,在模拟环境中进行训练,用域随机化将其转化为现实。 介绍 本文为了提高基于域随机化的姿态估计的准确性,对环境进行一些已知的几何变换,如移动环境中的物体,移动机器人手臂或干扰物、改变相机角度等。同时提出主动姿态估计方法:从不同角度和不同位置看一个物体,从而获得更准确、更稳健

weixin_38886470的博客 863

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上一篇: 机器人技术与智能系统的工程化与应用 第九章 双手与复杂对象操控,第十章 高吞吐仿真与并行训练架构
下一篇: 【图神经网络:原理与实战】 1 图与矩阵表示
VectorShift
博客等级 码龄1年 1844粉丝 1109原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

VectorShift

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值