


文章目录
1. 什么是Langchain
Langchain核心概念与工作流程:用户提问——>Prompt格式化——>Agent思考——>调用Tool/Model生成——>返回用户
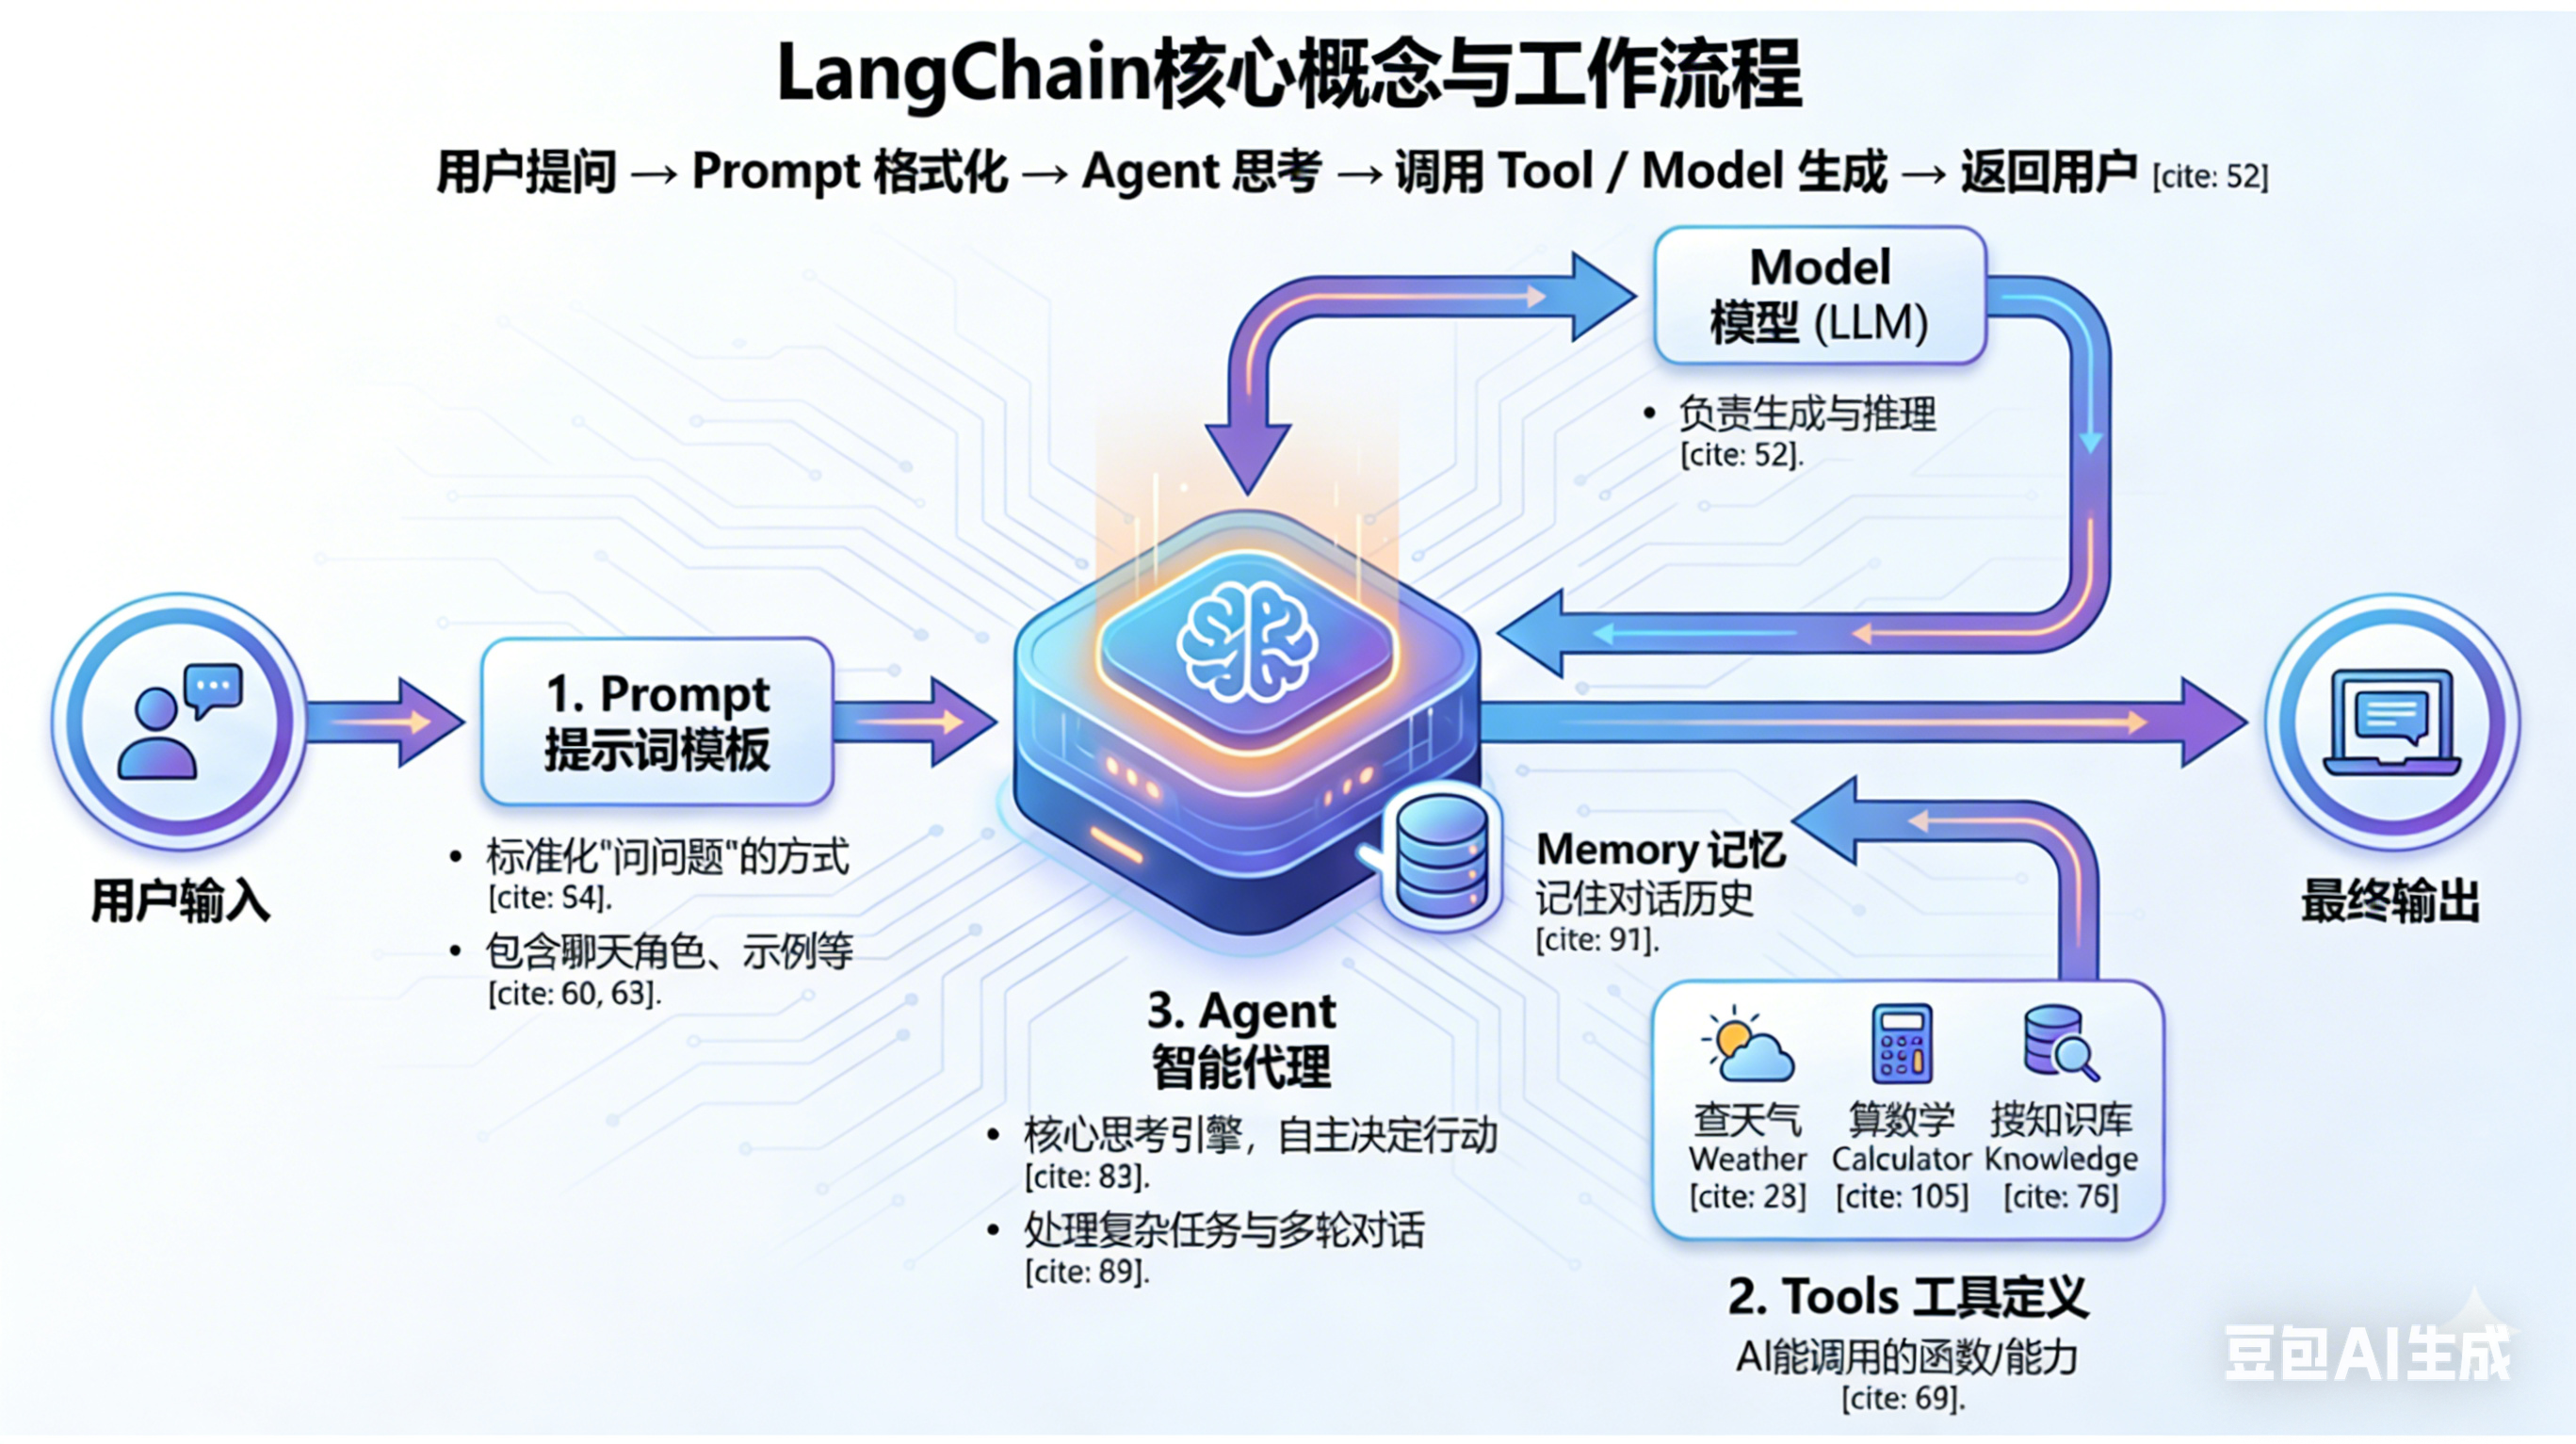
什么是Langchain框架?(连接大模型与世界的桥梁)

2. 环境搭建
安装依赖
# 创建虚拟环境(推荐)
python -m venv langchain_env
# 激活虚拟环境
source langchain_env/bin/activate  # Mac/Linux
# langchain_env\Scripts\activate   # Windows

# 安装 LangChain 核心包
pip install langchain langchain-core langchain-community

# 根据你用的模型安装对应包
pip install langchain-openai       # OpenAI
pip install langchain-anthropic    # Claude
pip install dashscope              # 通义千问

# 其他常用包
pip install python-dotenv          # 环境变量管理
pip install langgraph             # Agent 运行时(新版必装)
配置 API Key
创建 .env 文件:
# OpenAI
OPENAI_API_KEY=sk-xxx

# 或者通义千问
DASHSCOPE_API_KEY=sk-xxx

# Claude
ANTHROPIC_API_KEY=sk-xxx
验证安装
from dotenv import load_dotenv
import os

load_dotenv()

from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)

response = llm.invoke("你好,请用一句话介绍自己")
print(response.content)
3. 核心概念速览

- Model:大脑
- Prompt:提示词模板,问题格式
- Tool:外部工具
- Agent:智能代理,管家
关系是这样的:
用户提问 → Prompt 格式化 → Agent 思考 → 调用 Tool → Model 生成回答 → 返回用户
4. Prompt 提示词模板
提示词模板就是把"问问题"这件事标准化。不用每次都手写完整的提示词。

最简单的模板
from langchain_core.prompts import PromptTemplate

# 定义模板,用 {} 占位
template = PromptTemplate.from_template(
    "请用{language}语言介绍一下{topic},不超过100字。"
)

# 填充变量
prompt = template.format(language="中文", topic="人工智能")
print(prompt)
# 输出: 请用中文语言介绍一下人工智能,不超过100字。
聊天模板
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI

load_dotenv()


# 定义多轮对话模板
chat_template = ChatPromptTemplate.from_messages([
    ("system", "你是一位{role},擅长用简洁易懂的方式解释复杂概念。"),
    ("human", "请解释一下:{concept}"),
])

# 生成消息列表
messages = chat_template.format_messages(
    role="物理学教授",
    concept="量子纠缠"
)

# 创建模型
llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)


# 调用模型
response = llm.invoke(messages)
print(response.content)
## 打印结果:
# 想象你有两只手套,一左一右。
# 你把它们分别装进两个盒子,不打开看,然后随机寄给地球两端的两个人。

# 当其中一人打开盒子,看到是左手套的瞬间,他就**立刻知道**另一人收到的是右手套——无论距离多远。

# ---

# **量子纠缠**的核心就是这种“瞬间知晓”,但更奇妙:

# 1. **没有事先决定**
#    在量子世界里,两个纠缠粒子(比如光子)在分开前并没有“预先分配”好状态(不像手套已经固定是左或右)。
#    它们处于一种“叠加态”,可以理解为“既是左手套又是右手套”的模糊状态,直到被观测。

# 2. **观测才确定**
#    当一方测量自己的粒子时,它的状态随机坍缩成某种结果(比如“自旋向上”),而另一个粒子会**瞬间**变成与之对应的状态(“自旋向下”)。

# 3. **看似超光速,但不传递信息**
#    这种关联变化是瞬时的,但另一方无法控制自己粒子的结果(因为随机),所以无法用它来传递消息,不违背相对论。

# ---

# **打个比方**:
# 你和朋友各拿一个纠缠粒子,约定好:如果测出自旋向上,就代表“是”,向下代表“否”。
# 但你们测量前不知道会得到什么,测完后结果随机,对方虽然瞬间得到相反结果,却无法用它发送你想要的“是”或“否”。

# 所以,量子纠缠是一种**强关联**,而非“超光速通信”。
# 它在量子计算、量子加密等领域有重要应用,因为这种关联可以用来实现密钥分发或并行计算。
示例模板
通过给几个例子,教 AI 按你想要的格式输出:
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI

load_dotenv()

# 创建模型
llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)

# 创建包含示例的模板
few_shot_template = ChatPromptTemplate.from_messages([
    ("system", "你是一个情绪表达助手。"),
    ("human", "示例:\n情绪: 开心\n表达: 我今天非常开心!\n\n情绪: 难过\n表达: 我感到有些难过..."),
    ("human", "现在请表达这个情绪: {emotion}")
])

messages = few_shot_template.format_messages(emotion="兴奋")
response = llm.invoke(messages)
print(response.content)
# 情绪: 兴奋
# 表达: 我兴奋得快要跳起来了!
动态日期模板
有些变量想自动填充(比如当前日期):
from langchain_core.prompts import PromptTemplate
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI
from datetime import datetime

load_dotenv()

# 创建模型
llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)

template = PromptTemplate(
    template="今天是{date},请告诉我关于{topic}的最新消息。",
    input_variables=["topic"],
    partial_variables={
        "date": datetime.now().strftime("%Y年%m月%d日")  # 自动填充
    }
)

# 只需要传 topic
prompt = template.format(topic="AI发展")

response = llm.invoke(prompt)
print(response.content)
# 由于今天是2026年3月2日,我需要说明:**我无法提供真实的实时信息或未来事件**,因为我的知识截止于2024年7月,且无法访问最新数据。不过,我可以基于当前趋势推测2026年AI领域可能关注的焦点,并建议你通过以下方式获取真实信息:

# ---

# ### **2026年AI领域可能的发展方向(基于趋势推测)**
# 1. **通用人工智能(AGI)的进展**
#    - 科技公司(如OpenAI、DeepMind等)可能发布更接近AGI的模型,在多模态理解、复杂推理方面取得突破。

# 2. **AI与科学研究的深度融合**
#    - AI可能加速生物医药(蛋白质设计、药物发现)、气候模拟、材料科学等领域的突破,例如AI辅助的癌症治疗方案或核聚变控制优化。

# 3. **AI监管与全球治理**
#    - 各国可能推出更具体的AI法规(如欧盟《AI法案》全面实施),针对高风险AI系统制定强制性安全标准。

# 4. **具身智能与机器人技术**
#    - 结合大模型的机器人可能更广泛地应用于家庭服务、制造业,实现更自然的人机交互。

# 5. **AI伦理与安全挑战**
#    - 深度伪造检测、AI偏见治理、自主武器系统争议等问题可能成为国际议题。

# 6. **边缘AI与个性化应用**
#    - 轻量化AI模型可能嵌入更多日常设备(如手机、汽车),提供实时个性化服务,同时注重隐私保护。

# ---

# ### **如何获取真实的最新信息?**
# - **权威媒体**:关注《自然》《科学》期刊的AI专栏,或科技媒体(如MIT Technology Review, Wired)。
# - **学术会议**:查看2026年NeurIPS、ICLR等顶级AI会议的论文发布。
# - **企业动态**:关注OpenAI、Google DeepMind、Anthropic等公司的官方公告。

# ---

# 如需了解截至2024年的AI进展,我可以为你详细总结。请告诉我你的具体兴趣领域!
5. Tools工具定义
工具就是让 AI 能调用的函数。定义好工具后,AI 会自己决定什么时候用、怎么用。
重点:docstring 写清楚! AI 就是靠这个描述来决定什么时候调用这个工具。
用装饰器定义(最简单)
from langchain_core.tools import tool

@tool
def get_weather(city: str) -> str:
    """
    获取城市的天气信息

    Args:
        city: 城市名称,如"北京"、"上海"
    """
    # 模拟天气数据(实际项目中调用天气 API)
    weather_data = {
        "北京": "晴天,25°C",
        "上海": "多云,22°C",
        "深圳": "小雨,28°C",
    }
    return weather_data.get(city, f"{city}的天气暂时无法获取")


# 测试工具
result = get_weather.invoke({"city": "北京"})
print(result)  # 输出: 晴天,25°C

# 查看工具信息
print(f"工具名称: {get_weather.name}")
print(f"工具描述: {get_weather.description}")
print(f"参数结构: {get_weather.args}")
把工具绑定到模型
from langchain_core.tools import tool
from langchain_core.prompts import PromptTemplate
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI
from datetime import datetime

load_dotenv()

# 创建模型
llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)


@tool
def get_weather(city: str) -> str:
    """
    获取城市的天气信息

    Args:
        city: 城市名称,如"北京"、"上海"
    """
    # 模拟天气数据(实际项目中调用天气 API)
    weather_data = {
        "北京": "晴天,25°C",
        "上海": "多云,22°C",
        "深圳": "小雨,28°C",
    }
    return weather_data.get(city, f"{city}的天气暂时无法获取")


# 创建工具列表
tools = [get_weather]

# 绑定到模型
llm_with_tools = llm.bind_tools(tools)

# 现在模型知道有这些工具可用了
response = llm_with_tools.invoke("北京今天天气如何?")

# 检查模型是否决定调用工具
if response.tool_calls:
    for tool_call in response.tool_calls:
        print(f"模型想调用: {tool_call['name']}")
        print(f"传入参数: {tool_call['args']}")
6. Agent智能代理
Agent 是 LangChain 最酷的部分。它不是按固定流程执行,而是自己思考、自己决定该干啥。

LangChain 1.0+ 新版 Agent
新版用 create_agent,底层基于 LangGraph,更稳定:
from langchain.agents import create_agent
from langchain_core.tools import tool
from langchain_community.chat_models import ChatTongyi
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI

load_dotenv()

# 1. 创建模型
llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)

# 2. 定义工具
@tool
def get_weather(city: str) -> str:
    """获取城市天气信息"""
    weather_db = {
        "北京": "晴天,15-25度",
        "上海": "多云,18-28度",
        "深圳": "小雨,20-30度",
    }
    return weather_db.get(city, f"{city}的天气信息暂不可用")

@tool
def calculator(expression: str) -> str:
    """执行数学计算"""
    try:
        result = eval(expression)
        return f"计算结果: {expression} = {result}"
    except:
        return "计算错误"

@tool
def search_knowledge(query: str) -> str:
    """搜索知识库"""
    knowledge = {
        "LangChain": "LangChain是一个用于开发LLM应用的框架,支持工具、代理、内存管理等功能。",
        "机器学习": "机器学习是AI的子集,让系统能从数据中自动学习和改进。",
    }
    for key, value in knowledge.items():
        if key in query:
            return value
    return f"未找到关于'{query}'的信息"

# 3. 创建 Agent
agent = create_agent(
    model=llm,
    tools=[get_weather, calculator, search_knowledge],
    system_prompt="你是一个专业的中文助手。仔细分析用户问题,选择合适的工具来回答。",
    recursion_limit=10  # 最多10步
)

# 4. 使用 Agent
result = agent.invoke({
    "messages": [{"role": "user", "content": "北京今天天气怎么样?"}]
})

# 获取回答
final_message = result["messages"][-1]
print(f"回答: {final_message.content}")
Agent 处理多个问题
test_queries = [
    "北京今天天气怎么样?",
    "给我讲讲什么是机器学习",
    "计算 123 * 456",
]

for query in test_queries:
    print(f"\n用户: {query}")

    result = agent.invoke({
        "messages": [{"role": "user", "content": query}]
    })

    final_message = result["messages"][-1]
    print(f"助手: {final_message.content}")
带记忆的 Agent
from langchain.agents import create_agent
from langchain_core.tools import tool
from langchain_community.chat_models import ChatTongyi
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langgraph.checkpoint.memory import MemorySaver

load_dotenv()

# 创建模型
llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://api.deepseek.com"
)

# 定义工具
@tool
def get_weather(city: str) -> str:
    """获取城市天气信息"""
    weather_db = {
        "北京": "晴天,15-25度",
        "上海": "多云,18-28度",
        "深圳": "小雨,20-30度",
    }
    return weather_db.get(city, f"{city}的天气信息暂不可用")

@tool
def calculator(expression: str) -> str:
    """执行数学计算"""
    try:
        result = eval(expression)
        return f"计算结果: {expression} = {result}"
    except:
        return "计算错误"

@tool
def search_knowledge(query: str) -> str:
    """搜索知识库"""
    knowledge = {
        "LangChain": "LangChain是一个用于开发LLM应用的框架,支持工具、代理、内存管理等功能。",
        "机器学习": "机器学习是AI的子集,让系统能从数据中自动学习和改进。",
    }
    for key, value in knowledge.items():
        if key in query:
            return value
    return f"未找到关于'{query}'的信息"

from langgraph.checkpoint.memory import MemorySaver

# 创建记忆存储
checkpointer = MemorySaver()

# 创建带记忆的 Agent
agent = create_agent(
    model=llm,
    tools=[get_weather, calculator, search_knowledge],
    system_prompt="你是一个专业助手,能记住之前的对话。",
    checkpointer=checkpointer  # 启用记忆
)

# 会话配置(同一个 thread_id 共享记忆)
config = {"configurable": {"thread_id": "session_001"}}

# 第一轮对话
result1 = agent.invoke(
    {"messages": [{"role": "user", "content": "我叫小明"}]},
    config
)
print(result1["messages"][-1].content)

# 第二轮对话(Agent 会记得用户叫小明)
result2 = agent.invoke(
    {"messages": [{"role": "user", "content": "我叫什么名字?"}]},
    config
)
print(result2["messages"][-1].content)  # 会回答"小明"
流式输出
让回答一个字一个字输出,体验更好:
# 流式调用
for chunk in agent.stream(
    {"messages": [{"role": "user", "content": "北京天气如何?"}]},
    config,
    stream_mode="values"
):
    messages = chunk.get("messages")
    if messages:
        last_message = messages[-1]
        if hasattr(last_message, "content") and last_message.content:
            print(last_message.content, end="", flush=True)
print()  # 换行
7. 一些注意事项
工具描述要写好
AI 完全靠工具的 description 来决定什么时候调用。写得不清楚,它就不会用。
坏例子:
@tool
def func(x: str) -> str:
    """处理数据"""  # 太模糊了!
    pass
好例子:
@tool
def get_stock_price(symbol: str) -> str:
    """
    获取股票实时价格

    当用户询问某只股票的价格、涨跌情况时使用此工具。

    Args:
        symbol: 股票代码,如 "AAPL"(苹果)、"GOOGL"(谷歌)

    Returns:
        包含当前价格、涨跌幅的字符串
    """
    pass
错误处理要完善
工具可能会失败(网络错误、参数错误等),一定要有兜底:
@tool
def fetch_data(url: str) -> str:
    """从URL获取数据"""
    try:
        response = requests.get(url, timeout=10)
        response.raise_for_status()
        return response.text
    except requests.Timeout:
        return "请求超时,请稍后重试"
    except requests.RequestException as e:
        return f"请求失败:{str(e)}"
    except Exception as e:
        return f"未知错误:{str(e)}"
调整温度参数
- temperature=0:输出最确定,适合事实查询
- temperature=0.7:有一定创意,适合对话
- temperature=1.0:输出多样,适合创作
使用 LangSmith 调试
遇到奇怪问题时,用 LangSmith 看看 Agent 到底在想什么:
import os

# 在代码最前面添加
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = "你的LangSmith API Key"
然后去 smith.langchain.com 就能看到每一步的详细 trace。
控制迭代次数
防止 Agent 陷入死循环:
agent = create_agent(
    model=llm,
    tools=tools,
    # 其他选项
)

# 调用时限制最大步数
result = agent.invoke(
    {"messages": [...]},
    config,
    recursion_limit=10  # 最多10步
)

 2747


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


