Encoder-Decoder架构的基石:序列到序列(Seq2Seq)架构

详解从 Seq2Seq模型、RNN结构、Encoder-Decoder模型 到 Attention模型 注:本文的所有模型只涉及自然语言处理领域,同时本文不涉及太多复杂公式推导。 一、Seq2Seq 模型 1. 简介 Sequence-to-sequence (seq2seq) 模型,顾名思义,其输入是一个序列,输出也是一个序列,例如输入是英文句子,输出则是翻译的中文。seq2seq 可以用在很多方面:机器翻译、QA 系统、文档摘要生成、Image Captioning (图片描述... 阅读详情

序列到序列(Sequence-to-Sequence,简称Seq2Seq)是一种用于处理输入序列到输出序列映射的神经网络架构,由Google团队在2014年提出(论文《Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation》)。

核心思想:将可变长度的输入序列转换为固定长度的"上下文向量",再基于该向量生成可变长度的输出序列,适用于机器翻译、文本摘要、对话系统等场景。

Seq2Seq(序列到序列)架构是自然语言处理(NLP)领域中处理不等长序列映射任务的核心基础架构,奠定了现代序列生成类任务的技术框架,在 NLP 发展历程中起到承上启下的关键作用 —— 它既突破了传统模型的局限,又成为后续顶尖预训练模型的架构雏形。

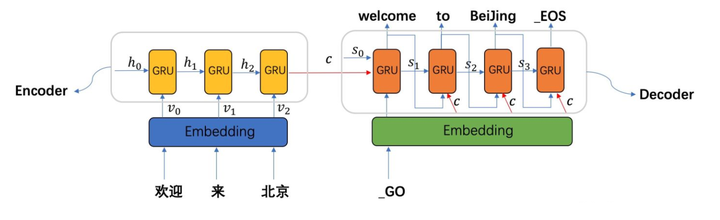
一、经典架构:编码器-解码器(Encoder-Decoder)
在这里插入图片描述

1. 编码器(Encoder)

**功能:**将输入序列(如"我爱机器学习")编码为一个固定长度的上下文向量(Context Vector),捕捉输入序列的全局信息。
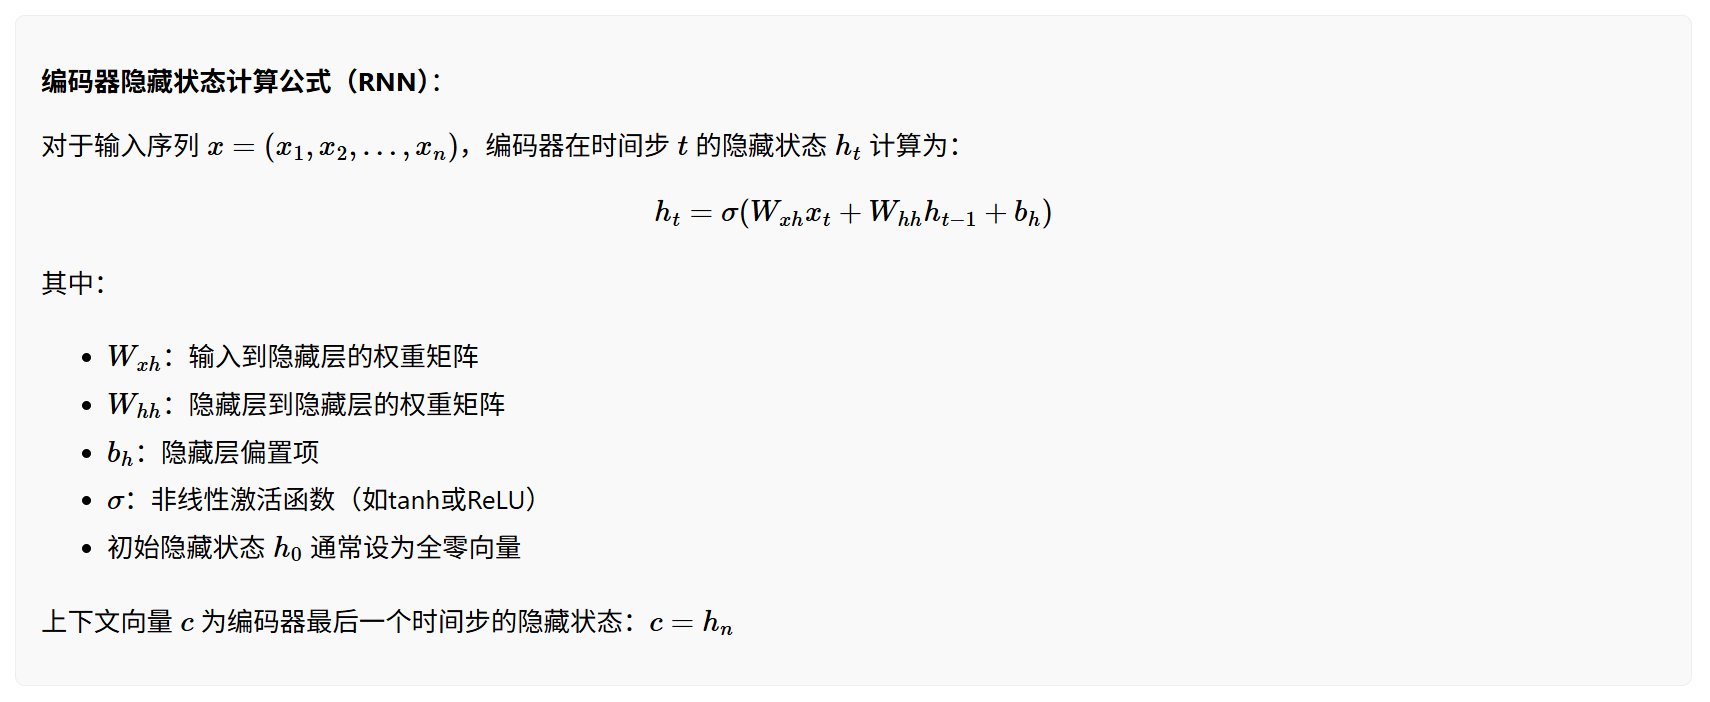
**结构:**通常采用循环神经网络(RNN)及其变体(LSTM、GRU),处理步骤如下:

输入序列按时间步依次输入编码器(如"我"→"爱"→"机器学习");
每个时间步的隐藏状态基于当前输入和上一时间步隐藏状态更新;
最终输出编码器的最后一个时间步隐藏状态作为上下文向量(代表对输入序列的"理解")。
在这里插入图片描述
在这里插入图片描述

2. 解码器(Decoder)

功能: 以编码器生成的上下文向量为初始输入,逐步生成输出序列(如"I love machine learning")。
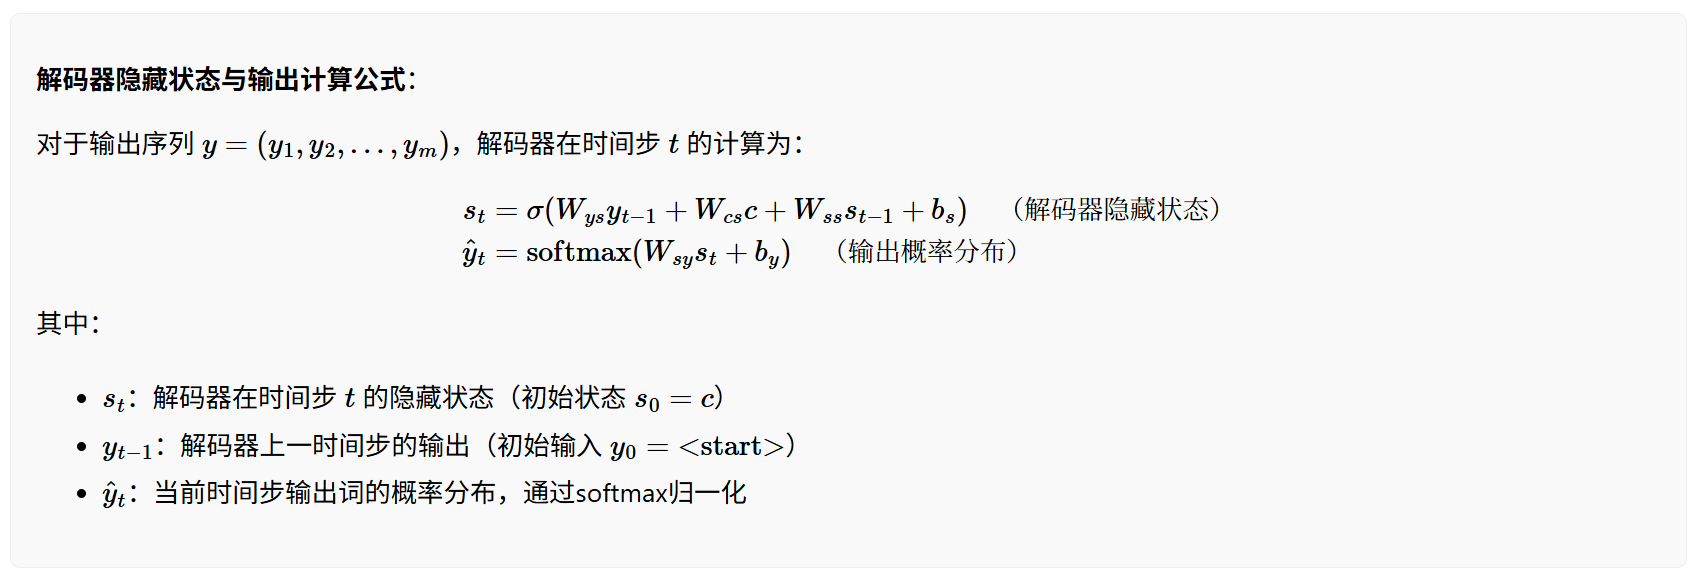
结构: 同样基于RNN/LSTM/GRU,生成步骤如下:

初始隐藏状态设为编码器输出的上下文向量;
第一个输入通常为特殊符号(如),生成第一个输出词;
将上一时间步的输出作为当前时间步的输入,结合隐藏状态更新,直到生成结束符号(如)。
在这里插入图片描述

3. 关键组件:循环神经网络变体

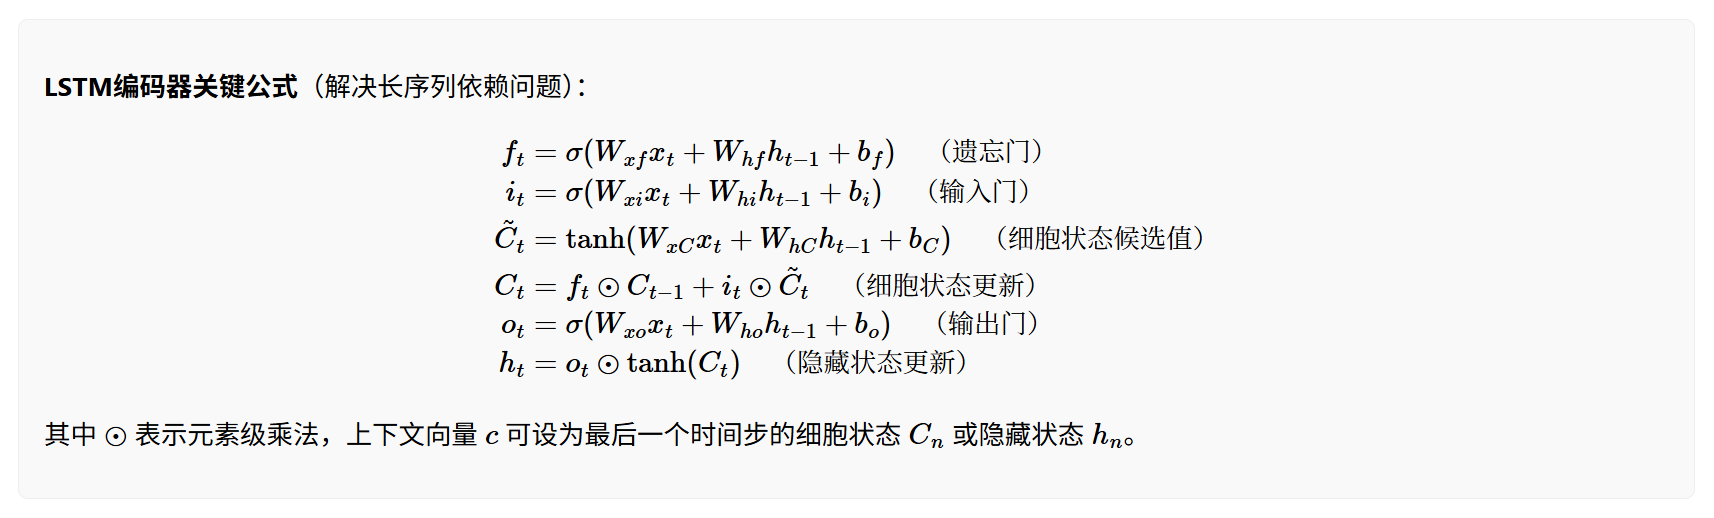
经典Seq2Seq中,编码器和解码器多采用LSTM(长短期记忆网络)或GRU(门控循环单元),解决传统RNN的"梯度消失/爆炸"问题,更好捕捉长序列依赖。
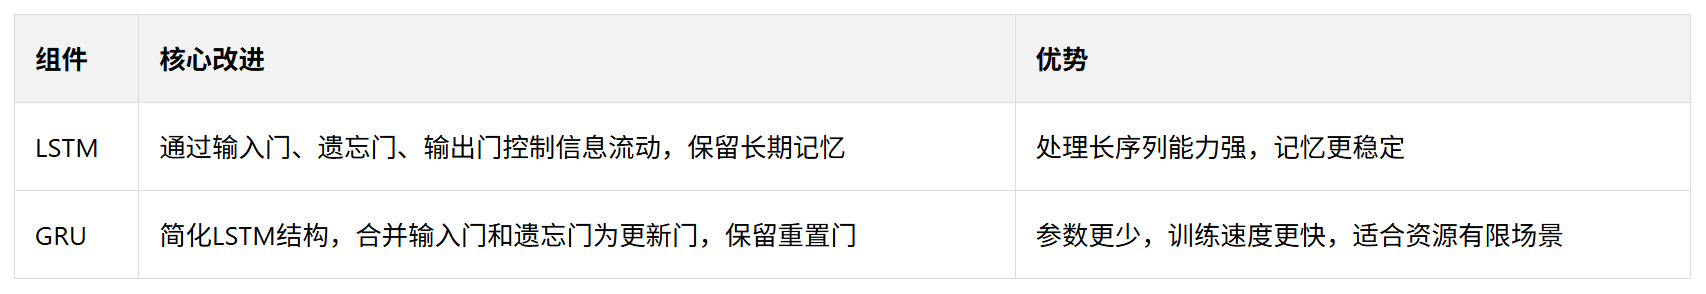
在这里插入图片描述

二、Seq2Seq的训练目标

Seq2Seq模型的训练核心就是学习编码器和解码器中的权重参数。

  • 训练目标
    Seq2Seq模型的训练目标是最大化给定输入序列 ( X ) 下输出序列 ( Y ) 的条件概率 ( P(Y|X) )。通常使用交叉熵损失函数,通过最小化预测序列与真实序列之间的差异来优化模型参数。

  • 可训练参数范围
    Seq2Seq模型的可训练参数主要包括两部分:

(1)编码器的权重参数

  • 对于RNN/LSTM/GRU编码器:
    • 输入到隐藏层的权重矩阵(如 ( W_{xh} )、( W_{xf} )、( W_{xi} ) 等)
    • 隐藏层到隐藏层的权重矩阵(如 ( W_{hh} )、( W_{hf} )、( W_{hi} ) 等)
    • 偏置项(如 ( b_h )、( b_f )、( b_i ) 等)

(2)解码器的权重参数

  • 对于RNN/LSTM/GRU解码器:
    • 输入到隐藏层的权重矩阵(如 ( W_{ys} )、( W_{cs} ) 等)
    • 隐藏层到输出层的权重矩阵(如 ( W_{sy} ))
    • 偏置项(如 ( b_s )、( b_y ) 等)

(3)如果使用注意力机制

  • 注意力评分函数中的权重矩阵(如 ( W_a )、( U_a )、( v_a ))

关键细节

  • 共享权重:在某些模型(如Transformer)中,编码器和解码器的部分层可能共享权重,但Seq2Seq经典架构中通常不共享。
  • Teacher Forcing:训练时解码器的输入通常使用真实标签(而非上一步的预测),以稳定训练。
  • 推理阶段:模型使用学习到的参数独立生成输出序列,无需真实标签。
Encoder-decoder模型及Attention机制 Seq2Seq模型及Attention机制Seq2Seq模型Attention机制 Seq2Seq模型 seq2seq模型最早可追溯到2014年的两篇paper [1, 2],主要用于机器翻译任务(MT)。seq2seq本质上是一种encoder-decoder框架,以翻译任务中的“英译汉”为例,模型首先使用编码器对英文进行编码,得到英文的向量化表示S,然后使用解码器对S进行解码,得到对应的中文。由于encoder与decoder两端处理的都是序列数据,所以被称为sequence-to-sequence,简 阅读详情

相关推荐

encoder-only / decoder-only / encoder-decoder架构分析

维度参数量低(1亿-4亿)高(十亿-万亿)中高(编码+解码双倍)训练成本低中高典型任务分类/理解生成/对话翻译/摘要2025占比<10%>80%~10%核心争议与趋势Decoder-only主导原因零样本能力与生成灵活性满足通用AI需求。工程友好:推理并行化程度高,更适合大模型部署。Encoder-Decoder潜力研究指出:同等参数量下,Encoder-Decoder在精确任务上有未释放潜力(需系统验证)。融合架构探索前缀语言模型。

成长之路 1489

seq2seq架构

输入:划分为序列的词向量输出:针对每一个词向量对应的译文从上图中可知, seq2seq模型架构, 包括两部分分别是encoder(编码器)和decoder(解码器)编码器和解码器的内部实现都使⽤了GRU模型, 这⾥它要完成的是⼀个中⽂到英⽂的翻译: 欢迎 来 北京 --> welcome to BeiJing. 编码器⾸先处理中⽂输⼊"欢迎 来 北京", 通过GRU模型获得每个时间步的输出张量,最后将它们拼接成⼀个中间语义张量c。

weixin_63685622的博客 624

【NLP】一文理解Seq2Seq

Seq2Seq技术,全称Sequence to Sequence,该技术突破了传统的固定大小输入问题框架,开通了将经典深度神经网络模型(DNNs)运用于在翻译,文本自动摘要和机器人自动问答以及一些回归预测任务上,并被证实在英语-法语翻译、英语-德语翻译以及人机短问快答的应用中有着不俗的表现。

sikh_0529的博客 1万+

序列到序列(Seq2Seq)模型概述

Seq2Seq模型,全称Sequence to Sequence模型,就如字面意思,输入一个序列,输出另一个序列。这种结构最重要的地方在于输入序列和输出序列的长度是可变的。

weixin_40280870的博客 5402

从零实现深度学习框架——Seq2Seq从理论到实战【理论】

Seq2Seq原理介绍。

日积月累,天道酬勤 1474

Seq2Seq模型

作者:禅与计算机程序设计艺术 1.简介 Seq2Seq模型是一种基于神经网络的文本生成模型,可以根据给定的输入序列生成对应的输出序列。 Seq2Seq模型分为编码器-解码器结构(Encoder-Decoder)和自回归语言模型(Autoregressive Language Modeling)两种类型。

AI天才研究院 602

Encoder-Decoder、Seq2Seq、 以及Transformer之间的关系

结论写在前面: Encoder-Decoder 是一种架构,范围非常广泛,只要是用一个编码结构一个解码结构的模型都是Encoder-Decoder 架构 seq2seq 和 Encoder-Decoder基本相同,只不过后者是一种抽象概念,前者是具体的模型,seq2seq可以看做是一种结构,有很多这种结构的模型。seq2seq有多种类型,N VS N,N vs 1, 1vs N, N vs M。最后一种应用最广。同时还有基于RNN的seq2seq,基于CNN的seq2seq,基于LSTM的seq2seq

咖乐部 6802

实战演练,如何用Easyexcel合并单元格,设置字体、边框样式,并在尾行加入备注

,实现效果如下:1、多级表头合并2、表头底纹+表格边框3、合并相同数据单元格4、尾行加入备注。

Su7148的博客 1万+

Encoder-Decoder 模型架构详解

文章目录概述Seq2Seq( Sequence-to-sequence )Encoder-Decoder的缺陷Attention 机制的引入Transformer中的Encoder-Decoder 概述 Encoder-Decoder 并不是一个具体的模型,而是一个通用的框架。 Encoder 和

Joselynzhao 3万+

Zemax操作41--公差分析(一)

zemax公差

lzy750750的博客 5973

给jetson nano 安装AX200网卡驱动

几经波折,因为在网上看到的基本都是amd版本而非arm版,然后最终选定V5.5是因为更新的几个版本的arm版本是false的(在https://kernel.ubuntu.com/~kernel-ppa/mainline/处选择版本时,得看在arm64上是false还是build succeeded,之前没经验呀刚刚才顿悟的) 1,参考文章https://blog.youkuaiyun.com/MIRANA0/article/details/106696334 学到了得下载如下四个: wget https://k

发嘎嘎的博客 2345

什么是Encoder-Decoder、Seq2Seq、Attention?

1 简介 发明时间:2014年由 [Bahdanau et al. 2014] 正式提出。 作用: Attention机制可以让神经网络更多的关注到输入中相关的信息,并减少对无关信息的注意。就像当我们看一副图,我们往往会对其中感兴趣的那部分更加注意,Attention机制也以类似的方式帮助神经网络更好的利用输入的信息。 有助于提升模型的可解释性。 1.1 Attention发明的背景 2014年, Seq2Seq模型 [Sutskever et al. 2014] 正式提出, 并以其优异的表

不精,不诚,不足以动人 4275

模拟ic入门——设计一个单极运放(一)单级运算放大器设计基础

主要介绍了单级运放的基本理论和使用场景

qq_64956710的博客 3739

Encoder-Decoder、Seq2Seq、Attention 以及Transformer之间的关系

一、Encoder-Decoder 模型 首先我们来了解一下Encoder-Decoder 模型, Encoder-Decoder 主要是 NLP 领域里的概念,它并不特值某种具体的算法,而是一类算法的统称,称之为Encoder-Decoder结构更合适。Encoder-Decoder 算是一个通用的框架,在这个框架下可以使用不同的算法来解决不同的任务。Encoder-Decoder 这个框架很好...

Wisimer 3376

AI量化交易工作台Vibe-Trading:用自然语言驱动策略回测与多智能体研究

量化交易通过数学模型和计算机程序执行投资决策,其核心在于将市场规律转化为可验证的策略。传统量化开发涉及数据获取、策略编写、回测验证等复杂工程,对非编程背景的从业者构成较高门槛。随着大语言模型技术的发展,自然语言交互正成为降低技术使用难度的关键。Vibe-Trading项目正是这一趋势的实践,它将金融工程任务封装为可调用的工具与技能,允许用户通过自然语言指令直接驱动策略回测、因子研究和投资组合分析。其技术价值在于构建了一个模块化的AI Agent框架,通过ReAct推理框架协调多个专项技能,并创新性地引入多智

weixin_28695161的博客 1566

JavaSpringBoot + VUE 相关开发环境配置合集

1.Java环境-JDK安装 参照:Java基础1-环境篇:JDK安装与环境变量配置 Java基础1-环境篇:JDK安装与环境变量配置_第一段代码的博客-优快云博客_jdk 2.Web服务器-Tomcat安装 原创Java服务器Tomcat安装和配置 3.Maven(后面为了项目兼容性,使用了3.0.5版本) 原创Maven安装和配置(Maven3.0.5) 4.nginx 原创nginx轻量级Web服务器安装和配置 5 数据库mysql 原创数据库Mysql安装和配置 ...

第一段代码的博客 3163

常见的encoder decoder架构有哪些

T5和BERT在架构上有根本性的区别。T5通过Encoder-Decoder结构实现了更广泛的应用,包括生成任务,而BERT则专注于文本理解。在选择使用哪种模型时,应根据具体任务需求进行判断。如果需要处理多种NLP任务并生成文本,T5是更合适的选择;而如果主要关注理解和分类,BERT则表现更为优越。分享改写Seq2Seq架构因其灵活性和强大的功能在自然语言处理领域得到了广泛应用。通过引入注意力机制和Transformer结构,这些模型在处理复杂任务时表现出色。

具身机器人和通用AI 1630

信息安全与技术——(十一)恶意代码检测与防范技术

恶意代码(Malicious Code )或恶意软件(Malware )主要是指以危害信息的安全等不良意图为目的的程序,它们一般潜伏在受害计算机系统中实施破坏或窃取信息。

m0_63853448的博客 5991

Encoder-Decoder架构详解

本文详细解析了Encoder-Decoder架构,这是Transformer的核心框架和序列到序列任务的标准模型。该架构由编码器和解码器两部分组成:编码器将输入序列转换为连续表示,解码器基于该表示生成输出序列。文章通过Python代码示例展示了Encoder层的实现细节,包括多头自注意力机制和前馈神经网络等关键组件,并配以架构流程图说明数据流向。典型应用场景涵盖机器翻译、文本摘要、对话系统等多种任务,具有输入输出长度可变、支持并行训练等特点。

海绵宝宝de派小星的博客 10万+

从 Service Entry Sheet 按 PO 行项目追溯服务行:PACKNO 与 ESLL 层级解包实战

摘要: SAP MM模块中,外部服务采购的数据结构较为复杂,服务明细并非直接存储在采购订单行项目表EKPO中,而是通过PACKNO关联到服务包表ESLL。本文解析了从采购订单行项目EBELN+EBELP获取服务行号SRVPOS的方法,重点分析了服务包的层级结构(根包、子包SUB_PACKNO),并提供了兼容合同项目的ABAP代码实现。通过EKPO-PACKNO定位根包后,需结合ESUC和ESLL表逐层解析子包,最终获取服务明细数据,解决了服务采购场景下的数据关联难题。(149字)

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 171

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Seq2Seq:Encoder-Decoder架构详解

实现逻辑编码器处理整篇文章,提取核心语义解码器生成简洁摘要,长度远小于原文优势:能自动提取文章关键信息,适用于新闻、学术论文等长文本处理核心贡献首次实现端到端序列转换,为NLP多项任务提供通用框架通过Encoder-Decoder架构解决了"输入输出长度不一致"的难题奠定了后续Transformer等高级架构的基础关键局限信息瓶颈:固定向量无法完美表示序列全部信息长距离依赖处理能力弱,尤其在无注意力机制时解码效率低,生成质量不稳定发展脉络。

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 729

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Pytorch+LSTM+Encoder+Decoder实现Seq2Seq模型

将Seq2Seq模型个构建采用Encoder类和Decoder类融合

linxizi0622的博客 4021

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

AI算法之Encoder-Decoder 和 Seq2Seq

Encoder-Decoder 是 NLP 领域里的一种模型框架。它被广泛用于机器翻译、语音识别等任务。 1 什么是 Encoder-Decoder ? Encoder-Decoder 模型主要是 NLP 领域里的概念。它并不特值某种具体的算法,而是一类算法的统称。Encoder-Decoder 算是一个通用的框架,在这个框架下可以使用不同的算法来解决不同的任务。 Encoder-Decoder ...

Mind_programmonkey的博客 3273

[ai笔记13] 大模型架构对比盘点:Encoder-Only、Decoder-Only、Encoder-Decoder

最近看完《这就是chatgpt》对于大语言模型的三种架构演进图印象颇深,今日就专题盘点一下三种大模型架构理论,同时做一个简单对比。

1万+

Encoder-Decoder和Seq2Seq

Encoder-Decoder 准确来说,Encoder–Decoder是一种框架,许多算法中都有该种框架。Encoder–Decoder是一种思想,因此在解释这种框架的时候需要结合某种算法来详细说明它的实现方式。 Encoder-Decoder框架有一个最显著的特征就是它是一个End-to-End学习的算法,在机器翻译中,比如将中文翻译成英语。编码是将输入序列转化成一个固定长度的向量;解码就是将...

weixin_44162104的博客 2244
上一篇: 从 n-gram 到神经网络:NPLM 如何重塑语言建模范式
下一篇: 一文看懂注意力机制:点积注意力机制、QKV含义、自注意力、多头注意力、注意力掩码
TracyCoder123
博客等级 码龄8年 1万+粉丝 226原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

TracyCoder123

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
