机器学习与深度学习基础(五):深度神经网络经典架构简介

第六周:深度学习基础(残差网络+RNN基础) 本文对残差网络结构做了详细的解释,残差网络的特点是特别容易优化,并且能够通过增加相当的深度来提高准确率。其内部的残差块使用了跳跃连接,缓解了在深度神经网络中增加深度带来的梯度消失问题。本文通过一个引例,对循环网络的正向传播过程做了详细的分析,以及对单向循环神经网络的结构进行了介绍,以及对循环神经网络的计算过程进行手推。循环神经网络的来源就是为了刻画一个序列当前的输出与之前信息的关系。从网络结构上,循环神经网络会记忆之前的信息,并利用之前的信息影响后面结点的输出。 阅读详情

本文学习要点:

1.深度神经网络分层架构:
全连接层
卷积层
池化层
2.深度神经网络代表:
CNN:CNN、AlexNet、VGG-Net、GoogLeNet(Inception)、ResNet(残差连接)
RNN:RNN、LSTM、GRU
编码器-解码器架构:序列到序列模型(Seq2Seq)

一、深度神经网络的不同层

1.1 全连接层

全连接神经网络:MLP神经网络就是一种全连接神经网络,最基础的用途是数值预测,即解决输入为连续的数值,输出也为连续的数值的任务。

关于全连接神经网络,可查看这位大佬的博客:https://www.bbbdata.com/text/501

1.2 卷积层、池化层

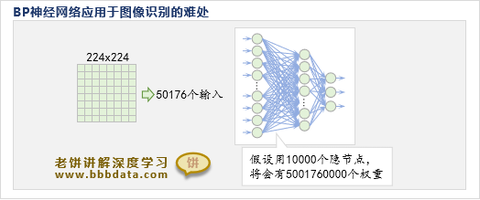
在卷积神经网络之前,比较火的是BP神经网络,因为BP神经网络只要隐神经元足够多,就能拟合任意曲线。但是,BP神经网络在应用于图象识别时,却难以进行,效果也并不太好,因为图象识别的输入比较多,就导致隐神经元也必须足够多,这样模型中的参数比较多,参数过多,训练就非常困难,而且模型的拟合能力也过强,导致模型预测效果往往不佳。

以图像处理为例,可以注意到,图像的每个像素并非是孤立的,它与周边的像素紧密相连,传统的全连接神经网络显然没有利用这一信息,于是卷积神经网络CNN诞生了。

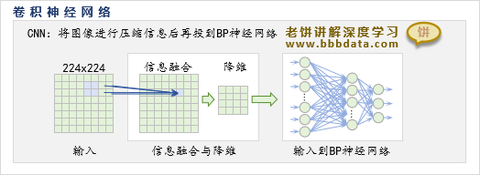
CNN引入了卷积层与池化层,先对输入进行信息融合与降维,在将输入个数压缩得更少后,再使用传统的全连接神经网络进行拟合。
在这里插入图片描述
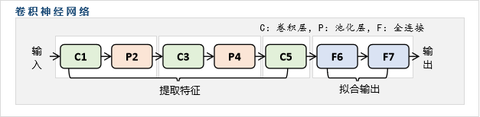
在这里插入图片描述

CNN的核心: 卷积操作(接收野)、池化操作(信息压缩)。
在这里插入图片描述

经过这样的处理后,在FeatureMap变得较小时,再会用传统的全连接神经网络来拟合输出;由于此时FeatureMap较小,所以传统神经网络的求解压力将减小,将不再存在太大的难题;值得注意的是,池化层是没有参数的,而卷积层的参数个数只受卷积核大小的影响,由于它们不直接受输入图片大小的影响,所以利用卷积层与池化层将图片Size进行压缩的代价相对是较小的。

关于CNN的详细解读可参考:https://www.bbbdata.com/text/652

二、 CNN-based系列深度神经网络

基础CNN模型并非某个人独立提出的模型结构,而是随着各种CNN模型(LeNet,AlexNet,VGG,…ResNet)的提出,逐渐在领域内形成一种公认的Base结构,从而就有了"基础CNN模型结构"。基础CNN模型结构最早成型于LeNet,然后在AlexNet中成熟,并在其它模型中丰富与完善。

总的来说,不管是“卷积神经网络”还是“基础卷积神经网络”,都不是指某个公认的、唯一的模型,而是符合“使用了卷积运算”的都叫卷积神经网络,同理,“只使用了卷积神经网络的基础技术”的都叫“基础卷积神经网络”。
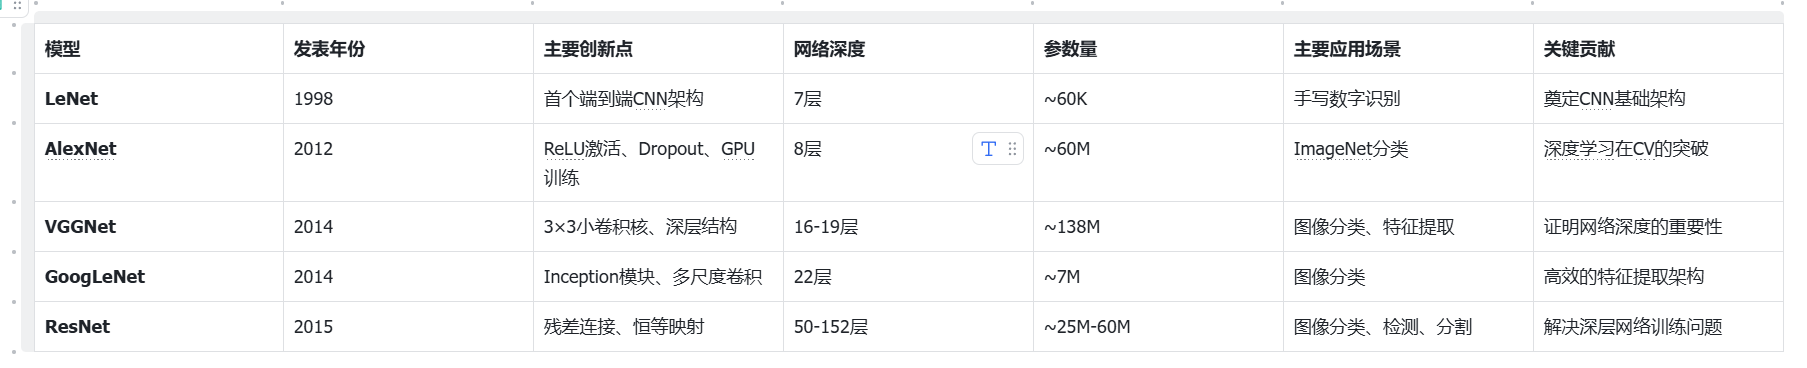
在这里插入图片描述

2.1 LeNet

LeNet是第一个成功应用于数字识别的卷积神经网络,其创新点在于首次将卷积层、池化层和全连接层组合成一个端到端的深度学习架构,通过局部感受野、权值共享和空间降采样等机制,有效提取图像特征并减少参数数量,为后续CNN发展奠定了基础。

论文:《Gradient - Based Learning Applied to Document Recognition》

  • 奠定卷积神经网络基础:
    LeNet首次证明了卷积神经网络在计算机视觉任务中的有效性,其"卷积-池化"的结构模式成为现代CNN的基本框架,为后续的AlexNet、VGG、ResNet等模型奠定了基础。

  • 推动深度学习复兴:
    在深度学习的"黑暗时代",LeNet的成功应用展示了神经网络的潜力,为2012年后深度学习的复兴埋下了伏笔。Yann LeCun也因此成为深度学习三巨头之一。

  • 现代改进与发展:
    虽然LeNet结构简单,但现代CNN仍延续其核心思想并进行了多方面改进:

    • 使用ReLU等更高效的激活函数替代sigmoid
    • 采用最大池化替代平均池化
    • 增加网络深度和宽度,提升特征提取能力
    • 引入批归一化、残差连接等技术
    • 使用Dropout等方法防止过拟合
  • 教学价值:
    由于结构简单、概念清晰,LeNet至今仍是深度学习和计算机视觉入门的经典教学案例,帮助初学者理解卷积神经网络的基本原理和工作机制。

2.2 AlexNet

AlexNet在ImageNet竞赛中首次超越传统方法,其创新点包括使用ReLU激活函数替代Sigmoid解决梯度消失问题、引入Dropout正则化防止过拟合、采用数据增强技术提高泛化能力、使用GPU并行训练加速计算,以及采用局部响应归一化(LRN) 增强特征表达,标志着深度学习在计算机视觉领域的突破。

论文:《ImageNet Classification with Deep Convolutional Neural Networks》

  • 数据增强操作:
    使用了多种数据增强技术,包括随机裁剪、水平翻转和颜色变换,显著增加了训练数据量,减少了过拟合,提高了模型泛化能力。
    • 随机裁剪原始图像的224×224区域
    • 水平翻转图像
    • 对RGB像素值进行PCA变换
  • Dropout正则化:
    AlexNet引入了Dropout技术,在训练过程中随机"丢弃"一部分神经元,有效减少了过拟合。这相当于同时训练多个子网络,提高了模型的鲁棒性。
    • 在训练时,每个神经元以概率p被暂时"丢弃"
    • 测试时,所有神经元保留,但权重乘以(1-p)
    • AlexNet在FC6和FC7层使用p=0.5的Dropout
  • 双GPU并行计算:
    AlexNet通过将网络分布在两个GPU上并行计算,大幅加速了训练过程。这是深度学习中多GPU训练的早期实践,为后续大规模模型训练奠定了基础。
    • Conv1、Conv2和Conv5的卷积核在两个GPU上独立计算
    • Conv3和Conv4的卷积核跨GPU连接
    • 全连接层在两个GPU上复制并同步
  • 其他重要技术:
    • 局部响应归一化(LRN):
      AlexNet在Conv1和Conv2后使用LRN,通过增强大激活值、抑制小激活值,增加了模型的泛化能力。虽然现代网络通常用Batch Normalization替代LRN,但这是早期尝试之一。
    • 重叠池化(Overlapping Pooling):
      AlexNet使用步长小于池化窗口大小的池化操作,如3×3窗口步长为2,这种重叠池化减少了过拟合,提高了特征提取的精确性。
    • 多尺度训练:
      在训练过程中,将原始图像缩放到不同尺寸(256-512像素),然后随机裁剪224×224区域,使模型学习到不同尺度的特征。

2.3 VGG

VGGNet的创新点在于采用简单而有效的设计理念,使用3×3小卷积核的深层网络结构,通过堆叠多个小卷积层替代大卷积核,在保持感受野的同时大幅减少参数数量,同时证明了网络深度对性能提升的重要性,其模块化设计思想影响了后续网络架构的发展。

论文:《Very Deep Convolutional Networks for Large - Scale Image Recognition》

VGG模型组成:

  • 卷积部分:由多个卷积块组成,每个卷积块包含1-3个3×3卷积层, followed by一个ReLU激活函数和一个2×2的最大池化层(除最后一个卷积块外)
  • 全连接部分:包含3个全连接层,最后接一个softmax激活函数用于分类

2.4 ResNet

ResNet通过引入残差连接(跳跃连接)解决了深层网络的梯度消失和退化问题,其核心创新是"恒等映射"思想,让网络可以直接学习残差函数,使得训练超深层网络(如152层)成为可能,同时通过批归一化等技术进一步稳定训练过程,在多个视觉任务上取得了突破性成果。

论文:《Deep Residual Learning for Image Recognition》
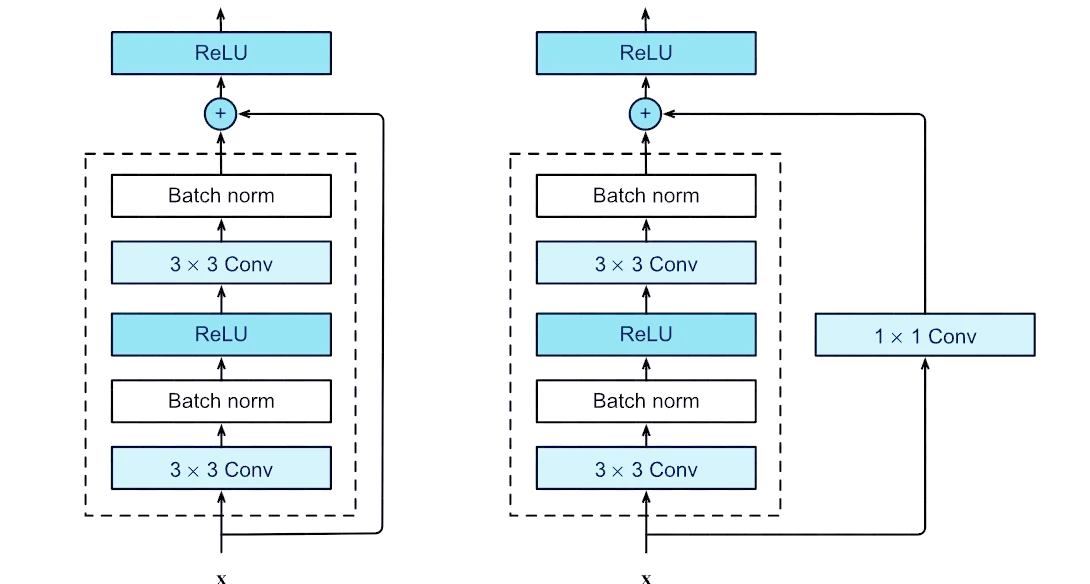
在这里插入图片描述

2.5 GoogLeNet

GoogLeNet的创新点在于提出Inception模块,采用多尺度并行卷积结构,同时使用1×1、3×3、5×5卷积核和最大池化层,通过1×1卷积进行降维减少计算量,这种设计既提高了特征提取的多样性,又有效控制了参数量和计算复杂度,为后续网络设计提供了新的思路。

论文:《Going Deeper with Convolutions》
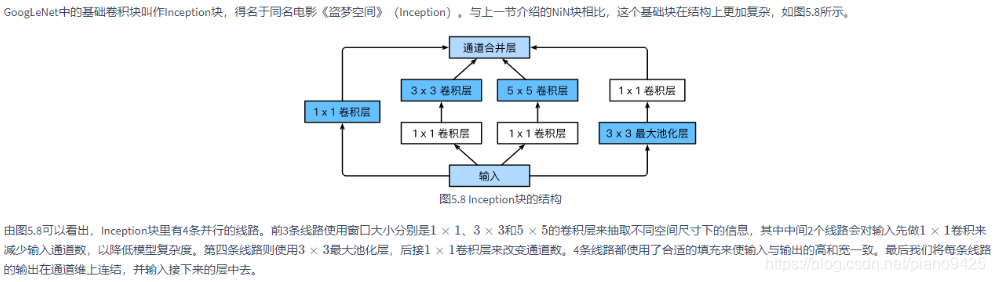
在这里插入图片描述

三、RNN-based系列深度神经网络

3.1 RNN

RNN(Recurrent Neural Network,循环神经网络)是一类专门用于处理序列数据的神经网络模型,核心特点是通过引入“循环连接”让网络具备记忆能力,能捕捉数据中的时序依赖关系——不同于前馈神经网络(如CNN、BP网络)的单向信息传递,RNN在处理每个序列元素时,会将当前输入与上一时刻的隐藏状态结合计算,使网络能利用历史信息理解上下文。其结构中包含重复的神经元模块(隐藏层),每个模块的输出不仅传递给下一层,还会反馈到自身作为下一时刻的输入,最终通过隐藏状态输出预测结果。

RNN最初被用于解决语音识别、自然语言处理(如文本生成、机器翻译)、时间序列预测等任务,但存在梯度消失/爆炸问题,难以捕捉长距离时序依赖,后续衍生出LSTM(长短期记忆网络)、GRU(门控循环单元)等改进模型,通过门控机制优化了长序列信息的记忆与传递能力。

详细解读可参考:https://zybuluo.com/hanbingtao/note/541458

3.2 LSTM

LSTM(Long Short-Term Memory,长短期记忆网络)是 Hochreiter & Schmidhuber 于 1997 年提出的 RNN 改进模型,核心通过引入 “门控机制”(输入门、遗忘门、输出门)和 “细胞状态”(Cell State)解决传统 RNN 的梯度消失 / 爆炸问题,实现对长距离时序依赖的有效捕捉。

传统 RNN 因仅靠简单隐藏状态传递信息,在处理长序列时,梯度会随反向传播的层数增加急剧衰减或膨胀,导致无法学习到远距离的上下文关联;而 LSTM 的细胞状态如同 “信息传送带”,能稳定存储长序列中的关键信息,遗忘门可选择性丢弃无用历史信息,输入门决定新信息的融入程度,输出门控制当前细胞状态的输出,数学上通过 sigmoid 和 tanh 激活函数实现门控的开关调节,既保留了 RNN 处理序列数据的能力,又突破了短记忆瓶颈。LSTM 广泛应用于长文本翻译、语音识别、时间序列预测(如股价、气象)等需要依赖长距离上下文的任务,是自然语言处理和时序建模领域的基础模型之一。

详细解读可参考:https://www.zhihu.com/question/445411028/answer/2323876011

3.3 GRU

GRU(Gated Recurrent Unit,门控循环单元)是 Cho 等人于 2014 年提出的 LSTM 简化版循环神经网络模型,它通过合并门控结构(将 LSTM 的遗忘门与输入门整合为更新门,同时用重置门替代输出门),在保持对长距离时序依赖捕捉能力的前提下,减少了参数数量、提升了计算效率。

相比 LSTM,GRU 去掉了细胞状态,仅通过隐藏状态传递信息,结构更简洁、训练速度更快,同时有效解决了传统 RNN 的梯度消失 / 爆炸问题,能捕捉长序列中的上下文关联,广泛应用于机器翻译、文本生成、语音识别等序列建模任务,是平衡性能与效率的经典门控循环模型。

详细解读可参考:https://zhuanlan.zhihu.com/p/694357122

深度学习基础篇之深度神经网络(DNN) 神经网络不应该看做是一个算法,应该看做是一个特征挖掘方法。在实际的业界发展过程中,数据的作用往往大于模型,当我们把数据的隐藏特征提取出来之后,用很简单的模型也能预测的很好。神经网络模型由生物神经中得到启发。在生物神经元细胞中,神经突触接收到信号,经过接收并处理信号后判断信号的信息强弱,来做出不同神经电位变化反应。受此启发,科研人员设计出基础的神经网络模型结构,神经元模型(Neuron Model)。 阅读详情

相关推荐

人工智能AI 机器学习ML 深度学习DL 和 神经网络NN 的关系

人工智能 机器学习 深度学习 神经网络 的关系

自动驾驶汽车和机器人技术爱好者 1974

神经网络架构

神经网络架构

Ricardo_PING的Blog 3286

DNN-深度神经网络

深度神经网络(DNN)是一种多层神经网络,通过将多个神经元连接在一起,形成一种深度结构。DNN可以用于处理各种类型的数据,包括图像、文本、语音等。在深度神经网络中,隐含层的数量和每层的神经元数量可以视具体任务和数据类型而定。DNN的训练过程通常采用反向传播算法和梯度下降优化方法,通过不断地调整神经网络的参数,以最小化预测误差和损失函数。深度神经网络具有多个非线性映射的特征变换,可以对高度复杂的函数进行拟合。相比浅层建模方式,深层建模能更细致高效的表示实际的复杂非线性问题。

2301_78731684的博客 4228

神经网络整体架构

神经网络整体架构

zhang1379的博客 2350

DNN(深度神经网络算法)

深度神经网络概念TensorFlow 成为最受欢迎的深度学习库,原因数据集tensorflow 读取数据通过feed_dict传递数据从文件中读取预加载的数据定义模型训练/学习评估模型 自从 1962 年 Rosenblat 提出感知机(Perceptron)以来,DNN 的概念就已经出现了,而自 Rumelhart、Hinton 和 Williams 在 1986 年发现了梯度下降算法后,DNN 的概念就变得可行了。直到最近 DNN 才成为全世界 AI/ML 爱好者和工程师的最爱。 一个算法出名后,它概念

1万+

深度神经网络(DNN),AI领域最具突破性的技术

由于 DNN 在语音识别 和图像识别上的突破性应用,使用 DNN 的应用量有了爆炸性的增长。这些 DNN 被部署到了从自动驾驶汽车 、癌症检测到复杂游戏等各种应用中。在这许多领域中,DNN 能够超越人类的准确率。而 DNN 的出众表现源于它能使用统计学习方法从原始感官数据中提取高层特征,在大量的数据中获得输入空间的有效表征。

Remon的专栏 1580

神经网络基础结构

全连接层的引入可以增加网络的灵活性和表达能力,使其能够适应各种复杂的任务,并进行准确的分类和预测。然而,随着网络层数的增加,全连接层的参数量也会大幅增加,导致计算量增加和过拟合的风险,因此需要适当的正则化和优化策略来处理。通过交替堆叠多个卷积层和池化层,CNN能够逐渐提取出抽象和高级的特征,并在全连接层中进行进一步的处理和分类。:全连接层也称为密集连接层或输出层,是神经网络中的一种常见层类型。参数共享:卷积层中的每个滤波器都使用相同的权重参数对输入数据进行卷积操作,从而减少了参数数量,降低了模型复杂度。

weixin_54418006的博客 2670

AI之DL:人工智能领域—深度学习的简介(包括相关术语概念)、常用算法、常用框架、应用场景之详细攻略

​ DL:深度学习技术之BP神经网络的简介、基础知识(神经元/感知机、训练策略、预测原理)、算法分类、经典案例应用之详细攻略 目录 深度学习浪潮兴起的三大因素 BP神经网络的简介 深度学习(神经网络)的算法分类 深度学习浪潮兴起的三大因素 海量的数据 不断提升的算法能力 高性能计算硬件的实现:GPU、TPU 1、感知机 DL之Perceptron:Perceptron感知器(感知机/多层感知机/人工神经元)的简介、原理、案例应用(相关配图)之详细攻略 2、对比:传统

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

深度学习入门(二):神经网络整体架构

DROP-OUT是防止神经网络过于复杂,进行随机杀死神经元的一种方法。查看circle data,可以看出效果不佳,看上去像切了一刀。左图是全连接神经网络,右图在神经网络训练过程中,查看circle data,可以看出效果较好。作用于每一层的输入,通过逐层计算得到输出结果。:数值较大或较小时,梯度约为0,出现。将神经元设置为1,查看效果。将神经元设置为2,查看效果。将神经元设置为3,查看效果。

weixin_51293984的博客 1739

人工智能(AI)、机器学习(ML)和深度学习(DL):有什么区别? | Linux 中国(转载)

在过去十年中,机器学习和深度学习的进步已经在各种规模的行业和组织中创造了人工智能热潮。最近,软件开发的低代码和无代码概念被用作机器学习中的自学习过程,它给出了完成特定任务的特定指令。通过使用数据和算法对机器进行“训练”,使其能够学习如何执行任务,更重要的是,将学习应用到不断发展的过程中。机器学习是在开发者社区专注于 AI 时发展起来的,然后发展了算法决策树学习、逻辑编程、聚类、并行处理和强化学习。让我们看看每个术语的演变和历程,以更好地理解人工智能、机器学习和深度学习实际指的是什么。本文转载于Linux。.

m0_46232425的博客 1134

AI Agent ReAct架构设计模型剖析

ReAct通过"思考-行动-观察"循环运作:智能体先进行自然语言推理,再调用外部工具执行行动,观察结果后继续推理直至解决问题。这种架构提高了透明度和准确性,减少幻觉风险,使LLM能主动分解任务并利用外部数据源。实现关键在于精心设计的提示模板,引导LLM按结构化格式响应,而非依赖模型固有能力。

weixin_43939320的博客 1250

【机器学习】深度神经网络(DNN)

本文全面介绍了深度神经网络(DNN)的核心概念与应用。DNN通过多层隐藏层实现分层特征学习,底层提取低级特征,上层组合为高级语义特征。文章详细解析了DNN的网络结构(输入层、隐藏层、输出层)、激活函数选择(ReLU、Sigmoid等)、训练原理(前向传播和反向传播),并提供了完整的Python实现代码。针对训练中的梯度消失、过拟合等问题,提出了ReLU激活函数、批量归一化、Dropout等解决方案。DNN广泛应用于图像识别、自然语言处理、推荐系统等领域,是CNN、RNN等现代深度学习模型的基础框架。

2401_84149564的博客 2779

Kill5.37版本下,使用ARMcomplier6编译__asm 函数报错的问题

Kill5-5.37版本下,使用ARMcomplier6编译__asm 函数报错的问题 问题简要描述: 昨日更新了keil5软件的版本,从5.17更新到了5.37版本,然后编译STM32项目文件时,软件提示编译报错。报错问题如下: Build started: Project: QKsoftware *** Using Compiler 'V6.18', folder: 'E:\MDK-ARM\ARM\ARM\ARMCLANG\Bin' Build target 'QKsoftware' compiling

weixin_43644424的博客 1万+

理解深度神经网络——DNN(Deep Neural Networks)

深度神经网络——DNN 是深度学习的基础。 要理解DNN最好先搞清楚它的模型。本篇博文主要对DNN的模型与前向传播算法做一个易于理解的总结。 1.从感知机到神经网络的理解。 感知机是这么一种模型:一个有若干输入和一个输出的模型。看下图: 输出和输入之间学习到一个线性关系,得到中间输出结果: 接着是一个神经元激活函数: 从而得到想要的结果1或者-1. 这个模型只...

qq_41665685的博客 4万+

前端开发学习--登录和注册页面设计(html和css,可完成两个页面点击切换)

今天学习了登录和注册页面的设计,主要是HTML和CSS部分,注册和切换采用了Js代码进行,后面将通过js进行填写内容的验证,进而可通过JSP跳转到Servlet进行DAO数据的校验,这属于后端部分了。 总体设计思路:整个页面设计可以分为主体(content)、头部(content-header)、内容(content-body)三个部分组成,其中是主体是根部,包含了头部和内容,头部和内容各自下设两...

weixin_43691879的博客 1万+

STM32CUBEMX+STM32H750VB+LWIP+LAN8720A+FREERTOS TCP服务器、UDP数据接收发送、网线热插拔、IAR-8.32开发

STM32CUBEMX+STM32H750VB+LWIP+LAN8720A+FREERTOS TCP服务器、UDP数据接收发送、网线热插拔、IAR-8.32开发STM32H750VB使用STM32CUBEMX生成工程IAR+J-LINK调试准备工作CUBEMX生成的代码问题所在如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章U

qq_37433166的博客 5344

PyTorch学习系列教程:深度神经网络【DNN】

对于PyTorch学习教程系列,有了前几篇推文做铺垫,这次打算用三篇文章分别介绍一下深度学习中的三大基石:DNN、CNN、RNN。本文就从DNN开始,即深度神经网络。

AAI666666的博客 3466

基于555定时器的D类功放设计:从PWM原理到无反馈电路实践

D类功放(数字功放)是一种高效率的音频放大技术,其核心原理是脉冲宽度调制(PWM)。它将输入的模拟音频信号转换为一系列高速开关的脉冲,通过控制功率开关管(如MOSFET)的通断,再经低通滤波器还原放大后的音频。相比传统AB类功放,其转换效率通常超过90%,显著降低了热能损耗。这项技术在追求高能效和小型化的现代音频设备中价值凸显,广泛应用于有源音箱、汽车音响和便携式设备。本文聚焦于一种独特的实现方案:以经典的555定时器芯片为核心,构建一个无整体负反馈的D类功放。通过剖析其PWM调制器、FET电压-电流转换级

weixin_30162121的博客 221

【深度学习基础】使用Pytorch搭建DNN深度神经网络与手写数字识别

本文介绍了如何使用PyTorch框架搭建深度神经网络模型。实现模型的搭建、模型训练、测试、网络的复用等,并实现机器学习领域的Hello world——手写数字识别。重点关注PyTorch的实现方式。

Bossfrank的博客 3613

逆向工程师的Shopee爬虫避坑指南:af-ac-enc-dat参数生成原理与反反爬策略

本文深入剖析了Shopee电商平台的反爬虫加密机制,重点解析了核心请求头参数x-sap-ri、x-sap-sec及af-ac-enc-dat的生成原理与联动关系。文章从逆向工程视角,提供了定位加密代码、分析算法逻辑的实战方法,并分享了基于JS执行环境模拟与无头浏览器控制的可持续反反爬策略,为高效、稳定地采集数据提供专业指南。

weixin_28607671的博客 1494

数学建模学习(121):Python实现模糊AHP(Fuzzy AHP)——从原理到实践

Python实现模糊AHP(Fuzzy AHP)

全栈川川 1539

什么是深度神经网络?与深度学习、机器学习、人工智能的关系是什么?

大家好,我是默语,擅长全栈开发、运维和人工智能技术。在本篇博客中,我将深入探讨深度神经网络,并解释它与深度学习机器学习和人工智能的关系。通过详细的介绍和代码示例,希望帮助大家更好地理解这些前沿技术名词及其应用。无论是初学者还是经验丰富的开发者,都能从中获益。🤖🧠深度神经网络(Deep Neural Networks,DNN)是指包含多个隐藏层的人工神经网络。与传统的神经网络相比,DNN能够更好地处理复杂的任务,如图像识别、语音识别和自然语言处理。技术定义应用场景优势深度神经网络多层神经网络结构。

沉淀所学,分享所思,让热爱与成长同行。商务记录AI实战经验,助力开发者快速成长。 热爱AI,希望做出有影响力的技术成果。 技术点亮生活,分享连接价值与机会。 专注AI落地实战,陪你走好技术每一步。 2万+

异构图中的注意力机制网络:节点级别和语义级别的注意力(Python实现)

在本文中,我们介绍了如何使用Python实现异构图中的节点级别注意力和语义级别注意力。通过语义级别注意力,我们可以根据节点的语义信息对节点进行加权聚合。在本文中,我们将介绍如何使用Python实现异构图中的注意力机制网络,包括节点级别的注意力和语义级别的注意力。最后,我们使用注意力权重对节点特征进行加权聚合,得到聚合后的节点表示。然后,将聚合后的节点表示传递给语义级别注意力模型,根据节点的语义信息进行加权聚合,得到最终的表示。函数中,首先使用节点级别注意力模型对节点特征进行聚合,得到聚合后的节点表示。

HackNebulaZ的博客 485

深度神经网络DNN

深度网络DNN的概念,是基于浅层网路——多层感知机MLP(或称人工神经网络ANN)的基础上发展而来。关于MLP或ANN的知识,此处不作赘述,网上有很多资料可以参考。 DNN是一个很广的概念,大名鼎鼎的CNN、RNN、GAN等都属于其范畴之内。CNN多用于网络结构数据类型的任务,如图像、声音、文本等;RNN多用于时间序列类型的任务,如音频、文本(NLP)、视频等;GAN则主要用于“生成数据、以假乱...

FanJin的博客 7649

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Interview之AI:人工智能领域岗位求职面试—人工智能算法工程师知识框架及课程大纲(AI基础之数学基础/数据结构与算法/编程学习基础、ML算法简介、DL算法简介)来理解技术交互流程

​ Interview之AI:人工智能领域岗位求职面试—人工智能算法工程师知识框架及课程大纲(AI基础之数学基础/数据结构与算法/编程学习基础、ML算法简介、DL算法简介)来理解技术交互流程 目录 剖析自己 一、AI基础 二、ML算法简介 三、DL算法简介 剖析自己 1、个人能力角度 确定自己应具备的能力:以结果为导向的思维,看职位要求让做什么,自己会会什么,还差哪些? 职位条件 目前能力 还差的能力 ML算法工程师 熟悉python/R、S

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

当传统算法遇见深度学习:OpenCV中经典ML与DNN的协同之道

本文探讨了OpenCV中传统机器学习(ML)与深度学习(DNN)的协同应用,展示了如何通过ml模块和dnn模块的联合使用提升计算机视觉任务的效率和性能。文章详细介绍了混合部署策略、资源优化技术以及OpenCV 4.x的最新突破,为开发者提供了实用的工程实践指南。

gg901的博客 821
上一篇: 机器学习与深度学习基础(四):什么是连接主义与符号主义
下一篇: 语言模型基础技术的开端:N-Gram与Bag-of-words详解
TracyCoder123
博客等级 码龄8年 1万+粉丝 226原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

TracyCoder123

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值