ALS

ALS算法理解   ALS算法全称为交替最小二乘法(Alternating Least Squares),是一种基于协同过滤思想的矩阵分解算法。其亮点之一就在于优化参数时使用了交替最小二乘法,而非常规的SGD或者是MBGD,这一点就决定了ALS算法可以进行分布式并行计算,因此其被收录于Spark的Mlib以及ML库中。下面将详细介绍这一算法: 一、隐语义模型 1.基本思想 在当前大数据环境下如果构建 用户-物品 共现矩阵其肯定是十分稀疏的,发生交互的用户和物品一定是少数,因此传统的矩阵分解方法(例如SVD)不再适用。 用 阅读详情

Spark机器学习

Spark MLlib

  MLlib目前支持4种常见的机器学习问题:分类、回归、聚类和协同过滤。spark.mllib包含基于RDD的原始算法API。spark.ml 则提供了基于DataFrames 高层次的API,可以用来构建机器学习工作流(PipeLine)。ML Pipeline 弥补了原始 MLlib 库的不足,向用户提供了一个基于 DataFrame 的机器学习工作流式 API 套件。
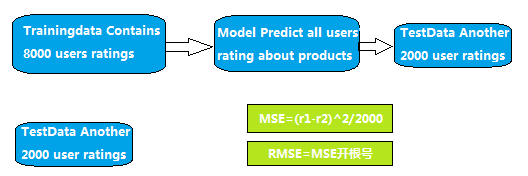
  利用SparkSQL处理完的数据会分成训练集的数据和测试集的数据(用来验证模型是否是准确的)。ALS中有train方法,会返回MatrixFactorizationModel。MatrixFactorizationModel中很多方法:在得到这个模型以后调用recomendProducts或recomendUsers方法,就能够得到想要的推荐结果。
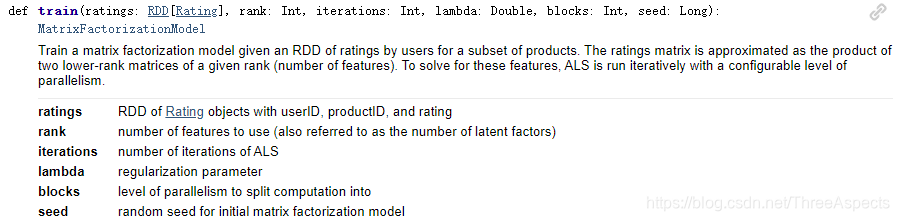
在这里插入图片描述

val model1 = ALS.train(ratings, rank, numIterations, lambda)//显性反馈模型
val model2 = ALS.trainImplicit(ratings, rank, numIterations, lambda, alpha)//隐性反馈模型

参数包括:
ratings:userId、productId、rating的三元组
rank:隐含因子
numIterations:迭代次数
Lambda:正则项的惩罚系数
alpha: 置信参数
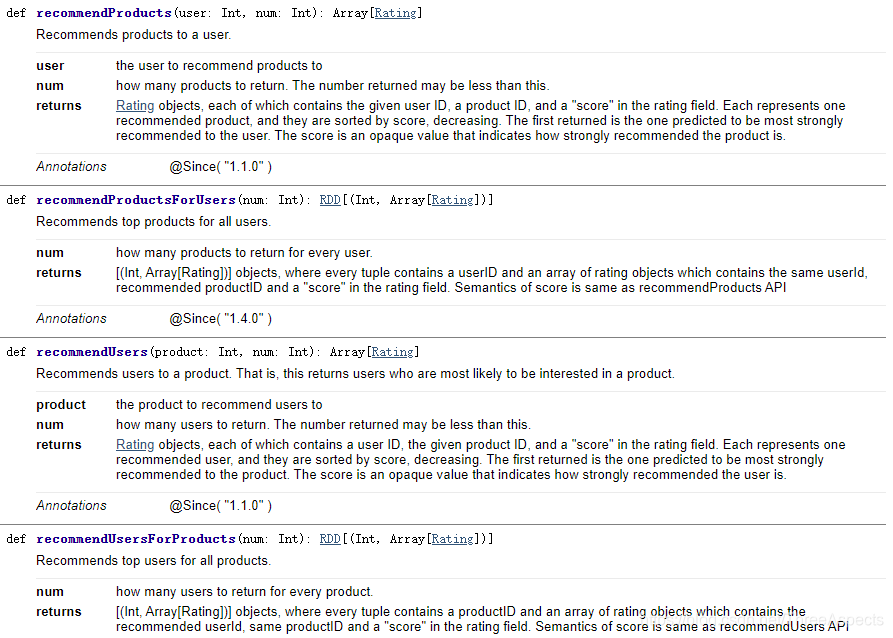
在这里插入图片描述

ALS

  ALS(交替最小二乘法),从协同过滤的分类来说,ALS算法属于混合CF,因为它同时考虑了User和Item两个方面,既可基于用户进行推荐又可基于物品进行推荐。用户和商品的关系,可以抽象为如下的三元组:<User,Item,Rating>。
  在spark MLlib 机器学习库中目前推荐模型只包含基于矩阵分解(matrix factorization)的实现。可以将矩阵分解成用户-特征矩阵和物品-特征矩阵。具体的分解思路,找出两个低维的矩阵,使得它们的乘积是原始矩阵。因此矩阵分解相当于进行了特征提取或者数据的降维。
  由于评分数据中有大量的缺失项,传统的矩阵分解SVD(奇异值分解)不方便处理这个问题。该方法在矩阵分解之前需要先把评分矩阵R缺失值补全,补全之后稀疏矩阵R表示成稠密矩阵R’,然后将R’分解成如下形式:R’ = UTSV。这种方法有两个缺点,第一是补全成稠密矩阵之后需要耗费巨大的存储空间,在实际中,用户对物品的行为信息量庞大,对这样的稠密矩阵的存储是不现实的;第二,SVD的计算复杂度很高。
  而ALS能够很好的解决这个问题。对于R(m×n)的矩阵,ALS旨在找到两个低维矩阵X(m×k)和矩阵Y(n×k),来近似逼近R(m×n),即: R m × n R_{m\times n} Rm×n​≈ X m × k X_{m\times k} Xm×k​ Y n × k T Y_{n\times k}^T Yn×kT​ 。其中R(m×n)代表用户对商品的评分矩阵,X(m×k)代表用户对隐含特征的偏好矩阵,Y(n×k)表示商品所包含隐含特征的矩阵。
  为了找到使低秩矩阵X和Y尽可能地逼近R,需要最小化下面的平方误差损失函数:L(X,Y)= ∑ u , i ( r u i − x u T y i ) 2 \displaystyle\sum_{u,i}(r_{ui-x_u^Ty_i})^2 u,i∑​(rui−xuT​yi​​)2……(1)
其中 x u x_u xu​(1×k)表示示用户u的偏好的隐含特征向量, y i y_i yi​(1×k)表示商品i包含的隐含特征向量, r u i r_{ui} rui​表示用户u对商品i的评分, 向量 x u x_u xu​和 y i y_i yi​的内积 x u T y i x_u^Ty_i xuT​yi​是用户u对商品i评分的近似。

  损失函数一般需要加入正则化项来避免过拟合等问题,我们使用L2正则化,所以上面的公式改造为:L(X,Y)= ∑ u , i ( r u i − x u T y i ) 2 + λ ( ∣ x u ∣ 2 + ∣ y i ∣ 2 ) \displaystyle\sum_{u,i}(r_{ui-x_u^Ty_i})^2+λ(|x_u|^2+|y_i|^2) u,i∑​(rui−xuT​yi​​)2+λ(∣xu​∣2+∣yi​∣2)……(2)
其中λ是正则化项的系数。到这里,协同过滤就成功转化成了一个优化问题。由于变量 x u x_u xu​和 y i y_i yi​耦合到一起,这个问题并不好求解,所以我们引入了ALS。

  使用交替最小二乘法(ALS)来最优化损失函数。ALS的实现原理是迭代式求解一系列最小二乘回归问题。也就是说我们可以先固定Y(例如随机初始化X),然后利用公式(2)先求解X,然后固定X,再求解Y,如此交替往复直至收敛,即所谓的交替最小二乘法求解法。具体求解方法说明如下:

  • 先固定Y, 将损失函数L(X,Y)对xu求偏导,并令导数=0,得到: x u = ( Y T Y + λ I ) − 1 Y T r u x_u=(Y^TY+λI)^{-1}Y^Tr_u xu​=(YTY+λI)−1YTru​……(3)
  • 同理固定X,可得: y i = ( X T X + λ I ) − 1 X T r i y_i=(X^TX+λI)^{-1}X^Tr_i yi​=(XTX+λI)−1XTri​……(4)其中 r u ( 1 × n ) r_{u(1×n)} ru(1×n)​是R的第u行, r i ( 1 × m ) r_{i(1×m)} ri(1×m)​是R的第i列, I是k×k的单位矩阵
  • 迭代步骤:首先随机初始化Y,利用公式(3)更新得到X,然后利用公式(4)更新Y,直到均方根误差变RMSE化很小或者到达最大迭代次数。
    R ′ = X Y R'=XY R′=XY
    R M S E = ∑ ( R − R ′ ) 2 N RMSE=\sqrt \dfrac{\sum(R-R')^2}{N} RMSE=N∑(R−R′)2​ ​

如何评价推荐结果好坏? 通过MSE:
在这里插入图片描述

// Evaluate the model on rating data
val usersProducts = ratings.map { case Rating(user, product, rate) =>(user, product)}
val predictions =model.predict(usersProducts).map { case Rating(user, product, rate) =>((user, product), rate)}
val ratesAndPreds = ratings.map { case Rating(user, product, rate) =>((user, product), rate)}.join(predictions)
val MSE = ratesAndPreds.map { 
  case ((user, product), (r1, r2)) =>
  val err = (r1 - r2)
  err * err}.mean()

即得到模型以后会产生一个user和product的tuple,分别为这个tuple得到预测的rating和实际的rating,然后两个rating再转成一个tuple,放到一个函数中做相减。对于推荐结果通过组合迭代的方式,通过变换迭代次数,惩罚值来寻求最佳模型。发现适当增大iterations,减小lambda,均方差可能会减小,从而推荐结果较优

ALS算法的缺点在于:

  1. 它是一个离线算法
  2. 无法准确评估新加入的用户或商品,即Cold Start(冷启动)问题

隐式反馈
  在实际的电商网站中,存在大量的用户行为间接反映用户的喜好,比如:用户的购买记录、搜索关键字甚至是鼠标的移动。我们将这些间接用户行为称之为隐式反馈(implicit feedback),以区别于评分这样的显式反馈(explicit feedback)。隐式反馈有以下几个特点:

  1. 没有负面反馈(negative feedback)。用户一般会直接忽略不喜欢的商品,而不是给予负面评价
  2. 隐式反馈包含大量噪声。比如,电视机在某一时间播放某一节目,然而用户已经睡着了,或者忘了换台
  3. 显式反馈表现的是用户的喜好(preference),而隐式反馈表现的是用户的信任(confidence)。比如用户最喜欢的一般是电影,但观看时间最长的却是连续剧。大米购买的比较频繁,量也大,但未必是用户最想吃的食物
  4. 隐式反馈非常难以量化
val model2 = ALS.trainImplicit(ratings, rank, numIterations, lambda, alpha)//隐性反馈模型

隐式模型多了一个置信参数,这就涉及到ALS中对于隐式反馈模型的处理方式了——有的文章称为“加权的正则化矩阵分解”,它的损失函数如下:
针对隐式反馈,有ALS-WR算法(ALS with Weighted–Regularization)。

  • ALS-WR的目标函数:min( x u , y i x_u,y_i xu​,yi​)L(X,Y)= ∑ u , i c u i ( p u i − x u T y i ) 2 + λ ( ∣ x u ∣ 2 + ∣ y i ∣ 2 ) \displaystyle\sum_{u,i}c_{ui}(p_{ui-x_u^Ty_i})^2+λ(|x_u|^2+|y_i|^2) u,i∑​cui​(pui−xuT​yi​​)2+λ(∣xu​∣2+∣yi​∣2)……(5),

我们知道,在隐反馈模型中是没有评分的,所以在式子中rui被pui所取代,pui是偏好的表示,仅仅表示用户和物品之间有没有交互,而不表示评分高低或者喜好程度。比如用户和物品之间有交互就让pui等于1,没有就等于0。
p u i = 1 ∣ i f : r u i > 0 p u i = 0 ∣ i f : r u i = 0 \begin{alignedat}{3} p_{ui}=1 |if:r_{ui}>0\\ p_{ui}=0 |if:r_{ui}=0 \end{alignedat} pui​=1∣if:rui​>0pui​=0∣if:rui​=0​
函数中还有一个cui的项,它用来表示用户偏爱某个商品的置信程度,比如交互次数多的权重就会增加。如果我们用dui来表示交互次数的话,那么就可以把置信程度表示成如下公式: c u i = 1 + α d u i c_{ui}=1+αd_{ui} cui​=1+αdui​其中α是置信度系数。

  • 求解方式还是最小二乘法: x u = ( Y T C u Y + λ I ) − 1 Y T C u r u x_u=(Y^TC^uY+λI)^{-1}Y^TC^ur_u xu​=(YTCuY+λI)−1YTCuru​……(6), y i = ( X T C i X + λ I ) − 1 X T C i r i y_i=(X^TC^iX+λI)^{-1}X^TC^ir_i yi​=(XTCiX+λI)−1XTCiri​……(7)
implicitPrefs 决定了是用显性反馈ALS的版本还是用适用隐性反馈数据集的版本。
alpha 是一个针对于隐性反馈 ALS 版本的参数,这个参数决定了偏好行为强度的基准。

本质上,这个方法将数据作为二元偏好值和偏好强度的一个结合,而不是对评分矩阵直接进行建模。因此,评价就不是与用户对商品的显性评分而是和所观察到的用户偏好强度关联了起来。然后,这个模型将尝试找到隐语义因子来预估一个用户对一个商品的偏好。

参考论文:
《Large-scale Parallel Collaborative Filtering forthe Netflix Prize》
《Collaborative Filtering for Implicit Feedback Datasets》
《Matrix Factorization Techniques for Recommender Systems》

1、隐式数据的使用,系统中存在浏览、点击、播放、关注、分享、购买等数据,怎样同时使用?
最开始的时候,只使用了点击数据,但是产品初期数据量有点小;同时关注、购买数确实相对于点击数据更为重要,因此当前采用这种赋权方法:
value = 5* 购买 + 4* 关注 + 3* 分享 + 2* 播放 + 1*点击

2、spark als怎样使用隐式反馈数据?

ALS als = new ALS()
.setMaxIter(alsIterCount)
.setAlpha(3)
.setRank(50)
.setRegParam(0.01)
.setUserCol("userIdIndex")
.setItemCol("itemId")
.setRatingCol("rating")
.setImplicitPrefs(true);

有三点:

  1. rating是一个上面的value,比如点击数目的累加和
  2. 加上setImplicitPrefs(true)
  3. 加上setAlpha(3),这个值可以自己调参;不要直接选40(论文中数字),项目数据如果很少,大于40直接数据就没了

3、对数据的清洗包括哪些
过滤掉userId、itemId为空的数据

4、ALS能否用于相关推荐、相似推荐
ALS没有原生支持,但是可以获取itemFactors,然后自己做crossjoin笛卡尔乘积,然后计算item和item之间的相似度,获取TOP K个最相关的即可

5、ALS计算结果怎么使用
当前只计算了相关推荐;以item为KEY,以itemlist为value存入了REDIS;前端每次访问直接根据itemId取出itemlist即可返回,几十毫秒即可;由于item变动不频繁,所以每天计算一次

6、怎么处理冷启动
对于新加入物品,直接取对应分类的热门列表即可;第二天就有了用户行为数据

ALS推荐算法简介 目录ALS(交替最小二乘法)1.1 原理推导2.1.1 ALS2.1.2 ALS-L2正则化2.1.3 Stochastic Gradient ALS2.1.4 隐式反馈(Implicit Feedback )2. 优缺点 ALS(交替最小二乘法) ALS (Alternating Least Squares) 交替最小二乘法。ALS 的核心是:打分矩阵R是近似低秩的。换句话说,一个打分矩阵 R ... 阅读详情

相关推荐

推荐系统之ALS算法详解

ALS算法是2008年以来,用的比较多的协同过滤算法。它已经集成到Spark的Mllib库中,使用起来比较方便。 从协同过滤的分类来说,ALS算法属于User-Item CF,也叫做混合CF。它同时考虑了User和Item两个方面。 用户和商品的关系,可以抽象为如下的三元组:<User,Item,Rating>。其中,Rating是用户对商品的评分,表征用户对该商品的喜好程度。 ALS...

GFDGFHSDS的博客 1万+

SparkML之推荐算法(一)ALS

ALS(alternating least squares ):交替最小二乘法 --------------------------------------------------------------------- 原理应用 Matlab 主成分分析应用als Spark源码 SparkML实验 -------------------------------------------

legotime的博客 2万+

基于ALS算法的简易在线推荐系统

继前期完成广义线性模型的在线流式机器学习的代码后,我们对spark的mllib中的推荐系统这一部分比较感兴趣,因为推荐系统这一部分在现实生活中也非常实用,尤其是基于地理位置的在线推荐系统目前非常火热,很多商业软件如大众点评,淘点点等都希望能根据用户以往的一些行为和当前所处的地理位置给用户做出最佳的推荐,给用户带来意想不到的惊喜。 在推荐系统领域,目前市面上中文的参考书并不多,我们主要学习了目前就

zhangyuming010的专栏 1万+

ALS召回算法

import org.apache.spark.api.java.JavaRDD; import org.apache.spark.api.java.function.Function; import org.apache.spark.ml.evaluation.RegressionEvaluator; import org.apache.spark.ml.recommendation.ALS; import org.apache.spark.ml.recommendation.ALSModel; impo

yuechuzhixing的博客 351

矩阵分解模型(1):ALS学习算法

一、矩阵分解模型。 用户对物品的打分行为可以表示成一个评分矩阵A(m*n),表示m个用户对n各物品的打分情况。如下图所示: 其中,A(i,j)表示用户user i对物品item j的打分。但是,用户不会对所以物品打分,图中?表示用户没有打分的情况,所以这个矩阵A很多元素都是空的,我们称其为“缺失值(missing value)”。在推荐系统中,我们希望得到用户对所有物品的打分情况,如果

oucpowerman的博客 3万+

基于Spark ALS在线推荐系统

所用技术:Bootstrap、flat-ui 、 Servlet、Spark1.4.1、Hadoop2.6.0、JDK说明:本系统不涉及ssh相关内容,只有简单的Servlet和JSP、HTML页面,系统架构相对简单。系统部署:1. 拷贝spark-assembly-1.4.1-hadoop2.6.0.jar到WebContent/WEB-INF/lib目录;(spark-assembly-1.4

fansy1990的专栏 1万+

spark机器学习之als

今天分析一下als算法在spark mlib中的相关应用,关于原理性的东西,还是不多做介绍,als本身是协同过滤算法的一种,08年以来也是使用最频繁的协同过滤算法了。主要的原理性东西,推荐这篇博客: http://blog.youkuaiyun.com/antkillerfarm/article/details/53734658 本文章在这里主要还是介绍als算法在spark mlib中的应用,以及在构建r

wangkai198911的博客 677

PySpark实现ALS推荐算法

@PySpark 实现ALS推荐算法 spark-submit movie_rec.py from pyspark import SparkConf, SparkContext from pyspark.mllib.recommendation import ALS, Rating from math import sqrt 获取所有movie名称和id对应集合 def movie_dict(f...

ting1234cn的博客 2939

ALS算法原理及python实现

1、原理篇 我们用人话而不是大段的数学公式来讲讲ALS是怎么一回事。1.1 你听说过推荐算法么 假如我是豆瓣的CEO,很多豆瓣的用户在豆瓣电影上都会对电影进行评分。那么根据这个评分数据,我们有可能知道这些用户除了自己评过分的电影之外还喜欢或讨厌哪些电影吗?这就是一个典型的推荐问题,解决这一类问题的算法被称为推荐算法。1.2 什么是协同过滤 协同过滤的英文全...

黑马程序员广州中心的专栏 2970

Spark---ALS推荐算法

Spark——ALS推荐算法推荐算法介绍协同过滤式推荐的优缺点ALS推荐算法的介绍用户对产品项目的评分稀疏矩阵(Sparse Matrix)的问题矩阵分解(Matrix Factorization)数据下载环境说明在IPython Notebook中运行推荐程序首先启动所有虚拟机并启动Hadoop集群Cluster切换至IPython Notebook工作目录并在Hadoop YARN-clien...

Tubby的博客 6139

Spark MLlib交替最小二乘法ALS源码解析

请先阅读leboop发布的博文《Spark MLlib协同过滤之交替最小二乘法ALS原理与实践》。 核心代码如下: //定义ALS,参数初始化 val als = new ALS().setRank(50) .setMaxIter(10) .setRegParam(0.01) .setUserCol("userId") .setItemCol(...

L 665

ALS算法介绍(协同过滤算法介绍)

目录一、ALS算法概括二、ALS算法原理及运用(1)、协同过滤(2)、ALS算法工作原理(3)、ALS算法输入的参数三、代码实现 一、ALS算法概括 1、ALS算法用来补全用户评分矩阵。由于用户评分矩阵比较稀疏,将用户评分矩阵进行分解,变成V和U的乘积。通过求得V和U两个小的矩阵来补全用户评分矩阵。 2、ALS算法使用交替最小二乘法来进行求解 3、ALS分为显示反馈和隐式反馈两种。显示反馈是指用户有明确的评分。对于商品推荐来说,大部分是通过用户的行为,获取隐式反馈的评分。隐式反馈评分矩阵需要进行处理,如果有

qq_42448606的博客 2万+

从波形图到参数调优:一次无感BLDC电机启动失败的深度解析

本文深入解析无感BLDC电机启动失败案例,通过波形分析揭示参数不匹配和IPM保护机制触发等关键问题。详细探讨了过零点检测、PWM周期设置及强拖参数调优的底层逻辑,并分享IPM模块保护机制与实战调优技巧,最终实现99.98%的启动成功率。

weixin_29182481的博客 820

spark中ALS介绍

spark里面的调用 //Rmse均方根误差 root mean square error //为预测值与实际值的差的平方和与次数的比值的平方根,可以用来评判模型的好坏 //计算均方根误差,模型 测试集需要格式为RDD[Rating] //当然rmse越小越好 def RmseComputer(model: MatrixFactorizationModel, dataOfTest...

qq_38250124的博客 6329

5分钟搞定kkFileView 4.4.0 Docker部署:小白也能上手的完整配置流程

本文提供了一份针对kkFileView 4.4.0版本的Docker部署完整指南。通过使用预构建的Docker镜像,即使是新手也能在5分钟内完成文件预览服务的搭建,涵盖从环境准备、镜像拉取、容器启动到服务验证的全流程,并分享了进阶配置与生产环境优化建议。

mango的博客 526

QT编程系列1--QT学习前需知

本周学习了一些QT编程方面的知识,学写了几个程序,这里把记录下来。一方面对前面学习的知识做一个总结,便于以后复习、再学习和应用;另一方面也和大家做个交流,有不足的地方请各位看官多指点。   首先是做一些学习之前的交代:一,学习QT需要哪些基础;二,学习QT有哪些用途,QT较其他的开发工具有哪些特点;三,学习QT的思路。

霜月孤鸟&RTEMS&TinyOS 1115

ALS算法解析

1 前言 Spark平台推出至今已经地带到2.4.x版本,很多地方都有了重要的更新,加入了很多新的东西。 但是在协同过滤这一块却一直以来都只有ALS一种算法。 同样是大规模计算平台,Hadoop中的机器学习算法库Mahout就集成了多种推荐算法,不但有user-cf和item-cf这种经典算法,还有KNN、SVD,Slope one这些,可谓随意挑选,简繁由君。 我们知道得是,推荐系统这个应用本身...

JavaEdge全是干货的技术号 6699

【智能体】零代码实战:Coze多智能体协作开发全流程解析

本文详细解析了Coze平台的多智能体协作开发全流程,从入门指南到实战技巧,帮助用户零代码构建高效AI团队。通过模块化设计和专业分工,多智能体系统能显著提升任务处理速度和准确率,适用于客服、内容创作、教育培训等多个场景。文章还提供了性能优化和常见问题解决方案,助力开发者快速掌握Multi-Agent技术。

weixin_29239279的博客 336

基于ALS推荐系统

文章目录推荐系统Spark实现相关概念相似度偏好矩阵ALS算法(交替最小二乘法)核心代码项目实现基于用户的电影推荐算法基于商品的用户推荐算法实现思路模型的保存与加载 推荐系统Spark实现 推荐系统模型是基于协同过滤思想实现 基于用户的协同过滤(User) 基于物品的协同过滤(Item) 相关概念 相似度 概念:无论是基于用户还是基于物品的推荐,其本质思想是计算用户和用户之间的相似度,或者计算...

u013259361的博客 2645

Verilog中generate for循环的5个实战技巧(附完整代码示例)

本文详细介绍了Verilog中generate for循环的5个高级实战技巧,包括参数化模块实例化、条件化生成、多维硬件结构实现等,并附有完整代码示例。这些技巧能显著提升FPGA开发效率,特别适合中级Verilog开发者学习应用。

weixin_28725949的博客 187

部署资源管理系统chemx

资源管理系统的部署教程

weixin_40784215的博客 822

ALS计算CP分解

Tensor rank 众所周知,CP分解就是将一个张量分解为一系列秩一张量之和。 那么在计算CP分解之前,首先我们会遇到的一个问题就是如何确定张量的秩?也就是应该选择多少个秩一张量来组成原始张量呢? 不幸的是,确定张量的秩是一个NP-hard问题,目前,已知的只能够确定一个张量秩的上界。 例如,对于一个一般的三维张量而言,χ∈RI×J×K\chi\in R^{I \times J \times K}χ∈RI×J×K, 它的秩遵循如下约束: 对于更多的关于张量秩的讨论不在这篇文章中提及,因此,在下面计算C

飞翔的红猪 1960

太空安全卫士:基于YOLOv5的空间态势感知系统(实现轨道碰撞预警与太空环境保护)

做完这个项目,你会发现自己完整走过了“数据采集→标注→模型训练→功能集成→界面开发”的毕设全流程,这不仅是技术能力的证明,更是对“技术守护宇宙安全”这一理念的实践。答辩时,你可以重点讲这几点:系统解决了航天监测的哪些痛点、YOLOv5在太空目标检测中的性能优势、系统未来能怎么优化(比如对接航天监测网络、实现实时轨道预测)。未来,这个系统还能往“更智能”的方向发展:比如结合轨道计算预测碰撞风险、开发移动端APP让天文爱好者参与太空垃圾上报、在航天任务中实现全自动避障决策……想象空间很大。

m0_71589036的博客 90

基于pyspark的als推荐电影

ALS推荐算法: ALS算法是基于模型的推荐算法 基本思想 对稀疏矩阵进行模型分解,评估出缺失项的值,以此来得到一个基本的训练模型。然后依照此模型可以针对新的用户和物品数据进行评估。ALS是采用交替的最小二乘法来算出缺失项的,交替的最小二乘法是在最小二乘法的基础上发展而来的。 从协同过滤的分类来说,ALS算法属于User-Item CF,也叫做混合CF,它同时考虑了User和Item两个方面。 矩...

xhaoDream的博客 3810

嵌入式铁头山羊stm32:一文总结

本文是一篇STM32嵌入式开发的综合知识总结,涵盖了STM32基础概念、GPIO、通信协议、外设驱动等核心内容。文章首先介绍了STM32的基本概念和型号含义,然后详细讲解了GPIO的8种工作模式及实验案例。接着重点阐述了USART、I2C、SPI三种通信协议的原理和实现方法,包括硬件连接、编程接口和实验应用。此外还介绍了OLED显示原理、中断系统、定时器、ADC转换等关键技术,每个模块都配有对应的实验案例和代码实现参考。文章内容全面系统,既包含理论知识,又提供实践指导,适合作为STM32开发的快速参考手册。

古泽汉书的博客 2785

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

ALS-算法

Spark机器学习(10):ALS交替最小二乘算法 Alternating Least Square ALS(Alternating Least Square),交替最小二乘法。在机器学习中,特指使用最小二乘法的一种协同推荐算法。如下图所示,u表示用户,v表示商品,用户给商品打分,但是并不是每一个用户都会给每一种商品打分。比如用户u6就没有给商品v3打分,需要我们推断出来,这就是机器学习的任务。 由于并不是每个用户给每种商品都打了分,可以假设ALS矩阵是低秩的,即一个mn的矩阵,是由mk和k*n两个矩阵

qq_24857543的博客 865

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

上一篇: SQL
下一篇: Spark与MySQL连接
K. Bob
博客等级 码龄8年 82粉丝 294原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值