


支持向量机的学习方法包括三种:线性可分支持向量机、线性支持向量机和非线形支持向量机,这三种由简至繁,依次介绍。
一、线性可分支持向量机与硬间隔最大化
1.1 线性可分支持向量机
考虑一个二分类问题,且数据集是完全线性可分的,通过间隔最大化等价的求解相应的凸二次规划问题学习得到的分离超平面为
ω
∗
∙
x
+
b
∗
=
0
(1)
\omega^* \bullet x+b^*=0\tag1
ω∗∙x+b∗=0(1)
以及相应的分类决策函数
f
(
x
)
=
s
i
g
n
(
ω
∗
∙
x
+
b
∗
)
(2)
f(x)=sign(\omega^* \bullet x+b^*)\tag2
f(x)=sign(ω∗∙x+b∗)(2)
称为线型可分支持向量机。
下面介绍间隔最大化以及如何求解。
1.2 函数间隔与几何间隔
一般来说,一个点距离分离超平面的远近可以表示分类预测的确信程度。距离分离超平面越远,正确预测该点的确信程度越高。
函数间隔:
对于给定的数据集和超平面
(
ω
,
b
)
(\omega, b)
(ω,b),定义超平面
(
ω
,
b
)
(\omega, b)
(ω,b)关于样本点
(
x
i
,
y
i
)
(x_i, y_i)
(xi,yi)的函数间隔为
γ
i
^
=
y
i
(
ω
∙
x
+
b
)
(3)
\hat{\gamma_i}=y_i(\omega\bullet x+b)\tag3
γi^=yi(ω∙x+b)(3)
超平面
(
ω
,
b
)
(\omega, b)
(ω,b)关于数据集的函数间隔为所有样本点的函数间隔的最小值,即
γ
^
=
min
i
=
1
,
⋯
,
N
γ
i
^
(4)
\hat{\gamma}=\min_{i=1,\cdots, N}\hat{\gamma_i}\tag4
γ^=i=1,⋯,Nminγi^(4)
其中
y
i
∈
{
+
1
,
−
1
}
y_i\in\{+1, -1\}
yi∈{+1,−1}
函数间隔可以表示分类预测的正确性和确信度。如果函数间隔大于0,说明预测正确,而函数间隔越大,确信度越高。
但当 ( ω , b ) (\omega, b) (ω,b)成倍变化时,比如变成 ( 2 ω , 2 b ) (2\omega, 2b) (2ω,2b),超平面没有变化,但函数间隔却发生了变化,因此引入几何间隔的概念。
几何间隔:
对于给定的数据集和超平面
(
ω
,
b
)
(\omega, b)
(ω,b),定义超平面
(
ω
,
b
)
(\omega, b)
(ω,b)关于样本点
(
x
i
,
y
i
)
(x_i, y_i)
(xi,yi)的几何间隔为
γ
i
=
y
i
(
ω
∣
∣
ω
∣
∣
∙
x
+
b
∣
∣
ω
∣
∣
)
(5)
{\gamma_i}=y_i(\frac{\omega}{||\omega||}\bullet x+\frac{b}{||\omega||})\tag5
γi=yi(∣∣ω∣∣ω∙x+∣∣ω∣∣b)(5)
超平面
(
ω
,
b
)
(\omega, b)
(ω,b)关于数据集的函数间隔为所有样本点的函数间隔的最小值,即
γ
=
min
i
=
1
,
⋯
,
N
γ
i
(6)
{\gamma}=\min_{i=1,\cdots, N}{\gamma_i}\tag6
γ=i=1,⋯,Nminγi(6)
由定义可知几何间隔与函数间隔的关系为 γ i = γ i ^ ∣ ∣ ω ∣ ∣ {\gamma_i}=\frac{\hat{\gamma_i}}{||\omega||} γi=∣∣ω∣∣γi^, γ = γ ^ ∣ ∣ ω ∣ ∣ {\gamma}=\frac{\hat{\gamma}}{||\omega||} γ=∣∣ω∣∣γ^。如果 ∣ ∣ ω ∣ ∣ = 1 ||\omega||=1 ∣∣ω∣∣=1,那么函数间隔与几何间隔相等,而当 ( ω , b ) (\omega, b) (ω,b)成倍变化时(超平面不发生变化),函数间隔会随之变化,而几何间隔不会变化。
1.3 间隔最大化
支持向量机的基本思想是求解能够正确划分训练数据集且几何间隔最大的分离超平面。间隔最大化的直接解释是:对训练数据集找到几何间隔最大的超平面意味着以充分大的确信度对训练数据进行分类。而这样的分离超平面存在且唯一。
1.3.1 最大间隔分离超平面
最大间隔分离超平面可等价于以下约束最优化问题
max
ω
,
b
γ
(7)
\max_{\omega, b}\gamma\tag7
ω,bmaxγ(7)
s
.
t
.
y
i
(
ω
∣
∣
ω
∣
∣
∙
x
+
b
∣
∣
ω
∣
∣
)
≥
γ
,
i
=
1
,
2
,
⋯
,
N
(8)
s.t. \quad y_i(\frac{\omega}{||\omega||}\bullet x+\frac{b}{||\omega||})\ge\gamma, \quad i=1,2,\cdots,N\tag8
s.t.yi(∣∣ω∣∣ω∙x+∣∣ω∣∣b)≥γ,i=1,2,⋯,N(8)
考虑到几何间隔和函数间隔的关系,可将上式写成
max
ω
,
b
γ
^
∣
∣
ω
∣
∣
(9)
\max_{\omega, b}\frac{\hat{\gamma}}{||\omega||}\tag9
ω,bmax∣∣ω∣∣γ^(9)
s
.
t
.
y
i
(
ω
∙
x
i
+
b
)
≥
γ
^
,
i
=
1
,
2
,
⋯
,
N
(10)
s.t. \quad y_i(\omega\bullet x_i+b)\ge\hat\gamma, \quad i=1,2,\cdots,N\tag{10}
s.t.yi(ω∙xi+b)≥γ^,i=1,2,⋯,N(10)
函数间隔 γ ^ \hat\gamma γ^的取值不影响问题的解,所以可令 γ ^ = 1 \hat\gamma=1 γ^=1,同时注意到 max ω , b 1 ∣ ∣ ω ∣ ∣ \max_{\omega, b}\frac{1}{||\omega||} maxω,b∣∣ω∣∣1等价于 min ω , b 1 2 ∣ ∣ ω ∣ ∣ 2 \min_{\omega, b}\frac{1}{2}||\omega||^2 minω,b21∣∣ω∣∣2
所以有
min
ω
,
b
1
2
∣
∣
ω
∣
∣
2
(11)
\min_{\omega, b}\frac{1}{2}||\omega||^2\tag{11}
ω,bmin21∣∣ω∣∣2(11)
s
.
t
.
y
i
(
ω
∙
x
i
+
b
)
−
1
≥
0
,
i
=
1
,
2
,
⋯
,
N
(12)
s.t. \quad y_i(\omega\bullet x_i+b)-1\ge0, \quad i=1,2,\cdots,N\tag{12}
s.t.yi(ω∙xi+b)−1≥0,i=1,2,⋯,N(12)
(
11
)
(11)
(11)和
(
12
)
(12)
(12)是一个凸二次规划问题,通过求解
(
11
)
(11)
(11)和
(
12
)
(12)
(12),得到
ω
∗
\omega^*
ω∗和
b
∗
b^*
b∗为最优解,即可得到分离超平面。
1.3.2 支持向量和间隔边界
在线性可分情况下,训练数据集的样本点中与分离超平面距离最近的样本点的实例成为支持向量。换句话说,支持向量是使约束条件 ( 12 ) (12) (12)等号成立的点。即下图中红色标记的点。
而两条虚线相互平行,而且并没有实例点落在它们中间,它们之间的距离就称为间隔。两条虚线称为间隔边界。
在决定分离超平面时,只有支持向量在起作用,其他实例点并不起作用。

1.3.3 学习的对偶算法
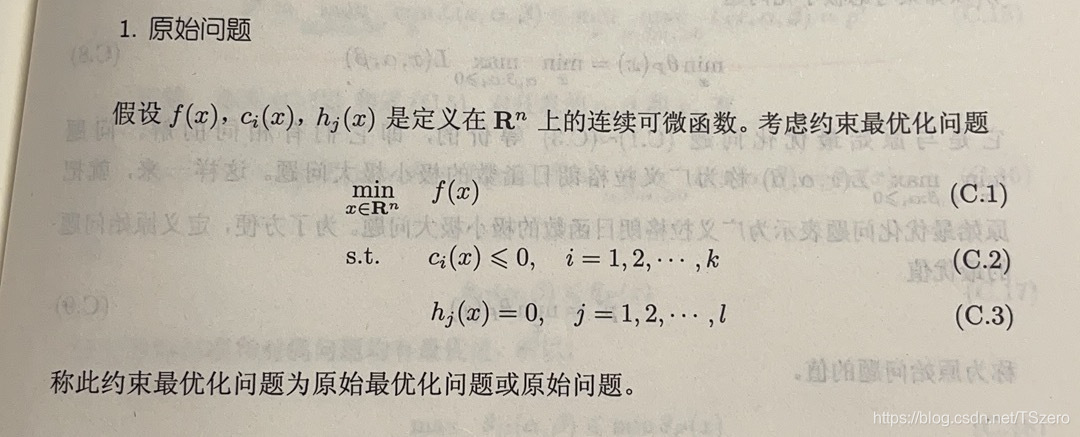
( 11 ) (11) (11)和 ( 12 ) (12) (12)并不容易直接求解,考虑将它作为原始最优化问题,应用拉格朗日对偶性,通过求解对偶问题得到原始问题的最优解。
首先构建拉格朗日函数
L
(
ω
,
b
,
α
)
=
1
2
∣
∣
ω
∣
∣
2
−
∑
i
=
1
N
α
i
y
i
(
ω
∙
x
i
+
b
)
+
∑
i
=
1
N
α
i
(13)
L(\omega, b, \alpha)=\frac{1}{2}||\omega||^2-\sum\limits_{i=1}^N\alpha_iy_i(\omega\bullet x_i+b)+\sum\limits_{i=1}^N\alpha_i\tag{13}
L(ω,b,α)=21∣∣ω∣∣2−i=1∑Nαiyi(ω∙xi+b)+i=1∑Nαi(13)
其中,
α
=
(
α
1
,
⋯
,
α
N
)
T
\alpha=(\alpha_1,\cdots,\alpha_N)^T
α=(α1,⋯,αN)T为拉格朗日乘子向量。根据拉格朗日对偶性,原始问题的对偶问题是极大极小问题,即
max
α
min
ω
,
b
L
(
ω
,
b
,
α
)
(14)
\max_{\alpha}\min_{\omega, b}L(\omega, b, \alpha)\tag{14}
αmaxω,bminL(ω,b,α)(14)
因此,为了得到原始问题的解,先求
L
(
ω
,
b
,
α
)
L(\omega, b, \alpha)
L(ω,b,α)对
ω
,
b
\omega, b
ω,b的极小,再求
α
\alpha
α的极大。
要求
L
(
ω
,
b
,
α
)
L(\omega, b, \alpha)
L(ω,b,α)对
ω
,
b
\omega, b
ω,b的极小,将
L
(
ω
,
b
,
α
)
L(\omega, b, \alpha)
L(ω,b,α)分别对
ω
,
b
\omega, b
ω,b求偏导数并令其等于0,得到
ω
=
∑
i
=
1
N
α
i
y
i
x
i
(15)
\omega=\sum\limits_{i=1}^N\alpha_iy_ix_i\tag{15}
ω=i=1∑Nαiyixi(15)
∑
i
=
1
N
α
i
y
i
=
0
(16)
\sum\limits_{i=1}^N\alpha_iy_i=0\tag{16}
i=1∑Nαiyi=0(16)
再将其带入
(
13
)
(13)
(13)并化简得到
min
ω
,
b
L
(
ω
,
b
,
α
)
=
−
1
2
∑
i
=
1
N
∑
j
=
1
N
α
i
α
j
y
i
y
j
(
x
i
∙
x
j
)
+
∑
i
=
1
N
α
i
(17)
\min_{\omega, b}L(\omega, b, \alpha)=-\frac{1}{2}\sum\limits_{i=1}^N\sum\limits_{j=1}^N\alpha_i\alpha_jy_iy_j(x_i\bullet x_j)+\sum\limits_{i=1}^N\alpha_i\tag{17}
ω,bminL(ω,b,α)=−21i=1∑Nj=1∑Nαiαjyiyj(xi∙xj)+i=1∑Nαi(17)
再求
α
\alpha
α的极大,并将极大转化为极小可有
min
α
1
2
∑
i
=
1
N
∑
j
=
1
N
α
i
α
j
y
i
y
j
(
x
i
∙
x
j
)
−
∑
i
=
1
N
α
i
(18)
\min_{\alpha}\frac{1}{2}\sum\limits_{i=1}^N\sum\limits_{j=1}^N\alpha_i\alpha_jy_iy_j(x_i\bullet x_j)-\sum\limits_{i=1}^N\alpha_i\tag{18}
αmin21i=1∑Nj=1∑Nαiαjyiyj(xi∙xj)−i=1∑Nαi(18)
s
.
t
.
∑
i
=
1
N
α
i
y
i
=
0
(19)
s.t.\quad \sum\limits_{i=1}^N\alpha_iy_i=0\tag{19}
s.t.i=1∑Nαiyi=0(19)
α
i
≥
0
i
=
1
,
2
⋯
,
N
(20)
\alpha_i\ge0\quad i=1,2\cdots,N\tag{20}
αi≥0i=1,2⋯,N(20)
设
α
∗
=
(
α
1
∗
,
⋯
,
α
N
∗
)
T
\alpha^*=(\alpha_1^*, \cdots, \alpha_N^*)^T
α∗=(α1∗,⋯,αN∗)T是对偶最优化问题
(
18
)
∼
(
20
)
(18)\sim(20)
(18)∼(20)的解,存在下标
j
j
j,使得
α
j
∗
>
0
\alpha_j^*\gt0
αj∗>0,并可按下式求得原始最优化问题
(
11
)
∼
(
12
)
(11)\sim(12)
(11)∼(12)的解
ω
∗
=
∑
i
=
1
N
α
i
∗
y
i
x
i
(21)
\omega^*=\sum\limits_{i=1}^N\alpha_i^*y_ix_i\tag{21}
ω∗=i=1∑Nαi∗yixi(21)
b
∗
=
y
j
−
∑
i
=
1
N
α
i
∗
y
i
(
x
i
∙
x
j
)
(22)
b^*=y_j-\sum\limits_{i=1}^N\alpha_i^*y_i(x_i\bullet x_j)\tag{22}
b∗=yj−i=1∑Nαi∗yi(xi∙xj)(22)
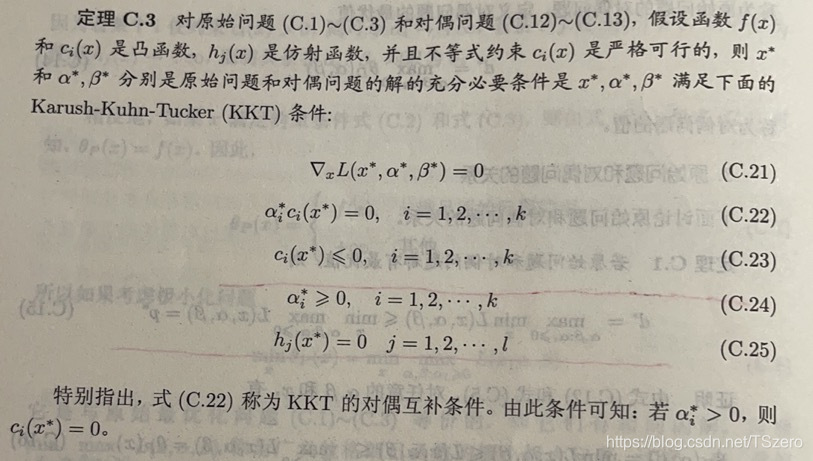
1.3.4 KKT条件
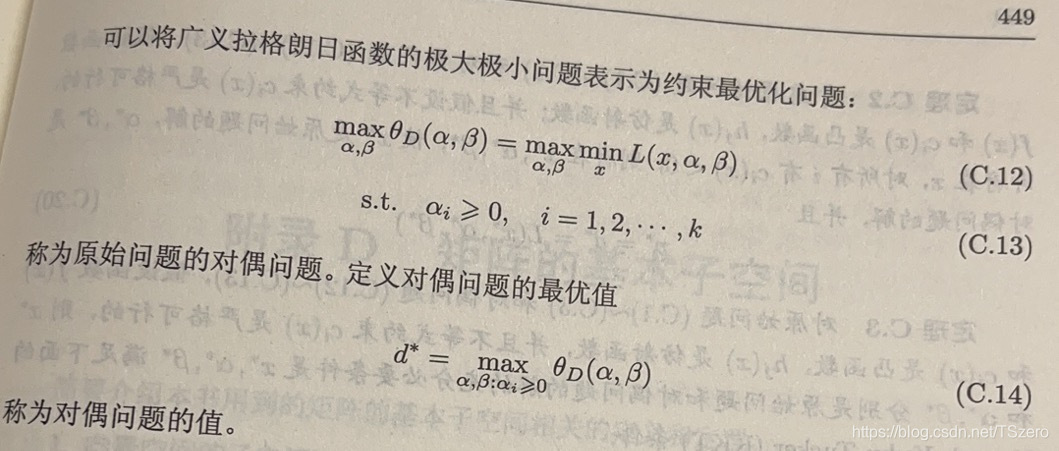
二、线性支持向量机与软间隔最大化
2.1 线性支持向量机
当数据集不能线性可分时,上述方法不适用,因为上述方法中的不等式约束并不能成立。假设数据集中有一些特异点。将这些特异点去除后,剩下大部分的样本点是线性可分的。不等式约束不能成立,即不能全部满足
y
i
(
ω
∙
x
i
+
b
)
−
1
≥
0
,
i
=
1
,
2
,
⋯
,
N
y_i(\omega\bullet x_i+b)-1\ge0, \quad i=1,2,\cdots,N
yi(ω∙xi+b)−1≥0,i=1,2,⋯,N,为了解决这个问题,可以对每个样本点
(
x
i
,
y
i
)
(x_i, y_i)
(xi,yi)都引入一个松弛变量
ξ
i
≥
0
\xi_i\ge0
ξi≥0,使得函数间隔加上松弛变量大于等于1,即约束条件变为
y
i
(
ω
∙
x
i
+
b
)
≥
1
−
ξ
i
,
i
=
1
,
2
,
⋯
,
N
(23)
y_i(\omega\bullet x_i+b)\ge1-\xi_i, \quad i=1,2,\cdots,N\tag{23}
yi(ω∙xi+b)≥1−ξi,i=1,2,⋯,N(23)
而目标函数变为
1
2
∣
∣
ω
∣
∣
2
+
C
∑
i
=
1
N
ξ
i
(24)
\frac{1}{2}||\omega||^2+C\sum\limits_{i=1}^N\xi_i\tag{24}
21∣∣ω∣∣2+Ci=1∑Nξi(24)
其中
C
>
0
C\gt0
C>0为惩罚函数,越大,对误分类的惩罚越大。
(
24
)
(24)
(24)使间隔尽可能大,同时误分类的点尽可能的少。
其对偶问题和上述类似,也是先写出拉格朗日函数,再求极小极大,最终可以得到
min
α
1
2
∑
i
=
1
N
∑
j
=
1
N
α
i
α
j
y
i
y
j
(
x
i
∙
x
j
)
−
∑
i
=
1
N
α
i
(25)
\min_{\alpha}\frac{1}{2}\sum\limits_{i=1}^N\sum\limits_{j=1}^N\alpha_i\alpha_jy_iy_j(x_i\bullet x_j)-\sum\limits_{i=1}^N\alpha_i\tag{25}
αmin21i=1∑Nj=1∑Nαiαjyiyj(xi∙xj)−i=1∑Nαi(25)
s
.
t
.
∑
i
=
1
N
α
i
y
i
=
0
(26)
s.t.\quad \sum\limits_{i=1}^N\alpha_iy_i=0\tag{26}
s.t.i=1∑Nαiyi=0(26)
0
≤
α
i
≤
C
i
=
1
,
2
⋯
,
N
(27)
0\le\alpha_i\le C\quad i=1,2\cdots,N\tag{27}
0≤αi≤Ci=1,2⋯,N(27)
同样的有,设
α
∗
=
(
α
1
∗
,
⋯
,
α
N
∗
)
T
\alpha^*=(\alpha_1^*, \cdots, \alpha_N^*)^T
α∗=(α1∗,⋯,αN∗)T是对偶最优化问题
(
25
)
∼
(
27
)
(25)\sim(27)
(25)∼(27)的解,存在下标
j
j
j,使得
0
<
α
j
<
C
0\lt\alpha_j\lt C
0<αj<C,可按下式求得原始最优化问题
(
23
)
∼
(
24
)
(23)\sim(24)
(23)∼(24)的解
ω
∗
=
∑
i
=
1
N
α
i
∗
y
i
x
i
(28)
\omega^*=\sum\limits_{i=1}^N\alpha_i^*y_ix_i\tag{28}
ω∗=i=1∑Nαi∗yixi(28)
b
∗
=
y
j
−
∑
i
=
1
N
α
i
∗
y
i
(
x
i
∙
x
j
)
(29)
b^*=y_j-\sum\limits_{i=1}^N\alpha_i^*y_i(x_i\bullet x_j)\tag{29}
b∗=yj−i=1∑Nαi∗yi(xi∙xj)(29)
2.2 支持向量
对于线性不可分的数据集,将对偶问题 ( 25 ) ∼ ( 27 ) (25)\sim(27) (25)∼(27)的解 α ∗ = ( α 1 ∗ , ⋯ , α N ∗ ) T \alpha^*=(\alpha_1^*, \cdots, \alpha_N^*)^T α∗=(α1∗,⋯,αN∗)T中对应于 α i ∗ > 0 \alpha_i^*\gt0 αi∗>0的样本点 ( x i , y i ) (x_i, y_i) (xi,yi)的实例称为支持向量。此时支持向量或者在间隔边界上,或者在间隔边界与分离超平面之间,或者在分离超平面误分一侧。
三、非线形支持向量机与核函数
有时分类问题是非线形的,这时用非线形模型才能较好的进行分类。但非线形问题往往不好解,所以进行一个非线形变换,将非线性问题变换为线性问题,通过解变换后的线形问题的方法求解原来的非线性问题。
用线性分类方法求解非线形分类问题分为两步:首先使用一个变换将原空间的数据映射到新空间;然后在新空间里用线性分类学习方法从训练数据中学习分类模型。核技巧就属于这样的方法。
3.1 核函数
设
X
\mathcal X
X是输入空间,
H
\mathcal H
H为特征空间,如果存在一个从
X
\mathcal X
X到
H
\mathcal H
H的映射
ϕ
(
x
)
:
X
→
H
(30)
\phi(x):\mathcal X\to\mathcal H\tag{30}
ϕ(x):X→H(30)
使得对所有的
x
,
z
∈
X
x, z\in\mathcal X
x,z∈X,函数
K
(
x
,
z
)
K(x,z)
K(x,z)满足条件
K
(
x
,
z
)
=
ϕ
(
x
)
∙
ϕ
(
z
)
(31)
K(x,z)=\phi(x)\bullet\phi(z)\tag{31}
K(x,z)=ϕ(x)∙ϕ(z)(31)
则称
K
(
x
,
z
)
K(x,z)
K(x,z)为核函数,
ϕ
(
x
)
\phi(x)
ϕ(x)为映射函数,
ϕ
(
x
)
∙
ϕ
(
z
)
\phi(x)\bullet\phi(z)
ϕ(x)∙ϕ(z)为
ϕ
(
x
)
\phi(x)
ϕ(x)与
ϕ
(
z
)
\phi(z)
ϕ(z)的内积。
核技巧的想法是,在学习和预测中只定义核函数
K
(
x
,
z
)
K(x,z)
K(x,z),而不显式的定义映射函数
ϕ
(
x
)
\phi(x)
ϕ(x)。一方面,直接计算核函数比较容易,而通过
ϕ
(
x
)
\phi(x)
ϕ(x)和
ϕ
(
z
)
\phi(z)
ϕ(z)计算
K
(
x
,
z
)
K(x,z)
K(x,z)并不容易;另一方面,注意到在线性支持向量机的对偶问题中,无论是目标函数还是决策函数都只设计输入实例与实例之间的内积
x
i
∙
x
j
x_i\bullet x_j
xi∙xj,因此可以用
K
(
x
,
z
)
=
ϕ
(
x
)
∙
ϕ
(
z
)
K(x,z)=\phi(x)\bullet\phi(z)
K(x,z)=ϕ(x)∙ϕ(z)来代替,此时目标函数变为
W
(
α
)
=
1
2
∑
i
=
1
N
∑
j
=
1
N
α
i
α
j
y
i
y
j
K
(
x
i
,
x
j
)
−
∑
i
=
1
N
α
i
(32)
W(\alpha)=\frac{1}{2}\sum\limits_{i=1}^N\sum\limits_{j=1}^N\alpha_i\alpha_jy_iy_jK(x_i,x_j)-\sum\limits_{i=1}^N\alpha_i\tag{32}
W(α)=21i=1∑Nj=1∑NαiαjyiyjK(xi,xj)−i=1∑Nαi(32)
这等价于经过映射函数
ϕ
\phi
ϕ将原来的输入空间变换到一个新的特征空间,将输入空间里的
x
i
∙
x
j
x_i\bullet x_j
xi∙xj变换为特征空间里的
ϕ
(
x
)
∙
ϕ
(
z
)
\phi(x)\bullet\phi(z)
ϕ(x)∙ϕ(z)。在新的特征空间里从训练样本学习线性支持向量机,当映射函数是非线性函数时,学习到的含有核函数的支持向量机就是非线形分类模型。学习是隐式的在特征空间进行的,不需要显式的定义特征空间和映射函数,这种技巧就是核技巧。
3.2 常用核函数
∙
\bullet
∙多项式核函数
K
(
x
,
z
)
=
(
x
∙
z
+
1
)
p
(33)
K(x,z)=(x\bullet z+1)^p\tag{33}
K(x,z)=(x∙z+1)p(33)
∙
\bullet
∙高斯核函数
K
(
x
,
z
)
=
exp
(
−
∣
∣
x
−
z
∣
∣
2
2
σ
2
)
(34)
K(x,z)=\exp({-\frac{||x-z||^2}{2\sigma^2}})\tag{34}
K(x,z)=exp(−2σ2∣∣x−z∣∣2)(34)
3.3 核函数的充要条件
设 K : X × X → R K:\mathcal X\times\mathcal X\to \bm R K:X×X→R是对称函数,则 K ( x , z ) K(x, z) K(x,z)为核函数的充要条件是对任意的 x i ∈ X , i = 1 , ⋯ , m x_i\in\mathcal X, i=1,\cdots,m xi∈X,i=1,⋯,m, K ( x , z ) K(x,z) K(x,z)对应的Gram矩阵 K = [ K ( x i , x j ) ] m × m K=[K(x_i,x_j)]_{m\times m} K=[K(xi,xj)]m×m是半正定的。
四、对比
4.1 优缺点
- 优点:
- 对异常值不敏感,因为只有支持向量起作用
- 类别不平衡也可以用,只要支持向量平衡就行
- 可用于非线性数据的分类
- SVM在处理小规模样本的时候表现非常好
- 缺点:
- 对大规模训练样本难以实施
- 只能解决二分类问题
- 当特征数很多时,速度会很慢
- 对缺失值敏感
4.2 和逻辑回归的对比
参考:《统计学习方法》第2版 李航 著

 5947


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


