万字硬核解读SAM 3:不止分割一切,它开始理解世界了

【图像分割】SAM SAM(Segment Anything Model),为分割一切,由Facebook的Meta AI实验室在2023年发布,能够根据文本指令或图像识别,实现对任意物体的识别与分割。论文地址:https://arxiv.org/abs/2304.02643项目地址:https://github.com/facebookresearch/segment-anythingSAM从任务(task)、模型(model)、数据(data)3部分展开。 阅读详情
AI摘要

Meta推出的SAM 3模型实现了从图像分割到语义理解的跨越,支持开放词汇、全实例分割与多模态提示,通过可提示概念分割(PCS)任务,使模型能根据文字或示例精准识别并追踪目标,在图文和视频任务中均大幅超越现有模型。

Meta最新的SAM 3,让分割模型学会了理解你说的话,而不仅仅是你指的东西。
计算机视觉里的Segment Anything Model (SAM,分割一切模型) 系列,一直在干一件事,就是把图像视频里你想要的东西给“抠”出来。

2023年的老大SAM 1,像个刚学会指认东西的婴儿。你给它一张图,用鼠标点一下、画个框,它就把那个东西的轮廓给你描出来。它开创了一个时代,让模型学会了零样本泛化,不用提前训练就能分割没见过的东西。它的三段式架构,提示编码器、图像编码器、掩码解码器,成了后来者的基石。

2024年的老二SAM 2,学会了看视频。它有了记性,能在连续的画面里一直跟着一个目标。这就解决了视频对象分割(VOS)的难题。它用上了Transformer架构,靠着对前面画面的记忆来预测下一帧里目标的位置,实现了实时跟踪。

到了2025年,老三SAM 3来了。它被投到顶会ICLR 2026,现在还在被大神们匿名评审。它干了件更颠覆的事,学会了听“概念”。你不用再指指点点,直接用文字告诉它“红色的苹果”或者“所有条纹猫”,它就能心领神会,把图里所有符合描述的东西都给你找出来,一个不落。
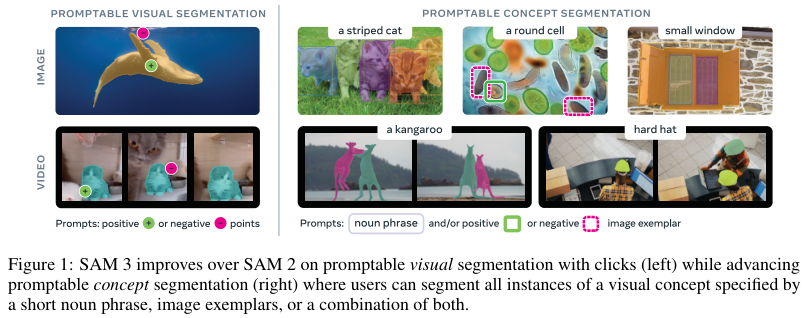
SAM系列就这样,从一个听话的工具,进化成了一个能理解语义的多模态模型。

SAM学会了思考

SAM 3的论文提出了一个新玩法,叫可提示概念分割(Promptable Concept Segmentation, PCS)。

就是你给它一张图或者一段不超过30秒的短视频,然后用一句话、一张示例图,或者两者结合的方式告诉它你要找什么“概念”,它就得把这个概念下的所有实例都检测、分割、并跟踪出来。

这事儿有几个核心的难点和亮点。

首先是开放词汇。它不像以前的分类模型,只能认识固定的几百几千个类别。PCS支持你输入任何名词短语,比如“一只快乐的狗”或者“没关紧的窗户”。

其次是全实例分割。以前的SAM,你点一下,它给你一个结果。现在你跟它说“车”,它就得把画面里所有的车都找出来,并且在视频里,还得认准了哪辆是哪辆,不能跟丢了。

再者是多模态提示。你可以只用文字,全局生效。也可以在某一帧上画个框,告诉它“这个是正样本”或者“这个不是”,让它举一反三。当然,文字和图像示例混着用也行。

最后是用户交互。它抠出来的图要是不够完美,你可以继续用点击的方式告诉它哪里多了,哪里少了,进行微调。

这个任务最大的挑战,在于“概念”本身是模糊的。你说“小窗户”,多小算小?带百叶窗的算不算?为了应对这种人类语言里的不确定性,SAM 3从数据收集、评估指标设计到模型构建,每一步都把这种歧义性考虑了进去。

要完成这么复杂的任务,模型架构自然不能简单。SAM 3的架构在SAM 2的基础上做了扩展,既能玩新的PCS任务,也兼容老的可提示视觉分割(PVS)任务。它用了双编码器-解码器的Transformer架构,里面有一个负责图像的检测器,还有一个负责视频的跟踪器和记忆模块。
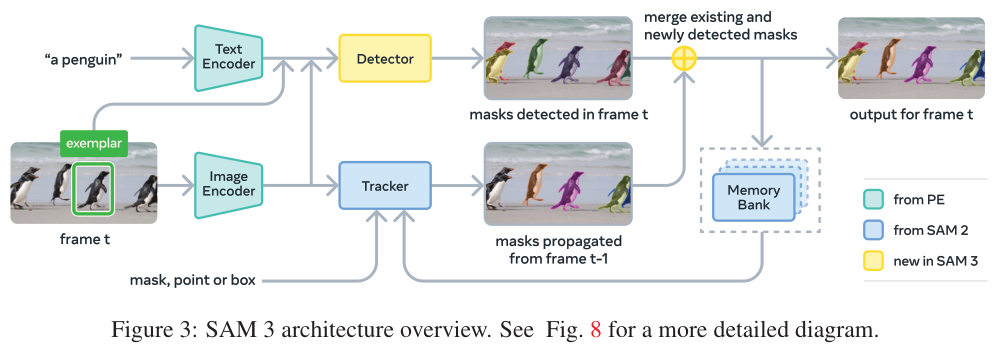
检测器的设计思路,借鉴了DETR(DEformable TRansformer)的范式。图片和文字提示先进去编码,要是有图片示例,也一并编码。这些编码后的信息,统称为“提示标记”。然后,一个融合编码器把这些提示标记和图像信息“搅拌”在一起。最后,一个类似DETR的解码器,通过学习到的对象查询,从融合后的信息里把目标一个个“揪”出来。

每一层的每个对象查询,都会预测两样东西:一个分类结果(这是不是你要找的东西?)和一个边界框的微调。它还用了一个叫“存在标记”(Presence Token)的聪明设计。

这个“存在标记”是SAM 3的一大创新。它把“识别”(这是什么)和“定位”(这东西在哪)这两件事给分开了。

在以前的检测模型里,模型得同时回答“有没有猫?”和“猫在哪里?”这两个问题,有时候会把自己搞糊涂。尤其是在找多个目标的时候,很容易顾此失彼。

SAM 3引入的这个存在标记,是个全局的、可学习的标记。它的唯一工作,就是判断你说的那个概念。

这个设计极大地提升了检测的准确率,尤其是在训练那些带否定词的短语时,比如“没有花的树”。论文里的消融实验显示,加上存在标记后,CGF1(分类门控F1)这个核心指标提升了5.7个点,主要是图像级的识别能力变强了。

SAM 3不仅能听懂文字,还能看懂例子。你可以给它一些带标签的边界框作为图像示例。比如,在一张有很多动物的图里,你圈出一只狗,标记为“正样本”,它就会去找到图里所有其他的狗。这和SAM 1、2那种点一下只出一个结果的模式完全不同,这是真正的举一反三。

对于视频,SAM 3用检测器加跟踪器的组合拳来处理。每一帧画面来了,检测器先找出新出现的目标,同时,跟踪器会把上一帧已经跟踪到的目标传播到当前帧。然后通过一个匹配函数,把新检测到的和跟踪过来的目标合并、更新,实现连贯的跟踪。

为了解决视频里常见的遮挡、拥挤等问题,它还设计了两套时间消歧策略。一是根据一个目标在过去一段时间内被稳定检测到的频率来打分,分数低的就抑制掉。二是用置信度高的检测结果,定期去“校准”跟踪器,防止它跟丢了或者跟错了。

在得到初步的分割结果后,用户还可以用点击来精修。这个过程和SAM 1、2类似,编码点击信息,然后解码器输出一个调整后的掩码。在视频里,这个调整会自动传播到整个片段。

它给自己造了个数据工厂

要让SAM 3学会PCS这种新技能,需要的数据量和多样性是任何现有数据集都无法满足的。所以,研究团队干脆自己动手,造了一个高效的“数据引擎”。

这个引擎的核心思想是一个反馈循环。SAM 3、人类标注员、AI标注员,三者协同工作。引擎会主动去挖掘当前版本SAM 3搞不定的“媒体-短语”组合,也就是专挑模型的弱项进行训练,从而高效地提升模型能力。

更绝的是,他们把一些人类标注员的工作,比如验证掩码质量,也交给了AI。这些AI标注员在特定任务上的表现已经能媲美甚至超过人类。这么一来,整个数据生产的吞吐量直接翻倍。

这个数据引擎的开发分了四个阶段,AI的参与度越来越高,人类则越来越专注于那些最困难、最需要创造力的环节。

一开始,数据引擎还比较原始。随机抽图,用简单的字幕模型和解析器来生成名词短语(NP)提案,然后让SAM 2生成候选掩码,最后完全由人类来验证这些掩码的质量和是否找全了所有实例。这个阶段积累了430万个图像-NP对,构成了初始数据集SA-Co/HQ。

到了第二阶段,事情变得有趣了。团队用第一阶段收集到的人类“接受/拒绝”标签,微调了一个Llama 3.2模型,创造出了AI验证员。这个AI能自动完成大部分掩码验证(MV)和穷举性验证(EV)工作,判断掩码质量好不好,以及有没有漏网之鱼。人类标注员从此解放出来,可以专注于AI搞不定的硬骨头。随着SAM 3和AI验证员的不断迭代升级,数据生产进入了快车道,这个阶段为数据集增加了1.22亿个图像-NP对。

第三阶段的目标是扩展。一方面,用AI去挖掘更有挑战性的案例。另一方面,把数据领域扩展到15个不同的数据集。他们还利用维基数据构建了一个包含2240万个节点的本体论,从中挖掘长尾、细粒度的概念,让模型的知识面更广。这个阶段又增加了1950万个图像-NP对。

最后,引擎扩展到了视频。视频标注的难度远超图像。团队让已经相当成熟的SAM 3来生成视频中的掩码片段,然后让人类标注员重点关注那些拥挤、容易跟丢的失败案例。最终,他们收集了一个包含52500个视频和467000个掩码片段的视频数据集SA-Co/VIDEO。

这个数据引擎本身,就是一项杰出的AI工程。

新考卷上的成绩怎么样?

有了强大的模型和数据引擎,是时候看看SAM 3的真实水平了。为此,团队不仅构建了庞大的训练数据集SA-Co,还专门打造了一套全新的评估基准,也叫SA-Co。

这个基准测试堪称“地狱难度”。它总共包含了21.4万个独特的短语,12.6万张图片和视频,还有超过300万个带“困难否定”标签的样本,专门用来测试模型的开放词汇识别能力。它的概念覆盖范围,比现有所有基准加起来还要大50倍。

评估指标也经过了精心设计。传统的检测指标比如平均精度(AP)不关心模型的置信度校准,导致模型可能在实际使用中并不好用。SA-Co基准只评估置信度高于0.5的预测,模拟了真实应用的场景,逼着模型做出靠谱的判断。

核心指标叫分类门控F1(CGF1),它同时考察了定位能力(pmF1)和分类能力(IL MCC)。简单说,你不仅要找得准,还得先判断对图里到底有没有这东西。

在图像PCS任务上,SAM 3和一众高手进行了比较,包括OWLv2、GroundingDino等专业检测模型,以及Gemini 2.5 Flash这样的通用大模型。
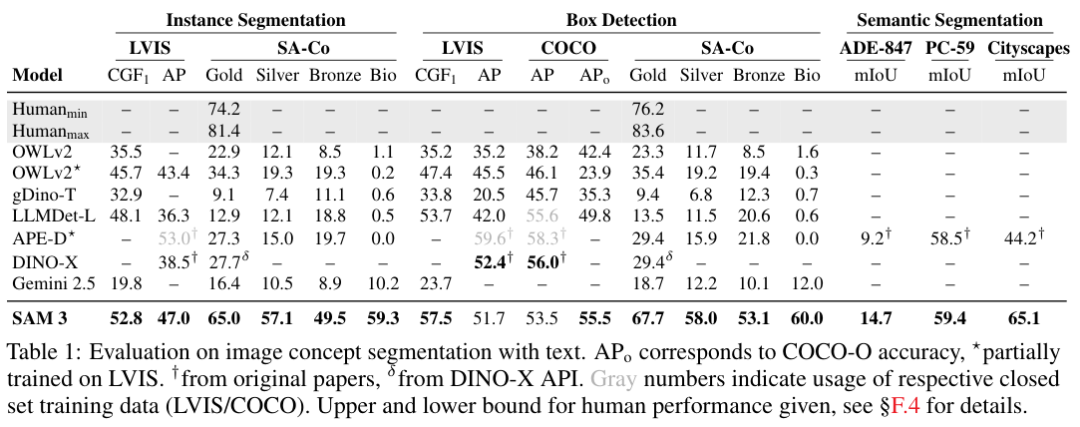
结果是碾压性的。在开放词汇的SA-Co/Gold基准上,SAM 3的CGF1分数达到了最强基线OWLv2⋆的两倍,并且已经达到了人类标注员预估性能下限的88%。在LVIS数据集上,它的零样本掩码AP达到了47.0,比之前的最好成绩高出一大截。
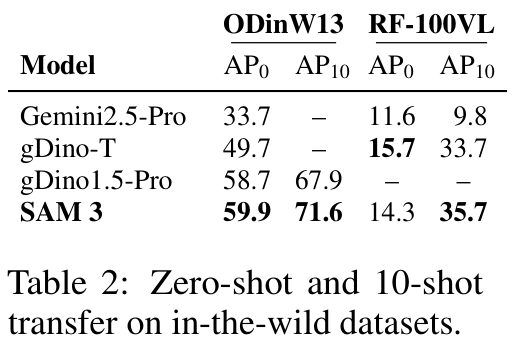
在少样本适应性测试中,SAM 3也展示了强大的学习能力。只需10个样本进行微调,它在ODinW13和Roboflow100-VL这两个数据集上的表现就超过了Gemini和专业的检测模型gDino。
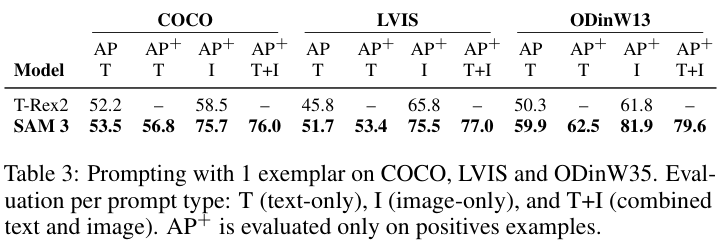
当使用图像示例进行提示时,SAM 3同样表现出色,在COCO、LVIS等数据集上显著优于之前的SOTA模型T-Rex2。
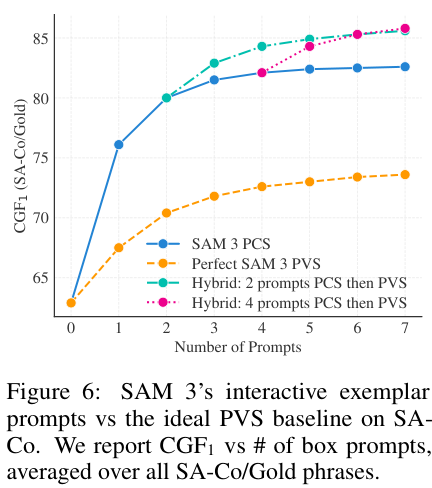
在模拟人类交互的实验中,SAM 3的PCS能力比传统的PVS(点一下改一个)效率高得多。因为它能从你给的示例中泛化,比如你告诉它一个漏掉的目标,它会主动去寻找其他类似的目标。仅仅3次点击交互,PCS的CGF1分数就比纯文本提示高了18.6个点。
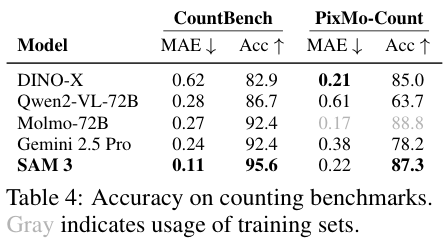
有趣的是,SAM 3还能用来数数。在对象计数基准上,它的准确率和平均绝对误差都优于Qwen2-VL-72B、Gemini 2.5 Pro等一众强大的多模态大语言模型(MLLM)。而且,它在数数的同时,还能把每个对象都给你分割出来,这是绝大多数MLLM做不到的。
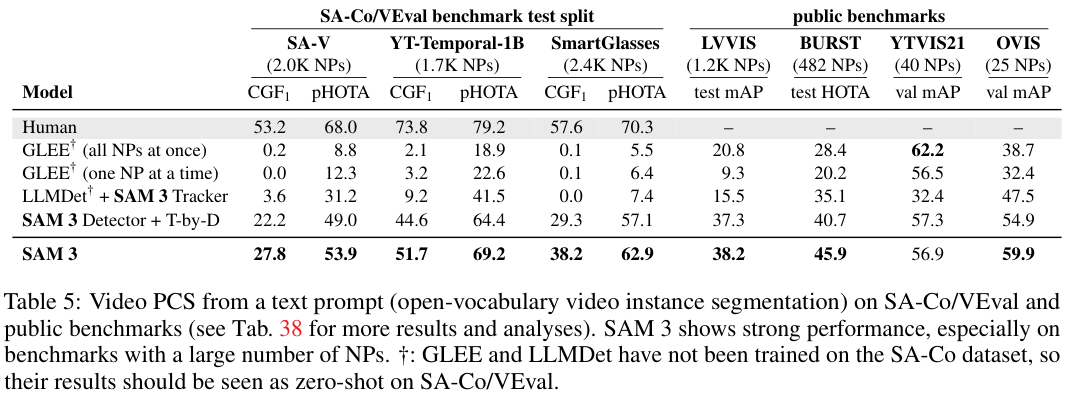
在视频PCS任务上,SAM 3同样大幅领先基线模型,证明了其在复杂动态场景下的强大分割与跟踪能力。
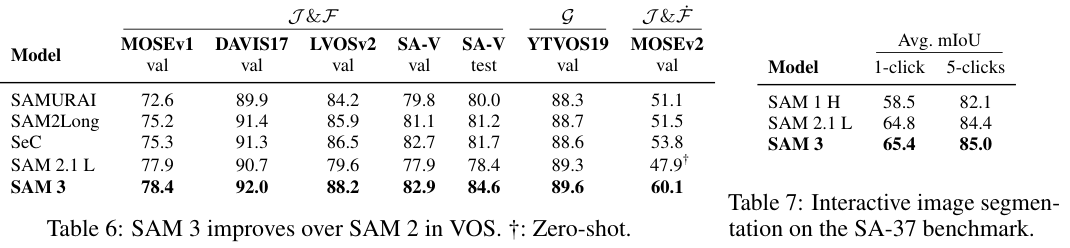
即使是在传统的PVS任务上,SAM 3也比它的前辈SAM 2更强,无论是在视频对象分割还是交互式图像分割上,都取得了更好的成绩。

当SAM有了个“大脑”

SAM 3本身是一个强大的视觉工具,但它的语言理解能力仅限于名词短语。如果把它和一个真正的多模态大语言模型(MLLM)结合,会发生什么?

研究团队做了一个实验,他们把SAM 3当作一个工具,交给一个MLLM来调用,组成了一个所谓的“SAM 3 Agent”。这个Agent可以处理更复杂的、带有逻辑推理的文本查询,比如“坐着但不拿礼物盒的人”。

MLLM负责理解这个复杂句式,把它分解成SAM 3能听懂的简单名词短语(比如“人”、“礼物盒”),然后指挥SAM 3去执行分割,并分析返回的结果,通过逻辑运算(比如求“人”的掩码与“礼物盒”掩码的差集)得到最终答案。
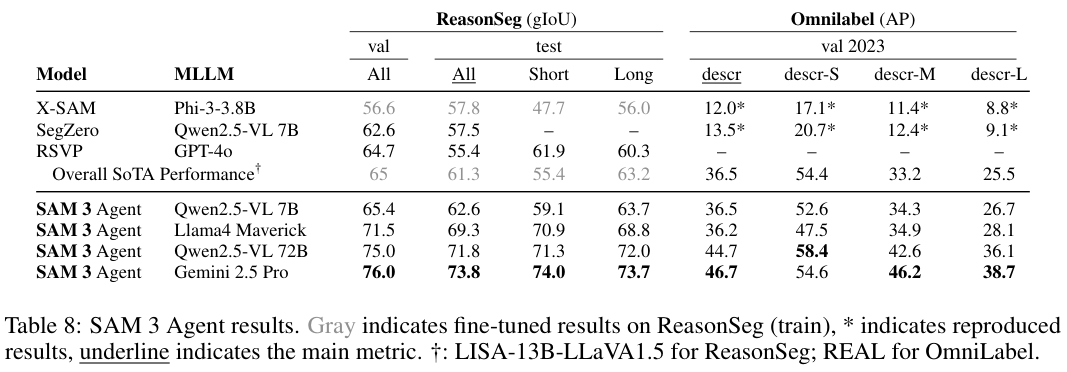
结果惊人。在ReasonSeg和OmniLabel这两个专门测试推理分割的基准上,零样本的SAM 3 Agent全面超越了之前所有经过专门训练的模型。这证明了SAM 3作为一个基础视觉工具的强大和通用性。它可以和各种MLLM即插即用,赋予它们强大的视觉感知和操作能力。

性能方面,SAM 3在一块H200 GPU上处理一张包含100多个对象的图像,只需要30毫秒。处理视频时,只要并发对象不超过5个,基本能做到实时。

当然,SAM 3并非完美。它在医疗影像、热成像这类专业领域的泛化能力还很有限。

在视频中遇到目标特别多的拥挤场景,性能也会下降。

而且,它对语言的理解还停留在短语层面,无法处理复杂的句子,更不具备MLLM那样的语言生成和复杂推理能力。

SAM 3通过引入可提示概念分割,成功地将分割模型从一个简单的视觉交互工具,升级为了一个能理解语义概念的视觉-语言多模态模型。

它的出现,以及其背后那套强大的数据引擎和评测基准,为整个计算机视觉领域树立了新的标杆。

参考资料:

https://openreview.net/forum?id=r35clVtGzw

https://arxiv.org/abs/2304.02643

https://arxiv.org/abs/2408.00714

END

图像分割之SAM(Segment Anything Model) 该模型有别于传统的分割模型。传统分割模型只能输入原图输出固定的分割结果,SAM在设计上可以同时输入原图和特定提示(点、框、阴影、文本),然后根据不同的提示输出不同的分割结果图,并且SAM支持不同提示的交互式分割。SA-1B覆盖了更广泛的图片区间,比第二大分割数据集多了11倍的图片400倍的mask。随着提示点的数量的增加,SAM的分割效果越来越高,随着提示点从1到9的增加,SAM方法和其他分割方法之间的gap越来越小。在论文的交互式分割任务中,有的提示信息,比如点的提示,存在模棱两可的情况。 阅读详情

相关推荐

[医学分割大模型系列] (3) SAM-Med3D 分割大模型详解

发表日期:2023年10月。

qq_38736504的博客 9477

SAM3看这一篇就够了,从模型图示详解到具体快速实践

SAM 3(带概念的片段)是一个统一的基础模型,用于图像和视频中的提示分割。它通过引入开放词汇分割,扩展了SAM 2的功能,使用户除了视觉提示(点、框、遮罩)外,还能使用自然语言文本提示对对象进行分割。该系统可以:1.检测并分割所有由文本或视觉提示指定的概念实例2.在视频帧中跟踪物体,并保持时间一致性3.通过训练数据处理400万+个独特概念4.通过专用API处理单幅图像和视频序列。

2301_79168784的博客 8081

带隙基准电路设计实战:从HSPICE仿真到Virtuoso版图全流程解析

在模拟集成电路设计中,基准电压源是确保系统精度与稳定性的核心模块。其基本原理在于巧妙结合具有正、负温度系数的电压,通过加权求和实现近似零温度系数的稳定输出,这一特性对于高精度数据转换器、电源管理芯片等至关重要。从工程实践角度,利用HSPICE进行深入的直流工作点、温度扫描和工艺角仿真,是验证电路性能、优化温度系数和电源抑制比的关键步骤。而借助Cadence Virtuoso进行版图实现时,必须重点关注电阻与BJT的匹配布局、敏感节点的保护以及电源完整性设计,以确保设计意图在硅片上得以准确呈现。通过完整的从前

weixin_29181861的博客 281

CV/LLM之SAM:SAM 3 的简介、安装和使用方法、案例应用之详细攻略

​ CVLLM之SAM:SAM 3 的简介、安装和使用方法、案例应用之详细攻略 目录 SAM 3的简介 SAM 3的安装和使用方法 SAM 3的案例应用 SAM 3的简介 2025年11月20日,SAM 3 (Segment Anything with Concepts) 是由 Meta Superintelligence Labs 推出的一个统一的基础模型,专为图像和视频中的可提示分割(promptable segmentation)而设计。该模型能够利用文本或视觉

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 3567

SPSS篇—卡方检验

今天依旧跟大家分享一个在SPSS中使用率比较高的分析方法:卡方检验。 在开始做分析之前,我们需要明白两件事情:卡方检验是什么?一般用来干什么?我们只有充分了解分析方法以后才能够正确的使用它。 卡方检验在百科中的解释是:卡方检验是用途非常广的一种假设检验方法,它在分类资料统计推断中的应用,包括:两个率或两个构成比比较的卡方检验;多个率或多个构成比比较的卡方检验以及分类资料的相关分析等。它的原理是...

小白数据营的博客 20万+

报错:subprocess.CalledProcessError: Command ‘[‘where‘, ‘cl‘]‘ returned non-zero exit status 1.

右键此电脑--属性--高级系统设置--环境变量--系统变量--找到Path。Enterprise是企业版,如果你是社区版就找Community。2.安装的时候,c++桌面那个需要勾选。

2301_77554343的博客 1506

SAM 3: 用概念分割万物!与SAM 2和YOLO 对比

摘要:SAM3是Meta发布的可提示概念分割模型,在SAM2基础上新增了通过文本/图像提示检测、分割和跟踪所有实例的能力。该模型支持开放词汇分割,允许使用名词短语或示例图像指定概念,实现了2倍的性能提升。SAM3采用解耦识别与定位的架构,在SA-Co大规模数据集上训练,支持图像级检测和视频级跟踪。相比SAM2和YOLO系列,SAM3更适合开放词汇概念分割任务,在LVIS等基准测试中取得先进结果。模型已集成到Ultralytics包中,提供Python和CLI接口,适用于内容审核、电子商务、医学成像等多种场景

Java_rich的博客 1487

【自然语言处理(NLP)实战】LSTM网络实现中文文本情感分析(手把手与教学超详细)

在当今数字化时代,人们在社交媒体、评论平台以及各类在线交流中产生了海量的文本数据。这些数据蕴含着丰富的情感信息,从而成为了深入理解用户态度、市场趋势,甚至社会情绪的宝贵资源。自然语言处理(NLP)的发展为我们提供了强大的工具,使得对文本情感进行分析成为可能。在这个领域中,长短时记忆网络(LSTM)凭借其能够捕捉文本序列中长距离依赖关系的能力,成为了情感分析任务中的一项重要技术。通过详细的步骤和示例代码,深入了解如何处理中文文本数据、构建LSTM模型、进行训练和评估。

halo的博客 2万+

Meta的SAM 3D和SAM 3来了,不止分割一切,还要3D重建一切

接着,。刚刚,Meta 正式发布了 SAM 3D 和 SAM 3。Meta 不仅开源了模型权重、推理代码和评测数据集,还推出了 Segment Anything Playground 平台,让研究人员和创作者能够直接体验这些前沿技术。SAM 3D 能从图像捕捉对象,无论是否遮挡,然后进行 3D 重建。

SuaniCommunity的博客 1935

使用 Mid360 从零开始搭建实物机器人入门级导航系统 —— 基于 Fast_Lio 和 Move_Base

本文详细介绍了如何使用Mid360机器人从零开始搭建一个基于Fast_Lio和Move_Base的入门级导航系统。通过配置 ROS2、集成激光雷达、IMU、Fast_Lio、Move_Base 等模块,我们成功构建了一个能够实现自动导航的机器人系统。在实际开发中,随着需求的变化,你可以不断调整参数、优化路径规划算法、增加新的传感器等,逐步提升机器人的智能与功能。

小蜗牛的珍贵百宝箱 3562

腾讯云运维工程师认证TCA--真题(最新2022.11)

解析:云原生应用的12要素,1.基准代码:一份基准代码,多份部署;解析:腾讯云主账号具备对其名下资源(包括存储桶)的最大权限,您虽然可以在存储桶策略中限制几乎所有操作,但主账号始终具备 PUT Bucket Policy 操作的权限,主账号调用该操作不检查存储桶策略。解析:瀑布模型将软件生命周期划分为制定计划、需求分析、软件设计、程序编写、软件测试和运行维护等六个基本活动,并且规定了它们自上而下、相互衔接的固定次序,如同瀑布流水,逐级下落。解答:云原生五大关键技术:微服务、容器化、DevOps、持续交付。

e1210101的博客 9909

『分割一切』的尽头是 3D:SAM 3D 刷屏,SAM3 为何被冷落?

2025 年秋季,Meta 在同一次发布中同时端出了两个模型:面向图像与视频的「可提示概念分割」基础模型 SAM 3,以及把分割结果直接推进到三维空间的 SAM 3D。然而仅仅几个月后回头看,两者在舆论场的待遇判若云泥——SAM 3D 以「分割一切进入 3D 时代」「有遮挡也能复原」的叙事刷遍技术媒体,而真正定义了下一代分割范式的 SAM 3,却在大多数讨论里沦为「又一个分割模型」。声量从来不等于

gitblog_01185的博客 159

无痛安装及初始配置 PHP 8.0.3 + Apache 2.4 + MySQL 8.0

PHP 8.0.3 + Apache 2.4 + MySQL 8.0MySQL 8.0.23 安装下载安装配置环境变量初始化MySQLPHP8.0.3 安装下载安装配置环境变量Apache 2.4 安装下载安装启动 MySQL 8.0.23 安装 下载 到官方网站下载:https://dev.mysql.com/downloads/mysql/ 目前的最新版本是MySQL 8.0.23 在Windows上有两种安装方式,一个是zip压缩文件解压然后配置,另一个是图像化界面安装。 这里选择第一种方法安装:

Kuang Da's Blog 6208

SAM2 / SAM3 / SAM3.1 三代同框:中文开发者到底该追哪个版本?

从 2023 年 SAM 引爆「分割一切」,到 2024 年 SAM 2 把能力扩展到视频,再到 2025 年 SAM 3 带着「概念分割」与 ICLR 2026 论文入场、SAM 3.1 把视频追踪效率拉满——不到三年,Meta 的 Segment Anything 家族已经走到第三代。但版本迭代带来的不是简单的「越大越强」,而是**任务范式的分裂**:SAM 2 解决的是「你指哪我切哪」,SA

gitblog_00627的博客 209

VxWorks系列 快速导航

Vxworks系列快速阅览导航

Mr.Sugarcane 1307

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

字节用LLaVA + SAM-2抢先实现了SAM-3,用概念分割一切,而不需要指出位置

同时,这个连接机制还支持梯度的反向传播,也就是说,当视觉大脑的工作结果不够理想时,这个“反馈”可以传回给语言大脑,帮助它学习如何下达更精准的指令。它能“看见”,也能“分割”和“跟踪”,但它听不懂人话。当语言核心理解了你的指令,比如“请分割那个穿黄色连衣裙的女孩”,它不会自己动手去画框,而是生成一段包含这个特殊暗号“[SEG]”的指令,然后把它传递给SAM-2模块。SAM-2看到这个暗号,立刻启动它的编码器和解码器,调动它的时序跟踪记忆模块,在视频里找到那个女孩,并输出一层像素级精准的分割掩码(mask)。

SuaniCommunity的博客 370

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

发布一周年复盘:218 万下载之后,SAM3 到底改变了什么?

2025 年秋,Meta Superintelligence Labs 带着"以概念理解一切"的口号发布了 Segment Anything Model 3(SAM 3),并在 arXiv 上以《SAM 3: Segment Anything with Concepts》(编号 2511.16719)提交论文,随即被 ICLR 2026 收录。彼时距离 SAM 2 发布不过两年,视觉社区的普遍疑问

gitblog_01110的博客 172

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

218 万下载的 SAM3,中文区为什么热不起来?看的人多,写的人少

2025 年 10 月,Meta 发布 SAM 3(Segment Anything Model 3),首次把"分割一切"从像素层面推进到**概念层面**:它不再需要你点一个点、画一个框,你只需要说一句话——"把画面里所有的橙色救生圈找出来"——它就能把符合这个开放词汇概念的所有实例一次性分割出来。这项能力在官方论文里被称为可提示概念分割(Promptable Concept Segmentati

gitblog_00020的博客 124

3 个场景把抖音作品批量收进本地素材库

存一条抖音作品要切五六次软件:截图、复制链接、丢进网页解析、下载完还得手动去水印、改名归档。我一个人攒曲库,攒到第三周直接放弃。直到我把整套流程交给 douyin-downloader,抖音批量下载、去水印、按作者分文件夹这些活,它一条命令全包了。 [![Douzy 抖音下载配置页:作品、喜欢、音乐、合集可勾选](https://raw.gitcode.com/GitHub_Trending/d

gitblog_00257的博客 36

SAM 3:基于单一概念的任意分割

我们提出了Segment Anything Model(SAM)3,这是一个统一的模型,能够基于概念提示在图像和视频中检测、分割并跟踪对象。我们将概念提示定义为简短的名词短语(例如“黄色校车”)、图像示例,或两者的组合。可提示概念分割(Promptable Concept Segmentation, PCS)接收此类提示,并返回所有匹配对象实例的分割掩码及其唯一身份标识。为推进PCS研究,我们构建了一个可扩展的数据引擎,生成了一个高质量数据集,包含400万个独特的概念标签(包括困难负样本),覆盖图像和视频。

AI浩 2585

SAM3:从“分割一切”到“理解万物”

SAM 3实现了从"分割一切"到"理解万物"的跨越,支持通过自然语言、图像示例等多元提示方式完成概念分割。SAM 3D更突破性地实现了单图3D重建,大幅降低了3D内容创作门槛。

围炉漫谈间,一起深聊人工智能、大数据这类前沿科技领域的新动态,在这里为你拆解前沿技术百货的多样精彩。 2980

SAM 3:用概念分割万物——Meta 开源的下一代通用分割模型详解

SAM 3 是一个统一的基础模型,专为可提示的图像与视频分割任务而设计。用户只需提供一段自然语言(如“穿红色球衣的球员”)、一个点、一个框或一张掩码图,SAM 3 就能精准地分割出所有符合描述的对象,并在视频中持续追踪它们。与前代SAM 2✅支持开放词汇(open-vocabulary)文本提示:不再局限于预定义类别,而是能理解任意短语(如“复古风格的咖啡杯”、“左后轮”)。✅穷尽式实例分割(exhaustive segmentation):对给定概念,自动找出图像/视频中所有匹配的实例,而非仅一个。

qq_42910179的博客 2801

一键启动万物分割!SAM3大模型镜像助力高效视觉分析

本文介绍了基于星图GPU平台自动化部署sam3 提示词引导万物分割模型的高效方案。通过该镜像,用户可一键启动WebUI,利用自然语言提示实现图像中多实例的精准分割,适用于AI应用开发、视觉分析与模型微调等场景,显著降低技术门槛。

weixin_35756373的博客 1143

SAM 3 重磅发布!基于文本 / 图像提示搞定图像 / 视频全流程分割,性能直接翻倍

SAM 3 重磅发布!基于文本 / 图像提示搞定图像 / 视频全流程分割,性能直接翻倍

阿旭的博客 3025

SAM3: Segment Anything with Concepts——基于概念的万物分割

SAM3: Segment Anything with Concepts——基于概念的万物分割

Together_CZ的博客 3727

阿旭算法与机器学习 | SAM 3 重磅发布!基于文本 / 图像提示搞定图像 / 视频全流程分割,性能直接翻倍

SAM3是一款视觉大模型,能够在图像和视频中基于概念提示(名词短语或图像示例)进行目标检测、分割和跟踪。其创新点包括:1) 采用共享视觉骨干网络和基于内存的跟踪器架构;2) 引入存在头(PresenceHead)解耦识别与定位;3) 构建包含400万概念的高质量数据集SA-Co。实验表明,SAM3在图像和视频任务上性能较现有系统提升2倍,支持30ms单图像推理和近实时视频跟踪。模型已开源,并展现出良好的多模态协作和领域适配能力。

csdn_xmj的博客 1083
上一篇: 农业AI加速!神农大模型3.0:寒武纪算力底座,训推一体全流程国产优化
下一篇: 谷雨互动赵乾坤 | AI答案时代生存法则:从流量变迁到GEO实践
算网社区
博客等级 码龄1年 250粉丝 850原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值