


✨✨ 欢迎大家来访Srlua的博文(づ ̄3 ̄)づ╭❤~✨✨🌟🌟 欢迎各位亲爱的读者,感谢你们抽出宝贵的时间来阅读我的文章。
我是Srlua小谢,在这里我会分享我的知识和经验。🎥
希望在这里,我们能一起探索IT世界的奥妙,提升我们的技能。🔮
记得先点赞👍后阅读哦~ 👏👏
📘📚 所属专栏:传知代码论文复现
欢迎访问我的主页:Srlua小谢 获取更多信息和资源。✨✨🌙🌙



论文概述
今天来给大家讲解一篇发表在中科院一区顶级期刊上《IEEE Transactions on Cybernetics》的有关于目前人工智能计算机视觉新方向(宽度学习)的文章。作者在这篇文章中基于宽度神经网络提出了一种改进的新模型,融入了模糊规则来提高模型对特殊特征的分辨能力。由于模糊规则的复杂性,本博客用了比较多的博客来讲述,如果大家觉得太难,可以直接下载附件代码先跑起来,从代码入手再回来看数学公式会更直接一点。
该论文作者们提出了一种名为模糊宽度学习系统(BLS)的新型神经模糊模型,通过将Takagi-Sugeno(TS)模糊系统融入BLS而构建。模糊BLS将BLS的特征节点替换为一组TS模糊子系统,并由它们分别处理输入数据。与立即将每个模糊子系统产生的模糊规则输出聚合为一个值不同,模糊BLS将它们全部发送到增强层进行进一步的非线性变换,从而保留输入特性。模糊子系统的去模糊化输出和增强层的输出被组合以获得最终模型输出。前件部分高斯隶属函数的中心以及模糊规则的数量通过k-means方法确定。在模糊BLS中需要计算的参数包括连接增强层输出和模型输出的权重,以及模糊子系统后件部分多项式的随机初始化系数,这些都可以通过解析方法计算。因此,模糊BLS保留了BLS的快速计算特性。
该模糊BLS通过一些流行的回归和分类基准进行评估,并与一些最先进的非模糊和神经模糊方法进行比较。结果表明,模糊BLS在性能上优于其他模型。此外,模糊BLS在模糊规则数量和训练时间方面也优于神经模糊模型,在一定程度上缓解了规则爆炸的问题。

创新点及贡献
-
为了建立一个名为模糊BLS的新神经模糊模型,他们用Takagi-Sugeno(TS)模糊子系统代替BLS左部的特征节点。模糊BLS的显著特征与其他神经模糊方法不同,其创新点如下。
-
模糊BLS包含一组一阶TS模糊子系统,输入数据由每个子系统处理。所有模糊子系统都参与产生模糊BLS的输出,因此它可以受益于这种"集成"结构。 k均值算法用于对输入数据进行分组,并确定每个模糊子系统的模糊规则数量,以及前件部分高斯隶属函数的中心。由于k均值算法的属性,不同的中心将从训练数据为每个模糊子系统生成,这可以确保产生不同的结果。然后尽可能多地提取输入数据的信息。
-
模糊子系统中模糊规则的输出不会立即汇总为一个值。相反,所有模糊子系统产生的中间值被连接为向量,并直接发送到用于非线性转换的增强节点。然后,增强层的输出以及模糊子系统的去模糊输出用于生成最终模型输出。
-
模糊BLS的参数包括连接增强层输出到最终输出层的权重以及每个模糊子系统中模糊规则后件部分的系数,这可以通过伪逆快速计算。因此,模糊BLS保留了BLS的快速计算特性。 算法流程讲解

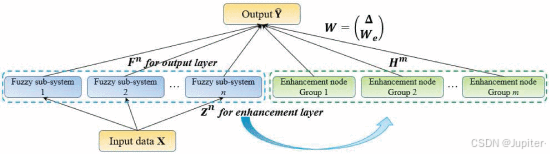


核心代码复现
-
本人在复现时用三个文件来完成本次项目,分别是main.py文件作为顶层文件调用所有函数和方法;utils.py文件作为工具文件,封装了一些所需要用到的方法;FBLS.py文件中实现了Fuzzy规则和BLS结合的新型宽度神经网络模型——FBLS,下面我们将分别给出他们的伪代码来进一步帮大家理解。
main.py文件
<span style="background-color:#f8f8f8"><span style="color:#333333">开始
|
|---> 导入 numpy 和 scipy.io 中的 loadmat 和 savemat 函数
|---> 导入 random 和 FBLS 模块中的 bls_train 函数
|
|---> 定义主函数 main():
|        |
|        |---> 从 MATLAB 文件 <span style="color:#aa1111">'wbc.mat'</span> 中加载数据
|        |        data <span style="color:#981a1a">=</span> loadmat(<span style="color:#aa1111">'wbc.mat'</span>)
|        |        train_x <span style="color:#981a1a">=</span> data[<span style="color:#aa1111">'train_x'</span>]
|        |        train_y <span style="color:#981a1a">=</span> data[<span style="color:#aa1111">'train_y'</span>]
|        |        test_x <span style="color:#981a1a">=</span> data[<span style="color:#aa1111">'test_x'</span>]
|        |        test_y <span style="color:#981a1a">=</span> data[<span style="color:#aa1111">'test_y'</span>]
|        |
|        |---> 转换测试集
|        |        n <span style="color:#981a1a">=</span> 随机生成一个置换数组,长度为 test_x.shape[0]
|        |        使用置换数组 n 的前 <span style="color:#116644">140</span> 行来更新 test_x 和 test_y,并将它们转换为 np.float64 类型
|        |        train_y 和 test_y 转换为二元标签 (-1, <span style="color:#981a1a">+</span><span style="color:#116644">1</span>)
|        |
|        |---> 初始化常数和变量
|        |        C <span style="color:#981a1a">=</span> <span style="color:#116644">2</span> ** <span style="color:#0000cc">-30</span>
|        |        s <span style="color:#981a1a">=</span> <span style="color:#116644">0</span>.8
|        |        best <span style="color:#981a1a">=</span> <span style="color:#116644">0</span>.72
|        |        result <span style="color:#981a1a">=</span> 空列表
|        |
|        |        NumRule <span style="color:#981a1a">=</span> <span style="color:#116644">2</span>
|        |        NumFuzz <span style="color:#981a1a">=</span> <span style="color:#116644">6</span>
|        |        NumEnhan <span style="color:#981a1a">=</span> <span style="color:#116644">20</span>
|        |
|        |---> 设置随机种子为 <span style="color:#116644">1</span>,生成 Alpha 和 WeightEnhan
|        |        Alpha <span style="color:#981a1a">=</span> 空列表
|        |        对于 i 从 <span style="color:#116644">0</span> 到 NumFuzz-1:
|        |            生成大小为 (train_x.shape[1], NumRule) 的随机数组 alpha
|        |            将 alpha 添加到 Alpha
|        |
|        |        生成大小为 (NumFuzz * NumRule <span style="color:#981a1a">+</span> <span style="color:#116644">1</span>, NumEnhan) 的随机数组 WeightEnhan
|        |
|        |---> 打印模糊规则数、模糊系统数和增强器数
|        |        打印字符串 <span style="color:#aa1111">'Fuzzy rule No.= {NumRule}, Fuzzy system No. ={NumFuzz}, Enhan. No. = {NumEnhan}'</span>
|        |
|        |---> 调用 bls_train 函数进行模型训练和测试
|        |        调用 bls_train(train_x, train_y, test_x, test_y, Alpha, WeightEnhan, s, C, NumRule, NumFuzz)
|        |        返回 NetoutTest, Training_time, Testing_time, TrainingAccuracy, TestingAccuracy
|        |
|        |---> 计算总时间,并将结果保存到 result 列表中
|        |        total_time <span style="color:#981a1a">=</span> Training_time <span style="color:#981a1a">+</span> Testing_time
|        |        将 [NumRule, NumFuzz, NumEnhan, TrainingAccuracy, TestingAccuracy] 添加到 result 列表
|        |
|        |---> 如果 TestingAccuracy 比 best 大,则更新 best,并将结果保存到 <span style="color:#aa1111">'optimal.mat'</span> 文件中
|        |        如果 best < TestingAccuracy:
|        |            更新 best 为 TestingAccuracy
|        |            将 {<span style="color:#aa1111">'TrainingAccuracy'</span>: TrainingAccuracy, <span style="color:#aa1111">'TestingAccuracy'</span>: TestingAccuracy,
|        |                 <span style="color:#aa1111">'NumRule'</span>: NumRule, <span style="color:#aa1111">'NumFuzz'</span>: NumFuzz, <span style="color:#aa1111">'NumEnhan'</span>: NumEnhan, <span style="color:#aa1111">'time'</span>: total_time}
|        |            保存到 <span style="color:#aa1111">'optimal.mat'</span>
|        |
|        |---> 将 result 列表保存到 <span style="color:#aa1111">'result.mat'</span> 文件中
|        |        将 {<span style="color:#aa1111">'result'</span>: np.array(result)} 保存到 <span style="color:#aa1111">'result.mat'</span>
|        |
|        |---> 打印字符串 <span style="color:#aa1111">'Results saved!'</span>
|
|---> 如果运行在主模块下:
|        调用主函数 main()
|
结束</span></span>-
在main.py文件中,我们将FBLS模型封装在bls_train函数中,加载好数据集之后输入模型中进行训练,并编写代码对输出的结果进行测试,打印出评价指标。
FBLS.py文件
<span style="background-color:#f8f8f8"><span style="color:#333333">开始
|
| 返回 <span style="color:#116644">2</span> / (1 <span style="color:#981a1a">+</span> exp(-2 * x)) <span style="color:#0000cc">-</span> <span style="color:#116644">1</span>
|
|---> 函数 result_tra(output):
| 返回 argmax(output, <span style="color:#0000ff">axis</span><span style="color:#981a1a">=</span><span style="color:#116644">1</span>)
|
|---> 函数 bls_train(train_x, train_y, test_x, test_y, Alpha, WeightEnhan, s, C, NumRule, NumFuzz):
| |
| |---> std <span style="color:#981a1a">=</span> <span style="color:#116644">1</span>
| |---> 记录开始时间
| |
| |---> 设置 H1 为 train_x
| |---> 初始化 y 为大小 (train_x.shape[0], NumFuzz * NumRule) 的零矩阵
| |---> 初始化 CENTER 为一个空列表
| |---> 初始化 <span style="color:#3300aa">ps</span> 为一个空列表
| |
| |---> 循环 i 从 <span style="color:#116644">0</span> 到 NumFuzz-1:
| | |
| | |---> 设置 b1 为 Alpha[i]
| | |---> 初始化 t_y 为大小 (train_x.shape[0], NumRule) 的零矩阵
| | |---> 使用 NumRule 个聚类对 train_x 进行 KMeans 聚类,并将中心设置为聚类中心
| | |
| | |---> 循环 j 从 <span style="color:#116644">0</span> 到 train_x.shape[0]-1:
| | | |
| | | |---> 计算 MF 为 exp(-sum((train_x[j, :] <span style="color:#0000cc">-</span> center) ** <span style="color:#116644">2</span>) / std)
| | | |---> 将 MF 归一化
| | | |---> 设置 t_y[j, :] 为 MF * (train_x[j, :].dot(b1))
| | |
| | |---> 将 center 添加到 CENTER
| | |---> 初始化 scaler 为范围 (0, <span style="color:#116644">1</span>) 的 MinMaxScaler
| | |---> 使用 scaler 对 t_y 进行拟合和变换,并将结果设置为 T1
| | |---> 将 scaler 添加到 <span style="color:#3300aa">ps</span>
| | |---> 设置 y[:, NumRule * i:NumRule * (i <span style="color:#981a1a">+</span> <span style="color:#116644">1</span>)] 为 T1
| |
| |---> 将 y 与一个全为 <span style="color:#116644">0</span>.1 的列连接起来形成 H2
| |---> 计算 T2 为 H2 dot WeightEnhan
| |---> 设置 l2 为 s / max(T2)
| |---> 对 T2 乘以 l2 应用 tansig
| |---> 将 y 与 T2 连接起来形成 T3
| |
| |---> 计算 beta 为 inverse(T3.T dot T3 <span style="color:#981a1a">+</span> eye(T3.shape[1]) * C) dot T3.T dot train_y
| |---> 记录训练时间
| |---> 打印 <span style="color:#aa1111">'Training has been finished!'</span> 和训练时间
| |---> 计算 NetoutTrain 为 T3 dot beta
| |
| |---> 设置 yy 为 result_tra(NetoutTrain)
| |---> 设置 train_yy 为 result_tra(train_y)
| |---> 计算 TrainingAccuracy 为 mean(yy <span style="color:#981a1a">==</span> train_yy)
| |---> 打印训练准确率
| |
| |---> 记录开始时间
| |
| |---> 设置 HH1 为 test_x
| |---> 初始化 yy1 为大小 (test_x.shape[0], NumFuzz * NumRule) 的零矩阵
| |
| |---> 循环 i 从 <span style="color:#116644">0</span> 到 NumFuzz-1:
| | |
| | |---> 设置 b1 为 Alpha[i]
| | |---> 初始化 t_y 为大小 (test_x.shape[0], NumRule) 的零矩阵
| | |---> 设置 center 为 CENTER[i]
| | |
| | |---> 循环 j 从 <span style="color:#116644">0</span> 到 test_x.shape[0]-1:
| | | |
| | | |---> 计算 MF 为 exp(-sum((test_x[j, :] <span style="color:#0000cc">-</span> center) ** <span style="color:#116644">2</span>) / std)
| | | |---> 将 MF 归一化
| | | |---> 设置 t_y[j, :] 为 MF * (test_x[j, :].dot(b1))
| | |
| | |---> 设置 scaler 为 <span style="color:#3300aa">ps</span>[i]
| | |---> 使用 scaler 变换 t_y 并将结果设置为 TT1
| | |---> 设置 yy1[:, NumRule * i:NumRule * (i <span style="color:#981a1a">+</span> <span style="color:#116644">1</span>)] 为 TT1
| |
| |---> 将 yy1 与一个全为 <span style="color:#116644">0</span>.1 的列连接起来形成 HH2
| |---> 对 HH2 dot WeightEnhan 乘以 l2 应用 tansig
| |---> 将 yy1 与 TT2 连接起来形成 TT3
| |
| |---> 计算 NetoutTest 为 TT3 dot beta
| |---> 设置 y 为 result_tra(NetoutTest)
| |---> 设置 test_yy 为 result_tra(test_y)
| |---> 计算 TestingAccuracy 为 mean(y <span style="color:#981a1a">==</span> test_yy)
| |---> 记录测试时间
| |---> 打印 <span style="color:#aa1111">'Testing has been finished!'</span> 和测试时间
| |---> 打印测试准确率
| |
| |---> 返回 NetoutTest, Training_time, Testing_time, TrainingAccuracy, TestingAccuracy
|
</span></span>在FBLS.py文件中,我们完整地复现了FBLS模型的代码,依照上面提到的算法流程一比一实现了FBLS从输入数据到输出测试结果的过程。
使用方法
-
在FBLS.py文件中我们已经封装好了结果,因此我们可以直接在main.py文件中调用我们想要的数据集并进行训练。
首先,我们需要把本地的数据集放入到当前目录中然后修改数据集名称为大家本地的数据集名称,或者给出它的绝对路径:data=loadmat(‘文件名的绝对路径’) 
-
这里我们的数据集中有四个变量:train_x,train_y,test_x,test_y,分别存储的训练集的数据、标签和测试集的数据、标签,标签采用独热编码。
-
然后在这里,我们可以修改模型的超参数(模糊规则数、模糊节点数和增强层数量)来使我们的模型拟合到最优结果

测试结果
-
在一次训练测试结束后,我们可以看到最后的结果,训练精度和测试精度都可以达到97%。

我们可以修改一下超参数,让 NumRule = 10,NumFuzz = 20,NumEnhan = 100
 可以看到现在模型训练精度虽然达到了100%,但是测试精度出现了下降,这就说明我们参数调的太大让模型出现了过拟合现象,具体的调参大家可以根据自己的数据集来调整。
环境配置
-
本次使用的python版本最好为python3.8及以上
-
使用的库函数包括numpy、scipy、sklearn和random
-
本文所有资源均可在该地址处获取。

希望对你有帮助!加油!
若您认为本文内容有益,请不吝赐予赞同并订阅,以便持续接收有价值的信息。衷心感谢您的关注和支持!

 1824


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


