果断收藏!AI绘图文字设计指南;将文本创建为漂亮时间线;伯克利·全栈深度学习训练营课程;CMU·数据库系统系列课程;前沿论文 | ShowMeAI资讯日报

论文研读系列——“TabDDPM: Modelling Tabular Data with Diffusion Models” TabDDPM: Modelling Tabular Data with Diffusion Models arxiv [Submitted on 30 Sep 2022] 链接:arXiv:2209.15421 代码:https://github.com/rotot0/tab-ddpm 摘要 本文介绍了 TabdDPM,这是一种旨在使用扩散模型生成表格数据的新模型,该模型在计算机视觉和语音处理等领域很受欢迎。TabdDPM 之所以独一无二,是因为它可以处理不同类型的数据特征,例如连续和离散的数据特征,因此 阅读详情

👀日报合辑 | 📆电子月刊 | 🔔公众号下载资料 | 🍩@韩信子

📢 『A Beginner’s Guide to Prompt Design for Text-to-Image Generative Models』从文本到图像,生成模型的提示设计 · 入门指南

https://towardsdatascience.com/a-beginners-guide-to-prompt-design-for-text-to-image-generative-models-8242e1361580

随着 Stable Diffusion、Midjourney 和 DALL·E2 的发布,使用文字提示生成图像成为新的潮流。如何使用尽可能少的提示文字来获得喜欢的图像呢?这里有一份通用的入门指南。

指南以『a cat wearing a pair of sunglasses (一只猫戴着一副太阳镜)』为基本提示文字,在 DreamStudio 中尝试改进文字以生成满意的图像。总结起来的基本技巧有:定义细粒度的艺术形式、添加风格或艺术家、添加增强形容词等。
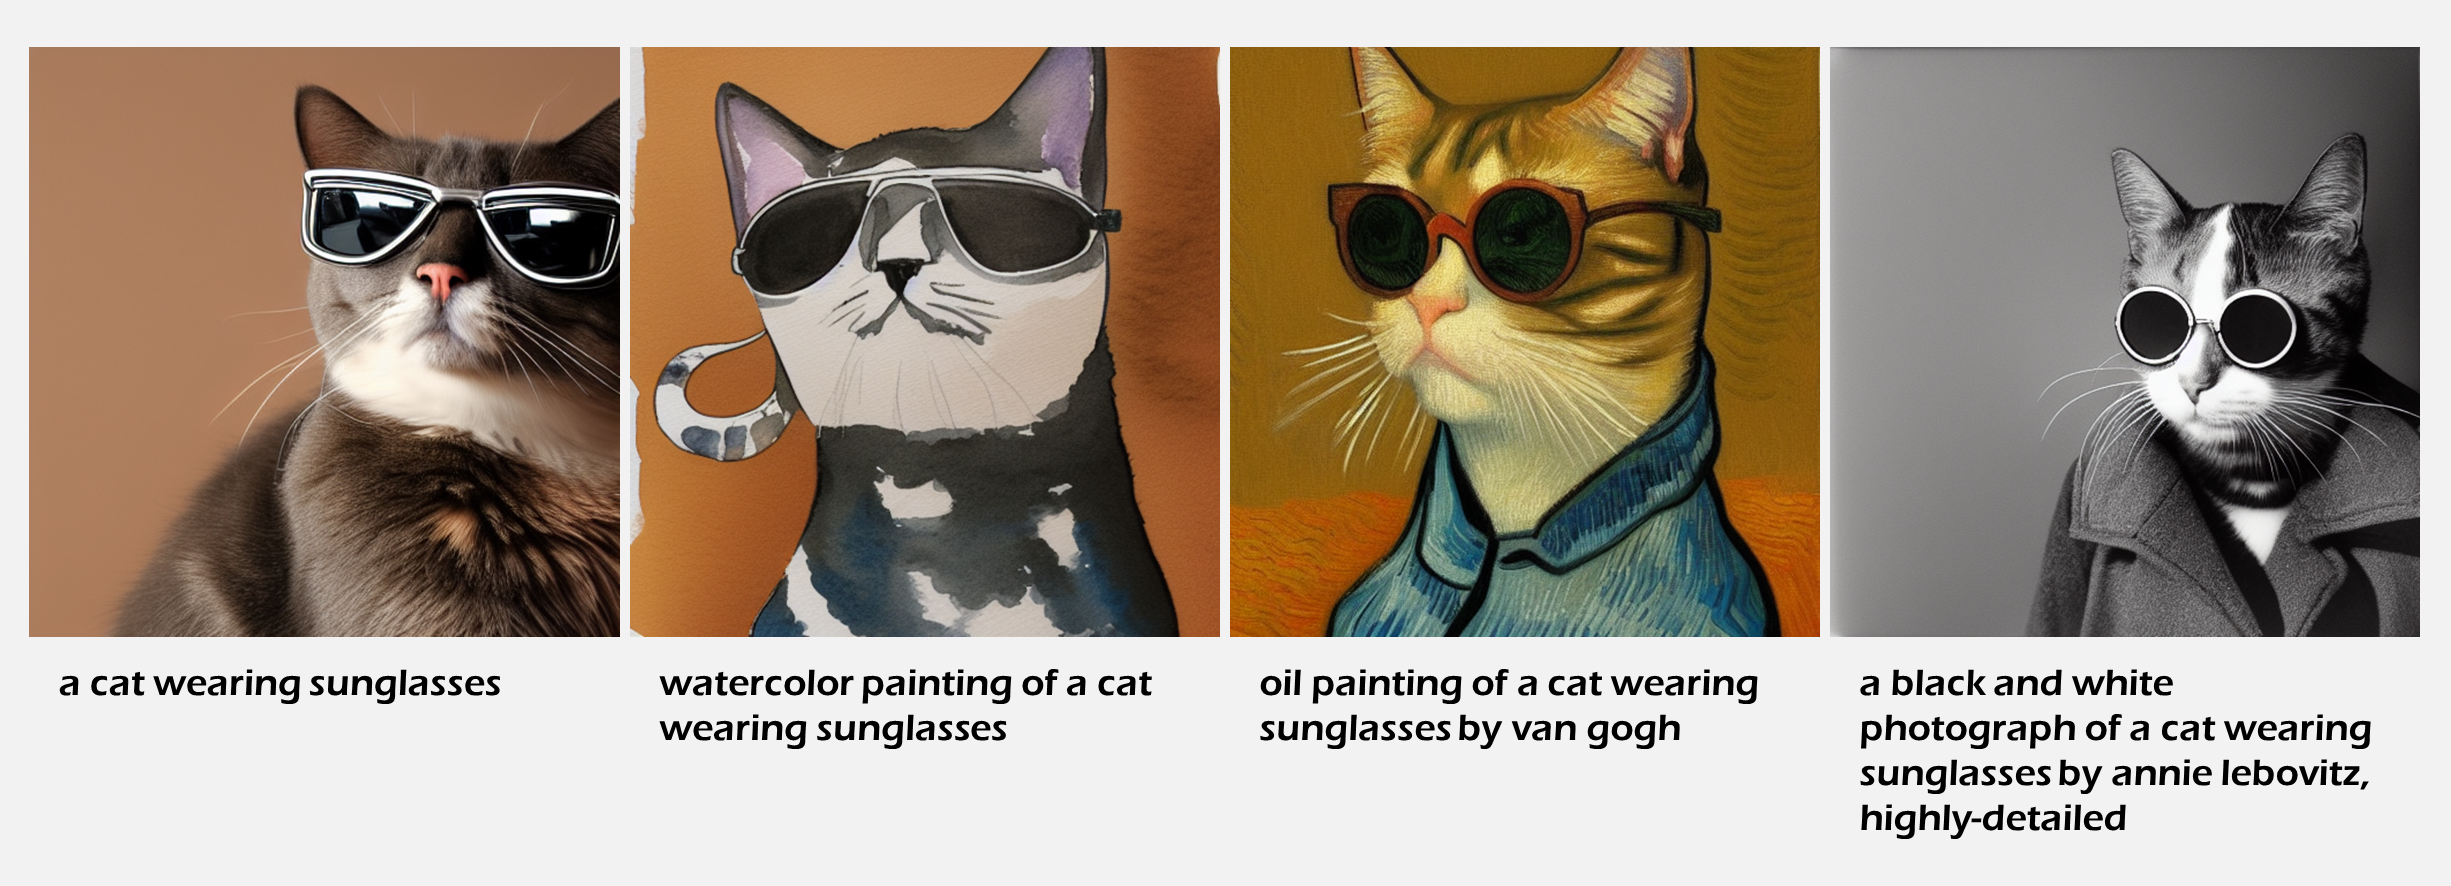
将文章建议的候选描述词整理如下

◉ 基础设置
提示长度应相对较短Midjourney 在60个单词以内,DALL·E2 在 400 个单词以内
提示文字的语言使用英语
一个不错的文字模板[艺术形式] of [主题] by [艺术家], [细节 1], …, [细节 n]
◉ 艺术形式
摄影(photography)studio photography, polaroid, camera phone
绘画(paintings)oil paintings, portraits, watercolor paintings
插图(illustrations)pencil drawing, charcoal sketch, etching, cartoon, concept art, posters,
数字艺术(digital art)3D renders, vector illustrations, low poly art, pixel art, scan
电影剧照(film stills)movies, CCTV
◉ 风格或艺术家
建议1混合两个或更多艺术家
建议2使用虚构艺术家
◉ 细节:形容词和质量提升器
取景close up, landscape, portrait, wide shot
配色方案dark, pastel
照明cinematic lighting, natural light
其他epic, beautiful, awesome

工具&框架

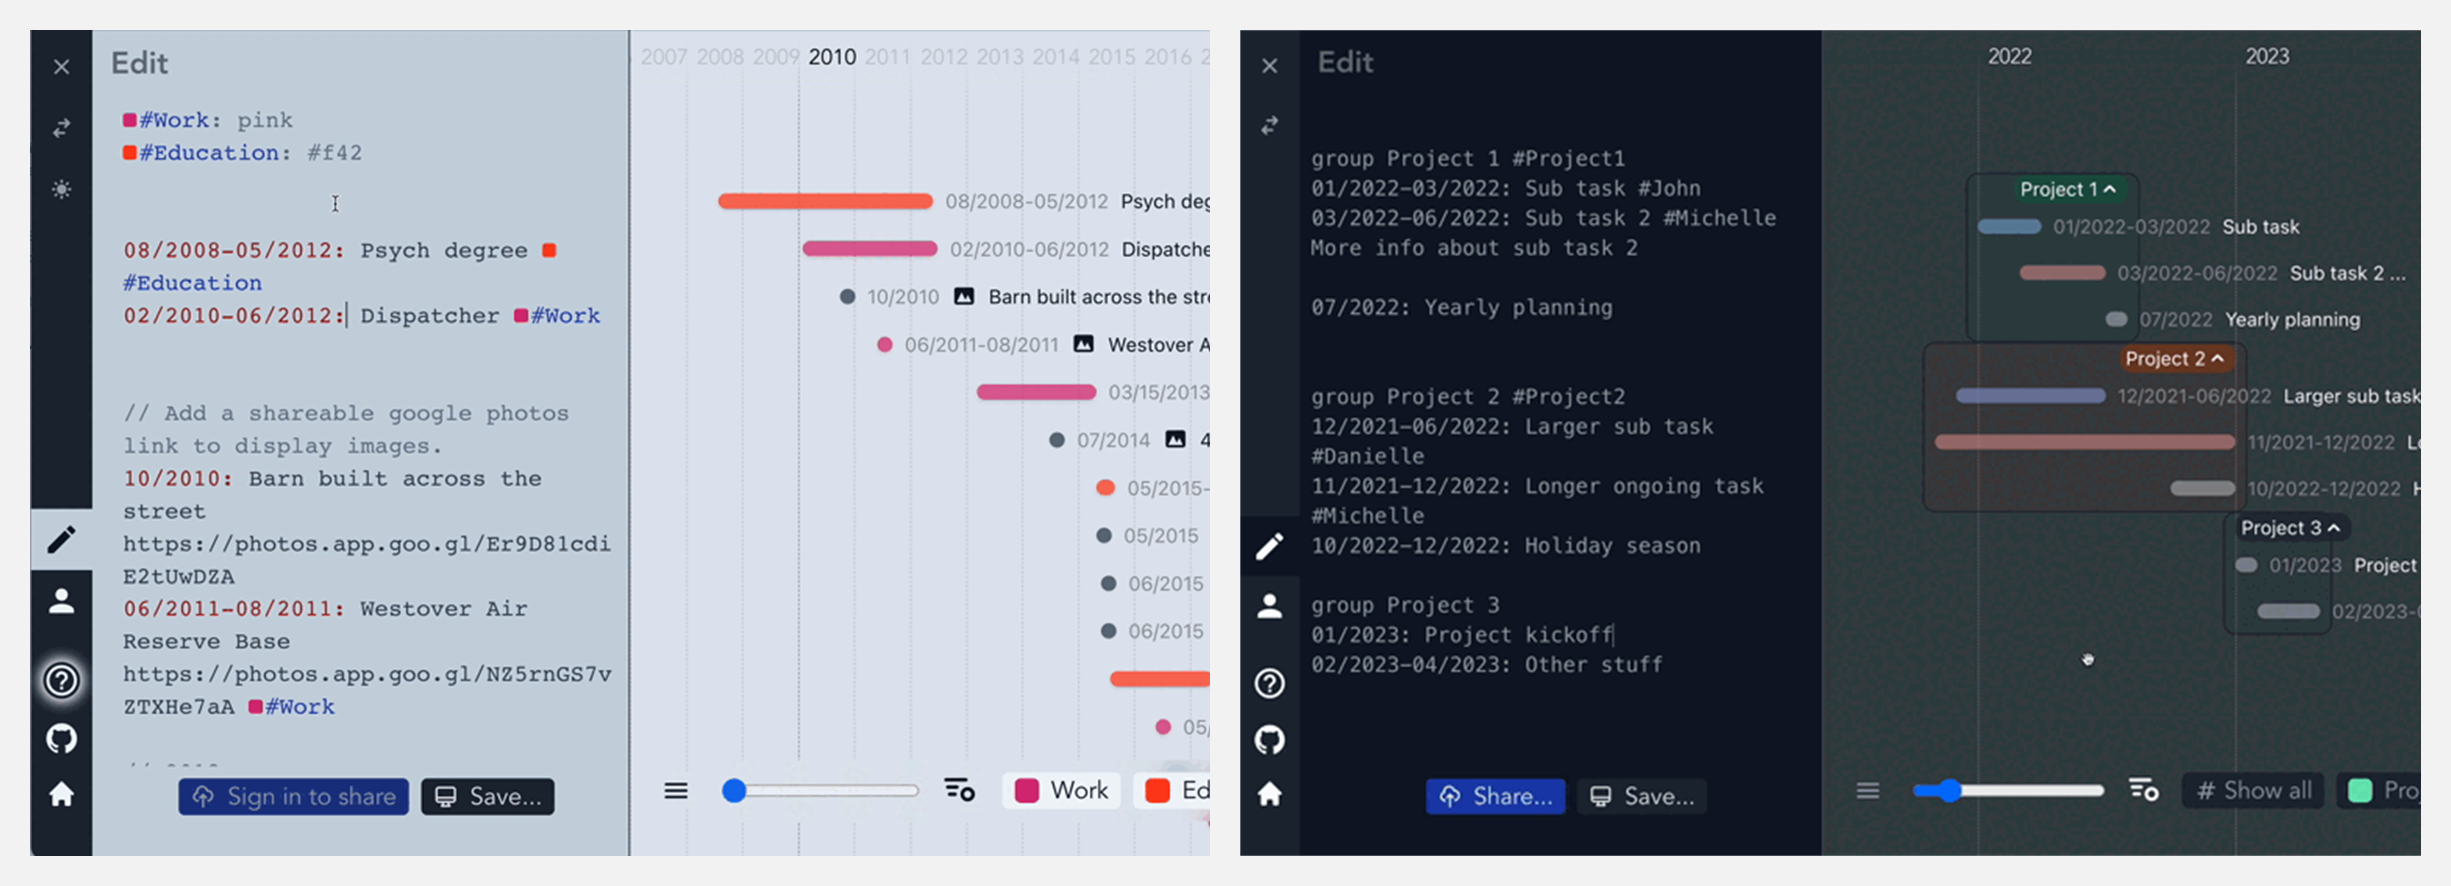
🚧 『Markwhen』将文本创建为漂亮的级联时间线

https://github.com/kochrt/markwhen

https://markwhen.com/

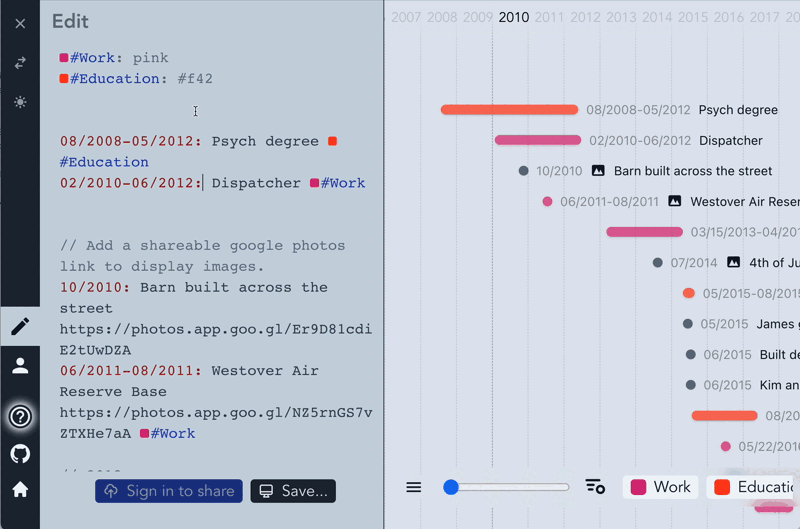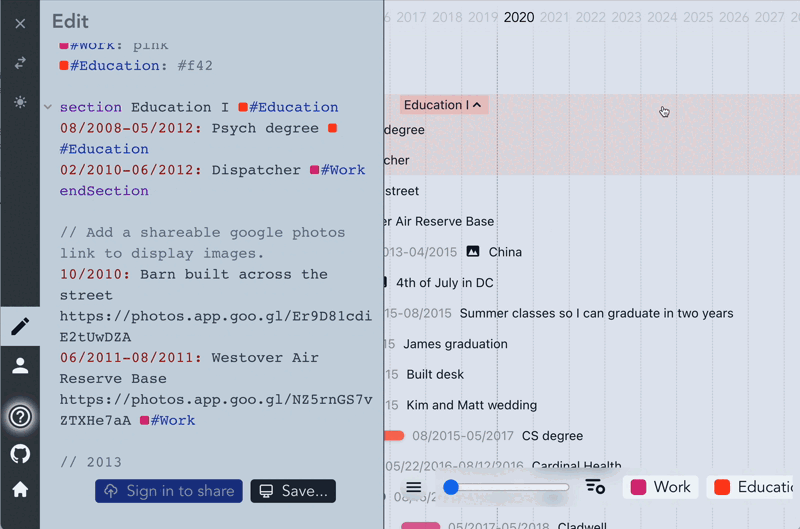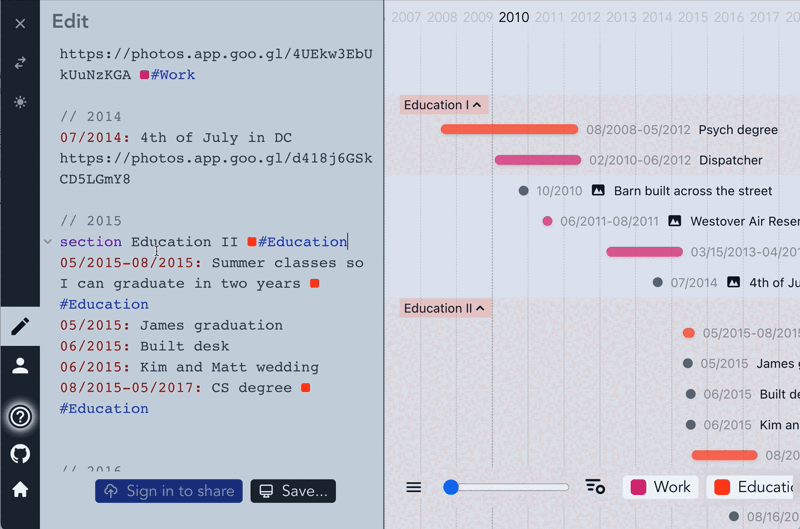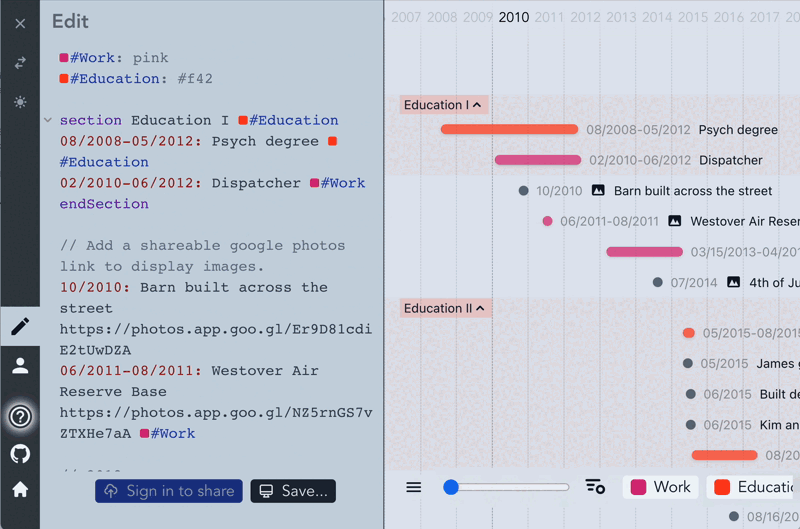
Markwhen是一个文本到时间线处理工具,它可以将类似 Markdown 的文本创建为漂亮的级联时间线。大家可以在上放第二个链接的在线网站体验它的功能效果。
🚧 『Go Recipes』Go 语言工具集锦

https://github.com/nikolaydubina/go-recipes

这个项目汇集了 Go 语言会用到的工具,知名的或鲜为人知的宝藏,包括测试、依赖、代码可视化、静态分析、代码生成、编译、执行等相关的工具。
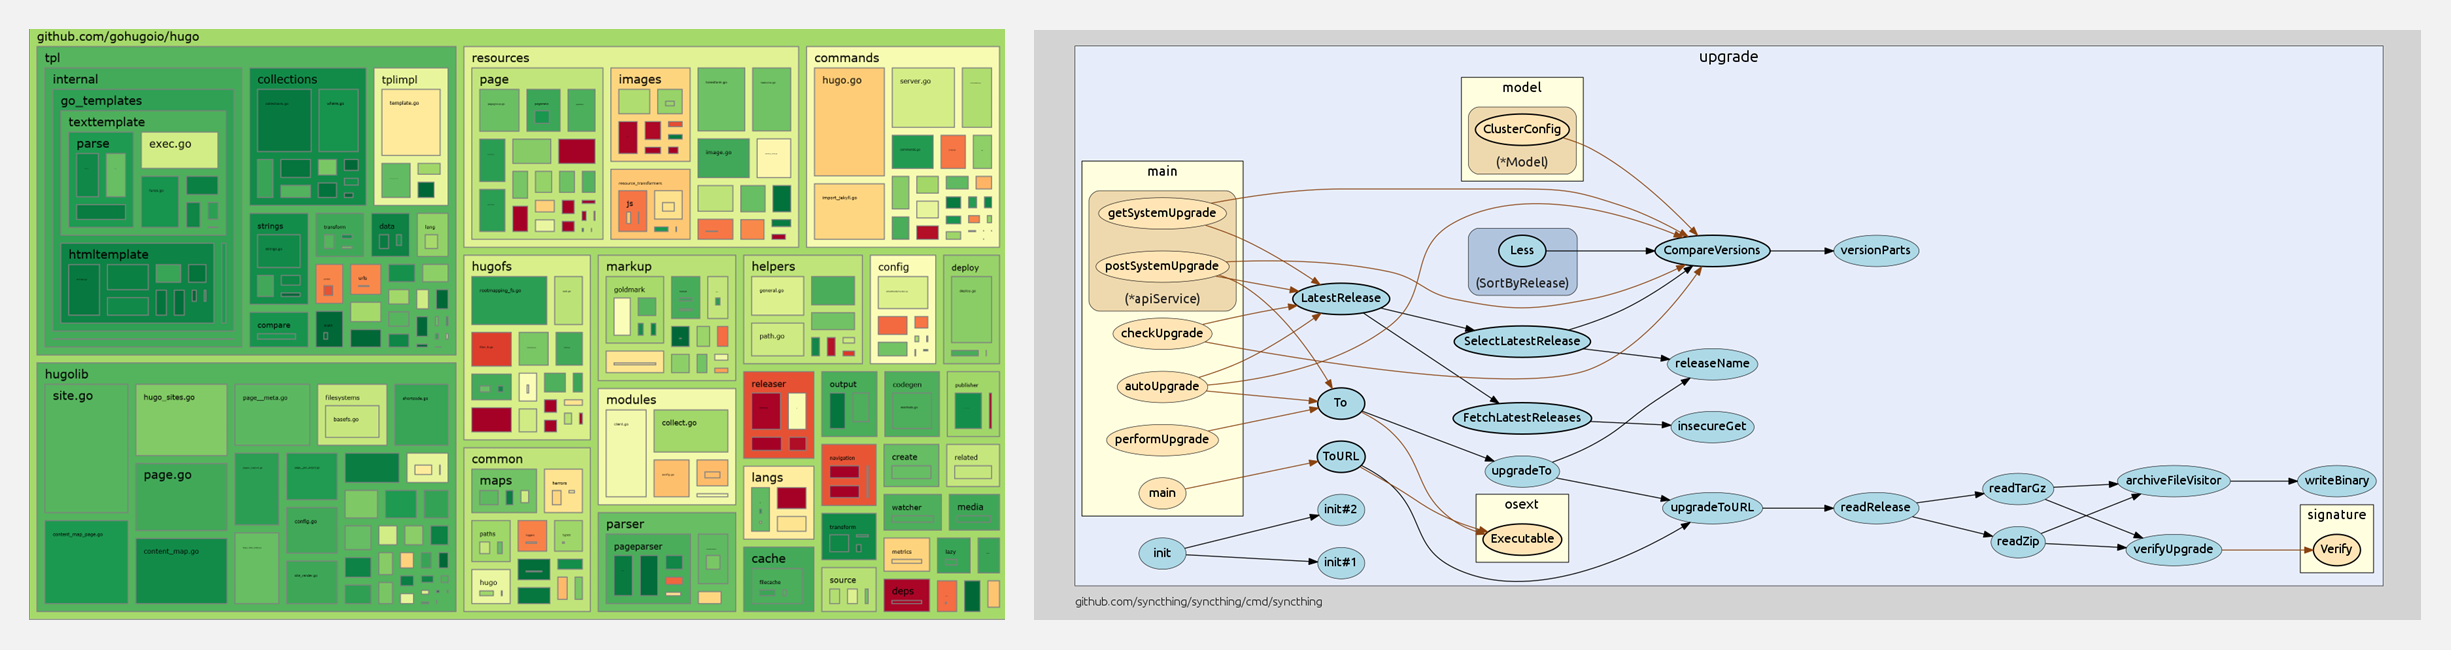
⬆ 测试 · 制作代码覆盖率树状图 & 代码可视化·制作包中的函数调用图
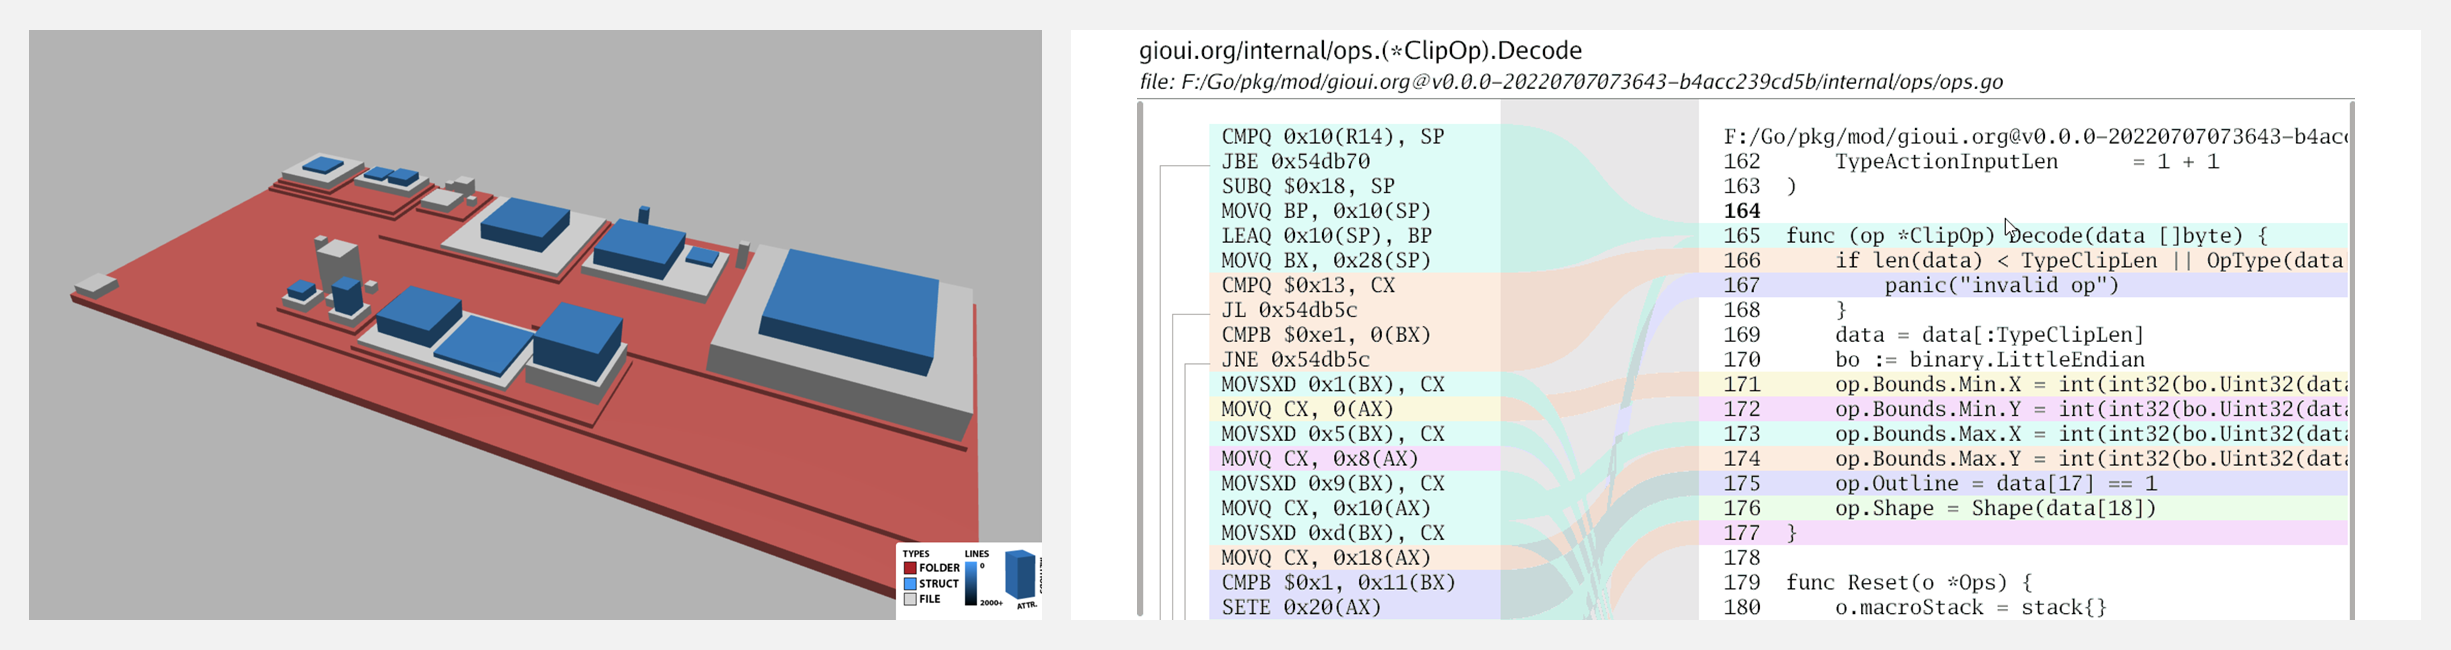
⬆ 代码可视化·制作 Go 代码库的 3D 图表 & 编译·以交互方式查看 Go 程序集

🚧 『Deep-loglizer』基于深度学习的日志分析异常检测工具包

https://github.com/logpai/deep-loglizer

https://arxiv.org/abs/2107.05908

Deep-loglizer是一个基于深度学习的日志分析工具包,用于自动异常检测。支持的模型包括:LSTM,Transformer,Autoencoder,Supervised models,Attentional BiLSTM,CNN。
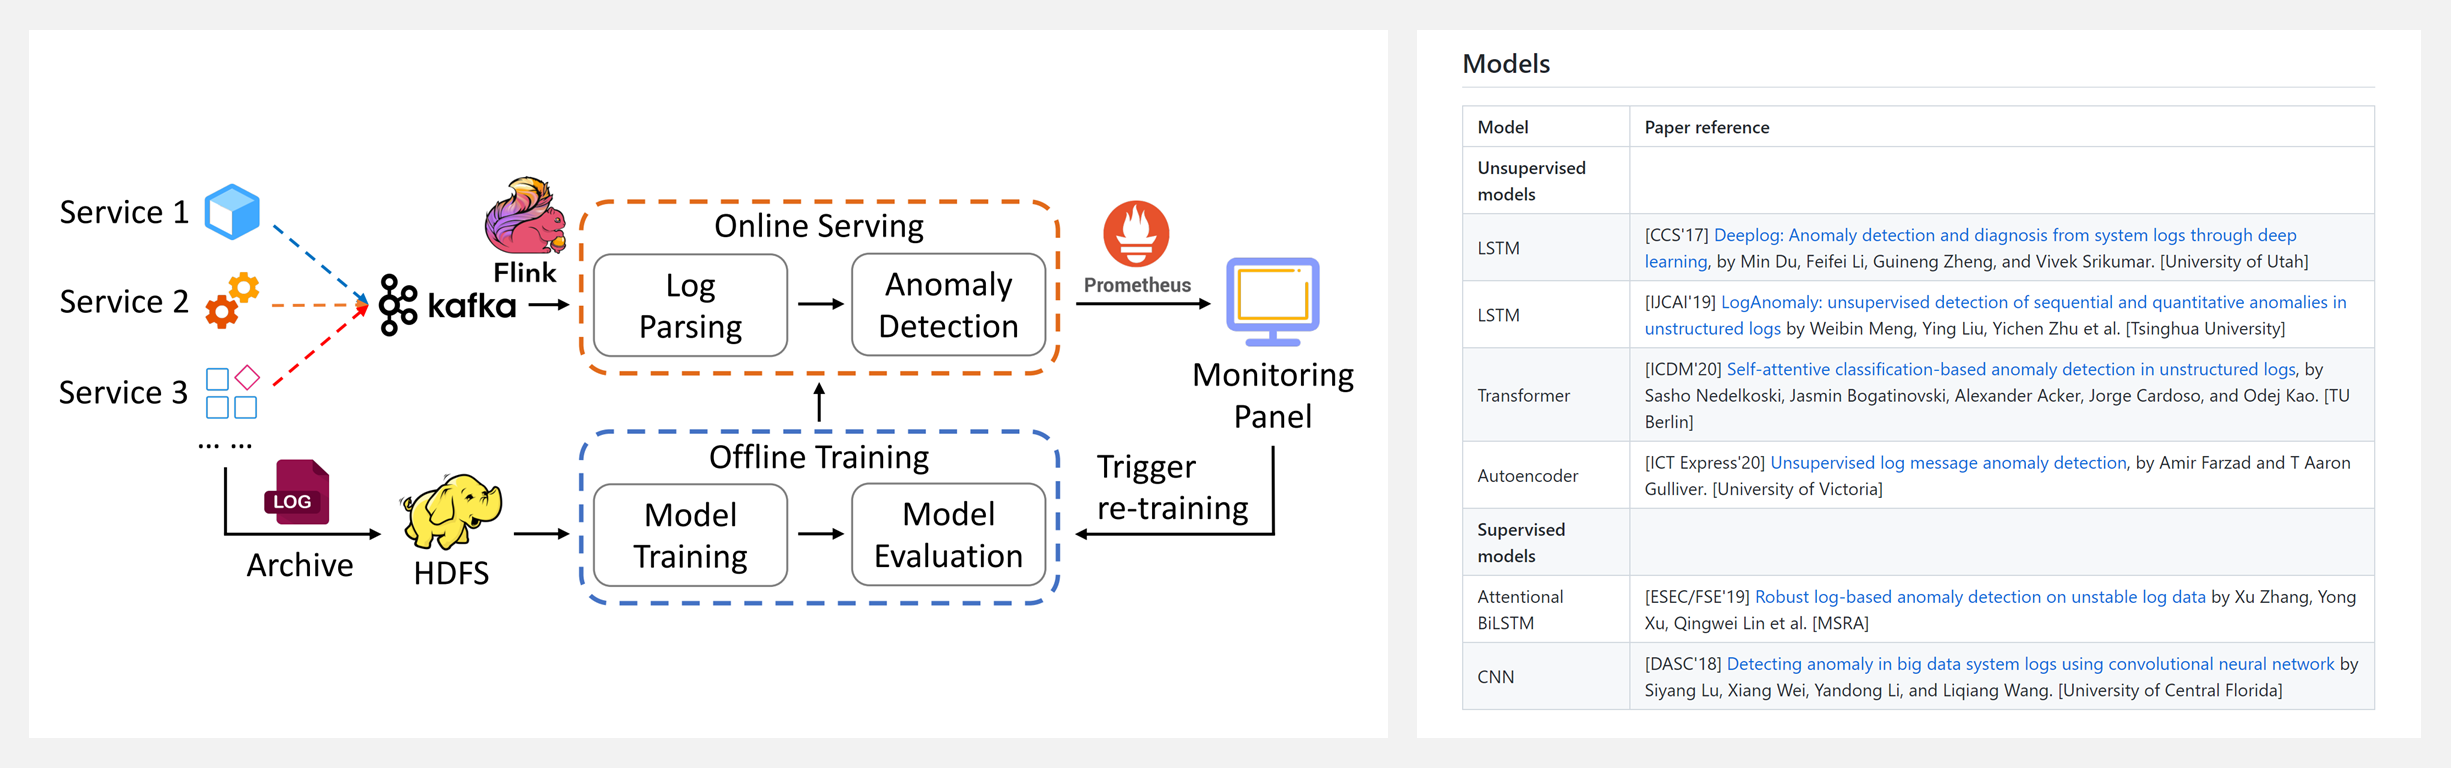
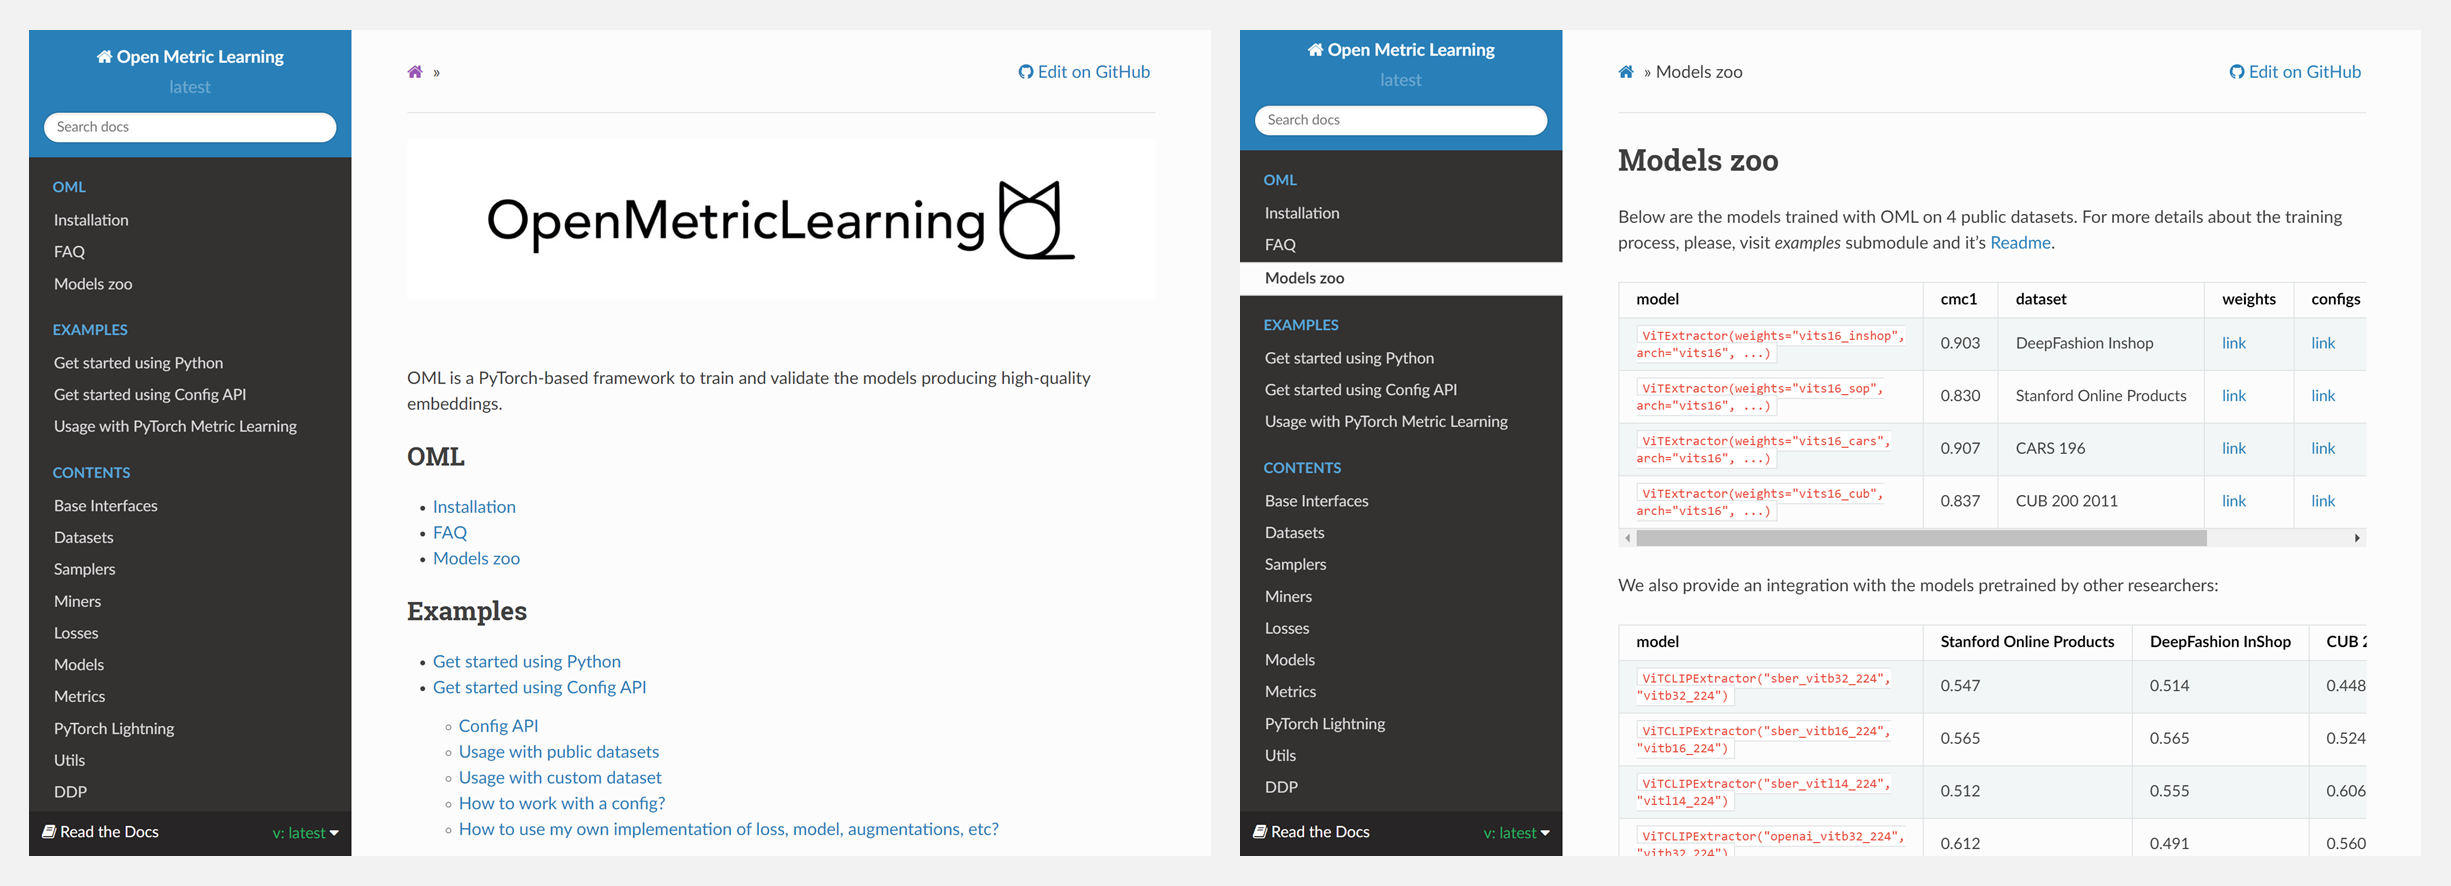
🚧 『OML』训练和验证产生高质量嵌入的模型

https://github.com/OML-Team/open-metric-learning

OML是一个基于 PyTorch 的框架,用于训练和验证产生高质量嵌入的模型。它针对以下场景和问题进行了调整,提供很好的支撑,你可以简单地使用OML来达到你的目的:

  • 使用嵌入进行搜索时,需要计算它们之间的一些距离(例如余弦或L2)。
  • 在搜索设置中,关心前N个输出与查询的关系如何。
  • 自己实现一个度量学习管道/流水线。

🚧 『uFuzzy』微小高效的Javascript模糊搜索引擎

https://github.com/leeoniya/uFuzzy

uFuzzy 是一个模糊搜索库,旨在将一个相对较短的搜索短语与一大批中短语相匹配。它常见的应用场景是列表过滤、自动补全/建议、以及标题/名称/描述/文件名/功能搜索。
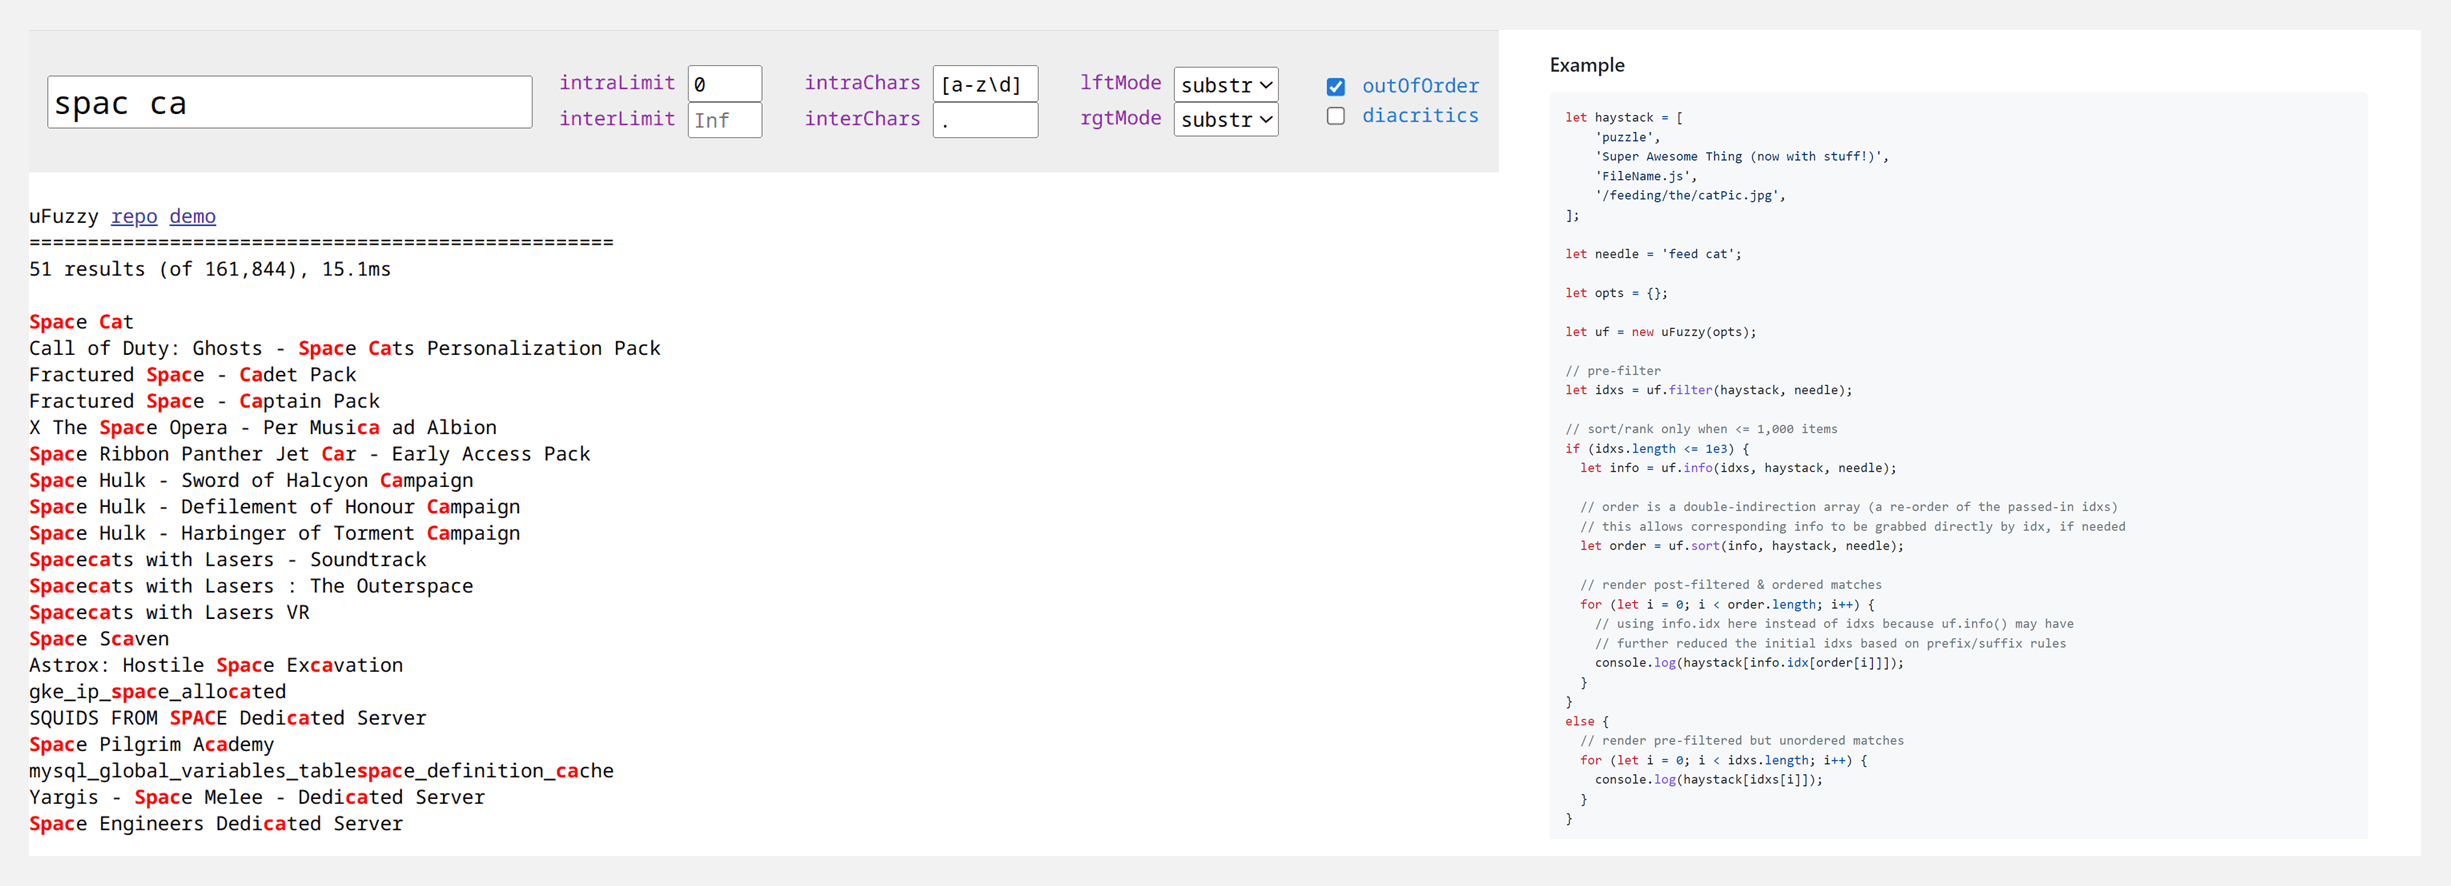
博文&分享

👍『Full Stack Deep Learning』Berkeley伯克利(FSDL) · 全栈深度学习训练营课程

https://www.showmeai.tech/article-detail/356

UC Berkeley 开放了这门全栈深度学习训练营课程,以实战为主,讲解了不同场景下应用深度学习解决问题的工具、过程和方法:从问题理解,方法选择、数据管理、选择 GPU 到 Web 部署、监控和再训练。

FSDL; Full Stack Deep Learning; 全栈深度学习训练营

FSDL 课程包含了典型的自然语言处理与计算机视觉中,对文本和图像的处理建模方法,也包括AI应用生态的其他工序与操作,比如数据标注与管理、模型测试、模型部署等。完整的课程学习可以帮助我们了解 AI 解决问题的全链条技能,更好地把控AI落地应用的能力。
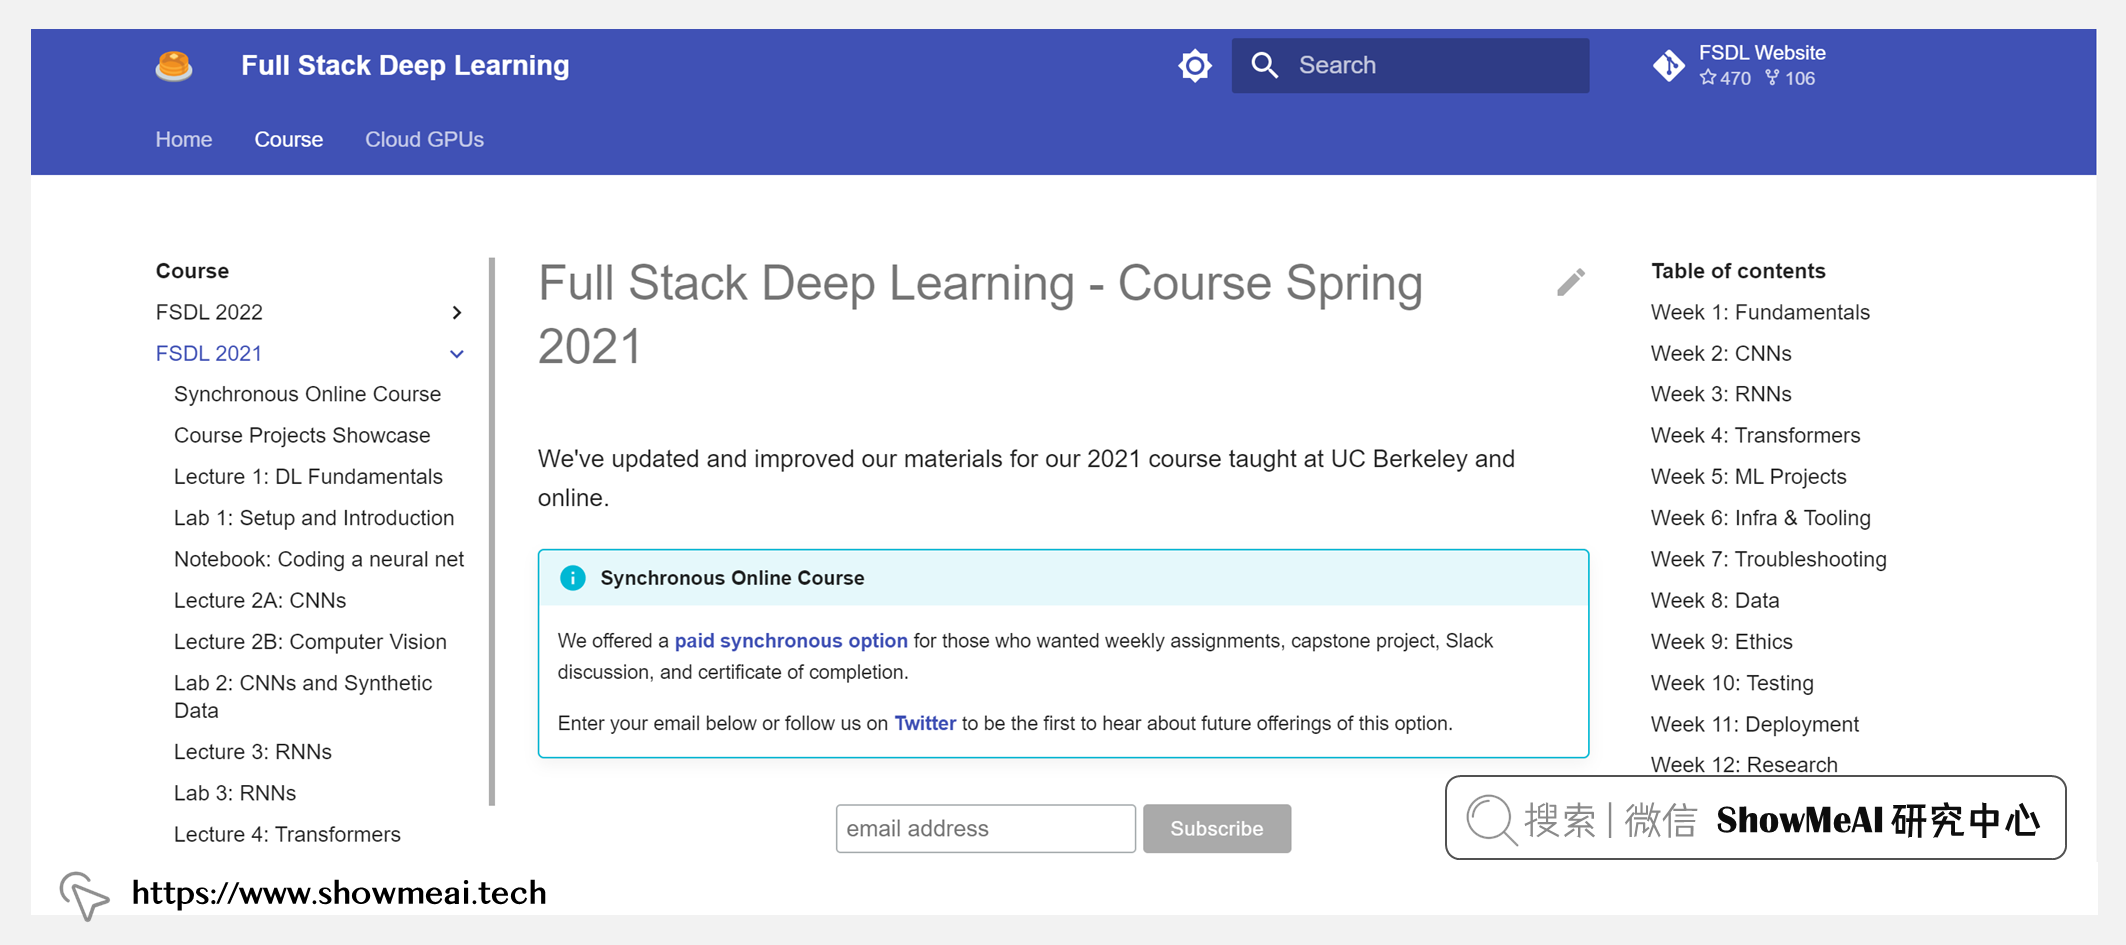
FSDL; Full Stack Deep Learning; 全栈深度学习训练营

ShowMeAI 对课程资料进行了梳理,整理成这份完备且清晰的资料包(点击 这里 获取这份资料包):

  • 📚课件。PDF文件。覆盖Lecture 1~13的全部章节。
  • 📚代码。.ip文件。覆盖Lab 1~10的全部内容
  • 📚笔记。PDF文件。课程学习的辅助资料,图文并茂,细节丰富。

👍 『Database System』CMU卡内基梅隆(14-455) · 数据库系统导论课程

https://www.showmeai.tech/article-detail/357

CMU 14-455 是 CMU 卡内基梅隆大学开放的数据库方向的专业课程,详尽介绍了数据库的基本知识、底层原理、效率优化、查询优化、新数据库等,是数据库管理系统设计与实施方向的权威好课。

14-455; Database System; 数据库系统导论

课程内容覆盖SQL、数据库、索引构建与优化、内存管理、并发控制、排序、分组聚合、查询规划、冲突与锁定、分布式数据库、内存数据库、Facebook Scuba、MongoDB、CockroachDB等内容,可以帮助构建系统的数据库原理与应用知识。
14-455; Database System; 数据库系统导论

ShowMeAI 对课程资料进行了梳理,整理成这份完备且清晰的资料包(点击 这里 获取这份资料包):

  • 📚课件。PDF版本,覆盖Lecture 1~26全部章节。
  • 📚笔记。PDF版本,覆盖Lecture 1~22章节。
  • 📚作业。PDF版本,覆盖Homework 2~5。

👍 『Advanced Database Systems』CMU卡内基梅隆(15-721) · 数据库系统进阶课程

https://www.showmeai.tech/article-detail/358

CMU 15-721 是 CMU 卡内基梅隆大学开放的数据库方向进阶课程,讨论了很多数据库方向新的技术研究方向与话题,适合有数据库基础又想在该方向有深入研究的同学学习。

15-721; Advanced Database Systems; 数据库系统进阶

课程是对现代数据库管理系统内部结构的综合研究,涵盖 OLTP 和 OLAP 中使用组件的核心概念与基础知识,讲解其实现的效率与准确率,并将在一个真实内存、多核数据库系统中完成实现。所以,课程学习前需要具备一定编程技能。
15-721; Advanced Database Systems; 数据库系统进阶

ShowMeAI 对课程资料进行了梳理,整理成这份完备且清晰的资料包(点击 这里 获取这份资料包):

  • 📚课件。PDF版本。覆盖Lecture 1~25所有章节。
  • 📚笔记。PDF版本。5份Notes,辅助课程学习。
  • 📚作业。Markdown文件。7份作业文件。
  • 📚拓展阅读资料。PDF文件。100+相关论文。

数据&资源

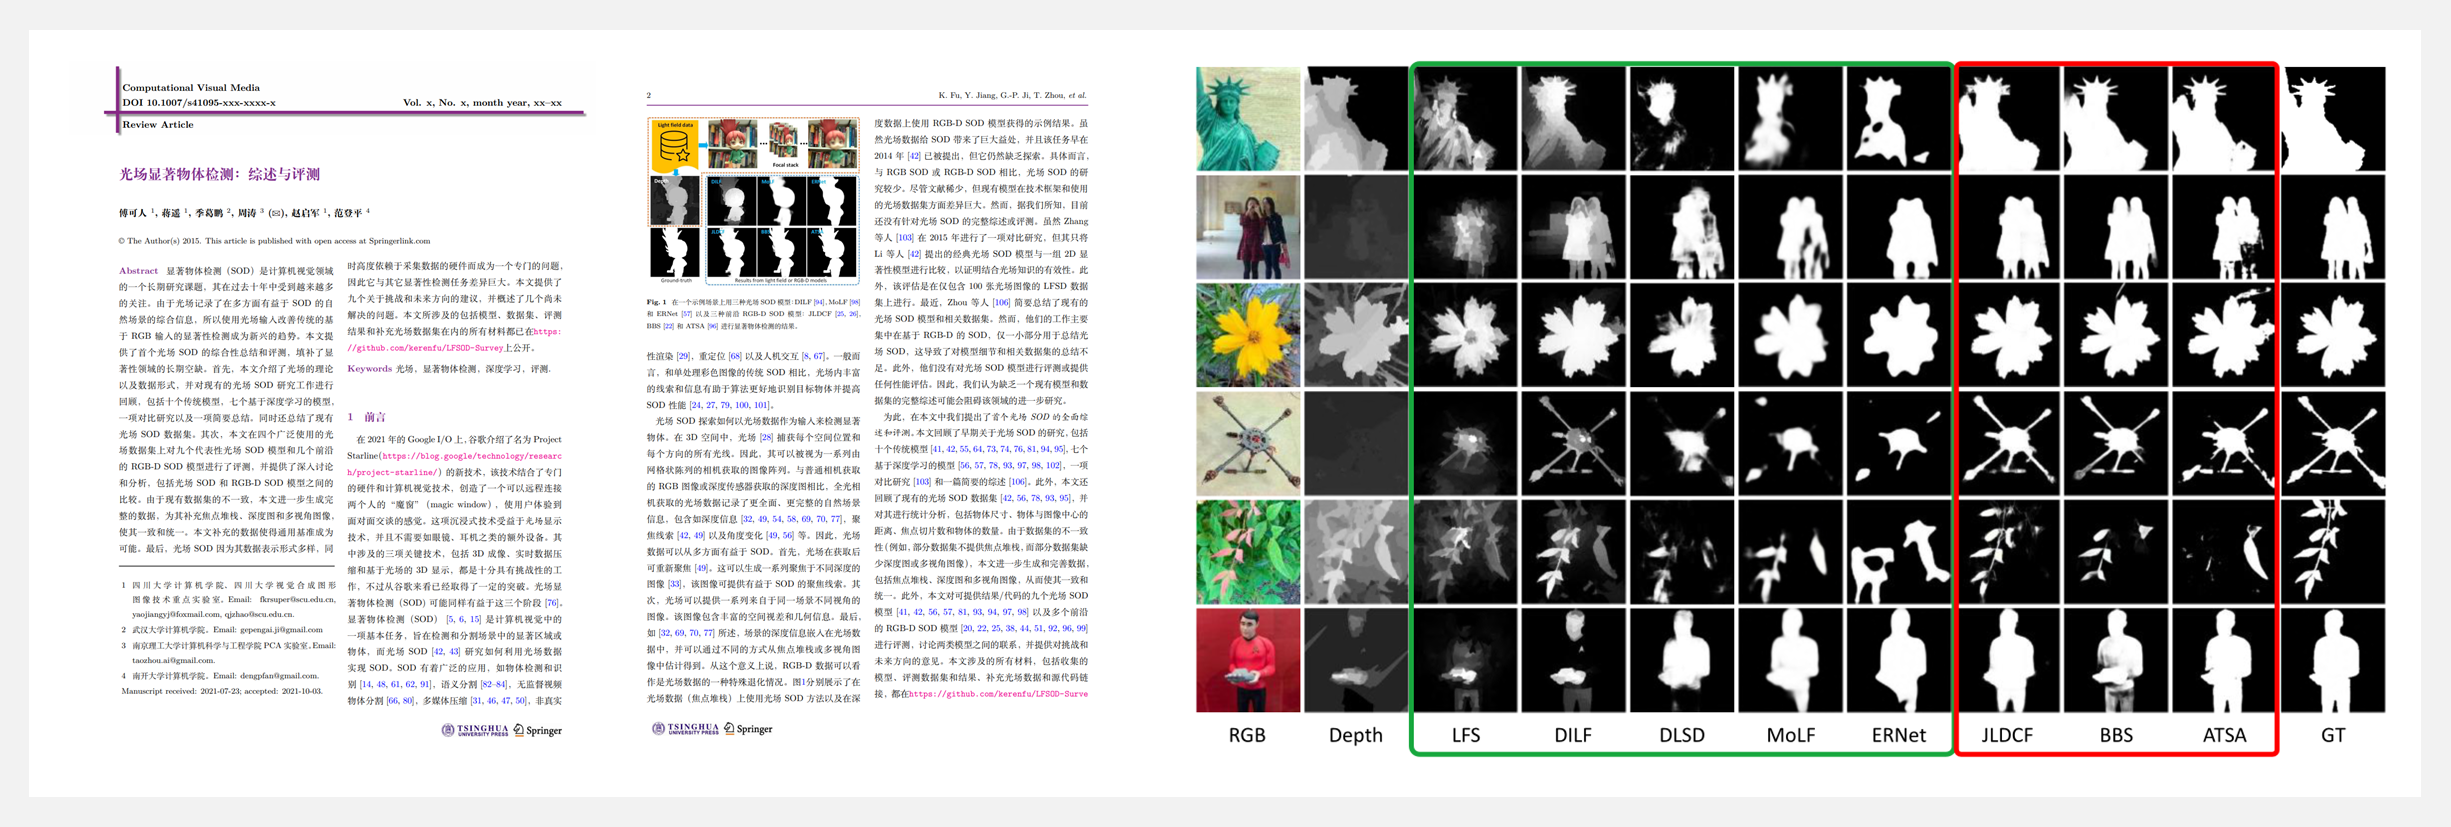
🔥 『Light Field Salient Object Detection: A Review and Benchmark』光场显著物体检测相关文献资源列表

https://github.com/kerenfu/LFSOD-Survey

http://www.kerenfu.top/sources/2021cvmlfsurvey-cn.pdf

  • Light Field
    • i. Multi-view Images and Focal Stacks
  • Light Field SOD
    • i. Traditional Models
    • ii. Deep Learning-based Models
    • iii. Other Review Works
  • Light Field SOD Datasets
  • Benchmarking Results
    • i. RGB-D SOD Models in Our Tests
    • ii. Quantitative Comparison
    • iii. All Models’ Saliency Maps
    • iv. Qualitative Comparison
  • Citation

研究&论文

可以点击 这里 回复关键字 日报,免费获取整理好的论文合辑。

科研进展

  • 2022.09.30 『降噪』 TabDDPM: Modelling Tabular Data with Diffusion Models
  • 2022.10.03 『语言模型』 SpeechCLIP: Integrating Speech with Pre-Trained Vision and Language Model
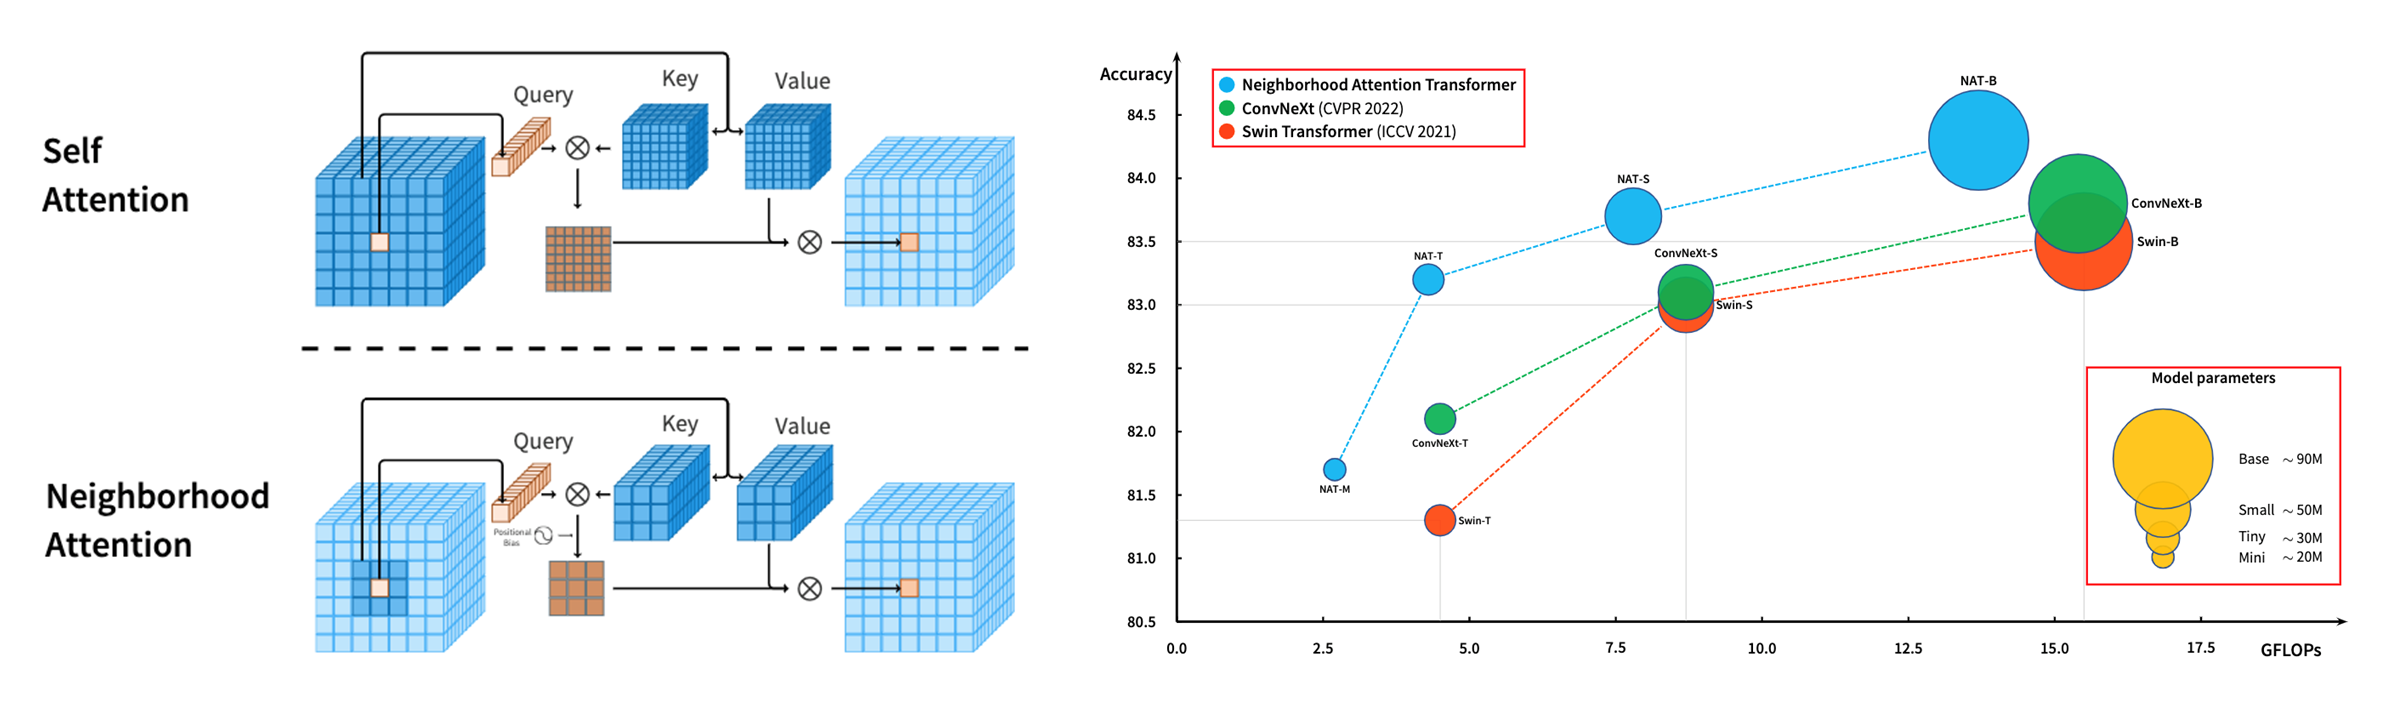
  • 2022.09.29 『图像分类』 Dilated Neighborhood Attention Transformer

⚡ 论文:TabDDPM: Modelling Tabular Data with Diffusion Models

论文时间:30 Sep 2022

领域任务:Denoising,降噪

论文地址:https://arxiv.org/abs/2209.15421

代码实现:https://github.com/rotot0/tab-ddpm

论文作者:Akim Kotelnikov, Dmitry Baranchuk, Ivan Rubachev, Artem Babenko

论文简介:Denoising diffusion probabilistic models are currently becoming the leading paradigm of generative modeling for many important data modalities./去噪扩散概率模型目前正成为许多重要数据模式的生成建模的领先范式。

论文摘要:去噪扩散概率模型目前正成为许多重要数据模式的生成模型的领先范式。作为计算机视觉界最普遍的模型,扩散模型最近在其他领域也获得了一些关注,包括语音、NLP和类图数据。在这项工作中,我们研究了扩散模型的框架是否对一般的表格问题有利,其中数据点通常由异质特征的向量表示。表格数据固有的异质性使其对精确建模具有相当大的挑战性,因为各个特征的性质可能完全不同,即有些是连续的,有些是离散的。为了解决这样的数据类型,我们引入了TabDDPM–一个可以普遍适用于任何表格数据集和处理任何类型特征的扩散模型。我们在一组广泛的基准上对TabDDPM进行了广泛的评估,并证明它比现有的GAN/VAE替代品更有优势,这与扩散模型在其他领域的优势是一致的。此外,我们表明TabDDPM可以用于面向隐私的设置,其中原始数据点不能被公开共享。
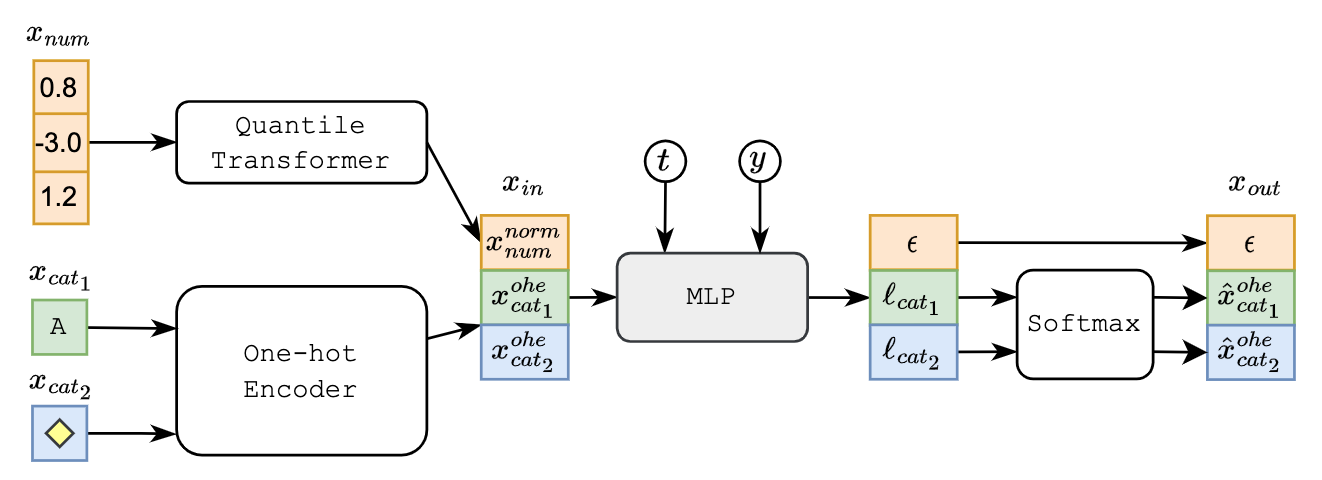
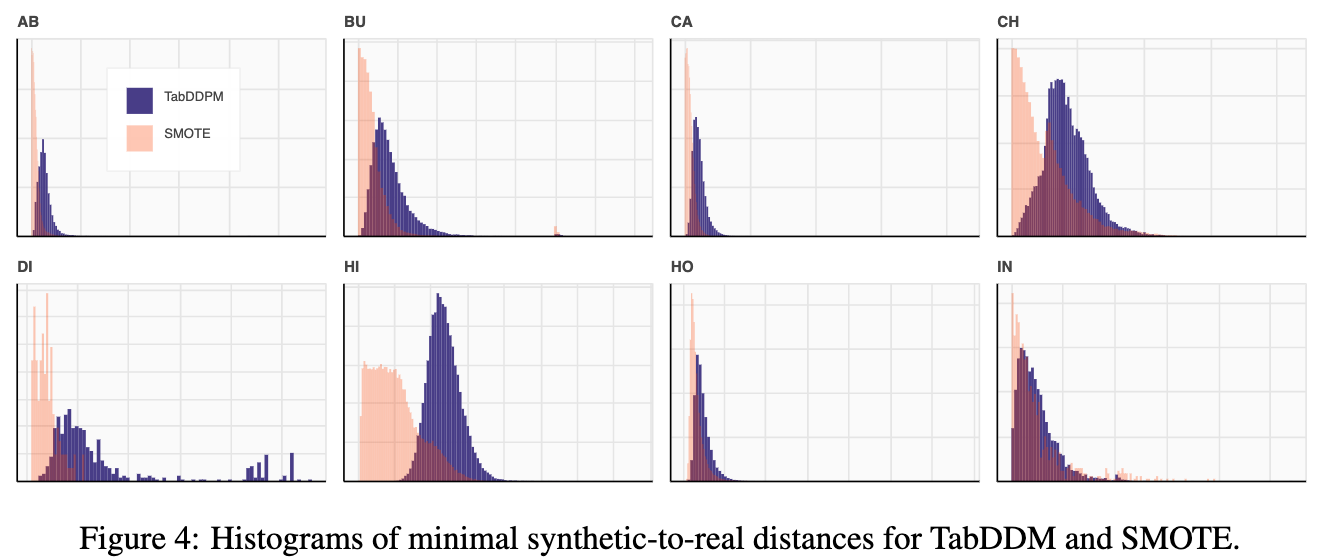
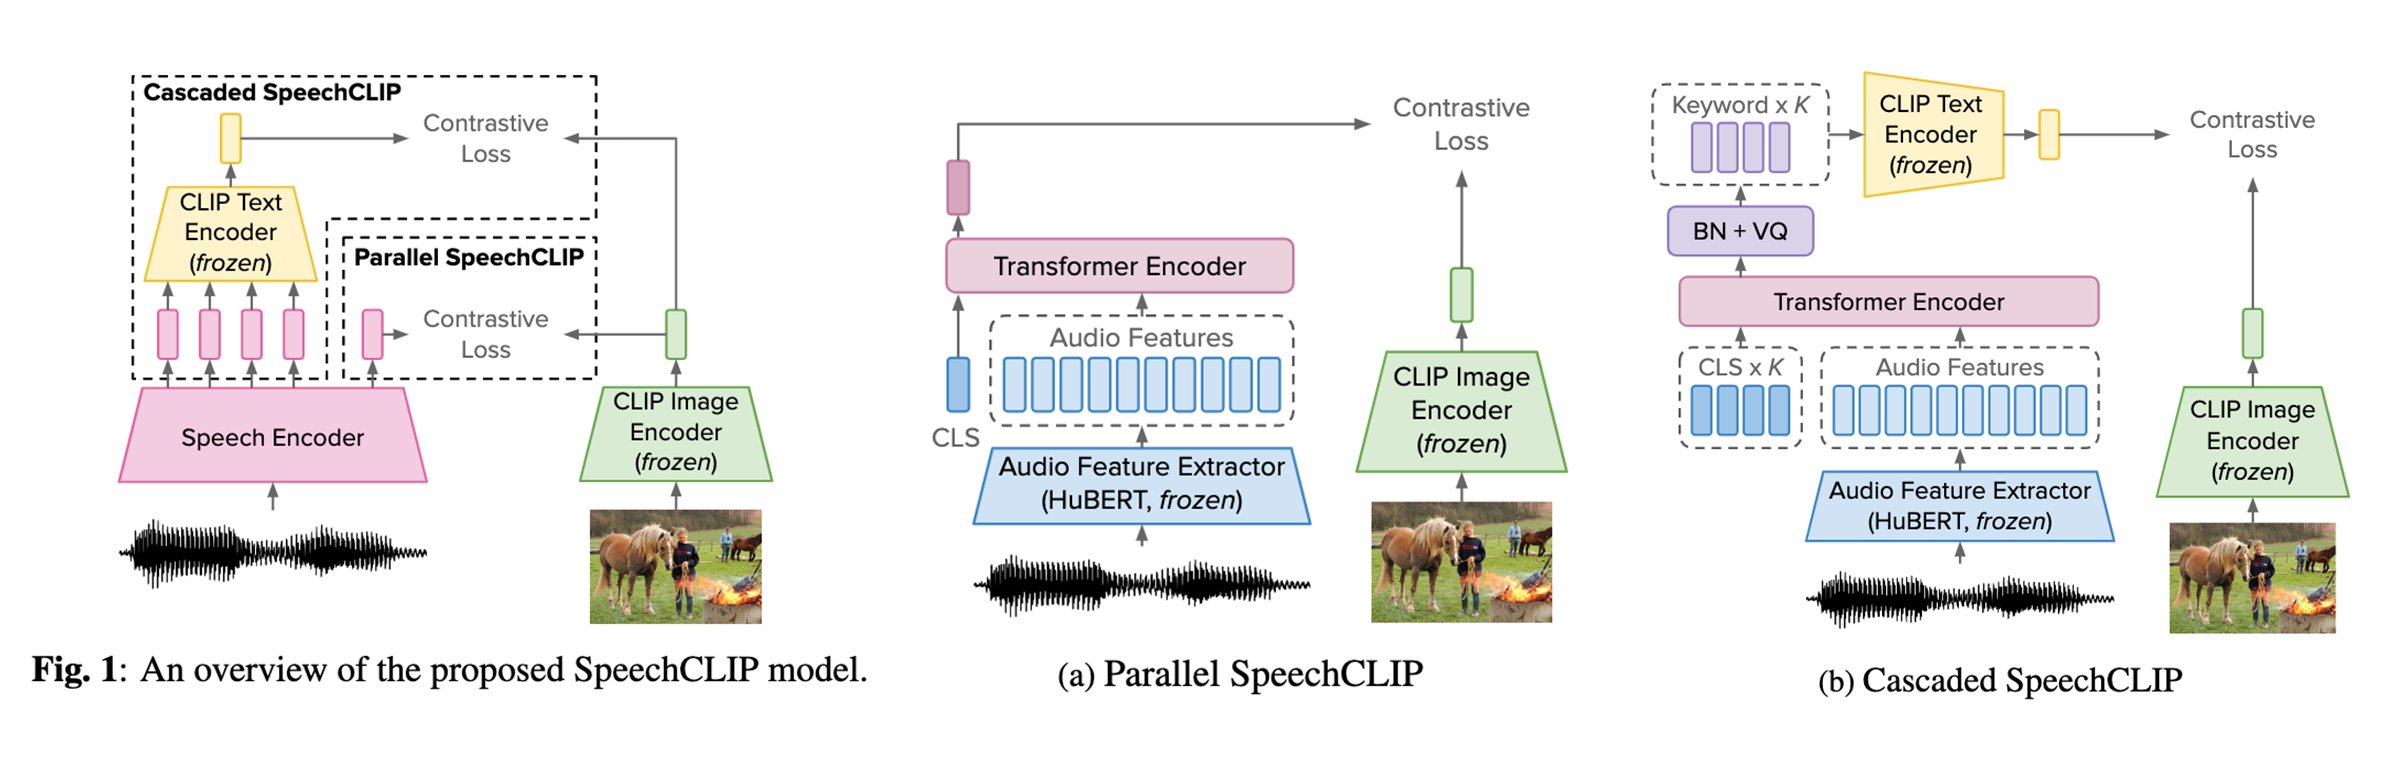
⚡ 论文:SpeechCLIP: Integrating Speech with Pre-Trained Vision and Language Model

论文时间:3 Oct 2022

领域任务:Language Modelling,语言模型

论文地址:https://arxiv.org/abs/2210.00705

代码实现:https://github.com/atosystem/speechclip

论文作者:Yi-Jen Shih, Hsuan-Fu Wang, Heng-Jui Chang, Layne Berry, Hung-Yi Lee, David Harwath

论文简介:Data-driven speech processing models usually perform well with a large amount of text supervision, but collecting transcribed speech data is costly./数据驱动的语音处理模型通常在大量的文本监督下表现良好,但收集转录的语音数据成本很高。

论文摘要:数据驱动的语音处理模型通常在大量的文本监督下表现良好,但收集转录的语音数据成本很高。因此,我们提出了SpeechCLIP,一个通过图像连接语音和文本的新型框架,以增强语音模型而不需要转录。我们利用最先进的预训练的HuBERT和CLIP,通过成对的图像和口语说明,以最小的微调将它们对齐。SpeechCLIP在图像-语音检索方面的表现优于先前的最先进水平,并在没有转录的直接监督下进行零样本的语音-文本检索。此外,SpeechCLIP可以直接从语音中检索出语义相关的关键词。
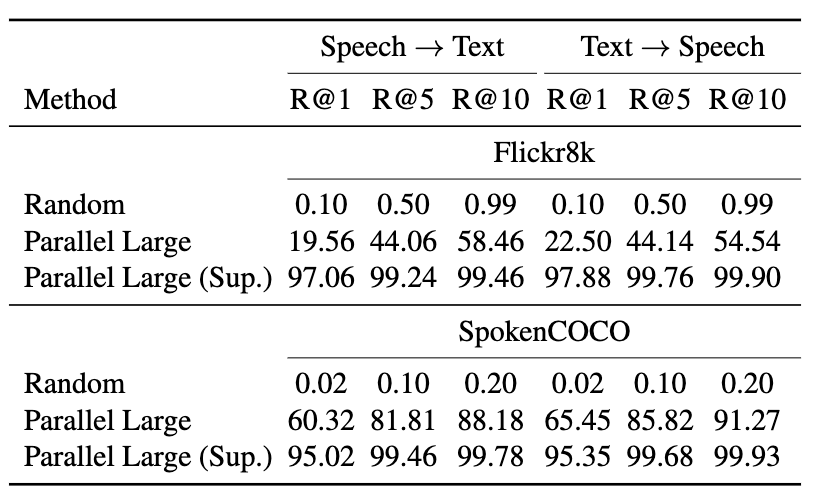
⚡ 论文:Dilated Neighborhood Attention Transformer

论文时间:29 Sep 2022

领域任务:Image Classification, Instance Segmentation, 图像分类,实例分割

论文地址:https://arxiv.org/abs/2209.15001

代码实现:https://github.com/SHI-Labs/Neighborhood-Attention-Transformer

论文作者:Ali Hassani, Humphrey Shi

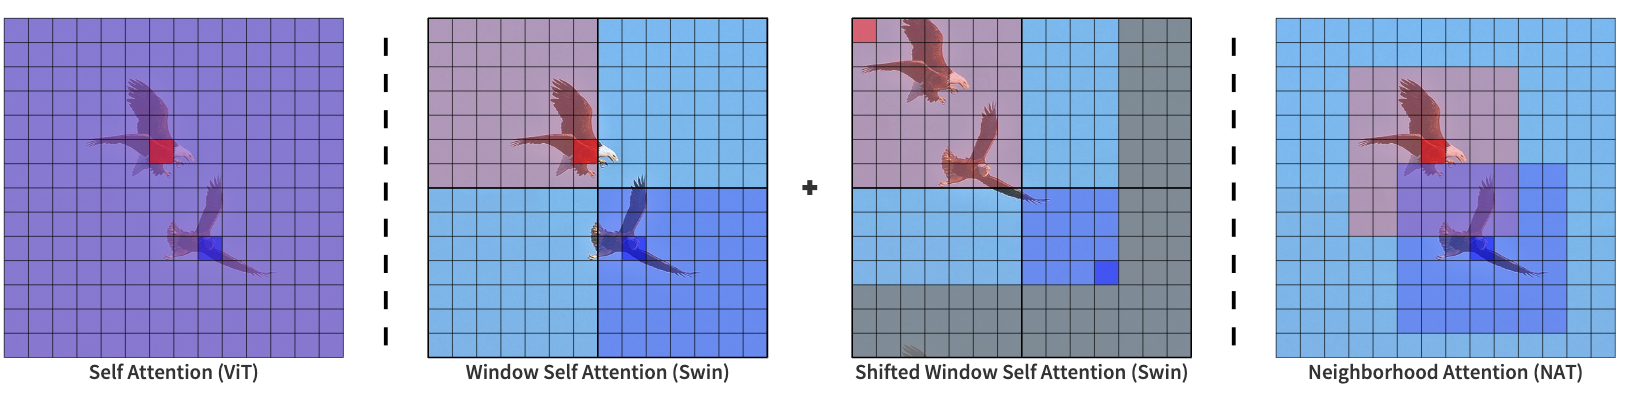
论文简介:These models typically employ localized attention mechanisms, such as the sliding-window Neighborhood Attention (NA) or Swin Transformer’s Shifted Window Self Attention./这些模型通常采用局部注意机制,如滑动窗口的邻域注意(NA)或Swin Transformer的移位窗口自我注意。

论文摘要:Transformers正迅速成为跨模式、领域和任务的最大量应用的深度学习架构之一。在视觉领域,除了正在进行的普通转化器的研究之外,分层transformer也获得了极大的关注,这要归功于它们的性能和易于集成到现有框架中。这些模型通常采用局部注意机制,如滑动窗口邻里注意(NA)或Swin transformer的移位窗口自我注意。虽然有效地降低了自我注意的四次方复杂性,但局部注意削弱了自我注意的两个最理想的特性:长距离的相互依赖模型和全局接受场。在本文中,我们介绍了扩张的邻域注意(DiNA),它是对NA的自然、灵活和有效的扩展,可以捕捉更多的全局背景,并在不增加成本的情况下成倍地扩大感受野。NA的局部注意和DiNA的稀疏全局注意相辅相成,因此我们引入了扩张邻域注意transformer(DiNAT),一个建立在两者基础上的新的分层视觉transformer。DiNAT变体比基于注意力的基线,如NAT和Swin,以及现代卷积基线ConvNeXt,享有明显的改进。我们的Large模型在COCO物体检测中比Swin模型领先1.5%的盒式AP,在COCO实例分割中领先1.3%的掩码AP,在ADE20K语义分割中领先1.1%的mIoU,并且在吞吐量上更快。我们相信,NA和DiNA的组合有可能赋予本文所介绍的任务以外的各种任务。为了支持和鼓励这个方向的研究,在视觉和其他方面,我们把项目开源到:https://github.com/SHI-Labs/Neighborhood-Attention-Transformer
我们是 ShowMeAI,致力于传播AI优质内容,分享行业解决方案,用知识加速每一次技术成长!

◉ 点击 日报合辑,在公众号内订阅话题 #ShowMeAI资讯日报,可接收每日最新推送。

◉ 点击 电子月刊,快速浏览月度合辑。

◉ 点击 这里 ,回复关键字 日报 免费获取AI电子月刊与论文 / 电子书等资料包。
tab-ddpm的核心代码 【代码】tab-ddpm的核心代码。 阅读详情

相关推荐

用kimi和claude自动生成时间轴图表

接下来,将以上大事记复制到claude中,然后加上一段提示词:根据以上内容,用react创建一个竖向的时间轴图表,要紧凑一些,不用滚动下拉即可在一屏中看见,字体加粗,要有设计感一些,时间要显示成年月日,标题是:元语智能大事记。{ date: '2022-10-01', event: 'PromptCLUE1.0模型' },{ date: '2023-01-12', event: 'ChatYuan大模型开源' },{ date: '2022-12-20', event: 'ChatYuan发布' },

AIGCTribe的博客 1881

VS Code时间轴插件:MarkWhen

MarkWhen是一款文本转时间轴的工具,非常好用,也十分炫酷。可在VS Code中搜索插件`MarkWhen`,点击安装,然后新建一个`.mw`后缀的文件,就可以使用了。

微小冷的学习笔记 4224

loglizer:用于自动异常检测的日志分析工具包[ISSRE'16]

逻辑器 Loglizer是基于机器学习的日志分析工具包,用于自动异常检测。 Loglizer是一种基于AI的日志的大数据分析工具,可以用于自动异常检测,智能故障诊断等场景 在许多软件系统的开发和维护过程中,日志都是必不可少的。 他们在系统运行期间记录详细的运行时信息,使开发人员和支持工程师可以监视他们的系统并跟踪异常行为和错误。 Loglizer提供了一个工具箱,该工具箱实现了许多用于自动异常检测的基于机器学习的日志分析技术。 :telescope: 如果您在研究中使用Loglizer进行发表,请引用以下论文。 何士林,朱杰明,何品佳,Michael R. Lyu。 , IEEE软件可靠性工程国际研讨会(

探索时间的奥秘:Markwhen——文本到时间线的魔法工具

探索时间的奥秘:Markwhen——文本到时间线的魔法工具 在信息爆炸的时代,管理时间和事件变得越来越重要。Markwhen是一个创新的开源项目,它将普通的Markdown文本转化为交互式的时间线,帮助你优雅地组织和呈现复杂的时间序列数据。 项目介绍 Markwhen不仅仅是一个工具,而是一整套生态系统,包括Web应用、VS Code扩展以及一系列可自定义的视图组件。它的核心功能是将易读的文本转...

gitblog_00050的博客 826

【UOJ170】Picks loves segment tree VIII

【题目链接】 点击打开链接 【前置阅读】 【BZOJ4695】最假女选手 【BZOJ3064】【TYVJ1518】CPU监控【UOJ169】【UR #11】元旦老人与数列 【思路要点】 前置阅读中的前两题中,我们分别对线段树的区间取最大/最小值和线段树的历史最大/最小值进行了研究。本题中,两类问题同时出现,因此我们

cz_xuyixuan的博客 1261

sram设计流程+memory compiler整理

→。

qq_50761108的博客 1万+

(论文笔记)TABDDPM:使用扩散模型对表格数据进行建模

去噪扩散概率模型目前正成为许多重要数据模式生成建模的主要范式。扩散模型在计算机视觉社区中最为流行,最近也在其他领域引起了一些关注,包括语音、NLP 和图形数据。在这项工作中,我们研究了扩散模型的框架是否可用于解决表格问题,其中数据点通常由异构特征的向量表示。表格数据固有的异构性使得准确建模变得非常具有挑战性,因为各个特征可能具有完全不同的性质,即其中一些特征可能是连续的,而另一些特征可能是离散的。

storyteller的博客 4860

汇率波动率建模实战:从GARCH到EGARCH的金融时间序列分析

在金融时间序列分析中,波动率建模是量化市场风险的核心技术。其基本原理在于捕捉金融资产收益率序列中存在的波动聚集、尖峰厚尾等典型特征。通过建立条件异方差模型,如GARCH及其扩展模型,可以动态估计和预测未来波动率,这对于资产定价、风险管理和投资决策具有重要价值。在金融工程领域,该技术广泛应用于外汇、股票和衍生品市场。本文以汇率波动率建模为具体场景,详细阐述了如何使用Python中的arch库,从数据预处理、模型选型(包括GARCH、EGARCH等)、参数估计到样本外预测评估的全流程实践,并深入探讨了模型在应对

weixin_32629853的博客 375

推荐文章:探索时间的编排艺术 —— Markwhen 开源工具深度解析

推荐文章:探索时间的编排艺术 —— Markwhen 开源工具深度解析 项目介绍 在繁杂的信息记录和管理中,时间的可视化成为了一种高效理解与规划的重要方式。【Markwhen】正是这样一款创新性的互动工具,它将普通的文本转换为美观且有序的时间线,让信息的组织和回顾变得直观而生动。尽管其在线编辑器保持私有,但其余组件包括时间线、日历视图以及VSCode插件等都已开放源代码,隶属于mark-when组...

gitblog_00885的博客 585

【MediaPipe实战】从零构建实时人脸关键点检测与表情分析系统

本文详细介绍了如何使用MediaPipe框架从零构建实时人脸关键点检测与表情分析系统。通过Python代码实现,系统能够精准检测468个3D人脸关键点,并实时分析用户表情,适用于智能交互应用。文章包含环境配置、核心实现、可视化技巧及性能优化等实战内容,帮助开发者快速掌握深度学习在计算机视觉中的应用。

weixin_30836759的博客 73

SVM-支持向量机学习(1):线性可分SVM的基本型

1. foreword先看的是李航老师的书第7章,比较传统按照以下三节展开: 线性可分SVM 线性SVM 非线性SVM SMO算法 李航老师讲东西向来不拖泥带水,但本节也几乎用了40页的篇幅,足见涉及内容之多。7月底硬着头皮啃了下来,边看边在笔记上摘抄标注,花了2天时间对SVM有了基本认识。一个月过去了,如今重新整理为博客,再看轻松许多,并不断对比西瓜书的内容,启望达到融会贯通。西瓜书此节明显节奏轻

鸟恋旧林的博客 8681

Markdown快速上手

Markdown基本语法【程序员写博客神奇】 Markdown是一种纯文本格式的标记语言。通过简单的标记语法,它可以使普通文本内容具有一定的格式,是深受技术人员喜爱的文档编写方式,很多著名的网站如github都对markdown有良好的支持。

weixin_38640052的博客 321

AEJoy —— 表达式之仅限在某一维摆动【JS】

效果图 wiggle() 的作用仅限于水平方向 想法 wiggle() 确实是一个非常方便的工具,但有时您希望对它有更多的控制。在本例中,我们希望仅将摆动限制在水平方向。 设计 要理解 wiggle() 最重要的一点是,它生成的结果与应用它的属性具有相同的维度。例如,如果你将 wiggle() 应用于 3D 层的 position 属性,结果将是一个由三个元素组成的数组(x、y 和 z 各一个)。我们需要做的就是将 wiggle() 的结果捕捉到一个变量(我们称之为 “w” ),然后从这个变量中提取我们想

ShaderJoy 的兴趣技术杂货铺 2095

老胡的周刊(第102期)

老胡的信息周刊[1],记录这周我看到的有价值的信息,主要针对计算机领域,内容主题极大程度被我个人喜好主导。这个项目核心目的在于记录让自己有印象的信息做一个留存以及共享。???? 项目ChatGPT-Shortcut[2]ChatGPT 快捷指令,按照领域和功能分区,可对提示词进行标签筛选、关键词搜索和一键复制:aishortlinkwarden[3]一个自托管的、开源的协作式书签管理器,用于收集、组织和...

howie6879's blog 520

04 HCM CPI SF集成-员工集成(一)

将员工主数据和组织数据从SAP Successfactors Employee CentraI复制到SAPERP或SAP S/4HANA,SAP SF CPI HCM集成

SAP CPI 147

Ollama本地大模型-个性化AI:训练自己的风格模型和数据投喂打造专属智能体验

之前我们使用Ollama下载了deepseek模型,现在我想将其训练成自己风格的模型,应该怎么做?

瑶山的博客 1784

如何快速上手 Markwhen:从文本到时间线的终极指南

Markwhen 是一个创新的文本到时间线可视化工具,让你能够通过简单的 Markdown 语法创建美观的瀑布式时间线。无论你是项目管理者、学生还是个人用户,Markwhen 都能帮助你快速将想法转化为清晰的时间线视图。 ## 🚀 什么是 Markwhen? Markwhen 的核心功能是将类 Markdown 文本自动转换为交互式时间线。你只需要编写简单的文本描述,Markwhen 就能智

gitblog_00950的博客 446

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

教程:15、系统日志及日志分析

大部分Linux发行版默认的日志守护进程为 syslog,位于 /etc/syslog 或 /etc/syslogd,默认配置文件为 /etc/syslog.conf,任何希望生成日志的程序都可以向 syslog 发送信息。 Linux系统内核和许多程序会产生各种错误信息、警告信息和其他的提示信息,这些信息对管理员了解系统的运行状态是非常有用的,所以应该把它们写到日志文件中去。完成这

644

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Deep-Loglizer 使用教程

Deep-Loglizer 使用教程 1. 项目的目录结构及介绍 Deep-Loglizer 是一个基于深度学习的日志分析工具包,用于自动化异常检测。以下是项目的目录结构及其介绍: deep-loglizer/ ├── benchmarks/ │ └── ... # 包含性能测试相关的文件 ├── data/ │ └── ... # 数据文件 ├── data_preprocess/ │ ...

gitblog_00778的博客 542

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

TabDDPM:基于扩散模型的表格数据生成技术深度解析

TabDDPM是Yandex Research推出的创新性开源项目,专注于利用扩散模型技术生成高质量的表格数据。该项目作为论文《TabDDPM: Modelling Tabular Data with Diffusion Models》的官方实现,为数据科学家和研究人员提供了强大的表格数据合成工具。 ## 技术架构与核心组件 TabDDPM项目采用模块化设计,主要包含以下核心组件: ###

gitblog_01179的博客 687

Yandex Research的Tab-DDPM:基于扩散模型的表格数据生成库

**Yandex Research的Tab-DDPM** 是一个创新的开源项目,专注于利用扩散过程(Diffusion-based)的方法来生成高质量的表格数据。该项目旨在解决数据合成领域中的挑战,特别是对于隐私保护、数据增强以及高效训练机器学习模型的需求。通过结合深度学习与扩散模型的先进技术,Tab-DDPM能够生成逼真的表格数据,对数据分析、模型测试和隐私保护等领域有着重要的应用价值。 ##

gitblog_00310的博客 1353

Markwhen完全指南:从零开始掌握文本时间线转换技术

Markwhen是一款革命性的文本转时间线工具,让您能够通过简单的类Markdown语法快速创建美观的瀑布式时间线。这个强大的开源项目支持美式/欧式日期格式、ISO8601标准、图片、链接、地理位置等丰富功能,彻底改变了时间管理和项目规划的方式。😊 ## 什么是Markwhen? Markwhen的核心功能是将文本语法实时转换为可视化时间线。您只需要编写类似Markdown的文本,系统就会自

gitblog_01036的博客 1073

学会这 5 个 AI 神器做字体设计,保证让你私单接到爆!

最近我在浏览 AI 绘画的相关内容时,发现不少图像都是与字体相关的,而且其中一些呈现出的艺术特效很是**让人眼前一亮**。 放在之前,我们需要掌握一些专业技能、并花费大量时间才能设计出**精致酷炫**的艺术字,但是现在却可以轻松用文本直接生成,这无疑极大地提升了设计效率,而且用 AI 探索出的风格也比我们能想象的**更丰富多样**。

ice829的博客 3487

日志异常检测资料汇总

1. 日志异常检测 1.1 日志异常检测模型 深度模型的日志异常检测,还有谁不会?:https://segmentfault.com/a/1190000039060586 AIOps关键技术:FT-tree提取日志模板 : https://cloud.tencent.com/developer/news/238966 (小米智能运维团队) 日志异常检测初步实践与探索: https://blog.youkuaiyun.com/pengzhouzhou/article/details/110211666#comments

酒酿小圆子呀~ 1829

【亲测免费】 探索数据生成新境界:TabDDPM——基于扩散模型的表格数据建模

在人工智能和数据分析的前沿,高质量的数据合成已成为研究者和实践者的热点话题。今天,我们为大家带来一款创新工具——**TabDDPM:基于扩散模型的表格数据建模**。这个开源项目源自一篇深具影响力的论文,其研究揭示了使用扩散模型(Diffusion Models)进行复杂表格数据建模的新方法。 ## 项目介绍 TabDDPM是一个开创性的项目,旨在解决传统方法在建模高维、异构的表格数据时面临的挑

gitblog_00724的博客 954
上一篇: 从建模型到写论文,哈佛AI研究经验大公开;必学!MIT的CS数学基础课;医疗AI平台;深度学习发现小分子药物工具库;前沿论文 | ShowMeAI资讯日报
下一篇: 撕开黑幕!AI担任拳击比赛裁判;思维导图&工程图表工具大合辑;CVPR视觉-语言的预训练最新进展;游戏开发资源列表;前沿论文 | ShowMeAI资讯日报
ShowMeAI
博客等级 码龄5年 6514粉丝 672原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

ShowMeAI

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值