万字解析!一文带你了解深度学习中经典神经网络结构--CNN、RNN、LSTM、Transformer!原创JOYCE_Leo16AI评论员2025年06

Transformer是什么?看完这篇你就醍醐灌顶 前言 由谷歌团队提出的预训练语言模型BERT近年来正在各大自然语言处理任务中屠榜(话说学者们也挺有意思的,模型名都强行凑个芝麻街的人物名,哈哈哈)。 BERT算法的最重要的部分便是Transformer的概念,它本质上是Transformer的编码器部分。 而Transformer是什么呢?transformer是永远的神,自从transformer使用了抛弃rnncnn的纯attention机制之后,各种基于transformer结构的预训练模型都如雨后春笋般雄起,而transformer中最重要就是使用 阅读详情

大家好,今天我们来总结下深度学习中一些经典的神经网络结构,包括了CNN、RNN、LSTM、Transformer,接下来就直接进入正题吧!

1 卷积神经网络(CNN)

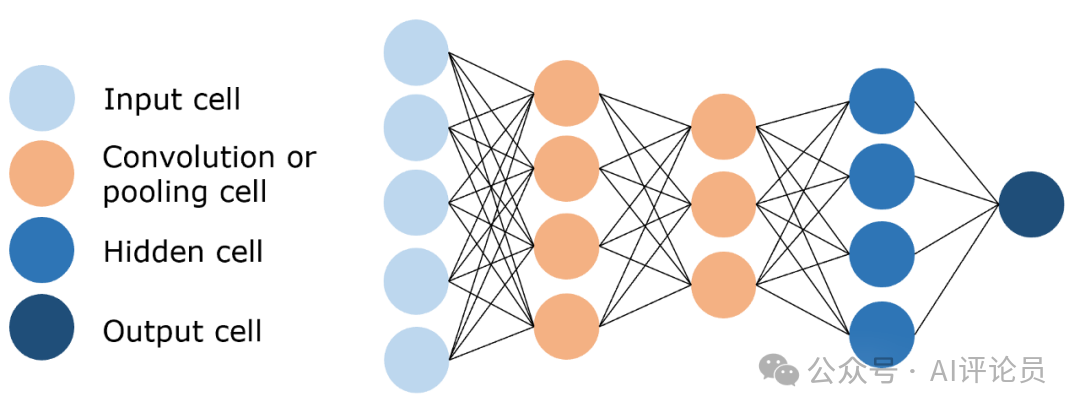
一种专用于图像处理的深度学习模型。其核心是卷积层,通过可学习的滤波器提取局部特征(如边缘、纹理),并利用参数共享降低计算量。池化层(如最大池化)进行下采样,减少数据维度并增强平移不变性。通过多层卷积-池化堆叠,CNN逐步构建层次化特征(从局部到全局),最后经全连接层完成分类。这种结构大幅减少参数量,使CNN在图像分类、目标检测等任务中高效且鲁棒。

网络结构

  • 卷积层:用来提取图像的局部特征

  • 池化层:用来大幅降低参数量级,实现数据降维。

  • 全连接层:用来输出想要的结果。

01.png

解决问题:

  • 提取特征:卷积操作提取图像特征,如边缘、纹理等,保留图像特征。

  • 数据降维:池化操作大幅降低参数量级,实现数据降维,大大减少运算量,避免过拟合。

工作原理

  • 卷积层:通过卷积核的过滤提取出图片中局部的特征,类似初级视觉皮层进行初步特征提取。
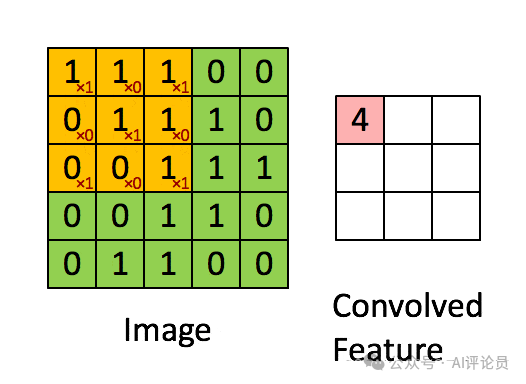
02.png

使用一个过滤器(卷积核)来过滤图像的各个小区域,从而得到这些小区域的特征值

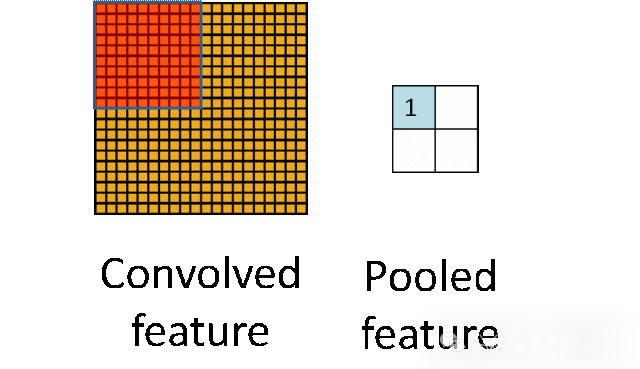
  • 池化层:下采样实现数据降维,大大减少运算量,避免过拟合。

03.png

原始是20*20,进行下采样,采样为10*10,从而得到2*2大小的特征图

  • 全连接层:经过卷积层和池化层处理过的数据输入到全连接层,得到最终想要的结果。
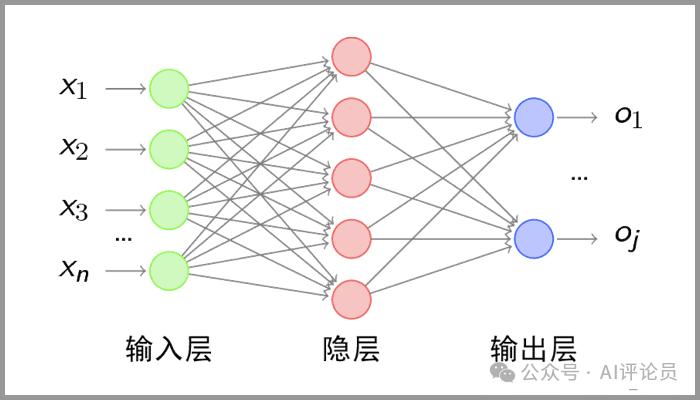
04.png

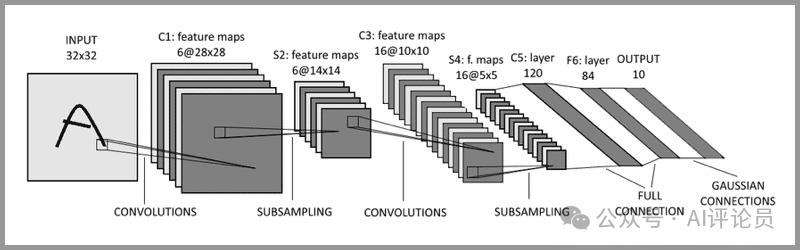
LeNet-5:被誉为卷积神经网络的“Hello World”,是图灵奖获得者Yann LeCun(杨立昆)在1998年提出的CNN算法,用来解决手写识别的问题。

LeNet-5通过引入卷积层、池化层和全连接层等关键组件,构建了一个高效且强大的图像识别网络,为后续卷积神经网络的发展奠定了基础。

  • 输入层:INPUT

  • 三个卷积层:C1、C3和C5

  • 两个池化层:S2和S4

  • 一个全连接层:F6

  • 输出层:OUTPUT

05.png

输入层-卷积层-池化层-卷积层-池化层-卷积层-全连接层-输出层

实际应用

  • 图像分类:可以节省大量的人工成本,将图像进行有效的分类,分类的准确率可以达到95%+。典型场景:图像搜索。

  • 目标定位:可以在图像中定位目标,并确定目标的位置及大小。典型场景:自动驾驶。

  • 目标分割:简单理解就是一个像素级的分类。典型场景:视频裁剪。

  • 人脸识别:非常普及的应用,戴口罩都可以识别。典型场景:身份认证。

【为初学者整理】另外我根据自己的入门经历和阅读经验,整理了一份针对机器学习深度学习新手的书单,总共有12本优质书籍!不仅包含了入门前需要掌握的前置知识,还兼顾了python编程语言、深度学习框架、常用第三方库、理论、实战,以及必读的经典论文
全套书籍.png

如果需要全套书籍的高清电子版和代码

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
2 循环神经网络(RNN)

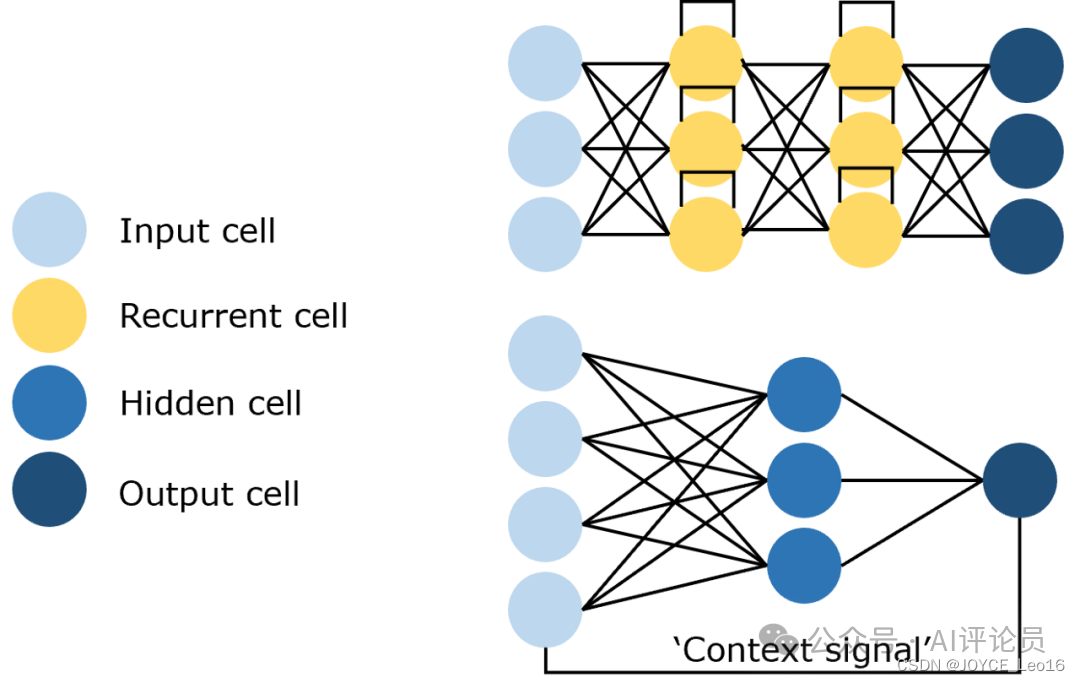
是一种专门处理序列数据的神经网络架构,其核心特点是具有记忆能力,能够存储历史信息并影响当前决策。与传统神经网络不同,RNN通过隐藏状态(hidden state)的循环连接,将前一个时间步的输出作为当前时间步的输入,从而实现对序列数据的时序建模。这种结构使RNN能够捕捉数据中的时间依赖性,适用于自然语言处理、语音识别、时间序列预测等任务。典型的RNN变体包括LSTM和GRU

网络结构

  • 输入层:接收输入数据,并将其传递给隐藏层。输入不仅仅是静态的,还包含着序列中的历史信息。

  • 隐藏层:核心部分,捕捉时序依赖性。隐藏层的输出不仅取决于当前的输入,还取决于前一时刻的隐藏状态。

  • 输出层:根据隐藏层的输出生成最终的预测结果。

06.png

解决问题

  • 序列数据处理:RNN能够处理多个输入对应多个输出的情况,尤其适用于序列数据,如时间序列、语音或文本,其中每个输出与当前的及之前的输入都有关。

  • 循环连接:RNN中的循环连接使得网络能够捕捉输入之间的关联性,从而利用先前的输入信息来影响后续的输出。

工作原理

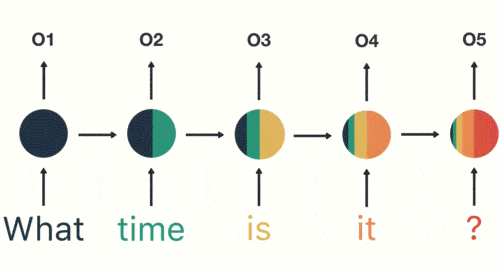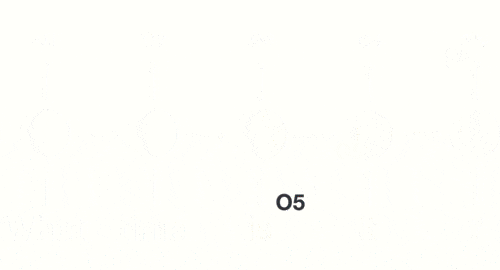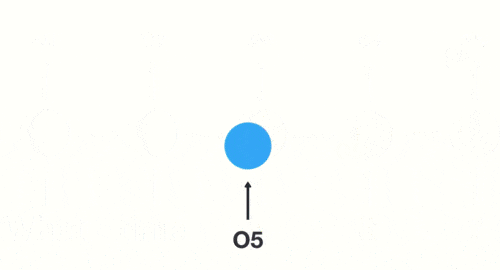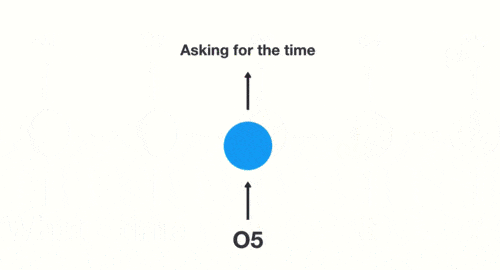
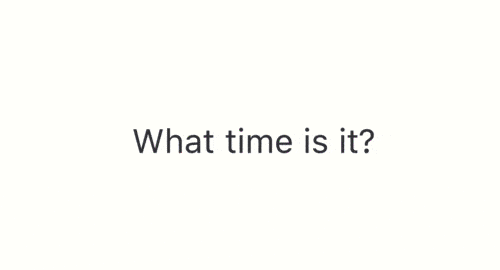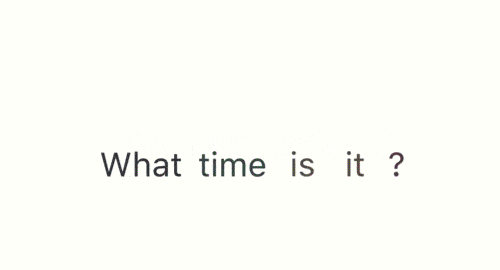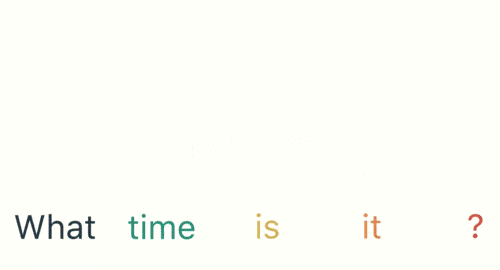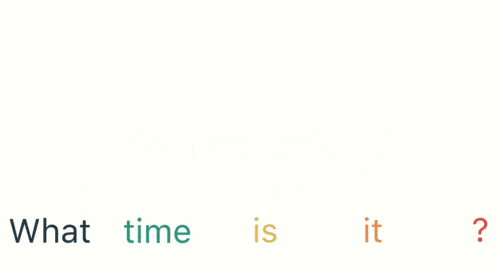
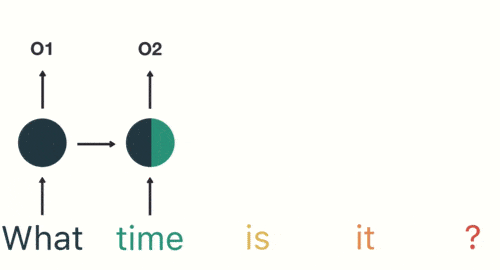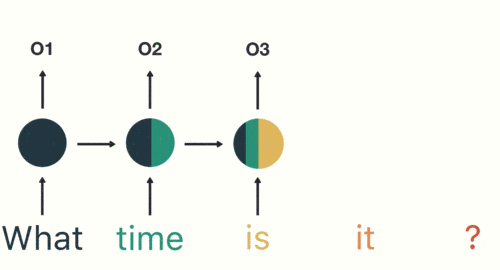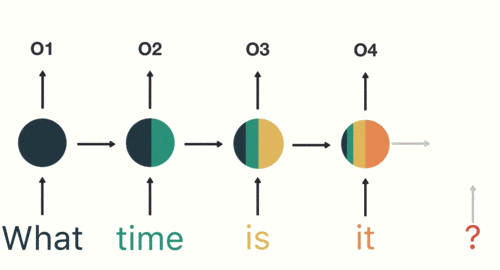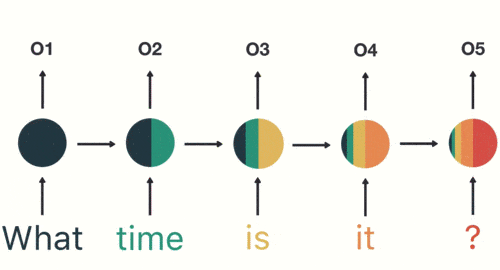
  • 输入层:先对句子“what time is it ?”进行分词,然后按照顺序输入。
07.gif

  • 隐藏层:在此过程中,我们注意到前面的所有输入都对后续的输出产生了影响。圆形隐藏层不仅考虑了当前的输入,还综合了之前所有的输入信息,能够利用历史信息来影响未来的输出。
08.gif

  • 输出层:生成最终的预测结果:Asking for the time。

09.gif

应用场景

(1)处理数据

  • 文本数据:处理文本中单词或字符的时序关系,并进行文本的分类或翻译。

  • 语音数据:处理语音信号中的时许信息,并将其转换为相应的文本。

  • 时间序列数据:处理具有时间序列特征的数据,如股票价格、气候变化等。

  • 视频数据:处理视频帧序列,提取视频中的关键特征。

(2)实际应用

  • 文本生成:填充给定文本的空格或预测下一个单词。典型场景:对话生成。

  • 机器翻译:学习语言之间的转换规则,并自动翻译。典型场景:在线翻译。

  • 语音识别:将语音转换成文本。典型场景:语音助手。

  • 视频标记:将视频分解为一系列关键帧,并为每个帧生成内容匹配的文本描述。典型场景:生成视频摘要。

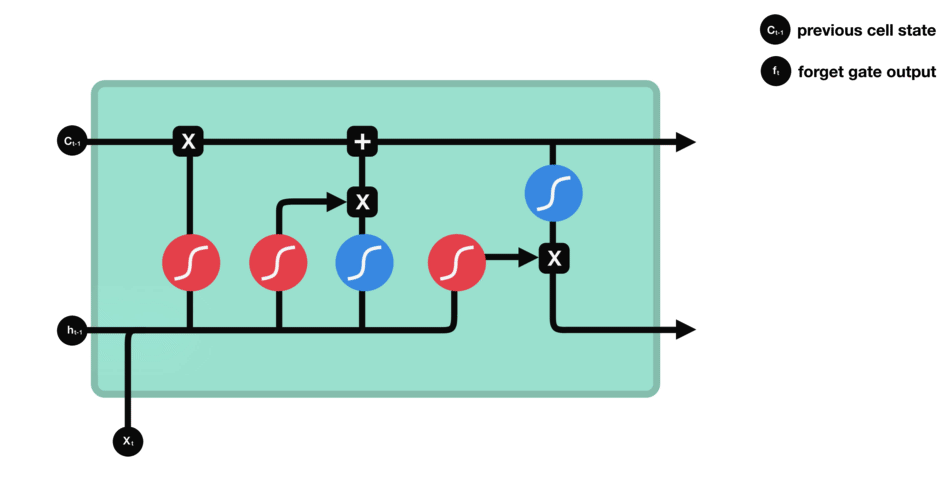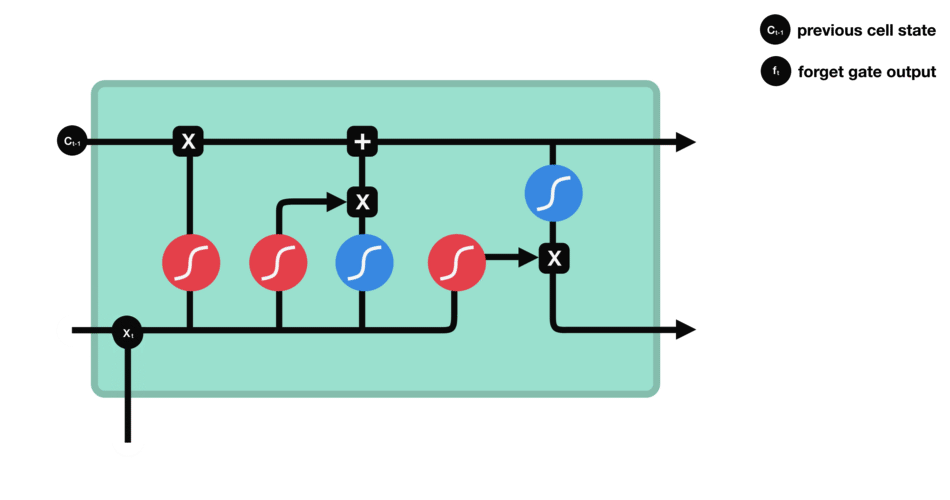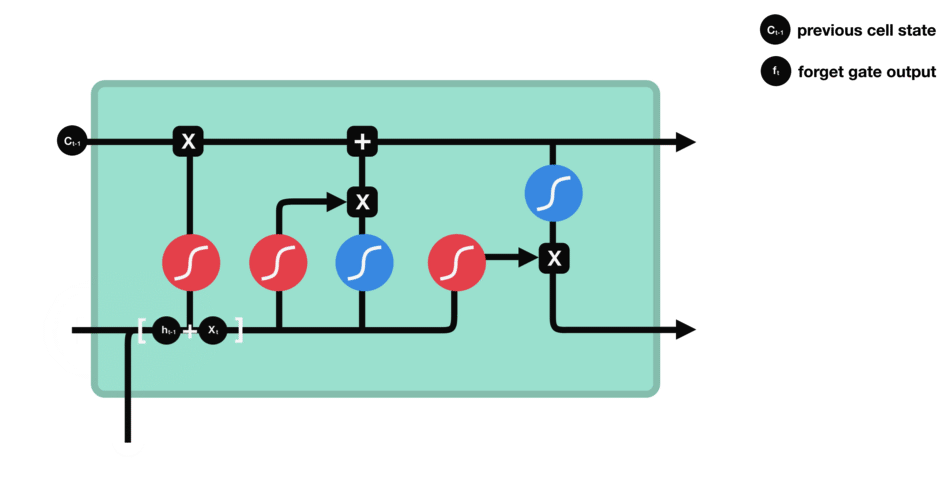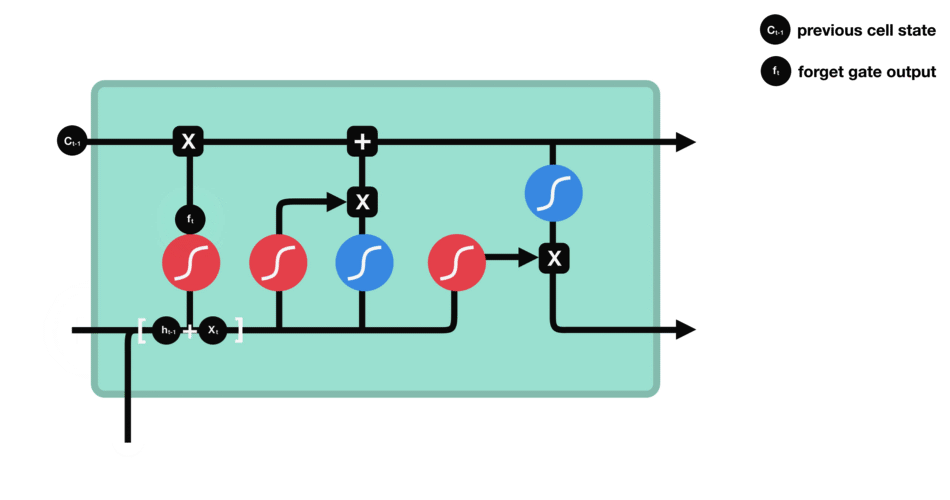
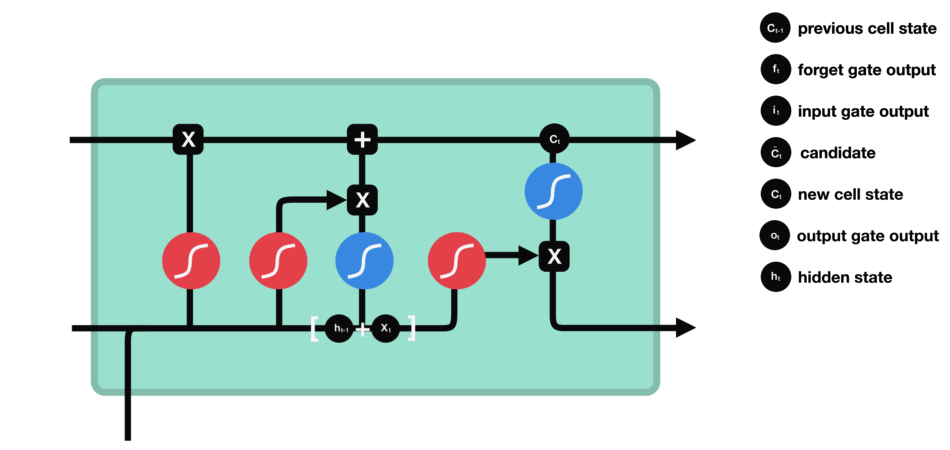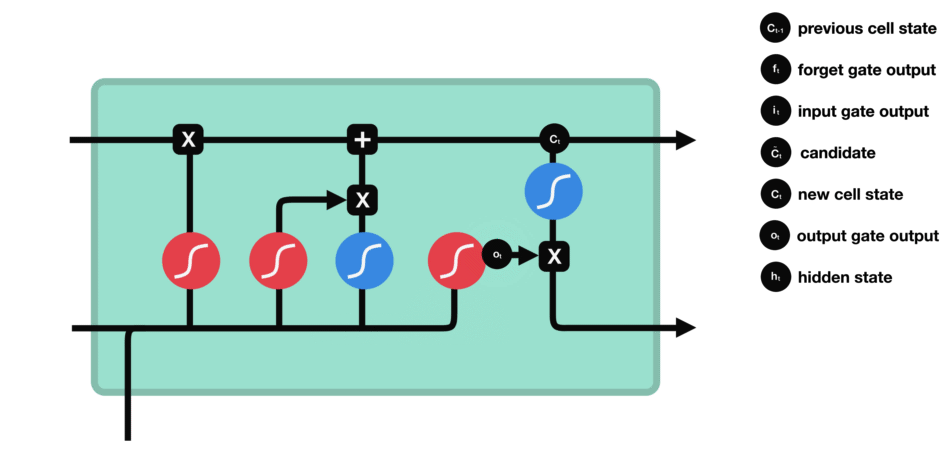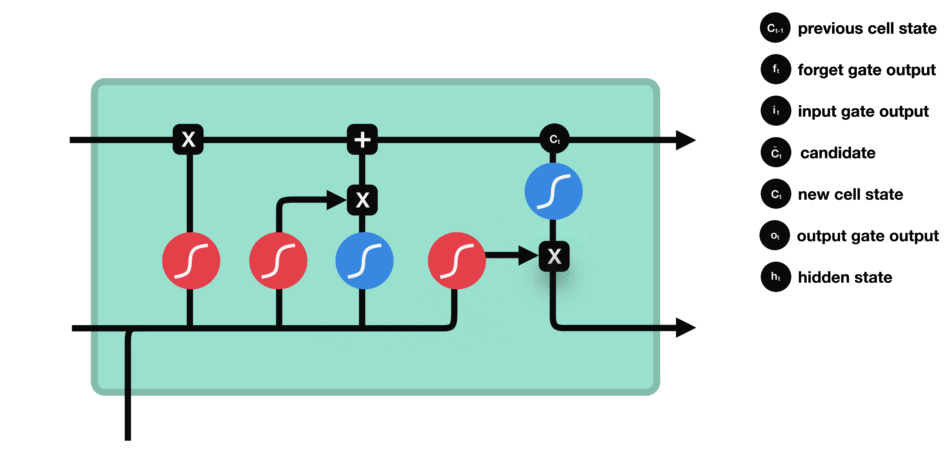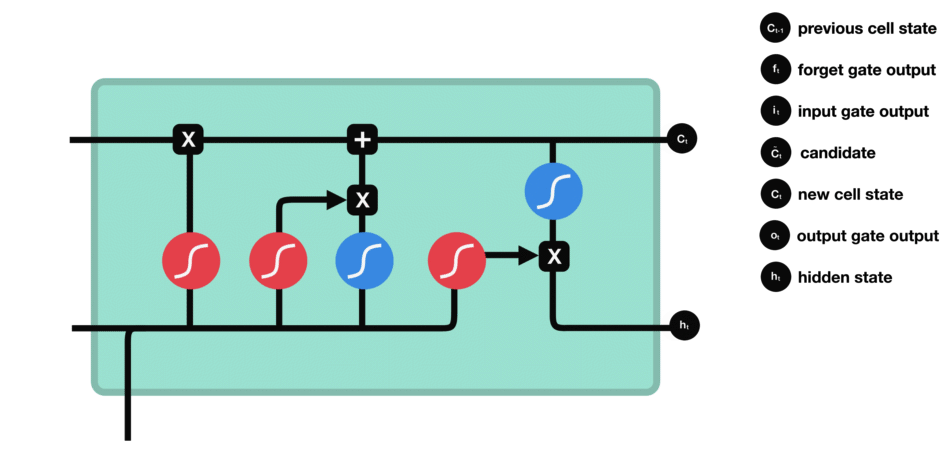
3 长短期记忆网络(LSTM)

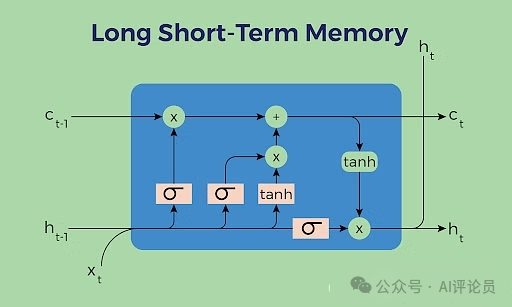
一种改进的循环神经网络,通过输入门、遗忘门和输出门控制信息流动,并利用细胞状态保存长期记忆。这种门控机制有效解决了传统RNN的梯度消失问题,使其能够学习长序列中的依赖关系,在机器翻译、语音识别等时序任务中表现优异,显著优于标准RNN

网络结构

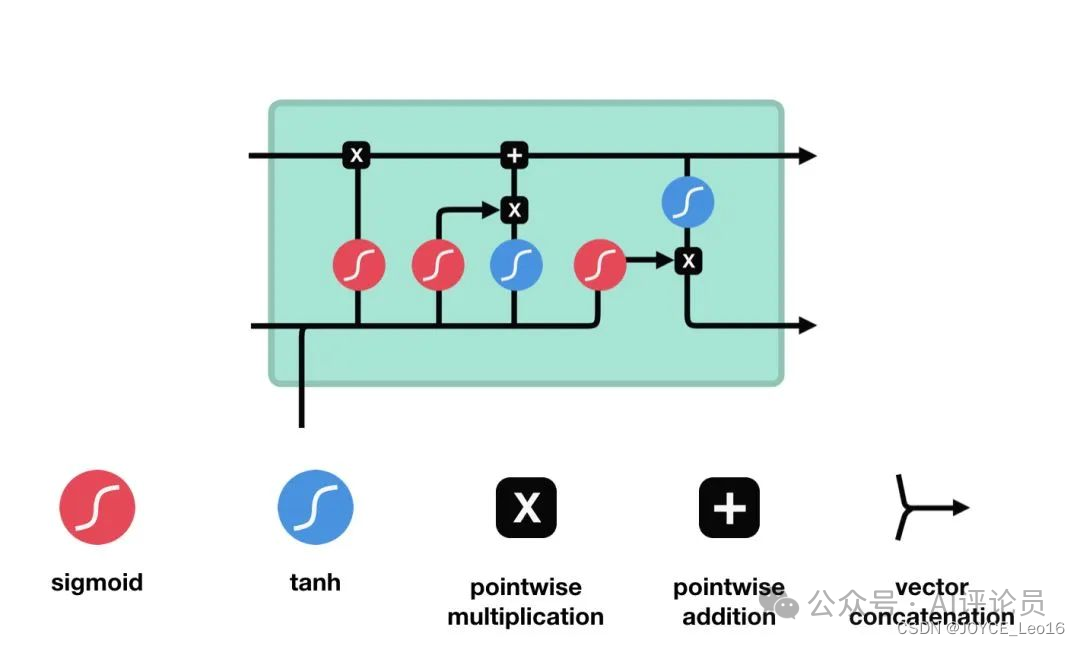
  • 细胞状态(Cell state):负责保存长期依赖信息。

  • 门控结构:每个LSTM单眼包含三个门:输入门、遗忘门和输出门。

  1. 遗忘门(Forget Gate):决定从细胞状态中丢弃哪些信息。

  2. 输入门(Input Gate):决定哪些新信息被加入到细胞状态中。

  3. 输出门(Output Gate):基于细胞状态决定输出的信息。

10.png

解决问题

  • 短时记忆:RNN难以捕捉和利用序列中的长期依赖关系,从而限制了其在处理复杂任务时的性能。

  • 梯度消失/梯度爆炸:在RNN的反向传播过程中,梯度会随着时间步的推移而逐渐消失(变得非常小)或爆炸(变得非常大)。

工作原理
11.png

  • 输入门:决定哪些新信息应该被添加到记忆单元中

由一个sigmoid激活函数和一个tanh激活函数组成。sigmoid函数决定哪些信息是重要的,而tanh函数则生成新的候选信息。
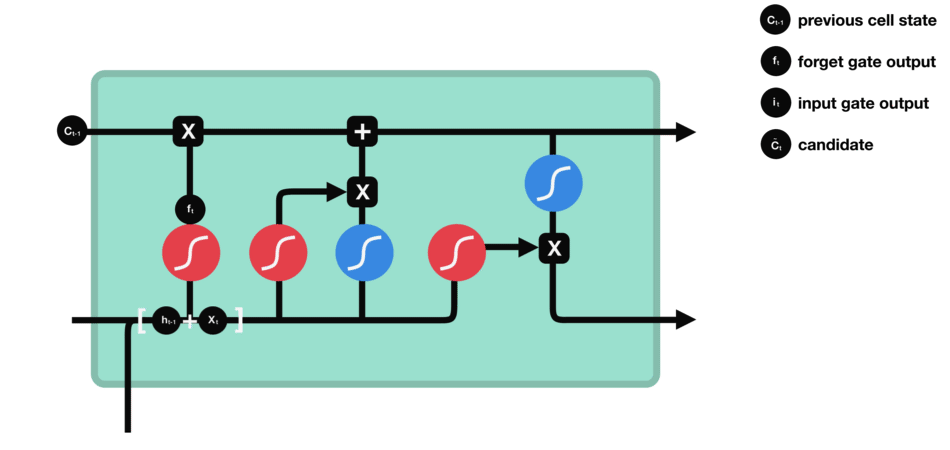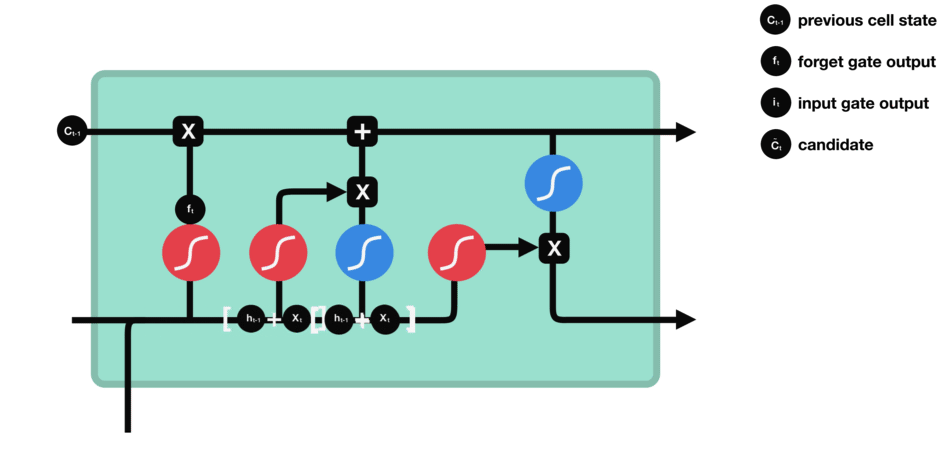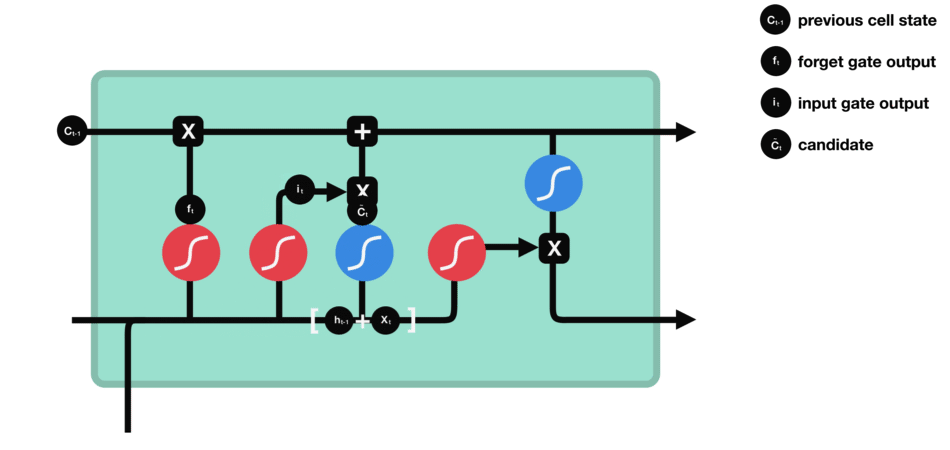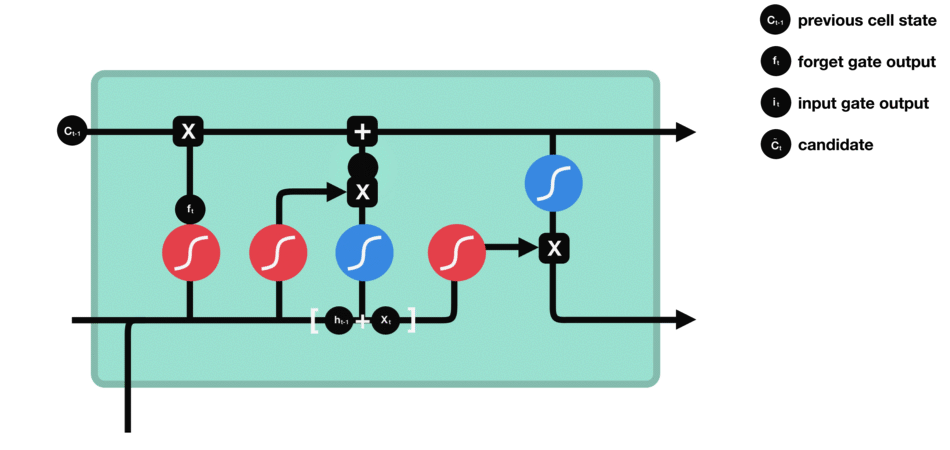
12.gif

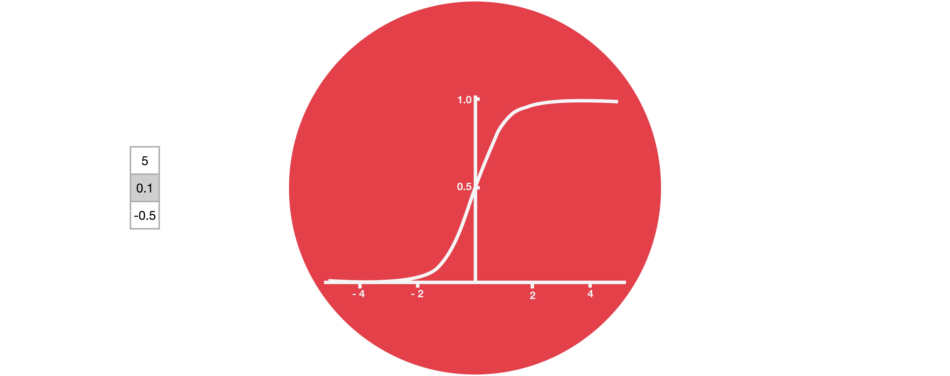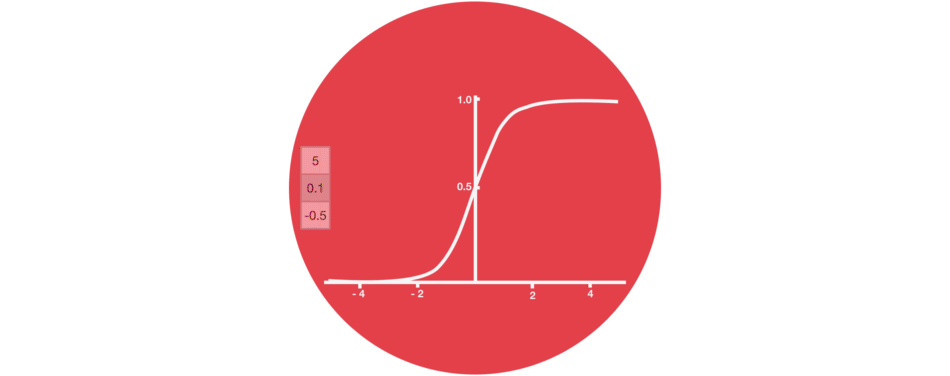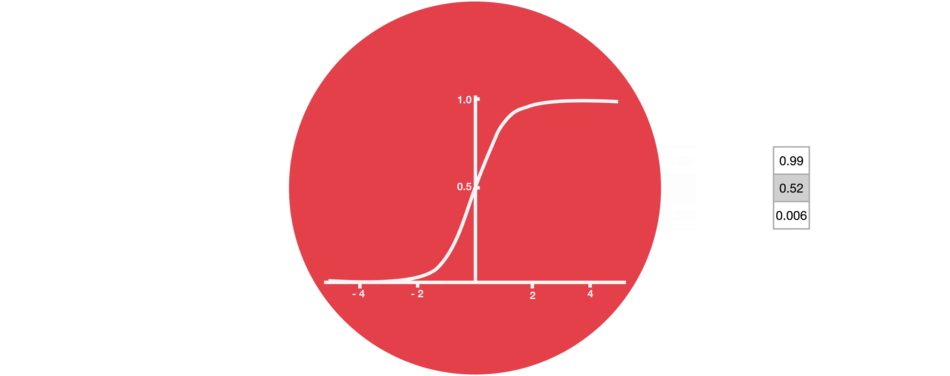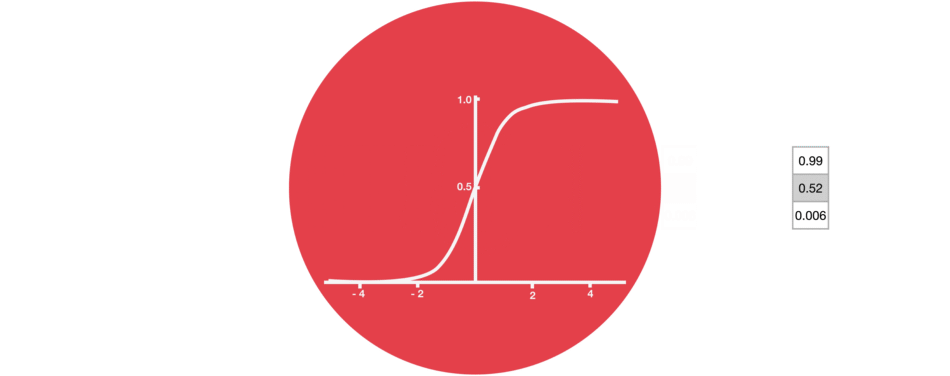
  • 遗忘门:决定哪些旧信息应该从记忆单元中遗忘或移除

遗忘门仅由一个sigmoid激活函数组成
13.gif

14.gif

  • 输出门:决定记忆单元中的哪些信息应该被输出到当前时间步的隐藏状态中。

输出门同样由一个sigmoid激活函数和一个tanh激活函数组成。sigmoid函数决定哪些信息应该被输出,而tanh函数则处理记忆单元的状态以准备输出。
15.gif

应用场景

(1)机器翻译

16.png

应用描述:

  • LSTM在机器翻译中用于将源语言句子自动翻译成目标语言句子。

关键组件:

  • 编码器(Encoder):一个LSTM网络,负责接收源语言句子并将其编码成一个固定长度的上下文向量。

  • 解码器(Decoder):另一个LSTM网络,根据上下文向量生成目标语言的翻译句子。

流程:

  • 源语言输入:将源语言句子分词并转换为词向量序列。

  • 编码:使用编码器LSTM处理源语言词向量序列,输出上下文向量。

  • 初始化解码器:将上下文向量作为解码器LSTM的初始隐藏状态。

  • 解码:解码器LSTM逐步生成目标语言的词序列,直到生成完整的翻译句子。

  • 目标语言输出:将解码器生成的词序列转换为目标语言句子。

优化:

  • 通过比较生成的翻译句子与真实目标句子,使用反向传播算法优化LSTM模型的参数,以提高翻译质量。

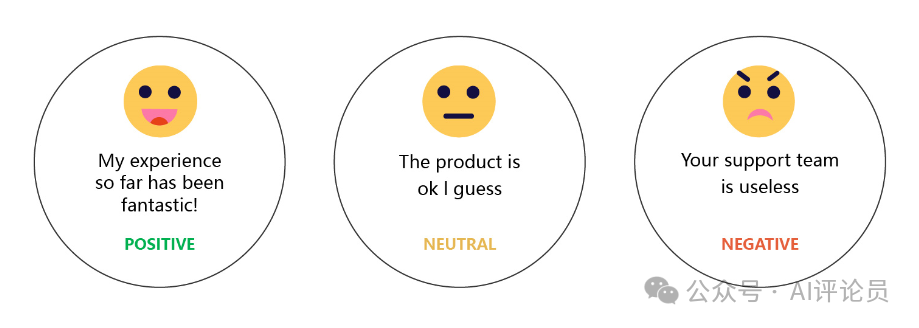
(2)情感分析
17.png

应用描述:

  • LSTM用于对文本进行情感分析,判断其情感倾向(积极、消极或中立)。

关键组件:

  • LSTM网络:接收文本序列并提取情感特征。

  • 分类层:根据LSTM提取的特征进行情感分类。

流程:

  • 文本预处理:将文本分词、去除停用词等预处理操作。

  • 文本表示:将预处理后的文本转换为词向量序列。

  • 特征提取:使用LSTM网络处理词向量序列,提取文本中的情感特征。

  • 情感分类:将LSTM提取的特征输入到分类层进行分类,得到情感倾向。

  • 输出:输出文本的情感倾向(积极、消极或中立)。

优化:

  • 通过比较预测的情感倾向与真实标签,使用反向传播算法优化LSTM模型的参数,以提高情感分析的准确性。

4 Transformer

一种革命性的神经网络架构,其核心是自注意力机制。它通过并行计算处理序列数据,利用多头注意力同时关注不同位置的信息,有效捕捉长距离依赖关系。结合位置编码和前馈网络,Transformer实现了对序列数据的多层特征抽取。这种架构不仅解决了RNN的顺序计算瓶颈,还在机器翻译、文本生成等NLP任务中取得突破性进展,成为BERT、GPT等前沿模型的基础框架。

网络结构

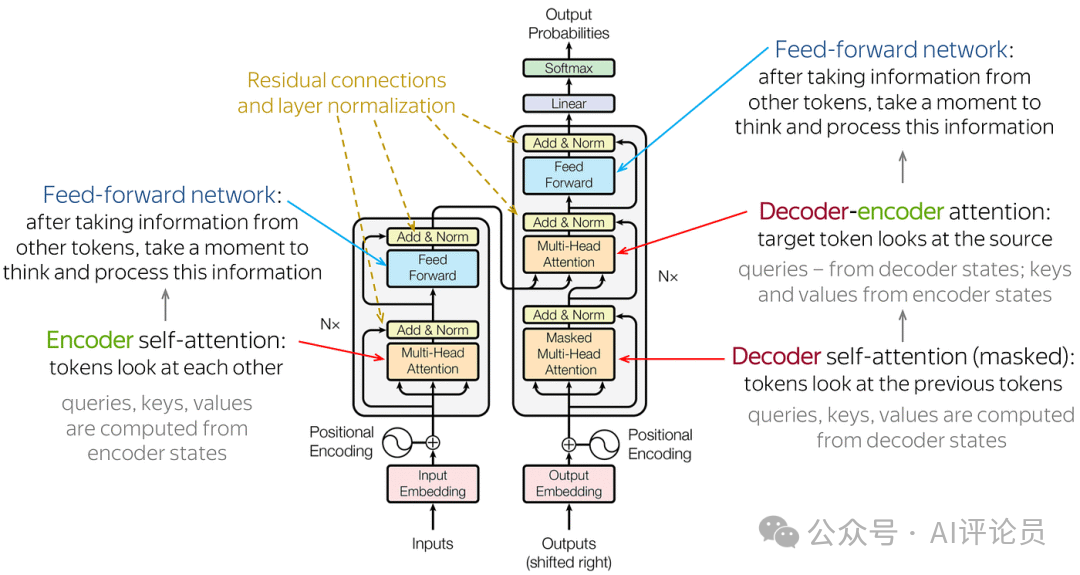
由输入部分输入输出嵌入与位置编码)、多层编码器、多层解码器以及输出部分(输出线性层与Softmax)四大部分组成。
18.png

输入部分:

  • 源文本嵌入层:将源文本中的词汇数字表示转换为向量表示,捕捉词汇间的关系。

  • 位置编码器:为输入序列的每个位置生成位置向量,以便模型能够理解序列中的位置信息。

  • 目标文本嵌入层(在解码器中使用):将目标文本中的词汇数字表示转换为向量表示。

编码器部分:

  • 由N个编码器层堆叠而成。

  • 每个编码器层由两个子层连接结构组成:第一个子层是多头自注意力子层,第二个子层是一个前馈全连接子层。每个子层后都接有一个规范化层和一个残差连接。

解码器部分:

  • 由N个解码器层堆叠而成。

  • 每个解码器层由三个子层连接结构组成:第一个子层是一个带掩码的多头自注意力子层,第二个子层是一个多头自注意力子层(编码器到解码器),第三个子层是一个前馈全连接子层。每个子层后都接有一个规范化层和一个残差连接。

输出部分:

  • 线性层:将解码器输出的向量转换为最终的输出维度。

  • Softmax层:将线性层的输出转换为概率分布,以便进行最终的预测。

解决问题

  • 长期依赖问题:在处理长序列输入时,传统的循环神经网络(RNN)会面临长期依赖问题,即难以捕捉序列中的远距离依赖关系。Transformer模型通过自注意力机制,能够在不同位置对序列中的每个元素赋予不同的重要性,从而有效地捕捉长距离依赖关系。

  • 并行计算问题:传统的RNN模型在计算时需要按照序列的顺序依次进行,无法实现并行计算,导致计算效率较低。而Transformer模型采用了编码器-解码器结构,允许模型在输入序列上进行编码,然后在输出序列上进行解码,从而实现了并行计算,大大提高了模型训练的速度。

  • 特征抽取问题:Transformer模型通过自注意力机制和多层神经网络结构,能够有效地从输入序列中抽取丰富的特征信息,为后续的任务提供更好的支持。

工作原理
19.png

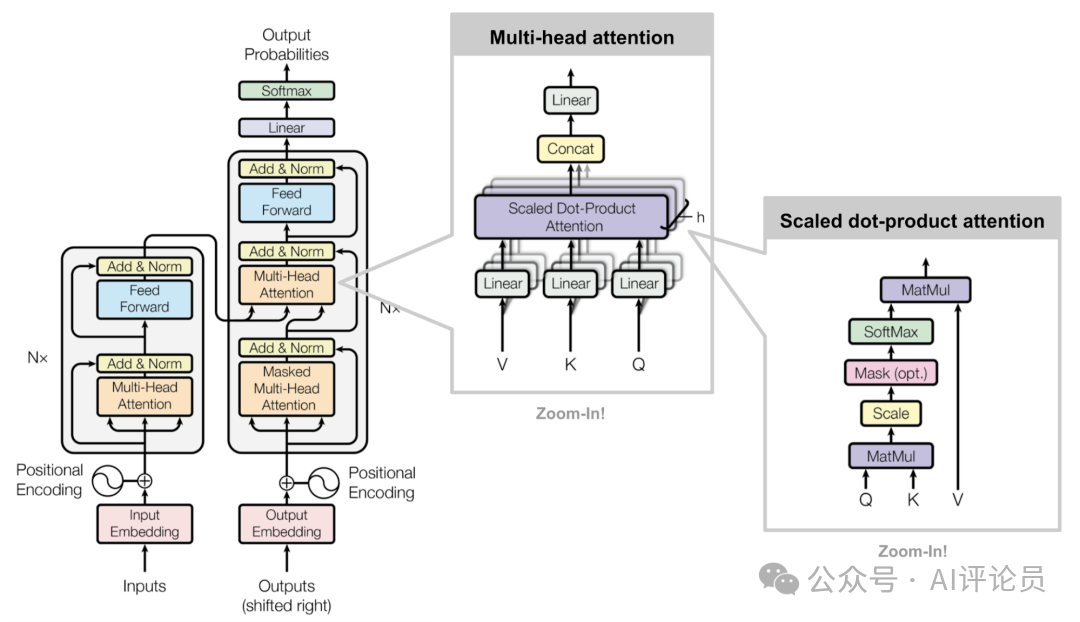
  • 输入线性变换:对于输入的Query(查询)、Key(键)和Value(值)向量,首先通过线性变换将它们映射到不同的子空间。这些线性变换的参数是模型需要学习的。

  • 分割多头:经过线性变换后,Query、Key和Value向量被分割成多个头。每个头都会独立地进行注意力计算。

  • 缩放点积注意力:在每个头内部,使用缩放点积注意力来计算Query和Key之间的注意力分数。这个分数决定了在生成输出时,模型应该关注Value向量的部分。

  • 注意力权重应用:将计算出的注意力权重应用于Value向量,得到加权的中间输出。这个过程可以理解为根据注意力权重对输入信息进行筛选和聚焦。

  • 拼接和线性变换:将所有头的加权输出拼接在一起,然后通过一个线性变换得到最终的Multi-Head Attention输出。

BERT

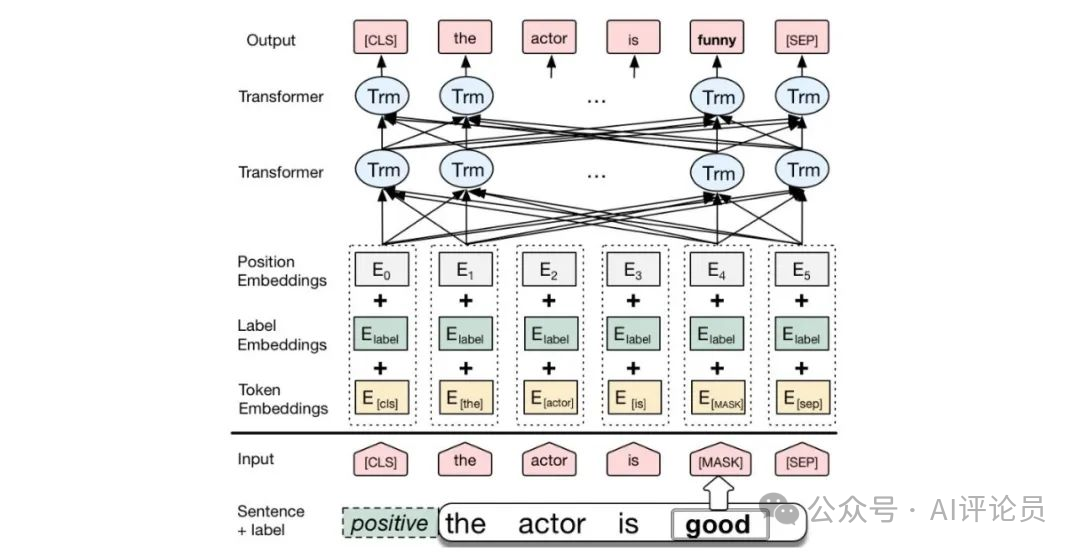
BERT是一种基于Transformer的预训练语言模型,它的最大创新之处在于引入了双向Transformer编码器,这使得模型可以同时考虑输入序列的前后上下文信息。
20.png

1. 输入层(Embedding):

  • Token Embeddings:将单词或子词转换为固定维度的向量。

  • Segment Embeddings:用于区分句子对中的不同句子。

  • Position Embeddings:由于Transformer模型本身不具备处理序列顺序的能力,所以需要加入位置嵌入来提供序列中单词的位置信息。

2. 编码层(Transformer Encoder):

  • BERT模型使用双向Transformer编码器进行编码。

3. 输出层(Pre-trained Task-specific Layers):

  • MLM输出层:用于预测被掩码(masked)的单词。在训练阶段,模型会随机遮盖输入序列中的部分单词,并尝试根据上下文预测这些单词。

  • NSP输出层:用于判断两个句子是否为连续的句子对。在训练阶段,模型会接收成对的句子作为输入,并尝试预测第二个句子是否是第一个句子的后续句子。

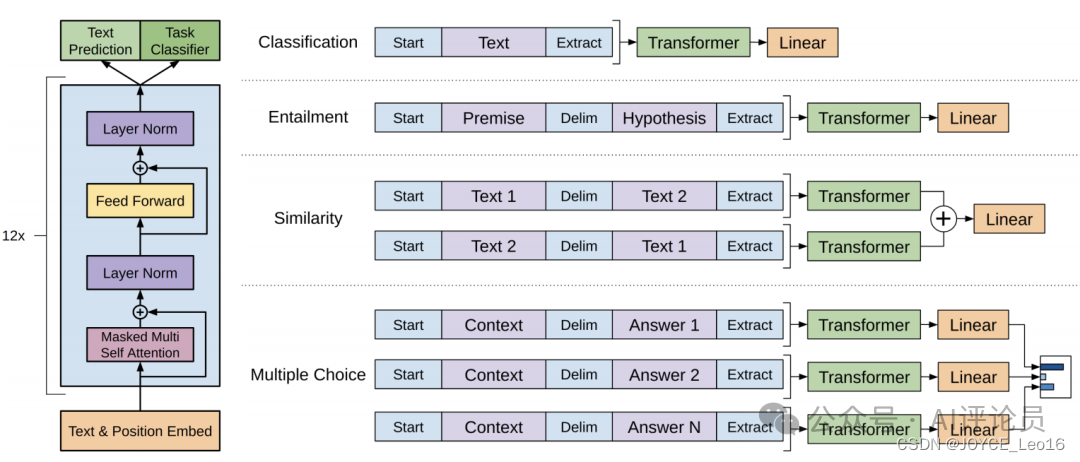
GPT

GPT也是一种基于Transformer的预训练语言模型,它的最大创新之处在于使用了单向Transformer编码器,这使得模型可以更好地捕捉输入序列的上下文信息。
21.png

1. 输入层(Input Embedding):

  • 将输入的单词或符号转换为固定维度的向量表示。

  • 可以包括词嵌入、位置嵌入等,以提供单词的语义信息和位置信息。

2. 编码层(Transformer Encoder):

  • GPT模型使用单向Transformer编码器进行编码和生成。

3. 输出层(Output Linear and Softmax):

  • 线性输出层将最后一个Transformer Decoder Block的输出转换为词汇表大小的向量。

  • Softmax函数将输出向量转换为概率分布,以便进行词汇选择或生成下一个单词。

放在最后:

另外想结合AI发文发刊,但不知道怎么做创新的同学,我们team磨练出了一套系统且专业的传统学科交叉AI科研入门方案,可带学生发paper,已迭代五次(持续迭代中),我们会根据你的研究方向来规划学习路径,并且根据你的实验数据分为了时序、图结构、影像三大实验室

文章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

神经网络之lstm 长短期记忆网络(Long Short-Term Memory, LSTM)是一种特殊类型的循环神经网络(RNN),由 Hochreiter 和 Schmidhuber 于 1997 年提出。LSTM 旨在解决传统 RNN 在处理长序列数据时遇到的梯度消失或梯度爆炸问题。LSTM 网络的核心是三个门的机制:遗忘门(forget gate)、输入门(input gate)、输出门(output gate)。这些门通过自适应的方式控制信息的流动,从而实现对长期依赖信息的捕捉。 阅读详情

相关推荐

LSTM神经网络详解

LSTM 长短时记忆网络(Long Short Term Memory Network, LSTM),是一种改进之后的循环神经网络,可以解决RNN无法处理长距离的依赖的问题,目前比较流行。 长短时记忆网络的思路: 原始 RNN 的隐藏层只有一个状态,即h,它对于短期的输入非常敏感。 再增加一个状态,即c,让它来保存长期的状态,称为单元状态(cell state)。 按照上面时间维度展开: 在 t 时刻,LSTM 的输入有三个:当前时刻网络的输入值 X_t、上一时刻 LSTM 的输出值 h_t-1、以及上

Maple__Boy 5万+

变形金刚——Transformer入门刨析详解

Transformer详解

m0_67505927的博客 10万+

霍尔编码器 vs 磁编码器:如何为你的电机控制项目选择最佳传感器(附实战对比)

本文深入对比了霍尔编码器和磁编码器在电机控制项目中的应用,从技术原理、性能参数、成本效益到实际场景选择提供了全面分析。通过实验室测试和项目案例,帮助工程师根据精度、环境抗性和预算选择最佳传感器方案,特别适合机器人、伺服驱动等领域的开发者参考。

weixin_28312391的博客 352

Transformer详解

近期Transformer MLP系列模型的出现,增加了CV领域的多样性。但是Transformer这一不同领域的模型对学习者来说需要一个细致的学习过程.下面就是本菜鸟总结学习路线。

qq_52302919的博客 7万+

LabVIEW电压信号采集系统:从零搭建到科研实战

本文详细介绍了如何从零开始搭建一个基于LabVIEW的电压信号采集系统。内容涵盖硬件选型(如NI USB-6002数据采集卡)、软件环境配置、核心程序开发(包括多通道同步采集、数据自动保存)以及高级功能优化。系统支持自定义采样率与时长,并提供了完整的LabVIEW程序框图和配套的Python数据分析脚本,旨在帮助科研人员和工程师快速构建稳定、高效的专属数据采集方案,提升实验自动化水平。

gold8的专栏 461

淘宝电商产品价格官方防爬取采集设计机制,如何破?|淘宝电商API数据采集看完你也会!

然而,随着电子商务的蓬勃发展,涌现出大量的第三方工具和应用,试图通过采集淘宝电商产品价格等信息来进行数据分析和竞争优势的获取。为了维护市场秩序和保护商家权益,淘宝采取了一系列的防爬取设计机制,以阻止非授权的数据采集行为。为了确保数据的准确性和及时性,淘宝采取了多层次的防爬取机制,以限制未经授权的数据采集。其它的情况,比如淘宝首页、淘宝关键词商品搜索结果页面、商品详情页面,都是正常展示,未实现加密;也可以使用【tesseract ocr识别】指令,这个是免费无限使用的;【淘宝商品搜索结果页面-本地截图】

TinagirlAPI的博客 1387

卷积神经网络(CNN)超详细介绍

文章转自:https://blog.youkuaiyun.com/jiaoyangwm/article/details/80011656 文章目录 1、卷积神经网络的概念2、 发展过程3、如何利用CNN实现图像识别的任务4、CNN的特征5、CNN的求解6、卷积神经网络注意事项7、CNN发展综合介绍8、LeNet-5结构分析9、AlexNet10、ZFNet10.1 意义10.2 实现方法10.3 训练细节10.4 卷积网络可视化10.6 总结 11、VGGNet11.1 结构11.2 网络特点:11.3 分

weixin_44021149的博客 6万+

基于深度学习的推荐系统设计与实现

基于深度学习的推荐系统设计与实现 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming / TextGenWebUILLM 基于深度学习的推荐系统设计与实现 关键词:深度学习, 推荐系统, 用

AI天才研究院 1079

(太长太全面了)CNN超详细介绍

原文链接:https://blog.youkuaiyun.com/jiaoyangwm/article/details/80011656 文章目录1、卷积神经网络的概念2、

qq_43703185的博客 3万+

基于 高斯过程回归(Gaussian Process Regression, GPR) 的 时间序列区间预测 的 MATLAB 示例代码

基于 高斯过程回归(Gaussian Process Regression, GPR) 的 时间序列区间预测 的 MATLAB 示例代码

算法如诗的博客 154

uniapp [全端兼容] - 详细实现下拉筛选菜单功能组件,下拉式筛选菜单效果,类似电商美团点击筛选项底部弹出列表点击选择后自动收起(详细示例代码,全端兼容小程序、安卓苹果app、h5网页、nvue

uni-app,vue2,vue3,向下弹出菜单包含筛选功能,日期筛选,下拉框选择器,下拉多条件筛选,下拉式筛选菜单,uniApp如何实现条件下拉筛选,Uniapp官方条件筛选组件,下拉框式条件筛选插件组件,最好用的插件组件,多端兼容,下拉菜单筛选,过滤筛选列表,下拉筛选栏,多列联动的条件筛选,下拉菜单地区和筛选,微信小程序,支付宝小程序,h5网页,移动端网站,安卓app,苹果app,nvue,uniapp所有平台兼容,下拉菜单筛选,下拉式条件筛选,下拉列表,点击排序,级联筛选,uniapp实现下拉筛选

🏆 前端领域优质创作者 1万+

【超详细】【原理篇&实战篇】一文读懂Transformer

Transformer是一种用于自然语言处理(NLP)和其他序列到序列(sequence-to-sequence)任务的深度学习模型架构,它在2017年由Vaswani等人首次提出。Transformer架构引入了自注意力机制(self-attention mechanism),这是一个关键的创新,使其在处理序列数据时表现出色。

艰难困苦,玉汝于成。 68万+

MTK Camera HAL 与 FeaturePipe 架构解析:从硬件抽象到功能管线的工程落地路径

MTK 的 Camera 系统在 Android 平台下采用高度模块化的 HAL 与 FeaturePipe 架构组合,分别承担着底层硬件抽象与上层功能封装的职责。通过将 ISP、3A 算法、Sensor 驱动与图像处理节点解耦封装于功能链条中,联发科平台实现了灵活可控的影像能力调度机制。本文将基于真实项目实践,系统解析 MTK Camera HAL 与 FeaturePipe 架构的设计思路、核心模块与运行机制,结合 AE/AWB/AF 控制流、Buffer 管理策略、功能管线构建方法与多线程调度实现方式

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1571

一文了解什么是——卷积神经网络CNN

为什么还有人不会CNN啊?写这么详细你还不看呐QWQ

WenJGo的博客 1万+

Python爬虫实战:利用最新技术爬取抖音话题挑战视频

本文将详细介绍如何使用Python最新技术栈构建一个高效的抖音话题挑战视频爬虫。我们将从环境配置开始,逐步讲解请求模拟、数据解析、反反爬策略、数据存储等关键环节,并提供完整的代码实现。本文适合有一定Python基础的开发者学习高级网络爬虫技术。关键词:Python爬虫、抖音API、话题挑战、视频爬取、反反爬本文详细介绍了如何使用Python最新技术栈构建抖音话题挑战视频爬虫。我们从基础请求开始,逐步实现了数据解析、反反爬策略、数据存储等核心功能,并探讨了分布式和增量爬取等高级主题。更智能的反反爬策略。

2201_76125261的博客 1744

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

神经网络算法 - 一文搞懂 Transformer(总体架构 & 三种注意力层)

本文将从三个方面,带您一文搞懂**输入嵌入:将输入的文本转换为向量,便于模型处理。位置编码:给输入向量添加位置信息,因为Transformer并行处理数据而不依赖顺序。多头注意力:让模型同时关注输入序列的不同部分,捕获复杂的依赖关系。残差连接与层归一化:通过添加跨层连接和标准化输出,帮助模型更好地训练,防止梯度问题。带掩码的多头注意力:在生成文本时,确保模型只依赖已知的信息,而不是未来的内容。前馈网络:对输入进行非线性变换,提取更高级别的特征。

xxue345678的博客 3万+

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

卷积神经网络(CNN)

卷积神经网络是多层感知机(MLP)的变种,由生物学家休博尔和维瑟尔在早期关于猫视觉皮层的研究发展而来,视觉皮层的细胞存在一个复杂的构造,这些细胞对视觉输入空间的子区域非常敏感,称之为感受野。CNN由纽约大学的Yann Lecun于1998年提出(LeNet-5),其本质是一个多层感知机,成功的原因在于其所采用的局部连接和权值共享的方式:一方面减少了权值的数量使得网络易于优化;另一方面降低了模型的复杂度、减小了过拟合的风险。当网络的输入为图像时,这些优点将表现地更加明显。

顺其自然~专栏 5万+

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

卷积神经网络总结

卷积神经网络模型结构 1. CNN的基本结构 图中是一个图像识别的CNN模型,最左边船的图像是输入层,计算机理解为输入若干个矩阵。接着是卷积层(Convolution Layer),卷积层的激活函数使用的是ReLU(x)=max(0,x)。在卷积层后面是池化层(Pooling layer),注意:池化层没有激活函数。 根据模型的需要卷积层+池化层的组合(或者卷积层+卷积层+池化层的组合)...

Yasin的博客 4428

CNN(卷积神经网络)详解

Why CNN 首先回答这样一个问题,为什么我们要学CNN,或者说CNN为什么在很多领域收获成功?还是先拿MNIST来当例子说。MNIST数据结构不清楚的话自行百度。。 我自己实验用两个hidden layer的DNN(全连接深度神经网络)在MNIST上也能取得不错的成绩(98.29%)。下面是一个三个hidden layer的网络结构图 盗图1 全连接深度神经网络,顾名思义,每个神经...

nwnlp的博客 33万+

你真的看懂Transformer了吗?小白学习笔记为你答疑解惑

Transformer是一种基于注意力机制的序列到序列模型,它在机器翻译任务中表现出色并逐渐成为自然语言处理领域的主流模型。Transformer模型的核心思想是使用自注意力机制(self-attention)来捕捉输入序列中各个位置的上下文关联。自注意力机制允许模型在编码和解码过程中对不同位置的信息进行加权,使得模型能够更好地理解上下文,并将重要的信息加权汇聚起来。通过多层的自注意力机制和前馈神经网络,Transformer模型能够学习到输入序列的表示,并生成与任务相关的输出。

xuleoo的博客 9438

【LSTM】深入浅出讲解长短时记忆神经网络(结构、原理)

1、LSTM的背景介绍 长短时记忆神经网络(Long Short-term Memory Networks,简称LSTM)是特殊的RNN,尤其适合顺序序列数据的处理,LSTM 由 Hochreiter & Schmidhuber (1997) 提出,并在近期被 Alex Graves 进行了改良和推广,LSTM明确旨在避免长期依赖性问题,成功地解决了原始循环神经网络的缺陷,成为当前最流行的RNN,在语音识别、图片描述、自然语言处理等许多领域中成功应用。 2、RNN的不足 图...

程序星空实验室 5万+

卷积神经网络(CNN)详细介绍及其原理详解

本文总结了关于卷积神经网络(CNN)的一些基础的概念,并且对于其中的细节进行了详细的原理讲解,通过此文可以十分全面的了解卷积神经网络(CNN),非常适合于作为Deep Learning的入门学习。下面就是本篇博客的全部内容!

IronmanJay 32万+

CNN简单介绍及基础知识

文章目录 一)卷积神经网络历史沿革 二)CNN简单介绍 三)CNN相关基础知识 前言 在过去的几年里,卷积神经网络(CNN)引起了人们的广泛关注,尤其是因为它彻底改变了计算机视觉领域,它是近年来深度学习能在计算机视觉领域取得突破性成果的基石。它也逐渐在被其他诸如自然语言处理、推荐系统和语音识别等领域广泛使用。在这里,主要从三个方面介绍CNN, (1)CNN历史发展 (2)CNN简单介绍 (3)CNN相关基础知识 一、卷积神经网络历史沿革 卷积神经网络的发展最早可...

尚拙的博客 1万+

神经网络结构——CNN、RNN、LSTM、Transformer !!

本文将从什么是CNN?什么是RNN?什么是LSTM?什么是Transformer?四个问题,简单介绍神经网络结构。神经网络结构通过卷积和池化操作有效地处理高维图像数据,降低计算复杂度,并提取关键特征进行识别和分类。网络结构用来提取图像的局部特征。用来大幅降低参数量级,实现数据降维。用来输出想要的结果。卷积神经网络(CNN)解决问题卷积操作提取图像特征,如边缘、纹理等,保留图像特征。池化操作大幅降低参数量级,实现数据降维,大大减少运算量,避免过拟合。工作原理。

不要给自己设限,尝试更多可能(思所向 皆可往) 3万+

(神经网络深度学习)--循环神经网络LSTM

如果你经过上面的文章看懂了RNN的内部原理,那么LSTM对你来说就很简单了,首先大概介绍一下LSTM,是四个单词的缩写,Long short-term memory,翻译过来就是长短期记忆,是RNN的一种,比普通RNN高级(上面讲的那种),基本一般情况下说使用RNN都是使用LSTM,现在很少有人使用上面讲的那个最基础版的RNN,因为那个存在一些问题,LSTM效果好,当然会选择它了!二、为什么LSTM比普通RNN效果好?

TU商的博客 1万+

【神经网络与深度学习】LSTM(Long Short-Term Memory)神经网络模型

LSTM(Long Short-Term Memory)是一种,通常被用于。因此,LSTM属于深度学习领域中的一种神经网络模型。在深度学习中,LSTM被广泛应用于需要处理长期依赖关系的任务,如语音识别、自然语言处理、时间序列预测等。相较于传统的RNN结构,。

qq_51467258的博客 1万+
上一篇: 看完这本1220页的教程书还不懂机器学习的可能性接近于0!
下一篇: 深度学习水论文无非就是排列组合,会讲故事,搭积木永不过时!
深度学习机器学习
博客等级 码龄2年 495粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值