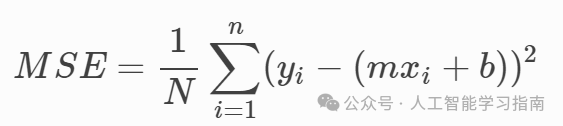掌握这四个要素,轻松理解几乎所有机器学习算法!

CRISP-ML(Q):工业级机器学习项目落地操作系统 机器学习生命周期管理是保障AI从实验走向生产的核心能力。其本质是将模型开发、部署、监控与迭代纳入可审计、可协同、可度量的标准化流程,通过质量门禁(Quality Gate)实现风险前置拦截与跨职能责任闭环。相比传统CRISP-DM,CRISP-ML(Q) 强化了运营化(Operationalization)与退役(Retirement)阶段,嵌入RACI角色矩阵和12类工程化交付模板,显著提升上线效率与系统稳定性。该框架已在汽车、能源、金融等强监管、高可靠性要求场景中验证有效,适用于追求模型可维护性、业务可 阅读详情

什么是损失函数、优化、模型或算法?机器学习算法及其术语的深奥,往往让初学者望而生畏。

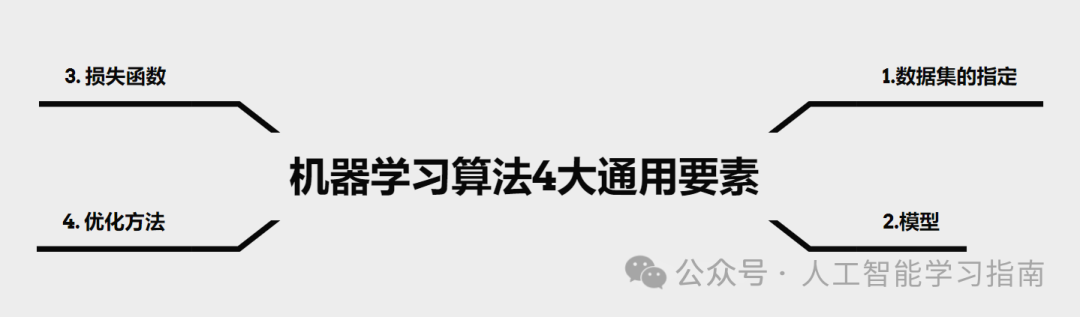
本文将通过拆解数据集、损失函数、优化方法和模型这几个要素,总结机器学习算法的每个“通用要素”。
图片

掌握这些“要素”后,你无需再将每个新遇到的机器学习算法视为孤立的实体,而是可以将其视为以下四个常见元素的独特组合。

机器学习算法种类繁多,本文将以线性回归算法为例,来探讨这四个要素。

章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
1. 数据集的指定

机器学习模型的第一个要素是数据集。

机器学习作为应用统计学的一种,依赖于大量数据。因此,你选择的数据特征(即作为输入的重要数据)会显著影响算法的性能。

选择数据特征的艺术如此重要,以至于它有了一个专门的术语:特征工程。更多关于特征工程的内容,请参见下文。

常见示例

  • X和y(输入和预期输出)→ 监督学习

  • X(仅输入)→ 无监督学习

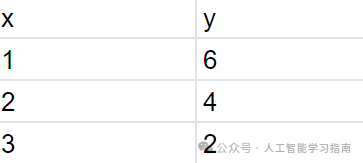
简单线性回归算法的数据集可能如下所示:

没有任何

图1.0:简单线性回归数据集
 

在线性回归示例中,我们指定的数据集就是我们的X值(输入)和y值(预测值,即观测数据)。

2. 模型

模型可以看作是一个主要函数,它接受你的X(输入)并返回你的ŷ(预测输出)。

虽然你的模型可能并不总是传统数学意义上的函数,但将模型视为函数是非常直观的,因为给定一些输入,模型会对输入进行处理以执行任务(T)。

常见示例

  • 多层感知机(基本神经网络)

  • 决策树

  • K-均值(聚类)

在简单线性回归的上下文中,模型是:

y = mx + b

其中,y是预测输出,x是输入,m和b是模型参数。

每个模型都有参数,这些参数有助于定义一个独特的模型,并且它们的值是通过从数据中学习来估计的。

例如,如果我们有第1节中的简单数据集,

没有任何

图1.0(复现):简单线性回归数据集
 

那么在线性模型中,我们的最优m和b将分别是-2和8,从而得到拟合模型y = -2x + 8。

特定的值-2和8使我们的线性模型对这个数据集来说是独一无二的。

由于我们的数据集相对简单,因此很容易确定使模型误差最小的参数值(在这种情况下,“预测”值等于“实际”值)。

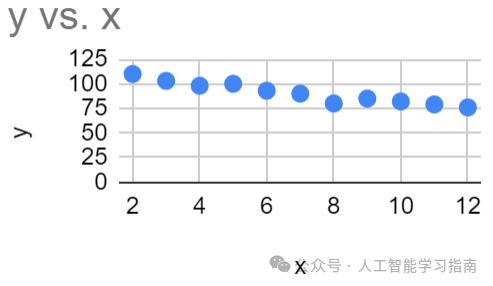
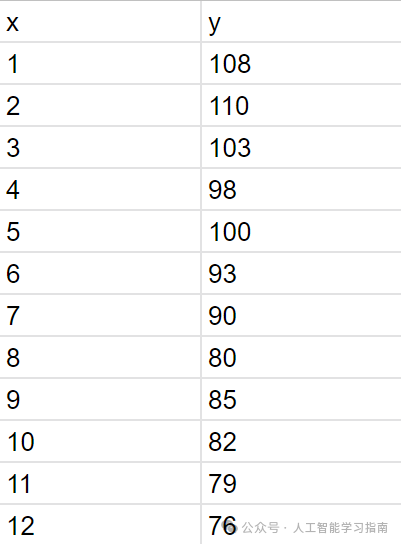
以下面这个数据集为例:
没有任何

图2.0:线性回归数据集
 

图2.0的图表如下所示

没有任何

图2.1:图2.0中数据集的图形展示
 

注意,此时找到最优的m和b不再像之前的示例那样简单。

在这种情况下,我们需要通过优化损失函数来估计最适合数据的模型参数m和b。

另外我们精心打磨了一套基于数据与模型方法的AI科研入门学习方案(已经迭代第6次),对于人工智能来说,任何专业,要处理的都只是实验数据,所以我们根据实验数据将课程分为了三种方向的针对性课程,包含时序、影像、AI+实验室,我们会根据你的数据类型来帮助你选择合适的实验室,根据规划好的路线学习 只需3-5个月左右(很多同学通过学习已经发表了 sci 一区及以下、和同等级别的会议论文)学习形式为直播+录播,多位老师为你的论文保驾护航。

适合人群:

  • 导师放养,自学无头绪

  • 时间紧任务重有延毕风险

  • 想提前完成大小论文为之后读博或工作做准备的

  • 想通过发表sci论文、提升科研能力bao研、考研的本科同学

章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

3. 损失函数

什么是损失函数?

第三个通用要素是损失函数,通常记作J(Θ)。

机器学习算法必须有一个损失函数,当这个函数被优化时,算法的预测能够尽可能准确地估计实际值,损失函数的优化过程就是学习的过程。

在最基本的意义上,损失函数是衡量观测值/实际值与基于模型的预测值之间差异的函数。

这非常直观,如果我们的函数衡量的是观测值和预测值之间的某种距离,那么当这个距离被最小化时,随着模型的学习,观测值和预测值之间的差异将逐渐减小,这意味着我们的算法预测正在成为对实际值的更好估计。

并非所有损失函数都能轻松计算,不过我们可以使用迭代数值优化(见优化方法)来优化它。

每种任务(T)都有常见的损失函数。

常见示例

  • 二次损失函数(分类、回归)*实践中不常用,但非常适合理解概念

  • 交叉熵损失函数,又称负对数似然(更多关于负对数似然和最大似然估计的信息,请参见下文链接)

  • 数据点与质心之间的残差平方和(K-均值聚类)

  • Dice损失(分割)

在我们的线性回归示例中,损失函数可以是均方误差:

没有任何

图3.0:线性回归的均方误差
 

这个损失函数衡量的是实际数据(yi)与模型预测值(mxi + b)之间的差异。

我们对这个差异进行平方,并通过除以数据点数量来对数据集取平均值。    

现在,我们可以使用优化方法来找到使损失最小的m和b。

4. 优化方法

最后是优化方法,即用于最小化或最大化相对于模型参数的损失函数的方法。

通过这个优化过程,我们正在估计使模型性能更好的参数。

优化方法主要有两种形式:

闭式优化

如果可以通过有限数量的“运算”找到函数的确切最小值(或最大值),则该函数可以进行闭式优化。

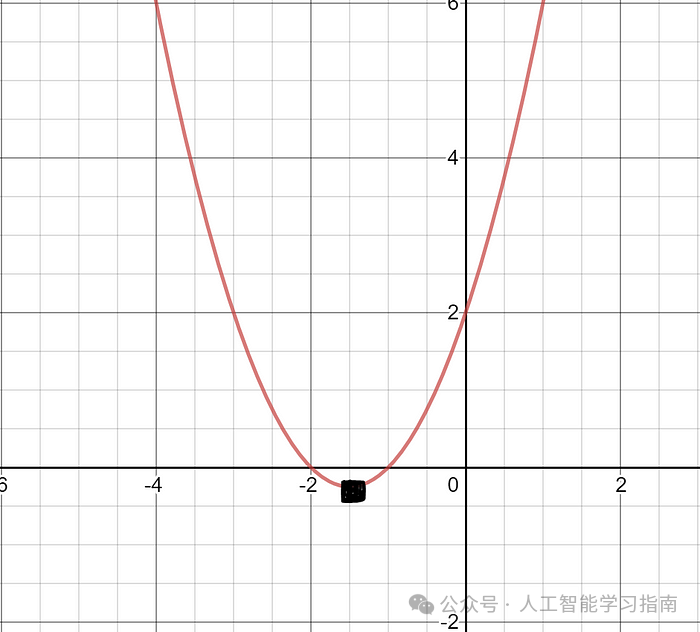
一个非常简单的例子只需要高中微积分知识。
没有任何

图4.0:函数J(w) = w² + 3w + 2的图形

通过对f(w)求导,并令其等于0(这是一系列有限运算),我们可以找到这个函数相对于w的确切最小值。

2w + 3 = 0 → w = -3/2

f(-3/2) = -1/4

迭代数值优化

迭代数值优化是一种估计最优值的技术。

它是最常见的优化方法,因为它通常比闭式优化方法具有更低的计算成本。

出于这个原因,许多算法会牺牲100%的准确性,以换取更快、更高效的极值估计,而且很多损失函数没有闭式解!
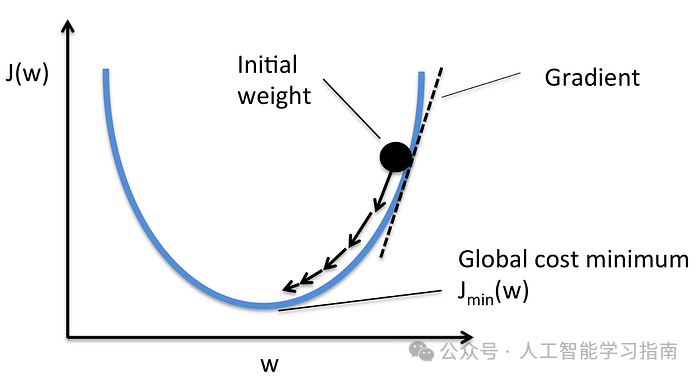
没有任何

图4.1:通过随机梯度下降(SGD)寻找使J(w)最小的w值

使用闭式优化中的相同示例,我们可以想象正在尝试优化函数J(w) = w² + 3w + 2。

我们可以想象在这个图上随机选择一个点(模型参数是随机初始化的,因此初始“预测”是随机的,函数的初始值也是随机的)。

在这种情况下,我们可以使用随机梯度下降(SGD)。

最好将这种类型的迭代优化想象为一个球在山坡/山谷中滚动,如图上图所示。

常见示例

  • 随机梯度下降(SGD)→ 迭代数值优化

  • Adam(自适应矩估计)→ 迭代数值优化

根据《深度学习》一书,“其他算法(如决策树和K-均值)需要特殊情况的优化器,因为它们的损失函数具有平坦区域……这些区域不适合基于梯度的优化器进行最小化。”

在我们的线性回归示例中,我们可以将SGD应用于均方误差损失函数,以找到最优的m和b。

我们的算法将计算均方误差相对于m和b的梯度,并迭代更新m和b,直到模型性能收敛或达到我们选择的阈值。

这类似于图中所示的J(w)函数的导数,并使w向导数的相反方向移动,使我们更接近最小值。(斜率为正时,w变得更负)

没有任何

关于反向传播的说明

许多人在深度学习的上下文中听说过反向传播这一术语。

一个常见的误解是,反向传播本身使模型学习,事实并非如此,反向传播不是优化方法。

那么反向传播在图中处于什么位置呢?

反向传播用于随机梯度下降的优化过程中的一个步骤。更准确地说,它是用于估计损失函数相对于模型参数的梯度的技术。

另外我们精心打磨了一套基于数据与模型方法的AI科研入门学习方案(已经迭代第6次),对于人工智能来说,任何专业,要处理的都只是实验数据,所以我们根据实验数据将课程分为了三种方向的针对性课程,包含时序、影像、AI+实验室,我们会根据你的数据类型来帮助你选择合适的实验室,根据规划好的路线学习 只需3-5个月左右(很多同学通过学习已经发表了 sci 一区及以下、和同等级别的会议论文)学习形式为直播+录播,多位老师为你的论文保驾护航。

适合人群:

  • 导师放养,自学无头绪

  • 时间紧任务重有延毕风险

  • 想提前完成大小论文为之后读博或工作做准备的

  • 想通过发表sci论文、提升科研能力bao研、考研的本科同学

章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~

也可以关注“AI技术星球”公众号,关注后回复“221C”获取。

开源书籍—鸢尾花书:从加减乘除到机器学习系列 | 开源专题 No.50 这篇文章是关于开源机器学习书籍《编程不难》的介绍。这本书是一个名为鸢尾花书的开源项目,从基础的加减乘除开始,逐步引导读者进入机器学习领域。这本书的核心优势和关键特性包括详细易懂的解释、渐进式教学、综合应用案例和开放资源。 阅读详情

相关推荐

看图轻松理解数据结构与算法系列(基于数组的栈)

前言 推出一个新系列,《看图轻松理解数据结构和算法》,主要使用图片来描述常见的数据结构和算法,轻松阅读并理解掌握。本系列包括各种堆、各种队列、各种列表、各种树、各种图、各种排序等等几十篇的样子。 栈 栈是一种线性存储结构且运算受限的线性表,它的插入和删除运算操作被限制在表的一端,该端称为栈顶,而另外一端则称为栈底。 栈中的数据以后进先出(Last In First Out 即LIFO)...

seaboat——a free boat on the sea.(公众号:远洋号) 730

AWS Code Examples 仓库 resources 目录全解析:跨服务示例的资源编排、基础设施与共享数据文件

`resources/` 是 aws-doc-sdk-examples 仓库中一个语言无关(language-agnostic)的公共资源层,集中存放跨服务示例运行所需的基础设施模板、前端客户端与共享数据文件。阅读本文后,你将掌握该目录四大子目录(`cdk`、`cfn`、`clients`、`sample_files`)的职责划分、各 CDK 应用创建的资源清单、三种运行 CDK 应用的方式(CD

gitblog_01152的博客 924

10、机器学习基础与数据要素解析

本文全面解析了机器学习的基础知识与数据要素,包括深度学习训练困境、预训练模型的应用、训练数据的需求、模型部署策略以及数据质量与完整性的关键因素。同时,文章深入探讨了数据科学家的职责、技能和职业发展路径,并结合不同行业的实际应用场景,展示了机器学习的广泛用途。通过本文,读者可以深入了解机器学习的核心概念和实践方法,为相关领域的学习和工作提供参考。

Pepper的专栏 60

机器学习算法交易教程第二版(一)

如果你正在阅读这篇文章,你可能已经意识到机器学习(ML)已经成为许多行业的战略能力,包括投资行业。与 ML 的兴起密切相关的数字数据的爆炸对投资产生了特别强大的影响,而投资已经有了使用复杂模型处理信息的悠久历史。这些趋势正在促成量化投资的新方法,并增加了将数据科学应用于自主和算法交易策略的需求。跨资产类别的交易范围非常广泛,因为它涵盖了从股票和政府债券到商品和房地产的范围。这意味着一个非常广泛的新型替代数据源可能与过去大多数分析工作的核心市场和基本数据相关。你可能也已经了解到,成功应用 ML 或数据科学需要

龙哥盟 4298

4、机器学习的核心要素:模型与特征深度解析

本文深入解析了机器学习的两大核心要素:模型与特征。系统介绍了朴素贝叶斯、逻辑模型、分组与分级模型等不同类型模型的特点与应用场景,探讨了特征在模型构建中的关键作用,并通过MLM数据集展示了多维度模型比较方法。文章还详细阐述了特征工程的重要性,包括特征选择与提取的常用技术,并结合电子邮件分类案例说明其实践流程。最后对模型特性与应用场景的匹配进行了分析,为读者提供了一套完整的模型选择与特征设计思路。

vim8coder的博客 63

Codesys 3.5报警功能配置保姆级教程:从变量定义到确认方式(含REF/ACK详解)

本文详细介绍了Codesys 3.5报警功能的配置流程,从变量定义到确认方式的选择,特别解析了REF和ACK两种确认方式的底层逻辑。通过实战案例和代码示例,帮助工程师快速掌握报警系统的搭建与调试技巧,提升工业自动化项目的可靠性。

weixin_29245767的博客 458

轻松掌握KNN算法:用邻居预测的机器学习利器

KNN(K近邻)算法是机器学习中最直观的分类与回归方法,通过计算待测样本与训练数据的距离,找出最近的K个"邻居"进行投票或取均值决策。算法核心包括K值选择、距离度量(如欧氏距离)、决策规则和高效检索优化。实战案例显示,KNN在鸢尾花分类中准确率可达96%。优势是原理简单、无需训练,但存在高维计算效率低等局限。改进策略包括特征降维、加权投票和索引优化。该算法适用于中小规模数据集的快速原型开发,是机器学习入门的经典方法。

2501_91832086的博客 579

Marin说PCB之LPDDR5的布线注意事项--01

以上就是本期所有内容了,有些是通用的LPDDR5的设计准则,有的是针对单板的设计规则,严格意义说是没有哪一种规则是完全适用的LPDDR5的 通用规则的,不同的单板可能板厚,板材,层数,SOC以及DDR的型号都是不同的,一般的做法就是严格按照SOC手册上的LPDDR5的要求加上仿真同事给的建议修改优化就好了,我们下期文章不见不散。我们知道想要做好一个LPDDR颗粒,需要考虑的是因素有很多例如,电源完整性,信号完整性,层叠的设计,布局的摆放,布线的合理规划,去耦电容的摆放等等。

weixin_45223454的博客 3163

免费解锁 WeMod 专业版:Wand-Enhancer 本地补丁与手机远程面板实操指南

WeMod 免费版的广告横幅、灰色锁定项、点不动的热键,是单机玩家的长期痛点。Wand-Enhancer 是一款开源本地补丁工具:扫描本机 WeMod(Wand)安装目录,直接修改本地客户端配置,免费解锁 WeMod 专业版,零联网、零订阅,还附赠一个手机浏览器就能操作的远程面板。不懂代码、不想付费、又警惕来路不明破解包的你,照这篇文章做完,拿到的就是一个自己构建、可复现、功能完整的专业版 WeM

gitblog_00757的博客 275

基于Spring Boot框架的网上蛋糕销售系统

随着互联网的普及和电子商务的迅猛发展,网上购物已经成为人们日常生活的一部分。蛋糕作为一种受欢迎的食品,其销售市场也逐渐向网络化方向发展。网上蛋糕销售系统能够打破时间和地域的限制,让消费者随时随地浏览和购买蛋糕,同时也为蛋糕商家提供了一个展示和销售产品的平台。该系统的开发旨在提高蛋糕预定和销售的便捷性,节约时间和经济成本,并推动蛋糕市场的进一步发展。开发语言:Java,一种面向对象的编程语言,具有跨平台性、稳定性和安全性等特点,适用于构建大型、复杂的Web应用程序。 框架:Spring Boot,一个基于Sp

2301_81127431的博客 997

解决OpenCASCADE性能瓶颈:显示加速与三角剖分优化全攻略

本文深入探讨OpenCASCADE在工业设计和CAD建模中的性能优化策略,重点解决显示加速与三角剖分等核心瓶颈问题。通过智能刷新控制、显示数据结构优化和动态LOD技术,显著提升渲染效率和交互体验,适用于复杂场景下的三维可视化应用。

weixin_30752699的博客 344

你真的对你构建的ML模型足够了解么?

https://www.toutiao.com/a6706346424298127876/ 我们真的了解在我们构建的ML模型中发生了什么吗?让我们来探索吧。 在我之前的博客中,我们看到了对XGBoost、LightGBM和Catboost的比较研究。通过这种分析,我们得出结论,catboost在速度和准确性方面都优于其他两个。在这一部分中,我们将深入探讨catboost,探索catb...

喜欢打酱油的老鸟 1333

Mac---安装Navicat

把这个填充好的字符串放入刚才打开的RSA在线加解密的网站中的第二个框框(替换之前的请求码),第一个框框不动(还是之前第10步骤中的私钥),点击RSA私钥加密,这时会得到一个加密的字符串,这个就是激活码。{“K”:“你的K值”, “N”:“52pojie”, “O”:“52pojie.cn”, “DI”:“你的DI值”, “T”:你的时间戳}链接: https://pan.baidu.com/s/1mEVY4hnKdktg-p7DBIfD7A 提取码: twwg。Navicat会弹出一个对话框,点击“注册”

weixin_53970868的博客 1万+

4gaBoards数据备份与恢复一步到位:boards-backup.sh完整操作指南

4gaBoards 是一款开源的实时看板(Kanban)项目管理系统,帮助团队以 项目 → 看板 → 列表 → 卡片 → 任务 的多级结构跟踪工作。自建 4gaBoards 实例后,**数据备份**是保障卡片、评论、附件等核心资产不丢失的最后一道防线。本文完整讲解 4gaBoards 官方自带的两个脚本:[boards-backup.sh](https://link.gitcode.com/i/0

gitblog_01005的博客 1103

诠视MR眼镜Unity开发设置_Unity2020.3.38

请按照如下设置Android SDK 和 Gradle。打包前先将Unity切换到Android模式。Preferences 设置。

m0_71932574的博客 603

最新Python爬虫实战(入门爬虫篇)——案例17:某天气网40天天气预报数据采集(详细爬虫思路截图+抓包动图演示+完整爬虫代码+详细注释)

本次案例通过分析某天气网的数据接口,成功实现了对40天天气预报数据的批量采集。抓包分析:利用浏览器开发者工具找到隐藏的JSONP数据接口,掌握URL构成规律。请求模拟:构造带有Referer和User-Agent的请求头,添加时间戳参数避免缓存,获取原始数据。数据解析:处理JSONP格式,去除前缀后使用json模块解析,提取所需字段并规范化日期格式。数据存储:利用pandas将结构化数据保存为Excel文件,便于后续分析和使用。动态数据接口的发现与分析JSONP数据的清洗与解析。

努力让自己发光,对的人才能迎着光而来 22万+

如何通过可视化数学快速掌握机器学习:鸢尾花书《数学要素》完整指南

你是否在机器学习学习中遇到数学障碍?《数学要素》——鸢尾花书系列第三部,为你提供从加减乘除到机器学习的可视化学习路径。这个开源项目通过25章精心设计的数学内容,将传统数学知识与现代机器学习实践完美结合,让你在可视化探索中掌握数学之美,轻松跨越数学到AI的技术鸿沟。 ## 🎯 项目核心价值:可视化数学学习革命 传统数学学习最大的痛点在于抽象概念难以理解,而《数学要素》通过**可视化数学**彻底

gitblog_00061的博客 771

【AutoSAR】【BootLoader】AutoSAR Bootloader 原理与流程

目录 一、HIS规范 二、BOOTLOADER软件架构 三、烧写流程 一、HIS规范 国外整车厂意识到在线刷新ECU的重要性,由奥迪公司、宝马公司、戴姆勒公司、保时捷公司、大众公司成立一个委员会,名为HIS委员会,专门负责帮助汽车制造商掌握微处理器控制单元软件和质量保证领域的原理和方法; HIS Bootloader的主要功能是通过标准的通信接口对ECU进行再编程 。 HIS Bootloader的软件设计基于AUTOSAR体系架构、ISO14229、ISO15765-2、HI...

专注汽车软件开发、AutoSAR、车载以太网、SOA、EE架构。 5248

大厂面试必备!贪心算法高频考点全解析,轻松拿下送分题!

贪心算法是一种在每一步选择局部最优解以期望获得全局最优解的算法策略。其核心思想是"只顾眼前",通过局部最优选择来构建问题的解。该算法适用于具有贪心选择性质和最优子结构性质的问题,具有简单高效的特点,但可能无法保证全局最优解。经典应用包括无重叠区间、分数背包和跳跃游戏等问题。贪心算法常与其他算法结合使用,如动态规划、回溯和二分查找等。学习贪心算法需要系统练习经典问题,并验证策略的正确性。随着AI技术的发展,掌握算法优化能力成为高薪岗位的重要技能。

WANGJUNAIJIAO的博客 987

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

如何快速掌握机器学习数学:鸢尾花书《数学要素》可视化学习终极指南

你是否曾因复杂的数学公式而放弃学习机器学习?是否觉得线性代数和微积分是AI领域的"拦路虎"?《数学要素》——鸢尾花书系列第三部,为你提供了一条从加减乘除到机器学习的完整可视化学习路径。这个开源项目通过25个精心设计的章节,将传统数学知识与现代机器学习实践完美融合,让你在可视化探索中轻松掌握数学之美。 ## 🔍 传统数学学习VS可视化数学教学 | 传统数学学习痛点 | 《数学要素》解决方案 |

gitblog_00775的博客 368

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

ml5-library实际案例分享:10个成功的商业应用分析

ml5.js是一个面向网页的友好机器学习库,它让艺术家、创意程序员和学生能够轻松使用机器学习算法和模型。这个开源项目在浏览器中提供强大的AI功能,让开发者无需复杂配置就能创建智能应用。在本文中,我们将深入分析10个成功的商业应用案例,展示ml5-library在实际项目中的强大应用价值。 ## 零售行业的智能购物助手 在电商领域,ml5-library的图像分类功能被广泛应用于智能购物助手开发

gitblog_00281的博客 808

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

airi 项目 Vue 异步计算实战:VueUse `computedAsync` 的原理、用法与工程落地

> 本篇指南以仓库 [.agents/skills/vueuse-functions/references/computedAsync.md](https://link.gitcode.com/i/a85f1ff867e7cfba3f4876bcaed8ddc6) 为主体骨架,结合 airi 仓库内 `stage-tamagotchi`、`stage-ui`、`stage-pages` 等 Vue

gitblog_00526的博客 448

不存在所谓的机器学习平台!

不存在所谓的机器学习平台! 作者:Ron Schmelzer是AI研究咨询公司Cognilytica的执行合伙人兼首席分析师。 在过去这几年,你可能注意到了供应商们以越来越快的步伐推出服务于AI生态系统的“平台”,即满足数据科学和机器学习的需求。“数据科学平台”和“机器学习平台”在竞相吸引数据科学家、机器学习项目经理以及管理AI项目/计划的其他人士的目光和钱袋。如果你是主要的技术供应商,但在...

hlhl_ren的博客 230

Calico 代码贡献指南:从功能设计、PR 提交到 release 分支补丁的完整流程

本文面向想要为 Calico(cloud native networking and network security)提交代码的开发者,系统梳理当前仓库 [CONTRIBUTING.md](https://link.gitcode.com/i/e7a8a5cd192688b12b7712f6747956bc) 规定的规范贡献流程:如何区分新功能与简单 bug fix 走不同通道、如何基于 mas

gitblog_01194的博客 291

5分钟就能轻松入门的机器学习基础知识

机器学习定义机器学习(Machine Learning)本质上就是让计算机自己在数据中学习规律,并根据所得到的规律对未来数据进行预测。机器学习包括如聚类、分类、决策树、贝叶斯、神经网络、深度学习(Deep Learning)等算法。机器学习的基本思路是模仿人类学习行为的过程,如我们在现实中的新问题一般是通过经验归纳,总结规律,从而预测未来的过程。机器学习的基本过程如下:机...

weixin_43373042的博客 285
上一篇: 真心分享!纯新手怎么简单高效入门机器学习深度学习?
下一篇: 机器学习深度学习入门课程(附课件和学习笔记)
深度学习机器学习
博客等级 码龄2年 495粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值