


家好!今天用一篇文章对经典的卷积神经网络进行详解,包含LeNet、AlexNet、VGGNet、NiN、GoogLeNet、ResNet、DenseNet,同时我也整理关于神经网络几大主流SOTA模型及相关变体的论文与代码仓库,可添加我的小助手无偿获取~
章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
LeNet : 基础图像识别网络 (1998)
LeNet-5是Yann LeCun等人在多次研究后提出的最终卷积神经网络结构,一般LeNet即指代LeNet-5。LeNet-5是用来处理手写字符的识别问题的。LeNet-5阐述了图像中像素特征之间的相关性能够由参数共享的卷积操作所提取,同时使用卷积、下采样(池化)和非线性映射这样的组合结构,是当前流行的大多是深度图像识别网络的基础。
LeNet的网络结构
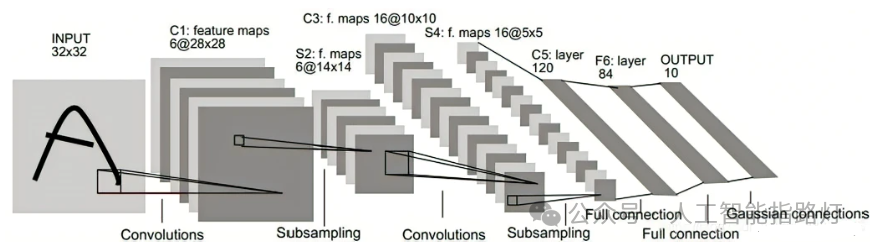
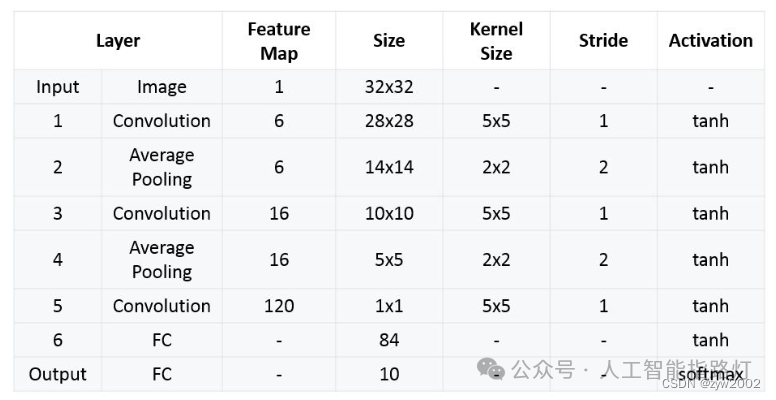
LeNet-5包含七层,不包括输入,每一层都包含可训练参数(权重),当时使用的输入数据是32*32像素的图像。下面逐层介绍LeNet-5的结构,并且,卷积层将用Cx表示,子采样层则被标记为Sx,完全连接层被标记为Fx,其中x是层索引。
LeNet-5结构:
-
输入:32x32的灰度图像,也就是一个通道,那么一个图像就是一个2维的矩阵,没有RGB三个通道。
-
Layer1:6个大小为5x5的卷积核,步长为1。因此,到这里的输出变成了28x28x6。
-
Layer2:2x2大小的池化层,使用的是average pooling,步长为2。那么这一层的输出就是14x14x6。
-
Layer3:16个大小为5x5的卷积核,步长为1。但是,这一层16个卷积核中只有10个和前面的6层相连接。也就是说,这16个卷积核并不是扫描前一层所有的6个通道。如下图,0 1 2 3 4 5这 6个卷积核是扫描3个相邻,然后是6 7 8这3个卷积核是扫描4个相邻,9 10 11 12 13 14这6个是扫描4个非相邻,最后一个15扫描6个。实际上前面的6通道每个都只有10个卷积核扫描到。
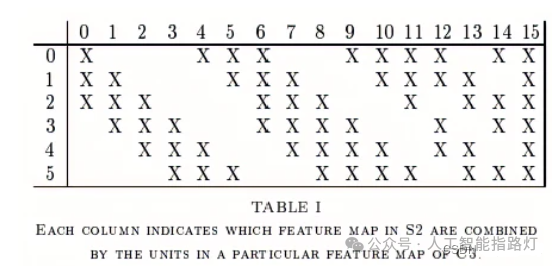
这么做的原因是打破图像的对称性,并减少连接的数量。如果不这样做的话,每一个卷积核扫描一层之后是10x10,一个核大小是5x5,输入6个通道,输出16个,所以是10x10x5x5x6x16=240000个连接。但实际上只有156000连接。训练参数的数量从2400变成了1516个。
-
Layer4:和第二层一样,2x2大小的池化层,使用的是average pooling,步长为2。
-
Layer5:全连接卷积层,120个卷积核,大小为1x1。
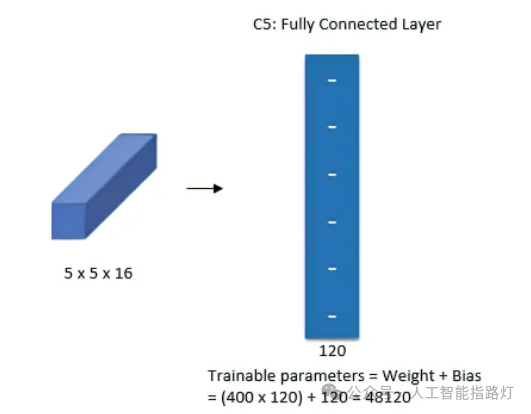
第四层结束输出为16x5x5,相当于这里16x5x5展开为400个特征,然后使用120神经元去做全连接,如下图所示:
-
Layer6:全连接层,隐藏单元是84个。
-
Layer7:输出层,输出单元是10个,因为数字识别是0-9。
最终,LeNet-5的总结如下:
LeNet小结
-
卷积网络使用一个3层的序列组合:卷积、下采样 (池化)、非线性映射 (LeNet-5最重要的特 性,奠定了目前深层卷积网络的基础)
-
使用卷积提取空间特征
-
使用映射的空间均值进行下采样
-
使用tanh或sigmoid进行非线性映射
-
多层神经网络 (MLP) 作为最终的分类器
-
层间的稀疏连接矩阵以避免巨大的计算开销
AlexNet:深度卷积网络 (2012)
Alex Krizhevsky等人在2012年提出了首个应用于图像分类的卷积神经网络变体AlexNet。他们认为特征本身应该被学习,而且特征应该由多个共同学习的神经网络层组成,每个层都有可学习的参数。
如下图,在网络的最底层,模型学习到了一些类似于传统滤波器的特征抽取器。
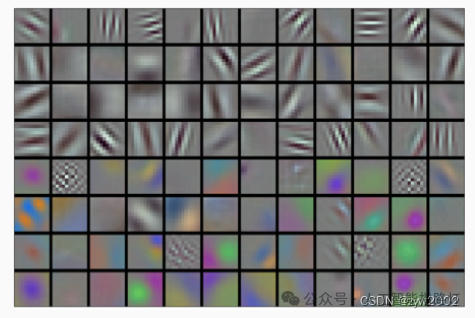
AlexNet的更高层建立在这些底层表示的基础上,以表示更大的特征,如眼睛、鼻子、草叶等等。而更高的层可以检测整个物体,如人、飞机、狗或飞盘。最终的隐藏神经元可以学习图像的综合表示,从而使属于不同类别的数据易于区分。
AlexNet使用GPU代替CPU进行运算,使得在可接受的时间范围内模型结构能够更加复杂,它的出现证明了深层卷积神经网络在复杂模型下的有效性。
AlexNet的网络架构:
AlexNet和LeNet的架构非常相似,如下图所示。左侧是LeNet, 右侧是AlexNet。
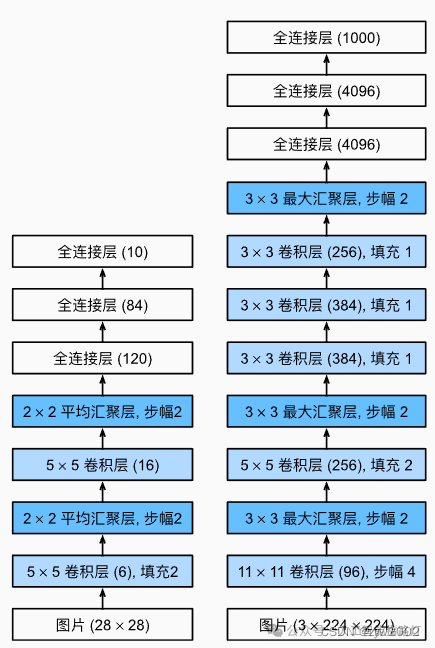
AlexNet由八层组成:五个卷积层、两个全连接隐藏层和一个全连接输出层。 其次,AlexNet使用ReLU而不是sigmoid作为其激活函数。 下面,让我们深入研究AlexNet的细节。
模型设计:
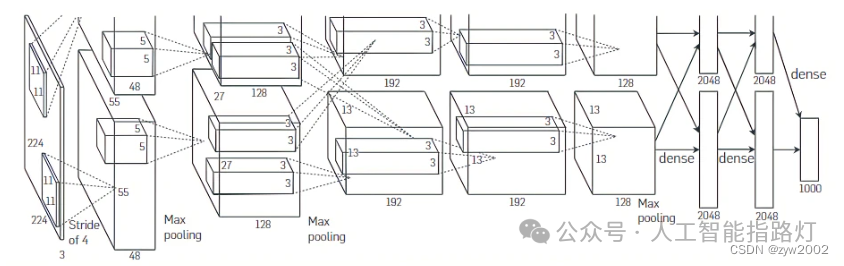
在AlexNet的第一层,卷积窗口的形状是11×11。 由于ImageNet中大多数图像的宽和高比MNIST图像的多10倍以上,因此,需要一个更大的卷积窗口来捕获目标。 第二层中的卷积窗口形状被缩减为5×5,然后是3×3。 此外,在第一层、第二层和第五层卷积层之后,加入窗口形状为3×3、步幅为2的最大汇聚层。 而且,AlexNet的卷积通道数目是LeNet的10倍。
在最后一个卷积层后有两个全连接层,分别有4096个输出。 这两个巨大的全连接层拥有将近1GB的模型参数。 由于早期GPU显存有限,原版的AlexNet采用了双数据流设计,使得每个GPU只负责存储和计算模型的一半参数。 幸运的是,现在GPU显存相对充裕,所以我们现在很少需要跨GPU分解模型(因此,我们的AlexNet模型在这方面与原始论文稍有不同)。
-
最大池化
在CNN中使用重叠的最大池化。此前CNN中普遍使用平均池化,AlexNet全部使用最大池化,避 免平均池化的模糊化效果。并且AlexNet中提出让步长比池化核的尺寸小,这样池化层的输出之间 会有重叠和覆盖,提升了特征的丰富性。
-
激活函数
此外,AlexNet将sigmoid激活函数改为更简单的ReLU激活函数。 一方面,ReLU激活函数的计算更简单,它不需要如sigmoid激活函数那般复杂的求幂运算。 另一方面,当使用不同的参数初始化方法时,ReLU激活函数使训练模型更加容易。 当sigmoid激活函数的输出非常接近于0或1时,这些区域的梯度几乎为0,因此反向传播无法继续更新一些模型参数。 相反,ReLU激活函数在正区间的梯度总是1。 因此,如果模型参数没有正确初始化,sigmoid函数可能在正区间内得到几乎为0的梯度,从而使模型无法得到有效的训练。
使用ReLU作为CNN的激活函数,并验证其效果在较深的网络超过了Sigmoid,成功解决了Sigmoid在网络较深时的梯度弥散问题,此外,加快了训练速度,因为训练网络使用梯度下降 法,非饱和的非线性函数训练速度快于饱和的非线性函数。虽然ReLU激活函数在很久之前就被 提出了,但是直到AlexNet的出现才将其发扬光大。
-
Dropout
AlexNet通过暂退法(dropout)控制全连接层的模型复杂度,而LeNet只使用了权重衰减。
Dropout虽有单独的论文论述, 但是AlexNet将其实用化,通过实践证实了它的效果。在AlexNet中主要是最后几个全连接层使用 了Dropout。
-
数据增强
随机地从 256 × 256的原始图像中截取 224 × 224大小的区域(以及水平翻转的镜 像),相当于增加了 ( 256 × 224 ) 2 × 2 = 2048倍的数据量。如果没有数据增强,仅靠原始的 数据量,参数众多的CNN会陷入过拟合中,使用了数据增强后可以大大减轻过拟合,提升泛化能力。进行预测时,则是取图片的四个角加中间共 5 个位置,并进行左右翻转,一共获得10张图 片,对他们进行预测并对10次结果求均值。
-
使用CUDA加速深度卷积网络的训练
利用GPU强大的并行计算能力,处理神经网络训练时大量 的矩阵运算。AlexNet使用了两块GTX580GPU进行训练,单个GTX580只有3GB显存,这限制了 可训练的网络的最大规模。因此作者将AlexNet分布在两个GPU上,在每个GPU的显存中储存一 半的神经元的参数。
AlexNet的代码实现
import torchfrom torch import nnfrom d2l import torch as d2lnet = nn.Sequential(# 这里,我们使用一个11*11的更大窗口来捕捉对象。# 同时,步幅为4,以减少输出的高度和宽度。# 另外,输出通道的数目远大于LeNetnn.Conv2d(1, 96, kernel_size=11, stride=4, padding=1), nn.ReLU(),nn.MaxPool2d(kernel_size=3, stride=2),# 减小卷积窗口,使用填充为2来使得输入与输出的高和宽一致,且增大输出通道数nn.Conv2d(96, 256, kernel_size=5, padding=2), nn.ReLU(),nn.MaxPool2d(kernel_size=3, stride=2),# 使用三个连续的卷积层和较小的卷积窗口。# 除了最后的卷积层,输出通道的数量进一步增加。# 在前两个卷积层之后,汇聚层不用于减少输入的高度和宽度nn.Conv2d(256, 384, kernel_size=3, padding=1), nn.ReLU(),nn.Conv2d(384, 384, kernel_size=3, padding=1), nn.ReLU(),nn.Conv2d(384, 256, kernel_size=3, padding=1), nn.ReLU(),nn.MaxPool2d(kernel_size=3, stride=2),nn.Flatten(),# 这里,全连接层的输出数量是LeNet中的好几倍。使用dropout层来减轻过拟合nn.Linear(6400, 4096), nn.ReLU(),nn.Dropout(p=0.5),nn.Linear(4096, 4096), nn.ReLU(),nn.Dropout(p=0.5),# 最后是输出层。由于这里使用Fashion-MNIST,所以用类别数为10,而非论文中的1000nn.Linear(4096, 10))
我们构造一个高度和宽度都为224的单通道数据,来观察每一层输出的形状。
X = torch.randn(1, 1, 224, 224)for layer in net:X=layer(X)print(layer.__class__.__name__,'output shape:\t',X.shape)
Conv2d output shape: torch.Size([1, 96, 54, 54])ReLU output shape: torch.Size([1, 96, 54, 54])MaxPool2d output shape: torch.Size([1, 96, 26, 26])Conv2d output shape: torch.Size([1, 256, 26, 26])ReLU output shape: torch.Size([1, 256, 26, 26])MaxPool2d output shape: torch.Size([1, 256, 12, 12])Conv2d output shape: torch.Size([1, 384, 12, 12])ReLU output shape: torch.Size([1, 384, 12, 12])Conv2d output shape: torch.Size([1, 384, 12, 12])ReLU output shape: torch.Size([1, 384, 12, 12])Conv2d output shape: torch.Size([1, 256, 12, 12])ReLU output shape: torch.Size([1, 256, 12, 12])MaxPool2d output shape: torch.Size([1, 256, 5, 5])Flatten output shape: torch.Size([1, 6400])Linear output shape: torch.Size([1, 4096])ReLU output shape: torch.Size([1, 4096])Dropout output shape: torch.Size([1, 4096])Linear output shape: torch.Size([1, 4096])ReLU output shape: torch.Size([1, 4096])Dropout output shape: torch.Size([1, 4096])Linear output shape: torch.Size([1, 10])
-
读取数据集
batch_size = 128train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=224)
-
训练
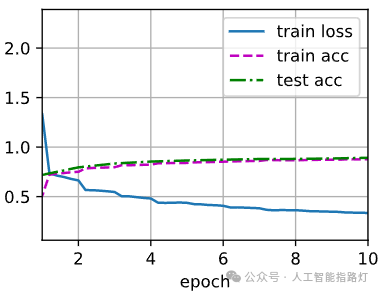
lr, num_epochs = 0.01, 10d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
s 0.327, train acc 0.881, test acc 0.8854149.6 examples/sec on cuda:0
AlexNet小结:
-
使用ReLU作为CNN的激活函数。
-
训练时使用Dropout随机忽略一部分神经元,以避免模型过拟合。
-
在CNN中使用重叠的最大池化。
-
提出了LRN层,对局部神经元的活动创建竞争机制,使得其中响应比较大的值变得相对更大,并 抑制其他反馈较小的神经元,增强了模型的泛化能力。此方法在之后的VGG中被认为是无效的。
-
AlexNet在训练时增加了大量的图像增强数据,如翻转、裁切和变色。 这使得模型更健壮,更大的样本量有效地减少了过拟合。
-
使用CUDA加速深度卷积网络的训练
ZFNet : 大型卷积网络 (2013)
ZFNet在2013年 ILSVRC 图像分类竞赛获得冠军,错误率11.19% ,比2012年的AlexNet降低了5%,ZFNet是由Matthew D.Zeiler和Rob Fergus在AlexNet基础上提出的大型卷积网络。ZFNet解释了为什么卷积神经网络可以在图像分类上表现的如此出色,以及研究了如何优化卷积神经网络。ZFNet提出了一种可视化的技术,通过可视化,我们就可以了解卷积神经网络中间层的功能和分类器的操作,这样就就可以找到较好的模型。ZFNet还进行消融实验来研究模型中的每个组件,它会对模型有什么影响。
ZFNet的网络结构

ZFNet 仅仅是在 AlexNet 上做了一些调参:
改变了 AlexNet 的第一层,即将卷积核的尺寸大小 11x11 变成 7x7,并且将步长 4变成了 2。
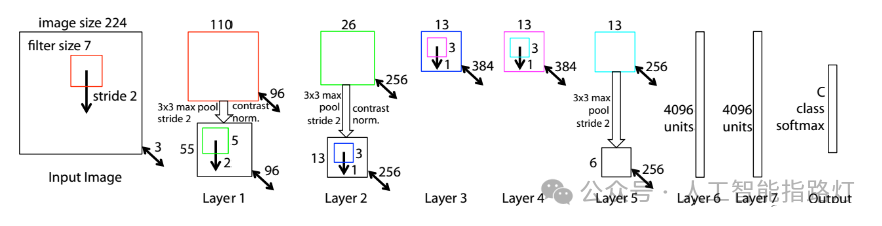
ZFNet实际上是微调(Fine-tuning)了AlexNet, 并通过反卷积(Deconvolution) 的方式可视化各层的输出特征图,进一步解释了卷积操作在大型网络中效果显著的原因。
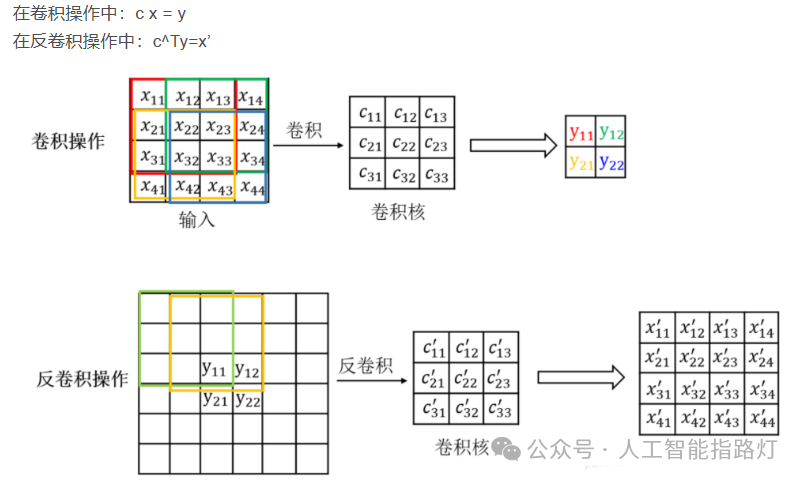
-
对卷积结果的可视化
作者将卷积核的计算结果(feature maps)映射回原始的像素空间(映射的方法为反卷积,反池化)并进行可视化。例如,下图Layer1区域最左上角的九宫格代表第一层卷积计算得到的前九张feature maps映射回原图像素空间后的可视化(称为f9)。第一层卷积使用96个卷积核,这意味着会得到96张feature maps,这里的前九张feature maps是指96个卷积核中值最大的9个卷积核对应生成的feature maps(这里称这9个卷积核为k9,即,第一层卷积最关注的前九种特征)。可以发现,这九种特征都是颜色和纹理特征,即蕴含语义信息少的结构性特征。
为了证明这个观点,作者又将数据集中的原始图像裁剪成小图,将所有的小图送进网络中,得到第一层卷积计算后的feature maps。统计能使k9中每个kernel输入计算结果最大的前9张输入小图,即9*9=81张,如下图红框中右下角所示。结果表明刚刚可视化的f9和这81张小图表征的特征是相似的,且一一对应的。由此证明卷积网络在第一层提取到的是一些颜色,纹理特征。
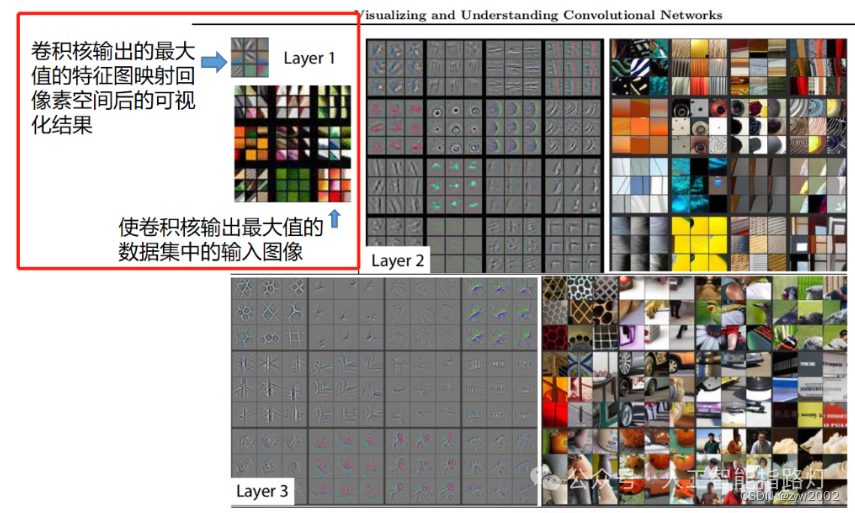
同理,观察Layer2和Layer3的可视化发现,第二次和第三次卷积提取到的特征蕴含的语义信息更丰富,不再是简单的颜色纹理信息,而是一些结构化的特征,例如蜂窝形状,圆形,矩形等等。那么网络的更深层呢?我们看下图:
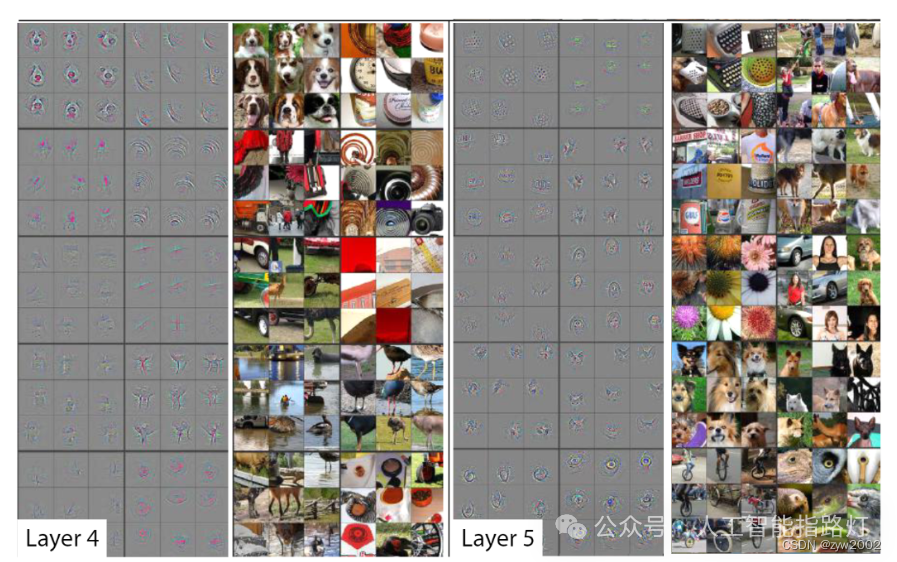
在网络的深层,如第四层,第五层卷积提取到的是更高级的语义信息,如人脸特征,狗头特征,鸟腿鸟喙特征等等。
最后,越靠近输出端,能激活卷积核的输入图像相关性越少(尤其是空间相关性),例如Layer5中,最右上角的示例:feature map中表征的是一种绿色成片的特征,可是能激活这些特征的原图相关性却很低(原图是人,马,海边,公园等,语义上并不相干);其实这种绿色成片的特征是‘草地’,而这些语义不相干的图片里都有‘草地’。‘草地’是网络深层卷积核提取的是高级语义信息,不再是低级的像素信息,空间信息等等。
-
网络中对不同特征的学习速度
如下图所示,横轴表示训练轮数,纵轴表示不同层的feature maps映射回像素空间后的可视化结果:
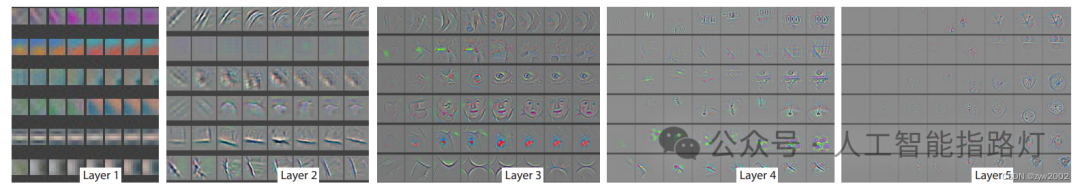
由此可以看出,low-level的特征(颜色,纹理等)在网络训练的训练前期就可以学习到, 即更容易收敛;high-level的语义特征在网络训练的后期才会逐渐学到。 由此展示了不同特征的进化过程。这也是一个合理的过程,毕竟高级的语义特征,要在低级特征的基础上学习提取才能得到。
-
图像的平移、缩放、旋转对CNN的影响
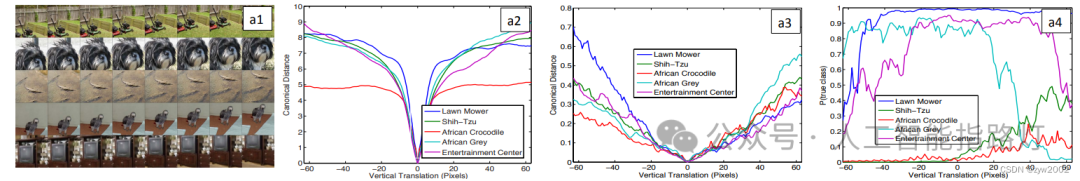
下图是探究图片平移对卷积模型影响的实验,a1是五张不同的图片经过不同大小的左右平移后的结果。
a2是原始图片与经过平移后的图片分别送进卷积网络后,第一层卷积计算得到的feature maps之间的欧氏距离,可以看出当图片平移0个像素时(即图中横轴=0处),距离最小(等于0)。其他位置随着左右平移,得到的距离都会陡增或陡减。五条彩色曲线分别代表五张不同的原始图片。
a3是原始图片与经过平移后的图片分别送进卷积网络后,第七层卷积计算得到的feature maps之间的欧氏距离,可以看出趋势与a2类似;但是,增减的曲线变换更平缓,这一定程度上说明了网络的深层提取的是高级语义特征,而不是低级的颜色,纹理,空间特征。这种语义信息不会随着平移操作而轻易改变,例如狗的图片平移后还是狗。
这个性质叫做:卷积拥有良好的平移不变性。
最后,a4表示的是原始图片与经过平移后的图片分别送进卷积网络后,卷积网络最后的识别结果。可以看出识别准确率是相对平稳的,且在横轴x=0时,识别准确率较高(此时,图片不平移,识别物体基本在图片中心位置)。
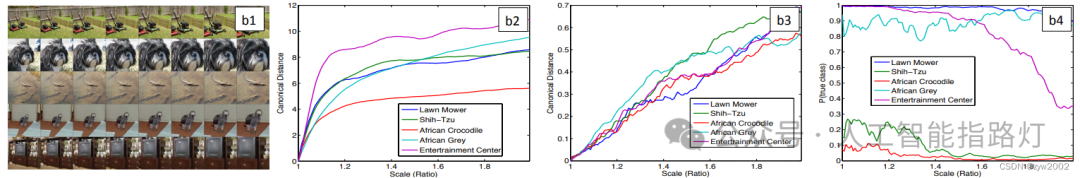
下图探究图片缩放对卷积模型影响的实验,实验方法和表述与上面探讨平移时的设置类似。结果表明,网络的浅层相较于网络的深层对缩放操作更敏感;且最终的识别准确率较平稳。这个趋势跟探究平移操作对卷积模型影响的趋势类似,即:卷积操作也具有良好的缩放不变性。
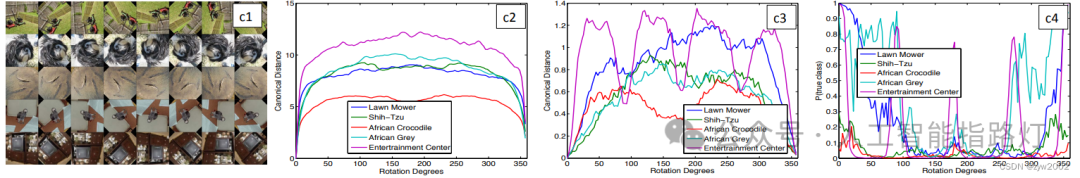
下图是探究图片旋转对卷积模型影响的实验,可以看出旋转操作对卷积的影响正好与平移和缩放相反:卷积第一层对旋转的敏感程度较低,第七层对旋转的敏感程度高。这是因为颜色,纹理这些低级特征旋转前后还是相似的特征;但是目标级别的高级语义特征却不行,例如“特征9”旋转180°后变成了“特征6”. 看最终的识别准确率曲线也能发现旋转0°和350°时模型的识别准确率最高,因为此时旋转后模型最接近原始图片。对于某些存在对称性质的特征,例如原图中的电视,在旋转90°,180°,270°时都有不错的识别准确率。因此,卷积操作不具有良好的旋转不变性。
总结:
卷积的平移不变性是从滑动遍历这个操作带来的,不管一个特征出现在图中的什么位置,卷积核都可以通过滑动的方式,滑动到特征上面做识别。
卷积的缩放不变性则是从网络的层级结构中获得,不同层的卷积操作拥有不同尺寸的计算感受野 。至于旋转不变性缺失找不到对应的操作。
那么,为什么现在的一些成熟项目,例如人脸识别,图像分类等依然可以对旋转的图片做识别呢? 这是因为我们用大量的训练数据,旋转不变性可以从大量的训练数据中得到。其实,不仅是旋转不变性,卷积本身计算方法带来的平移不变性和缩放不变性也是脆弱的,大部分也是从数据集中学习到的。深度学习是一种基于数据驱动的算法。
-
改变卷积核的大小
ZFNet通过对AelxNet可视化发现,由于第一层的卷积核尺寸过大导致某些特征图失效(失效指的是一些值太大或太小的情况,容易引起网络的数值不稳定性,进而导致梯度消失或爆炸。图中的体现是(a)中的黑白像素块)。
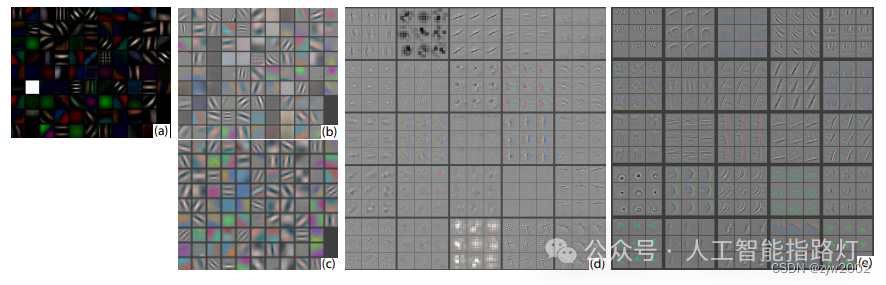
此外,由于第一层的步长过大,导致第二层卷积结果出现棋盘状的伪影(例如(d)中第二小图和倒数第三小图)。因此ZFNet做了对应的改进。即将第一层 11X11步长为4的卷积操作变成 7X7步长为2的卷积。
-
遮挡对卷积模型的影响
ZFNet通过对原始图像进行矩形遮挡来探究其影响,如下图所示:
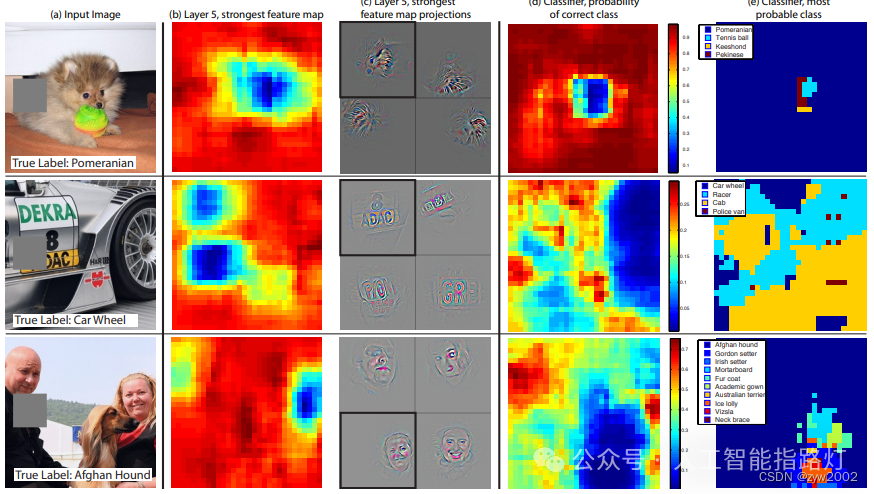
b表示计算遮挡后的图像经过第五个卷积层后得到的feature map 值的总和。红色代表更大的值。 由此可以看出来卷积计算后的特征图也是保留了原始数据中不同类别对象在图像中的空间信息。
c左上角的小图是经过第五个卷积后值最大的特征图的deconv可视化结果。由此实例2(可视化结果为英文字母或汉字,但原图的标签是“车轮”)可以看出卷积后值最大的特征图不一定是对分类最有作用的。c中的其他小图是统计数据集中其他图像可以使该卷积核输出最大特征图的deconv可视化结果。
d表示灰色滑块所遮挡的位置对图像正确分类的影响,红色代表分类成功的可能性大。例如博美犬的图像,当灰色滑块遮挡到博美犬的面部时,模型对博美犬的识别准确率大幅度下降。
e表示模型对遮挡后的图像的分类结果是什么。还拿博美犬的例子,灰色遮挡在图片中非狗脸的位置时,都不影响模型将其正确分类为博美犬(大部分都是蓝色标签,除了遮挡滑动到狗脸位置时)。
这个遮挡实验证明,深层的网络提取的是语义信息(例如狗的类属),而不是low-level的空间特征。因此对随机遮挡可以不敏感。
ZFNet的实现代码
import torch.nn as nnimport torch# 与AlexNet有两处不同: 1. 第一次的卷积核变小,步幅减小。 2. 第3,4,5层的卷积核数量增加了。class ZFNet(nn.Module):def __init__(self, num_classes=1000, init_weights=False):super(ZFNet, self).__init__()self.features = nn.Sequential(nn.Conv2d(3, 96, kernel_size=7, stride=2, padding=2), # input[3, 224, 224] output[96, 111, 111]nn.ReLU(inplace=True),nn.MaxPool2d(kernel_size=3, stride=2), # output[96, 55, 55]nn.Conv2d(96, 256, kernel_size=5, padding=2), # output[256, 55, 55]nn.ReLU(inplace=True),nn.MaxPool2d(kernel_size=3, stride=2), # output[256, 27, 27]nn.Conv2d(256, 512, kernel_size=3, padding=1), # output[512, 27, 27]nn.ReLU(inplace=True),nn.Conv2d(512, 1024, kernel_size=3, padding=1), # output[1024, 27, 27]nn.ReLU(inplace=True),nn.Conv2d(1024, 512, kernel_size=3, padding=1), # output[512, 27, 27]nn.ReLU(inplace=True),nn.MaxPool2d(kernel_size=3, stride=2), # output[512, 13, 13])self.classifier = nn.Sequential(nn.Dropout(p=0.5),nn.Linear(512 * 13 * 13, 4096),nn.ReLU(inplace=True),nn.Dropout(p=0.5),nn.Linear(4096, 4096),nn.ReLU(inplace=True),nn.Linear(4096, num_classes),)if init_weights:self._initialize_weights()def forward(self, x):x = self.features(x)x = torch.flatten(x, start_dim=1)x = self.classifier(x)return xdef _initialize_weights(self):for m in self.modules():if isinstance(m, nn.Conv2d):nn.init.kaiming_normal_(m.weight, mode='fan_out', nonlinearity='relu')if m.bias is not None:nn.init.constant_(m.bias, 0)elif isinstance(m, nn.Linear):nn.init.normal_(m.weight, 0, 0.01)nn.init.constant_(m.bias, 0)def zfnet(num_classes):model = ZFNet(num_classes=num_classes)return model
章中所有的数据和资料,可添加小助手无偿分享~
扫码添加小助手即可无偿获取~
也可以关注“AI技术星球”公众号,关注后回复“221C”获取。
 111


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


