利用深度图使用3d-3dICP估计位姿

《SLAM十四讲》3D-3D位姿估计 pose_estimation_3d3d.cpp(代码详解+原理) 3D-3D的位姿估计的求解需要两张RGB-D图像,经过特征匹配得到配对的特征点,再经过SVD方法求解出相机位姿(R和t)。 P和P’为两组匹配点,pi与p’i分别为两幅RGB-D图像的特征点。 还是先看代码: void pose_estimation_3d3d( const vector<Point3f>& pts1,//第一幅图像3D坐标点 const vector<Point3f>& pts2,//第二幅图像3D坐标点 Mat& 阅读详情

需要安装opencv3并且编译了features模块

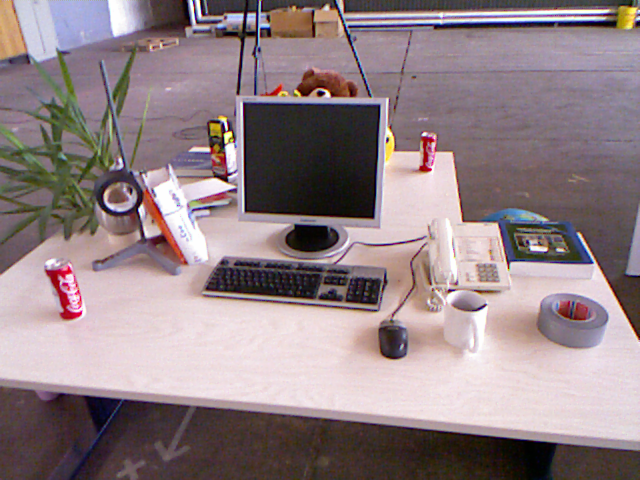
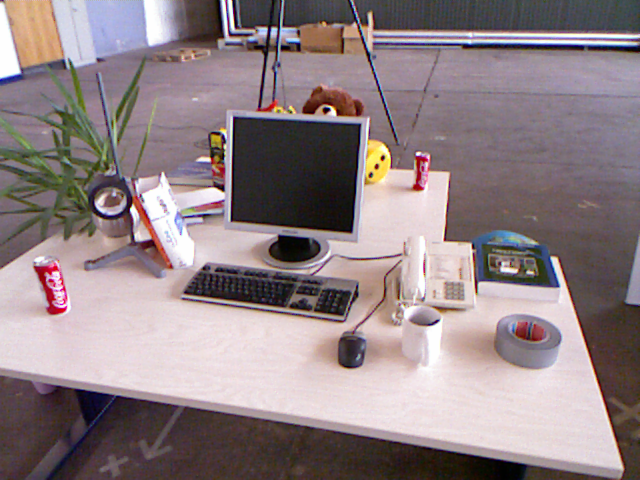
代码中的1.png

代码中的1_depth.png

代码中的2.png

代码中的2_depth.png

// 来自高翔SLAM十四讲
#include<iostream>
#include<opencv2/core/core.hpp>
#include<opencv2/features2d/features2d.hpp>
#include<opencv2/highgui/highgui.hpp>
#include<opencv2/calib3d/calib3d.hpp>
#include<Eigen/Core>
#include<Eigen/Geometry>
#include<Eigen/SVD>

#include<chrono>

using namespace std;
using namespace cv;


void find_feature_matches (
    const Mat& img_1, const Mat& img_2,
    std::vector<KeyPoint>& keypoints_1,
    std::vector<KeyPoint>& keypoints_2,
    std::vector< DMatch >& matches );

// 像素坐标转相机归一化坐标
Point2d pixel2cam ( const Point2d& p, const Mat& K );

void pose_estimation_3d3d (
    const vector<Point3f>& pts1,
    const vector<Point3f>& pts2,
    Mat& R, Mat& t
);

int main(){
    // 读取图像
    Mat img_1 = imread("1.png", CV_LOAD_IMAGE_COLOR);
    Mat img_2 = imread("2.png", CV_LOAD_IMAGE_COLOR);

    vector<KeyPoint>keypoints_1, keypoints_2;
    vector<DMatch> matches;
    find_feature_matches(img_1, img_2, keypoints_1, keypoints_2, matches);
    cout<<"一共找到了"<<matches.size() <<"组匹配点"<<endl;

    // 建立3D点
    Mat depth1 = imread("1_depth.png", CV_LOAD_IMAGE_COLOR);    // 16位无符号数
    Mat depth2 = imread("2_depth.png", CV_LOAD_IMAGE_COLOR);
    Mat K = (Mat_<double>(3,3) << 520.9, 0, 325.1, 0, 521.0, 249.7, 0, 0, 1);
    vector<Point3f> pts1, pts2;

    for(DMatch m:matches){
        ushort d1 = depth1.ptr<unsigned short>(int ( keypoints_1[m.queryIdx].pt.y))[int(keypoints_1[m.queryIdx].pt.x)];
        ushort d2 = depth2.ptr<unsigned short>(int(keypoints_2[m.trainIdx].pt.y))[int ( keypoints_2[m.trainIdx].pt.x)];
        if( d1 ==0 || d2 == 0) continue;    // bad depth
        Point2d p1 = pixel2cam( keypoints_1[m.queryIdx].pt, K);
        Point2d p2 = pixel2cam( keypoints_2[m.trainIdx].pt, K);
        float dd1 = float(d1)/5000.0;
        float dd2 = float(d2)/5000.0;
        pts1.push_back(Point3f(p1.x * dd1, p1.y * dd1, dd1));
        pts2.push_back(Point3f(p2.x * dd2, p2.y * dd2, dd2));
    }

    cout<<"3d-3d pairs : "<<pts1.size() <<endl;
    Mat R, t;
    pose_estimation_3d3d(pts1, pts2, R, t);
    cout<<"ICP via SVD results : "<<endl;
    cout<<"R = "<<R<<endl;
    cout<<"t = "<<t<<endl;
    cout<<"R_inv = "<<R.t() <<endl;
    cout<<"t_inv = "<<-R.t() * t <<endl;    // 这个是表示的什么

    // 下面是 bundle adjustment有问题就写了
    return 0;
}

// 找到匹配的特征点
void find_feature_matches ( const Mat& img_1, const Mat& img_2,
                            std::vector<KeyPoint>& keypoints_1,
                            std::vector<KeyPoint>& keypoints_2,
                            std::vector< DMatch >& matches )
{
    // 初始化
    Mat descriptors_1, descriptors_2;
    Ptr<FeatureDetector>  detector = ORB::create();
    Ptr<DescriptorExtractor> descriptor = ORB::create();
    Ptr<DescriptorMatcher> matcher  = DescriptorMatcher::create("BruteForce-Hamming");  // 暴力匹配

    // 第一步:检测 Oriented FAST 角点位置
    detector->detect(img_1, keypoints_1);
    detector->detect(img_2, keypoints_2);

    // 第二步:计算角点的BRIEF描述子
    descriptor->compute(img_1, keypoints_1, descriptors_1);
    descriptor->compute(img_2, keypoints_2, descriptors_2);

    // 第三步:匹配描述子
    vector<DMatch> match;
    matcher->match(descriptors_1, descriptors_2, match);

    // 第四步:筛选匹配点
    double min_dist = 10000, max_dist = 0;  // 表示最大距离和最小距离
    for(int i=0; i<descriptors_1.rows; i++){
        double dist = match[i].distance;
        min_dist = min_dist<dist?min_dist:dist;
        max_dist = max_dist>dist?max_dist:dist;
    }
    printf("Max dist : %f\n", max_dist);
    printf("Min dist : %f\n", min_dist);
    // 以两倍最小距离作为最小值
    for(int i=0; i<descriptors_1.rows; i++){
        if(match[i].distance <= max(2*min_dist, 30.0)){
            matches.push_back(match[i]);
        }
    }
}

Point2d pixel2cam(const Point2d& p, const Mat& K){
    return Point2d(
        (p.x - K.at<double>(0,2)) / K.at<double>(0,0),
        (p.y - K.at<double>(1,2)) / K.at<double>(1,1)
    );
}

// 位姿估计
void pose_estimation_3d3d(
    const vector<Point3f>& pts1,
    const vector<Point3f>& pts2,
    Mat& R, Mat& t
){
    Point3f p1, p2; // 全部匹配的点的中间值
    int N = pts1.size();
    for(int i=0; i<N; i++){
        p1 += pts1[i];
        p2 += pts2[i];
    }
    // 相对于中间点的位置
    p1 = Point3f(Vec3f(p1) / N);
    p2 = Point3f(Vec3f(p2) / N);
    vector<Point3f> q1(N), q2(N);  
    for( int i=0; i<N; i++){
        q1[i] = pts1[i] - p1;
        q2[i] = pts2[i] - p2;
    }

    // 计算 q1 * q2^T
    Eigen::Matrix3d W = Eigen::Matrix3d::Zero();
    for(int i=0; i<N; i++){
        W += Eigen::Vector3d(q1[i].x, q1[i].y, q1[i].z) * Eigen::Vector3d ( q2[i].x, q2[i].y, q2[i].z ).transpose();
    }
    cout<<"W = \n"<<W <<endl;

    // 对W进行SVD分解
    Eigen::JacobiSVD<Eigen::Matrix3d>svd(W, Eigen::ComputeFullU | Eigen::ComputeFullV);
    Eigen::Matrix3d U = svd.matrixU();
    Eigen::Matrix3d V = svd.matrixV();

    if(U.determinant() * V.determinant() < 0){
        for(int x=0; x<3; x++){
            U(x, 2) *= -1;
        }
    }
    cout<<"U = \n"<<U<<endl;
    cout<<"V = \n"<<V<<endl;

    Eigen::Matrix3d R_ = U*(V.transpose());
    Eigen::Vector3d t_ = Eigen::Vector3d(p1.x, p1.y, p1.z) - R_ * Eigen::Vector3d( p2.x, p2.y, p2.z );

    // 转换为 cv::Mat
    R = (Mat_<double>(3,3) << 
            R_(0,0), R_(0,1), R_(0,2),
            R_(1,0), R_(1,1), R_(1,2),
             R_(2,0), R_(2,1), R_(2,2)
        );
    t = (Mat_<double>(3, 1) << t_(0,0), t_(0,1), t_(0,2));
}


// 3d到3d的估计是对空间点运动的估计,并没有出现相机模型
// 也就是说,仅考虑3D点之间的变换时,与相机并没有关系

 

3D-3D:ICP 3D-3D:ICP1. ICP算法2.SVD方法 1. ICP算法 2D-2D问题是通过已知的2D图像坐标点对来求解图像间的变换关系(即 RRR 和 ttt)。3D-2D问题是通过已知的3D空间点坐标和对应的2D像素坐标来求解图像的位姿。 所以很显然,3D-3D问题是根据已知的3D空间点对来求解图像图像间的变换关系。 假设我们有一组配对好的 3D 点 现在想要找到一个欧式变换RRR,ttt,使得... 阅读详情

相关推荐

视觉slam初识

第2讲 初始SLAM 经典视觉SLAM框架: 视觉里程计:根据传感器采集到的数据信息(彩色信息和深度信息),估计相邻帧图像之间相机的运动,包括旋转矩阵和平移矩阵;相邻帧的运动串起来,就构成了轨迹;但会出现漂移问题,需要后端优化和回环检测; 后端优化:根据VO测量的相机位姿,以及回环检测的信息,优化得到全局一致的轨迹和地图; 回环检测:判断机器人是否回到之前到达过的位置; 建图:根据估...

a1059682127的博客 410

视觉SLAM十四讲笔记-7-5

视觉SLAM十四讲笔记-7-5 7.9 3D-3D:ICP 这节来介绍 3D-3D 的位姿估计问题。假设有一组配对好的 3D 点(例如,对两幅 RGB-D 图像进行了匹配): P={p1,p2,...,pn},P′={p1′,p2′,...,pn′} P = \{p_1,p_2,...,p_n\},P' = \{p_1',p_2',...,p_n'\} P={p1​,p2​,...,pn​},P′={p1′​,p2′​,...,pn′​} 现在,想要找一个欧氏变换 R,tR,tR,t,使得: ∀i,pi=R

qq_35588369的博客 768

基于深度图的位姿估计(2018至今)

基于深度图的位姿估计[2018至今]1. 简介2. A2J回归网络2.1 历史总结2.1.1 先进的非深度学习方案2.1.2 2D深度学习方案2.1.3 3D深度学习方案2.1.3.1 基于3D-CNN 1. 简介 2. A2J回归网络 论文:A2J: Anchor-to-Joint Regression Network for 3D Articulated Pose Estimation from a Single Depth Image (2019) 核心思想 本着整体学习以增强泛化能力的精神,通过

MyArrow的专栏 5306

【CV】相对位姿估计的进展和新方法

文稿整理者:小萝卜审稿&修改:赵季博士本文总结自12月4日赵季博士关于【相对位姿估计的进展和新方法】公开课。位姿估计是多视图几何的重要方向。赵博士在公开课第一部分首先概述了位姿估计...

fengdu78的博客 2207

对极几何,PNP,ICP求解位姿的方法原理、优缺点

特征点法位姿估计总结

zxnzjccmily的博客 7009

3D视觉入门必看:OpenCV+PnP算法实现物体位姿估计的5个常见坑点

本文详细解析了使用OpenCV+PnP算法实现物体位姿估计时的5个常见坑点,包括坐标系混乱、特征点质量、算法选择、退化配置和验证陷阱。特别针对位姿估计这一核心技术挑战,提供了实用的解决方案和优化建议,帮助开发者在工业自动化、机器人抓取等场景中提升精度和稳定性。

weixin_29054399的博客 159

ICP 求解相机思路

1.之前仍然是需要创建find_feature_matches,和pixel2cam,一个是用来匹配描述子的,一个是把像素坐标转成归一化平面坐标的。里面的变量都要带上&。2.因为是3d-3d.所以这里读取了两个深度图。depth1,depth2.跟之前一样。不同的是第二张图片的像素坐标也要转成空间点坐标。转成空间点坐标不需要旋转和平移。ushort d1=depth.ptr<unsi...

weixin_30587025的博客 351

50、基于3D模型深度特征对齐的相机位姿估计

本文介绍了一种基于深度学习的相机位姿估计与3D场景建模方法,通过深度特征对齐和MPP聚类技术,解决了传统方法在模板选择、视觉特征提取及参数估计方面的不足。该方法融合RGB视觉特征和深度信息,利用DPFC算法优化分类,实现了高精度的3D重建和相机位姿参数估计,适用于机器人、AR/VR、3D打印等多个领域。

snow3的博客 165

基于视觉的位姿求解总结

1. 位姿求取方法 1. 2D-2D:通过二维图像点的对应关系,恢复出在两帧之间摄像机的运动。 1. 方法 1. 对极约束,八点法求本质矩阵,分解得旋转矩阵和平移矩阵 1. 5个自由度,8对点来估计 1. SVD分解 2. 单应矩阵:描述两个平面之间的映射关系,若场景中的特征点都落在同一平面上(如墙、地面),可以通过单应性来进行运动估计。 1...

Bettyshasha的专栏 4094

用workbuddy自定义Skill:手把手搭建AI炒股分析助手

AI Agent正成为个人投资研究的重要工具,而Skill作为行为规范,能让AI输出保持稳定与专业。在AI Agent应用中,很多人分不清Skill与Agent的区别:Agent负责目标拆解与执行,Skill则固化分析流程与输出模板。借助本地工作台workbuddy,用户可自定义Skill,实现从市场环境检查到财务排雷的五段式分析。通过调低温度参数、设定数据验证规则,该方案能有效避免大模型凭空编造数据,帮助个人投资者快速完成基本面体检、资金面观察与风险清单生成。本文基于一套可直接套用的配置与一个月实测,展示

weixin_29038537的博客 519

C语言 在合并编译 ( 多.c文件 ) 情况下 实现 linked list ( 链表 ) 教程 . 更新ing

写在前面  依旧是参考借鉴了 浙江大学 温老师 的视频教程,很不错,在中国大学MOOC上,强力推荐!  虽说有借鉴,但是能保证的是每一行代码都是我自己经过理解后手敲出来的,所以才来做了这部分的教程。  最后,带 * 字符是我个人觉得可以添加的功能,按理来讲是可以不看的,而且大概率是可以有更好的改进的。  PS: 文章还在更新,如果文字蓝了(有超链接),说明写完了,如果没蓝,说明我在开军舰.jpg 源代码:  这里→源代码. 第一步:前置工作  先说一下每一篇都会出现 main 函数的,stage1 只是给没

weixin_47287635的博客 525

视觉SLAM第7讲:视觉里程计2(3D-2D:PnP、3D-3D:ICP)

本文主要介绍了视觉SLAM中PnP和ICP两种位姿估计算法。PnP通过3D-2D点对估计相机位姿,包括直接线性变换(DLT)、P3P等方法,并展示了如何用非线性优化和g2o进行求解。ICP则处理3D-3D点对匹配问题,推导了基于SVD的解析解,并实现了g2o优化版本。实验部分对比了OpenCV、手写高斯牛顿法和g2o在不同场景下的性能,验证了这些方法在RGB-D SLAM中的有效性。最后总结了特征点视觉里程计中的关键技术点,包括特征匹配、2D-2D运动估计和3D点重建等核心问题。

weixin_45728280的博客 1009

UE5游戏逆向实战:用FModel提取.pak文件中的3D模型(附Dumper-7避坑指南)

本文详细介绍了如何使用FModel工具从UE5游戏的.pak文件中提取3D模型,并提供了Dumper-7的避坑指南。内容涵盖FModel工具链配置、UE5特有的unversioned properties问题解决方案、Dumper-7实战流程以及模型后处理技巧,帮助开发者高效获取游戏资产。

weixin_30872499的博客 422

3D-3D:ICP_SVD

3D-3D:ICP_SVD引言1.ICP2.SVD3.非线性求解 引言 ch7. 利用一组匹配好的3D点(比如RGB-D图像),求解R,tR,tR,t,使用迭代最近点(Iterative Closest Point,ICP).和PnP求解类似,ICP的求解同样分为线性方法(SVD)和非线性方法(BA). 1.ICP 2.SVD 只要求出了两组点之间的旋转,平移量是非常容易得到的。所以重点是R...

fb_941219的博客 1277

Verilator+VSCode实战:5分钟搞定Verilog语法检查与波形调试

本文详细介绍了如何将Verilator仿真器与VSCode编辑器高效集成,打造极速的Verilog开发工作流。通过环境配置、实时语法检查、一键仿真与波形生成等实战技巧,帮助IC设计工程师在几分钟内完成从代码编写到波形调试的全过程,大幅提升中小规模模块的验证效率。

weixin_28454475的博客 469

electron windows设置镜像地址环境变量报错npm error `ELECTRON_MIRROR` is not a valid npm option

如果你是在使用某个特定的脚本或配置文件,请检查该文件中是否有不正确的配置项,并进行相应的修正。确保你遵循electron的官方安装指南,并且没有包含不必要的或错误的配置选项。如果问题依然存在,可以查看npm的官方文档或者相关社区获取更多帮助。

qq_36158551的博客 3323

【slam十四讲第二版】【课本例题代码向】【第七讲~视觉里程计Ⅱ】【使用LK光流(cv)】【高斯牛顿法实现单层光流和多层光流】【实现单层直接法和多层直接法】

【slam十四讲第二版】【课本例题代码向】【第七讲~视觉里程计Ⅱ】【使用LK光流(cv)】【高斯牛顿法实现单层光流和多层光流】【实现单层直接法和多层直接法】

qq_45954434的博客 5122

ESP32 双雷达融合盲区车辆接近预警系统设计与实现

/ 超声波传感器引脚// 触发引脚// 回声引脚// 预警模块引脚// 蜂鸣器引脚// LED引脚// 串口配置(毫米波雷达用UART2)#define BAUD_RATE 115200 // 雷达串口波特率(IWR6843默认配置)// 预警阈值(可根据实际需求调整)// 高危区阈值(3m)// 预警区阈值(10m)// 传感器数据存储// 毫米波雷达距离(m)// 毫米波雷达速度(km/h)// 超声波距离(m)// 融合后距离(m)

weixin_42300449的博客 745

深入理解SLAM中的3D-3D位姿估计:基于SVD与图优化的实现

本文主要探讨计算机视觉与SLAM领域中一个核心问题:如何从两组3D点对应关系中估计相机运动(即旋转矩阵R和平移向量t)。我们将基于gaoxiang12/slambook项目中的pose_estimation_3d3d.cpp实现,详细解析3D-3D位姿估计的两种主要方法:SVD分解法和图优化法。 ## 3D-3D位姿估计问题定义 给定两组3D点集pts1和pts2,其中pts1中的每个点与pt...

gitblog_00330的博客 627

CAM350常用快捷键

CAM350快捷键 CAM350常用快捷键

bhxc809751502的博客 3056

高并发网络爬虫实践(欧赔、亚盘、大小指数数据爬取)

本文通过对一个实战化的高并发网络爬虫脚本进行深度模块化剖析,展示了如何构建一个兼具性能、健壮性和易用性的数据采集工具。核心设计思想总结模块化与单一职责: 每个函数都专注于解决一个特定问题,无论是网络请求、数据解析还是文件操作。并发与效率: 通过ThreadPoolExecutor实现了高效的并发抓取,极大缩短了总耗时。健壮性与容错: 强大的重试机制、细致的异常处理和线程安全的文件写入,保证了程序在复杂网络环境下的稳定运行。断点续传: 精心设计了进度记录与恢复机制,使得大规模抓取任务变得轻松可控。

猫敷雪 480

3D姿态估计——ThreeDPose项目简单易用的模型解析

前言 之前写过tensorflow官方的posenet模型解析,用起来比较简单,但是缺点是只有2D关键点,本着易用性的原则,当然要再来个简单易用的3D姿态估计。偶然看见了ThreeDPose的项目,感觉很强大的,所以把模型扒下来记录一下调用方法。 参考博客: ThreeDPose官方代码 微软的ONNX模型解析库 ONNX解析库的pythonAPI文档 3D姿态估计最大的好处就是卡通角色的肢体驱动了,其实就是单目摄像头的动捕方法。 理论和代码解析 可以从官方去下载模型,戳这里,或者在文末的百度网盘下载。

风翼冰舟的博客 1万+

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

姿态估计之3D 人体姿态估计 - 总结(1)【转】

参考 1、3D 人体姿态估计简述 - 知乎 2、3D人体姿态估计(介绍及论文归纳) 0 前言 3D Human Pose Estimation(以下简称 3D HPE )的目标是在三维空间中估计人体关键点的位置。3D HPE 的应用非常广泛,包括人机交互、运动分析、康复训练等,它也可以为其他计算机视觉任务(例如行为识别)提供 skeleton 等方面的信息。关于人体的表示一般有两种方式:第一种以骨架的形式表示人体姿态,由一系列的人体关键点和关键点之间的连线构成;另一种是参数化的人体模型(如 SMPL

light169的专栏 8967

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

2D/3D姿态估计整理

主要参考: https://www.jianshu.com/p/39fe654ed410 https://blog.youkuaiyun.com/sinat_26917383/article/details/79704097 2个思路: 1)Top-Down(自上而下)方法:将人体检测和关键点检测分离,在图像上首先进行人体检测,找到所有的人体框,对每个人体框图再使用关键点检测,这类方法往往比较慢,但姿态估计准...

qq_38109843的博客 2894

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

3D人体姿态估计(介绍及论文归纳)

3D人体姿态估计(介绍及论文归纳) 基本概念姿态估计难点人体结构化特性2D 姿态估计任务挑战 3D 姿态估计问题挑战应用方法 数据集类型可用信息姿态数据集PoseTrackCrowdPoseHuman3.6MDensePoseCOCOMPIIFLICLSP RGB数据集Leeds Sports Pose (LSP) DatasetFLIC DatasetMPII Human Pose DatasetMS COCO Keypoint LeaderboardAI ChallengePoseTr.

weixin_43955293的博客 3520

基于深度学习的深度图与位姿估计

深度学习目前已经进入快速发展的时期。在深度学习之前,计算机视觉领域都是采用手工的方式提取图像特征,这些特征都比较明显。深度学习主要代表就是神经网络,尤其是卷积神经网络在数字图像处理中表现出了优越的性能。这主要是因为神经网络可以提取图像中的深层次特征,通过神经网络端到端的学习可以使神经网络自动去学习计算机需要关注的特征。 基于深度学习的深度估计以及相机自我运动估计,是使用卷积神经网络进行端到端的学习。深度估计与相机自我运动估计通常分为两个不同的网络进行端到端的学习。其中深度估计的网络采用典型的编解码结构,网

TFZ941214的博客 5281
上一篇: 利用深度图实现3D-2D的PNP相机位姿估计
下一篇: tensorflow数据加载器
rdc01234
博客等级 码龄9年 10粉丝 156原创
评论 9
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值