一行代码训练成本再降30%,AI大模型混合精度训练再升级|开源

DeepSeek-R1:开源大模型的技术革命与行业影响分析 DeepSeek-R1的诞生不仅是一次技术突破,更是AI发展范式的革新。它证明通过算法创新与工程优化,可以在不依赖海量计算资源的条件下实现顶尖性能。这种"高效智能"的发展路径,为全球AI产业提供了重要的中国方案。随着开源生态的持续演进,我们有理由期待这场由DeepSeek引发的技术革命,将加速人工智能普惠时代的到来。 阅读详情

FP8通过其独特的数值表示方式,能够在保持一定精度的同时,在大模型训练中提高训练速度、节省内存占用,最终降低训练成本。

AI大模型开发系统Colossal-AI的混合精度训练再度升级,支持主流的BF16(O2) + FP8(O1)的新一代混合精度训练方案。

仅需一行代码,即可对主流LLM模型能够获得平均30%的加速效果,降低相应大模型开发成本,并保证训练收敛性。

无需引入额外的手写CUDA算子,避免了较长的AOT编译时间和复杂的编译环境配置。

开源地址:https://github.com/hpcaitech/ColossalAI

FP8混合精度训练

低精度计算一直是GPU硬件发展趋势。

从最早的FP32,到目前通用的FP16/BF16,再到Hopper系列芯片(H100, H200, H800等)支持的FP8,低精度计算速度越来越快,所需的内存也越来越低,非常符合大模型时代对硬件的需求。

目前FP8混合精度训练影响训练结果的最大因素就是scaling方案,常见的方案有两种:

  • 延迟scaling

  • 实时scaling

延迟scaling采用之前一段时间窗口内的scaling值来估计当前scaling,同时将scaling的更新和矩阵乘法(gemm)融合起来。这种计算方法效率较高,但由于是估算的scaling,所以对收敛性影响较大。

实时scaling直接采用当前的张量值来计算scaling,所以计算效率较低,但是对收敛性影响较小。根据英伟达的报告,这两种scaling方案的计算效率差距在10%以内。

Colossal-AI采用了对训练收敛性影响较小的实时scaling方案,同时实现有着不输其他延迟scaling实现的性能。

在单卡H100上对矩阵乘法进行的测试,可以看到矩阵的维度越大,FP8的加速效果越明显,而且Colossal-AI的实现与Transformer Engine的性能几乎一致,如图1所示。但Transformer Engine需要复杂的AOT编译环境配置和较长的编译时间。

△图1. 单卡GEMM性能测试

为了实验结果更贴近现实,Colossal-AI直接在主流LLM上进行了实际训练的测试。

首先在H100单卡上进行了测试,以下测试中Transformer Engine (TE)采用的其默认的延迟scaling方案。
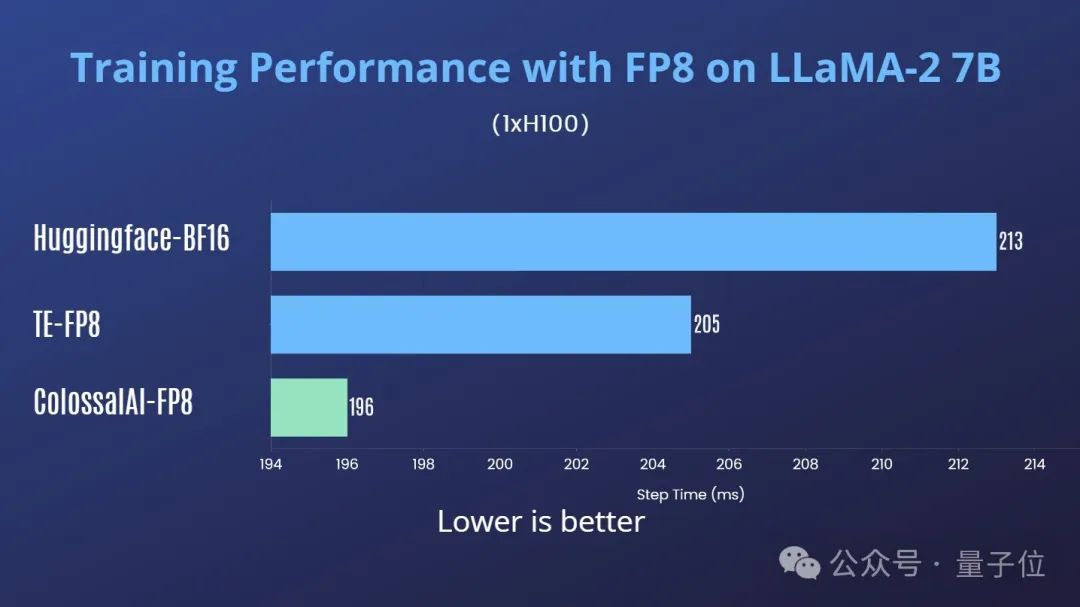

同时进行了收敛性测试,可以看到FP8混合精度训练的loss曲线与bf16的基本一致,如图4所示:
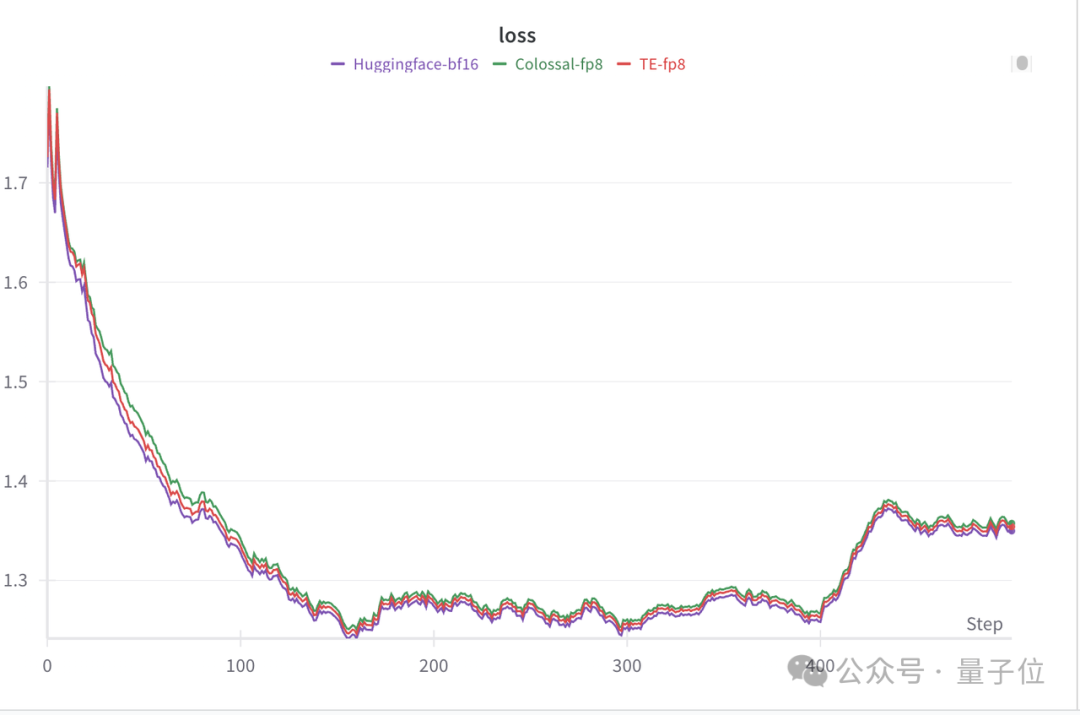

△图4. H100单卡 LLaMA2-7B 混合精度训练loss曲线

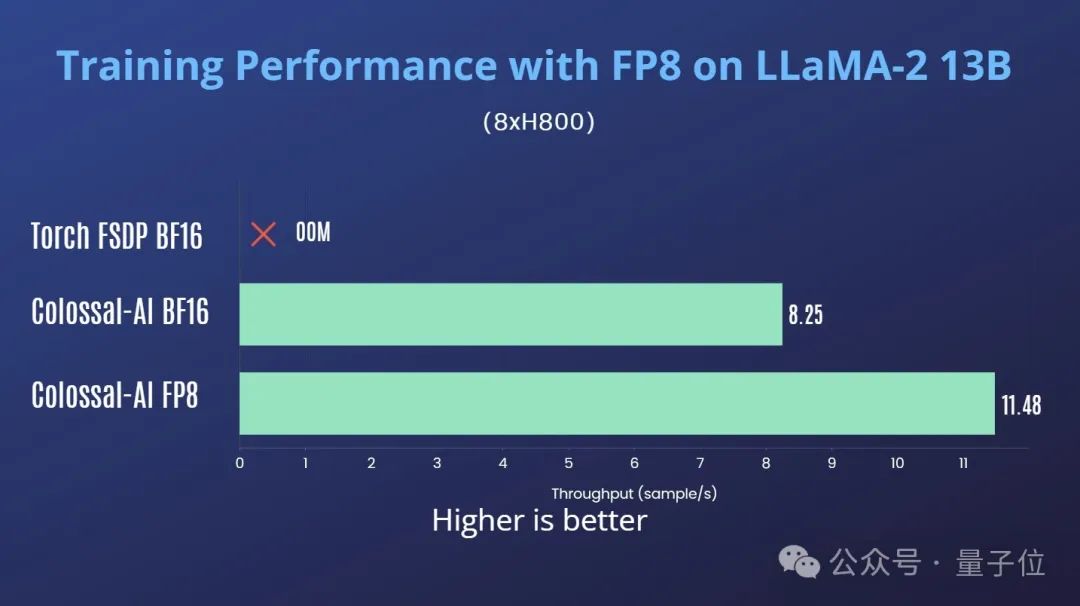
Colossal-AI还测试了H800多卡并行训练场景下的性能。在单机8卡H800上训练LLaMA2-7B,Colossal-AI FP8对比Colossal-AI BF16有35%的吞吐提升,对比Torch FSDP BF16有94%的吞吐提升。

在单机8卡H800上训练LLaMA2-13B,Colossal-AI FP8对比Colossal-AI BF16有39%的吞吐提升。
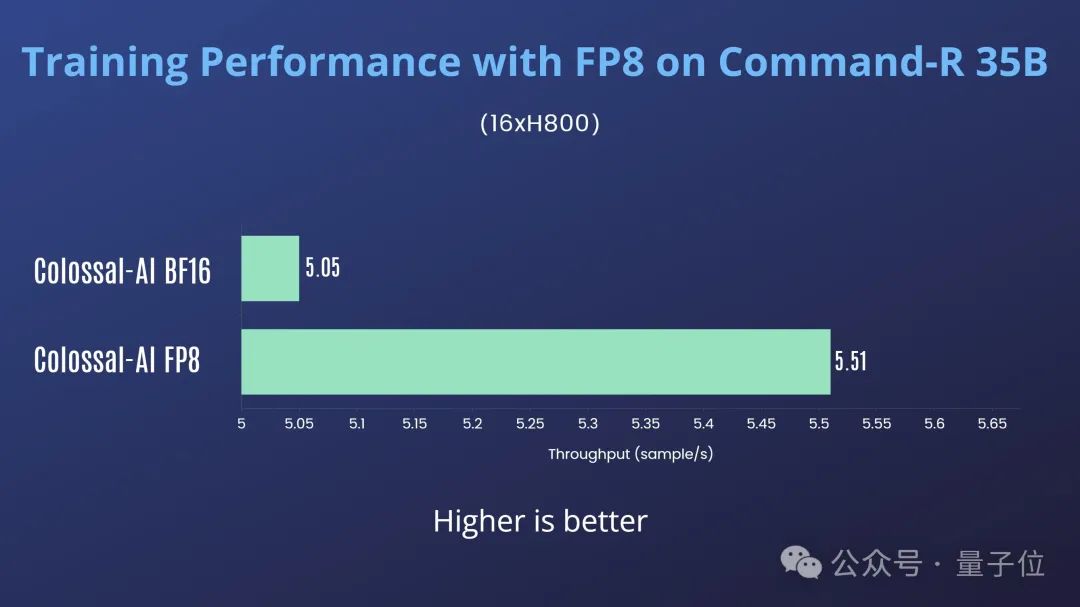
在2机16卡H800上训练Cohere Command-R 35B,Colossal-AI FP8对比Colossal-AI BF16有10%的吞吐提升,如图7所示:
根据英伟达的报告和测试经验,对FP8混合精度训练性能调优有一些初步的认识:

  • 尽量少使用张量并行,用流水线并行代替张量并行

  • 模型hidden size越大,加速效果越明显

  • 矩阵乘法占比高的模型加速效果大

由于上述实验中Command-R 35B采用了张量并行,所以加速效果不太明显。

Colossal-AI对FP8的支持较为广泛,各种并行方式都能和FP8混合精度训练兼容。使用时,仅需在初始化plugin时开启FP8即可:

from colossalai.booster.plugin import GeminiPlugin, HybridParallelPlugin, LowLevelZeroPlugin``...``plugin = LowLevelZeroPlugin(..., use_fp8=True)``plugin = GeminiPlugin(..., use_fp8=True)``plugin = HybridParallelPlugin(..., use_fp8=True)

除此之外,无需多余的代码和AOT编译。

开源地址:https://github.com/hpcaitech/ColossalAI

2024最新全套大模型学习资料:大模型学习成长路线、书籍&学习文档、视频教程、项目实战、面试题汇总等,免费分享~

有需要的同学可以通过【微信扫描下方二维码】,即可免费领取!!!
一、大模型学习成长路线

学习新技能,方向至关重要。 正确的学习路线图可以为你节省时间,少走弯路;方向不对,努力白费。

这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。可以说是最科学最系统的学习成长路线。

二、大模型书籍&学习文档

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

在这里插入图片描述

在这里插入图片描述

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

在这里插入图片描述

四、大模型实战项目

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

在这里插入图片描述

五、大模型面试题汇总

面试,不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

在这里插入图片描述

上述的资料已经全部打包好,有需要这份全套的大模型学习资料的同学,可以通过【微信扫描下方二维码】,免费领取!!!

机会总是留给有准备的人。 如果你需要学习大模型,那么请不要犹豫,立刻行动起来!早掌握,早享受。

(42页PPT)电子AI+系列专题DeepSeek重塑开源大模型生态,AI应用爆发持续推升算力需求(附下载方式) DeepSeek的快速发展印证了开源模式在大模型领域的生命力,其技术创新不仅降低了AI应用门槛,更推动了整个算力产业链的升级。随着AI向多模态、专业化方向发展,智能算力基础设施的建设将成为各国科技竞争的关键领域。在人工智能技术飞速发展的当下,开源大模型正成为推动行业进步的重要力量。本文将对DeepSeek这一现象级开源大模型及其对算力需求的影响进行深入解读,从技术突破、生态布局到产业影响,全面剖析这一专题的核心内容。篇幅所限,本文只提供部分资料内容,完整资料请看下面链接。详细资料请看本解读文章的最后内容。 阅读详情

相关推荐

国产AI芯片大模型训练实战:降本增效与软硬协同全解析

大模型训练正从依赖高端GPU转向国产AI芯片自主可控路径。其核心原理在于突破CUDA生态束缚,通过MLIR编译器重构、INT16混合精度优化、KV Cache动态分片及定制化通信库(如C3L)实现算力真实吞吐提升。技术价值体现在显著降低千卡时成本(¥/kWh)、提升tokens/sec/W能效比,并满足金融等高合规场景对ECC、长时稳定性和中文长文本处理的严苛要求。典型应用场景包括3B级LLM日均高频训练、领域微调(如金融术语理解)、万字文档推理等。本文聚焦寒武纪思元590与壁仞BR100双平台实测经验,覆

alince20008的博客 504

一行代码,AI大模型训练成本再降30%,混合精度训练再升级

FP8通过其独特的数值表示方式,能够在保持一定精度的同时,在大模型训练中提高训练速度、节省内存占用,最终降低训练成本。AI大模型开发系统Colossal-AI的混合精度训练再度升级,支持主流的BF16(O2) + FP8(O1)的新一代混合精度训练方案。,降低相应大模型开发成本,并保证训练收敛性。无需引入额外的手写CUDA算子,避免了较长的AOT编译时间和复杂的编译环境配置。

python12345678_的博客 753

AI自动生成端侧1B大模型训练框架实战

端侧大模型训练面临硬件适配难、内存受限、功耗敏感等核心挑战,其本质是跨层技术(CUDA内存管理、混合精度调度、NPU算子兼容性)的约束满足问题。现代方案不再依赖人工魔改HuggingFace Trainer或PyTorch DDP,而是将设备指纹(如Adreno 750)、模型拓扑(Llama-1B)、训练目标(FP16+INT4、梯度检查点)转化为结构化约束,驱动AI完成从训练脚本生成、动态Dataloader构建到NPU编译部署的全栈闭环。该范式显著降低嵌入式AI工程师的框架开发门槛,并保障代码在骁龙8

weixin_33924770的博客 402

一文了解人工智能AI、大模型、AI大模型、ChatGPT、GPT-4、OpenAI、Claude 3...

这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。AI大模型是“人工智能预训练大模型”的简称。更新的数据集:GPT-4 的训练数据集不仅更大,而且包含了更广泛的主题和领域,从而使模型具有更全面的知识。更大的模型容量:GPT-4 采用了更多的神经网络层和参数,使其能够学习更复杂的文本模式和结构。

python12222_的博客 2106

免费开源项目一行代码训练成本再降30%,AI大模型混合精度训练再升级,安装部署步骤,支持docker一键运行!AI从任何地方使用语音命令控制您的电脑和智能家居!

免费开源项目一行代码训练成本再降30%,AI大模型混合精度训练再升级,安装部署步骤,支持docker一键运行!AI从任何地方使用语音命令控制您的电脑和智能家居!

代码讲故事 715

Halcon和C#联合编程实现硬币识别(个人入门练习)

本人为机器视觉入门小白,自己突发奇想 1.图片数据来源和分析 2.HALCON实现 3.C#搭建界面框架 4.C#中嵌入HALCON代码,即联合编程 5.导出.exe文件,运行以及Debug 目标是这样的,在图片中识别出每种类型的硬币数量,然后计算出总钱数。先上结果,再细说过程。 C#界面和识别结果: 1.图片数据来源和分析 图片大小及格式均统一,拍摄的时候已经尽可能的去除了背景噪点,所以图像处理的要求并不很高(重点在于思路)。硬币区分原理本人代码采用直径范围来判断(也可以半径或区域面积,HALCON算子

Demobird的博客 3616

5分钟看懂Deepseek开源周之三:开源核弹!DeepGEMM凭FP8+MoE双杀:1350 TFLOPS碾压cuBLAS,大模型训练成本暴降50%

深度求索开源周第三天:DeepGEMM代表了大模型底层计算从“依赖硬件厂商优化”向“开源算法驱动”的范式转移,其技术方向将显著降低大模型训练门槛、加速稀疏架构创新,并推动行业形成更开放的软硬件协同生态。短期看,它可能成为MoE模型训练的事实标准;长期而言,其设计理念或影响下一代AI芯片的指令集架构设计。

a1966565的博客 1894

从农田到城市:如何利用NDVI和缨帽变换提升遥感图像分类精度?

本文深入探讨了如何利用NDVI(归一化差值植被指数)和缨帽变换(Tasseled Cap Transformation)两大关键技术,有效提升从农田到城市等复杂场景的遥感图像分类精度。文章通过剖析地物光谱特征,对比了原始波段与衍生特征的优劣,并提供了在ENVI、ArcGIS及Python环境中的具体操作指南与实战策略,旨在帮助从业者构建更鲁棒的特征工程流程,从而解决地物混淆、边界模糊等常见分类难题。

redis7keeper的博客 867

一文解析 DeepSeek 大模型高效训练背后的极限 AI 工程优化

国产之光 Deepseek 大模型成功出圈,在效果比肩非开源模型ChatGPT的同时,其运行成本很低。那么 Deepseek 是如何实现这么高效的训练呢?文本将简要介绍 Deepseek 母公司幻方开源的 HAI-platform 大模型训练工具,来一窥极限 AI 工程的秘密。为了更好地发挥 GPU 集群的计算能力,训练具有惊人功能的、强大的万亿参数模型,一个高效简洁的大模型训练工具十分必要。

m0_59164520的博客 2177

单细胞测序数据分析——细胞通讯 CellChat

cellchat

G2530051386的博客 1万+

从零开始:kohya_ss环境部署与LoRA/SDXL模型训练实战指南

本文提供了一份详细的kohya_ss环境部署与模型训练实战指南。从零开始,手把手教你使用Conda创建虚拟环境、安装依赖并启动Web GUI界面。核心内容涵盖高质量数据集的准备方法,并重点解析了如何使用kohya_ss工具进行LoRA模型和SDXL模型的微调训练,包括关键参数配置与常见报错解决方案,帮助初学者快速上手AI绘画模型定制。

weixin_29162439的博客 536

Llama-Factory是否支持混合精度训练?BF16/FP16全部兼容

Llama-Factory全面支持BF16和FP16混合精度训练,结合LoRA/QLoRA可显著降低显存消耗并提升训练效率。通过Hugging Face Accelerate实现自动精度管理,兼容主流硬件,支持WebUI一键配置,大幅降低大模型微调门槛。

weixin_30789053的博客 614

Python模拟发送SOME/IP消息(Scapy模块)

SOMEIP提供服务、订阅、响应、通知等Python代码示例

liluo0815481的博客 3068

详解混合精度训练的梯度稳定性:从损失缩放原理到PyTorch/TensorFlow实战

通过结合理论分析与实践代码,开发者可在训练吞吐量提升2-3倍的同时保持模型精度,该技术已广泛应用于计算机视觉、自然语言处理等领域的大模型训练场景。

燃灯工作室 1310

信贷系统学习总结(6)—— 贷前、贷中、贷后全流程核心模型解析

本文系统解析了金融风控模型的技术演进与应用实践。从贷前、贷中到贷后全流程,详细介绍了A卡、B卡、C卡三类核心评分模型,以及反欺诈、动态监控、催收优化等关键技术的实现路径。重点阐述了特征工程设计、模型验证指标、联邦学习等创新应用,并提供了多个实战案例数据。同时提出了算法选择的"黄金三角"原则和分阶段技术演进路线,强调数据治理、模型全生命周期管理和复合型团队建设的重要性。文章指出未来风控将向决策智能化、数据无感化和风险预知化方向发展,需要平衡技术创新与合规要求。

科技D人生 1220

《大数据之路:阿里巴巴大数据实践》-第1篇 数据技术篇 -第3章数据同步

我们将数据釆集分为日志采集和数据库数据同步两 部分。数据同步技术更通用的含义是不同系统间的数据流转,有多种不 同的应用场景。主数据库与备份数据库之间的数据备份,以及主系统与 子系统之间的数据更新,属于同类型不同集群数据库之间的数据同步。 另外,还有不同地域、不同数据库类型之间的数据传输交换,比如分布 式业务系统与数据仓库系统之间的数据同步。对于大数据系统来说,包 含数据从业务系统同步进入数据仓库和数据从数据仓库同步进入数据 服务或数据应用两个方面。本章侧重讲解数据从业务系统同步进入数据 仓库这个环节,但其适

m0_54252387的博客 961

中国MoE一夜爆火!大模型新王暴打GPT-4o,训练成本仅600万美元

比如,Llama 3 405B消耗了3080万GPU小时,而看起来更强大的DeepSeek-V3却只用了280万GPU小时(计算量减少了约11倍)。不是的,但这表明,你必须确保不浪费已有的资源,这个案例很好地证明了在数据和算法方面还有很大的优化空间」。到目前为止,模型在实际应用中的表现相当出色——不仅在LLM竞技场名列前茅,而且从Karpathy本人的快速测试来看,结果也都很不错。正如开头所述,DeepSeek-V3是一个强大的混合专家模型(MoE),总参数量为为671B,每个token激活37B参数。

具身机器人和通用AI 865

eNSP常见故障处理

eNSP无法启动设备一直停在#井号的问题的解决方案?

lvshiliang123的博客 2万+

DeepSeek:低成本高性能的国产大模型突围之路

DeepSeek 的崛起不仅是技术突破的胜利,更是中国 AI 产业从 "跟随者" 到 "引领者" 的缩影。通过架构创新、场景深耕和生态构建,DeepSeek 正在重新定义大模型的价值标准。在可预见的未来,我们或将见证一个以中国技术为核心的全球 AI 新生态。

weixin_47231119的博客 1042

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

文心开源:文心大模型4.5系列全面开放,AI普惠时代加速到来

百度开源文心大模型4.5系列,包含10款模型(4240亿参数MoE多模态模型至3亿参数轻量模型)及完整工具链,遵循Apache 2.0协议允许商用。开源首日下载超50万次,推动AI普惠化,降低企业应用门槛。此举标志中国AI从参数竞赛转向生态共建,加速产业智能化进程。

星河灿烂的博客 1818

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

大模型训练效率提升至2.6倍,腾讯Angel机器学习框架升级

在算力紧缺的背景下,如何提升大模型训练和推理的效率,并降低成本,成为业界关注的焦点。

GZZN2019的博客 589

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

GPU算力短缺下的AI训练成本优化实战方案

在AI模型训练领域,GPU算力资源的高效利用始终是核心挑战。随着大模型训练需求激增和芯片供应紧张,算力成本优化技术变得尤为关键。从技术原理看,混合精度训练通过FP16/FP32混合计算减少显存占用,模型压缩则利用量化和剪枝降低计算复杂度。这些技术能显著提升硬件资源利用率,特别适合应对当前GPU价格波动带来的预算压力。实际工程中,结合云平台竞价实例和消费级显卡集群等方案,可构建高性价比的训练环境。例如AWS Spot实例配合检查点机制能降低60%成本,而RTX 4090集群通过梯度累积技术可实现80%的成本节

weixin_28465009的博客 294

《国内可训练的主流大模型及相关平台》

国内可训练的主流大模型及相关平台,涵盖开源模型、企业级解决方案和低代码开发工具,支持从学术研究到产业落地的全流程需求

zheng_ruiguo的专栏 2326

阿里云Qwen3重大版本革新:分离式训练技术引领开源大模型性能突破

2025年7月21日,阿里云通义千问团队在AI领域投下重磅炸弹——正式发布Qwen3系列的里程碑版本Qwen3-235B-A22B-Instruct-2507-FP8。这款经过全面升级的旗舰模型不仅在核心性能指标上超越了Kimi-K2、DeepSeek-V3等当前开源领域的标杆产品,更在部分关键能力上实现了对Claude-Opus4-Non-thinking等闭源系统的超越,标志着国内大模型技术正

gitblog_00940的博客 725
上一篇: 零基础学AI大模型要多久?真的能学会吗?
下一篇: AI产品经理从入门到精通(知识体系非常详细)看这一篇就够了!!!
大模型-小原
博客等级 码龄4年 2689粉丝 212原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值