一行代码,AI大模型训练成本再降30%,混合精度训练再升级

【深度学习基础知识 - 21】加快模型训练速度的方法 在深度学习任务中,虽然可以通过堆叠参数、设计更复杂的结构来提高模型的表征能力,但这也会导致模型的计算量增加,训练时间延长,大大降低模型的产出效率。这篇文章根据博主的经验简单介绍一些加快模型训练速度的方法,以及为什么需要关注模型的训练速度。 加快网络训练速度的方法 1. 合理的超参数设计 BatchSize。每次迭代batch的大小是影响每次推理速度的主要因素,而batchsize并非越大越好,一个经验性的可选数值是32、64、128,一般来说,每个batch的大小一旦超过64,继续增大batch带来的性能 阅读详情

FP8通过其独特的数值表示方式,能够在保持一定精度的同时,在大模型训练中提高训练速度、节省内存占用,最终降低训练成本。

AI大模型开发系统Colossal-AI的混合精度训练再度升级,支持主流的BF16(O2) + FP8(O1)的新一代混合精度训练方案。仅需一行代码,即可对主流LLM****模型能够获得平均30%的加速效果,降低相应大模型开发成本,并保证训练收敛性。无需引入额外的手写CUDA算子,避免了较长的AOT编译时间和复杂的编译环境配置。

开源地址:

https://github.com/hpcaitech/ColossalAI

FP8混合精度训练

低精度计算一直是GPU硬件发展趋势,从最早的FP32,到目前通用的FP16/BF16,再到Hopper系列芯片(H100, H200, H800等)支持的FP8,低精度计算速度越来越快,所需的内存也越来越低,非常符合大模型时代对硬件的需求。

目前FP8混合精度训练影响训练结果的最大因素就是scaling方案,常见的方案有两种:

  • 延迟scaling

  • 实时scaling

延迟scaling采用之前一段时间窗口内的scaling值来估计当前scaling,同时将scaling的更新和矩阵乘法(gemm)融合起来。这种计算方法效率较高,但由于是估算的scaling,所以对收敛性影响较大。

实时scaling直接采用当前的张量值来计算scaling,所以计算效率较低,但是对收敛性影响较小。根据英伟达的报告,这两种scaling方案的计算效率差距在10%以内。

Colossal-AI采用了对训练收敛性影响较小的实时scaling方案,同时实现有着不输其他延迟scaling实现的性能。

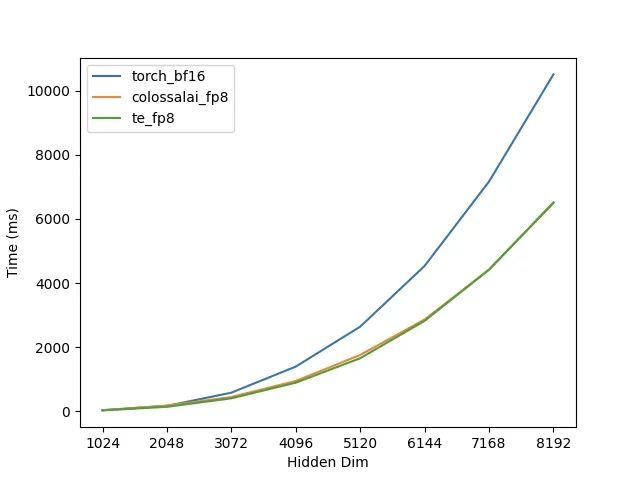
在单卡H100上对矩阵乘法进行的测试,可以看到矩阵的维度越大,FP8的加速效果越明显,而且Colossal-AI的实现与Transformer Engine的性能几乎一致,如图1所示。但Transformer Engine需要复杂的AOT编译环境配置和较长的编译时间。
img

图1. 单卡GEMM性能测试

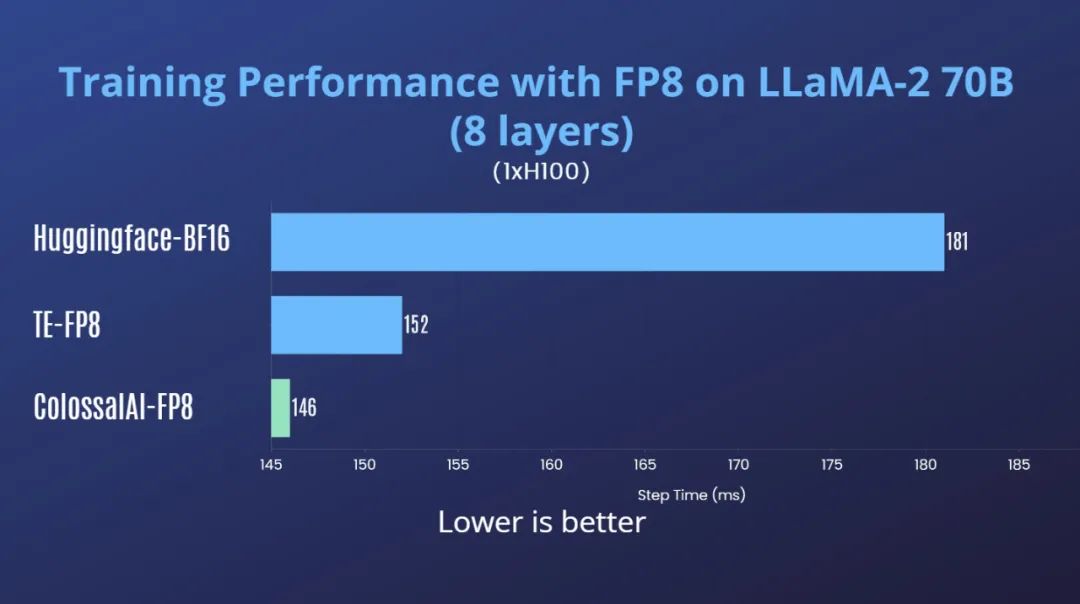
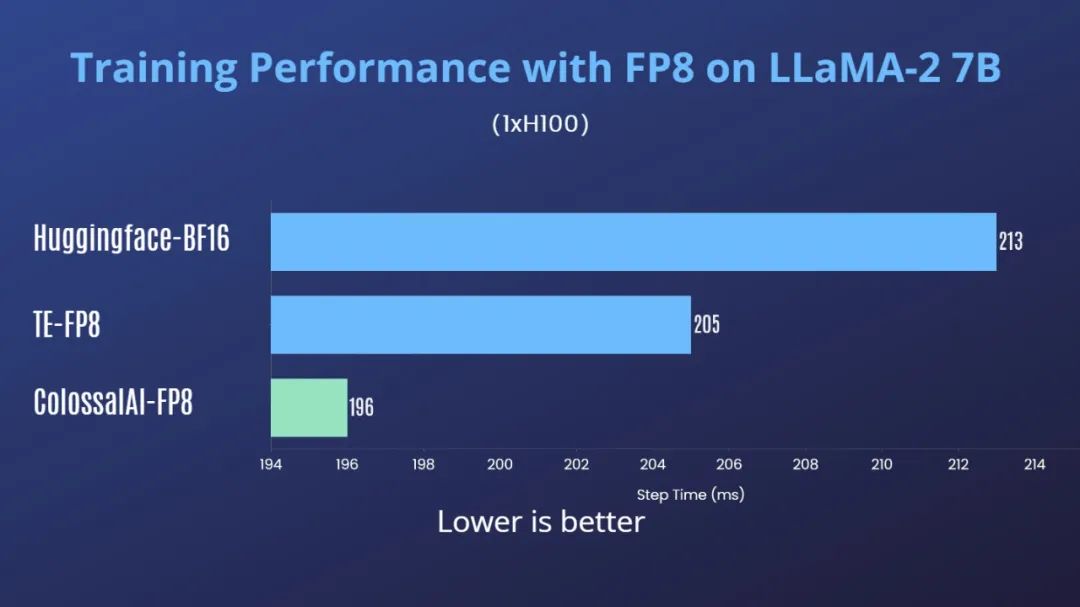
为了实验结果更贴近现实,Colossal-AI直接在主流LLM上进行了实际训练的测试。

首先在H100单卡上进行了测试,以下测试中Transformer Engine (TE)采用的其默认的延迟scaling方案。
img

img

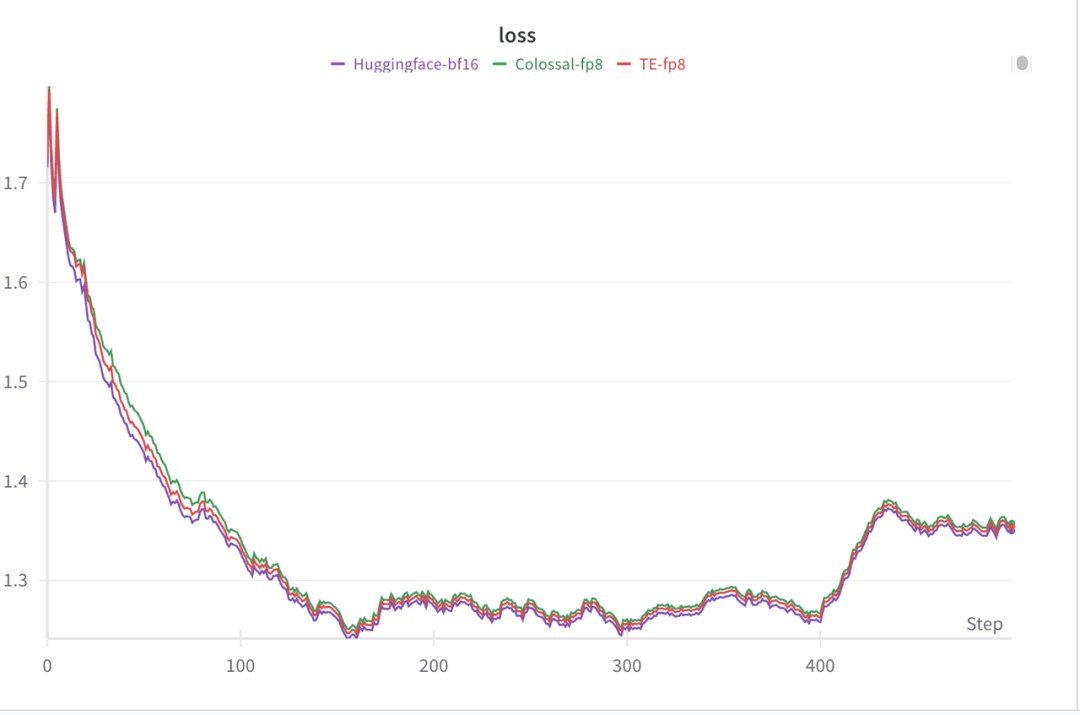
同时进行了收敛性测试,可以看到FP8混合精度训练的loss曲线与bf16的基本一致,如图4所示:
img

图4. H100单卡 LLaMA2-7B 混合精度训练loss曲线

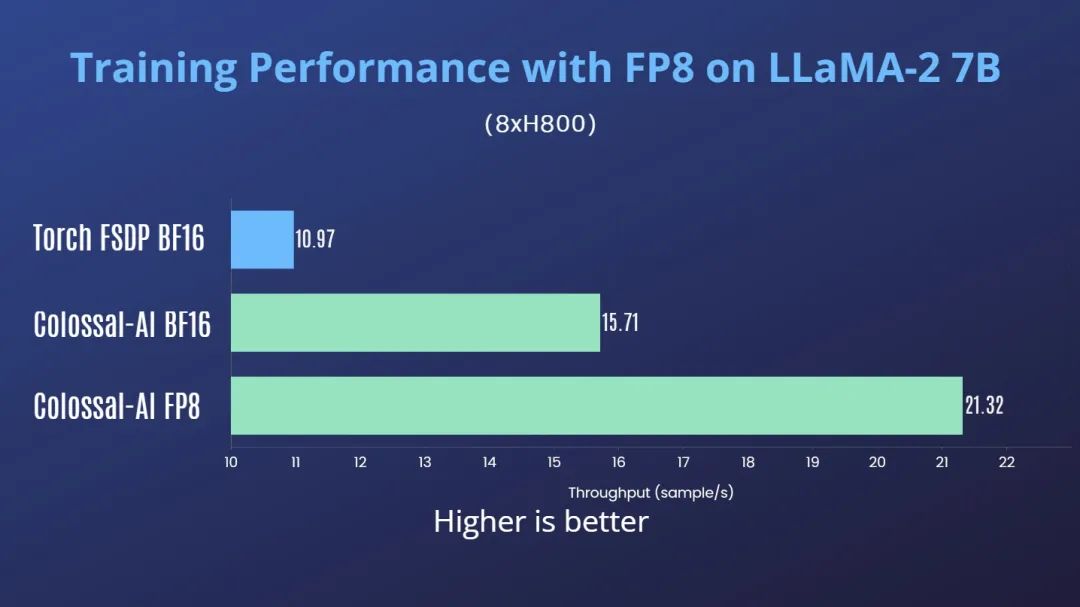
Colossal-AI还测试了H800多卡并行训练场景下的性能。在单机8卡H800上训练LLaMA2-7B,Colossal-AI FP8对比Colossal-AI BF16有35%的吞吐提升,对比Torch FSDP BF16有94%的吞吐提升。
img

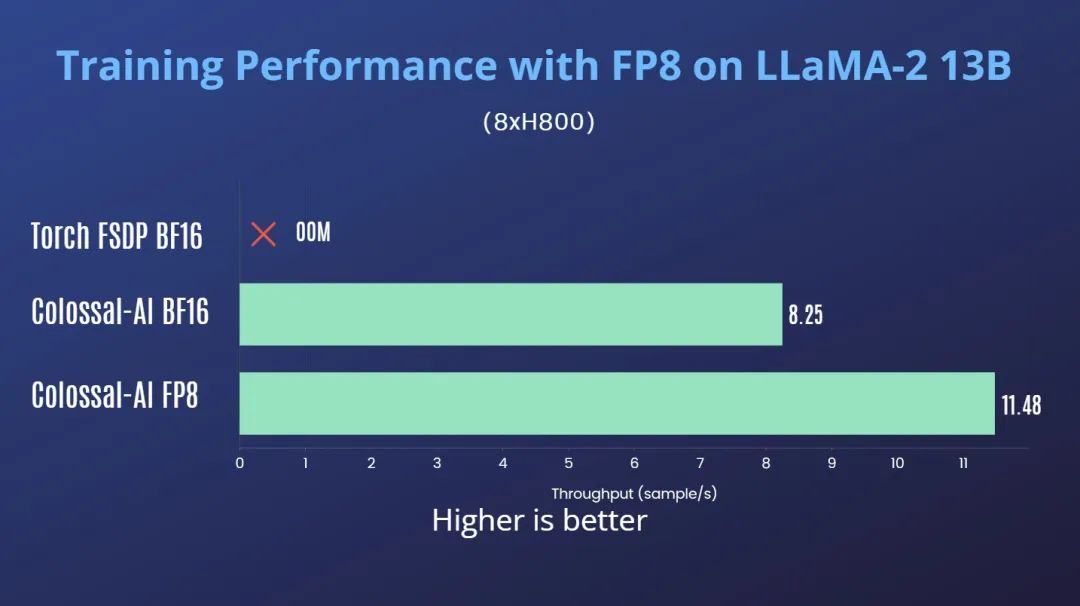
在单机8卡H800上训练LLaMA2-13B,Colossal-AI FP8对比Colossal-AI BF16有39%的吞吐提升。
img

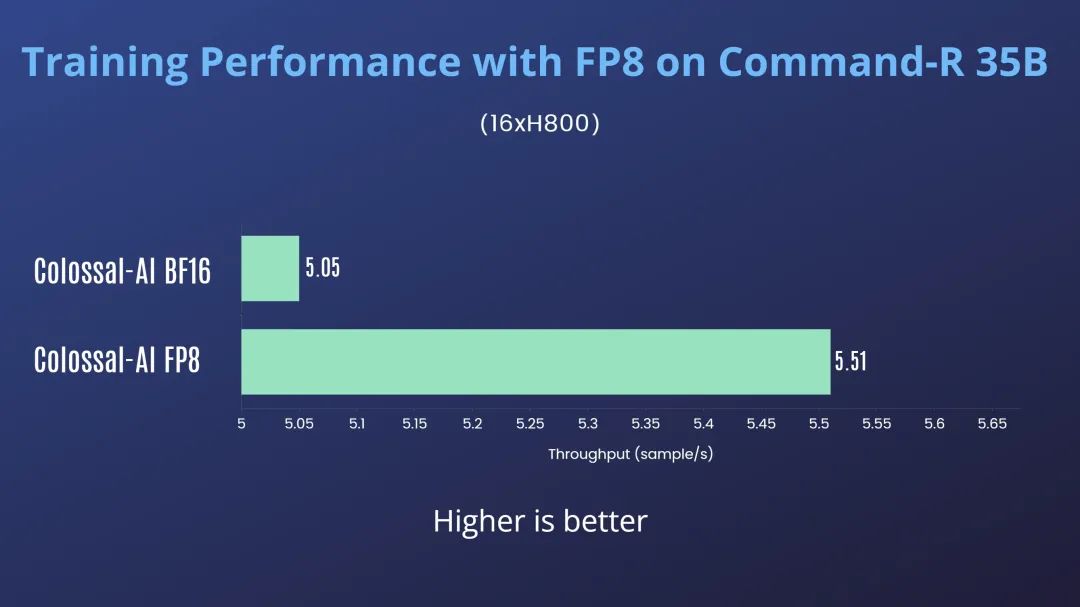
在2机16卡H800上训练Cohere Command-R 35B,Colossal-AI FP8对比Colossal-AI BF16有10%的吞吐提升,如图7所示:
img

根据英伟达的报告和测试经验,对FP8混合精度训练性能调优有一些初步的认识:

  • 尽量少使用张量并行,用流水线并行代替张量并行
  • 模型hidden size越大,加速效果越明显
  • 矩阵乘法占比高的模型加速效果大

由于上述实验中Command-R 35B采用了张量并行,所以加速效果不太明显。

Colossal-AI对FP8的支持较为广泛,各种并行方式都能和FP8混合精度训练兼容。使用时,仅需在初始化plugin时开启FP8即可:

from colossalai.booster.plugin import GeminiPlugin, HybridParallelPlugin, LowLevelZeroPlugin
...
plugin = LowLevelZeroPlugin(..., use_fp8=True)
plugin = GeminiPlugin(..., use_fp8=True)
plugin = HybridParallelPlugin(..., use_fp8=True)

除此之外,无需多余的代码和AOT编译。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

大模型训练加速利器:混合精度训练(Mixed Precision Training)实战解析 本文深入解析混合精度训练(Mixed Precision Training)在大模型训练中的加速原理与实战应用。通过FP16与FP32的智能组合,可显著提升训练速度并降低显存占用,特别适合百亿参数级大模型。文章详细讲解PyTorch实现步骤、常见问题解决方案,并分享与梯度累积、DeepSpeed等技术的联用技巧,帮助开发者高效训练LLaMA等大型语言模型。 阅读详情

相关推荐

国产AI芯片大模型训练实战:降本增效与软硬协同全解析

大模型训练正从依赖高端GPU转向国产AI芯片自主可控路径。其核心原理在于突破CUDA生态束缚,通过MLIR编译器重构、INT16混合精度优化、KV Cache动态分片及定制化通信库(如C3L)实现算力真实吞吐提升。技术价值体现在显著降低千卡时成本(¥/kWh)、提升tokens/sec/W能效比,并满足金融等高合规场景对ECC、长时稳定性和中文长文本处理的严苛要求。典型应用场景包括3B级LLM日均高频训练、领域微调(如金融术语理解)、万字文档推理等。本文聚焦寒武纪思元590与壁仞BR100双平台实测经验,覆

alince20008的博客 504

一行代码训练成本再降30%,AI大模型混合精度训练再升级|开源

通过其独特的数值表示方式,能够在保持一定精度的同时,在大模型训练中提高训练速度、节省内存占用,最终降低训练成本。AI大模型开发系统的,支持主流的BF16(O2) + FP8(O1)的新一代混合精度训练方案。仅需一行代码,即可对主流LLM模型能够获得,降低相应大模型开发成本,并保证训练收敛性。无需引入额外的手写CUDA算子,避免了较长的AOT编译时间和复杂的编译环境配置。开源地址:https://github.com/hpcaitech/ColossalAI。

AI大模型资料分享员 897

免费开源项目一行代码训练成本再降30%,AI大模型混合精度训练再升级,安装部署步骤,支持docker一键运行!AI从任何地方使用语音命令控制您的电脑和智能家居!

免费开源项目一行代码训练成本再降30%,AI大模型混合精度训练再升级,安装部署步骤,支持docker一键运行!AI从任何地方使用语音命令控制您的电脑和智能家居!

代码讲故事 715

如何在云上低成本运行TensorFlow大模型训练?

在云环境运行大规模TensorFlow模型时,通过使用官方镜像、分布式训练、混合精度和XLA优化,可显著降低训练成本。结合TensorBoard监控与合理架构设计,避免资源浪费,提升训练效率。真正的低成本源于高效率的工程实践。

weixin_36431145的博客 718

企业AI训练成本优化:架构师的分布式训练实践

想象你是一家电商企业的AI架构师,老板拍着桌子问:"我们的推荐模型从1亿参数升级到10亿后,训练成本涨了10倍,再这样下去部门预算要见底了!能不能把成本降下来?"这不是虚构场景——根据斯坦福AI指数报告,2020-2023年大模型训练成本年均增长300%,单个千亿参数模型的训练成本可达千万美元级别。为什么企业AI训练成本会失控?(底层原因分析)分布式训练如何像"多人协作做蛋糕"一样降低成本?(核心技术原理)架构师需要掌握哪些"省钱技巧"?(从资源调度到精度优化的全流程实践)

AI开发架构师 888

沈阳计算机研究所复试,沈阳计算所复试试题附答案.doc

沈阳计算所复试试题附答案目录数据结构1200612007220085200914操作系统16200616200718200818200919组成原理20200620200720200821200921经典算法22数据结构2006数据结构部分(共25分,第1题10分,第2题15分)在(下图)所示的有向图中:v1 v2v4 ...

weixin_42511053的博客 862

一文了解人工智能AI、大模型、AI大模型、ChatGPT、GPT-4、OpenAI、Claude 3...

这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。AI大模型是“人工智能预训练大模型”的简称。更新的数据集:GPT-4 的训练数据集不仅更大,而且包含了更广泛的主题和领域,从而使模型具有更全面的知识。更大的模型容量:GPT-4 采用了更多的神经网络层和参数,使其能够学习更复杂的文本模式和结构。

python12222_的博客 2106

3dsMax高效导入OSGB倾斜模型的3个关键步骤与插件应用

本文详细解析了在3dsMax中高效导入OSGB倾斜模型的三个核心步骤:建立索引、处理贴图路径以及选择合适的插件。针对导入过程中常见的模型崩溃、贴图丢失和操作卡顿问题,提供了从数据结构理解到插件选型的实战解决方案,帮助用户实现大规模实景模型在3dsMax中的流畅导入与编辑。

weixin_29238147的博客 469

GPU算力租赁推荐:低成本训练YOLO大模型

通过GPU算力租赁平台按需使用高性能显卡,可显著降低YOLO模型训练成本。本文介绍不同场景下的GPU选型策略、优化训练代码的方法,并结合真实案例说明如何节省数万元开支,同时提升研发效率与协作能力。

weixin_28988985的博客 998

从零开始掌握机械臂运动控制:原理、建模与实践

本文系统介绍了机械臂运动控制的核心原理与实践方法。从运动学与动力学建模的基础理论出发,详细解析了经典PID控制与现代MPC(模型预测控制)算法的应用,并通过ROS与MATLAB仿真案例,指导读者从零开始实现机械臂的轨迹规划与精准控制,为工业自动化应用提供完整的技术路径。

weixin_29099217的博客 565

深度学习部署工程师--8(docker+TensorRT部署到推理+yolo人体检测)下

本文介绍了YOLOv5模型通过TensorRT加速部署的流程。首先需要检查磁盘空间,确保有30GB可用。文章对比了不同推理方式的性能:int8量化+TensorRT可达200FPS,纯TensorRT为166FPS,CUDA为147FPS,CPU为93FPS。重点讲解了将YOLOv5模型导出为ONNX格式的详细步骤,包括修改Detect类的forward方法以移除decode运算,使用git patch批量修改代码,安装必要的依赖库,以及通过onnx-graphsurgeon工具修改ONNX图结构。最终目标

FJN110的博客 494

PaddlePaddle镜像支持FP16混合精度训练,节省显存高达40%

PaddlePaddle最新GPU镜像原生支持FP16混合精度训练,显存最多降低40%,训练速度提升近70%。通过自动化的损失缩放和Tensor Core优化,用户无需修改代码即可享受高效训练体验,尤其适合中文AI任务与边缘部署,显著降低资源成本与环境配置门槛。

weixin_35516273的博客 937

『MaxKB 2.x 开发环境搭建』在Windows下运行最新源码的完整步骤

本文将详细介绍如何在Windows系统中完成MaxKB最新版(2.x)开发环境的搭建,包括前端、后端以及数据库的配置,确保开发者能够顺利启动项目。

老陈聊架构 586

YOLO11显存不足?混合精度训练实战解决

本文介绍了基于“星图GPU”平台,如何通过自动化部署YOLO11深度学习镜像,解决目标检测模型训练中的显存不足问题。借助该平台的高效环境配置能力,用户可快速启用混合精度训练,在不降低精度的前提下显著减少显存占用,典型应用于YOLO11模型微调任务,实现小显存设备上的高性能训练。

weixin_42513209的博客 938

基于情感分析+聚类分析+LDA主题分析对服装产品类的消费者评论分析

本研究旨在通过对服装产品类的消费者评论进行综合分析,为企业提供更全面、更深入的市场洞察和决策支持。同时,本研究的方法和结果也可以为其他领域的消费者评论分析提供借鉴和参考。

m0_64336780的博客 2万+

爬虫瑞数5.5案例:欧冶钢材交易官网,带后缀K5nOZLud(面向对象补环境)

瑞数动态安全 Botgate(机器人防火墙)以“动态安全”技术为核心,通过动态封装、动态验证、动态混淆、动态令牌等技术对服务器网页底层代码持续动态变换,增加服务器行为的“不可预测性”,实现了从用户端到服务器端的全方位“主动防护”,为各类 Web、HTML5 提供强大的安全保护。由于之前某通信的瑞数已经调整,这里再出一篇文章,瑞数特点以及请求执行的流程已在之前的文章中分析过,这里不再特别讲解;

老衲爱洗头的博客 3043

PyTorch 2.9混合精度训练:3步开启FP16,省时省显存

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.9镜像,无需手动配置CUDA环境即可快速搭建兼容性良好的深度学习环境。基于该平台,用户可轻松实现混合精度训练,仅需三步即可开启FP16,显著降低显存占用并提升训练速度,适用于模型微调、AI应用开发等典型场景,尤其适合显存有限的开发者高效利用算力资源。

GarnetFalcon73的博客 976

315、弱电基础知识介绍

常见的弱电系统包括:闭路电视监控系统、防盗报警系统、门禁系统、电子巡更系统、停车场管理系统、可视对讲系统、家庭智能化系统及安防系统、背景音乐系 统、LED显示系统、等离子拼接屏系统、DLP大屏系统、三表抄送系统、楼宇自控系统、防雷与接地系统、寻呼对讲及专业对讲系统、弱电管道系统、UPS不 间断电源系统、机房系统、综合布线系统、计算机局域网系统、物业管理系统、多功能会议室系统、有线电视系统、卫星电视系统、卫星通讯系统、消防系统、电话 通讯系统、酒店管理系统、视频点播系统、人力资源管理系统等等。

qq_43416206的博客 1366

大模型Token包年套餐上线:最高节省70%成本

通过PyTorch-CUDA预置镜像与Token包年套餐组合,开发者可实现开箱即用的GPU环境与长期成本优化。容器化技术解决了环境配置繁琐、多卡训练复杂等问题,显著提升AI开发效率,同时大幅降低训练支出。

weixin_35019679的博客 1178

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

JMeter 6.0.0 迁移 Java 17 完整指南:5 步走通升级,一次避坑到位

JMeter 6.0.0 把最低运行环境从 Java 8 直接提到了 Java 17。这次 Java 17 升级不只是换个 JDK 那么简单:垃圾回收、插件生态、脚本引擎都会跟着变。下面按"升级前体检 → 构建落地 → 配置与插件 → 升级后验收"的顺序把整套迁移流程走一遍,你照着做就行。 [![JMeter 6.0.0 主界面截图](https://raw.gitcode.com/gh_mir

gitblog_00705的博客 1085

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

【人工智能】大模型训练与推理对硬件性能的需求

​基础公式​:​推理显存​ ≈ 参数显存 × 1.2 + KV缓存 + 激活值​训练显存​ ≈ 参数显存 × 6(梯度+优化器状态+激活值)​规模与精度​:百亿级模型必选分布式部署(如175B模型需8×H100)​优化优先级​:​低显存场景​ → 量化(INT4) > 动态批处理(vLLM) > 注意力优化(FlashAttention)​高并发场景​ → 多卡互联(NVLink) > 异构计算(CPU卸载)

weixin_49199313的博客 6347

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

支持FP16/BF16混合精度训练|Llama-Factory效率再提升

Llama-Factory全面支持FP16/BF16混合精度训练,显著降低显存占用并提升训练速度。通过自动混合精度(AMP)技术,结合LoRA等高效方法,用户无需修改代码,仅需简单配置即可在单卡A100上高效微调LLaMA-2-7B等大模型,显存减少近50%,训练速度提升2倍。

weixin_35639680的博客 1052

一文解析 DeepSeek 大模型高效训练背后的极限 AI 工程优化

国产之光 Deepseek 大模型成功出圈,在效果比肩非开源模型ChatGPT的同时,其运行成本很低。那么 Deepseek 是如何实现这么高效的训练呢?文本将简要介绍 Deepseek 母公司幻方开源的 HAI-platform 大模型训练工具,来一窥极限 AI 工程的秘密。为了更好地发挥 GPU 集群的计算能力,训练具有惊人功能的、强大的万亿参数模型,一个高效简洁的大模型训练工具十分必要。

m0_59164520的博客 2177

Llama-Factory是否支持混合精度训练?BF16/FP16全部兼容

Llama-Factory全面支持BF16和FP16混合精度训练,结合LoRA/QLoRA可显著降低显存消耗并提升训练效率。通过Hugging Face Accelerate实现自动精度管理,兼容主流硬件,支持WebUI一键配置,大幅降低大模型微调门槛。

weixin_30789053的博客 614
上一篇: 将文本或 url 信息结合 LLM 的常识自动转成可视化的知识图谱!
下一篇: 啃完它别说大模型 虎先锋都能轻易拿捏!<ChatGLM3大模型本地化部署、应用开发与微调>
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值