当AI开始“审判”AI:21%的ICLR 2026评审纯AI生成,深度剖析学术圈的“效率陷阱”!

【ICLR 2026 Oral】TimeMixer++: A General Time Series Pattern Machine for Universal Predictive Analysis 很好的ICLR Oral,爱来自瓷器! 阅读详情

上面这个相当扎心的答案,来自Pangram实验室的分析报告。

这件事被发现的起因颇具戏剧色彩:CMU的AI研究员Graham Neubig,感觉自己收到的同行评审AI味超级重。

他之所以起疑心,是因为这些评审内容“非常冗长,且包含大量符号”,并且所要求的分析方式并非“审稿人通常在AI或ML论文中所要求的那种标准统计分析方式”。

做事嘛,不能光靠直觉,要真凭实据啦。

Graham Neubig自己干不了这个事儿,就在𝕏上发布了一个悬赏令,希望有人能做一轮系统性的检测,看ICLR的论文和审稿中到底夹杂了多少AI文本。

我愿意悬赏50美元,给第一个做了这件事的人~
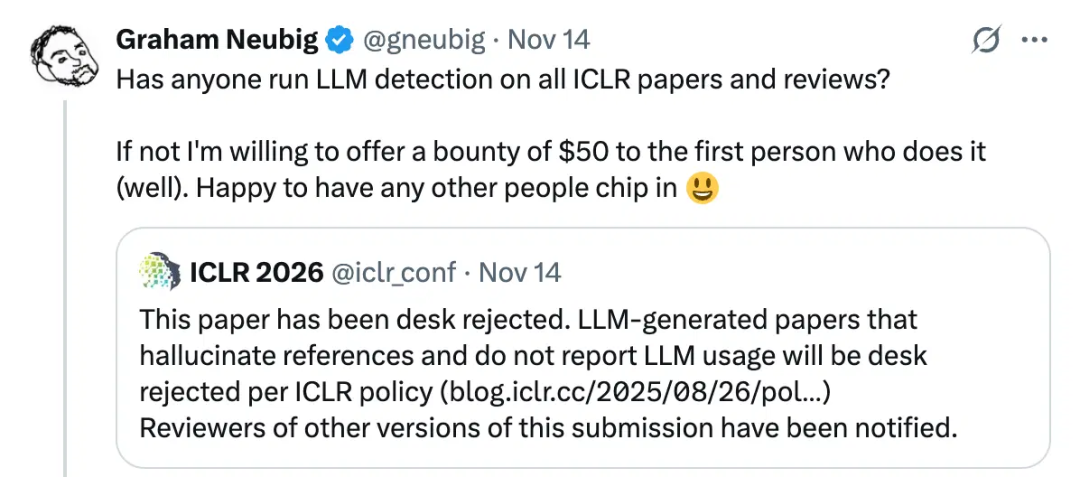
Pangram实验室就是那个接黄榜的。

这个实验室的业务之一,正好是开发检测AI生成文本的工具。

结论简单粗暴:

  • 75800条评审中,15899条高度疑似完全由AI生成,占比21%。
  • 大量论文正文中也检测出AI参与的痕迹,有的论文甚至大半字数都是AI的产出。

一个顶级AI学术会议,审稿和投稿两头都出现大规模AI代写……

是怎么测出“AI味”的?

Pangram这次对ICLR的全部提交论文和所有评审做了系统分析,并且在博客中公开了全过程。

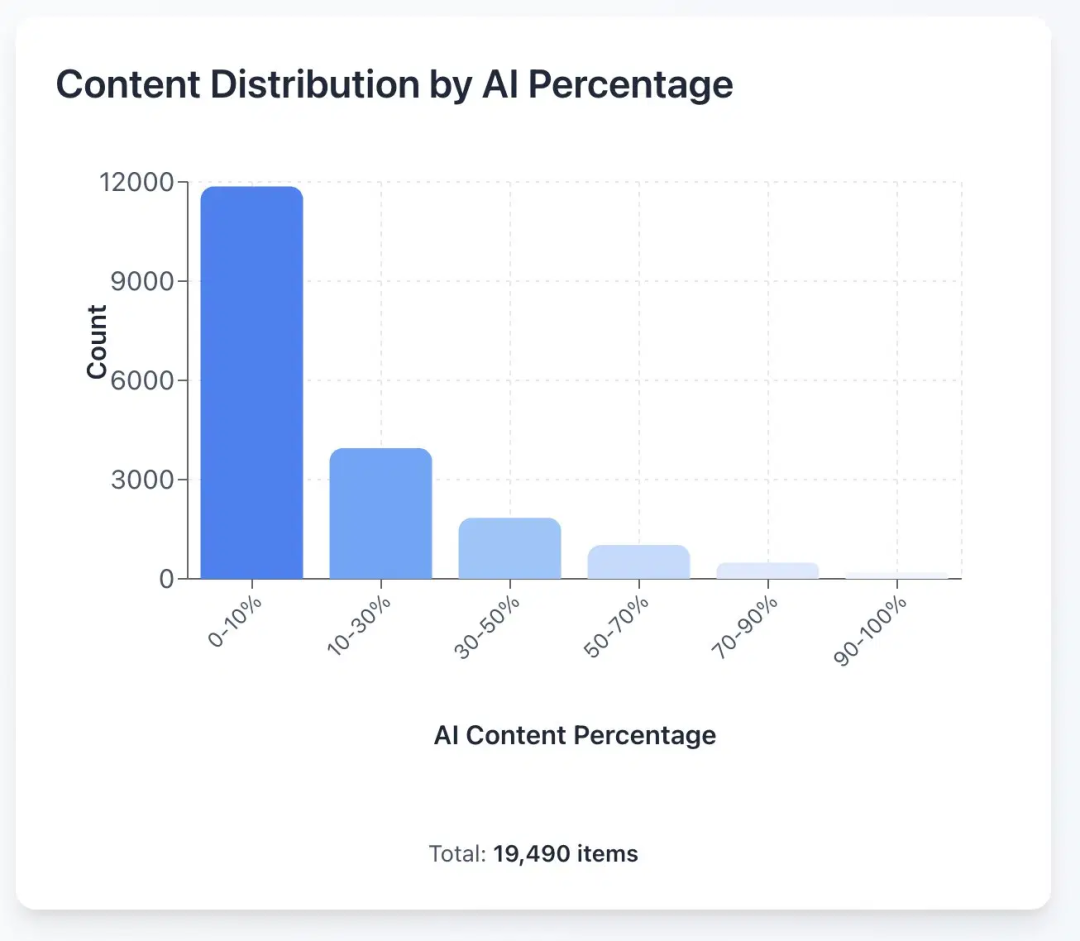
他们先在OpenReview上,把ICLR 2026的数据全部拉了下来,总计约19490篇论文投稿,以及75800条审稿意见。

这些论文多为PDF格式,普通PDF解析工具面对公式、图表、行号、表格等内容时容易抽风,会干扰后续的文本分析。所以常规的PDF解析器,比如PyMuPDF就用不了了。

于是Pangram用OCR模型*(他们用的是Mistral OCR)* 把PDF转成Markdown,再统一转成纯文本,尽量减少格式噪音。
检测两类文本时,Pangram实验室用了两种不同的模型——

检测论文正文时,用的是extended text classifier。

具体流程是先把整篇论文按段落或语义片段切分成若干segment,判断每个segment“更像人写”还是“更像AI写”。

之后汇总结果,得到整篇论文中AI生成内容的大致比例,最后标记出“人类为主”“混合写作”“几乎完全AI生成”“极端outlier”等类别。

为了验证模型的准确程度,Pangram还拿2022年之前的ICLR论文和NeurIPS论文做了测试。

结果显示,这些论文由AI生成的概率是0%(尽管有部分论文用于模型训练)。
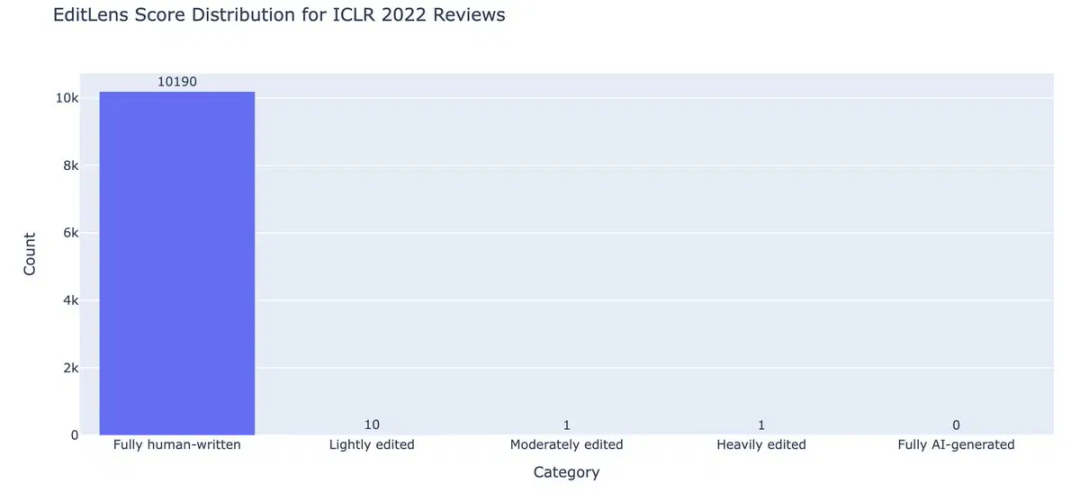
检测评审内容时,使用了新模型EditLens。

这个模型除了判断评审内容是否为AI生成外,还尝试判断AI在其中的参与程度。

分为五个级别:完全人工撰写、AI润色、中等程度AI编辑/辅助、AI重度参与、完全由AI生成。

在一个已知完全由人类撰写的对照语料上,EditLens把纯人类写作内容错判成AI润色过的内容的误报率,差不多是1/1000;错判成中等程度AI编辑/辅助内容的误报率是1/50000;错判成AI重度参与的错误率是1/100000。
回到实验室对ICLR 2026论文和评审的检测,结果如下。

有15899篇评审完全由AI生成,占评审总数的21%。

此外,超过一半的评审涉及不同程度的AI参与行为。
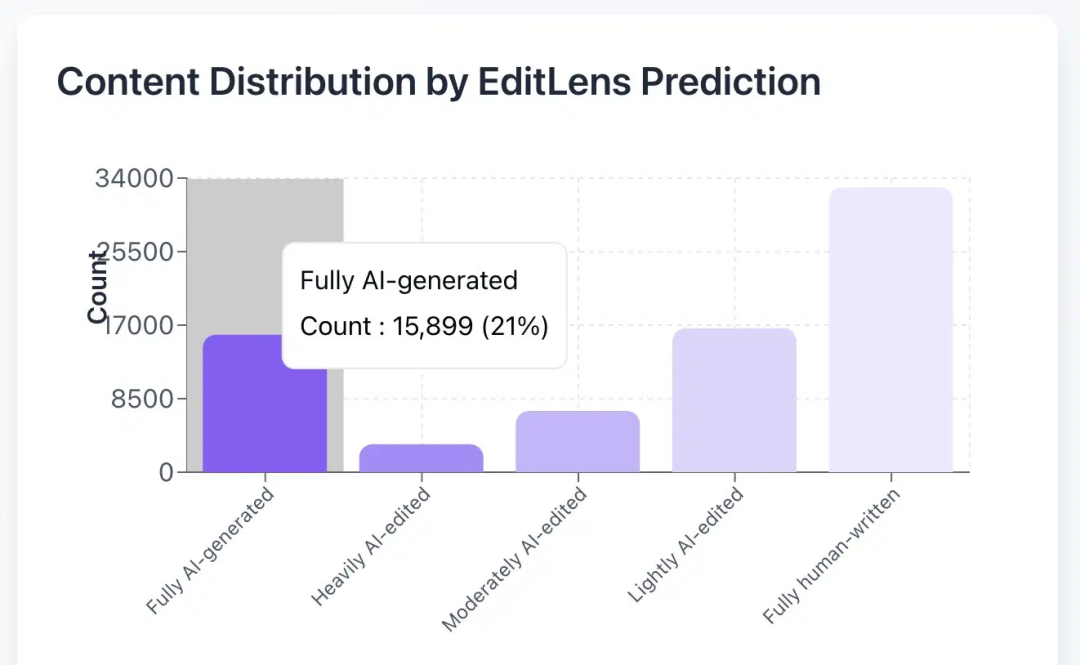
此外,61%的ICLR 2026论文是人工撰写的,但有199篇论文*(占总数量的1%)*完全由AI生成。

但实验室提到,部分完全由AI生成的论文,可能在此前已经被ICLR拒稿了,不会出现在OpenReview中。
一、AI顶会审稿正陷入一种奇妙的恶性循环

Pangram表示,他们做这个事情当然是因为有个悬赏贴在*(doge)*,但并不是为了“点人名、批判某几个个体”,而是希望揭示一个趋势,一种现象。

ICLR 2026高级项目主席、康奈尔大学伊萨卡分校副教授Bharath Hariharan表示,这是ICLR首次大规模遇到此类问题。

ICLR开始用自动化工具,来评估提交的论文和同行评审是否违反了会议规定。

是的,其实ICLR对论文和评审中使用AI/禁止使用AI有非常清晰和详细的规定。

首先,如果使用了AI,必须披露,需要遵循“所有对研究的贡献都必须得到承认”和“贡献者应该期望……获得对其工作的认可”的道德准则政策。

其次,ICLR作者和评审者最终对其贡献负责,遵循“研究人员不得故意做出虚假或误导性声明,编造或篡改数据,或歪曲结果”的道德准则政策。

同时,ICLR还规定了作者在使用AI撰写论文和进行评审时应遵循的指南。

总结来说,论文作者可以用AI帮自己撰写论文,或者配合自己做研究,但必须声明自己使用了AI,并对论文的科学性和诚信负责。

同行可以用AI润色自己的评审,但纯用AI写评审可能违反道德准则,因为这既不是同行本人的观点而是外部意见,也违反了保密原则。
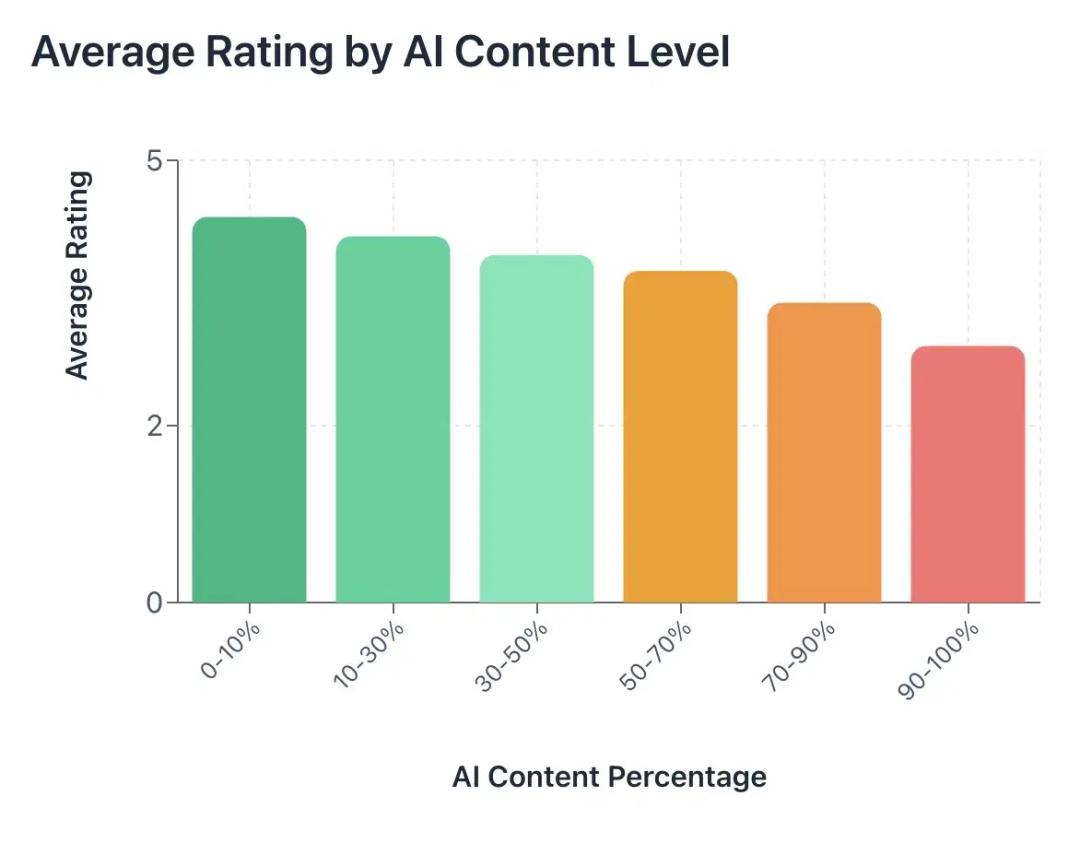
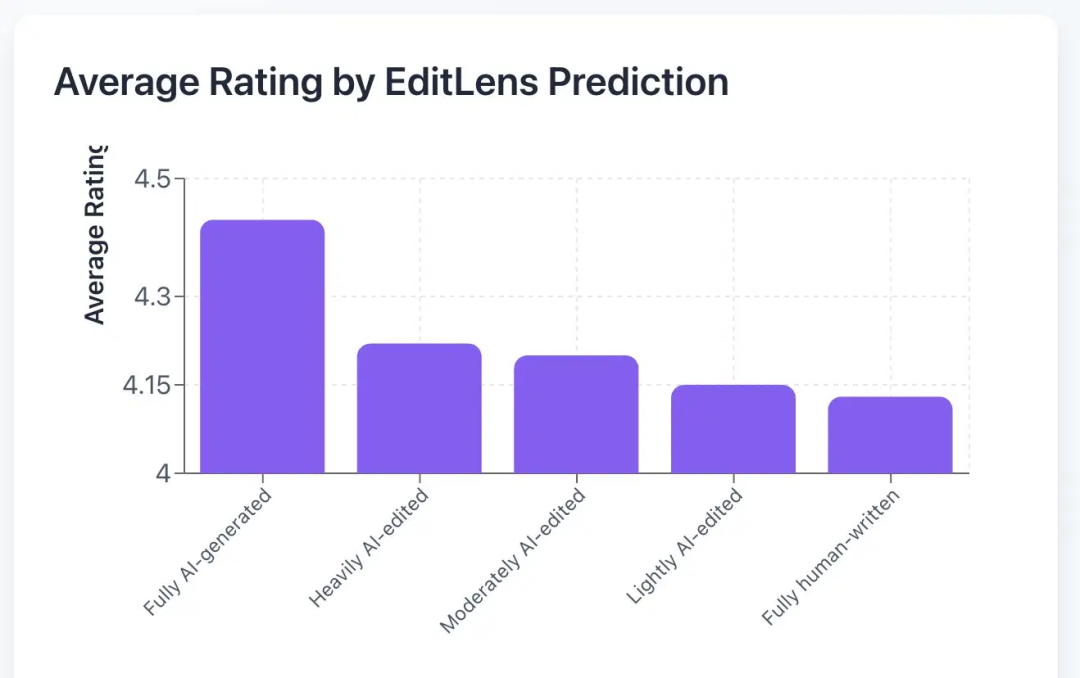
值得一提的是,Pangram实验室还把“AI 使用程度”和“评审分数”做了关联。

结果呈现出来的是两个相当微妙的趋势:

第一,论文中AI内容越多,平均收到的审稿评分就越低。

这可能意味着现阶段的AI写作,还是无法代替人类原创的论文的质量。
第二,审稿中AI参与程度越高,给出的评分就会越高。

换句话说,AI审稿更倾向于宽松友好的态度,评分就会偏高。
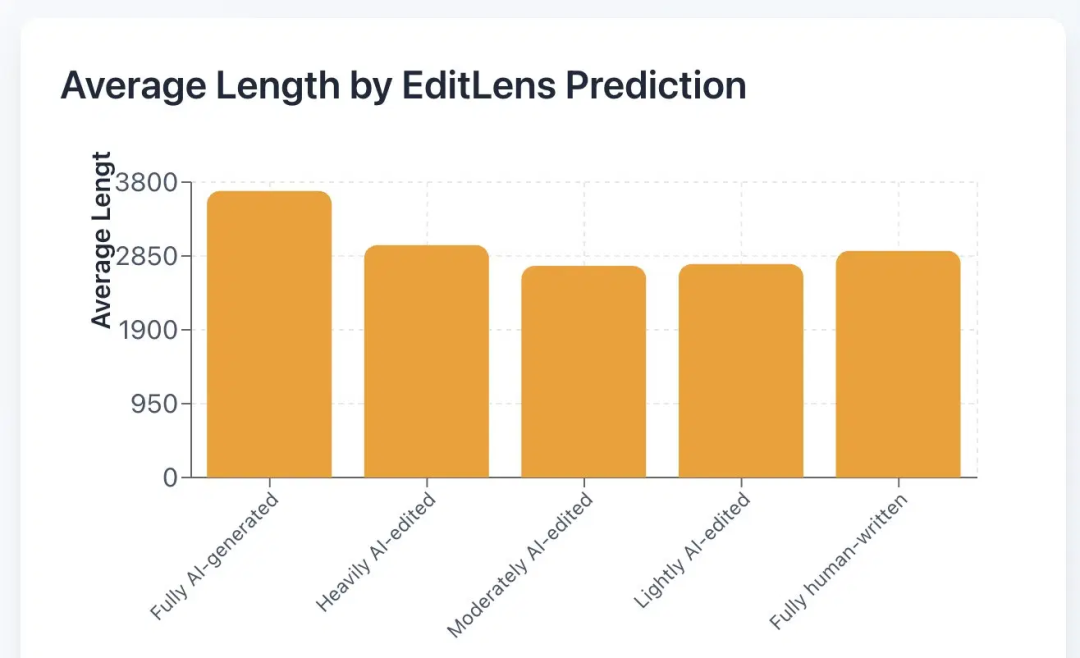
此外,AI生成的审稿内容往往字数较多,但信息密度低,建设性建议少,评论很多都很空洞,要不就是一堆车轱辘话。

这和以前 “长审稿=高质量审稿” 的情况完全相反。

而且论文作者们为了更好地rebuttal,一定会很认真地看评审意见。结果可能就是读了一些又长又没用的屁话,摊手。

这真的很消耗同行之间的信任。
二、怎么判断你得到的review是不是AI生成的?

Pangram实验室总结了一些AI生成的评审内容的特点,供大家参考,判断自己得到的review人工含量高不高。

先说标题。

AI生成的同行评审喜欢用粗体章节标题,标题往往由2-3个摘要标签组成,后面会跟冒号。

一个例子:
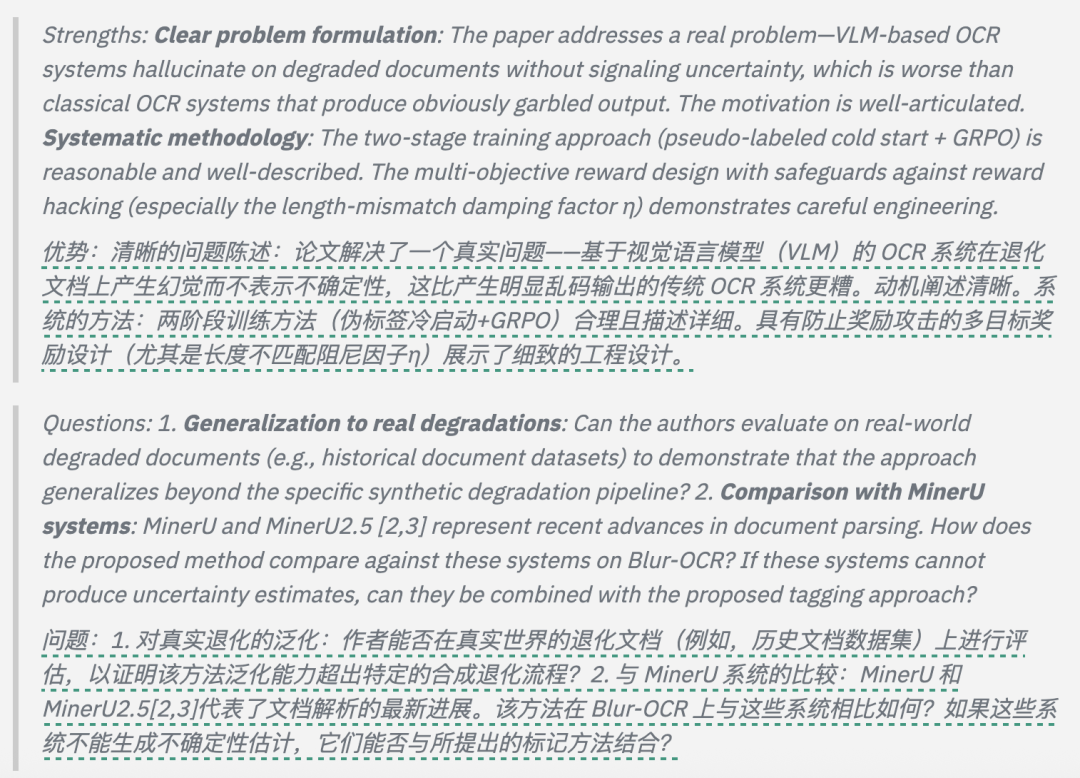
整体内容上,AI生成的评审内容总是吹毛求疵,没给出啥真正的分析。

这些评审基本都在关注表面问题。典型的AI评审内容包括提出让论文作者做更多已展示的消融实验、要求增加测试集大小或控制数量,或要求提供更多示例。

当然,最明显的就是说一些没啥用的片汤话,让人听君一席话,如听一席话那种。

不过,一个新的问题出现了。

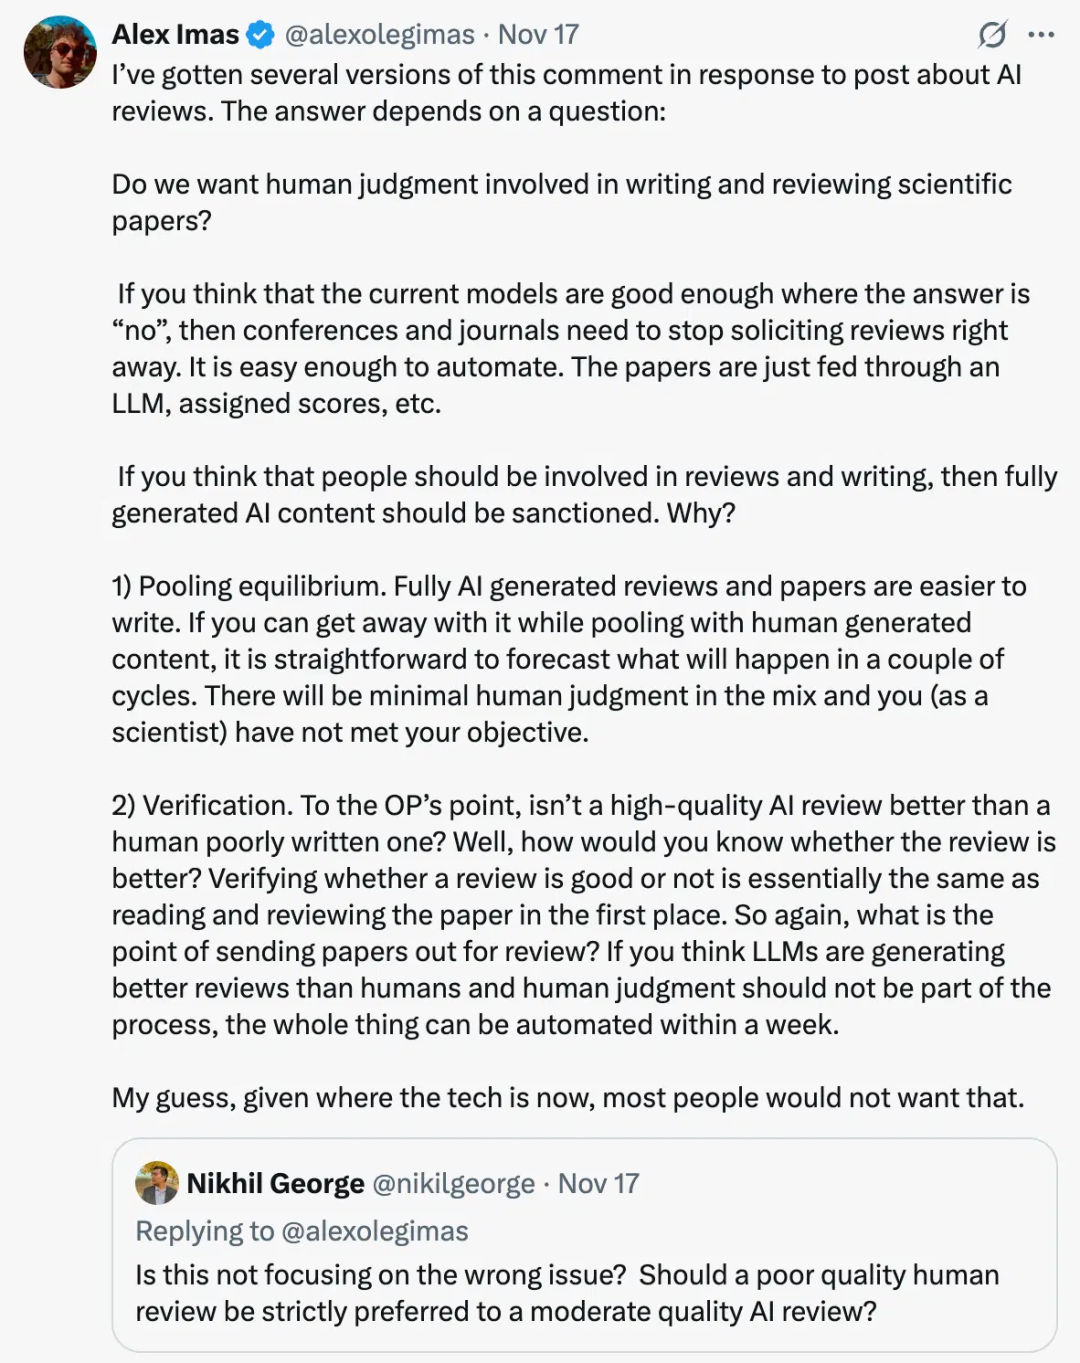
正如芝加哥大学经济学家 Alex Imas最近一条推文中说的那样:

我们是否希望在同行评审中包含人类判断?
三、One More Thing

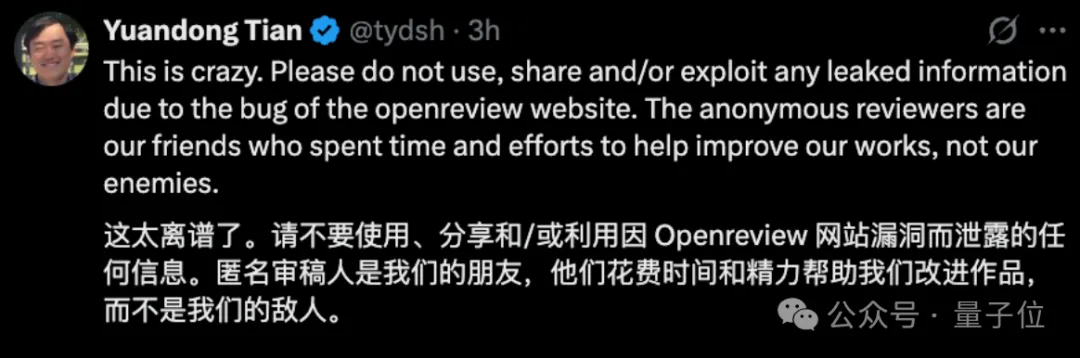
又有坑惨阶跃AI研究员的苹果论文,又有双盲评审制度一夜失效的bug,现在还有这么大规模的AI评审内容被揪出来……

今年的ICLR真的是抓马十足,而且开盒事件的余波还没有完全平息。

能理解大家知道是谁给自己的论文打低分后,情感上绝对会感觉到被背刺。

但事后值得关注的重中之重,还是“如何保证双盲评审能继续按规则施行”,任何顶会都不要再有这种惊天bug发生。

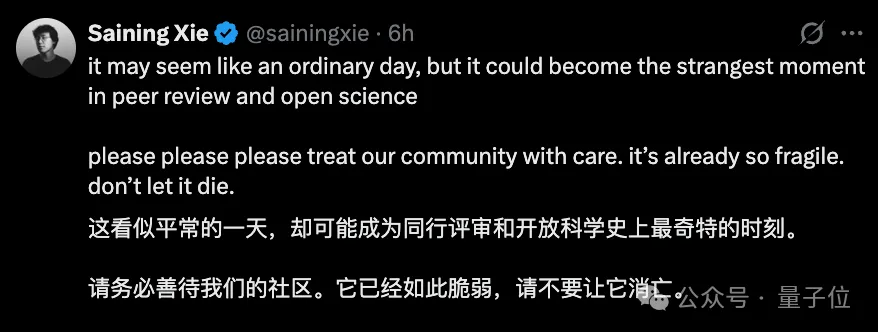
这关乎到整个学术共同体,是大家要一起面对的问题。
就像谢赛宁说的那样,“请务必善待我们的社区。它已经如此脆弱,请不要让它消亡。”
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

【ICLR 2026 Oral】Shedding Light on Time Series Classification using Interpretability Gated Networks 好文! 阅读详情

相关推荐

Mamba-3惊现ICLR 2026投稿:三重升级打满“推理优先”范式

在实验测量中(固定精度与状态维),单步延迟对比显示 Mamba-3(含 MIMO)更低延迟且更优困惑度-状态维的 Pareto 前沿:从 Mamba-2 → Mamba-3(SISO)整体下移,Mamba-3(MIMO)在相同状态开销下进一步下移。与此前追求参数简化、结构轻量的 Mamba-2 不同,Mamba-3 回到了对数值稳定性与状态表达力的根本追问——它用更高阶的离散化精度、更丰富的复值动态和更高密度的算术更新,让线性时序模型重新具备可解释、可扩展的物理一致性。

Paper weekly 1772

计算机顶级会议详细信息汇总

每年会议截稿日期不会有太大差别~因此每年会议都可以根据这个时间来提前准备。

2301_81211286的博客 1万+

论文阅读:ICLR 2026 AlphaAlign: Incentivizing Safety Alignment with Extremely Simplified Reinforcement Le

该论文发现:当前大语言模型的安全对齐方法存在两大痛点——要么导致模型对正常问题也过度拒绝,要么依赖海量人工标注的安全推理数据,模型只是死记硬背拒绝词,并没有真正理解“什么该拒绝”。而该论文的方法如同让孩子先思考“火会烧伤我,所以不能碰”,并通过奖励正确推理过程(比如说出“因为烫”),最终让孩子自己学会判断所有类似危险。该论文发现,基座模型其实已经内化了很多安全知识,只是没有被激活。为此,该论文提出全新框架AlphaAlign,用极简强化学习(RL)搭配可验证的安全奖励,激励模型内在的自我保护意识。

CSPhD-winston的博客 329

ICLR 2026截稿提醒:注意这项新规,否则直接拒稿

从面包山的日出到拉帕区的夜生活,整座城市散发着热带特有的慵懒与活力,就像里约人常说的:"上帝用六天创造世界,第七天创造了里约。会议考虑了广泛的学科领域,包括特征学习、度量学习、组合建模、结构化预测、强化学习、不确定性量化和大规模学习和非凸优化问题,以及视觉、音频、语音、语言、音乐、机器人、游戏、医疗保健、生物学、可持续性、经济学、机器学习中的伦理考虑等方面的应用。ICLR 2025,投稿量:11565篇,录取率:32.08%;ICLR 2022,投稿量:3391 篇,录取率:32.3%。

ConferenceEye的博客 5497

你不必懂AI,但必须会用AI:写给所有焦虑中的职场人

AI时代不必焦虑学技术,关键在于用AI解决实际问题。文章指出,99%的人只需成为AI使用者而非建造者,核心竞争力在于结合业务痛点运用AI工具提升效率。与其盲目学习工具,不如梳理工作流程,识别可优化环节,让AI赋能重复性、标准化任务。行业经验与AI工具的结合才是真正的职场护城河。建议从具体工作场景出发,寻找匹配的AI解决方案,迈出应用第一步。

hundred98的博客 721

麒麟V10系统下微信PC版安装全攻略:从源配置到一键安装(附常见问题解决)

本文详细介绍了在麒麟V10系统下安装和优化微信PC版的完整流程,包括系统环境准备、软件源配置、多途径安装方案以及性能优化技巧。特别针对国产操作系统用户,提供了从基础安装到高级配置的一站式解决方案,并附有常见问题排查方法,帮助用户快速实现微信PC版的高效运行。

weixin_30500105的博客 720

值得收藏!2024年人工智能顶级会议投稿信息汇总(机器学习领域)

本文对机器学习领域内的顶级会议进行了介绍,以便读者了解会议主题、截稿日期、举办时间及地点等关键信息。同时,还将这些会议信息汇总成了表格,做到一目了然,为读者投稿会议论文提供方便。

audyxiao001的博客 2万+

dxf-viewer 查看器

dxf-viewer SDK 的示例,它是一个基于 Three.js 和 Vue3 构建的基于 WebGL 的 BIM 模型查看器。它用于查看 DWG/DXF/PDF 文件。面积测量 - 角度测量 -标记。

qq_25547755的博客 866

ICLR 2026 重磅前瞻!Rebuttal前时间序列高分论文大盘点(附分类+核心方法解析)

ICLR 2026 Rebuttal前结果已正式公布!从评审得分分布来看,主流论文得分集中在 4.0–5.0 区间,4.5 分段以 86 篇达到峰值,整体呈现 “中间集中、两端稀疏” 的典型形态;6.0 以上论文数量明显减少,低于 3.0 的论文占比极小,反映出评审意见趋于理性、分化度有限,也意味着创新性与方法普适性成为论文脱颖而出的关键,而时间序列方向研究竞争依然激烈,7.0 以上高分作品往往在理论创新或应用影响力上具备显著突破。

2501_91070801的博客 2258

CoDeSys系列-3、Windows运行时软PLC主站和p-net从站IO设备组网测试

前面CODESY下载安装并熟悉了,p-net搭建从站也已经跑在虚拟机树莓派上了,我们只需要快速搭建一个profinet主站来和从站进行交互即可,这里我们直接用Windows下带的软PLC搭建profinet主站并和p-net的demo从站程序进行IO交互。评估是否进行Windows下的运行时PLC前先看一下注意事项,Windows下安装配置会需要修改boot及防火墙等,可能会影响Windows电脑的正常使用,所以创建项目时的设备可以选择非RTE的。

逍遥游的博客 7316

伪距单点定位算法原理以及利用最小二乘法计算实例

即该公式:建立下列代价函数满足最佳估值的条件为:即:可解得未知参数 X 的最佳估值由于每个可见卫星观测量的精度可能不一样,这时,需要对不同观测量赋予一个权重系数,称为加权。

qq_43381998的博客 1万+

ICLR 2026吃瓜现场:有人用LLM连投4版论文,竟然拿到两个8分?

他发现这篇论文里到处是奇怪的行文、不连贯的推导,还有不少对不上号的引用,但分数却一点没受到影响。首先是第一位,这位审稿人的审稿,看起来非常顺滑:开头两句礼貌夸赞“思路不错”、“有潜力”,接着轻轻带过几个中性意见“摘要稍微技术化一点”、“可以解释得更清楚”。如果论文是模型写的,审稿也是模型写的,那剩下的人类 reviewer 到底在体系里扮演什么角色?大家现在都开始自己去查审稿了——看看审稿人到底是自己写的,还是模型顺手糊的。这波操作给人的感觉就是,多丢几版上去试试,看哪版能撞上不懂行的审稿人。

Paper weekly 1453

【CVPR2025 DEIM】超详细!手把手训练自己的数据集教学:从源码下载,配置虚拟环境,准备数据集、训练、验证、推理测试 ,实现0到1的完整教学过程。本文在win系统上训练,最强实时目标检测算法!

本文详细介绍了CVPR2025 DEIM目标检测模型的完整使用流程。内容包含:1)源码下载与虚拟环境配置;2)Visdrone2019数据集准备与配置文件修改;3)训练参数设置及Windows系统常见问题解决方案;4)模型验证、推理测试及热力图生成方法。特别针对Windows用户提供了虚拟环境配置指导,并详细说明了数据集路径设置、参数调整等关键步骤。通过本文的指导,小伙伴可以快速掌握DEIM模型的使用方法,用于学术论文研究和实验分析。

Ai缝合怪、助力小伙伴高效发论文 7669

ICLR 2026 VLA 研究现状深度剖析

VLA 的定义在社区内出人意料地存在争议,尚未形成明确共识。近期一篇综述论文给出了一个广义定义:“视觉-语言-动作 (VLA) 模型是一个系统,它将视觉观察和自然语言指令作为必要输入,并可能整合其他感官模态。它通过直接生成控制指令来产生机器人动作。是否在某种类型的互联网规模视觉-语言数据上进行过预训练。VLA 是一个使用预训练骨干网络的模型,该骨干网络在互联网规模的视觉-语言数据上训练过,并随后被用于生成控制指令。

2501_93430156的博客 1929

RHCA III之路---EX436-1

由于ha这门课有大量命令需要在3个节点上同步执行.如果执行history会出现前面数字,复制多行会有些麻烦.lab环境是nodea,nodeb,nodec 考试环境是node1,node2,node3。就可以快速将历史命令实现可多行复制,当然也可以用awk进行分割,个人喜好随意。技巧只能加快答题速度,对考试得分帮助不大。确认3个红框内容一致,且没报错即可。再执行一个histrory。3个node节点上运行。这样就能1次复制3行。

Q先生 1012

面经-2023-联发科MTK-数字芯片设计

面经-2023-联发科MTK-数字芯片设计

w0shishabi的博客 2946

ICLR 2026|图像融合方向录用情况一览

ICLR 2026图像融合领域投稿全军覆没。会议检索显示4篇相关论文均未被接收,涉及VLM Agent、扩散模型、特征解耦和恶劣天气建模等前沿方向。这些工作包括《FuseAgent》《Dig2DIG》等创新研究,虽展现技术突破但未能入选。该结果反映出该领域研究仍面临挑战,期待未来能有更成熟的研究成果问世。

陈嘿萌的博客 524

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

实验室4篇论文被ICLR 2026录用

但现有记忆检索大多停留在一次性向量Top-K的快检索,它像大模型的“快思考”,反应迅速、成本可控,却天然偏向表层相似性:面对含糊提问、长尾细节或需要串联经历的场景时,容易召回不全或把不相关片段一起捞上来,造成“记忆噪声”与回答漂移。大量的实验结果有力地证明了 SONATA 的优越性:在多个真实世界的数据集上,该方法不仅能够比现有技术更敏锐地捕捉到潜在的演变模式,而且在预测精度和计算效率上均实现了显著提升,从而为处理大规模动态张量数据提供了一种强有力的新工具。检索到的记忆通过基于LLM的过滤进一步精炼。

阿木寺的博客 459

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

新加坡见!快手11篇论文入选人工智能领域顶会ICLR 2025

快手11篇论文入选人工智能领域顶会ICLR 2025

kuaishoutech的博客 1863

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

ICLR 2026 | Rebuttal前 时空数据(Spatial-Temporal)高分论文总结

本文整理了ICLR2026时空领域高分论文(均分>5),涵盖轨迹生成、城市智能体、时空图预测等方向。TrajFlow(6.5分)提出基于流匹配的全国范围GPS轨迹生成方法;USTBench(6分)建立评估大语言模型城市时空推理能力的基准;UrbanGraph(5.5分)开发物理信息异构图网络预测城市微气候。其他入选论文涉及交通信号控制、地球观测、气候预测等应用,均采用原论文提供的关键词进行简要介绍。所有论文均未正式录用,分数仅供参考。

suzukiwudi的博客 1141

Mamba-3惊现ICLR 2026!引爆AI圈

例如,当遇到需要周期性状态跟踪或精确计数的场景,Mamba-2可能依旧力不从心,因为它的内部状态演化仍是相对单一的衰减形式,缺乏「钟摆」般来回振荡的机制来捕捉循环规律。如果把AI智能体看作是在理解「环境观察」的问题,那随着「不可见状态」的增长(也就是观察不到,需要推理出来的信息),模型要解决的就变成了「状态追踪问题」。从Mamba-1的雏形初现,到Mamba-2的加速攀升,再到Mamba-3的全面跃迁,这项技术就像一段连续的乐章,一步步逼近效率与能力的完美和声。带着这些经验和反思,Mamba-3孕育而生。

阿木寺的博客 560

【论文学习】ICLR 2026和CVPR 2026论文:RF-Mem、mHC、Proxy-GS 和 Audio MCQ

1)RF-Mem通过模仿人类双记忆机制实现大模型长记忆的自适应检索,平衡效率与精度;2)mHC采用流形约束超连接解决大模型训练不稳定问题,在保持表达能力的同时确保训练收敛;3)Proxy-GS通过代理网格实现3D高斯泼溅的遮挡剔除,大幅提升大场景实时渲染效率。4)AudioMCQ构建音频选择题数据集并提出新训练范式,解决音频-语言大模型的音频理解缺失问题。

m0_62969865的博客 447

ICLR26出分!计算机视觉方向均分4.28,rebuttal进行时,涨分方法,速看!

这是一支实力强大的高学历导师团队,在计算机科学、机器学习、深度学习等领域,积累了丰富的科研经历,研究成果也发表在国际各大顶级会议和期刊上,在指导学员的过程中,今年是十分制,且只有2、4、6、8、10偶数分档,这让高分和低分之间的差距将被进一步拉大,正负意见的差距也显得更加直观明显。均分6分以上Accept的概率比较大,今年均分都低,如无负分,还是建议好好rebuttal,提分概率较大!的同学,想要以宏观视角,把之前长达四年单篇论文细节的研究成果,整合成一部逻辑自治、体系完整的博士学位论文。

小白学视觉 412

CVPR 2025 快开奖啦!ICML、IJCAI、MICCAI 2025 微信群成立!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!CVPR 2025 投稿交流群成立!!扫码下方二维码或者添加微信号:CVer2233,一定要备注CVPR 2025投稿+昵称,CVer小助手会拉你进入CVPR 2025 投稿交流群!扫码...

阿木寺的博客 566

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 395
上一篇: 【惊天内幕!】Transformer作者爆料:GPT-5.1已存在,OpenAI内部命名已乱套!
下一篇: 【小身材,大能量】阶跃开源4B Agent模型:如何在所有安卓设备上实现丝滑操作?
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值