【惊天内幕!】Transformer作者爆料:GPT-5.1已存在,OpenAI内部命名已乱套!

浪潮服务器ESXI6.7部署实战:手动集成RAID驱动避坑指南 本文详细介绍了在浪潮服务器上部署ESXI6.7时手动集成RAID驱动的完整流程和避坑指南。从驱动获取、解压技巧到封装实战,逐步解决国产服务器常见的驱动缺失问题,特别针对PM8060 RAID卡提供具体解决方案,帮助IT运维人员顺利完成ESXI部署。 阅读详情

过去一年里,关于AI发展,出现了两种观点的分化:

  • 一边是“AI增长放缓、模型到顶、预训练无用论”
  • 另一边则是隔三差五就来一次“AI大周”:GPT-5.1、Gemini 3、Grok 4.1。
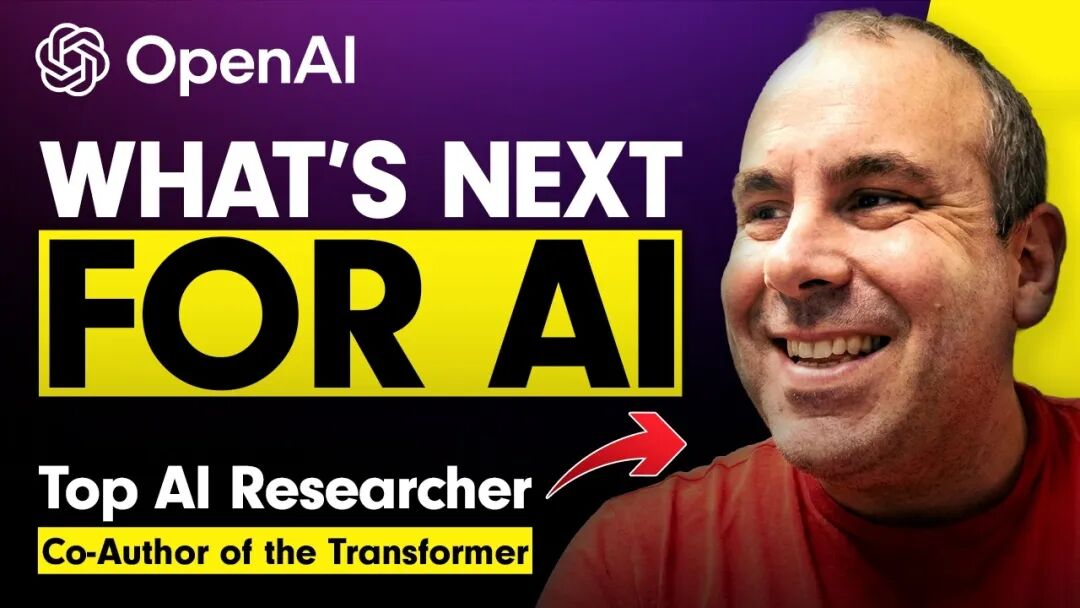
而Transformer作者之一、现任OpenAI研究科学家的Łukasz Kaiser最近接受采访,给出了第一视角的解答。

信息量极大,包括AI的底层范式转变、GPT-5.1的命名规则、未来AI的发展趋势……以及Transformer诞生背后的二三事。

AI不是变慢了,而是换代了。

GPT-5.1不是简单的小版本迭代,OpenAI内部版本命名规则有所变化。

多模态推理将会成为下一个突破点。

AI不会让人类完全失去工作。

家用机器人是继ChatGPT后最可见的AI革命。

下面一起来康康详细内容:

一、AI发展没有放缓,而是平稳增长

过去一年里,有关“模型进展变缓”的声音层出不穷,但Łukasz认为这种看法是错误的。
他给出的解释也很直白:

从内部视角看,AI的能力增长是一条非常平滑的指数曲线。

这类似于摩尔定律,几十年来摩尔定律始终有效,甚至在GPU的推动下还在加速,归根结底也是因为它历经了数代技术的迭代。

因此,AI从外部看,趋势是平稳的;而从内部看,其进步也离不开新技术、计算机能力的提升和工程优化的共同作用。

至于为什么会有人觉得“变慢了”,原因无它:AI的底层范式,已经悄悄从预训练转向推理模型。

这也是继Transformer诞生后的又一次关键转折。

如果把技术发展的过程描述为一条S型曲线*(起步→快速增长→平稳期)*,那么预训练就处于S曲线的上升后期,而推理模型仍处于初期。

不过这并不意味着预训练的Scaling Laws就失效了,它仍在发挥作用,只是和新的推理范式相比,需要投入更多的资金。
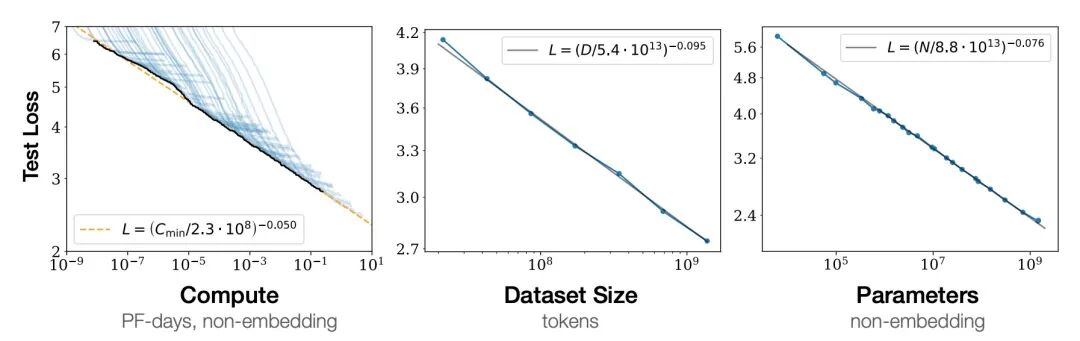
所以出于经济上的考量,业内人士开始普遍将工作重心转向更小也更便宜,但质量相同的模型,所以这也是导致外界认为预训练已经停止的原因之一。

那么回到推理模型上,由于该范式还处于新兴阶段,进步速度会相当之快。

以ChatGPT为例,GPT-3.5会直接基于训练数据记忆给出答案,而不会借助任何外部工具和推理,反观现在最新的ChatGPT会主动浏览网站、进行推理分析,再给出准确答案。

对于普通用户来说,如果不仔细对比,可能会觉得二者差异不大,但实际上这背后是性能质的飞跃。

又比如说Codex,程序员的工作方式已经在近几个月里转变为**“Codex先处理,然后人工微调”**的模式,这种变化其实相当之彻底,但如果不是专业从事编程工作,自然不会留意到这种根本性变革。

所以总的来说,这一切的变化都发生得太快,以至于让人们还未曾察觉到其中的变化。

而推理模型的本质其实也与基础大模型类似,只是在给出最终答案前,会优先进行思考,也就是所谓的思维链。

在思考过程中,模型被允许使用工具,例如浏览网页,以给出更准确的答案。其推理过程也会被视为模型的一部分并接受训练。

相比于传统的深度神经网络梯度下降训练,推理模型则更多使用的是强化学习。

具体来说,强化学习会通过奖励机制推动模型获取更好的答案,也需要研究人员提供更细致的数据准备,以完成强化学习的参数调整。

然后通过强化学习,模型就能学会对自身错误的纠正。

后续行业也会继续转向更复杂的强化学习,例如借助一个大模型来判断答案的正确性或偏好度,或者融入更多的人类偏好。
总之,未来强化学习的应用范围会更加广泛,不仅仅适用于特定领域,还能处理更多通用数据,比如说多模态推理,虽然最近Gemini已经能够在推理过程中生成图像,但整体来说还处于刚刚起步的阶段,相信在强化学习的帮助下会有进一步的提升。

二、GPT-5.1绝非表面上的小版本更新

关于最近发布的GPT-5.1,Łukasz也释出了更多细节。

GPT-5.1看起来只是小版本更迭,实际从内部来讲,是一个巨大的稳定性迭代。

首先回到最初的GPT-4到GPT-5,简单来说,得益于强化学习和合成数据的应用,GPT-5的推理能力明显提升了。

而到GPT-5.1的改进,则更多集中在后训练阶段,比如增加安全性、减少幻觉,以及添加了如书呆子、专业等多种风格选择。
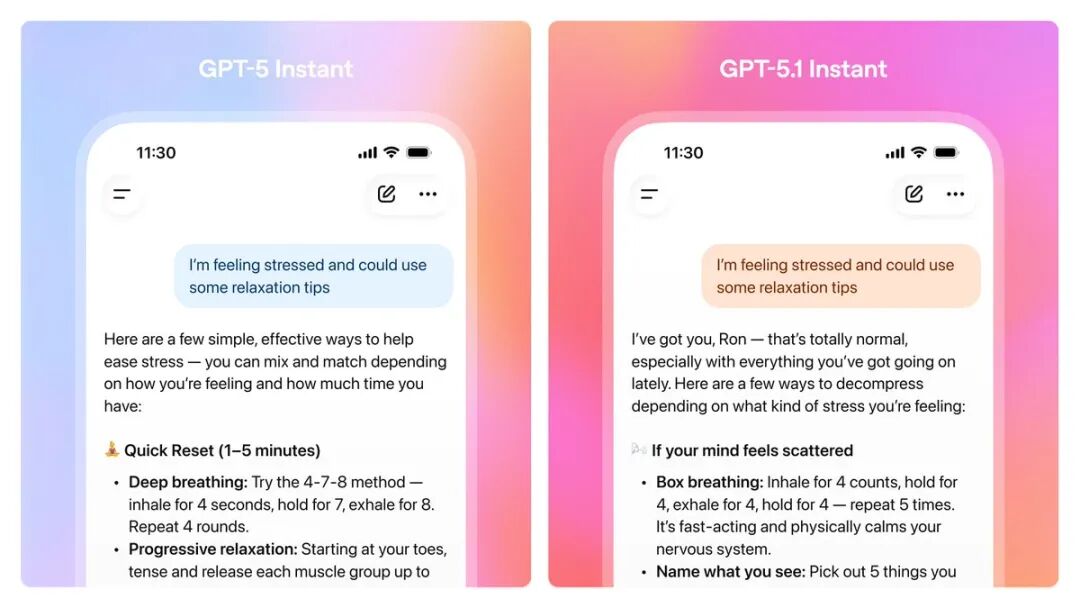
版本的命名方式也不再与技术细节挂钩,转而以用户体验为导向,比如GPT-5是基础能力较强的模型,GPT-5.1是能力更优的版本,Mini是更小、更快、更廉价但性能稍弱的模型,推理模型则专注于复杂任务。

这种命名方式的转变也为OpenAI内部带来了更多灵活性,现在强化学习、预训练、幻灯片优化等多个项目并行工作,然后通过蒸馏技术就能将多项目成果整合到一个模型中。

这大大缩短了模型迭代时间,可以更好地满足用户体验需求,所以GPT-5.1看似是小版本更新,实则背后是OpenAI基于用户对其能力和目标预期做出的策略调整。

不过坦白地讲,GPT-5.1在部分能力上仍然存在短板。
比如Łukasz用自己5岁的女儿举了个例子——

GPT-5.1能够游刃有余地解决奥林匹克竞赛题,但在面对小学一年级的数奇偶数题目上却错误百出。

该题目内容是,图中有两组点,中间有一个共享点,问总点数是奇数还是偶数。

5岁的孩子能够在10秒内就算出答案*(因为共享点的存在导致总点数为奇数)*,但无论GPT-5.1还是Gemini 3都会自动忽略这个共享点,误判为偶数。

这主要还是因为模型缺乏足够的多模态能力,也未能将一个问题的推理经验迁移到相似场景中,所以后续他们将会在训练中进一步强化多模态推理和上下文推理迁移能力。

三、从谷歌Transformer走向OpenAI

而作为Transformer的作者之一,Łukasz也在访谈中补充了很多诞生细节。
Łukasz自己原先是一名专注于理论计算机科学的学者,高中时就对数学和计算机充满兴趣,并在德国获得了理论计算机科学与数学博士学位。

他一直对“思维是如何运作的”、“智能的本质是什么”诸如此类的问题充满好奇,也曾在法国获得终身教职,从事逻辑和编程研究。

直到深度学习兴起,他加入了谷歌。

先是成为了Ray Kurzweil团队的一员,后转至Google Brain,开始与Ilya Sutskever等人合作。

在开发Transformer的过程中,Łukasz主要负责编码和系统工作,参与TensorFlow框架的开发。
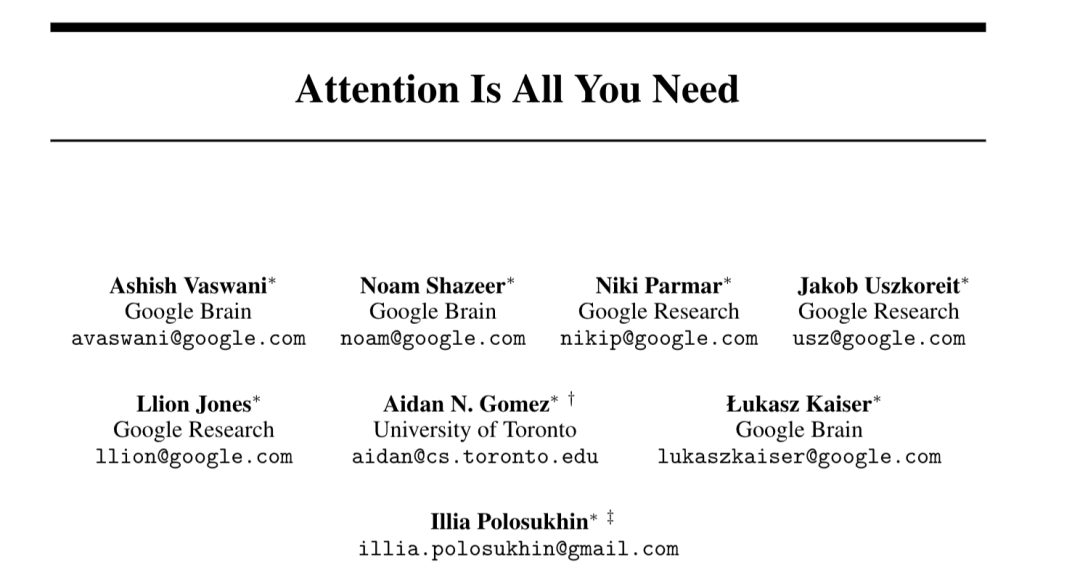
不过有趣的是,据他回忆,Transformer论文的八位共同作者从未在同一个物理房间中共同出现过。

而虽然他们彼此之间素未谋面,但他们通过不同角度共同构建了这个模型:

有人专注于注意力机制本身,有人研究如何通过前馈网络存储知识,还有人复杂解决工程实现问题,比如他自己。

从现在的角度看,Transformer毫无疑问是当今AI架构的里程碑,但在当时,很多人对用同一个模型处理多个任务的想法并不理解,他们普遍认为不同任务就应该分别训练不同的专有模型。

而他们八个人坚信自己的选择,后来的事实也证实了他们的想法是正确的。
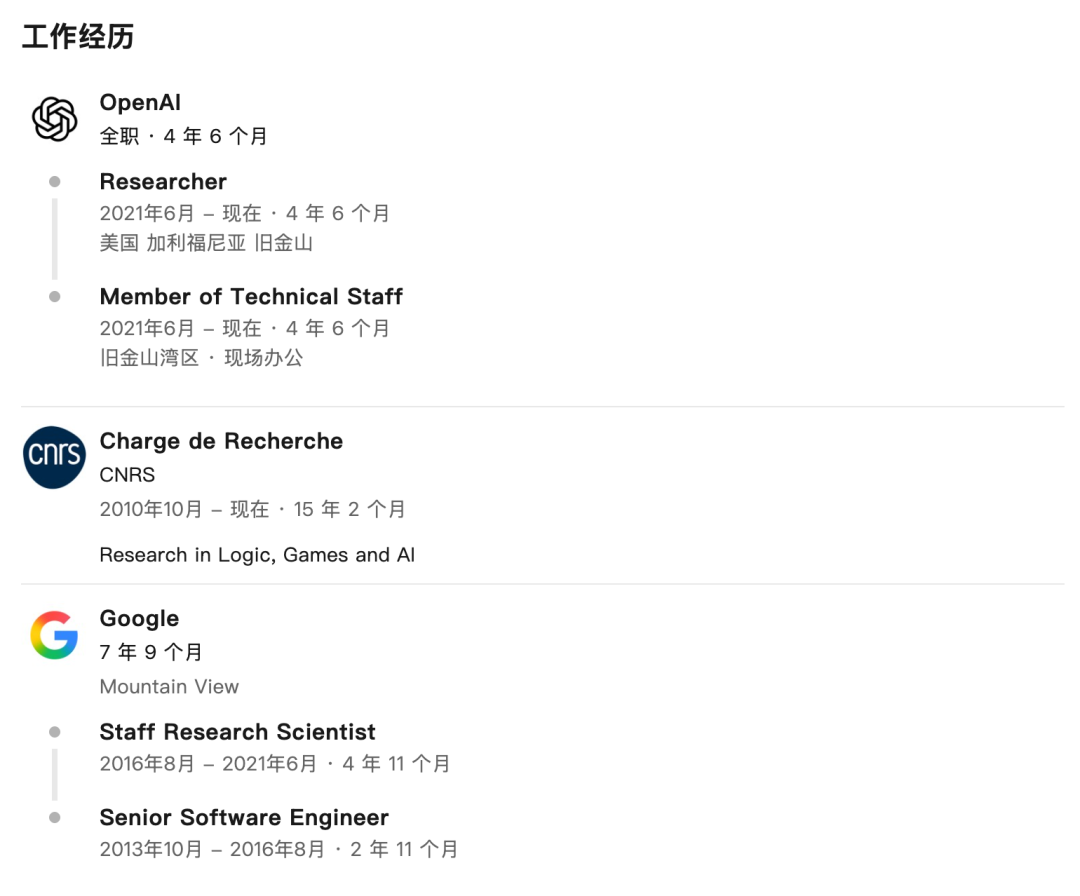
关于之所以离开谷歌,转投OpenAI,其中一个原因还是因为llya。

llya在谷歌时期就是Łukasz的直系领导,在创办OpenAI后也屡次邀请他加入。刚好这时,Łukasz也无法适应Google Brain的团队规模扩大以及远程工作氛围,于是一拍即合,来到了OpenAI。

OpenAI也没有让他失望,这里没有严格的组织架构,都是根据项目自发组队,也会根据项目进展灵活调整,直到项目成熟才会逐步扩大团队。

当然不同项目之间也会存在资源竞争,毕竟OpenAI内部GPU资源有限。

从技术层面看,预训练目前消耗的GPU资源最多,其次是强化学习和视频模型,资源分配在很大程度上还是由技术需求决定。

所以竞争不可避免,Łukasz本人也不例外。
四、下一次突破来自多模态推理+具身智能

最后,Łukasz聊了聊他眼中的AI未来。

AI会改变工作,但不会让工作消失。

因为从产品层面上看,即使AI自动化了绝大部分任务,但人类专家的需求仍然存在。

以翻译行业为例,其实Transformer论文最初的应用场景就是翻译,现在的模型也能准确翻译西班牙语、法语等语言,但对于报纸广告乃至ChatGPT UI界面,仍然需要人类译者进行二次审核。
这本质上是信任问题,即使模型能力再强,对于一些高风险、高关注度的场景,还是会倾向于依赖人类专家经验。

只是说,对于另外一些基础工作,可替代性会变高,后续也会出现相应的工作内容变化,但归根结底不会让人类无事可做。

Łukasz还预计,家用机器人可能会成为“下一次更为直观的AI革命”。
机器人技术的进展,取决于多模态能力和通用强化学习、通用推理的进步。一旦这些领域取得突破,机器人技术必将迎来爆发式增长。

目前已经有很多硅谷公司在相继推出智能手遥操作等硬件产品,硬件基础也将迅速成熟,届时将协同多模态和物理世界推理能力,实现家用机器人的能力跃迁。

这将会比ChatGPT更直观、更易感知。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

免费教你快速学会分析运算放大器电路(保证学会) 本文旨在学习如何快速简单地对运算放大器进行分析 阅读详情

相关推荐

VLA、世界模型与端到端在智驾中的本质关系与工程落地

世界模型并非3D重建,而是对环境状态转移函数的可微分建模;VLA不是视觉+语言+动作的简单拼接,核心在于跨模态语义对齐。二者共同支撑具身智能系统实现从感知到行动的闭环推演,其技术价值体现在长尾场景泛化能力提升与决策延迟降低。在自动驾驶领域,真实量产方案均采用VLA架构作为多模态感知基础,嵌入轻量级世界模型以支持反事实轨迹推演,并通过WA硬件封装保障实时性,最终由端到端控制层完成像素到扭矩的语义贯通。这种混合架构已成L2+/L3智驾系统的工程共识。

weixin_34163553的博客 366

GPT-Live 全双工语音 API Java 服务端落地实战:事件协议、会话恢复与生产踩坑

GPT-Live 把语音 Agent 的接入门槛从"搭三条流水线"降到了"写一个 WebSocket 状态机",但对 Java 后端的真实要求反而更高了:你要管长连接生命周期、事件顺序、退避重试、计费监控和会话恢复——这些恰恰是 Java 工程师在消息队列和 RPC 框架里练了二十年的基本功。配置在启动时锁死、流没有完成信号、轮次边界自己负责;业务状态与会话状态分离、并发按连接数规划。下一个十年,"数字员工"打的每一通电话,背后都得有一个扛得住生产环境的 Java 网关——这个活儿,就该我们干。

qq_36021478的博客 159

永磁同步电机矢量控制——电流内环前馈解耦策略

在采用永磁同步电机矢量控制时,ud和uq的指令值存在耦合项。需要对其进行解耦,目前,常用的解耦设计方法有前馈解耦、偏差解耦以及内模控制,本文主要分享电流内环前馈解耦控制策略。

a12312341ll的博客 8701

GPT-6.2 灰度的 3D 演示火了

在 GitHub 社区有部分 Claude Opus 5.5 用户抱怨复杂任务变慢、质量波动或更快耗尽额度。并展示了单个提示词生成的 Three.js 场景:浮空岛、瀑布、光照和昼夜变化,全塞进一个 HTML 文件里,没有外部素材。此前多用户反馈现在 GPT-6 降智了,如果本次消息属实,那 ChatGPT 用户的体验将会有很大的改善。为了不错过 GPT、Claude、Gemini、Grok 和 Apple 的重要更新与实用教程,请关注👆。欢迎在评论区留言你的想法,给他人启发。

hello99yum的博客 238

风控IV、AUC、KS python计算代码

df_temp:数据集,Y:是否逾期标签,feas_list:需要计算IV的 变量。2、 按月和不同Y 下的 IV计算。

暮雨听轩的专栏 1618

什么是论文的创新点?公式化描述算是创新点吗?

写科研论文时,挑战之一就是如何让你的工作“脱颖而出”,也就是要有创新性。不管实验多么精确、推导多么复杂,若没有真正的创新,论文很可能会被拒。关于如何创新问题上,我最近在看刘雪峰老师的《科技论文写作指南》,看到了很多关于写作的新论述,在这里和大家进行分享。

加百力 的技术博客 1928

百度 ERNIE Evolve 自动研究系统:NanoGPT 速通 38.9 秒,P800 推理速度达基线 623.6%

百度文心团队 11 月 9 日在技术博客发布《ERNIE Evolve:让自动研究走进真实 AI 研发》,介绍一套自动研究系统:给它一个真实代码仓库、一个优化目标和一套评测标准,它自己提出研究方向,在隔离环境里改代码、跑实验,靠独立评测决定哪些改动留下,再把每轮的发现存成后续可复用的经验。百度把这件事放在“递归自我迭代”(RSI)的框架里讲,也就是让自动研究去改进做 AI 研发的系统本身。 文章先在三项公开任务上检验它,分别对应训练算法、训练速度和 GPU 算子;随后把它接进还在开发中的 ERNIE 5.5

2601_95836219的博客 392

【服务器电源架构与关键技术发展趋势】AI数据中心迅猛发展,服务器电源如何演变?

功率级跃升:机柜功率从 100kW 向 1MW 级发展,供电架构采用 HVDC + 固态变压器(SST),省去传统 UPS、PFC 环节; 母线电压升级:从 48V 向 400V→800V 演进,配套 AI 电弧检测、智能运维解决高压安全与维护难题; 能效(PUE)提升:目标 PUE<1.3,通过液冷 CDU 替代传统风冷,可将 PUE 降至 1.16(传统 AI 集群 PUE 达 1.6); 拓扑控制复杂化:功率拓扑从单相→三相、单级→多交错结构,适配高功率需求; 安全维度扩展:新增网络安全防护需求。

昔时扬尘处 1451

GPT Image 2.6 编辑验收实战:保留项清单、接口骨架与排错流程

> 本文由 AceDataCloud 来源文章改编并经 AI 辅助整理。示例使用占位凭据;具体参数、计费、权限和区域可用性以当前模型目录与接口文档为准。 “接口返回了一张图”不等于编辑成功。对商品图和内容素材来说,真正困难的是判断:模型是否只改了该改的部分,原来已经正确的商品结构、文字和光影有没有被破坏。 ![纸面标注需要修改的位置](https://i-blog.csdnimg.cn/dir

jakeycis123的博客 256

深度学习技巧应用26-CNN中多种注意力机制的嵌入方法,终于搞懂注意力机制了

大家好,我是微学AI,今天给大家介绍一下深度学习技巧应用26-CNN中多种注意力机制的嵌入方法,终于搞懂注意力机制了。CNN是一种能够有效处理图像和其他二维数据的深度学习模型。在传统的CNN中,每个卷积核都会对输入的所有位置进行相同的操作,这可能导致网络无法针对特定区域或特征进行更加关注和重点处理。 注意力机制被引入卷积神经网络中,旨在使网络能够自动地学习和聚焦于输入中的重要区域或特征。通过引入注意力机制,可以增强网络对不同区域或特征的关注度,提取更有意义和相关的特征,从而提高模型的性能和表达能力。

微学AI的博客 3314

第四天 Labview交互也很轻松(4.1 DAQ数据采集)

LabVIEW DAQ数据采集有很大的优势,NI提供了超过5千万条I/O通道,支持多种主流总线(如USB、PCI、PCIe、PXI等),并为所有这些设备提供统一的编程接口,实现软硬件的无缝集成。LabVIEW包含全套范例,覆盖各类应用,用户无需从头创建整个数据采集系统,可以快速启动并执行这些范例程序。所有NI DAQ硬件都采用NI-DAQmx驱动程序,支持多种编程语言,并包含了这些编程语言的示例代码,使得与NI硬件的通信变得更加便捷。

weixin_38637405的博客 2618

Claude Fable 5.2 深度解析:全面领跑 GPT-6 Astra,降价 20% 下的性能突破与接入指南

2026 年 11 月 9 日,Anthropic 正式发布新一代旗舰推理模型。该模型与专供高密级科研机构的共用同一套底层权重,定位为面向全量开发者与企业用户的通用旗舰版本。Fable 5.2 在以及三大维度实现了系统性代际跃升。在权威综合评测 AA Intelligence Index v5 中,Fable 5.2 以 65 分登顶总榜,并在曾被视为推理天花板的 ARC-AGI 3 测试中创下 81% 的新纪录;

2609_96793082的博客 394

图像拼接(Image Stitching)

图像拼接(Image Stitching):是一项计算机视觉技术,它将多张重叠的图像合并为一张更大、无缝的全景图或广角视图。该技术广泛应用于全景摄影、地图制作、医学影像处理、计算机视觉及增强现实(AR)等领域。

📷 图像处理践行者 | 传统算法 · 深度学习 · 多模态 | 分享实战经验与技术洞见,探索从像素到智能的无限可能。 2506

智能体的模型列表为什么要从三处来源合成:一次让 GPT-6.1 Sol 选不上的发布延迟

原文:OpenClaw Blog - 《Use new models in OpenClaw without an update》(https://openclaw.ai/blog/use-new-models-in-openclaw-without-an-update)

2401_88139521的博客 337

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

GPT Image 2.6 商品图局部编辑:文字、markup 标注与 mask 蒙版怎么选

GPT Image 2.6 给商品图换了三次背景,最终看上去更精致,瓶盖却变宽了,标签位置也偏了。需求原本只是“做一张秋季促销图”,结果变成重新核对整个包装。对需要持续改版的电商团队来说,精准编辑的价值不是一次生成有多惊艳,而是已经确认的产品细节能否尽量留下来。 本文以“同一瓶商品,分别制作日常、节日、移动端素材”为例,介绍一套母版分支编辑方法:先固定唯一基准,再把每种变化拆开,最后用差异记录决

JonaHu的博客 184

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

GPT-5.5 报 429 insufficient_quota 怎么办?为什么加退避还是失败

上周五晚上 10 点多,我给一个代码服务接入 GPT-5.5,看到 429 就顺手加了指数退避。折腾半天,日志反而刷得更凶。GPT-5.5 返回时,业务代码通常不应继续短周期自动重试。这个错误一般与账单、可用额度、API Key 归属或账户状态有关。短期等待和指数退避通常不能解决;应先修复账单或额度状态,再用单次最小请求验证。在本文讨论的两类 OpenAI 错误中,通常适合有限退避;其他 429 应结合错误体、等响应头以及请求是否幂等来判断,不能只看 HTTP 状态码。

ofoxcoding的博客 235

GPT-6 Luna 批量处理实战指南

本文聚焦企业级数据处理中的“甜蜜的负担”,分享利用大语言模型在本地或私有云环境中构建高效、可控的数据流水线的十大实战场景。涵盖数据清洗、多语言翻译、智能分类、文案优化、习题解析、A/B测试、合同初审、代码重构、舆情分析及成本管控,通过提示词工程与流程编排,实现千万级数据的快速高质量处理,显著降本增效,保障安全合规,助力AI真正成为可落地的生产力工具。

聚焦具身智能产业前沿,分享深度行业洞察、技术趋势与产业落地思考。 85

无人配送车通信架构解析:双5G、1000BASE-T1与TSN/gPTP时间同步

从车载网络架构出发,分析无人配送车中的双5G通信、1000BASE-T1千兆车载以太网、TSN/gPTP时间同步及多链路通信机制,并介绍SV920网联域控制器的应用。

starelink的博客 293

GPT-6.1 Terra是什么?gpt-6.1-terra API实测:视觉理解、电脑操作、写作与JSON输出

GPT-6.1 Terra把视觉理解、界面操作、写作和结构化输出放在同一个快速模型中。它能读懂截图里的文字与控件位置,能把界面任务拆成带校验的动作序列,也能按要求生成文案并输出固定格式的数据。对于内容、运营和自动化类应用,它是值得优先评估的一档;复杂编程和高风险的端到端执行,则应与GPT-6.1 Sol或GPT-6 Astra对照后再决定。

2601_96207100的博客 466

gpt-image-2.6双子星实测:flare快2倍,sunburst慢在精修

*还有一个反直觉的发现:quality=low(13.4s)并不比 quality=high(11.8s)快——画质档位影响的主要是输出 token 数(low 903、high 1674),而不是时间。既然价格一样,选型就只剩两个问题:**差多快,差多少精。一句话版本:**flare 管"多和快",sunburst 管"好和细",价格一样,按等待容忍度选。sunburst 输出(36.5s):文字同样全对,还额外把"二维码占位框"五个字标注了上去,元素更丰富(购物车、礼盒、百分比标签)

ttbobocom的博客 538

gpt-image-2.6-sunburst + Cline + Cherry Studio API 配置:尺寸、格式与任务轮询一篇就够

11 月 11 日,我给一个海报生成器补图片接口,折腾半天才发现:代码没坏,是我把创建接口返回的任务 ID 当成了图片地址。现有公开资料没有可交叉验证的尺寸、格式、任务端点和价格说明,具体能力应以服务商文档及当前账号的实际响应为准。在多服务商场景中,直连端点与 OpenRouter、Together AI、ofox.io 等聚合网关/中转方案的主要差异,应通过。工具是否支持图片专用端点、异步任务、轮询和结果展示,是另一回事。把模型可见性、创建请求、任务状态、图片结果和文件下载拆开,每层单独验证。

2601_95893075的博客 163

权重量化的实现:从absmax到GPTQ与AWQ

本文系统梳理了大模型权重量化从基础到高级的完整技术路径,涵盖从简单的absmax量化到GPTQ、AWQ等感知激活的先进方法。通过代码实现与误差分析,揭示了量化粒度(如per-channel、per-group)、非均匀格点(NF4)及激活感知机制对精度的关键影响。重点对比了GPTQ的二阶误差补偿与AWQ的轻量敏感列保护策略,并强调量化选型需以精度预算为先,结合反量化开销与kernel融合优化,方能真正释放显存杠杆。

2601_96733043的博客 368

Linux入门第二部分(ARM裸机篇) 第十三章 GPT定时器

本文基于正点原子I.MX6U开发板,介绍GPT定时器的工作原理与高精度延时实现。GPT为32位向上计数器,支持12位分频、输入捕获、输出比较及溢出中断,可配置为restart或free-run模式。通过设置ipg_clk(66MHz)并分频至1MHz,实现1μs精度延时。编写delay_init、delayus和delay函数,利用GPT1实现精确微秒级阻塞延时,最终在main函数中实现LED每500ms翻转一次,验证了高精度延时的可行性。

Zevalin的博客 189

GPTIMER通用定时器

ESP32S3包含两个定时器组每一组都有两个通用定时器和一个主系统看门狗定时器。

智能机器人产学研基地 67

Meta发布小模型Muse Ember,智能体基准多项超GPT-6与Claude Haiku 5.5

Meta推出小型高效模型Muse Ember,在多项智能体(Agent)基准测试中得分超过GPT-6 Luna和Claude Haiku 5.5,官方数据显示其输出token更少、响应更快,已在Muse Code和Meta Model API上线。

wfly blog 234

用上 Gemini 4 Carbon:比 GPT-6 Astra 还强

花 420 块开 Ultra,原本惦记的是里面的 Claude。结果 Claude 额度不太够折腾,反而是 Carbon 把活扛起来了,这会员开得还挺值。就是回头看前阵子的操作有点好笑:Argon 只有 50 分的时候拿它疯狂写代码,换上 60 分的 Carbon 之后,又拿 57 分的 Astra 去审它。两个都用错了场景,不会只有我一个人这样吧。我是良逍,最近主要在折腾 AI 产品、独立开发和出海工具,平时会记录自己实测过的工具、踩过的坑和产品上线的过程。

良逍Ai出海 167

FastGPT 接入 glm-5.3 通用排障指南:模型 ID、参数透传与超时检查(版本范围说明)

不同 FastGPT 和 AI Proxy 版本的菜单位置及功能可能不同,常见入口包括“模型配置”“模型供应商”或“AI Provider”。如果部署中存在独立 AI Proxy,应在真正负责发送上游请求的服务中完成配置。只修改前端显示名称,不会自动改变后端请求使用的 model ID。配置项示例注意事项接口类型OpenAI 兼容接口上游需支持对应协议Base URLhttps://服务商地址/v1最终地址以请求日志为准API Key实际密钥不要暴露在前端公开变量中Model。

weixin_46591161的博客 221
上一篇: 让每一分广告费都花在刀刃上!对话布尔向量,看视频营销Agent如何为ROI兜底!
下一篇: 当AI开始“审判”AI:21%的ICLR 2026评审纯AI生成,深度剖析学术圈的“效率陷阱”!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值