LoRA:大模型轻量化微调技术,从入门到精通

[论文阅读笔记77]LoRA:Low-Rank Adaptation of Large Language Models 从效果来看,不论预训练模型的大小,LoRA采用更少的参数,可以达到全参模型的更好的效果。 阅读详情

Lora: Low-rank adaptation of large language models,作为LLM领域的的‘古早’论文, 发表于机器学习顶会 ICLR 2022, 至今已经有20988 引用,对LLM微调部署产生了深远影响。

大模型时代的适配困境

在人工智能的浪潮中,大语言模型(Large Language Models, LLMs) 已成为推动自然语言处理(NLP)进步的核心动力。 从 BERT 到 GPT-3,再到当下的多模态模型,模型规模呈指数级增长。 然而,随着参数量达到百亿甚至千亿级别,传统的全参数微调(Full Fine-tuning) 已逐渐暴露出不可忽视的弊端。

以 GPT-3 为例,模型参数高达 1750 亿个。 如果我们希望在不同下游任务(如问答、摘要、SQL 生成等)中部署专属微调版本,就需要为每个任务存储和更新同样庞大的参数集。 这意味着:

  • 每个模型副本都要占据数百 GB 显存;
  • 不同任务间切换需要重新加载整个模型;
  • 算力与存储成本成倍增加,几乎无法大规模部署。

LoRA(Low-Rank Adaptation) 的提出正是为了解决这一根本问题。 它以一种简单但极具启发性的方式,实现了参数高效(Parameter-efficient) 的大模型微调。 LoRA 不仅显著降低了训练和存储开销,还在多个任务中超越了传统的全参数微调性能,成为当前主流的参数高效适配方法之一。

一、LoRA 的核心理念:低秩更新

LoRA 的核心思想源自一个重要观察:

在下游任务微调过程中,模型参数的变化其实具有低秩结构(Low-Rank Structure)。

换句话说,大模型在预训练阶段已经学习到丰富的语义空间; 在适配新任务时,我们只需要对部分方向上的权重进行细微调整,而不必重新更新整个高维参数矩阵。

LoRA 将这一思想形式化为以下权重更新方式:

W = W₀ + ΔW = W₀ + B A

其中:

  • W₀:预训练权重矩阵(被冻结)
  • ΔW:微调时的参数变化
  • A ∈ ℝ^{r×k}、B ∈ ℝ^{d×r}:可训练的低秩矩阵
  • r:秩(rank),通常远小于模型维度(例如 r=4 或 8)

通过这种分解,LoRA 仅需训练 A 和 B,而非整个 W₀。 训练过程中,LoRA 对输入向量 x 的前向传播为:

h = W₀ x + B A x

起始时,A 服从高斯分布初始化,B 初始化为零,使得 ΔW = 0。 整个模型在训练开始时与原始模型等价,随后逐步学习下游任务所需的细微方向调整。

二、低秩微调的物理含义

LoRA 背后的理论直觉非常优雅:

  • 预训练模型的参数空间维度虽然极高,但有用的特征变化集中在少数几个方向。
  • 任务适配对应的是在这些“有效维度”上进行低秩扰动。

这种“低秩更新”思想可追溯到信号处理与矩阵分解理论,即复杂系统的变化往往可以由少量基向量(basis)刻画。 因此,LoRA 实质上是在模型空间中寻找一个低维子空间,使得在该子空间上的更新足以捕捉任务特征。

三、LoRA 的实际设计与实现

在 Transformer 架构中,LoRA 可以应用于多个关键位置的权重矩阵,尤其是自注意力层中的:

  • 查询矩阵 ( W_q )
  • 键矩阵 ( W_k )
  • 值矩阵 ( W_v )
  • 输出矩阵 ( W_o )

实验表明,将 LoRA 应用于 ( W_q ) 与 ( W_v ) 组合时表现最佳: 它能在参数最少的前提下实现最优性能。

LoRA 的部署过程具有极高的工程便利性:

  • 训练时冻结预训练模型,仅优化低秩矩阵 A 与 B;
  • 推理时可将 ( B A ) 与 ( W_0 ) 合并为完整权重矩阵,不增加任何额外延迟;
  • 在任务切换时,仅需加载数 MB 级别的 LoRA 模块即可完成“即时切换”。

这种模块化特性让 LoRA 成为多任务系统与个性化 AI 的理想解决方案。

四、实验结果:性能与效率双丰收

LoRA 在多个主流模型与任务上进行了系统验证,包括 RoBERTa、DeBERTa、GPT-2、GPT-3。

模型微调方法可训练参数比例性能表现
RoBERTa-LargeLoRA0.2%与全量微调持平
DeBERTa-XXLLoRA0.3%略优于 Fine-tuning
GPT-2 / GPT-3LoRA0.01%超过多种 Adapter 与 Prefix 方法

在 GPT-3 175B 上,LoRA 仅需 470 万个参数(约占原模型 0.003%),显存占用从 1.2 TB 降至 350 GB。 在 WikiSQL、MNLI、SAMSum 等任务上,LoRA 的性能不仅与全微调持平,甚至略有超越。

当秩 r = 1 时,LoRA 仍能保持接近完整模型的精度。这强烈说明:语言模型在适配任务时,其权重变化的“本质自由度”极低。

LoRA 的应用与影响

自论文发表以来,LoRA 已成为当前 AI 工程实践中最常用的轻量化适配技术之一。 它的出现彻底改变了大模型微调的范式:

  • 科研层面:使学术研究者能在有限算力下探索超大模型的能力;
  • 产业层面:让企业能够在主模型不变的前提下快速部署多任务版本;
  • 工具生态:HuggingFace、PEFT、Diffusers 等主流框架均原生支持 LoRA;
  • 扩展应用:LoRA 思想已扩展至多模态模型、语音识别、图像生成与强化学习等领域。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。
在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
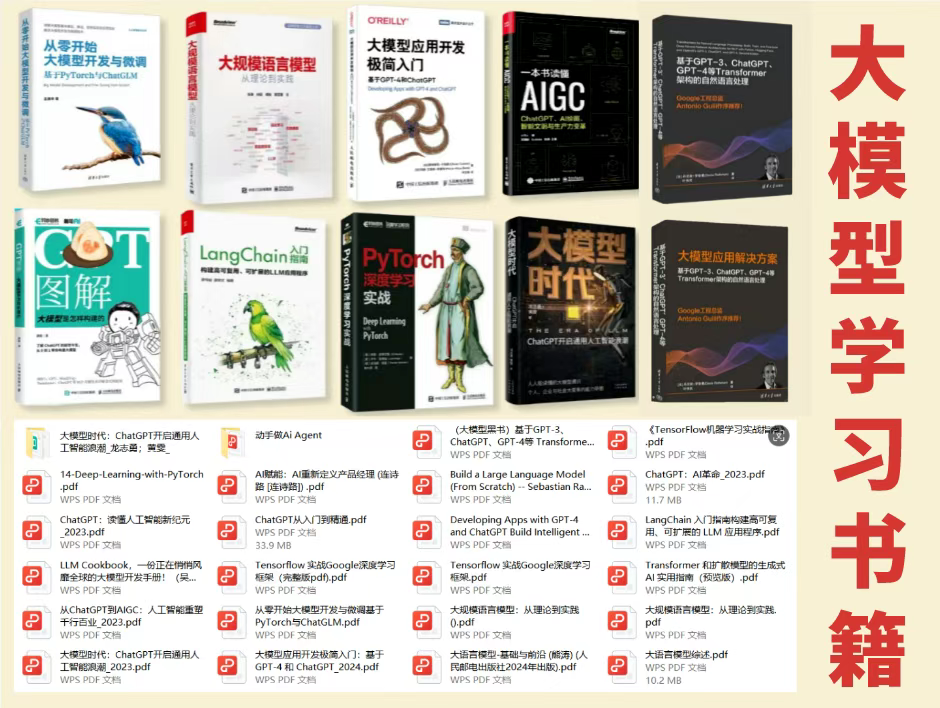
在这里插入图片描述

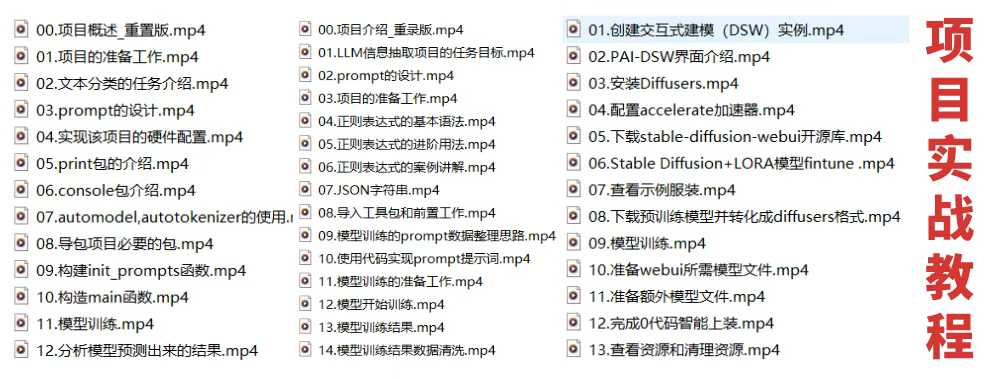
配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

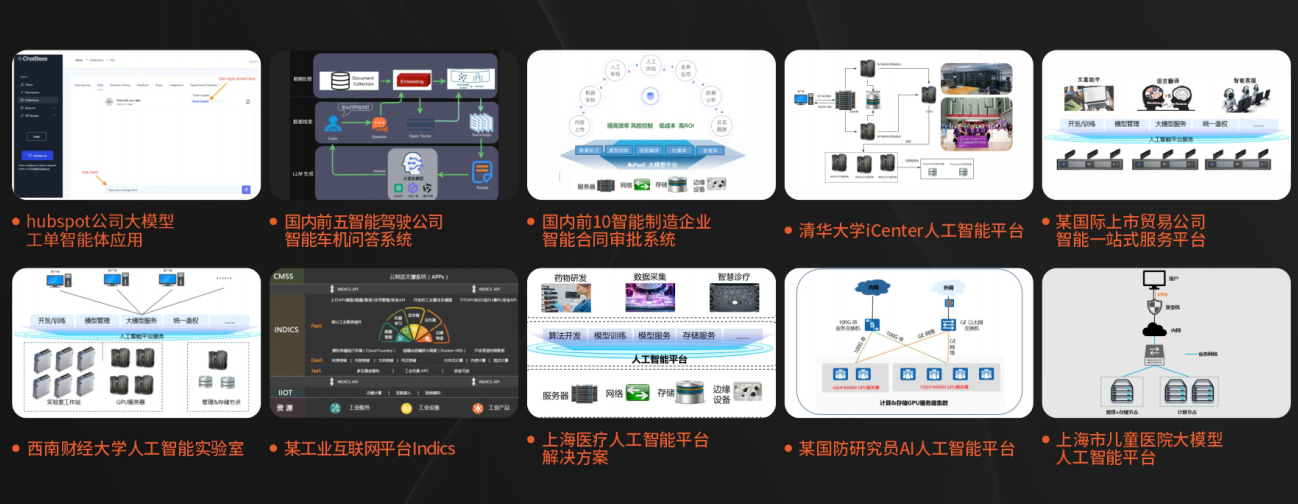
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
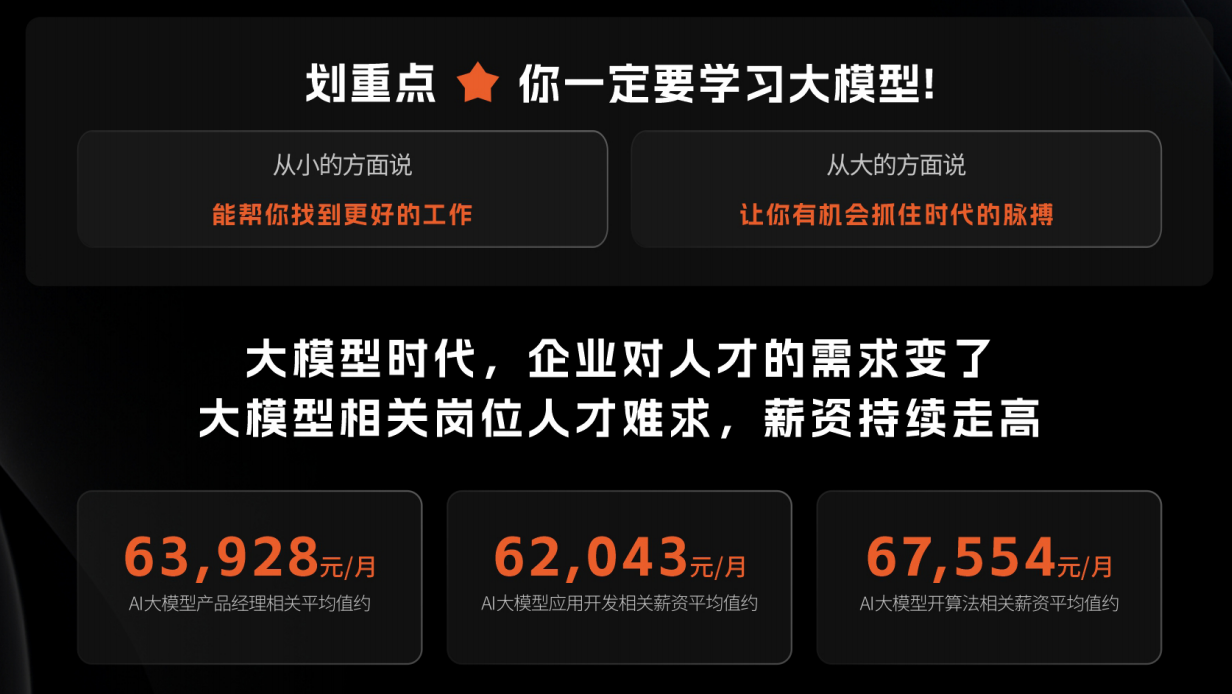
在这里插入图片描述

适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

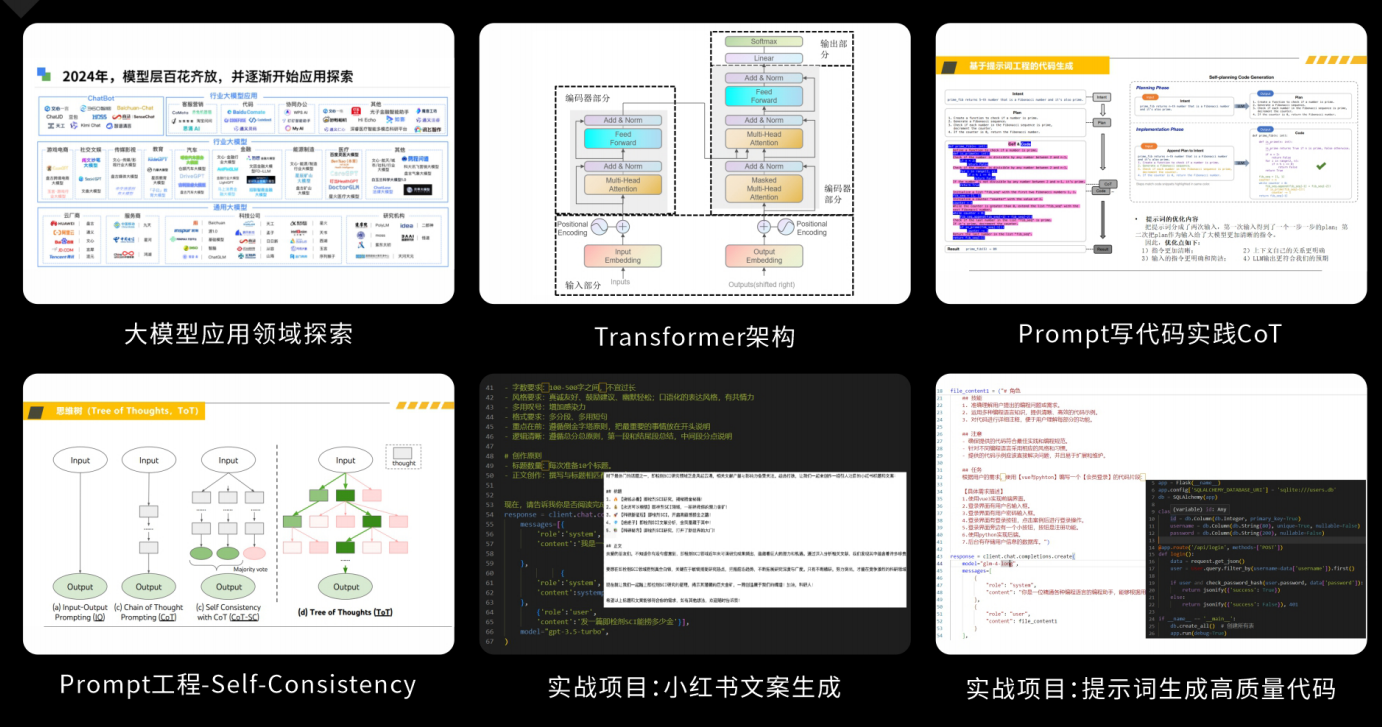
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
在这里插入图片描述
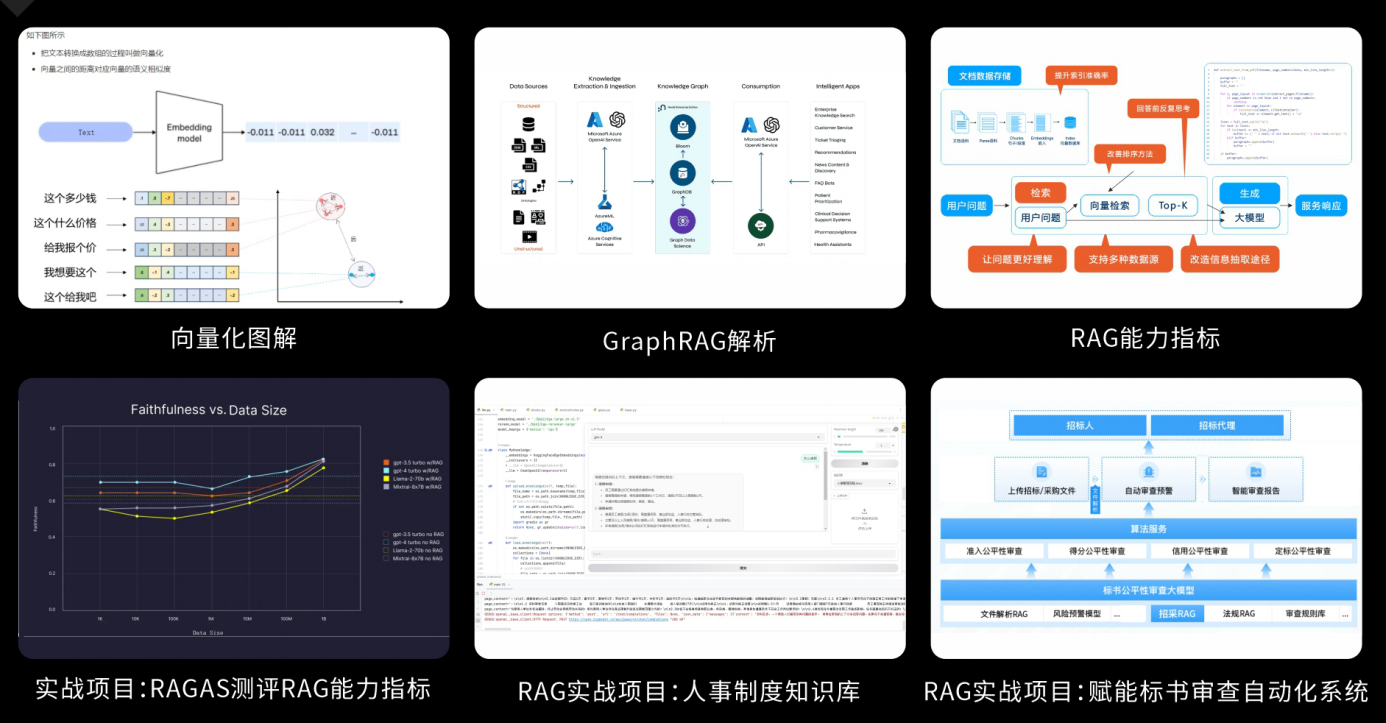
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述
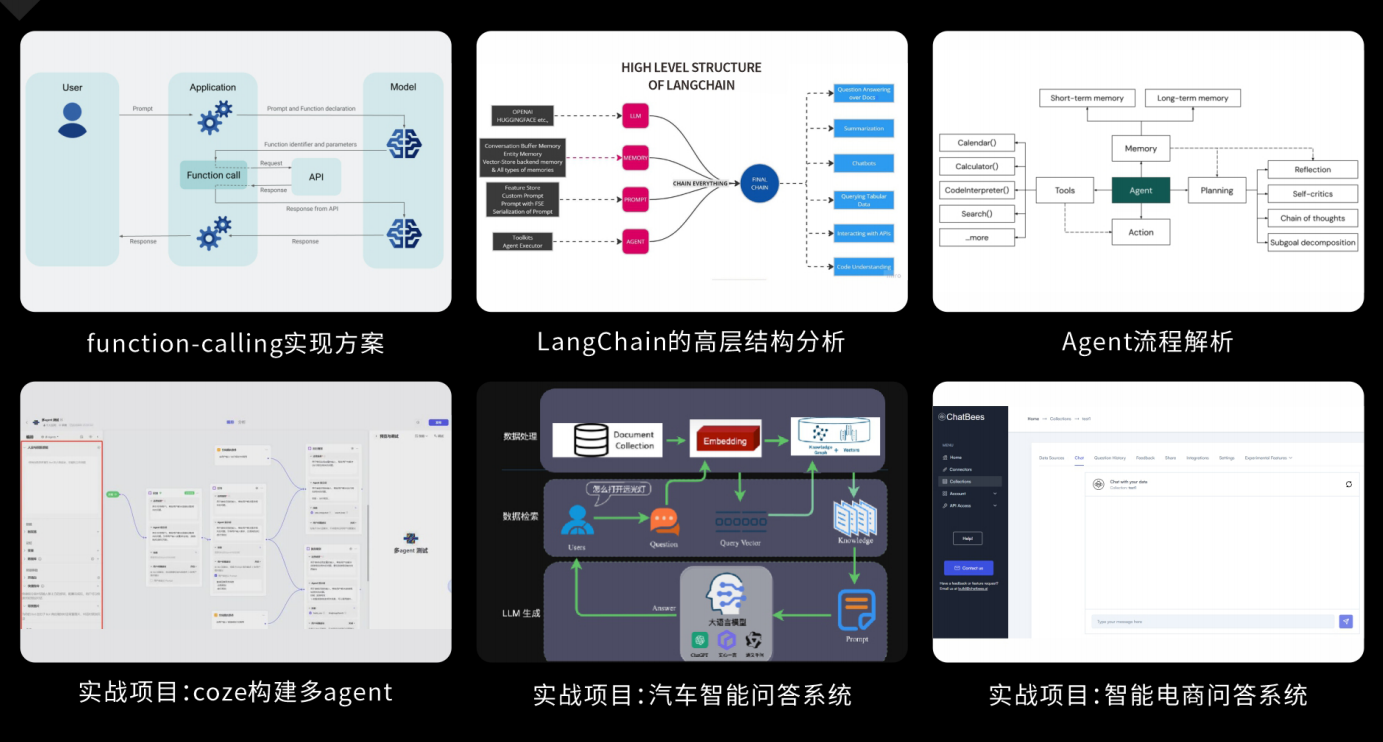
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
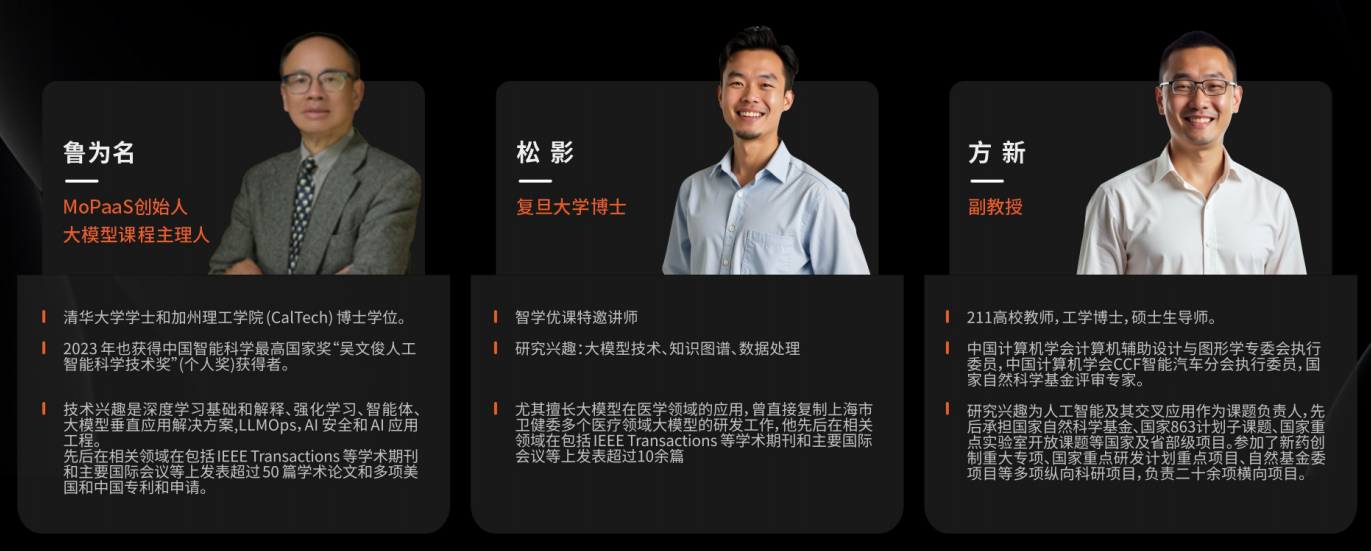
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

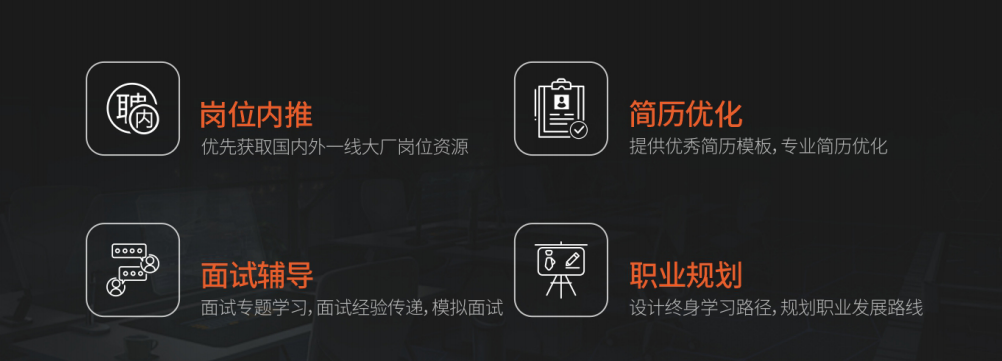
一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调 在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位

在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

LoRA 微调技术详解:参数高效的大模型轻量化适配方案 LoRA 微调技术作为一种参数高效的大模型轻量化适配方案,通过低秩分解的方法,在保持模型性能的同时,显著减少了可训练参数的数量,降低了计算成本和存储需求。它具有广泛的应用场景,在自然语言处理、计算机视觉、跨模态任务等领域都展现出了良好的效果,为大模型的实际应用提供了有力的支持。 阅读详情

相关推荐

AIGC模型轻量化训练:LoRA微调技术详解

随着GPT-4、Stable Diffusion等AIGC模型的快速发展,模型参数规模呈现指数级增长(如GPT-3拥有1750亿参数)。传统全量微调(Fine-Tuning)需要更新模型所有参数,导致显存占用大、训练时间长、硬件成本高昂。LoRA技术通过对预训练模型权重矩阵进行低秩近似,仅更新少量新增参数,在保持性能的同时将微调成本降低2-3个数量级。本文将系统解析LoRA的核心原理、数学推导、代码实现及实战应用,适用于希望优化大模型训练效率的AI开发者、算法工程师及研究人员。背景介绍。

AI天才研究院 1391

(ICLR-2022)LoRA:大型语言模型的低秩自适应

自然语言处理的主导范式包括对通用领域数据进行大规模预训练,并适应特定任务或领域。随着我们对更大的模型进行预训练,传统的微调(重新训练所有模型参数)变得不那么可行。以 GPT-3 175B 为例,部署许多独立的微调模型实例(每个实例有 175B 个参数)的成本极其高昂。我们提出了低秩自适应(LoRA),它冻结预训练的模型权重,并将可训练的秩分解矩阵注入 Transformer 架构的每一层,大大减少下游任务的可训练参数数量。

顾道长生的科研笔记 2143

大模型LoRA微调技术:原理、优势与应用实践

在众多大模型微调技术中,LoRA(Low-Rank Adaptation,低秩自适应)因其高效性和实用性脱颖而出。LoRA技术的出现完美解决了这些痛点。LoRA基于一个关键洞察:**大模型适配新任务时,参数变化矩阵ΔW具有低秩特性**。- **显存需求**:如GPT-3(1750亿参数)微调需要超过1TB显存。- **推荐LoRA**:计算资源有限、需要快速迭代、多任务场景。- **推荐全量微调**:数据量充足、计算资源丰富、性能要求极致。| 全参数微调 | 175B | 1.2TB | 89.2 |

qq_41804746的博客 893

LORA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS

自然语言处理的一个重要范式是在通用领域数据上进行大规模预训练,然后根据特定任务或领域进行适应性训练。随着我们对模型进行更大规模的预训练,完全微调(重新训练所有模型参数)变得越来越不可行。以GPT-3 175B为例,部署独立的微调模型实例,每个实例有175B个参数,成本过高。我们提出了低秩适应(Low-Rank Adaptation,LoRA)方法,该方法冻结预训练模型的权重,并将可训练的秩分解矩阵注入到Transformer架构的每个层中,从而大大减少了下游任务的可训练参数数量。

qq_43800752的博客 3568

影刀rpa的使用一--读取excel表格数据并循环出每一项

1、全部展示2、运行结果展示之后可以按照各自的需求对excel中取出的数据进行处理。

qq_69268437的博客 1万+

Python之美——Python2与Python3多版本共存

Python多版本共存的方法Python2、Python3共存的方法python2下载及环境变量配置第一步、打开Python官网,下载Python2第二步、python2环境变量配置测试结果 Python2、Python3共存的方法 方法如下: 1.先确保不同版本解释器的python.exe所在的路径在环境变量中 2.拷贝各自的python.exe并重命名即可 步骤(理解不了下面有图示): 1、首先你需要将不同的python版本安装,且都已经将跟版本的环境变量配置好了,python3和2的下载方式

chenchen5152的博客 3946

【LLM大模型】大模型高效微调-LoRA原理详解和训练过程深入分析

LoRA与训练目标是解耦的,但本文设定就是语言模型建模。以下将给出语言建模(可自然推广到序列建模)的基本符号定义,即最大化给定提示的条件概率(本质是极大似然估计)。给定一个参数为ΦΦ预训练的自回归语言模型PΦ(y|x)PΦ(y|x)。xx为输入,yy为输出note: 为与原文符号一致,下文ΦΦ、ΘΘ、WW均表示模型参数全参数微调每次full fine-tuning训练,学一个 ΔΦΔΦ,|ΔΦ||ΔΦ| 参数量大hold不住语言模型的条件概率分布建模目标高效微调。

二狗的博客 1739

Mac OS X 工具技巧:一文搞定个性化命令行窗口(iTerm2 + zsh + oh-my-zsh 配置Powerline风格)

本不想写这篇文章的,因为在Linux下已经配置过很多次,想着mac应该找篇文章一次就搞定了,结果还是踩坑,看了很多文章,不是某一点没不清楚,就是截图有问题或者命令有问题,官网又难得找等等……花了3个多小时才搞定,所以,还是来总结一篇文章就能够搞定的教程。 为什么要用zsh?用了这么多年的bash,不能说bash不好,不过当我用了zsh后发现,什么叫更好用。 配置过程稍微有点繁琐,但是你看过效果...

mickjoust的技术小屋 1万+

【论文笔记】LoRA LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS

随着模型越来越大,全量微调变得越来越不可行。作者提出了低秩适配器(LoRA),它冻结了预训练的模型权重,并将可训练的秩分解矩阵注入到 Transformer 架构的每一层中,大大减少了下游任务的可训练参数的数量。在GPT-3 175B使用Adam上,与全量微调相比,LoRA减少了10,000倍参数量,减少了3倍GPU内存消耗。🧐与Adapter相比,没有额外的推理延迟下面是对语言建模问题的简要描述,特别是在给定特定任务提示的情况下条件概率的最大化。

Yulki的博客 3344

WIFI CSI动作识别数据集全解析:从数据采集到深度学习应用

本文全面解析了利用商用Wi-Fi设备的信道状态信息进行动作识别的完整流程。文章以经典WiSA数据集为例,深入剖析了CSI数据的采集原理、结构特点,并详细阐述了从原始数据预处理、特征工程到深度学习模型(如CNN-LSTM融合架构)构建与优化的关键技术,旨在为研究者提供从数据到应用的全链路实战指南。

r2s3t4的博客 281

国民技术N32G45X SysTick定时器实战:从1us到100ms的精准延迟实现(附完整代码)

本文详细解析了国民技术N32G45X芯片中SysTick定时器的工作原理,并提供了从1微秒到100毫秒的高精度延迟实现方案。通过对比官方库函数的局限性,文章重点介绍了无中断查询模式、时钟源选择策略以及完整的代码实现,帮助嵌入式开发者精准控制时序,适用于LED控制、软件模拟通信协议等多种实战场景。

weixin_29190573的博客 378

LoRA技术深度解析:从原理到实战的大模型轻量化微调指南

LoRA通过**“冻结基座+训练低秩插件”的创新设计,将大模型微调的参数量从亿级降至万级**,显存需求从数百GB降至个位数GB,适配器存储从数GB降至几MB。它用极低的成本撬动了接近全量微调的效果,让大模型定制化从“巨头专属”走向“人人可用”。对于绝大多数实际应用场景,LoRA是当前性价比最高的微调方案。底部锚点⬆ ⬆ 顶部 ⬆ ⬆⬇ ⬇ 底部 ⬇ ⬇⬆ ⬆ 顶部 ⬆ ⬆。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 1275

9 硬件工程师笔面试高频知识考点真题解析——运算放大器

运算放大器(运放)摘要 运放是一种高增益、差分输入的模拟集成电路,具有虚短(线性区输入电压相等)和虚断(输入电流为零)特性,支持负反馈(线性放大)和开环/正反馈(饱和区比较)两种工作模式。关键特性包括高输入阻抗、低输出阻抗,理想运放参数(如无限增益)与实际参数(如有限带宽)的差异。 选型要点: 信号特性:直流/低频信号关注失调电压(Vos)、温漂;高频信号侧重带宽(GBW)和压摆率(SR)。 电源条件:单/双电源供电、电压范围及功耗需求(如电池设备需低静态电流)。 精度与噪声:微弱信号需低噪声运放,高精度场

XU157303764的博客 1678

一文读懂大模型微调:从 LoRA 到 QLoRA 再到全量微调的核心差异

一文读懂大模型微调:从 LoRA 到 QLoRA 再到全量微调的核心差异

xxue345678的博客 1256

绘制Winform动态折线图,LiveCharts如何打造数据可视化神器?

在C# Winform应用程序中,使用LiveCharts库来创建动态、美观的折线图不仅能够提升用户体验,还能直观展示数据趋势。下面,我们将通过一个详尽的示例,展示如何在Winform项目中集成LiveCharts并绘制折线图。:在Visual Studio中,选择“文件” > “新建” > “项目”,然后选择“Windows Forms 应用(.NET)”模板。LiveCharts的强大之处在于其高度的可定制性,你可以根据需求调整颜色、动画效果、交互方式等,让图表更加符合你的应用需求。

java专栏 1683

开发具有情感分析能力的AI Agent

本文将深入探讨开发具有情感分析能力的AI Agent的各个方面。我们将首先介绍情感分析的基础知识,包括定义、背景和应用领域。接着,我们将详细讲解情感分析的核心概念、数据处理方法和算法原理。随后,文章将展示如何设计情感分析系统架构,并进行项目实战,包括环境安装、源代码实现和案例分析。最后,我们将总结最佳实践和注意事项,为读者提供进一步学习的资源。情感分析(Sentiment Analysis),也称为意见挖掘,是自然语言处理(NLP)的一个分支。

SuperAGI2025 1146

LoRA原理与实战:从入门到精通大模型微调技术!

文章介绍了LoRA(低秩适配)技术,这是一种高效微调大型语言模型的方法。LoRA通过在原始模型旁添加两个低秩矩阵,只更新少量参数(约0.01%-1%),而非全部参数,从而显著降低计算和存储成本。该方法训练速度快,部署灵活,可像插件一样插拔,适用于领域适配、多任务学习和个性化定制等多种场景,效果接近全参数微调,特别适合资源有限或需要快速适应的场景。

2401_85325557的博客 855

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

大模型轻量化微调技术原理与实战实现

摘要: 轻量化微调技术(如LoRA)通过仅更新大模型部分参数,显著降低计算资源需求,使中小设备也能实现定制化AI模型。本文概述了轻量化微调的核心目标与技术定位,重点解析LoRA的低秩矩阵原理及其优势(参数量减少90%以上)。以医疗问答场景为例,展示了在MacBook Pro上微调LLaMA-7B的完整流程,包括环境配置、数据预处理、训练与推理实现,为资源受限场景提供了可行方案。 关键词: 轻量化微调、LoRA、大模型、低秩适应、LLaMA

没事学AI的博客 1259

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【建议收藏】大模型微调技术全解析:全量微调与LoRa微调如何选择?

【建议收藏】大模型微调技术全解析:全量微调与LoRa微调如何选择?

kaka0722ww的博客 1411

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

大模型微调实战:LORA微调

是一种高效的参数高效微调方法,其核心思想是通过在预训练模型的权重矩阵中引入低秩适配矩阵(低秩分解矩阵 A 和 B),仅对这部分新增参数进行训练,从而大幅减少计算和显存开销。与传统全参数微调相比,LORA 通过冻结原始模型参数,仅更新适配层参数,实现了轻量化训练。在涉及到矩阵相乘的模块,在原始的PLM旁边增加一个新的通路,通过前后两个矩阵A,B相乘,第一个矩阵A负责降维,第二个矩阵B负责升维,中间层维度为r,从而来模拟所谓的本征秩(intrinsic rank)。

aolan123的博客 1883

大模型微调Fine-Tuning(二)核心技术解析:LoRA、Prefix Tuning、量化微调(QLoRA)

随着大模型的参数规模持续攀升,传统的全量微调(Full Fine-tuning)面临显存占用高、计算成本大、部署维护复杂等难题,为了解决这一瓶颈,研究者提出了多种轻量化微调技术,如LoRA、Prefix Tuning、QLoRA等,它们在保留模型性能的同时,大幅降低了资源消耗,成为企业和开发者实现多任务、高效部署的重要手段。在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。,以动态、形象的方式展示技术概念,

老皮的博客 1873

LoRA技术详解,让你的大模型轻量化快速精通新技能

LoRA技术以其“四两拨千斤”的哲学,极大地降低了大模型个性化的门槛。

m0_64363449的博客 905

大模型微调必学:LoRA系列方法全解析,从入门到精通

本文详细介绍了三种大模型参数高效微调技术:LoRA通过低秩矩阵分解减少可训练参数;AdaLoRA动态调整矩阵秩,优化参数分配;QLoRA结合LoRA与4位量化技术,显著降低内存消耗。文章对比分析了这些方法的技术原理、性能表现、资源效率及适用场景,并提供了Qwen模型的LoRA微调代码示例,为开发者选择适合自身需求的微调方案提供了全面指导。

2401_85375186的博客 1769

【AIGC】俗解读大模型微调(Fine Tuning),包括全量微调和轻量化微调

开始之前,为了方便大家理解,我们先对大模型做一个直观的抽象。本质上,现在的大模型要解决的问题,就是一个序列数据转换的问题:输入序列Xx1x2xmXx1​x2​...xm​, 输出序列Yy1y2ynYy1​y2​yn​XXX和YYYYWXY = WXYWX。我们所说的“大模型”这个词:“大”是指用于训练模型的参数非常多,多达千亿、万亿;而“模型”指的就是上述公式中的矩阵WWW。

Code_LT的博客 9913

大模型微调全攻略:从全量到轻量化

本文系统介绍大模型微调技术演进,从全量微调到轻量化方法(LoRA、Prefix Tuning等)。分析各策略原理、优缺点及适用场景,提供分布式训练、混合精度等工程实践,并通过案例展示LoRA在降低成本同时保持性能的效果,为开发者提供完整技术选型与系统设计参考。

2301_82275412的博客 1019

DeepSeek大模型微调实战:从入门到精通的完整指南

文章详解DeepSeek大模型微调技术(LoRA/QLoRA轻量化方法)、部署方案(本地化/云服务)与性能优化、类GPT工具使用范式(提示工程/RAG/工具链集成),以及数据隐私与成本优化策略。通过微调使大模型适配垂直领域,降低资源消耗并保持泛化性;部署阶段关注推理加速与内存管理;使用环节结合提示工程和RAG提升输出质量;最后平衡数据合规与成本效益。

m0_65555479的博客 1052
上一篇: Agent开发从入门到精通,两周就够了!收藏这篇保姆级教程就够了!
下一篇: 程序员必学:大模型问答系统的向量数据库应用指南(超详细教程,建议收藏)
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值