生命科学的“神级”工程!百图生科如何搭建50亿蛋白质的AI搜索引擎?一篇看懂!

贺福初院士等:首个10亿级、AI就绪的蛋白质组学数据门户 人工智能(AI)正在重塑蛋白质组学分析流程,在肽段鉴定灵敏度与定量性能上均实现显著提升。然而,受限于大规模、高质量、标注统一的数据集匮乏,深度学习模型在蛋白质组学领域的潜力尚未被充分挖掘。本文构建1个10亿级、AI就绪的质谱(MS)数据门户π-MSNet。该门户采用统一的鉴定与质控流程,整合了来自10种仪器类型、55个物种的36,356次液相色谱-串联质谱(LC-MS/MS)数据,包含超 16.6亿张MS/MS谱图、5.01亿条肽谱匹配(PSM)结果与900万个前体离子。 阅读详情

提起向量数据库,很多人的第一反应是做非结构化数据处理。

更进一步,还会有人想到是对图片、视频、文本、音频、pdf这样五花八门的数据做embedding后,进行语义相似度检索。

那么你有想过,在顶尖生命科学 AI 企业中,他们是如何利用向量数据库与大模型的吗?

有资料显示,AIDD能够节省20-30%的临床前开发成本,并大幅缩短研发时间。

具体路径上,通过大模型海量的生成、预测与优化能力,AI几乎可以生成无限药物组合可能,去针对过往未被考虑的疾病治疗靶点,生成具有优化特性的新药物分子或生物制剂,辅助和优化传统制药中的高通量筛选和生成设计环节。

理想很丰满,现实却总是很骨感。

在实际中,仅仅是如何把处理自然语言、图片信息的embedding模型,用于对蛋白质、DNA、RNA、细胞、分子、文本进行相似度检索,这一步,就已经难倒了无数人。

作为行业头部玩家,百图生科的答案是打造专有的生命科学大模型2100亿参数xTrimo V3基础大模型,在此基础上,结合Milvus向量数据库打造生物科学AI落地新范式。

01

AI落地生物医学,有哪些门槛

在医药行业,新药研发是一个九死一生的过程:《nature》杂志统计,一款新药研发的平均成本大约为26亿美元,研发平均耗时十年,成功率却不到10%。

作为其中的佼佼者,百图生科已经在药物研发、生物制造、医疗健康等关键领域,成功实现了 200 多个任务模型的 State-of-the-Art 表现,为全球范围内的 700 多家用户提供了优质服务,累计收获了超过 20 亿美元的总客户订单。

但要把实验室级的 AI 能力推向规模化应用,即使强如百图生科,也不是一帆风顺。

问题可以总结为传统工具遇到了know how极多的高精尖行业,还同时面临企业数据从百万级升级到十亿级的关键节点。具体来看,挑战可以分为五重:

第一道门槛是蛋白质搜索效率低下问题。

此前,百图生科的蛋白质搜索主要依赖多序列比对(MSA)技术,单次结果返回需 10-20 分钟。小规模研究中,这个速度尚可接受;但面对数亿、数十亿条序列的生产级需求,项目进度就会完全瘫痪。生物研发对时间敏感度极高,一款药物早上市一天,就能为患者争取更多治疗机会,低效的搜索方式显然撑不起大规模研发需求。

第二道门槛是多模态数据之间断联。

生物数据形态多样,涵盖蛋白质结构、DNA 序列、细胞成像、科研文本等,生命科学的突破往往就藏在跨模态数据的关联中 ——比如生物体的DNA会影响其所能产生的蛋白质大类,而蛋白质结构与细胞病变之间也往往有着对应关系。数据无法联动,就意味着错失核心科研线索。

第三道门槛则是速度与精度之间的权衡。

生物医学研究容不得半点误差,百图生科研发的 RAG 发现助手,既需要亚秒级响应速度保障研究员工作效率,又需要达到研究级精度避免错误引导。但多数传统工具要么追求速度牺牲精度,要么侧重精度降低效率,同时还要满足医疗数据严格的隐私合规要求,难度极大。

第四道门槛则是通用工具的适配性太低。

生物数据具有独特属性,比如蛋白质序列的同源性、DNA 的碱基配对规律等,需要定制化的索引策略和embedding模型。但市面上的通用搜索工具都是标准化设计,无法适配生物数据的特殊性,强行使用只会导致搜索效果大打折扣。

最后一道门槛则是一套架构,难以满足多种业务需求。

虽然同属生物医学,但是在百图生科内部,其AI落地在不同应用场景落地时对性能的需求差异显著:对话式助手需要即时响应,蛋白质预测可容忍几分钟延迟但需支持批量处理,基础模型训练则要求高吞吐量的数据处理能力。

试图用一套架构满足所有需求,显然不现实,各场景的性能需求根本无法同时兼顾。

总结来说,就是AI要落地,百图生科自己已经解决了xTrimo 模型与数据这一步,但是怎么帮模型找到最合适的数据,百图生科对向量数据库的要求是:

要性能也要精度,要能力成熟还要有针对专业场景的适配性。

02

why Milvus?

出于对性能的考量,百图生科先将目光放在了闭源商业化的向量数据库产品上,但闭源工具就像封装好的黑盒,要么定制化受限,要么成本过高。

碰了一鼻子灰的百图生科决定将宝压在开源产品上,但在部分高校科研场景中备受好评的Faiss 仅能应对小规模测试,进入生产环境后稳定性、扩展性全不达标。

一套综合对比下来,只有 Milvus 能全面满足需求。

其最核心的原因在于,Milvus的开源特性,支持深度定制。

生物数据的特殊性决定了必须针对场景做定制化开发,Milvus 的开源设计让百图生科能自由修改代码、优化参数,甚至根据蛋白质序列特性调整索引策略。

并且,Milvus完善的社区团队,也能让百图生科在做索引优化时遇到任何问题都能第一时间得到响应与帮助。

而此前Milvus及其背后的Zilliz团队,更是已经有过了与国际顶尖创新药大厂一起,做分子指纹检索等相关项目的经验,Milvus技术 + 资源的双重支撑,远超单一工具的价值。

但开源并不意味着Milvus只能作为实验室里的大号玩具。

能力上,无论是研究员的即时性亚秒级查询,还是批量处理数十亿条序列的任务,Milvus 的水平扩展架构都能轻松应对。通过增加服务器节点,就能实现数据规模从亿级到百亿乃至千亿级”的突破,且性能始终保持稳定。

并且,这一套系统已经在金融、医疗等多行业经过长期验证,全球超 上万家企业用其支撑核心业务。

更不用说Milvus成熟的混合检索能力。过去,行业用 “肺癌靶点” 关键词筛选文献的同时,还想找到与之匹配相似的蛋白质结构,需要同时搭建向量+关键词检索两套系统。而通过Milvus,百图生科首次实现了一套系统就能完成蛋白质、DNA、文本等多类数据的搜索优化,效率与IT系统的运维都得到了极大优化。

03

三大场景落地

选定 Milvus 后,百图生科将其部署在三大核心场景,彻底解决了此前的落地难题

1、科研助手:从小时搜变秒级答

基于 RAG 技术的 AI 发现助手,通过 LangGraph 搭建流程框架,整合全球上亿篇科研文献、专利及生物数据库资源。这些包含公式、蛋白质结构示意图的专业数据,被转化为向量嵌入后存储至 Milvus。

比如研究员检索 “PD-1 抗体相关蛋白质结构” 时,Milvus可以同时启动向量搜索(匹配相似结构)和关键词搜索(文本检索 “PD-1” 相关内容),过去需要几个小时才能完成的文献梳理,现在亚 秒级就能搞定。

2、蛋白预测:规模、速度、精度 同步增长

针对蛋白质预测,百图生科摒弃低效的 MSA 方法,全面采用 Milvus 进行向量搜索。通过自研的embedding模型将每条序列转化为高维向量嵌入存储至 Milvus 后,搜索规模可以从数亿条直接突破至50 亿条。

性能层面更是显著提升:此前查询一条罕见病相关蛋白质需10-20 分钟,现在不到1秒内即可完成;同时,AI 驱动的向量相似度算法让预测精度比传统方法更加精准。

3、模型训练:跨模态数据彻底打通

多模态生物 AI 模型训练的核心难点,在于实现特定蛋白质序列与分子数据、细胞成像、文本信息的有效整合。Milvus 恰好解决了这一问题:研究员上传肺癌细胞成像图,可自动匹配对应的 DNA 突变序列、蛋白质数据及相关科研文献;输入病毒 RNA 序列,能直接调取感染后的细胞形态数据,从而让跨模态关联发现更高效。

04

成效

Milvus 带来的不仅是性能数据的提升,也在一定程度上改变了百图生科的科研逻辑和市场地位。

核心性能上,百图生科实现了

  • 蛋白质序列搜索速度提升 22 倍,从 15 分钟 / 次压缩至 不到50 秒 / 次;
  • 单系统支持 50 亿条蛋白质序列查询,最高支持百亿乃至千亿的向量检索规模,响应时间稳定在 1 分钟内;
  • 数据处理规模从数亿级突破至数十亿级,增幅超 10 倍;
  • 交互类查询全部实现亚秒级响应,大幅增加研究员满意度。

科研逻辑上,百图生科实现了

  • 形成良性迭代循环:搜索效果与 xTrimo 模型性能深度绑定,模型每迭代一次,搜索精度也会随之提升,构建起 模型优化→搜索精准→研发提速→数据积累→模型再优化的闭环,这是传统工具无法实现的。
  • 打破跨模态数据壁垒:通过 Milvus 实现分子、细胞等不同层级数据的统一对齐,无缝跨模态搜索,支撑下一代多模态模型。
  • 大幅降低运营成本:传统模式需要部署多套检索系统,现在依靠 Milvus 单一系统,成本直接减半,节省的资金全部投入核心研发。
  • Milvus 成 “枢纽”,串起 AI 模型、NebulaGraph 图数据库、LangGraph 代理框架。

05

尾声

百图生科的实践,为生物 AI 行业提供了重要参考。

过去,不少企业试图将 ChatGPT 等通用大模型改造为生物 AI 工具,结果因无法适配生物数据特性,最终沦为四不像。

百图生科的思路更务实:从头研发 xTrimo 这类生物专属基础模型,搭配 Milvus 这种适配生物场景的工具,虽然前期投入大,但能精准解决行业痛点,形成差异化竞争力。

与此同时,生物 AI 的竞争本质是数据处理能力的竞争,很多企业忽视数据库、搜索工具等隐形基建的投入,导致研发过程频繁卡壳。

百图生科采用专业工具组合策略:Milvus 负责向量搜索,NebulaGraph 处理知识图谱,LangGraph 支撑智能代理,各环节选用最优工具,也更能适应生物 AI 复杂多样的需求。

未来,依托 Milvus 搭建的技术基础,百图生科计划将 AI 能力延伸至生命科学的全链条:

包括但不限于帮药企提速药物研发,助医院优化临床研究、患者数据分析,给合成生物公司升级生物体设计、生产,为农业生物改良作物、精进基因分析等等。基于稳定高效的基础设施,百图生科的目标是把技术转化为真正解决行业问题的可落地方案。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
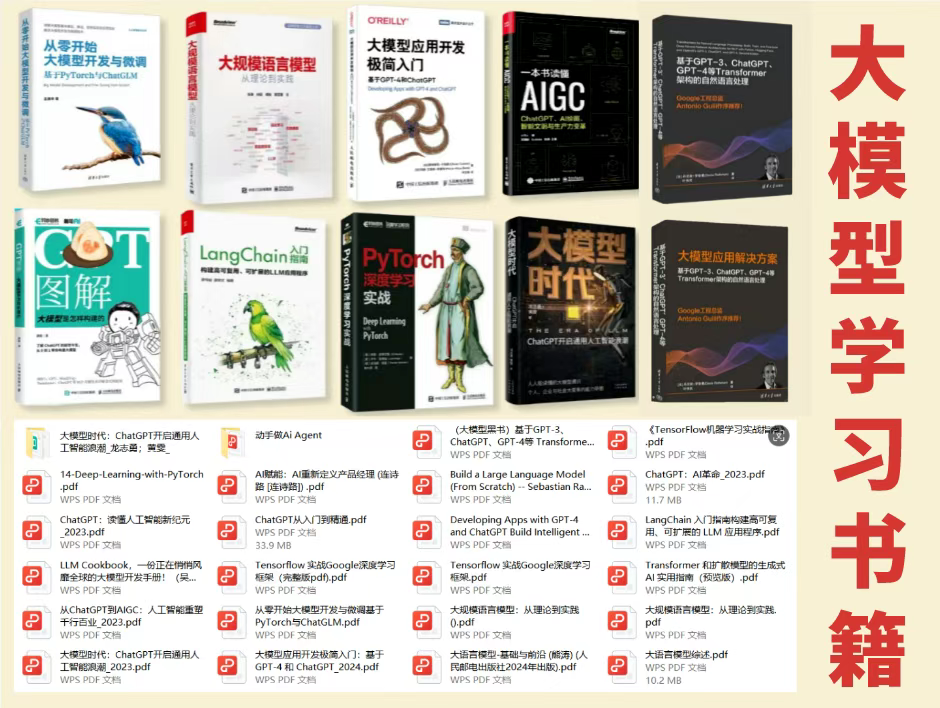
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

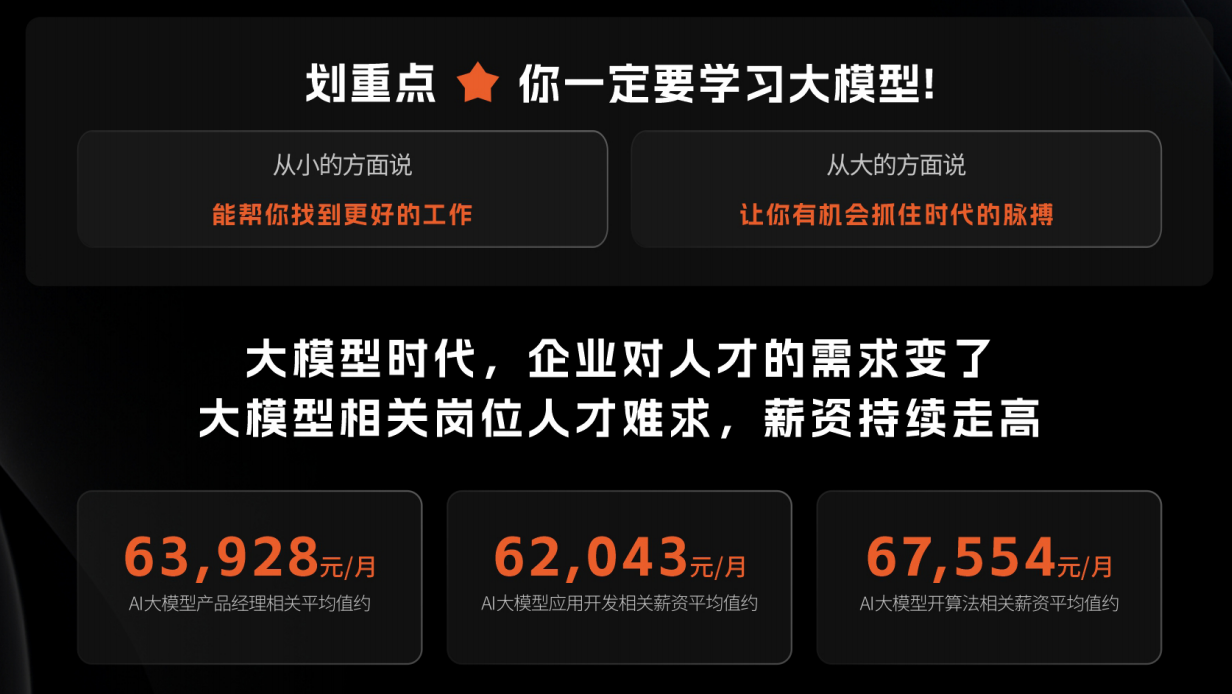
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

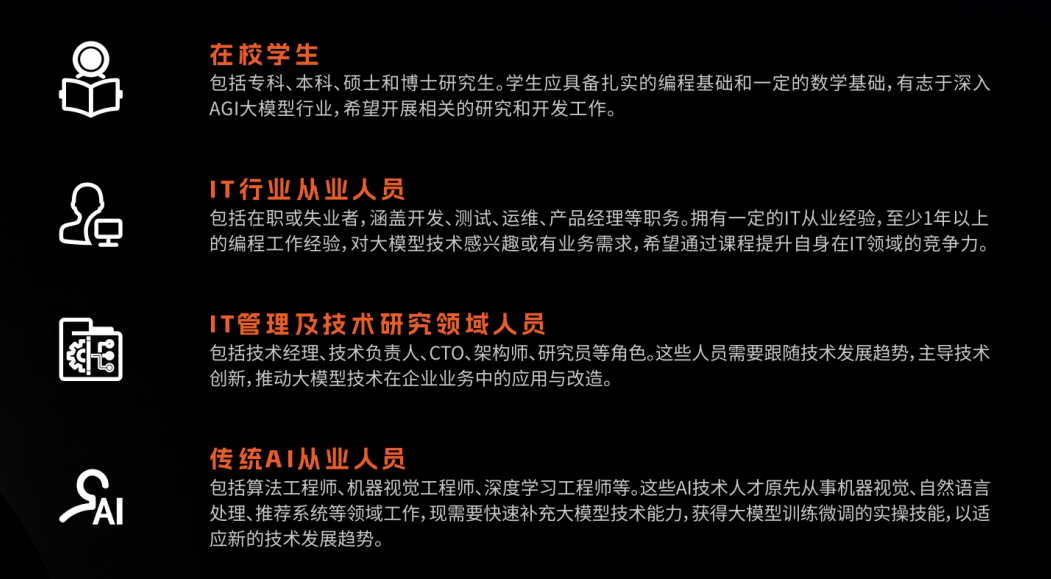
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

BioEmu:微软黑科技炸场!生成式AI重构蛋白质模拟:千倍效率碾压传统计算,新药研发周期砍半 BioEmu 是微软推出的生成式深度学习系统,可在单个 GPU 上每小时生成数千种蛋白质结构样本,支持模拟动态变化、预测热力学性质,并显著降低计算成本。 阅读详情

相关推荐

AI 蛋白质设计:基于文本的定制蛋白质生成SwissProt

我们都知道,蛋白质是生命的基石之一。设计出稳定性、催化活性或特异性更强的定制蛋白质是合成生物学、药物研发和生物技术领域的关键挑战。但我们已经无数次见证了传统蛋白质设计的艰巨和耗时。

iCloudEnd的博客 132

地球超2亿蛋白质结构全预测,AlphaFold引爆「蛋白质全宇宙」!

视学算法报道编辑:拉燕Aeneas如願 桃子【导读】今天,AlphaFold又让学术界沸腾了。DeepMind官宣,AlphaFold可以预测出2亿多个蛋白质结构,几乎覆盖了整个「蛋白质宇宙」。今天,DeepMind再次引爆学术界!AlphaFold能够预测2亿多个蛋白质结构,实现数量级的重大飞跃。最重要的是,全部免费开放!在未来,预测蛋白质结构就如同使用「谷...

zandaoguang的博客 676

『n8n』初识界面

在首页(Overview),我们和 n8n 最常打交道的是“Workflows”、“Credentials”、“Executions”这几个面板(其实后面2个也会用到,但初学阶段可以先不管)。Workflows 面板可以看到我们创建的所有工作流,所以要给工作流起一个一眼看上去就知道是干嘛的名字。

weixin_39415598的博客 1460

AI for Science:人工智能如何改变科研

AI for Science:人工智能如何改变科研

layneyao的博客 2622

网络工程师的Python入门实战:手把手教你写交换机配置备份脚本

本文详细介绍了如何利用Python为网络工程师开发一个高效的交换机配置备份脚本,涵盖环境搭建、设备连接方案、智能设备发现、多因素认证、异常处理、配置差异对比等关键步骤。通过实战案例展示如何将备份时间从4小时缩短至15分钟,显著提升运维效率,特别适用于华为交换机等设备的配置导出与备份需求。

weixin_30291791的博客 304

chipseeker Y叔

这一次讲解非常重要的peak注释,注释在ChIPseeker里只需要用到一个函数annotatePeak,它可以满足大家各方面的需求。 输入 当然需要我们上次讲到的BED文件,ChIPseeker自带了5个BED文件,用getSampleFiles()可以拿到文件的全路径,它返回的是个named list,我这里取第4个文件来演示。annotatePeak的输入也可以是GRanges对象,你如果用R做peak calling的话,直接就可以衔接上ChIPseeker了。 require(ChIPseeke

生信小博士的博客 1589

谷歌AlphaFold近日宣称预测出地球上几乎所有蛋白质结构

从今天起,预测几乎所有已知蛋白质的结构,都如同使用搜索引擎一样简单

weixin_4528312的博客 1047

Starlink地面终端天线对星(一)对星流程,星历下载,信标信号

starlink卫星终端对星采用机械伺服+相控阵电子扫描的混合模式,兼顾快速盲扫和高精度跟踪;对星流程分三步:冷启动与盲捕获 → 建立初始链路并下载星历 → 进入正常通信模式;

chen2jiang3的博客 2724

AI助力生物医药研发:基于深度学习的蛋白质 - 配体结合亲和力预测

生物医药研发是保障人类健康的关键领域,但面临着成本高、周期长等诸多挑战。人工智能(AI)技术,特别是深度学习,为解决这些问题提供了新途径。本文聚焦于AI在生物医药研发中蛋白质 - 配体结合亲和力预测的具体应用,详细阐述实现流程,给出代码示例,分析运行结果,探讨使用场景和应用成效,旨在展示AI为生物医药研发带来的变革与潜力。

linlinzhengkarry的博客 4295

5分钟搞懂异构图注意力网络(HAN):从元路径到节点聚合的全流程解析

本文深入解析异构图注意力网络(HAN)的核心原理与实战应用,从元路径设计到多级注意力实现的全流程。HAN通过节点级和语义级双重注意力机制,有效处理包含多种节点和边类型的异构图数据,在电商推荐、学术网络分析等场景展现卓越性能。文章提供DGL实现代码和调参技巧,帮助开发者快速掌握这一强大工具。

weixin_29056701的博客 311

【SWAT水文模型】SWAT-CUP参数率定与模型验证实战指南

本文提供了SWAT水文模型参数率定与模型验证的完整实战指南。详细介绍了如何使用SWAT-CUP工具,特别是SUFI-2算法,进行自动化参数校准,并阐述了模型验证的关键步骤以避免过度拟合。内容涵盖从工程搭建、核心参数选择、迭代优化到结果分析与常见问题排查的全流程,旨在帮助用户提升SWAT模型模拟的准确性与可靠性。

weixin_29072299的博客 499

AlphaFold 3 和 GPT-4o 在蛋白质数据银行条目知识上的史诗级“跨界”

原文:towardsdatascience.com/epic-crossover-between-alphafold-3-and-gpt-4os-knowledge-of-protein-data-bank-entries-ec7b6dd589e0如果你对生物信息学和生物学数据分析感兴趣,你会发现这篇文章立刻很有启发性。对于更广泛的 AI 科学家来说,他们在这里会找到通过推动它产生幻觉来探测 LLM 的方法,然后找到克服这种限制的方法。

龙哥盟 835

【规则引擎连载3】 WebSphere ILOG JRules 开发——新建一个规则项目

规则项目依赖于bom,bom来自于一个Java项目,所以在建规则项目之前,需要先建立一个Java项目,也就是建模。 说明:原则上是一个规则项目,一个bom。如果规则项目很多,并且每个规则项目的bom都是一样的,那么可以将bom提取出来,单独作为一个项目,这样减少不必要的重复操作,减少维护成本,降低出错几率。这里逐步讲解两种方法来创建规则项目,推荐第二种。 本文主要建立两种规则项目与bom之间的关系,编写相关的规则内容,如操作规则、规则流、决策表等,在后续文章中详细讲解 。

manman的分享 2331

ColabFold完整教程:快速上手AI蛋白质结构预测

还在为昂贵的计算资源和复杂的安装配置而头疼吗?ColabFold为你提供了革命性的解决方案!这个基于AlphaFold2算法的开源工具,让任何人都能在几分钟内开始蛋白质三维结构预测,无需专业硬件设备。🚀 ## 为什么选择ColabFold? ### 计算资源零门槛 传统蛋白质结构预测需要强大的GPU集群,而ColabFold巧妙利用了Google Colab的免费GPU资源,彻底打破了技术壁

gitblog_00857的博客 964

ESP32之 ESP-IDF + Clion 开发环境搭建(二)—— Linux版

本文介绍了 Linux 下,使用Clion IDE 用官方 ESP-IDF 开发包进行 ESP32 开发的环境搭建

Augtons 的博客 6098

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

AlphaFold预测了几乎所有已知蛋白质!涵盖100万物种2.14亿结构,数据集开放免费用...

来源:量子位 | 公众号 QbitAI明敏 发自 凹非寺全世界几乎所有已知蛋白质结构,都被AlphaFold预测出来了!在预测出人类98.2%蛋白质一年后,DeepMind的重磅成果再次引爆学术界。包括植物、细菌、真菌在内的100万个物种、2.14亿个蛋白质结构,现在都增加到了数据集中。其中80%结构的可信度达到了足以支撑研究实验的水平,更有35%达到了高置信度。而且这些...

人工智能学家 416

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

[AI驱动生命科学研究] DDN与亥姆霍兹慕尼黑中心荣获2023人工智能突破奖

全球人工智能(AI)和多云数据管理解决方案的领军企业DDN 公司与亥姆霍兹慕尼黑中心一起被授予 2023 AI 突破奖,获奖类别为“基于AI 的上佳生命科学解决方案 ”。DDN与亥姆霍兹慕尼黑中心因为在加速 AI 驱动的科学发现方面的工作而获得认可, 这些科学发现为社会和人类健康带来了切实的好处。

weixin_43740418的博客 269

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

融合蛋白质语言模型和图像修复模型,麻省理工与哈佛联手提出PUPS ,实现单细胞级蛋白质定位

麻省理工学院和哈佛大学的团队提出了一种结合了蛋白质序列和细胞图像来进行未知蛋白质亚细胞定位的预测框架 PUPS。该框架创新地结合了蛋白质语言模型和图像修复模型来预测蛋白质定位,使其兼并推向未知蛋白预测的泛化能力和捕获细胞可变性的细胞类型特定预测。

HyperAI超神经 1256

生成全1矩阵_ProGen:蛋白质生成语言模型

今天给大家介绍的是一项由硅谷Salesforce Research的Ali Madani等人和斯坦福的Possu Huang教授课题组合作的工作,他们在这篇论文中提出的一种蛋白生成语言模型ProGen。作者将蛋白质工程视为无监督序列生成问题,利用大约2.8亿个的蛋白质序列对12亿个参数进行训练,且要求这些蛋白质序列是基于分类和关键字标签的,如分子功能和细胞成分,这为ProGen模型提供了前所未有的...

weixin_39520880的博客 487

ESM:一种基于Transformer的蛋白质语言模型,让你轻松预测和生成蛋白质

蛋白质是生命的基本组成单位,它们的结构和功能决定了生物体的各种特性和活动。然而,蛋白质的结构和功能是如何从它们的氨基酸序列中决定的,这是一个长期困扰生物学家的难题。传统的方法是通过实验手段来测定蛋白质的结构和功能,但这种方法耗时耗力,而且无法覆盖所有的蛋白质。随着人工智能的不断发展,一种新的方法出现了,那就是利用深度学习技术来预测蛋白质的结构和功能,这种方法被称为蛋白质语言模型。

clcaojzy的博客 9027

【2025】Datawhale AI春训营-蛋白质预测(AI+生命科学)-Task2笔记

c = 'X'nn.GELU(),return xinitial=0,metric / len(valid_dataloader) } ") # 保存当前 epoch 的模型 save_path = f"model.pkl" torch . save(model . state_dict() , save_path) print(f"Model saved to {03d",

Mocode的博客 462

漫谈多模态:从检索推荐,计算机视觉到生命科学 | 百辨太魔人 第6期

点击蓝字关注我们AI TIME欢迎每一位AI爱好者的加入!扫码进入小宇宙收听音频本期百辨太魔人:王辉,AI4Science 算法工程师朱浩崴,清华大学软件工程博士生冯张驰,北京航空航天大学硕士生俞笛,清华大学深圳国际研究生院硕士生本期干货文字稿由太魔人王辉整理撰写正如Isaac Asimov在《I, Robot》中描述的那样,未来的机器人不仅会处理各种信息,还会探索自我意志。达到这一目标,多模态大...

AITIME_HY的博客 1301

直播预告 | 蛋白质优化新突破!浙江大学成果入选NeurIPS 2024,论文一作详解技术亮点

为了进一步推进 AI4S 的普适化,将学术机构的科研成果进一步降低传播壁垒,分享给更广泛的行业学者、科技爱好者及产业单位,HyperAI超神经策划了「Meet AI4S」视频栏目,邀请深耕 AI for Science 领域的科研人员或相关单位,以视频的形式分享研究成果、方法思路,共同探讨 AI for Science 在科研进展及推进落地过程中面临的机遇和挑战,促进 AI for Science 的科学普及和传播。DePLM 不仅在突变效应预测方面优于当前最先进的模型,还展现出对新蛋白质的强大泛化能力。

HyperAI超神经 811

学术分享|无惧数据匮乏!上海交大博士后周子宜详解蛋白质语言模型的小样本学习方法 FSFP

为了进一步推进 AI4S 的普适化,将学术机构的科研成果进一步降低传播壁垒,分享给更广泛的行业学者、科技爱好者及产业单位,HyperAI超神经策划了「Meet AI4S」视频栏目,邀请深耕 AI for Science 领域的科研人员或相关单位,以视频的形式分享研究成果、方法思路,共同探讨 AI for Science 在科研进展及推进落地过程中面临的机遇和挑战,促进 AI for Science 的科学普及和传播。在每次训练迭代中,把 PLM 对训练样本的预测排列向它们的真实排列修正。

HyperAI超神经 1188

ProGen:蛋白质生成语言模型

今天给大家介绍的是一项由硅谷Salesforce Research的Ali Madani等人和斯坦福的Possu Huang教授课题组合作的工作,他们在这篇论文中提出的一种蛋白生成语言模型ProGen。作者将蛋白质工程视为无监督序列生成问题,利用大约2.8亿个的蛋白质序列对12亿个参数进行训练,且要求这些蛋白质序列是基于分类和关键字标签的,如分子功能和细胞成分,这为ProGen模型提供了前所未有的进化序列多样性,并允许它进行基于一级序列相似性、二级结构准确率和构像能量的细粒度控制生成。根据NLP指...

DrugOne 3872

学术分享|无惧数据匮乏!上海交大博士后周子宜详解蛋白质语言模型的小样本学习方法 FSFP...

作者:李姝编辑:李姝,李宝珠「Meet AI4S」系列直播第三期将于 9 月 25 日开播,HyperAI超神经邀请到了上海交通大学博士后周子宜,他将为大家分享蛋白质语言模型的小样本学习方法。预训练蛋白质语言模型 (PLMs) 能够以无监督的方式学习数百万蛋白质中氨基酸序列的分布特征,在揭示蛋白质序列与其功能之间的隐含关系方面显示出了巨大的潜力。在此背景下,上海交通大学自然科学研究院/物理天文学院...

HyperAI超神经 1294
上一篇: 多模态模型终极指南:一文掌握2025最新进展,从入门到精通,收藏这篇就够了!
下一篇: 多模态大模型瘦身终极指南(超详细),HoloV如何剪掉90%Token?看这篇就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值