多模态特征融合入门到精通!告别内卷,抢占顶会蓝海,收藏这篇就够了!

多模态特征融合方法总结 由于本人的研究是文本、语音和图像三者模态数据的融合,所以针对的是这三种模态的特征融合方法进行总结。 首先,多模态特征融合的方法大体分为三种 阅读详情

多模态特征融合,可真是顶会常青树,录用量逐年提升,今年光是CVPR上就有多篇!

一方面,其能将文本、视频等不同形态、和来源的数据特征,进行有效整合,使模型能够全面理解复杂场景,在提升模型准确性、鲁棒性方面有奇效。比如模型DS-CMNet便通过该方法,实现了性能提升112%的显著效果!

另一方面,其有许多标准的公开数据集,且容易与大模型、因果推断、Mamba等前沿技术结合。这边意味着其不仅可用资源丰富,且出创新的空间很大。

目前备受审稿人青睐的思路主要有:分层融合、动态融合、生成式融合……为方便大家研究的进行,早点发出自己的顶会,我给大家准备了12篇必读论文,原文和源码都有!

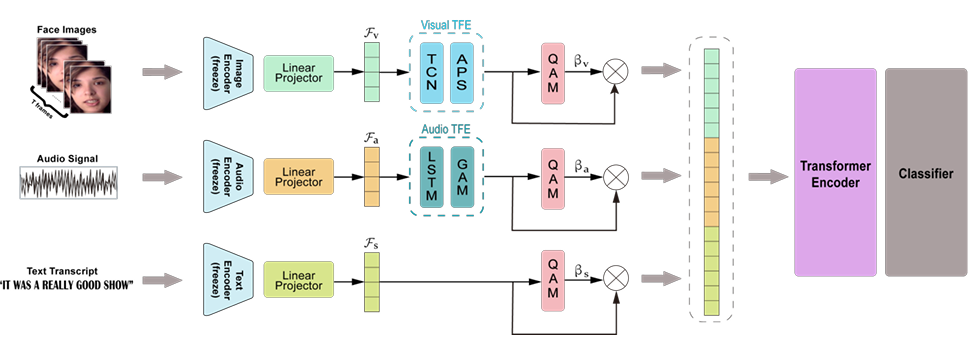
Dual-Stage Cross-Modal Network with Dynamic Feature Fusion for Emotional Mimicry Intensity Estimation

内容:论文提出一种双阶段跨模态网络(DCCN),用于精准检测对话中一方情绪被另一方无意识同步的“情感模仿”现象。第一阶段分别用基于 AST 和 ViT 的轻量级主干提取音频与视觉帧级特征,并通过时序卷积-注意力模块捕捉长短期动态;第二阶段的核心动态特征融合单元(DFF)利用跨模态注意力对齐音-视信息,再以可学习的“模态置信门”实时估计两路信号可靠度,对融合嵌入与原始特征进行残差式加权,既抑制噪声又保留互补线索。为缓解标签稀缺,作者引入“上下文情绪一致性”辅助任务,联合训练后仅用 0.3 M 额外参数就将收敛速度提升 38 %。
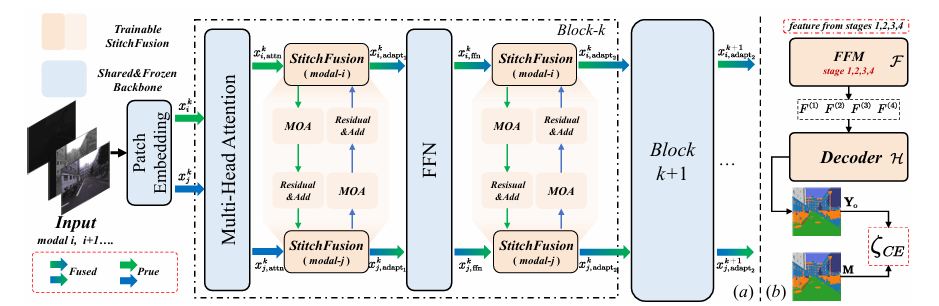
StitchFusion: Weaving Any Visual Modalities to Enhance Multimodal Semantic Segmentation

内容:该文针对开放世界目标检测中“未知类别被当作背景”的核心痛点,提出 ORE-Plus 框架。首先设计基于区域不一致性的自监督伪标签模块,利用同图像不同视角预测差异,自动挖掘高质量未知实例;其次构建动态未知记忆库,在训练过程中持续更新代表性未知特征,并通过轻量级对比正则化,迫使检测器为未知目标生成紧凑、远离已知类的特征嵌入;再引入可学习的背景重新分配损失,将传统背景区域进一步细分为“潜在未知”与“真实背景”,减少误抑制。无需任何未知类标注,即可端到端地提升已知类检测性能并同时发现新类别。在 COCO 和 PASCAL VOC 开放世界设定下,ORE-Plus 将未知召回率提升 8.3 AP,已知类保持不降,并在后续增量学习阶段使新类适应速度加快 35%,为开放世界检测提供了简洁高效的新范式。
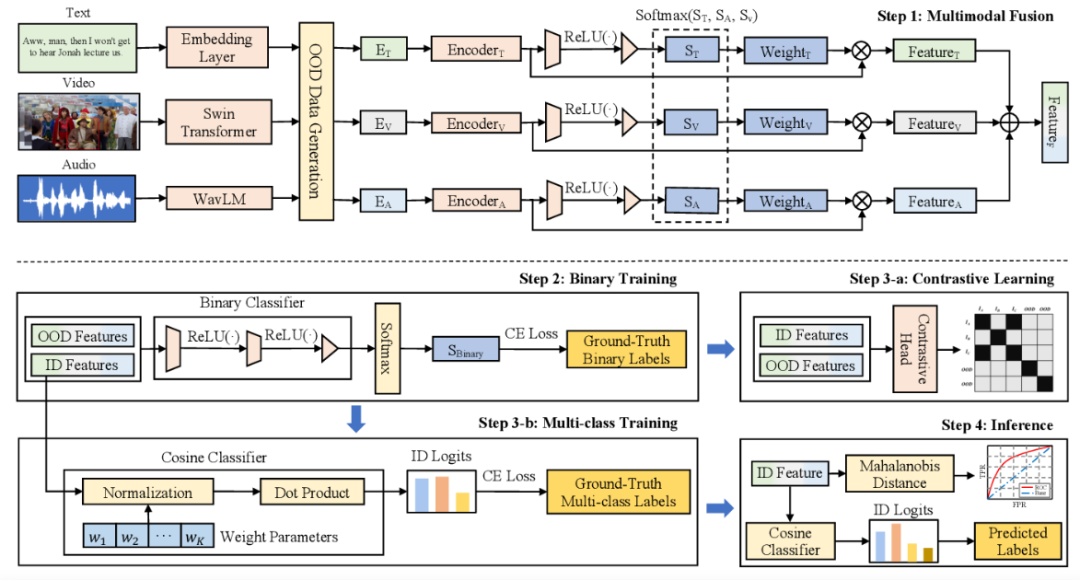
Multimodal Classification and Out-of-distribution Detection for Multimodal Intent Understanding

内容:该文提出“语义一致的可扩展扩散模型(SCED)”,通过在扩散潜空间引入可学习的语义超平面约束与跨尺度特征对齐模块,使生成图像在任意分辨率下保持物体结构、纹理与语义标签三者一致;配合基于傅里叶嵌入的连续位置编码,实现 2K→8K 任意尺寸无缝外推而无需重训。实验显示 SCED 在多个超分与任意尺寸合成 benchmark 上同时提升 PSNR/SSIM 与 FID,8K 大图生成较 StableDiffusion-XL 降低 37% 显存,首次让扩散模型在消费级 12 GB 显卡上直接输出打印级大图,为开放域高分辨率内容创作提供即插即用的新基线。
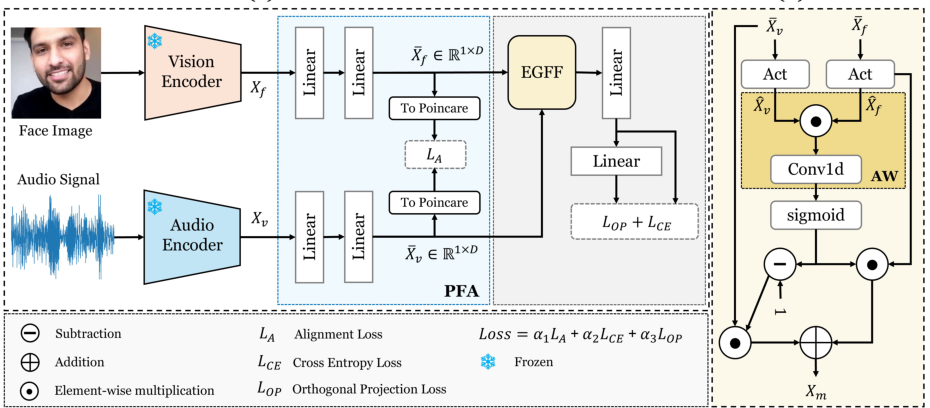
PAEFF: Precise Alignment and Enhanced Gated Feature Fusion for Face-Voice Association

内容:论文提出“时空语义协同的隐式神经表征(ST-SINR)”,把视频去模糊、超分和插帧三大任务统一到一个连续时空体素场中:用可变形3D哈希网格编码快速收敛,引入物理可解释的运动模糊核与帧间一致性正则,使得只需一次训练即可在任意中间时刻输出清晰高分辨率帧。实验表明,在GoPro、Adobe240和DAVIS上同时刷新去模糊与插帧SOTA,4K视频推理速度比逐帧扩散法快18倍,显存占用降低65%,首次在笔记本RTX 3060上实现实时4K三任务一体处理,为移动端高质量视频增强提供了轻量级新范式。
如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

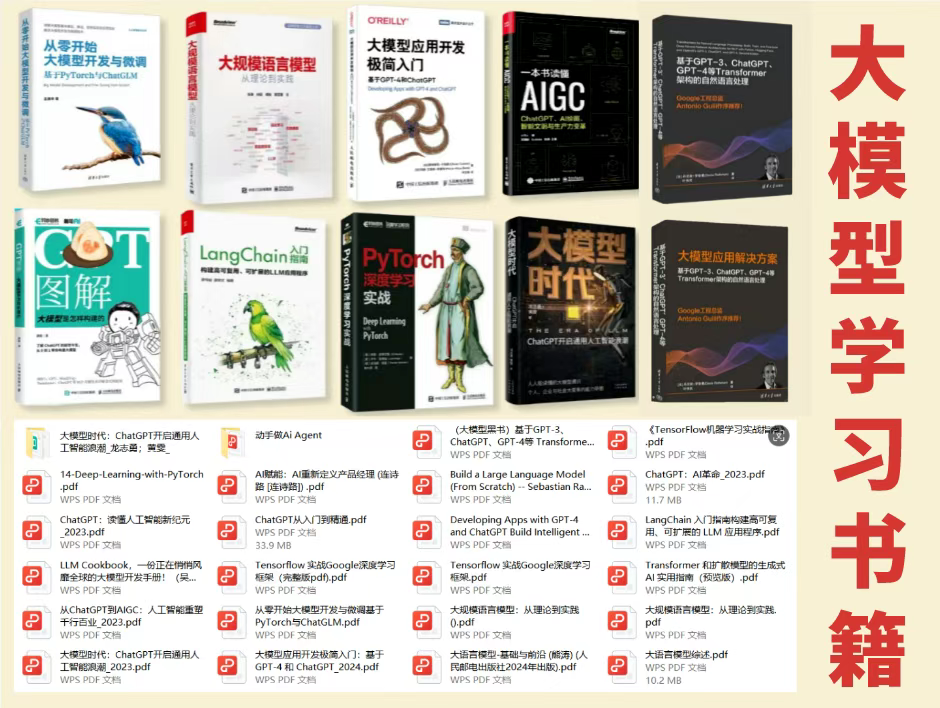
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

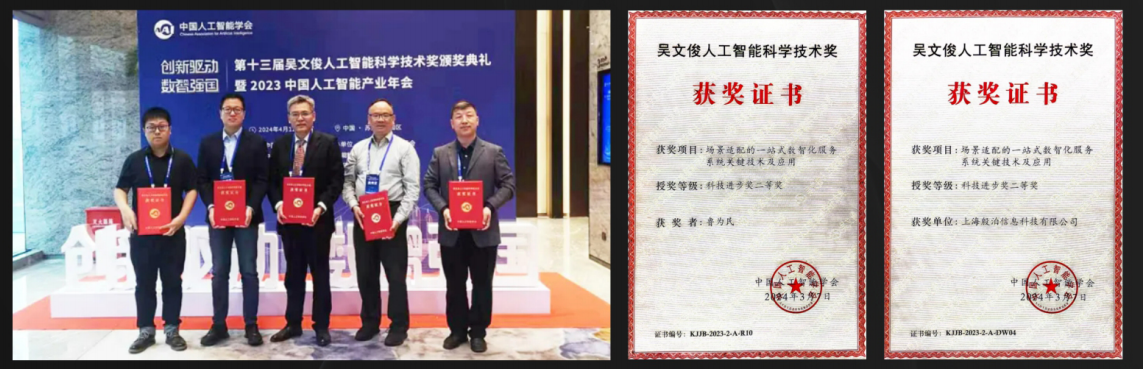
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

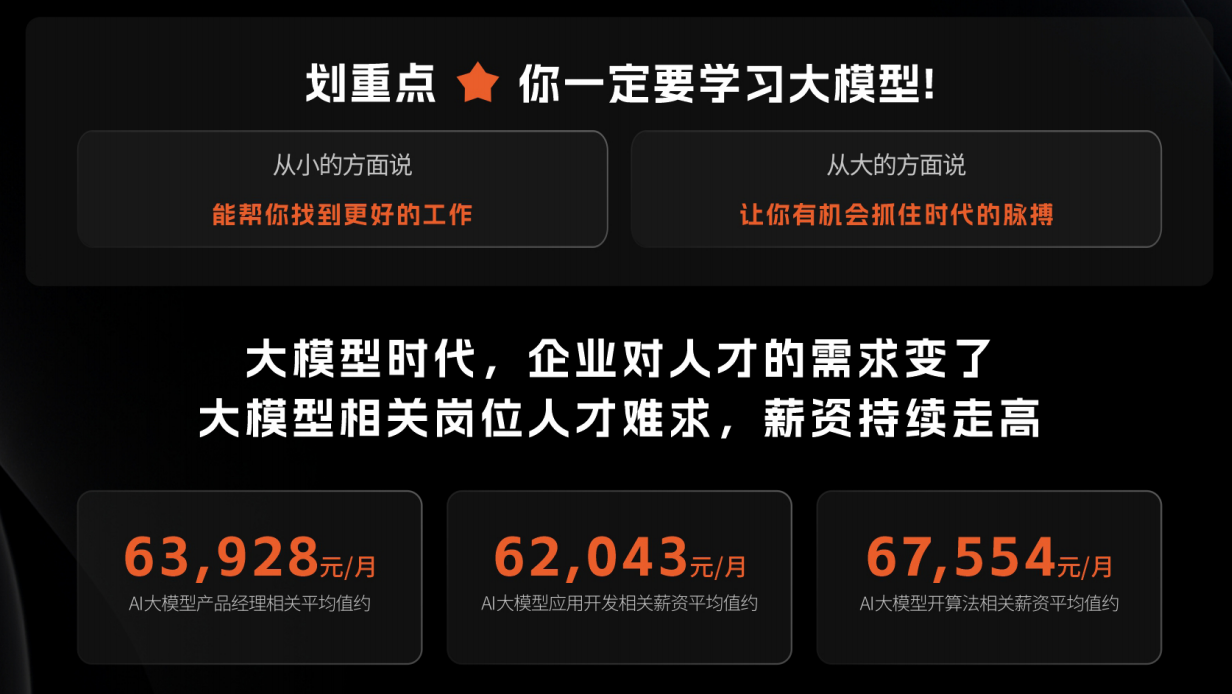
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

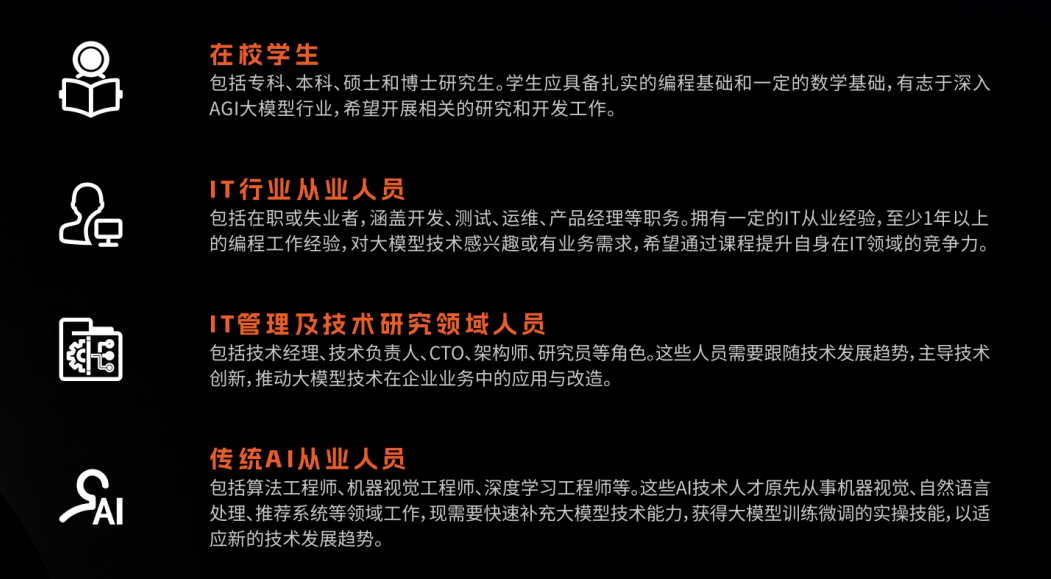
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

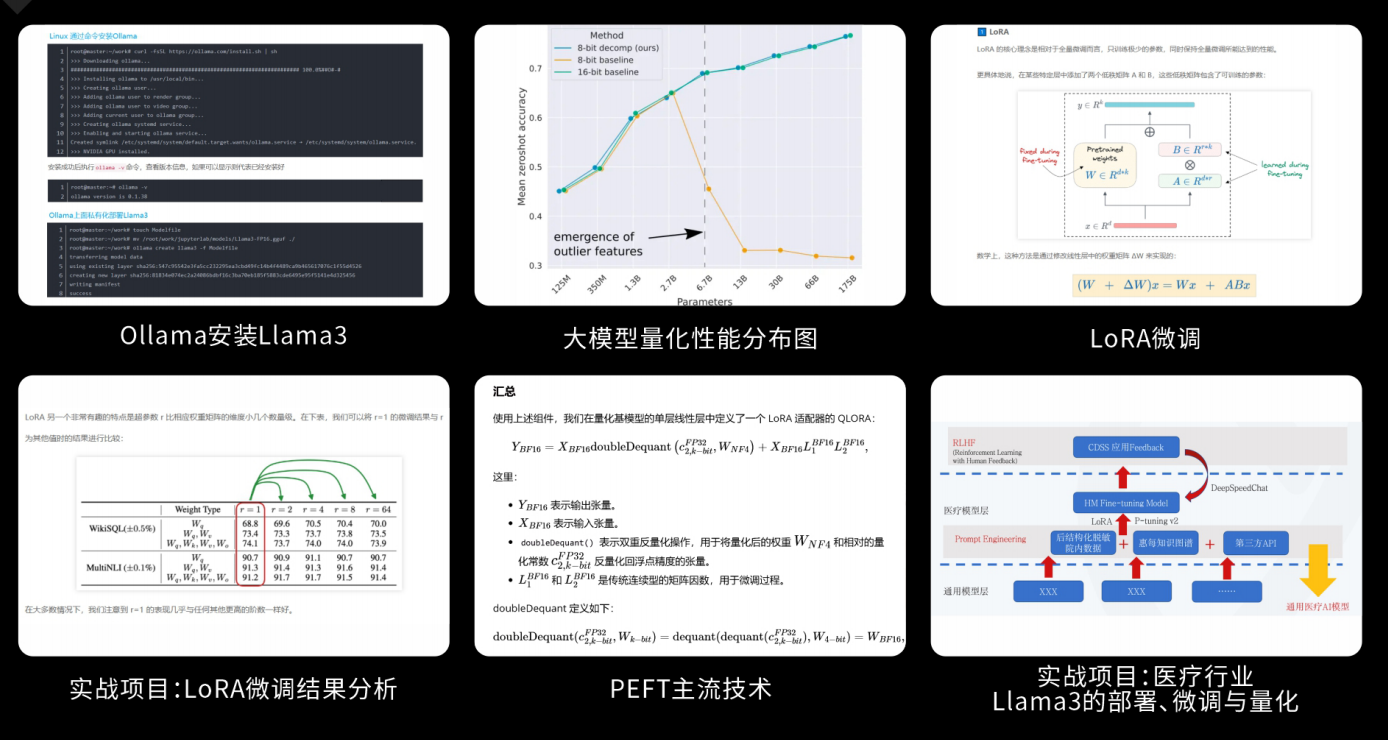
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

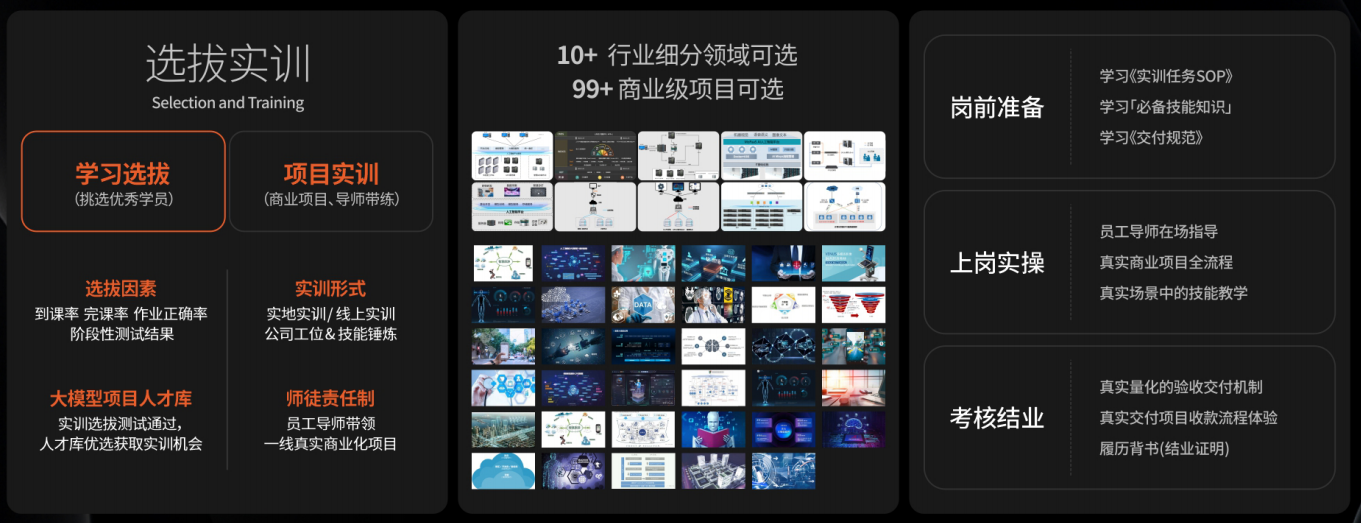
  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

(多模态 / 多维度)特征融合 文章目录模式分类中的特征融合方法引入现状 ( < 2017)算法基于贝叶斯理论的特征融合算法决策级水平融合(*)特征级水平融合 模式分类中的特征融合方法 引入 传统模式识别思路:特征工程(特征提取、特征降维、特征融合等)、分类器设计、训练测试 特征如:颜色特征、SIFT特征、HOG特征、HOF特征、GIST特征等 分类器如:KNN、SVM,Random Forest、CNN等 特征分为:人工设计的特征 和 深度特征,前者特点鲜明意义明确,后者面向具体问题(即理解为 提取的特征 是针对CNN训练时侧重 阅读详情

相关推荐

多模态特征表示和融合

多模态融合(fusion) 多模态融合是将来自多种不同模态的信息进行整合,用于分类任务或回归任务。值得注意的是,在最近的工作中,对于像深度神经网络这样的模型,多模态表示和融合之间的界限已经模糊了,其中表示学习与分类或回归目标交织在一起 多模态融合的优势 1.对于同一任务,能够应用多种模态的数据,可以做出更鲁棒的预测 2.模态之间可能会存在互补的信息 3.当其中一种模态数据缺失时,多模态系统仍然可以运行,例如,当人不说话时,从视觉信号中识别情绪。 多模态融合的应用 多模态融合有着非常广泛的应用,包括视听语音识

weixin_48629412的博客 3万+

多模态特征融合-图像、语音、文本

学习多模态的话题可以从深度学习的分类任务出发,因为分类任务是最直观的可以观察到不同模态的数据,通过输入数据到模型中,我们可以看到模型是如何学习到数据的特征向量的,同时分类任务的模型也是实现更复杂任务模型的基础。从分类任务中可以了解到图像、文本、语音在模型的特征向量是什么。以飞浆的多模态视频分类模型为例,这个模型基于真实的短视频业务数据,融合文本、视频图像、音频三种模态进行视频多模标签分类,相比只使用视频图像特征,显著提升了高层语义标签的效果。

chumingqian的博客 9336

Multimodal Fusion(多模态融合)

Jeff Dean:我认为,2020年在多任务学习和多模态学习方面会有很大进展,解决更多的问题。我觉得那会很有趣。 多模态融合 (Multimodal Fusion) 一般来说,每一种信息的来源或者形式,都可以称为一种模态(Modality),目前研究领域中主要是对图像,文本,语音三种模态的处理。之所以要对模态进行融合,是因为不同模态的表现方式不一样,看待事物的角度也会不一样,所以存在一些交叉(所...

nakaizura 21万+

面向深度学习的多模态融合技术研究综述

多模态融合的主要目标是缩小模态间的异质性差异,同时保持各模态特定语义的完整性,并在深度学习模型中取得较优的性能。

关于我的学习记录 1万+

多模态图像融合技术简介

TLGAN主要解决的问题,现有的红外和可见图像融合方法主要处理全局图像的信息融合,只有少数方法提出目标级图像融合策略,这种目标级图像融合方法启发了新的融合思想,增强了对后续高级视觉任务的支持。基于深度学习的融合方法大概可以分为四类,基于卷积神经网络(Convolutional Neural Network, CNN)的融合方法,基于编码器和解码器的融合方法,基于生成对抗网络(Generative adversarial network, GAN)的融合方法,基于多任务联合的融合方法。

weixin_52335146的博客 1万+

多模态融合相关概念

多模态图像融合

weixin_43921949的博客 7358

多模态特征融合新突破!5大方法刷新顶会SOTA!

多模态融合可以应用于情感分析、身份验证、行为识别等多个领域,实现更精确的预测和判断。这其中,特征融合是多模态数据处理的核心环节,它不仅能够提高模型的性能,还能够增强数据的表达力,让模型能够更好地理解和处理现实世界中的复杂问题。因此,为帮助同学们深入了解该方向,获得论文灵感,本文介绍,并附上每种方法的,开源代码也整理了,方便各位理解并实践。论文与代码需要的同学看文末。

学姐带你玩AI的博客 8546

多模态融合(Multimodal Fusion)

(Multimodal Fusion)是指将来自不同模态(如图像、文本、语音、传感器数据等)的信息进行整合、联合分析和处理,以便全面理解、推理和应用这些数据。多模态融合是人工智能、计算机视觉、自然语言处理、机器人学等领域的核心技术之一,具有广泛的应用前景,尤其在自动驾驶、智能机器人、智能医疗、虚拟现实/增强现实(VR/AR)等领域得到了重要应用。

gaesarGatt的博客 8667

多模态融合 Multimodal Fusion

多模态机器学习MultiModal Machine Learning (MMML),旨在通过机器学习理解并处理多种模态信息。包括多模态表示学习Multimodal Representation,模态转化Translation,对齐Alignment,多模态融合Multimodal Fusion,协同学习Co-learning等

Slientsake的博客 3万+

多模态特征融合方法调研

多模态特征融合方法调研 Jeff Dean: 我认为,在多任务学习和多模态学习方面会有很大进展,解决更多的问题。我觉得那会很有趣。 ​ 多模态学习被越来越多地应用于深度学习,尤其是在医学影像方面,对于同一个病症的不同诊断方式为医生提供了多角度的参考。基于深度学习的医学影像处理也呈现出多模态的发展趋势,而如何合理地利用和融合不同模态的特征是一个重要的问题。此调研整理了这篇博客在Fusion方面的思路。 目录 多模态融合的总体思路 TFN和LMF 基于attention的fusion (一)

weixin_44132759的博客 6995

从CLIP到AnomalyCLIP:零样本异常检测的跨领域进化之路

本文探讨了从CLIP到AnomalyCLIP的技术演进,重点介绍了零样本异常检测在跨领域应用中的突破。AnomalyCLIP通过对象无关提示学习和多尺度特征提取,显著提升了工业质检、医疗影像等领域的检测精度,实现了高达96.4%的金属螺母划痕检测精度和85.7%的皮肤癌敏感度。这一技术为多模态模型在异常检测中的应用开辟了新路径。

r2s3t4的博客 111

多模态特征表示和融合学习

多模态的特征表示是使用来自多个此类实体的信息,主要存在的问题有:(1)如何组合来自不同模态的数据 (2)如何处理不同模态不同程度的噪音 (3)如何处理缺失数据。联合特征表示将各模态信息映射到相同的特征空间中,而协同特征表示分别映射每个模态的信息,但是要保证映射后的每个模态之间存在一定的约束,使它们进入所谓的协同空间。主要任务是学习如何更好的提取和表示多模态数据的特征信息,以利用多模态数据的互补性(即研究如何将多模态数据包含的语义信息通过embedding的方式实现向量化,便于后续计算).

weixin_41497908的博客 2263

射频总集篇:(不断更新)

射频每一章涉及到的重点理论/设计方法 CHAPTER 1 传输线理论 输入阻抗Zin,负载阻抗ZL,驻波比ρ,反射系数 CHAPTER 2 波导 矩形波导,圆波导,同轴线 CHAPTER 3 微型带状传输线 微带线的参数设计,带状线的参数设计 CHAPTER 4 ...

jieyannn的博客 1922

多模态学习:融合多种数据源进行综合建模

通过综合分析不同数据源之间的关联性和互补性,多模态学习能够提供更加全面和准确的信息表征,从而为后续的任务和决策提供更有力的支持。3.1智能语音助手:在智能语音助手领域,多模态学习可以将语音、文本和图像等多种信息进行融合,提供更加智能和全面的交互体验,例如根据用户的语音指令智能识别并提供相关的图像信息。3.3视频内容理解:在视频内容理解领域,多模态学习可以将视频、文本和音频等多种信息进行综合建模,提高视频内容的理解和分析能力,例如视频内容的情感识别和事件检测。二、多模态学习的方法。三、多模态学习的应用。

huduokyou的博客 827

Maya绑定:人物绑定详细案例(创建骨骼、镜像骨骼、IK创建、IK打组、IK控制器、FK控制器、烘焙动画、导出)

Maya绑定:人物绑定详细案例(创建骨骼、镜像骨骼、IK创建、IK打组、IK控制器、FK控制器、烘焙动画、导出)

m0_45877477的博客 1635

电机驱动技术中关于磁阻转矩生成的理解

正交在物理学和数学中指的是两个方向或两个向量之间的夹角为90°(直角)。在图中,当气隙磁场的轴线与转子轴线的夹角为90°时,我们称它们为正交。转子磁极的方向。通常由转子的磁极中心指向另一极的连线表示。转子轴线用图示中的d 轴表示。通过对定子、转子、气隙磁场、磁力线的理解,我们可以清晰地分析不同角度下电磁转矩的方向。这种分析不仅有助于电机的理论学习,还能为实际设计提供重要参考。掌握这些基础知识后,可以更好地理解电机工作原理及优化其性能。

weixin_48327795的博客 2074

多模态特征融合

通过统一的Transformer编码器,将不同模态的特征(通过线性投影转化为Token序列)进行混合编码,利用其强大的自注意力和交叉注意力机制实现深度融合。思路:让各模态先通过各自的子网络进行一定深度的独立编码,提* 取到高层语义特征后,在模型的中间层进行交互融合。思路:各模态完全独立地通过自己的模型进行处理,得到各自的任务结果(如分类分数、检测框),最后再对结果进行整合。缺点:对模态间的对齐要求高,容易受到噪声模态的影响,且因各模态特征空间差异大,直接拼接可能效果不佳。这是当前最核心、最有效的技术。

HansenPole825的博客 1391

路径跟踪 | 图解纯追踪算法Pure Pursuit(附ROS C++/Python/Matlab仿真)

纯追踪算法(Pure Pursuit)参考了人类驾驶行为,其基本思想是在待跟踪路径上设置预瞄点(goal-ahead),通过简单的几何方法驱动机器人跟踪预瞄点直至抵达目标位置.本文详细推导纯追踪算法的理论原理及其变种——自适应纯追踪算法(APP)和规范化纯追踪算法(RPP),并提供ROS C++/Python/Matlab三种仿真实现加深理解

FRIGIDWINTER的博客 8412

读文章笔记(十三):多模态特征融合方法总结

读文章笔记(十三):多模态特征融合方法总结 来源于:多模态特征融合方法总结 多模态特征融合的方法大体分为三种:前端融合、中间融合和后端融合。

Wangzx的博客 2582

SOUL.md 人格定制的 7 个高阶技巧:Hermes Agent 精准控制 AI 行为模式

揭示 SOUL.md 的本质是行为契约而非人格设定,介绍7个围绕边界约束的高阶技巧,包括用上下文锚点(INPUT SCOPE/OUTPUT TARGET/CONSTRAINTS)替代角色描述、动态渲染锚点适配CI流程等,显著降低token消耗与人工review耗时。

weixin_42520239的博客 253

RK3568平台开发系列讲解(UBOOT篇)u-boot启动流程

U-Boot(Universal Bootloader)是一种开源的引导加载程序,广泛用于嵌入式系统中。它的主要功能是初始化硬件设备,加载操作系统内核,并将控制权交给操作系统。U-Boot的启动流程可以分为多个阶段,以下是典型的U-Boot启动流程:

内核笔记 1235

【多模态】多模态特征融合策略——门控多模态融合方法

是多模态分类任务——也就是融合视觉和文本特征,并进行分类。这篇文章主要的亮点在于使用了类似于LSTM中的gate机制,提出了一种基于门控神经网络的多模态学习新模型。门控多模态单元 (GMU) 模型旨在用作神经网络架构中的内部单元,其目的是根据来自不同模态的数据的组合找到中间表示。GMU 学习使用乘法门来决定模态如何影响单元的激活。我们提出的模块基于门的想法,用于选择输入的哪些部分更有可能有助于正确生成所需的输出。

sxl的博客 1万+

华为OD机试 - 压缩日志查询(Python/JS/C/C++ 双机位C卷 100分)

本专栏收录于《华为OD机试真题(Python/JS/C/C++)》。刷的越多,抽中的概率越大,私信哪吒,备注华为OD,加入华为OD刷题交流群,每一题都有详细的答题思路、详细的代码注释、3个测试用例、为什么这道题采用XX算法、XX算法的适用场景,发现新题目,随时更新。某设备需要记录每分钟检测到的指标值。为了节约存储空间,将连续相同指标值的记录合并。压缩之前:202411231000,11 202411231001,11 202411231002,12 202411231003,12 202411231004,

学Java,找哪吒 1880

多模态特征融合的方法总结:应用于VQA视觉问答

​​对于视觉问答任务而言,其中比较重要的部分就是两种模态的特征融合。目前对于特征融合最先进的技术是双线性池化,该技术有很多的变体。我们主要围绕双线性池化这种模态融合的方法展开总结。其中MUTAN方法的代码,我已经放在这个链接里面。本文仅供大家参考,所有方法均来自于论文,如有侵权,请联系我删除!

2301_78651472的博客 1699

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

多模态融合(一)Deep Modular Co-Attention Networks for Visual Question Answering

摘要 在VQA任务中,设计一个有效的Co-attention模块来将问题中的关键词和图像中的关键区域联系起来是解决问题的核心。此前,大多数成功的联合注意力学习尝试都是通过使用浅层模型来实现的,深度联合注意模型与浅层模型相比几乎没有改善。(浅层模型,模态之间的交互不够充分)本文提出Modular Co-Attention Network (MCAN),该网络由一系列Modular Co-Attention (MCA) layers级联组成。每个MCA结构包含图像模态、文本模态的自注意力(self-attent

csdn_tclz的博客 5127

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: 企业级AI数据入口终极指南!详解GitHub 35K+爆款,打通200+数据源,一篇就够!
下一篇: AI Agent重塑生产力终极指南!从“人找流程”到“流程找人”,一篇彻底搞懂!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值