彻底搞懂腾讯GRPO!为什么说“免训练”是大模型优化的下一个风口?这篇讲透了!

使用python实现随机正态分布数据,并导出到表格(超详细) 最近需要大量的正态分布的数据,为了方便,使用python实现随机正态分布,画出理想正态分布图和实际的矩形分布,并导出到表格里面。以上就是今天要讲的内容,本文仅仅简单介绍了使用python随机生成正态分布的数据,画图,并导出。正态分布是机器学习中很常见的一种需求,往往需要大量的数据进行测试,此时,本文的方法就可以大大减少因数据而花费的时间啦!如有问题,欢迎评论区留言啊! 阅读详情

不调整模型参数,只优化提示词中的经验知识,就能大幅提升大模型性能——腾讯优图的新方法正在改变AI优化格局。

大模型微调不再需要昂贵计算资源!腾讯优图团队最新提出的Training-Free GRPO方法,仅需约120元成本就能达到传统7万元微调的效果,为大模型应用落地降低了门槛。

传统微调面临的核心挑战

当前,大语言模型在专业场景中使用工具(如计算器、搜索引擎)时表现不佳,传统解决方案是通过微调来优化模型参数。但这种方法存在明显痛点:

  • 算力成本高昂:微调大型模型需要大量GPU资源
  • 泛化能力有限:优化后的模型在新领域表现往往下降
  • 需要大量数据:收集高质量的训练样本困难
  • 收益递减:随着训练进行,性能提升逐渐饱和

创新解决方案:不调参数,只优化经验

Training-Free GRPO的核心思路很巧妙:保持模型参数完全不变,通过优化提示词中嵌入的“经验知识”来引导模型做出更好决策。

具体来说,该方法建立了一个外部经验知识库,工作流程分为三个关键步骤:

第一步:经验生成与分析

让模型对同一任务生成多个解决方案,然后进行自我评估,分析每个方案的优缺点。

第二步:经验提炼

基于评估结果,总结出成功的经验法则和失败的教训,形成简洁的自然语言描述。

第三步:知识库动态更新

根据新获得的见解,对经验库进行添加、删除、修改或保留操作,确保经验质量持续提升。

实验效果:低成本实现显著提升

团队在数学推理和网页搜索两大任务上进行了验证,使用了671B参数的DeepSeek-V3.1-Terminus模型。

数学推理任务表现突出

在AIME数学竞赛题库上的测试结果显示:

  • AIME24数据集:准确率从80.0%提升至82.7%
  • AIME25数据集:准确率从67.9%提升至73.3%
  • 仅使用100个训练样本,成本约18美元(120元人民币)

与传统方法成本对比惊人

传统微调方法需要数万个样本,成本超过10000美元,而Training-Free GRPO仅需120元就实现了相当甚至更好的效果。

网页搜索任务同样有效

在WebWalkerQA基准测试上,该方法将模型得分从63.2%提升至67.8%,证明了其在复杂任务上的泛化能力。

技术价值与行业影响

这项技术的突破性意义体现在三个方面:

极大降低应用门槛

中小企业甚至个人开发者都能负担得起大模型优化成本,促进AI技术普惠。

保持模型通用能力

由于不修改参数,模型原有的强大能力得以完整保留,避免“越优化越狭隘”的问题。

推动绿色AI发展

大幅减少计算资源消耗,符合可持续发展理念。

腾讯优图团队的这项研究为大模型优化提供了新思路:从“改变模型”转向“引导模型”,未来随着大模型基础能力的持续增强,这种轻量级优化方法的价值将更加凸显。论文和代码已开源,为AI社区提供了可复现的解决方案,预计将推动更多创新应用的出现。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
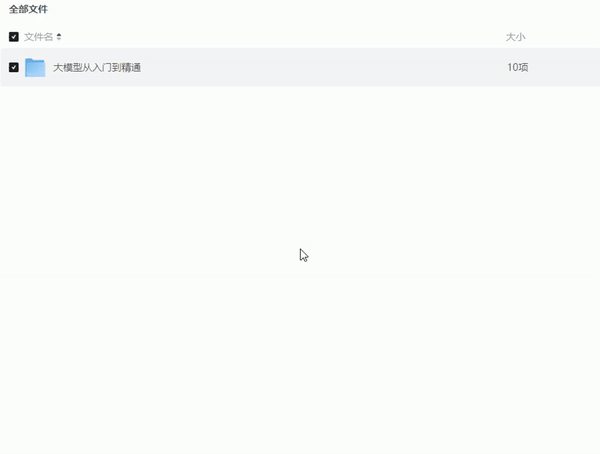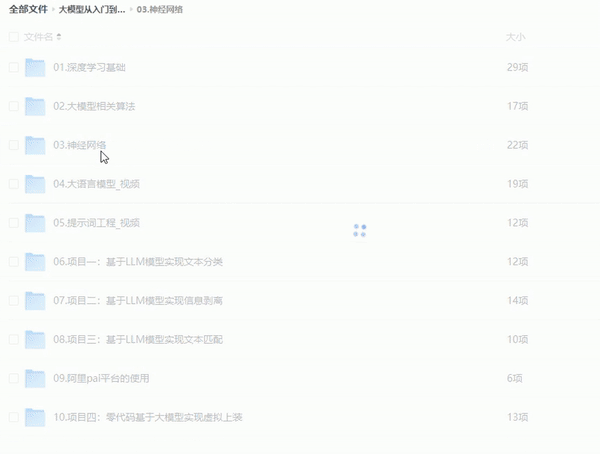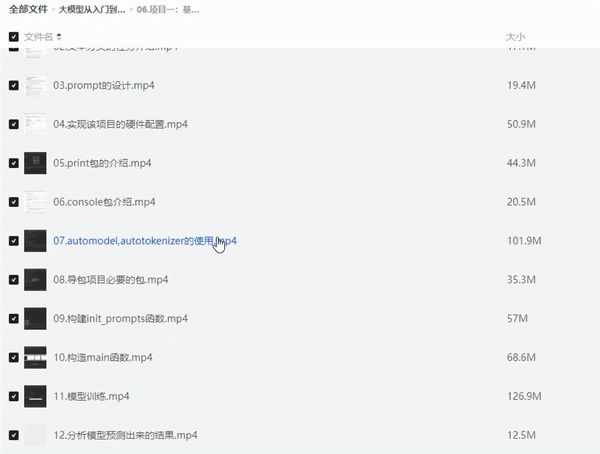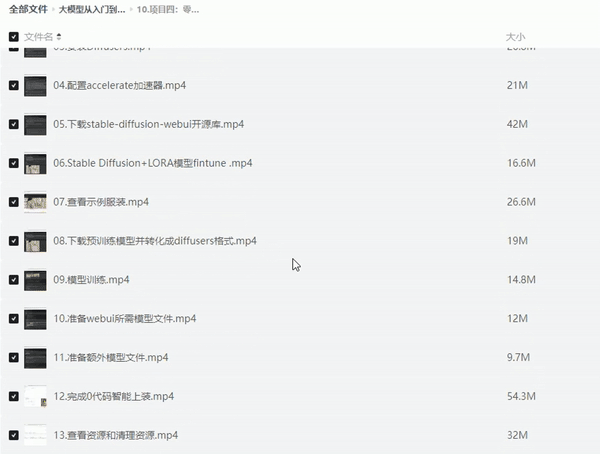
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

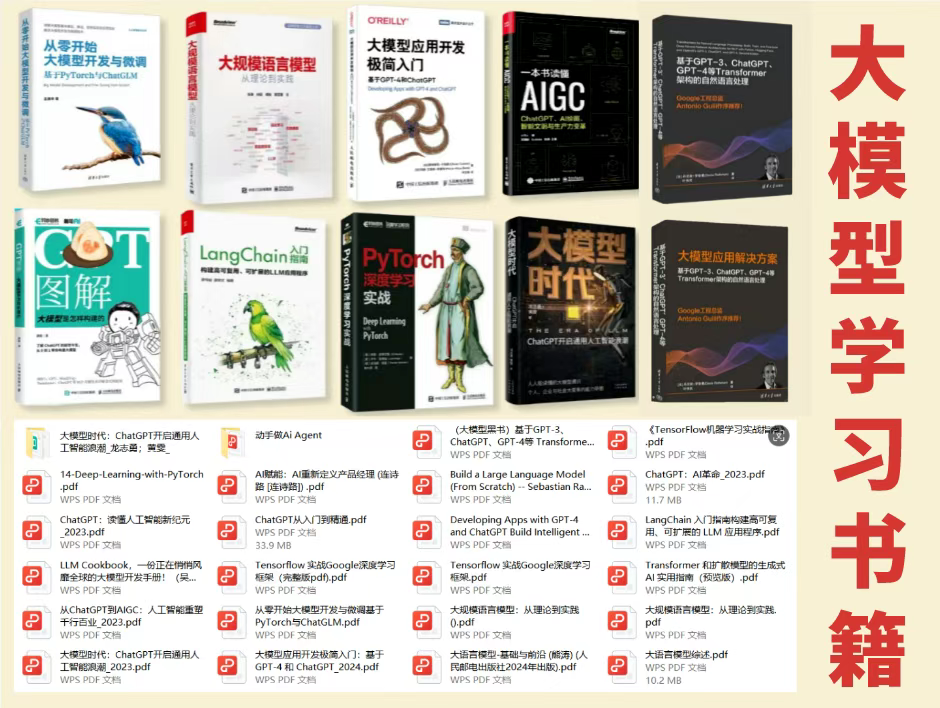
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

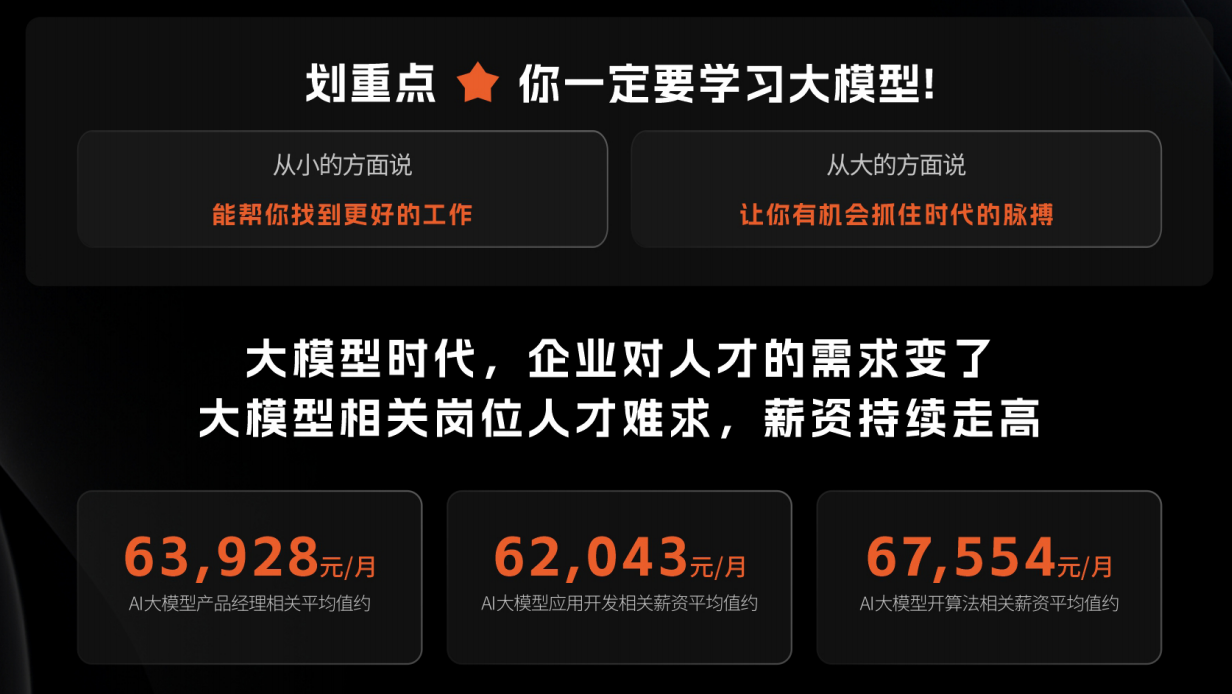
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

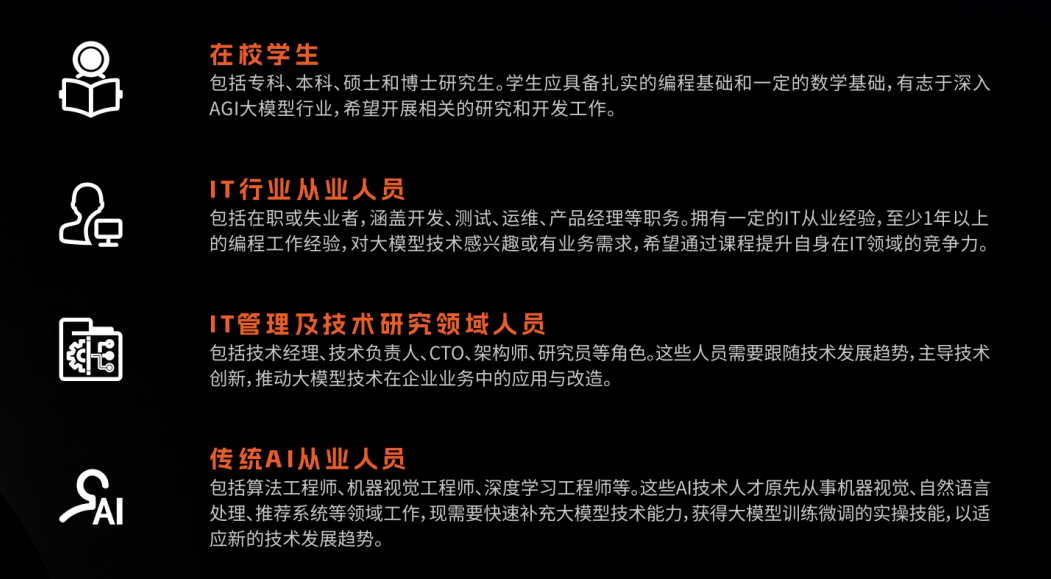
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

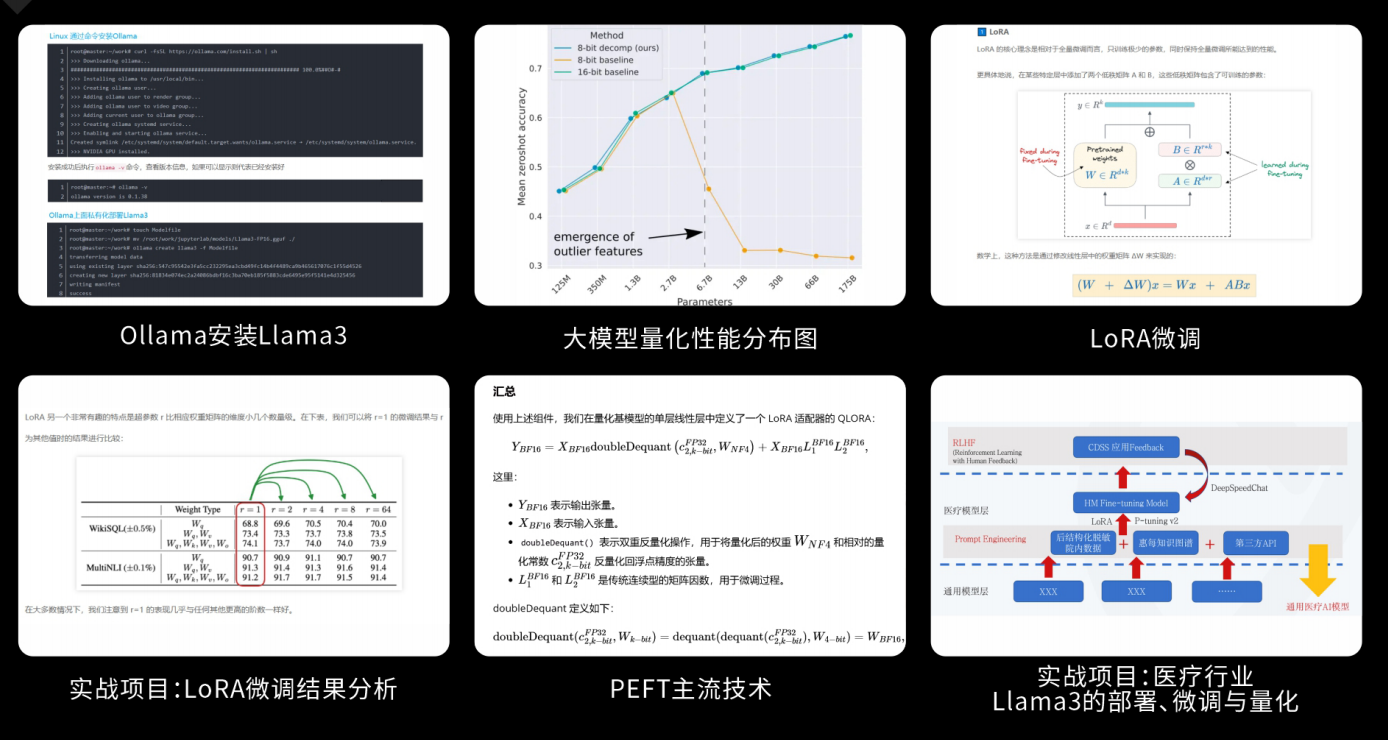
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Java接入DeepSeek大模型:从零实现流式对话+多轮会话管理(完整项目实战) emitter.completeWithError(new RuntimeException("连接DeepSeek服务超时"));private static final Set<String> BLACK_WORDS = Set.of("暴力", "色情", "政治敏感");emitter.onCompletion(() -> log.info("SSE连接完成"));emitter.onTimeout(() -> log.warn("SSE连接超时"));// 每个路由基础连接数。 阅读详情

相关推荐

11.15 分析finrl 的框架

11.15 分析finrl 的框架

yueguoqing88的博客 1086

一篇教你玩转腾讯混元大模型!

一篇教你玩转腾讯混元大模型!

Langchain的博客 3683

告别微调!腾讯提出Training-Free GRPO:无需更新参数,还能保证泛化性,成为传统RL的有力替代

传统方法在跨领域测试中表现大幅下降(如数学模型在搜索任务中准确率仅18.3%),而Training-Free GRPO通过切换经验库,在数学和搜索任务中均达到最优表现,凸显其泛化优势。,在每轮迭代中,模型根据当前经验生成多个答案,评估它们的质量,并总结出“成功经验”或“失败教训”,更新到知识库中。后续查询时,模型会参考这些经验,从而提升表现。,而是让LLM自己分析这些答案,总结出“为什么A答案比B答案好”的语义描述,形成一条条经验(例如:“在几何题中,应先验证点是否在边界内,避免无效解”)。

zenRRan的博客 967

用 SQL 分析不同用户群组留存率

一、前言 用户增长对企业非常重要,主要包括: 新增、留存、召回 。本文介绍一个实用的分析留存率的方法: Cohort Analysis (群组分析),APP的下载量越高并不是说产品就越好,产品若没有很好的留存,花费大量时间和资源来挖掘新客户也将是竹篮打水一场空。群组分析有利于衡量用户在每个漏斗的用户流失节点、用户流失数据,从而帮助你发现产品的用户的行为模式和用户增长点。从本质上讲,群组分析Cohort Analysis为你提供了一种数据驱动的方法,用群组分析Cohort Analysis方法,可以来帮助提

qq_39984050的博客 3173

电子设计实战:用MOS管手把手搭建D触发器电路(含时序分析避坑指南)

本文详细介绍了如何使用MOS管从零开始搭建D触发器电路,重点解析了建立时间和保持时间等关键时序参数对电路稳定性的影响。通过实测波形分析和避坑指南,帮助电子工程师掌握D触发器的实际搭建技巧与优化方法,提升数字电路设计的可靠性。

x1y2z的博客 1163

腾讯发布新一代大模型:混元 Turbo,湖南居然有自研大模型团队

一、腾讯发布新一代大模型:混元 Turbo2024年9月5日,在腾讯全球数字生态大会上,腾讯集团副总裁、云与智慧产业事业群COO、腾讯云总裁邱跃鹏宣布发布新一代的大模型——腾讯混元Turbo。腾讯混元Turbo采用MoE(Mixture of Experts,专家混合)架构,这一架构的采用使得模型在推理效率和成本上实现了显著优化。相比上一代产品,腾讯混元Turbo的推理效率提升了100%。这意味着...

weixin_45727359的博客 1898

AutoSAR配置与实践(基础篇)2.5 RTE对数据一致性的管理

SWC内部不同的Runnable访问共同全局变量,Runnable类似C文件中的函数,这些函数如果被放在不同Task上运行, 可能出现出现同一时刻多个函数共同运行的情况。可以通过为受影响的任务分配相同的优先级,为受影响的任务分配相同的内部操作系统资源,或者将OS的任务配置为非抢占性来实现。数据一致性:当多个操作同时读写同一个数据,由于任务的抢占,出现了数据被篡改的情况,造成非预期的数据结果。SWC内部变量保护,限定局变量的作用域在变量的作用域在SWC的不同runnable间。

nihaoljq2010的博客 2628

腾讯大模型 App 正式上线,全面接入微信 QQ 等 600+ 业务!

移动互联网有 12 亿用户,AI 头部产品却只有百万量级的日活。作者 | 王启隆责编 | 唐小引出品丨AI 科技大本营(ID:rgznai100)北京时间 5 月 30 日,基于混元大模型的 C 端 App「腾讯元宝」正式上线,各大应用商店一早就开放了下载,这款应用瞄准了大家在工作效率场景中的核心需求:信息获取 — 处理 — 生产,对应了其主打的AI 搜索 + AI 总结 + AI 写作 三大功...

AI科技大本营 2559

MiniQMT国债逆回购策略Python代码全解析

通过本文的介绍,我们不仅学习了如何在MiniQMT平台上使用Python编写国债逆回购策略,还对策略的逻辑构建、代码实现以及风险管理有了深入的了解。国债逆回购策略是一种适合初学者的低风险投资方式,希望本文能帮助你在量化交易的道路上迈出坚实的一步。

木头大左的博客 1919

【人工智能】Gemini怎么使用智能体的能力? Gemini Gems: 定制你的AI智能体

Gems 是 Gemini 的定制版本。你可以通过设定特定的指令(Instructions),让它变成你需要的专家。一旦创建,它会记住这些设定,你不需要在每次对话时重复输入背景信息。目前创建和使用自定义 Gems 通常需要订阅(Google One AI Premium 计划)。对于大多数用户来说,Gemini Advanced 中的 Gems是使用智能体能力的最直接方式。它能让你把重复性的提示词封装成一个好用的工具。

奶爸的编程之路,也就一周冷个三天 782

参数不动也能提升大模型能力?腾讯Training-Free GRPO深度解析!

腾讯优图实验室提出Training-Free GRPO方法,将LLM策略优化从参数空间迁移到上下文空间。该方法不通过梯度更新改变模型权重,而是利用LLM的反思能力从任务经验中提炼可泛化知识,作为上下文指导后续行为。这是一种非参数化、仅需推理的优化范式,实验证明其以极低成本实现了媲美甚至超越传统RL微调的效果,且保留了模型的通用性和跨领域迁移能力。

Trb701012的博客 969

RTDETR最强结构图 | 包含模型整体结构图 | 全模块展开图 | AiFi模块展开图

RT-DETR 最全结构图

Coding... 9601

大模型面经,腾讯-混元大模型面经-华5硕,差点没顶住,大模型入门学习路线与面试精要(附104G福利资源)

大模型面试全攻略:从技术面到学习路线 本文详细记录了腾讯混元大模型团队4轮技术面试的全过程,涵盖大模型架构对比(MoE vs Dense)、训练推理流程、SFT/RLHF算法原理等核心知识点。面试重点考察了LoRA、DeepSpeed ZeRO等优化方法,以及强化学习在对齐中的应用,并包含多道代码题和开放性问题。文章最后提供了系统的大模型学习路线图,分为初阶应用、高阶开发、模型训练和商业落地四个阶段,包含提示工程、RAG系统、智能体开发等实用技能,并附赠大厂内部案例和提示词模板等学习资源,帮助开发者快速提升

m0_74942241的博客 1354

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

大模型微调技术大揭秘:RLHF、GRPO、DPO与PPO,哪个更适合你?

人力资源社会保障部有关报告显示,据测算,当前,****我国人工智能人才缺口超过500万,****供求比例达1∶10。脉脉高聘发布的《2025年度人才迁徙报告》显示,在2025年1月-10月的高薪岗位Top20排行中,AI相关岗位占了绝大多数,。总结来说,当前人工智能岗位需求多,薪资高,前景好。企业为抢AI核心人才,薪资给的非常慷慨,单拿今年的秋招来说,各互联网大厂释放出来的招聘信息中,我们就能感受到AI浪潮,比如。但现实却是,仍有很多同学不知道如何抓住AI机遇,会遇到很多就业难题,比如:;

2401_84204413的博客 267

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

大模型算法:强化学习、微调与对齐

大模型、具身智能机器人、自动驾驶等技术爆火的今天,你还在传统算法的学习中停滞不前吗?

HUANGXIN9898的博客 2420

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Agent岗位终极指南!年薪60-300w,从入门到精通,看这篇就够了!

agent方向岗位年薪平均在 60~300w! 根据2025年最新招聘数据,Agent领域薪资已冲至互联网行业顶端:

m0_59163425的博客 1558

手撕代码+大模型深度解析,27届暑期失利?秋招冲刺必备!

技术面试精要:大模型与AI应用开发核心考点 面试重点: 模型原理:深入掌握Transformer架构(自注意力、FFN、MoE等)、微调技术(LoRA/DPO)及训练优化(PPO/GRPO显存分析) 算法实践:包括路径总和、动态规划等编码题,以及KL散度、损失函数等数学推导 业务落地:聚焦RAG、Agent开发、模型微调三大核心能力,需展示项目中的技术选型与业务价值闭环能力 行业趋势: 2026年AI应用层爆发,大模型工程师缺口显著(平均月薪7.8w)。企业急需掌握垂类模型微调、智能体构建及检索增强生成(R

2301_80239908的博客 245

大模型岗位别乱冲!这4个热门赛道里,最香的其实是“应用开发”

AI大模型领域四大热门方向解析 随着AI行业爆发式增长,大模型领域岗位需求激增,主要分为四个方向: 算法研发与预训练:技术门槛最高,专注模型训练与优化,适合高学历研究型人才,岗位集中于大厂实验室。 模型对齐与后训练:通过微调提升模型实用性,需求快速增长,适合具备工程与强化学习背景的从业者。 推理工程与部署:负责模型落地优化,需求稳定,需掌握C++/Python及分布式系统,工程能力要求高。 应用开发:岗位最多且门槛友好,聚焦商业场景落地,需掌握RAG、Agent开发等技能,适合转行者快速切入。 当前AI人才

2401_84495872的博客 376

从零到实战:手把手教你构建LLM的四大核心阶段!

大型语言模型(LLM)的构建包含四个关键阶段:预训练阶段通过海量语料学习语言基础;指令微调阶段使模型具备对话和任务执行能力;偏好微调阶段(RLHF)基于人类反馈优化回答质量;推理微调阶段针对数学等任务通过正确性反馈强化性能。当前AI应用层需求爆发,掌握RAG、Agent和微调技术的开发者成为稀缺人才,相关岗位薪资显著高于行业平均水平。企业正加速布局大模型应用开发,建议开发者把握技术红利期,通过系统学习构建核心竞争力。

m0_65555479的博客 365

零经验拿下第一份大模型实习,笨办法全公开

零经验拿下第一份大模型实习,笨办法全公开

2301_81940605的博客 693

从随机初始化到智能对话:揭秘大语言模型LLM的五大进阶阶段!

大语言模型(LLM)训练分为四个关键阶段:1)随机初始化模型;2)预训练阶段通过海量语料学习语言基础;3)指令微调使模型具备对话能力;4)偏好微调(RLHF)和推理微调分别优化回答质量和逻辑推理能力。完整训练流程使模型从零知识逐步发展为能理解指令、符合人类偏好并解决复杂问题的AI助手。当前AI应用层人才需求旺盛,掌握RAG、Agent开发和微调技术成为核心竞争力。

libaiup的博客 228

大模型微调:手把手教你提升AI性能,拿高薪Offer的必备技能!

本文系统介绍大模型微调技术,重点解析监督微调(SFT)和基于人类反馈的强化学习(RLHF)两大核心方法。SFT部分涵盖全参微调与高效参数微调(PEFT),详细讲解Lora等主流技术;RLHF部分深入剖析奖励模型训练、Bradley-Terry模型及PPO算法等关键环节。文章还提供常见面试问题解析,帮助读者快速掌握技术要点。随着AI行业爆发式增长,掌握大模型微调技术将成为求职和科研的重要竞争力,相关岗位薪资涨幅显著,人才缺口巨大。文末附赠AI学习资源包,助力读者把握AI发展机遇。

2401_85343303的博客 262

2026年最新大模型学习路线:从入门到精通的全面指南

**数理基础** * **微积分/线性代数**:理解梯度下降、矩阵运算(推荐:3Blue1Brown《线性代数本质》) * **概率统计**:掌握分布、假设检验(资源:可汗学院概率统计) * **计量经济学**(可选):用于经济/金融数据分析

Trb701012的博客 707

收藏!AI时代程序员如何逆袭?4大转型方向助你升职加薪!大模型算法入门必看:11个方向深度解析(含收藏福利)

2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

m0_48891301的博客 333

我刷了83套AI_Agent面试题(112轮面试),发现一个

AI Agent岗位爆火,面试避坑指南来了! 当前AI领域最热门的就业方向是Agent,招聘平台每天新增数百个相关职位,薪资12K-70K不等。通过对83套真实面试题的分析发现,面试官更关注实操细节而非理论概念,高频考点包括微调对齐(DPO、LoRA)、模型架构(Transformer)、RAG检索(BM25)等。行业数据显示,我国AI人才缺口超500万,大厂AI岗位平均年薪达36.9万,但缺乏实战经验者易踩坑。建议求职者通过真题反推项目实践,针对性补齐短板,并附有免费AI学习资源包助力入门。 (摘要字数:

2401_85375151的博客 221
上一篇: LLM智能体终极指南!驱动企业软件革命,从原理到落地,收藏这篇就够了!
下一篇: 彻底搞懂LLM+RL+Task!构建模型原生智能体,这篇“保姆级”统一公式解析就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值