保姆级拆解!从RLHF到RLVR,大型推理模型技术全突破!原理+实战+避坑,一篇吃透!

无监督RLVR技术:强化学习与视觉表征的融合创新 无监督强化学习与视觉表征(RLVR)是机器学习领域的前沿技术,通过结合强化学习的决策能力和视觉表征的自监督学习优势,为模型训练提供了高效的数据增强方案。其核心在于双通道学习系统:视觉编码器提取特征,强化学习智能体优化策略。这一技术显著提升了数据效率和表征鲁棒性,特别适用于大规模语言模型(LLM)训练。实际应用中,Swin Transformer作为视觉编码器表现优异,配合PPO算法能实现最佳迁移效果。RLVR技术在视频理解、具身智能等场景展现出强大潜力,是当前AI工程实践中的重要突破。 阅读详情

导读:近期,一篇名为《A Survey of Reinforcement Learning for Large Reasoning Models》的综述性文章系统梳理了强化学习(RL)在前沿大型推理模型(LRM)中的应用、挑战与未来方向。本文旨在为领域内的研究者与从业者,提供对该篇综述的专业化、结构化解读,提炼其核心技术脉络与前沿洞见。

一、核心论点:从语言模型(LLM)到推理模型(LRM)的范式跃迁

当前,大型语言模型(LLM)正经历一次关键的能力跃迁,即从主要关注生成流畅、连贯的文本,转向解决需要复杂逻辑、规划与反思的推理任务。该综述明确指出,强化学习(RL)是驱动这一范式转变的核心方法论。

与早期用于对齐人类价值观的强化学习(如 RLHF)不同,当前的前沿趋势是基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)。RLVR 的目标不再是主观的“对齐”,而是客观的“正确性”,它为模型能力的扩展开辟了除预训练数据和参数规模之外的第三条路径——通过强化“思考过程”来提升推理性能。

二、强化学习方法论的演进路径

综述将 RL 在大模型领域的应用演进划分为三个主要阶段,每一次迭代都标志着目标与方法的深化。
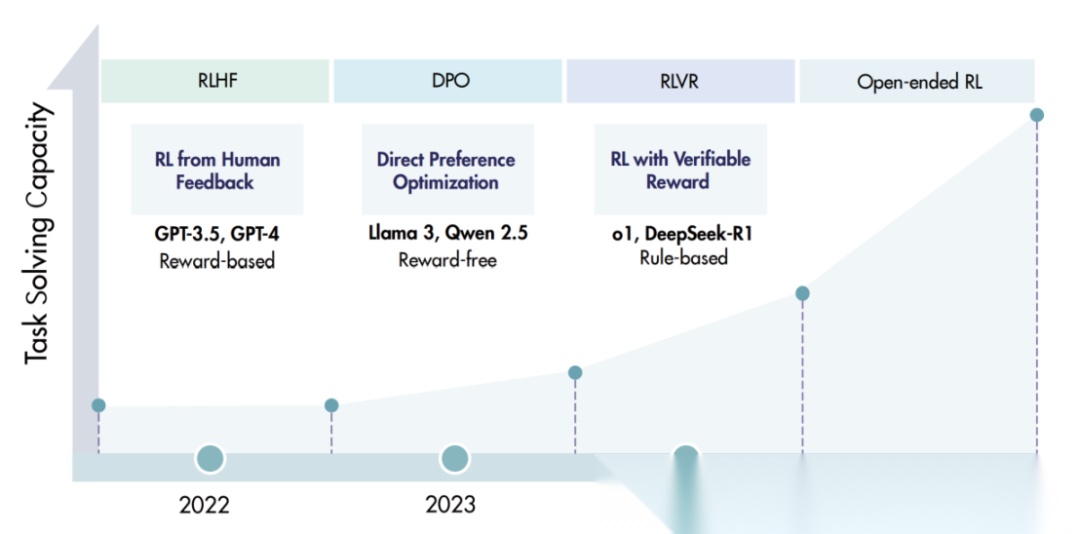
图1:从 RLHF 到 RLVR,RL 的应用目标从主观对齐转向客观推理,显著提升了模型的任务解决上限

第一阶段:RLHF (基于人类反馈的强化学习)

核心目标:使模型的输出符合人类的偏好与价值观。

技术路径:通过人类标注员对模型输出进行排序,训练一个奖励模型(Reward Model),该模型作为人类偏好的代理,再通过 PPO 等算法优化 LLM 策略。

代表模型:GPT-3.5, GPT-4。

第二阶段:DPO (直接偏好优化)

核心目标:提升对齐效率与稳定性。

技术路径:绕过显式训练奖励模型的步骤,将偏好数据直接转化为策略优化的损失函数,简化了对齐流程。

代表模型:Llama 3, Qwen 2.5。

第三阶段:RLVR (基于可验证奖励的强化学习)

核心目标:直接激励并提升模型在可客观评估任务上的推理能力。

技术路径:奖励信号来源于确定性的、可被程序自动验证的外部环境。例如,数学问题的答案正确性、代码的单元测试通过率等。

代表模型:OpenAI o1, DeepSeek-R1。

三、RLVR 的核心技术组件拆解

综述系统性地将 RLVR 的技术栈分解为三大基础组件,这构成了当前构建大型推理模型的标准流程。
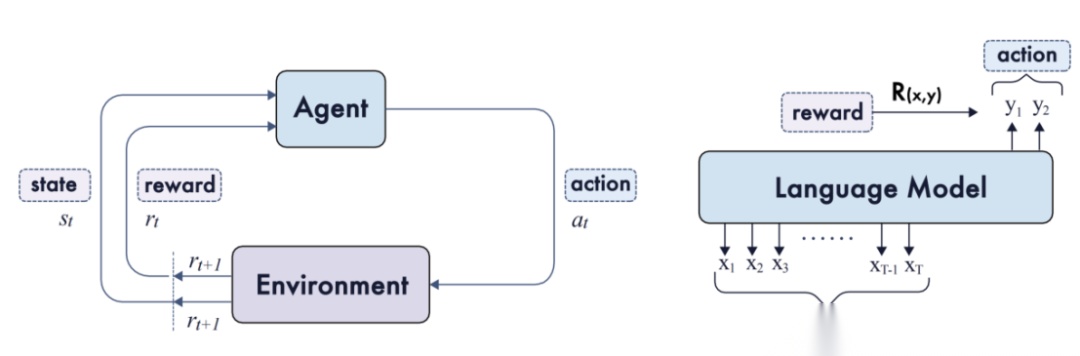
图2:强化学习基本组件与作为智能体的语言模型

1. 奖励设计 (Reward Design):定义优化的目标信号

奖励函数是 RL 的灵魂,其设计的优劣直接决定了模型能力的上限。

可验证奖励 (Verifiable Rewards):RLVR 的基石。在数学、代码等领域,利用自动化的验证器(Verifier)提供最可靠的训练信号。实践中通常结合准确率奖励与格式奖励。

生成式奖励 (Generative Rewards):针对缺乏客观评价标准的开放域任务,利用一个强大的判别模型(通常是另一个 LLM)来生成评估反馈,作为奖励信号。

密集/稀疏奖励 (Dense/Sparse Rewards):这是一个关键的权衡。稀疏的最终结果奖励(Outcome Rewards)易于定义但信噪比低;而密集的过程奖励(Process Rewards)能提供更细粒度的指导,但设计和标注成本高昂。

2. 策略优化 (Policy Optimization):执行参数更新的算法

获取奖励后,模型需通过优化算法来更新其策略网络。

主流算法:目前,以GRPO (Group Relative Policy Optimization) 为代表的“无批评家”(Critic-Free)算法已成为主流。

核心机制:GRPO 放弃了传统的、需要额外训练一个价值网络(Critic)的 Actor-Critic 框架。它通过在每个推理步骤中对一组(Group)生成的候选答案进行评估,并计算相对于该组均值的优势(Advantage),从而构造出低方差的策略梯度。这显著降低了训练的复杂度和计算开销,提升了大规模训练的可行性。

3. 采样策略 (Sampling Strategy):提升数据效率的机制

RL 的样本效率高度依赖于如何生成用于策略更新的轨迹(Trajectory)。

动态采样 (Dynamic Sampling):核心思想是实施一种课程学习(Curriculum Learning)。在训练过程中,系统会动态评估每个任务的难度,优先采样那些模型表现处于“中等水平”(即有一定概率成功,但尚未完全掌握)的任务。这避免了在过易或过难的样本上浪费计算资源,从而最大化了每个采样样本的学习效率。

四、深度剖析:RL在关键领域的应用

理论的进步最终要通过实践来检验。该综述在第6节详细阐述了基于RL训练的推理模型如何在多个前沿领域推动技术边界,展现出巨大的应用潜力。

1.编程与软件工程 (Coding Tasks & Software Engineering)

核心应用:RL极大地提升了模型在可验证编程任务上的性能,从解决算法竞赛题,到自动修复代码BUG、提升代码质量,甚至在整个代码库(Repository)层面进行代码生成与维护。

关键机制:利用单元测试、编译器反馈等作为客观、可扩展的奖励信号,通过RLVR闭环优化代码生成策略。

2.智能体任务 (Agentic Tasks)

核心应用:打造能自主使用外部工具(如搜索引擎、计算器、API)的AI智能体,以完成多步骤、交互式的复杂任务,如网页浏览、信息搜集、操作图形界面(GUI)等。

关键机制:RL使智能体能够通过与环境的“试错”来学习最优的工具调用序列和策略,这是通向通用人工智能的重要一步。

3.多模态任务 (Multimodal Tasks)

核心应用:增强模型在图像、视频和3D空间中的理解与生成能力,特别是在需要空间感知和跨模态语义对齐的任务上。

关键机制:RL被用来优化模型的注意力机制和生成策略,例如,通过奖励函数引导模型生成在空间关系、物体数量上更准确的图像,或是在长视频中进行更连贯的事件推理。

4.机器人技术 (Robotics Tasks)

核心应用:解决机器人操作中的核心挑战——数据稀缺和泛化能力差。RL被应用于训练视觉-语言-动作(VLA)模型。

关键机制:允许机器人在模拟环境中通过简单的成功/失败奖励进行自主探索和学习,从而掌握新技能,大幅降低了对昂贵的人工遥操作数据的依赖。

5.医疗领域 (Medical Tasks)

核心应用:在可验证的医疗任务(如医学选择题、影像报告结构化)和开放式生成任务(如生成诊断报告)中提升模型的准确性和推理能力。

关键机制:对于可验证任务,直接使用客观正确性作为奖励信号;对于开放式任务,则探索利用规则、专家知识库或模型生成的评估来构造奖励,推动模型生成更可靠、更专业的医疗文本。

五、前沿争论与未来展望

尽管 RLVR 已取得显著成功,但综述也指出了领域内亟待解决的几个根本性问题。
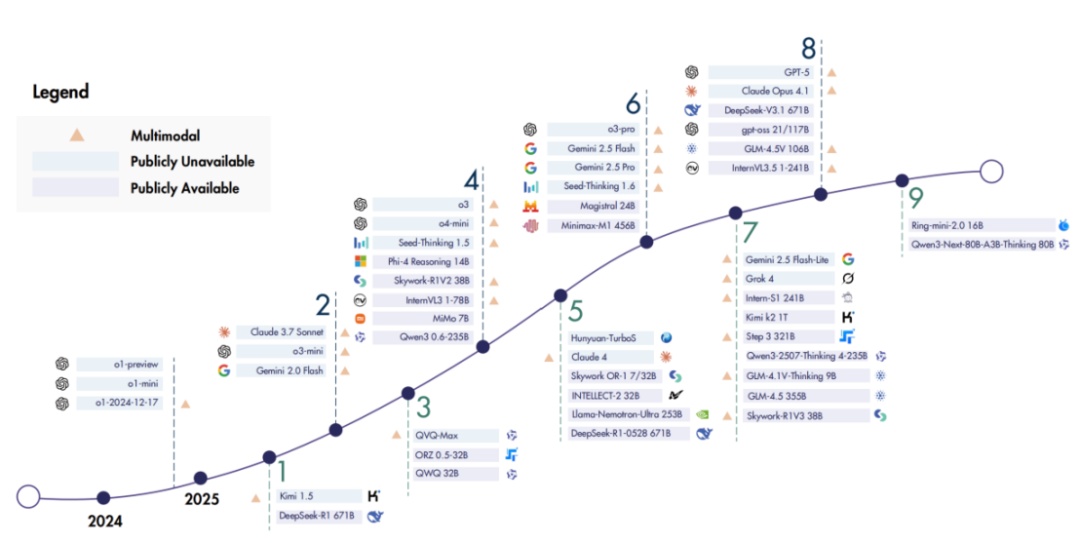
图3:近年来基于RL训练的推理模型发展迅猛,但也带来了新的挑战

强化学习的角色:是“磨砺”还是“创造”? RL 究竟是在激发模型预训练阶段已具备的潜在能力(Sharpening),还是在发现全新的、超越预训练数据分布的推理策略(Discovery)?目前学界对此尚无定论。

RL 与 SFT 的边界:在提升模型泛化能力方面,RL 和监督微调(SFT)的优劣关系复杂。普遍认为 RL 更能促进“举一反三”的泛化能力,而 SFT 更倾向于“死记硬背”。然而,最佳实践往往是两者的结合。

未来方向:

将 RL 前置到预训练阶段:探索在模型构建的早期就引入强化学习信号。

高效推理:训练模型学会根据任务难度自适应地分配计算资源(思考时间)。

多智能体与机器人应用:将单体智能扩展到多体协作与物理世界交互,是 LRM 的终极目标之一。

结论

该综述为我们描绘了一幅清晰的技术路线图:强化学习,特别是 RLVR,正成为推动 LLM 向 LRM 演进的核心引擎。它将 AI 的训练范式从被动的模仿学习,推向了主动的、基于环境反馈的探索式学习。理解并掌握这一技术脉络,对于把握下一代人工智能的发展方向至关重要。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
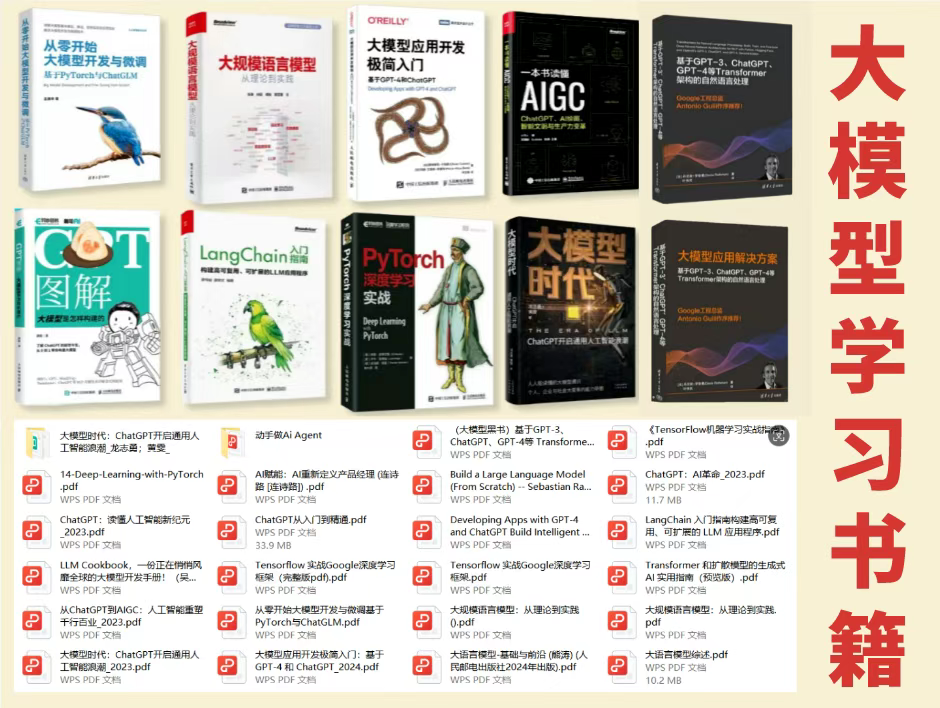
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

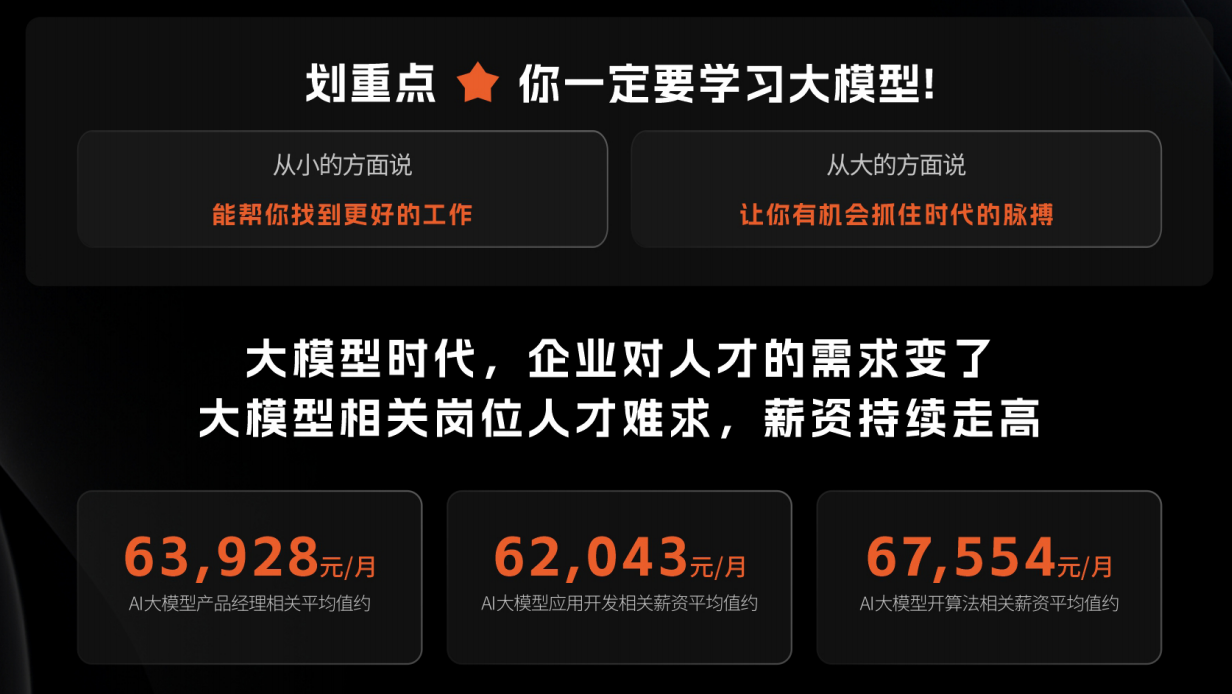
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

适合人群

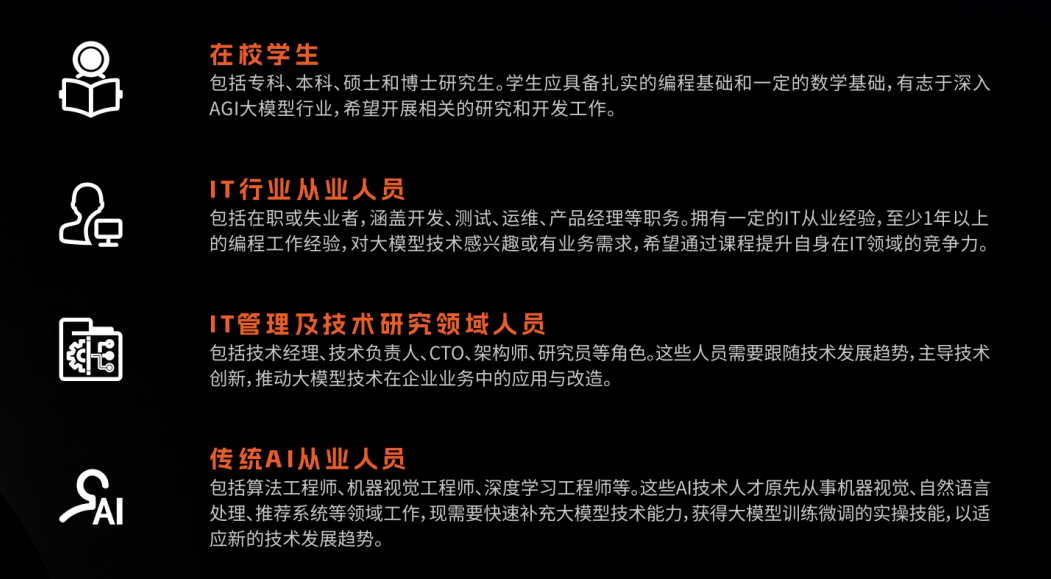
  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

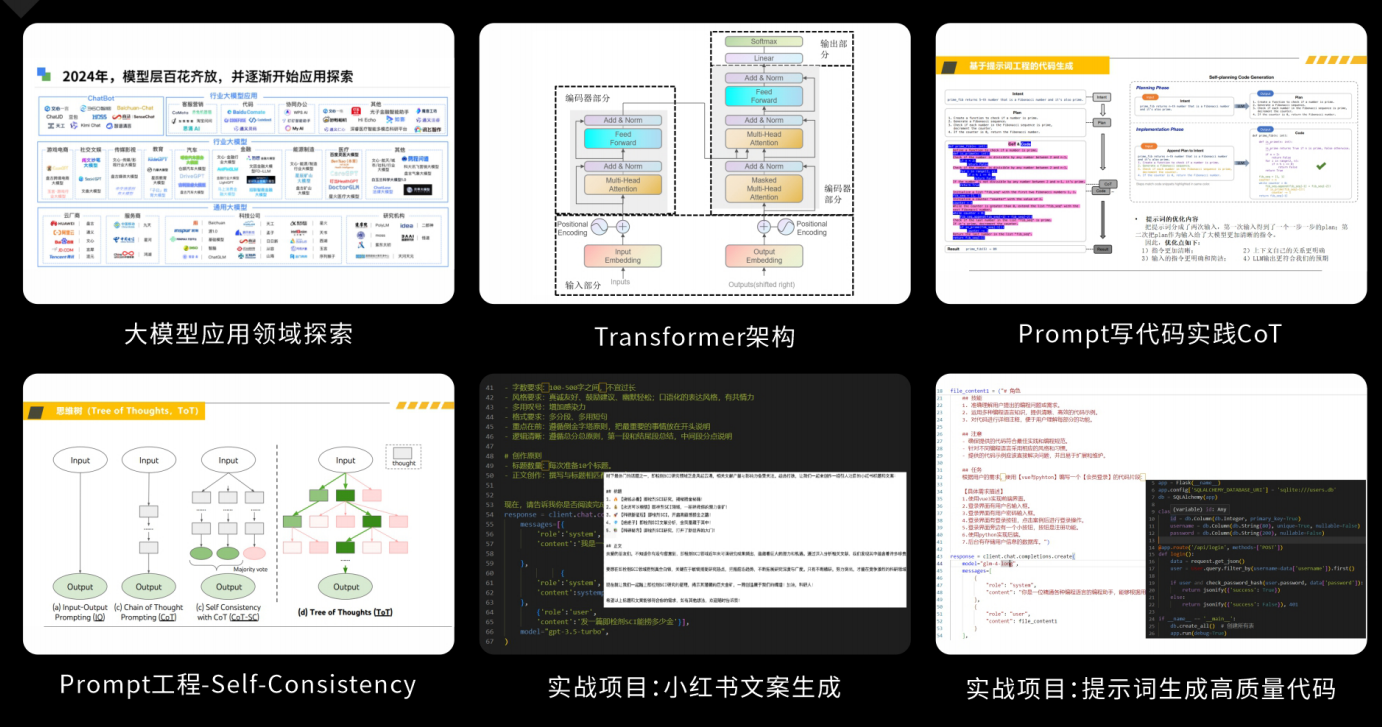
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

【参数配置】OpenClaw 的破解之道(Doom Loop) 本文深入解析了OpenClaw中的Doom Loop(死循环)问题及其应对策略。主要内容包括: Agent Loop的核心概念:基于ReAct范式,OpenClaw通过"思考-行动-观察"循环执行任务,但可能陷入无进展的死循环。 Doom Loop现象:Agent持续执行但任务进度为零,常见于四种工具调用场景:相同调用重复执行、调用不存在工具、轮询工具卡死、操作交替振荡。 OpenClaw的防御机制: 第一道防线:重试端断路器,通过上下文压缩熔断(最多3次)和总重试次数熔断(32-160次)防止无限重试。 阅读详情

相关推荐

逆向分析美团外卖mtgsig3.0签名算法:从抓包到算法还原实战

在移动应用开发与安全领域,API接口签名是保障数据传输完整性与身份验证的核心机制。其基本原理是通过特定的算法,将请求参数、时间戳等数据与密钥结合,生成唯一的签名串,服务器通过验证签名来识别请求的合法性。这项技术的核心价值在于防止数据篡改、重放攻击和未授权访问,是构建安全客户端-服务器通信的基石。在实际应用中,签名算法广泛应用于电商、社交、金融等各类App的接口保护场景。本文以美团外卖App的mtgsig3.0签名为具体案例,详细拆解了其生成逻辑。通过结合Frida动态调试与Jadx静态分析,文章深入探讨了如

weixin_29325515的博客 1250

RLVR:2025年大模型训练的新范式,解锁模型推理能力

RLVR(基于可验证奖励的强化学习)在2025年成为大模型训练新范式。与传统RLHF依赖人类主观反馈不同,RLVR使用自动化、客观的奖励信号。RLVR使模型展现出"推理感",因为模型通过自我发现问题解决路径,而非简单模仿人类。训练重心从"预训练+对齐与修饰"演变为"预训练+对齐与修饰+长时间RLVR",形成新的规模规律,推理能力与测试时计算量直接挂钩。

Trb701012的博客 1704

A Mathematical Framework for Transformer Circuits—(二)

transformer数学理论框架

qq_42208244的博客 758

浅聊RLVR

首先,RL的根本是提高采样效率,但是传统的RL需要依赖人类标注或者复杂的奖励模型,但是RLVR改变了这点,他不需要上述的条件,而是通过规则化验证器生成二元反馈(0/1)。根据任务的类型,可验证类型分为三类:1、正确性验证:通过模型输出和标准答案做匹配来生成奖励。2、执行验证:通过代码解释器执行生成的代码,根据单元测试结果提供奖励。3、可验证约束:强制模型遵循输出格式或者拒绝不当的请求,违法规则奖励则为0.

egglikeFe的博客 1076

SPI 协议帧格式深度解析:从 8 位数据到 16 位扩展的 3 种模式

本文深入解析SPI协议的帧格式,涵盖从8位标准到16位扩展的三种模式。通过详细讲解SPI时钟模式、数据宽度配置及实际应用案例,帮助开发者掌握SPI外设的深度定制能力,提升嵌入式系统开发效率。特别适用于连接传感器、存储器和显示器等高速通讯场景。

weixin_34110749的博客 346

CV领域交叉注意力机制:QKV在图像特征增强中的核心作用解析

本文深入解析了CV领域中交叉注意力机制的核心组件QKV在图像特征增强中的关键作用。通过通俗类比和实战案例,阐述了Q(查询)、K(键)、V(值)如何协同实现动态权重分配,从而在目标检测、图像分割与生成等任务中显著提升模型性能与语义对齐能力。

weixin_29194817的博客 444

RLVR(可验证奖励的强化学习):大模型后训练的客观评估策略

RLVR(可验证奖励的强化学习)是当前主流的大模型训练方法,通过预定义规则(如数学答案匹配、代码测试)提供二元奖励信号,替代传统RLHF的主观评估。其核心优势在于客观性、易设计性和防作弊能力,广泛应用于数学推理、代码生成等确定性任务。构建RLVR需关注数据准备、奖励函数设计和验证体系,但存在领域依赖性强和可能窄化模型能力的局限。未来将聚焦垂直领域优化和工业级实施方案,推动技术实际落地。

AlgoCraft 1839

ROS新手必看:5分钟搞定URDF小车建模(附Rviz可视化调试技巧)

本文为ROS新手提供了快速构建URDF机器人模型的实战指南。通过一个完整的两轮差速小车建模案例,详细解析了URDF的核心语法、Rviz可视化调试技巧以及常见问题排查方法,帮助初学者快速掌握ROS机器人建模与可视化调试的核心技能。

weixin_29079643的博客 250

干货|清华NLP实验室突破性创新:RLVR技术,破解通用领域推理难题!

清华大学NLP实验室提出RLPR技术,突破现有强化学习局限。该技术通过参考概率奖励机制(PR)捕捉模型内在评估能力,无需领域特定验证规则,仅需一次前向传播即可生成高质量奖励。研究显示,PR奖励质量显著优于传统方法,在0.5B规模即达0.91 AUC值。RLPR还创新性地引入动态过滤机制,提升训练稳定性。实验证明,该技术在Gemma、Llama、Qwen等主流模型上均能稳定提升推理能力,为强化学习在通用领域的应用开辟了新路径。相关代码、模型和数据已全面开源。

2401_84494441的博客 1013

用Bus Hound和MIDIOX抓包分析USB MIDI数据流:从硬件接口到软件解析的完整实战

本文详细介绍了如何使用Bus Hound和MIDIOX工具抓包分析USB MIDI数据流,从硬件接口到软件解析的完整实战过程。通过解析MIDI协议、捕获Note On/Off事件、控制变更消息等实例,帮助开发者深入理解音乐数字接口的底层通信机制,并提供了常见问题的解决方案和调试技巧。

weixin_42692935的博客 406

SpringBoot+Maven打包实战:把项目变成SDK供其他团队调用

本文详细介绍了如何将SpringBoot项目改造并打包成可被其他项目依赖的SDK。通过调整Maven配置,剥离SpringBoot父依赖与启动类,并定制打包插件,最终生成标准的JAR依赖库,实现从“可执行应用”到“组件化SDK”的优雅转变,便于团队间功能复用。

assembly8low的博客 829

强化学习(RLVR)真的能提升大语言模型的推理能力吗?——解读最新研究

Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?

阿正的梦工坊 1071

EB TRESOS 29.0.0安装教程用于MCAL配置开发

本文介绍的搭建基于NXP官网提供EB软件,进行基于标准AUTOSAR软件底层驱动配置的开发

qq_53260940的博客 1882

【大模型技术学习】RLVR:可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards)

RLVR是在传统RL框架基础上,增加奖励验证模块的一类算法。在智能体与环境交互过程中,对每一步奖励的合法性、合理性进行实时验证,仅将通过验证的“可信奖励”用于价值更新和策略优化。合法性验证:奖励是否符合预设规则(如安全约束、业务合规要求);合理性验证:奖励是否与智能体的真实贡献匹配(避免因环境噪声或无关行为获得奖励);追溯性验证:奖励的计算过程可回溯、可复现(记录奖励生成的关键参数、环境状态)。RLVR通过引入奖励验证机制,为强化学习的可靠落地提供了新的解决方案。

专注:太空算力、AI infra、异构调度、大模型成本工程 496

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

程序员必藏!大模型训练革命:从RLHF到RLVR的范式转换与未来突破!

本文解析了大模型训练从RLHF到RLVR的范式革命。RLHF依赖人类偏好,存在过度优化瓶颈;RLVR通过可验证奖励(如数学正确性)实现对齐客观真理,支持无限扩展。GRPO算法作为RLVR高效引擎,移除价值模型,利用群体相对表现进行优化。DeepSeek R1、Kimi K1.5和Qwen 3等模型展示了高质量SFT、数据筛选和高效基础设施的重要性。RLVR为AGI发展开辟新道路,通过自我验证环境实现AI能力的持续跃升。

libaiup的博客 1295

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

强化学习对齐三种范式对比:RLHF vs RLAIF vs RLVR

RLHF 的 reward 是主观近似(approximation)人类意图的一个 proxyRLVR 的 reward 是客观可验证(verifiable)的执行性结果或逻辑真值选择标准推荐方法有自动验证机制、标准明确RLVR目标主观、无法形式化RLHF。

ZacharyGz的博客 7088

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

VeriFree:无需Verifier的通用RL框架

VeriFree:无需Verifier的通用RL框架

KI的博客 1105

【AI论文】隐形枷锁:为何RLVR无法摆脱其起源之缚

摘要: 本研究探讨了可验证奖励强化学习(RLVR)在提升大型推理模型中的潜在局限性。理论上,RLVR受限于基础模型支持集,无法生成初始概率为零的解决方案,仅作为保守的重新加权机制运作。实证分析表明,尽管RLVR能提高pass@1指标,但在高采样预算下会缩小探索范围,导致无法获取基础模型原本能解决的正确答案。研究还发现,RLVR在标记层面熵增加的同时,答案层面熵降低,表明解决方案趋向收敛于更小集合。这些发现揭示了RLVR在拓展推理边界方面的局限性,建议未来结合显式探索机制或混合策略以突破约束。论文链接:250

m0_66899341的博客 1361

LLMs之RLVR:《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base

​ LLMs之RLVR:《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》翻译与解读 《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》翻译与解读 地址 论文地址:[2

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1988

揭秘语言模型后训练:指令微调、偏好调优与强化学习的深度解析

人工智能领域的语言模型(Language Models)如GPT、Llama等,已经成为推动技术变革的核心力量。然而,预训练后的模型并非完美,它们仍需通过后训练(Post-training)来进一步优化性能,满足实际应用需求。本文将深入解析后训练的核心技巧,包括指令微调(SFT)偏好调优(DPO)和强化学习(RLVR),结合TÜLU 3的创新实践,展示如何通过后训练让模型更强大。后训练是指在语言模型大规模无监督预训练完成后,进一步针对特定任务、场景或用户需求进行的训练优化过程。提升模型的指令理解。

qq128252的博客 2218

零基础也能看懂!强化学习入门指南:从RLHF到RLVR全梳理

强化学习(RL)已经成为当今 LLM 不可或缺的技术之一。从大模型对齐到推理模型训练再到如今的智能体强化学习(Agentic RL),你几乎能在当今 AI 领域的每个领域看到强化学习的身影。

2401_85325726的博客 1811

从DeepSeek-R1到通义R1-Omni!中国AI齐头并进

随着DeepSeek R1的推出,强化学习在大模型领域的潜力被进一步挖掘。Reinforcement Learning with Verifiable Reward (RLVR) 方法的出现,为多模态任务提供了全新的优化思路。

大模型研究中心 709

RLHF与RLVR:强化学习在AI训练中的两大范式对比

RLHF和RLVR作为强化学习在AI训练中的两大范式,各自具有独特的优势和适用场景。RLHF通过捕捉人类的主观偏好来优化模型输出,使模型更加贴近人类期望;而RLVR则通过客观、可验证的奖励信号来激励模型发展出复杂的推理能力,确保模型在专业任务中保持高精度。在实际应用中,我们可以根据具体任务的需求和特点选择合适的训练范式,以充分发挥强化学习的潜力。希望今天的分享能够帮助大家更好地理解RLHF和RLVR的区别与联系,为大家的AI训练之路提供有益的参考。

Mamba的博客 809

RLVR强化学习训练成本暴降98%!12种PEFT方法大PK,结果让人意外...

第一次系统评测了PEFT方法在强化学习中的表现。停用标准LoRA,改用结构变体:DoRA、MiSS、AdaLoRA在RLVR场景下明显更强,DoRA甚至能超越全参数微调。如果你还在用标准LoRA训练强化学习模型,那真的该升级工具箱了。远离SVD初始化的坑:PiSSA和MiLoRA在强化学习中会翻车,原因是它们和RLVR的"非主成分更新"特性存在根本性冲突。如果想优化初始化,学LoRA+调学习率就好,别折腾SVD分解。保持适度的参数量:极端压缩(VeRA、IA³、Rank-1)会让模型"饿"到学不动。

Python_cocola的博客 977

震惊!强化学习训练后,大模型推理“天花板”反而降低了?清华研究揭示RLVR局限性

•••Yang Yue, Zhiqi Chen, Rui Lu, Andrew Zhao, Zhaokai Wang, Yang Yue, Shiji Song, Gao Huang (清华大学 LeapLab, 上海交通大学)••问题A:RL提升了找到正确路径的效率;•问题B:RL可能丢失基础模型中存在的正确路径,导致探索范围缩小。• 右图:随着RL训练进行,pass@1(平均性能)提升,但pass@256(能力边界)下降。

AI生成曾小健3 1459

【论文阅读】A Survey of Reinforcement Learning for Large Reasoning Models

在本文中,我们综述了利用强化学习赋能大型语言模型进行推理的近期进展。强化学习在推动 LLM 能力前沿方面取得了卓越的成功,尤其是在解决数学和编程等复杂的逻辑任务上。因此,强化学习已成为将 LLM 转变为语言推理模型 (LRM) 的一种基础性方法。随着该领域的飞速发展,将强化学习进一步扩展应用于 LRM 不仅在计算资源方面,也在算法设计、训练数据和基础设施方面面临着基础性挑战。为此,我们有必要及时回顾该领域的发展历程,重新评估其发展轨迹,并探索各种策略来增强强化学习的可扩展性,以期最终迈向超级人工智能 (AS

bylander的博客 2991
上一篇: AI知识图谱5分钟速成!无需人工标注,文本数据秒变智能网络,一篇讲透原理与实战!
下一篇: 想让LLM智能体真正“会思考”?先吃透这套核心架构与推理范式!深度拆解,一篇就够!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值