彻底搞懂大模型!从零拆解LLM核心原理:海量文本统计+神经网络拟合,万字长文一篇通!

大模型核心技术原理: Transformer架构详解 四是,通用语言模型,如 GLM,该模型结合了自回归和自编码两种形式的模型,举个例子,“123456”是一串输入的序列,现在把 “3”、“5”、“6” 挖空,让模型去学习,那么,挖空以后换成一个 “ mask token” 告诉模型这个地方遮掉了一些内容,现在需要去预测出来遮掉的内容。一是,自编码模型,如 BERT,简单讲就是给到一句话,然后把这句话的内容挖空,当问及挖空的内容时,就把内容填回去,这其实是典型地用来做一个自然语言理解的任务,但做生成任务是非常弱的;本文由博客一文多发平台。 阅读详情

如果零散地看大语言模型的相关描述:有人说大模型是预测下一个词的模型,有人说大模型是将词转化为向量,有人说大模型运用了自注意力机制,还有人指出大模型采用无监督学习和强化学习……让人看得眼花缭乱。

这篇文章就把这些说法归归类,结构化地把大模型讲讲明白。

引言

当前几乎所有主流的大语言模型(LLM,Large Language Model)都基于 2017 年 Google 团队发表的一篇论文《注意力就是一切》(Attention Is All You Need)中提出的 Transformer 架构。像 GPT(Generative Pre-trained Transformer)这一类模型,则在训练流程上采用了「预训练 + 微调」的范式,成为当代广泛使用的生成式模型家族。

多模态(Multimodal)是近年的热门方向,目标是让模型能够顺滑处理文本、图像、音频、视频等多种输入形式。本文主要讲解以文本为主的大模型基础原理,但这些底层机制在多模态模型中也是通用或可扩展的。

人工智能体(Artificial Intelligence Agent)指的是把大模型作为执行器,让它代替人类完成具体事务,而不只是聊天或给出建议。比如自动预订旅行的机票与酒店、搭建并部署可运行的网站、自动创作并发布自媒体内容等,这类是对底层模型的高级应用,但仍高度依赖底层模型提供的能力与接口。
从产品角度看,豆包、DeepSeek、元宝等应用,或者基于它们背后模型的 API,都是大模型产品的不同呈现。

{

(DeepSeek的API接口参数,右滑查看完整内容)

content:(一拍桌子)哎哟,这话说的,您这是跟核桃过不去啊!

(DeepSeek的API接口返回内容,部分结构已省略)

一个典型的大模型产品可以分为三层:底层的模型本身(海量参数)、中间的调用/服务框架(负责并行、分片、调度、缓存等),以及面向用户的上层应用界面(网页、App 或 API)。用户能看到的,一般只有最上层的界面。
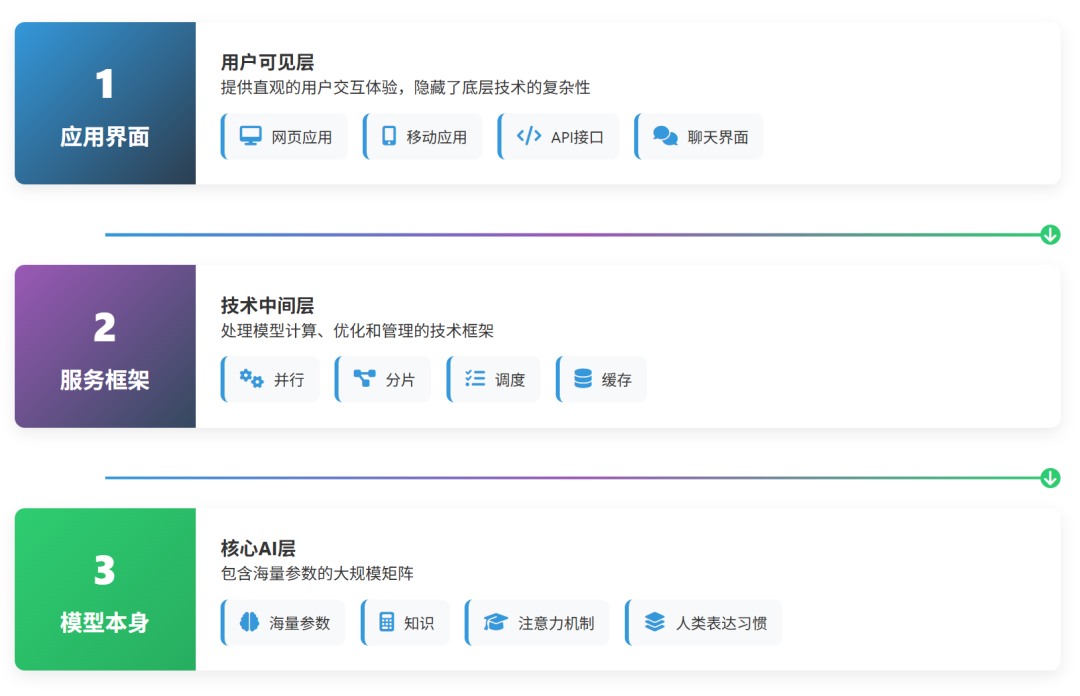
从物理形态上讲,模型本身就是若干训练好的矩阵,矩阵元素是浮点数,这些参数在训练阶段被优化出来并保存在磁盘/内存中。

调用模型时,系统会把输入(文本或多模态信号)先转成数值向量,用一系列线性代数运算(矩阵乘法、激活函数、归一化等)与这些向量交互,最后把得到的向量再映射回人类可读的词或标记,形成输出。
这是 Transformer 架构的原理图,我们从下往上重点关注输入(红)、注意力/解析(橙)与前馈/输出(蓝)三个部分。
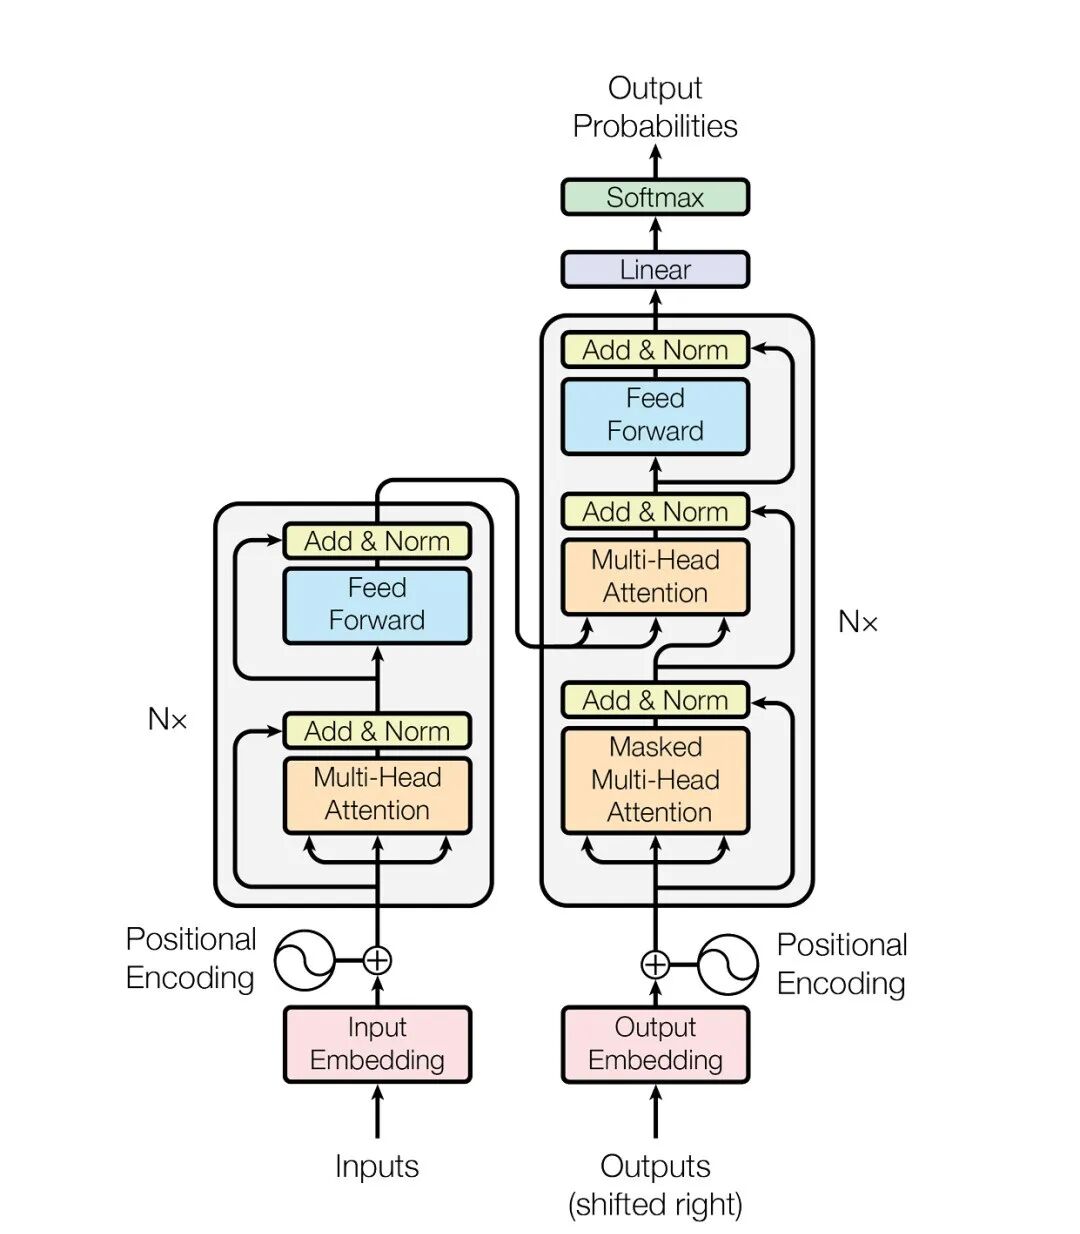
1)词元输入

词元(Token)是大语言模型处理数据的基本单位。一句话在输入前会被分割为若干 token,且顺序被保留;模型接收到的就是这个有序 token 序列(例如“我比他更水”被输入成“我” -> “比” -> “他” -> “更” -> “水”,而不会被输入成“他” -> “更” -> “我” -> “水” -> “比”)。常见的计费单位“每百万 token”就是指这种 token 的数量。

早期的大语言模型,大多依赖卷积神经网络(CNN,Convolutional Neural Network)与循环神经网络(RNN,Recurrent Neural Network),其缺点是无法在超大范围上理解和追溯词元之间的关联关系,但当序列长度增长到几百甚至几千时,RNN 在捕捉远距离依赖上会变弱,计算效率也受限。

Transformer 的自注意力机制能在理论上直接让任意两个 token 互相「看到」对方,从而把建模的范围从局部窗口扩展到整个输入序列(即模型的上下文窗口长度)。上下文窗口的具体长度可以是几千,甚至几十万 token,这标志着模型能同时考虑的文本范围大大提高。

在进入模型前,每个 token 会被映射到高维向量空间,叫做词嵌入(Embedding)。在这个空间里,语义越近的词对应的向量距离也越近。以二维向量空间举例,点(7, 8)可能代表「摸鱼」,点(7.3, 8.3)可能代表「划水」,而代表「打工人」的点可能就在(9, 9.6)了。
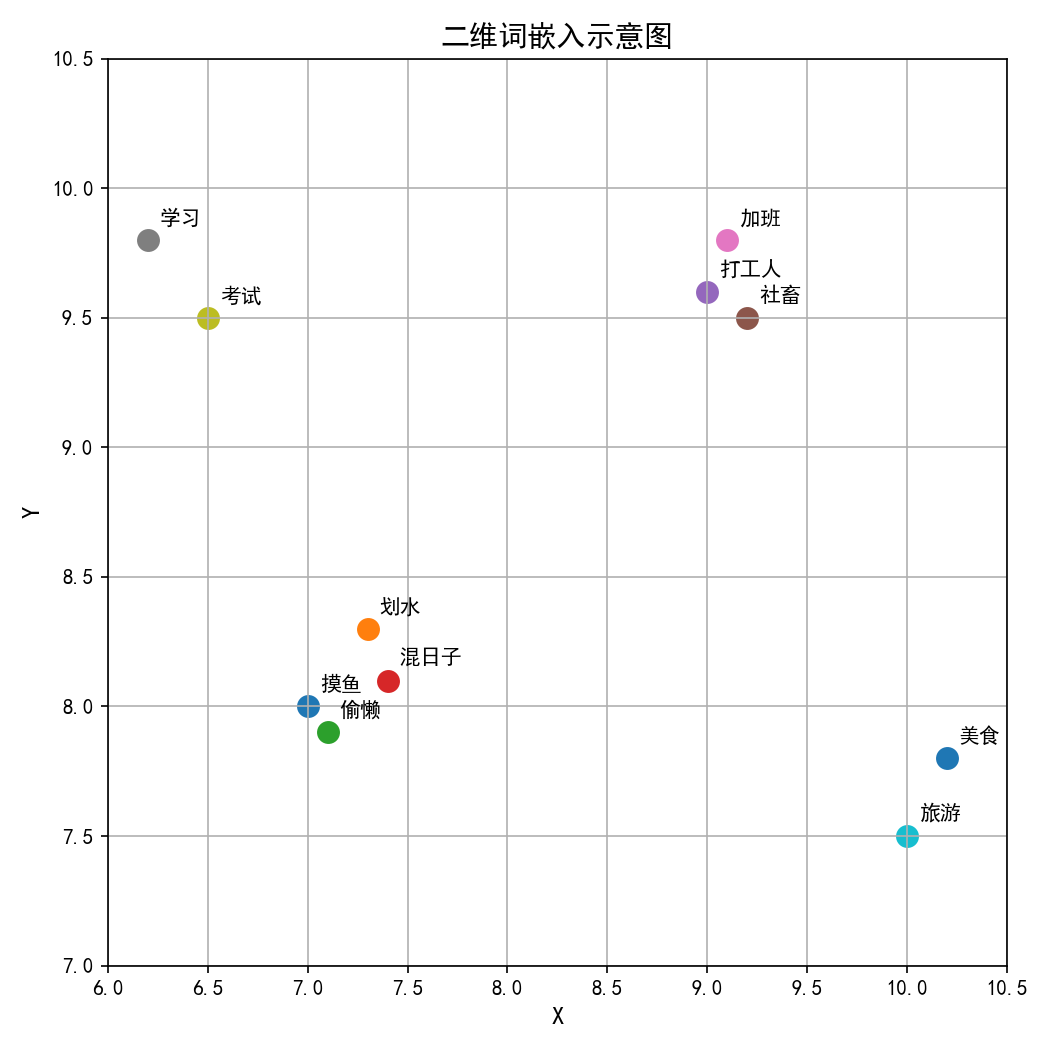
(词嵌入的低维可视化展示,仅为部分聚类趋势,非实际情况)

二维示例便于理解,但实际维度往往很大——现代模型经常能够达到数千到上万维。

2)解析与回答

有了有序输入的 token 后,Transformer 对每个 token 计算三个向量:Query(Q,表示“我在找什么”)、Key(K,表示“我能提供什么”)和 Value(V,表示“我是什么”)。注意力机制通过比较 Q 与其它 token 的 K 来决定对哪些 token 赋予更多关注,然后把对应的 V 以加权和的方式聚合起来,形成当前 token 的上下文表示。

以前面那个例子“我比他更水”来说,对于“水”这个 token,模型可能会根据上下文更关注“我”而不是“他”。

在实现上,每一层注意力模块可视作若干矩阵乘法与一次输出变换(记作 Wq、Wk、Wv、Wo 的组合),矩阵尺寸等于 d_model × d_model。

内部语义上常把输入向量分成 num_heads 个子空间并行计算,叫做多头注意力(Multi-Head Attention)。多头注意力的设计允许模型在不同子空间关注不同类型的关系,提升表达力与鲁棒性,不至于让模型“钻牛角尖”。若 d_model = 12288,num_heads = 64,则每个头的维度为 192(12288/64)。

在模型理解完输入序列想要干什么以后,就进入了回答的环节,这里会经过一个叫前馈神经网络(FFN,Feed Forward Network)的结构,来对每个 token 做逐位置的非线性变换。常见做法是先将维度提升到 d_ff(通常为 4×d_model),再降回 d_model。维度提升后能容纳更多的信息进行复杂组合,来回答输入中的问题,比如“水是一种物体 → 但在有些情况下水是形容词 → 水可以形容能力更弱 → 这种情况下水是贬义词”这样的知识,就是从 FFN 这里「拿」出来的。

这一套注意力 + FFN 的模块会堆叠 N 层(有的模型 N=96 或更高),形成深层网络,用来回答各种复杂问题。

3)结果输出

在经过了所有层级后,模型已经能给出一团混合的结果了,但此时的答案还只是每个位置上候选 token 的分数,需要进行线性处理(Linear)和归一化(Softmax)把分数转成概率分布,依次输出概率最高的 token,这样就是人类能理解的顺序答案了。这也是通常所说「大模型根据下一个词的概率分布生成文本」的含义:模型在每一步基于当前上下文预测下一个 token 的概率。

现在我们就可以回答这个问题:大模型的参数量如何计算?
每一层的主要权重来自注意力部分:

Wq、Wk、Wv、Wo四块矩阵,每块的大小均为 12288 × 12288,合并后大致相当于 4 × d_model^2

和 FFN 部分:

两块矩阵,约为 2 × d_model × d_ff,若 d_ff = 4 × d_model 则为 8 × d_model^2

因此一层权重近似为 12 × d_model^2。以 d_model = 12288、N = 96 为例,按上式计算得到的主要权重数量约为 :

12 × 12288^2 × 96 ≈ 1.739 × 10^11(约 1739.5 亿)

加上其他小量参数(嵌入、偏置、归一化等),就是 GPT-3 的实际参数规模(1750亿)。
弄清架构以后,训练目标就是确定上述所有矩阵(权重)的数值。

GPT 系列常见的训练流程可以分三步:

  1. 预训练(Pre-training)。通常采用自监督学习(Self-supervised Learning)方法:在大规模未标注语料上训练,让模型根据上下文预测缺失的 token(或者用下一句预测、因而构成“标签与输入来自同一文本”的一种学习方式)。自监督常被归入“无监督学习”范畴,但严格意义上自监督是通过构造伪标签来学习的一类特殊方式。

  2. 指令微调(Instruction Fine-tuning)。用高质量、带任务指令的示例(人工标注数据)来训练模型,使其学会按照自然语言指令执行特定任务,从而在交互时更符合人类期望的回答形式。

  3. 人类反馈强化学习(RLHF,Reinforcement Learning from Human Feedback)。先收集人类对模型输出偏好的排序或评分,训练一个奖励模型来估计人类偏好,再用强化学习算法对基础模型进一步微调,使模型输出更符合人类偏好与安全规范。

此外还有蒸馏学习(Knowledge Distillation)等技术:通过让小模型模仿大模型的行为,把「教师模型」的知识迁移到「学生模型」,以在有限计算资源下尽量保留表现。很多 Mini , Nano 版本的模型就是经过更大模型蒸馏后的产物。

对于个人或小团队想训练小规模模型的情况,常见策略是采用开源的预训练模型做基础,然后用自有数据做指令微调或领域微调,这样可以在可承受的计算资源上获得实用性能。
把训练好的静态模型部署完成后,面对新请求时就是运行前述的计算过程。由于参数规模庞大,实际运行需要计算框架配合(如对矩阵分片并行、分布式计算等)才能高效完成。

在推理阶段,把矩阵运算映射到合适的硬件(CPU、单卡 GPU、多卡分布式集群、或专用推理芯片)以提高吞吐与延迟表现。工程上通常要考虑模型并行、数据并行、流水线并行、分片、内存与带宽优化等问题,以让大模型在资源受限时仍能高效运行。


这就是大语言模型的主要原理了,各家公司会基于不同的数据源、模型设计与训练细节推出各自的模型,同时建立起多维的模型评测体系(例如准确性、鲁棒性、幻觉指数、安全性、细分领域性能等)。需要提醒的是:评测分数高并不意味着模型在每个具体场景都是「最好」的,对于每个用户来说:

适合自己的大模型才是最好的大模型

基于 Transformer 的架构,也催生了大量多模态模型:通过对不同模态输入给予合适的权重编码与注意力机制,使图像、视频与文本等跨模态信息能互相融合并用于生成或理解任务。

虽然核心原理相对直观,但落地实现涉及大量工程细节与挑战。全球大量顶尖的研究者与工程团队正持续投入这一领域,推动技术快速演进。或许 AI 的使用极限,只受限于我们人类的想象力了。

我会把一些学习资料整理到评论区,方便大家查阅。如果这篇文章对你有所帮助,欢迎互动交流,你的反馈会促使我继续规划并输出更多实用的技术内容。
在讲解过程中,为避免分散注意力,我省略了一些对主干结构影响不大的内容,在此进行补充说明,有兴趣的朋友可以继续往下看:

位置编码(Positional Encoding)

Transformer 需要位置信息来保持序列顺序。原始论文采用了基于不同频率的正弦/余弦函数构造的固定位置编码(sin/cos),具体函数为:
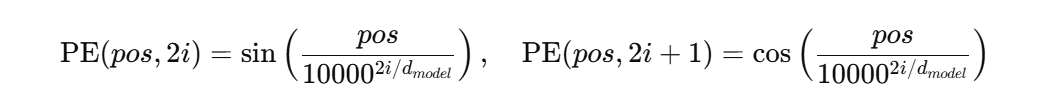
后来许多实现改为可学习的位置嵌入(Learned Positional Embeddings),两者在不同场景下各有优劣。

激活函数(Activation Function)

在两层(升维再降维)前馈神经网络 FFN 之间通常会加入非线性激活函数以赋予模型非线性表示能力。常见选择包括
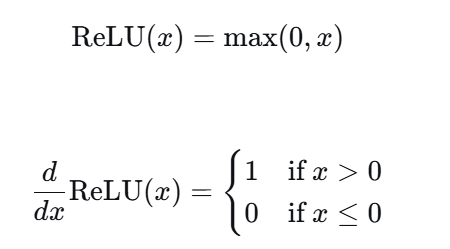
修正线性单元(ReLU,Rectified Linear Unit)
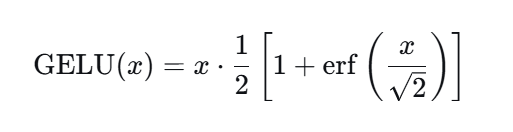
高斯误差线性单元(GELU,Gaussian Error Linear Unit)

后者在许多 Transformer 实现中表现良好。
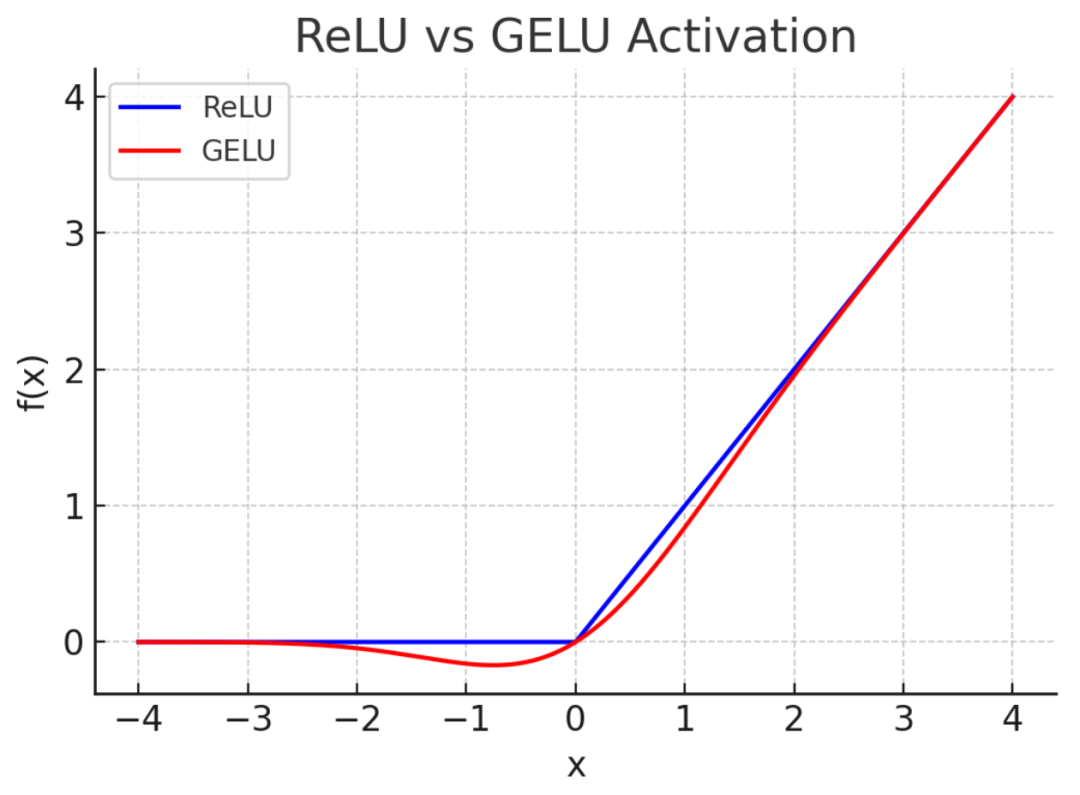
(两种函数的图像)

残差连接(Residual Connections)

为了稳定训练与缓解梯度问题,Transformer 在子层(注意力子层与 FFN 子层)后通常使用残差连接(把子层输入 x 与子层变换 F(x) 相加),并配合归一化操作来统一尺度与加速训练。

掩码多头注意力(Masked Multi-Head Attention)

在自回归预训练中,训练时要确保模型在预测某一位置的 token 时不能看到该位置之后的真实 token,因此使用掩码机制屏蔽未来位置。这保证了模型在生成时只基于已生成的上下文进行预测。

缩放点积注意力‌(Scaled Dot-Product Attention)

单头注意力的输出为:
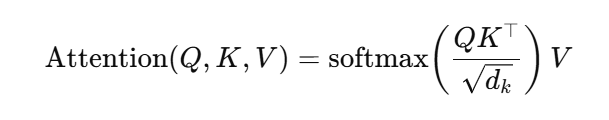
对于多头注意力(h 个头),每个头在子空间上做上述计算,最后拼接各头输出再做一次线性变换:
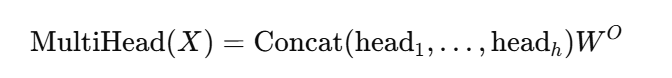
如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

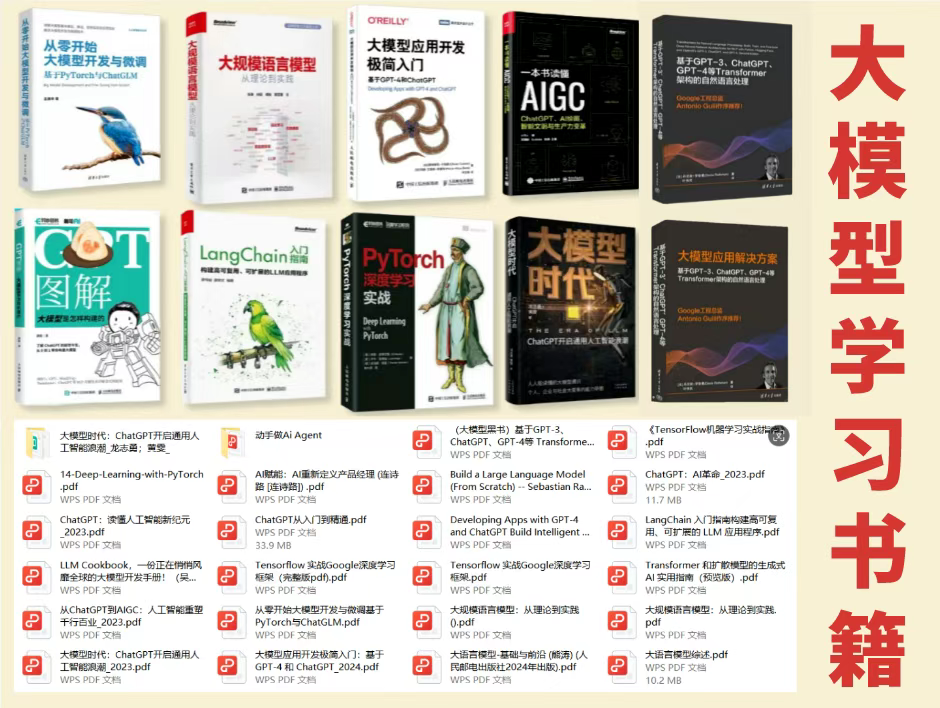
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

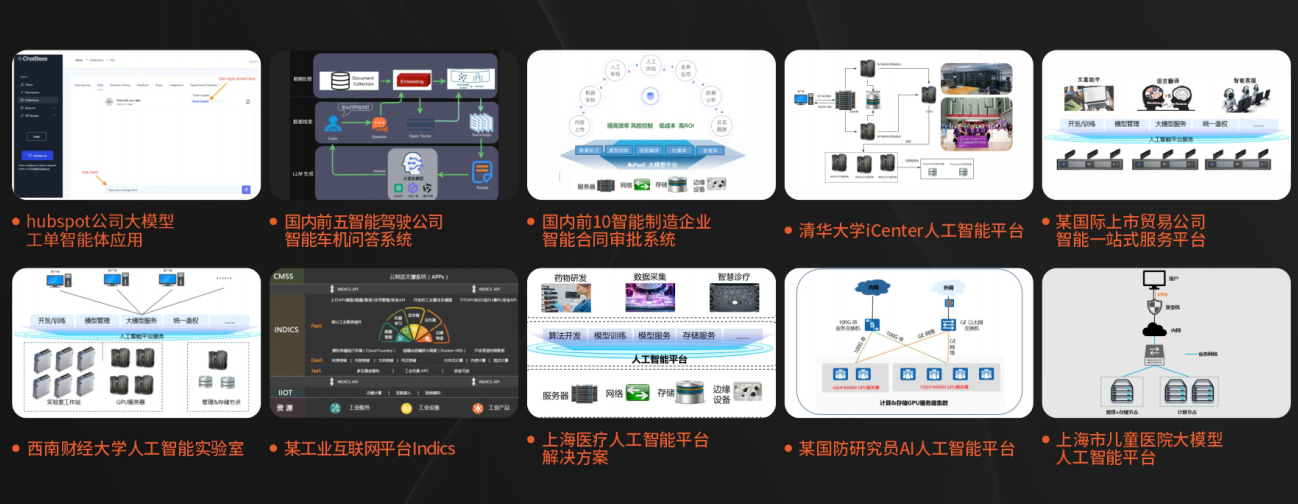
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

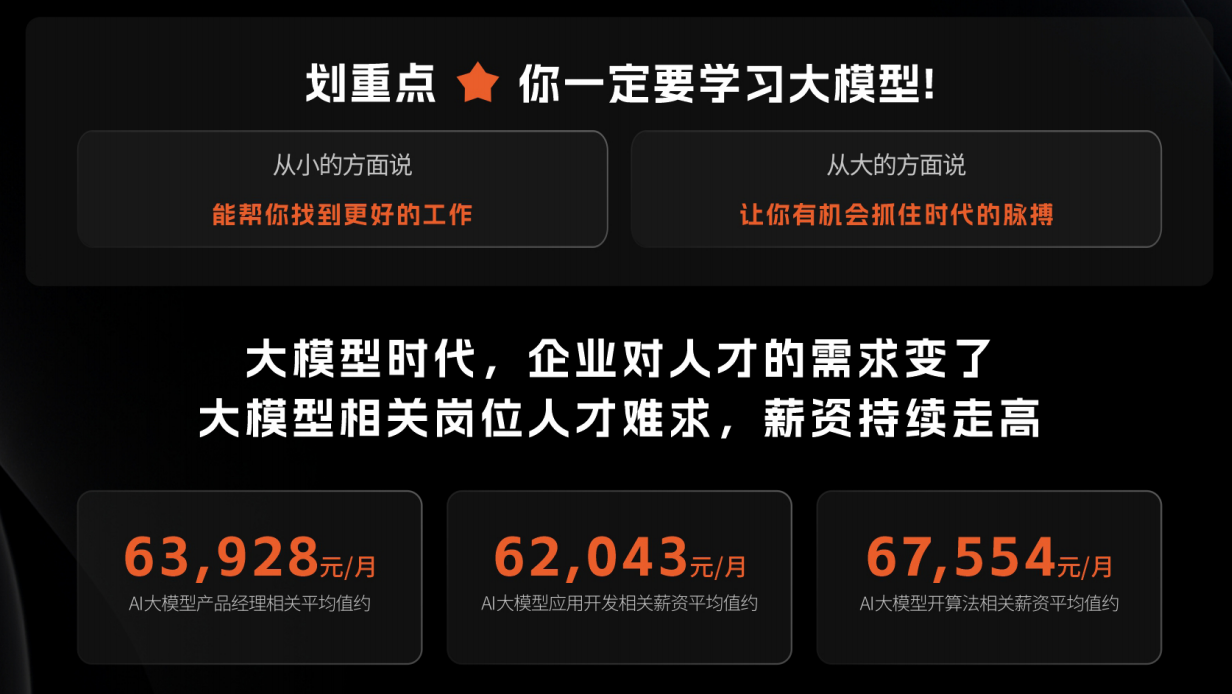
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

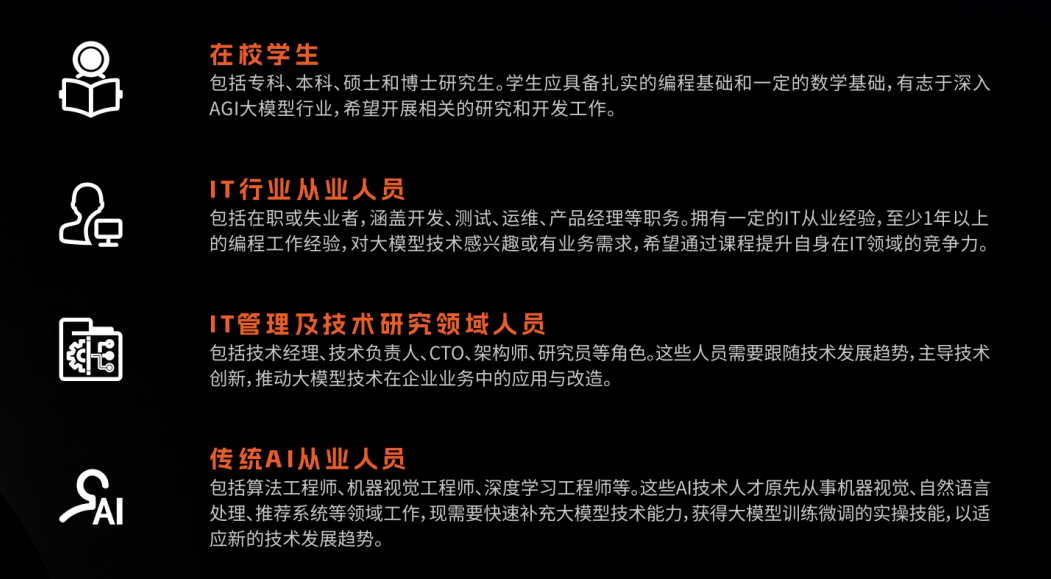
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

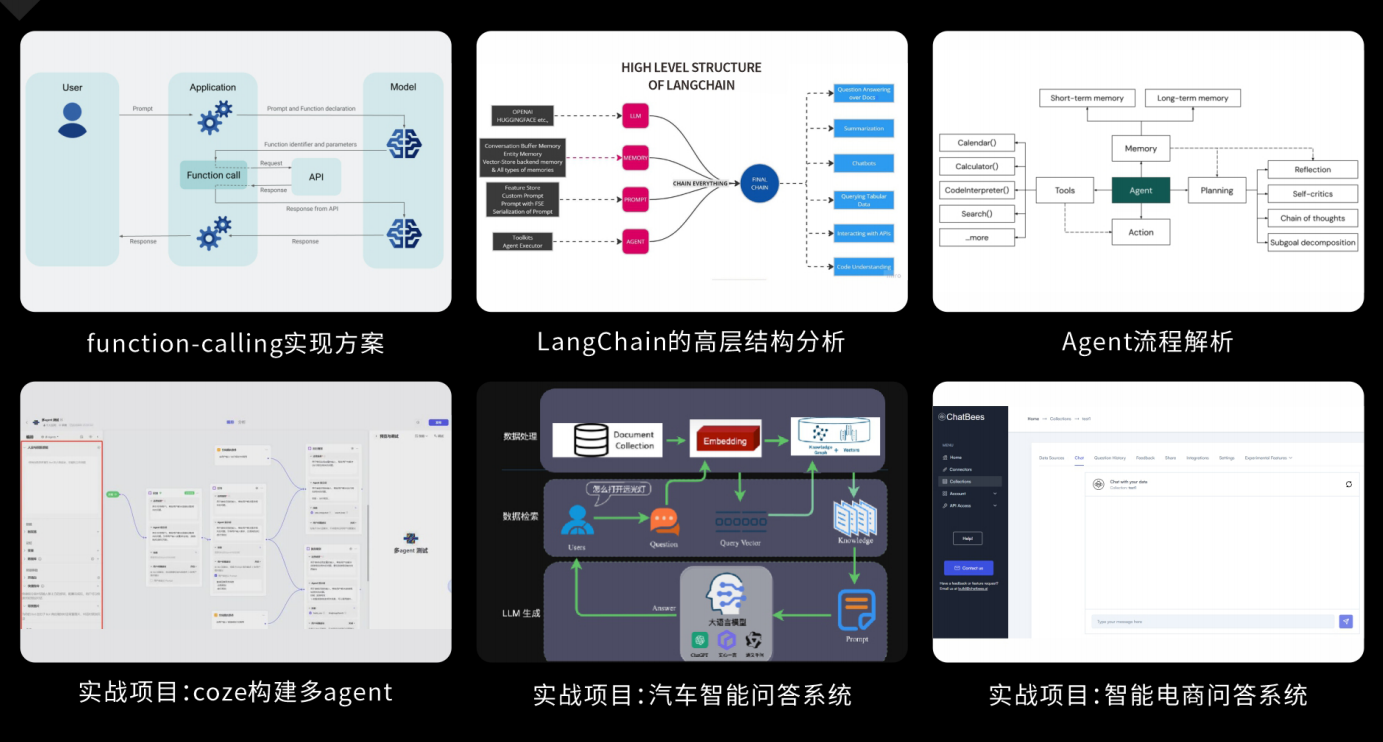
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

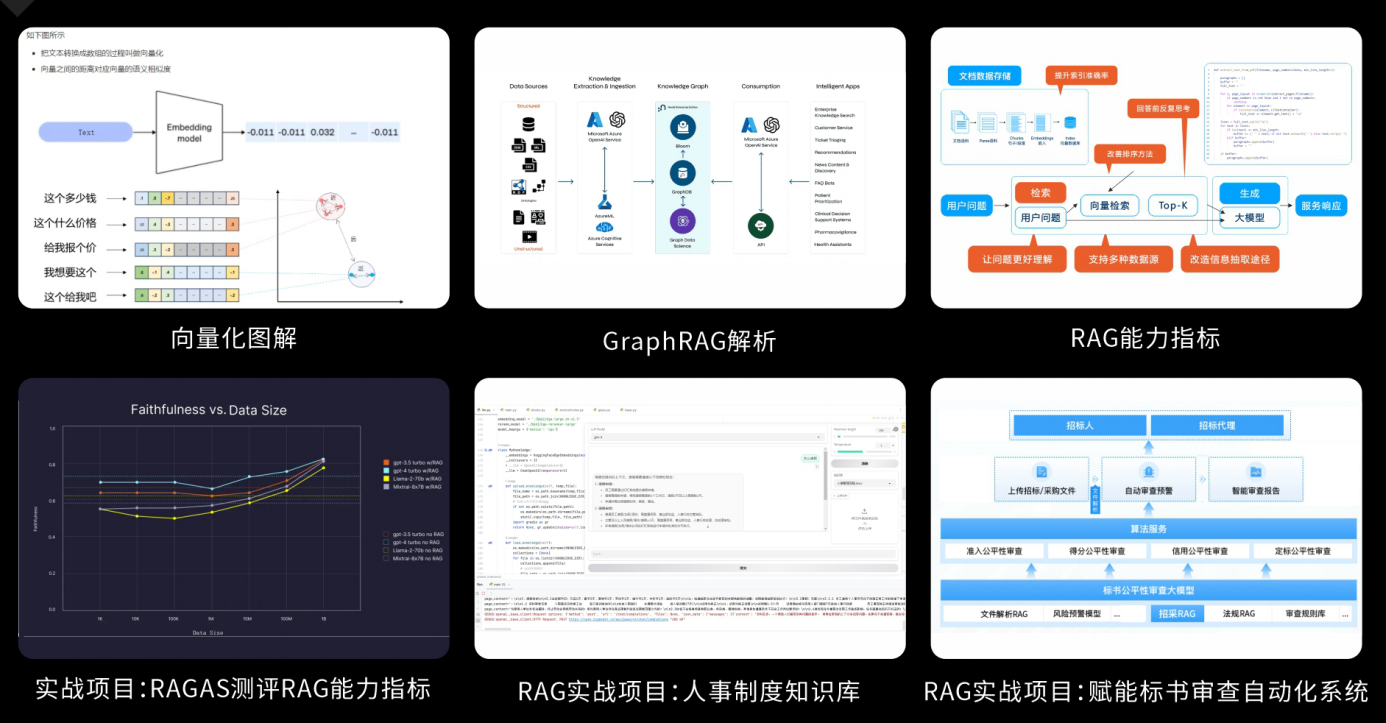
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

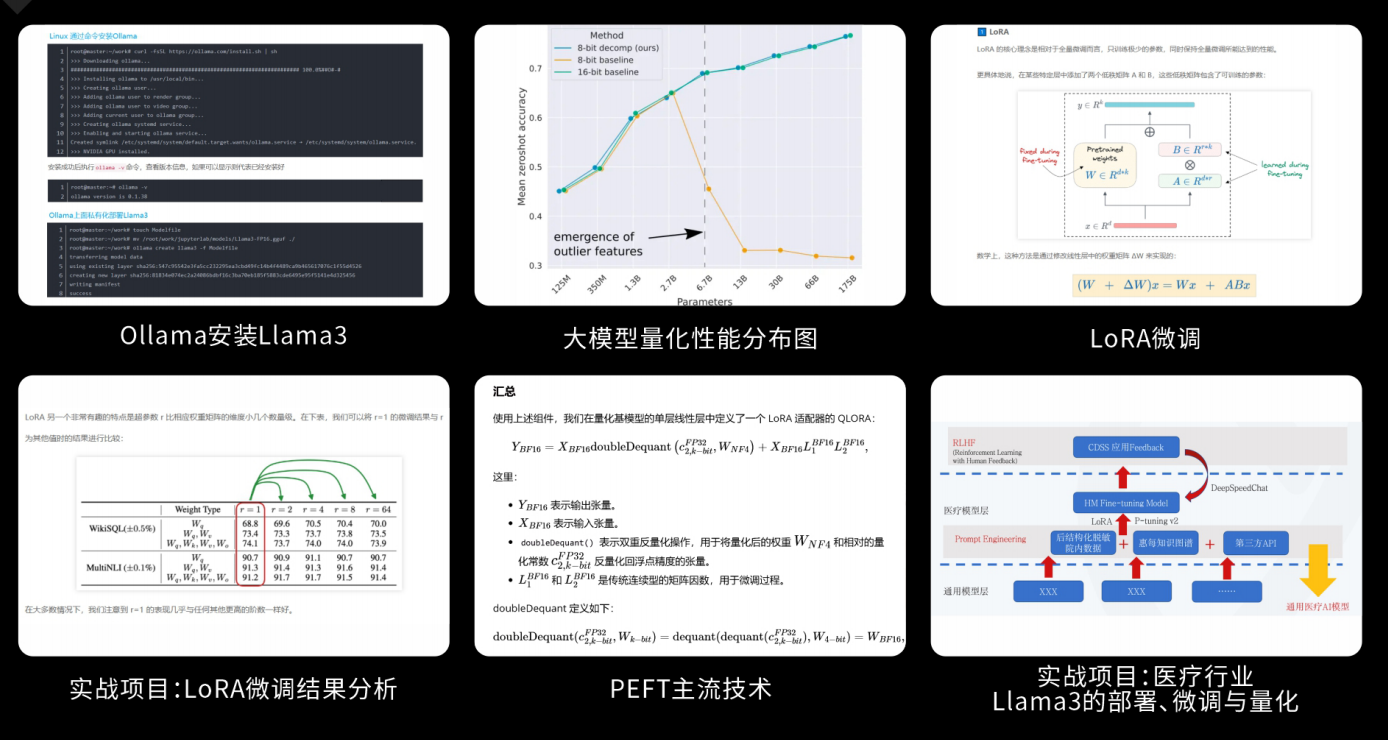
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

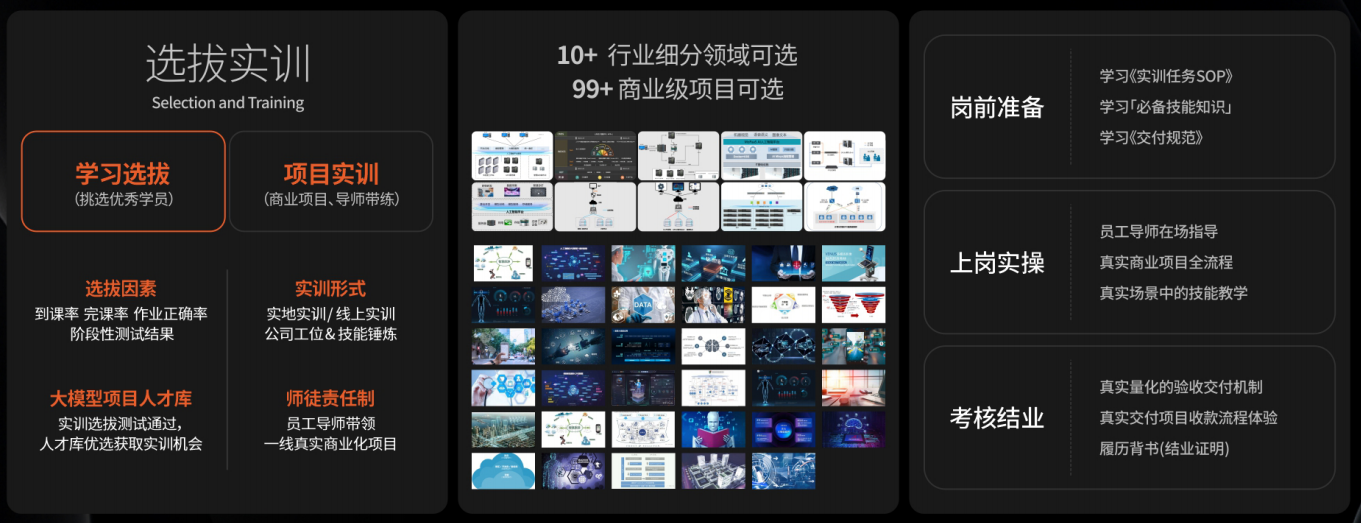
  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

大模型入门指南:基本技术原理与应用 本文探讨了大型神经网络模型的基本技术原理,包括深度神经网络、激活函数、损失函数、优化算法、正则化和模型结构等,并讨论了预训练与微调、模型压缩与加速、解释性与可解释性、隐私与安全等关键议题,旨在帮助读者更好地理解和利用大模型来解决实际问题。 阅读详情

相关推荐

大模型底层原理及算法

输入问题↓Token 化↓向量表示↓Transformer 多层注意力计算↓预测下一个 Token 概率↓逐词生成回答↓经过对齐策略形成自然、有用、安全的回答大模型通过海量数据学习语言和知识的统计规律,再利用 Transformer 注意力机制处理上下文,通过预测下一个 Token 逐步生成回答;经过指令微调和对齐训练后,就表现出类似智能问答的能力。它不是传统数据库查答案,也不是简单关键词匹配,而是一个经过大规模训练的概率生成系统。

wladh0910的博客 543

深度讲解AI大模型原理,它到底是如何工作的,零基础入门到精通,收藏这一篇就够了

假如我们有一个AI大模型,比如GPT2。此时我们向模型输入,“[cls]、今、天、天、气、真”,一共6个字(单词)。我们希望模型基于这6个字,生成第7个字。此时,模型会输出第7个字,是“的”字。这里要需要特殊说明:最开始的[cls],是一个特殊标记;它用于标记句子的起始位置;模型需要基于一些特殊的标记来进行计算。现在不太理解也没关系,可以暂时忽略这个cls标记。接着,我们要生成第8个字。对于第8个字的生成,就会依赖初始输入的6个字,与刚刚生成的第7个“的”字。

Python_0011的博客 2592

SWAT模型非点源模拟原理

目录引言模型概述非点源污染模拟原理物质迁移内容过程营养物农药病原菌运移河道水质模型营养元素的地表水体循环河道水质模拟藻类模拟氮元素磷元素生化需氧量及溶解氧重金属的运移蓄水体水质模拟 引言 今天无意接触到这一块,就记录下来了。 模型概述 1、流域中非点源污染的来源主要是农业化肥和农药的施用。 2、氮、磷等营养物和农药的迁移和转化取决于化合物在土壤环境中经历的转化过程。 3、SWAT模型可以模拟水文相应单元内氮、磷完整的营养物循环过程和任何一种农药的降解过程。 4、SWAT模拟流域内泥沙、藻类、溶解氧、有机污染

DoWayChan的博客 4878

一文了解大模型工作原理——以ChatGPT为例

2022年11月30日,ChatGPT模型问世后,立刻在全球范围内掀起了轩然大波。无论AI从业者还是非从业者,都在热议ChatGPT极具冲击力的交互体验和惊人的生成内容。这使得广大群众重新认识到人工智能的潜力和价值。对于AI从业者来说,ChatGPT模型成为一种思路的扩充,大模型不再是刷榜的玩具,所有人都认识到高质量数据的重要性,并坚信“有多少人工,就会有多少智能”。ChatGPT模型效果过于优秀,在许多任务上,即使是零样本或少样本数据也可以达到SOTA效果,使得很多人转向大模型的研究。

weixin_63866037的博客 5600

从拆箱到跑通:Intel RealSense D435i开箱实测+ROS驱动配置全流程

本文详细记录了Intel RealSense D435i深度相机的开箱体验,并提供了在Ubuntu 22.04与ROS2 Humble环境下,从安装librealsense2 SDK到配置ROS2驱动的完整流程。重点解决了驱动安装、数据流发布、点云对齐以及IMU数据融合等关键步骤,帮助研究者和开发者快速实现D435i与机器人系统的集成。

weixin_29168393的博客 304

ADRV9009的学习历程(一)

** AD9361的同胞ADRV9009 ** 终于记录一下了 距离第一次想写博客记录自己学习的点点滴滴,大概已经过去有一年有余。一直都是停留在心有余而力不足的境界。 基本每次做项目遇到问题都会来优快云寻求帮助,这里虽离庙堂较远,但高手云集。每每读来,思绪万千,次次膜拜。 趁这次又学习了一样新物件,就记录一下,望大神看见能赐教一下。 ADRV9009 最近有项目要用到ADRV9009这个芯片。就来学习一下。做过AD9361的都知道,ADI官方会给出这个芯片的参考手册、数据手册和驱动程序。当然我只是见过AD

weixin_42868560的博客 1万+

人工智能世界观(认知篇)

本文系统梳理了人工智能(AI)的基础知识体系,重点解析了大模型(LLM)的核心原理、技术演进及应用边界。主要内容包括: AI基础认知:从规则驱动到数据驱动的范式转变,强调AI=数据+算法+算力的技术本质,区分了弱AI与通用AI(AGI)的能力差异。 技术发展史:回顾AI七十年发展,从符号主义、专家系统到深度学习的五次技术浪潮,重点分析Transformer架构如何推动大模型革命。 大模型原理:详解LLM的三大支柱(参数量/数据量/算力),揭示自回归生成和注意力机制的工作逻辑,对比GPT与BERT的技术路线差

轻舟已过万重山 551

FPGA之串口收发字符串之(四)——串口屏USART_HMI介绍

之前对串口各模块的设计都做了相关介绍。这里介绍串口屏的相关知识。 本次项目使用的串口屏型号是陶晶驰串口屏TJC3224T024_011,这个型号的串口屏的资料在官网可以找到。本文抛转引玉,简单介绍以便在本工程中更好的应用。 下图是该串口屏的实物图: 一般地,使用单片机或者嵌入式MCU控制串口屏,都会用到串口,同样地,在FPGA中实现也是类似,不过稍微复杂,具体代码设计过程中有以下问题需要...

隔壁old余的博客 7495

万字长文,解读大模型技术原理(非常详细)零基础入门到精通,收藏这一篇就够了

1)突破了远距离文本依赖的学习限制,避开了递归网络的模型体系结构,并且完全依赖于注意力机制来绘制输入和输出之间的全局依赖关系。2)可高度并行进行训练,这对发挥硬件红利以及快速迭代模型非常重要。下图是论文提到的Transformer模型,对编码器和解码器使用堆叠式的自注意力和逐点式、全连接层,分别如图1的左半部分(编码器)和右半部分(解码器)所示,相关技术细节后面会重点讲到。

Python_0011的博客 9388

SARScape实战:集成GACOS数据优化InSAR大气校正全流程

本文详细介绍了如何在SARScape软件中集成GACOS数据,以优化InSAR大气校正的全流程。通过实战步骤,从GACOS数据申请、下载、导入,到在单景干涉图和SBAS-InSAR流程中应用,有效剥离大气相位延迟,显著提升形变监测结果的精度与可靠性,实现从“雾里看花”到“拨云见日”的转变。

weixin_28419039的博客 399

三种1:4传输线变压器巴伦的分析

满足多模多馈天线系统匹配要求的传输线变压器巴仑有:双线传输线变压器( 见图1) 、三线传输线变压器( 见图4) 和四线传输线变压器( 见图5) 。尽管3 者的结构不同, 但都可实现1∶4 阻抗变换和不平衡-平衡转换。下面就应用电报方程对它们的阻抗变换特性和输出平衡特性进行分析。

weixin_42407808的博客 8047

什么是大模型?一文读懂大模型的基本概念

大模型通过训练海量数据来学习复杂的模式和特征,具有更强大的泛化能力,可以对未见过的数据做出准确的预测。引申到模型层面,涌现能力指的是当模型的训练数据突破一定规模,模型突然涌现出之前小模型所没有的、意料之外的、能够综合分析和解决更深层次问题的复杂能力和特性,展现出类似人类的思维和智能。ChatGPT对大模型的解释更为通俗易懂,也更体现出类似人类的归纳和思考能力:大模型本质上是一个使用海量数据训练而成的深度神经网络模型,其巨大的数据和参数规模,实现了智能的涌现,展现出类似人类的智能。

weixin_46880696的博客 11万+

【图像检测】基于MATLAB的火灾监测系统设计

1 简介 针对传统火灾监测系统对于大空间的室内场合和开阔的室外环境易失效的问题,提出了一种结合火灾火焰特征和烟雾特征来进行判断的数字图像型火灾监测算法.火焰颜色特征是基于RGB颜色模型中的R,G,B三基色分量和它们之间的关系来判断是否有火焰发生,烟雾模型特征是图像灰度化预处理后,基于HIS空间模型提取的,通过计算像素点与基准像素点之间距离D的大小来判断是否有火灾发生.对提出的算法进行MATLAB仿真,并和传统的基于五种算子的边缘检测算法提取火焰烟雾特征进行对比.实验结果表明,提出的火焰特征和烟雾特征提取算

qq_59747472的博客 2797

大语言模型技术原理

总体来说,ChatGPT 在人工标注的prompts和回答里训练出SFT监督策略模型,再通过随机问题由模型给出多个答案,然后人工排序,生成奖励模型,再通过PPO强化训练增强奖励效果。最终ChatGPT能够更好理解指令的意图,并且按指令完成符合训练者价值观的输出。最后,大语言模型作为一个被验证可行的方向,其“大”体现在数据集广泛,参数和层数大,计算量大,其价值体现在通用性上,有广泛的应用场景。大语言模型能够发展,主要还是模型具备很好的并行扩展性,随着数据量和计算量的增加,主要挑战在工程和调优上。海外除了G

云原生智能数据管理平台 4749

YOLO11全网首发:CVPR2026 Transformer注意力 | BinaryAttention 1-bit注意力,推理提速100%,超越FlashAttention2

本文改进:BinaryAttention 结合YOLO11的C3k2模块,全网首发创新。

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 855

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

概念科普|大模型它到底是什么?

ChatGPT、Open AI、大模型、提示词工程、Token、幻觉等人工智能的黑话,在2023年这个普通却又神奇的年份里,反复的冲刷着大家的认知。

2301_81888214的博客 2786

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

《大模型原理没那么难!小白也能吃透的保姆级科普》

我们将从大模型的模型架构和核心工作原理出发,用最通俗易懂的语言拆解大模型架构 —— 哪怕你是从未接触过大模型的零基础小白,也能轻松理解大模型的运转方式。无论是想掌握 Agent 开发的技术内核、精进 Prompt 设计的实践技巧,还是单纯好奇 AI 背后的奥秘,本文都将用层层剖析的方式,帮你撕掉 **「技术门槛」** 的标签,让大模型认知真正实现 **「零起点可及」**。

王不二的AI之路 1067

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

大模型底层原理全解析:从Transformer到训练流程,程序员必备收藏

本文系统解析了大语言模型(LLM)的基础原理,基于Transformer架构,通过词嵌入、自注意力机制和前馈神经网络处理文本输入。大模型采用"预训练+微调"范式,包括自监督预训练、指令微调和人类反馈强化学习三阶段。模型参数规模庞大,实际运行需考虑并行计算和硬件适配。多模态扩展和AI体应用是当前发展方向。理解这些原理有助于开发者更好地应用和优化大模型技术。

2401_85373691的博客 1522

大模型是什么?大模型发展历程、底层原理、如何学习大模型?非常详细,一篇文章全给你搞定!

但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

2401_84495872的博客 1450

大模型扫盲系列——初识大模型

大模型是指具有数千万甚至数亿参数的深度学习模型。近年来,随着计算机技术和大数据的快速发展,深度学习在各个领域取得了显著的成果,如自然语言处理,图片生成,工业数字化等。为了提高模型的性能,研究者们不断尝试增加模型的参数数量,从而诞生了大模型这一概念。本文讨论的大模型将以平时指向比较多的大语言模型为例来进行相关介绍。

HUANGXIN9898的博客 1945

大模型扫盲系列——大模型实用技术介绍_大模型底层技术是哪些

从公式知,输入是正的,则直接输出该值;如果输入是负的,则输出0。ReLU因其简单性和效率在深度学习中非常流行。它有助于解决梯度消失问题,加速了神经网络的收敛,并且计算简单。

2401_85280307的博客 1921

技术干货|什么是大模型?超大模型?Foundation Model?

目前Foundation Model或者是大模型,特别地火,接下来介绍什么是大模型,大模型的基本概念;接着看看大模型的实际作用,然后基于这些实际作用,我们简单展开几个应用场景。最后就是介绍支持大模型训练的AI框架。在往下看之前,想抛出几个问题,希望引起大家的一个思考:1)为什么预训练网络模型变得越来越重要?2)预训练大模型的未来的发展趋势,仍然是以模型参数量继续增大吗?3)如何预训练一个百亿规模的大模型? MindSpore官方资料GitHub : https://github.com/mindspore-

Kenji_Shinji的博客 5万+

大模型原理是什么?一文带你从底层弄清楚大模型的基本概念(非常详细)零基础入门到精通,收藏这一篇就够了_一文了解大模型底层逻辑

大模型是指具有大规模参数和复杂计算结构的机器学习模型。这些模型通常由深度神经网络构建而成,拥有数十亿甚至数千亿个参数。大模型的设计目的是为了提高模型的表达能力和预测性能,能够处理更加复杂的任务和数据。大模型在各种领域都有广泛的应用,包括自然语言处理、计算机视觉、语音识别和推荐系统等。大模型通过训练海量数据来学习复杂的模式和特征,具有更强大的泛化能力,可以对未见过的数据做出准确的预测。

HUANGXIN9898的博客 4019

AI大模型应用探索:全面解析语言大模型LLM的底层原理与工作机制!

本文用三个层级由浅入深地解析了大语言模型的工作原理:1)极简级将大模型视为概率计算器,基于输入内容输出最可能的答案;2)入门级介绍文本如何被转化为token向量,通过多头注意力机制等神经网络进行计算;3)初级详细说明token向量化、位置编码等关键技术,解释模型如何通过概率计算逐字生成回答。文章还提供了一套从入门到精通的大模型学习资源包,包含视频教程、学习路线和实战项目等资料。

2401_85390073的博客 643

小白必看:大模型入门全攻略 —— 底层原理 + 实战案例,一篇搞定从懂到用

小白必看:大模型入门全攻略 —— 底层原理 + 实战案例,一篇搞定从懂到用

python12345_的博客 2414

一文搞懂大模型底层原理!带你从0构建对大模型的认知!小白也能看懂!

在当今人工智能技术飞速发展的背景下,AI大模型已成为推动科技进步和产业变革的重要力量。然而,对于许多初学者来说,大模型的底层原理和实际应用往往显得晦涩难懂。本文将从零开始,带你用十分钟彻底搞懂AI大模型的底层原理,帮助你构建对大模型的全面认知,无论你是小白还是有一定基础的学习者,都能轻松入门。

EnjoyEDU的博客 2095
上一篇: 收藏必备!AI大模型幻觉检测全攻略:实时高亮技巧详解,一篇掌握
下一篇: 颠覆传统!LinearAttention让Transformer计算量暴跌90%:大模型面试必考优化秘籍一篇通!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值