收藏必备!AI大模型幻觉检测全攻略:实时高亮技巧详解,一篇掌握

【SeedLab】Packet Sniffing and Spoofing Lab 本节实验要求:借助Scapy库,实现网络流量的捕获与伪造。 阅读详情

幻觉检测一直是大模型研究领域的热点。

当AI医生给你一份“凭空捏造”的诊疗方案,或者AI律师引用一条“子虚乌有”的法律条文时,大模型的“幻觉”将会给现实世界带来巨大的风险。

过去,我们处理“幻觉”的方式更像是“事后诸葛亮”。等模型洋洋洒洒写完一篇长文,再用另一套系统去拆解、检索、验证每一个“事实声明”,这种方式不仅耗时,而且成本高昂,无法干预,不适用于实时交互的场景。

想象一下,如果AI在生成长篇大论时,能实时地把那些“一本正经的胡说八道”给高亮出来,那就完美了。

来自苏黎世联邦理工学院(ETH Zürich)等机构的研究团队的最新研究《Real-Time Detection of Hallucinated Entities in Long-Form Generation》就实现了这一点。他们开发了一个流式幻觉检测器,能在生成过程中即时标记幻觉实体。与以往主要针对短问答的检测方法不同,这项技术专门解决长文本生成中的幻觉问题。

它的核心思想是:不检测整个句子的真假,只识别具体的“实体”(人名、地名、日期、数字等)是否为虚构。

实施架构非常巧妙:

  1. 数据准备:让大模型(比如Llama-3.3-70B)针对各种主题生成长篇回答,其中自然会包含真实和虚构的实体。
  2. 自动标注:利用更先进的、带网络搜索功能的模型(如Claude),去自动验证这些回答中的每一个实体,并为每个词(Token)打上“幻觉”或“非幻觉”的标签。
  3. 训练探针:基于标注好的数据,训练一个极其轻量的线性探针(Linear Probe)。这个探针能直接读取模型在生成每个词时的内部“想法”(隐藏层激活值),并瞬间判断出这个词是不是“幻觉”的一部分。

一个有趣的发现是,当使用LoRA探针进行微调时,模型会表现出更强的“认知谦逊”,有时在生成一个幻觉实体后会立刻进行自我纠正。

实验结果表明,该方法在多个长文本生成场景中,其AUC远超传统方法,同时,在短问答和数学推理等领域也表现出色。这意味着,即使只针对“实体”进行训练,该检测器也学到了识别更广泛内容真实性的能力。

虽然创建标注数据集的成本较高,但研究发现,在一个模型上标注的数据可以有效迁移,用于训练其他模型的检测器。为此,团队已将数据集和代码完全开源。

当然,这项技术也存在局限。比如,如果模型从头到尾都在大篇幅地胡编乱造,那么满屏高亮可能反而会让用户无所适从。

小结

这个技术的演进反映了幻觉检测已经从“事后补救”转向“过程监控”。

其直接的应用可能是高风险的AI场景,比如医疗或法律咨询。想象一个医生助手AI,能在生成诊断建议时实时标出不确定的药物名称或研究引用,这远比事后发现问题再修改要宝贵得多。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

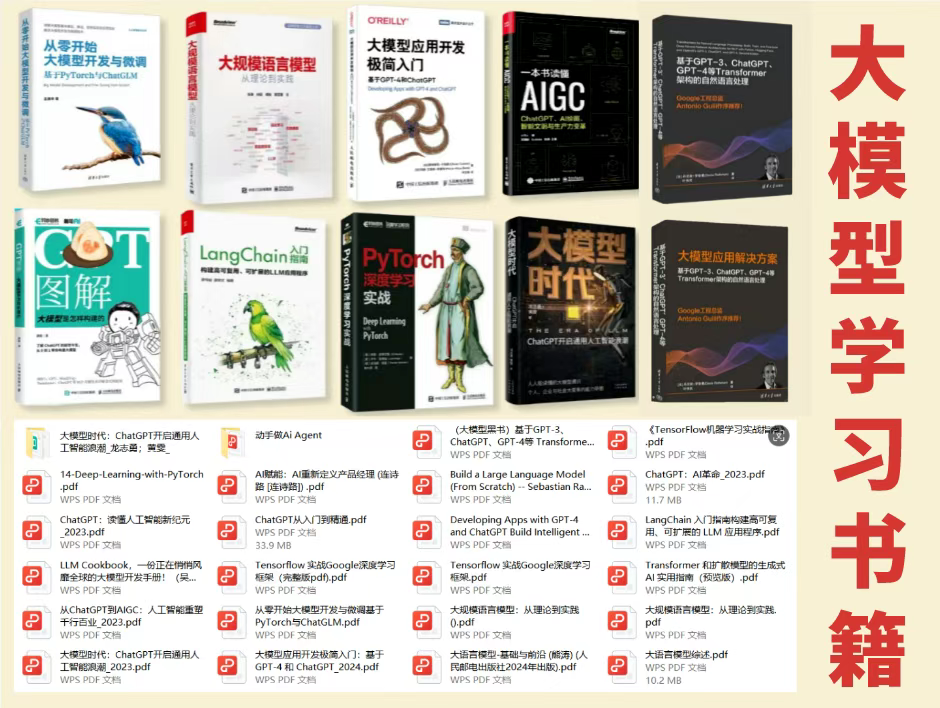
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

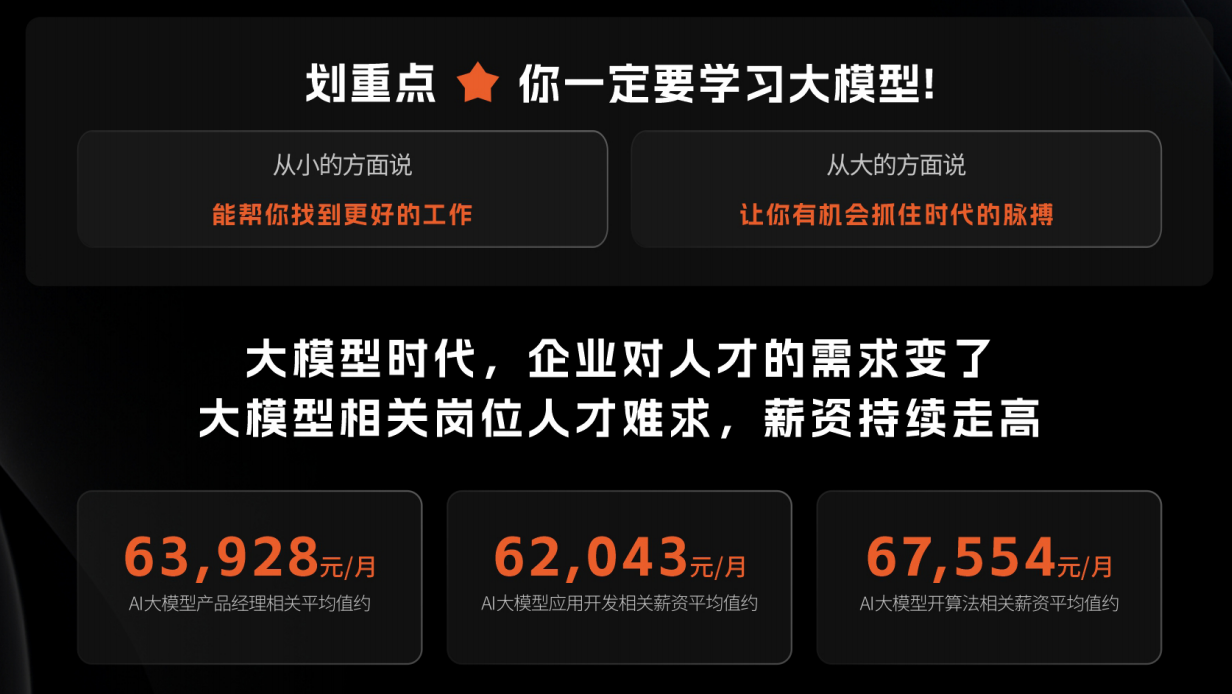
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

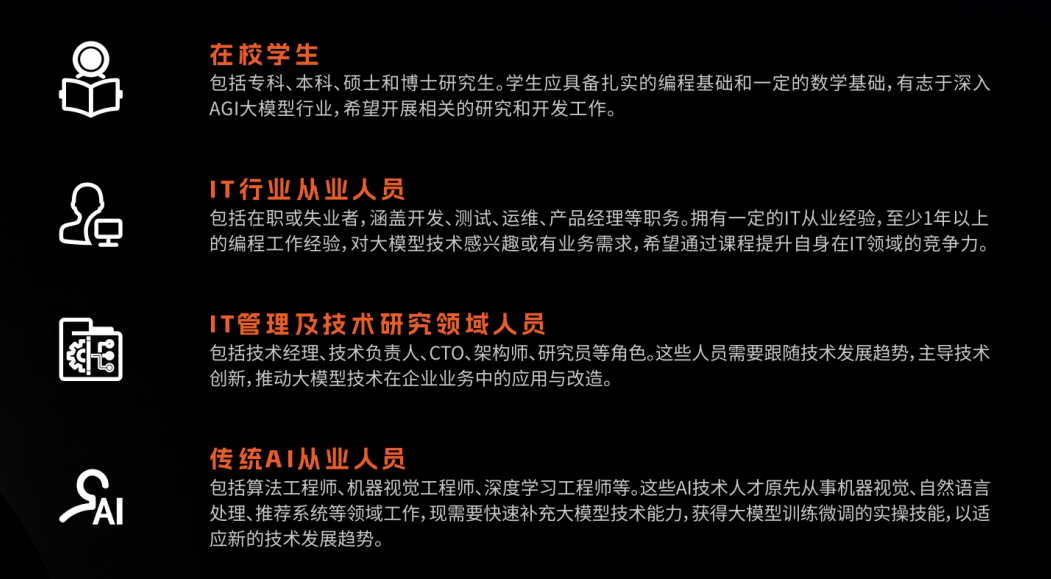
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

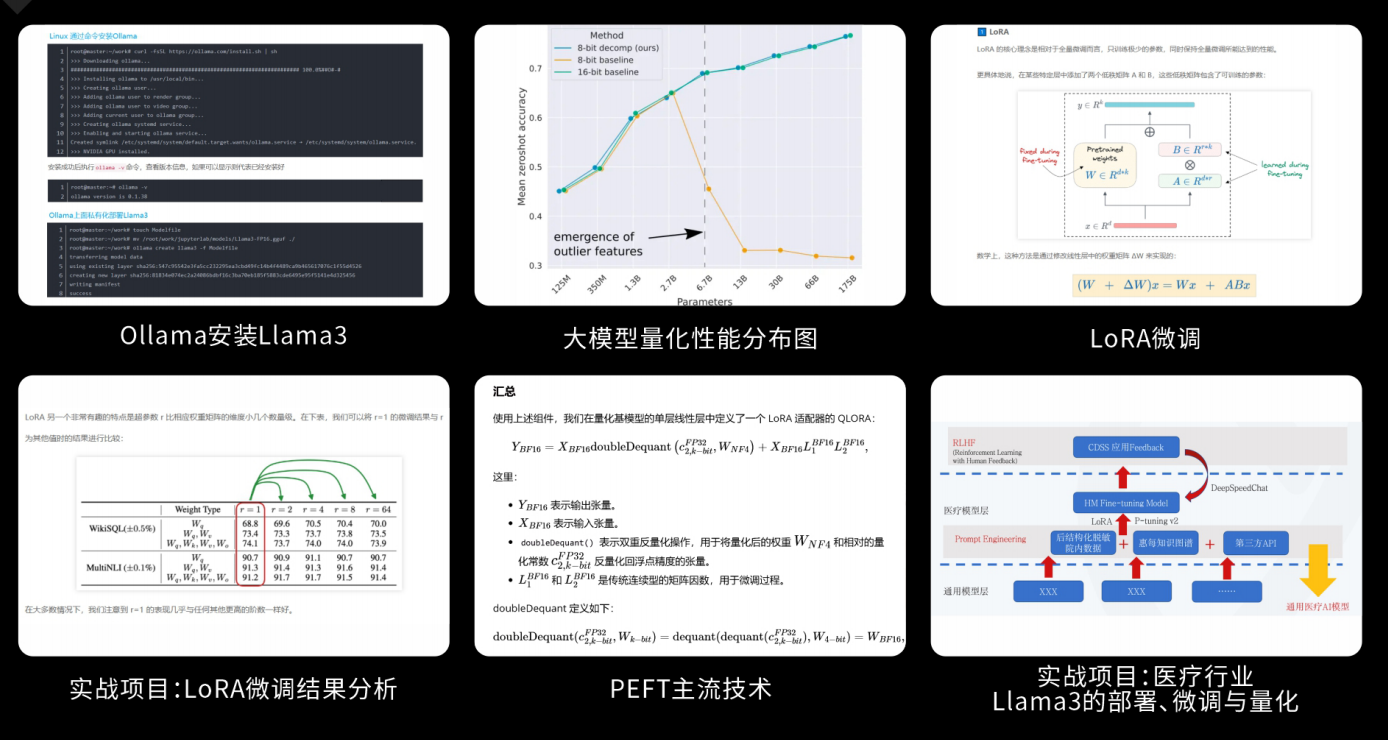
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

YOLOv11改进策略【损失函数篇】| 替换激活函数为Mish、PReLU、Hardswish、LeakyReLU、ReLU6 在卷积神经网络中,激活函数通过在神经网络中引入非线性,使网络能够学习和逼近复杂函数,从而处理复杂的模式识别与分类问题。 阅读详情

相关推荐

云漾AI创作平台实战:如何用GPT4.0+Midjourney快速生成商业级插画(附Prompt模板)

本文详细介绍了如何利用云漾AI创作平台结合GPT4.0和Midjourney快速生成商业级插画。通过智能文案生成与视觉化工作流,大幅提升创作效率,适用于电商、社交媒体等多种场景。文章包含实用Prompt模板和参数调整技巧,帮助设计师和内容创作者高效产出专业插画。

weixin_29251567的博客 219

ChatGPT识图分析实操指南:从拍照到精准识别的完整链路

多模态大模型的视觉理解能力正从实验室走向日常生产力工具,其核心在于图像输入→语义解析→结构化输出的技术闭环。GPT-4o已突破传统OCR局限,支持布局感知、自适应增强与多步推理,但实际效果高度依赖图像质量、模型版本及提问方式三大前提。理解其视觉编码器的patch size限制、语义盲区与单帧处理特性,是规避幻觉与误判的关键。本文聚焦真实场景下的可复现操作——涵盖手机拍摄黄金三角法则、HEIC转JPEG等格式预处理、EXIF元数据剥离,以及‘角色+任务+约束’式精准提问范式,助力用户在教育、工程、法律、消费等

weixin_34049948的博客 495

强化学习-马尔可夫模型

前文提到了强化学习源自马尔可夫决策过程,本文从马尔可夫概念入手,讲解和马尔可夫有关的模型和概念。在马尔科夫决策过程中,我们有一个智能体,它在一个马尔科夫过程中进行决策,每次决策都会导致状态的转移和获得即时奖励。智能体的目标是通过选择动作来最大化未来奖励的期望值。通常马尔科夫决策过程是个五元组:SAPRγSAPRγS 表示状态集合,代表智能体可能处于的所有状态。A 表示动作集合,代表智能体可以采取的所有动作。

君子之学必日新,日新者日进也。不日新者必日退,未有不进而不退者 8062

大模型幻觉检测新方法:实时检测技术详解

文章介绍了苏黎世联邦理工学院等机构开发的一种大模型实时幻觉检测技术。该技术通过训练轻量级线性探针,能够在大模型生成内容时实时识别虚构实体(人名、地名等),而非检测整个句子。实验表明,该方法在长文本生成等场景中表现优异,且数据集和代码已开源。这项技术标志着幻觉检测从"事后补救"转向"过程监控",特别适用于医疗、法律等高风险AI场景。

2401_85375151的博客 1057

ROST_CM6软件之词频分析、社会网络和语义网络分析、情感分析

简介 ROST CM 6是武汉大学沈阳教授研发编码的国内目前唯一的以辅助人文社会科学研究的大型免费社会计算平台。该软件可以实现微博分析、聊天分析、全网分析、网站分析、浏览分析、分词、词频统计、英文词频统计、流量分析、聚类分析等一系列文本分析。 社会网络和语义网络分析(S) 数据 注意,保存时编码要为ANSI 所以这里需要转换一下 准备自定义表与停词表 例如 同时,点击快速分析后,将会弹出网络图 对网络图进行设置 对布局进行设置 对节点、边进行设置 最终效果图 修改 情感分析

积一时之步,臻千里之遥程 9万+

802.1x之EAP-TLS测试方法

CA证书一般是由权威的认证机构发出,用来验证该机构签名的证书,持有CA证书的设备可以验证对端的证书是否由自己信任的机构颁发的。在我们内部使用证书时,我没可以自己充当CA认证机构,管理私钥和CA证书,使用他们签名服务器、客户端证书。2、使用证书请求文件server_csr.pem、CA私钥、CA公钥生成服务器证书(正常情况下自己不拥有CA私钥,是把证书请求文件发给认证机构,由认证机构返回证书)进行802.1x EAP-TLS认证时需要IPC、服务器分别存储CA证书、设备证书、私钥,通过交换证书实现身份验证。

写作是为了更好的思考 2164

大模型系列——幻觉

信息抽取模型可直接使用大模型本身来抽取,也可以使用现有的信息抽取模型 需要一个信息抽取模型 需要评测基准验证该评估方法的可行性,并与人类对齐 https://arxiv.org/pdf/1905.13322 待定⌛️ 效果一般,且需要依赖较为复杂且可靠的信息抽取模型。例如,大型语言模型(LLMs)可以从生成性反馈循环中显著受益,通过Milvus这样的开源向量数据库,可以高效地存储和检索编码文本数据语义的向量表示,从而创建一个不断学习和改进的动态系统。

hang on it more longer 4302

订餐平台餐厅信息抓取:使用Python爬虫获取商家信息和用户评价

在这篇博客中,我们展示了如何使用Python爬虫抓取订餐平台上的餐厅信息和用户评价数据。通过使用requests和Selenium,我们能够有效地从静态和动态网页中提取数据,并使用pandas和matplotlib对数据进行存储和分析。未来,您可以根据需求进一步扩展功能,例如增加错误处理、增加抓取多个页面的能力,或者使用高级技术如分布式爬虫来抓取更大规模的数据。

2201_76125261的博客 1651

大型语言模型幻觉检测相关综述

本综述对大型语言模型(LLMs)幻觉检测领域的关键数据集进行了系统性的梳理与分析。我们全面回顾了81个相关数据集,并基于其核心任务与评估目标,构建了一个包含四大类别——事实核查数据集、问答数据集、多模态幻觉检测数据集和专项幻觉基准——的分类体系。此项工作不仅为研究者提供了一份该领域的详尽资源地图,更重要的是,通过深入剖析各类数据集的设计理念、任务类型、评测指标和局限性,揭示了当前幻觉检测研究的现状、核心挑战与技术演进脉络。

yanqianglifei的专栏 2299

A*搜索算法在三维路径规划(避障)中的MATLAB实现与Python实现

A star algorithmA*搜索算法简介A*搜索算法的Python简化代码MATLAB实现启发函数回溯轨迹RRT算法对比A\*算法在三维路径规划中的一些不足 A*搜索算法简介 A*搜索算法是Greedy Best-First算法的改进,因为Greedy Best-First算法只考虑将预估距离(当前节点到目标点的预估距离)作为遴选开节点集的条件。即: priority=heuristic(goal,next)priority=heuristic(goal, next)priority=heurist

ZYunfei的博客 2万+

RAG 实战:LangChain + 向量数据库构建知识问答系统

从文档加载、分割、嵌入到检索增强生成,完整实现一个基于本地文档的知识问答系统。

kaixin110a的博客 188

【干货收藏】大模型幻觉检测革命:从“亡羊补牢“到“实时监控“

苏黎世联邦理工学院研究团队开发了流式幻觉检测器,能在长文本生成过程中实时高亮可能存在幻觉的"实体"。该方法通过训练轻量级线性探针直接读取模型生成时的"思维痕迹",即时判断内容真伪。实验显示,这种方法在AUC指标上远超传统方法,且标注数据具有迁移性。研究已开源代码和数据,标志着幻觉检测从"事后补救"进入"过程监控"新阶段,为AI安全落地提供重要支持。

weixin_72959097的博客 1019

路径跟踪 | 图解纯追踪算法Pure Pursuit(附ROS C++/Python/Matlab仿真)

纯追踪算法(Pure Pursuit)参考了人类驾驶行为,其基本思想是在待跟踪路径上设置预瞄点(goal-ahead),通过简单的几何方法驱动机器人跟踪预瞄点直至抵达目标位置.本文详细推导纯追踪算法的理论原理及其变种——自适应纯追踪算法(APP)和规范化纯追踪算法(RPP),并提供ROS C++/Python/Matlab三种仿真实现加深理解

FRIGIDWINTER的博客 8408

一份全面的大模型「幻觉」综述

,来自腾讯AI实验室和一些国内大学的研究团队,综述提出了LLM幻觉现象的分类法和评估基准,分析旨在减轻LLM幻觉的现有方法,并确定未来研究的潜在方向。将重点放在解决与数据相关的幻觉、与训练相关的幻觉和与推理相关的幻觉的方法上,每种方法都提供了量身定制的解决方案,以应对各自原因所固有的特定挑战。)从LLM幻觉的创新分类方法出发,深入探究了可能导致幻觉的因素,并对检测幻觉的方法和基准进行了概述。目前在LLM幻觉问题上已经有无数的研究,比如关于幻觉的检测、幻觉的评估基准分类、缓解幻觉的方法等。

u012744245的博客 4935

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【必须知道】LLM大模型幻觉(hallucination)的成因和处理测试

大模型的幻觉,即是指大模型的生成结果中包含了无根据的或错误的内容,生成结果中不可避免的存在着事实编造,这类问题被称为幻觉问题。模型能力越强大,生成结果的语言越流畅,与用户的交互越自然,用户就越不容易分辨出结果的真伪,幻觉问题的潜在危害性就越大。幻觉一词来自英文文献中的 "hallucination" 的翻译,根据 Merriam Webster 词典的解释,幻觉是无根据的或错误的表达或看法(an unfounded or mistaken impression or notion)。

longxiaotian718的博客 2754

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Detecting and Preventing Hallucinations in Large Vision Language Models----大视觉语言模型中检测和预防幻觉

近年来,大型语言模型 (LLM) 改变了人工智能格局,将其训练数据扩展到数万亿个标记,将参数数量扩展到数千亿个(Brown 等人,2020 年;Touvron 等人,2023 年)。这释放了强大的智能行为,并通过使用 ChatGPT 等聊天代理得到了广泛采用。最近,多模态模型的进展已经被广泛采用,将视觉主干移植到预训练的大型语言模型上,从而产生了 LVLM(Liu et al. 2023b;

Mars_prime的博客 1844

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

大小模型的智慧碰撞:揭秘AI幻觉实时检测

论文标题:SLM Meets LLM: Balancing Latency, Interpretability and Consistency in Hallucination Detection论文链接:https://arxiv.org/pdf/2408.12748大型语言模型(LLMs)能力强大,但在实时应用中面临延迟挑战,例如进行在线幻觉检测。为解决这一问题,论文提出了一种新颖的工作流程来解决这一挑战,通过平衡延迟和可解释性。

weixin_58753619的博客 1613

大模型「幻觉」,看这一篇就够了 | 哈工大华为出品

西风 发自 凹非寺量子位 | 公众号 QbitAI大模型“幻觉”,终于有系统综述了!一口气49页,详细阐述了幻觉定义、分类、导致幻觉的原因,还有检测幻觉、减轻幻觉的方法。这篇最新综述来自哈工大和华为,一po出就在网上火得不行:具体来说,文中用一套新的范畴框架来定义模型幻觉,并将其分为事实性幻觉、忠实性幻觉两大类。此外,它还总结了模型产生幻觉的三大来源:数据源、训练过程和推理,并给出了对应的减轻幻觉...

量子位 1257

大模型评测之幻觉检测hallucination_evaluation_model

大背景: 2025开年deepseek铺天盖地的新闻 参会代表已经表明,年度主线就是以AI为基础 Manus于3月初横空出世 国内各种模型竞赛的现状,只要是和科技沾边的公司不可能没有大模型,哪怕是里三层外三层套壳也得上 东升西降,宏观使然,竞争中必然有科技竞争 小背景  本公司自研大模型rd,在模型排名中必有一席之地 除了加大力度研发,还需各种评测 正好,吾就是一名专业的模型评测员 随着各...

weixin_40695257的博客 251

检测和缓解大型视觉语言模型中的幻觉现象:基于细粒度AI反馈的方法

检测和缓解大型视觉语言模型中的幻觉现象:基于细粒度AI反馈的方法 Detecting and Mitigating Hallucination in Large Vision Language Models via Fine-Grained AI Feedback

Together_CZ的博客 1635

AI幻觉检测:商业应用中的关键挑战

幻觉检测是AI领域的关键挑战,尤其在商业应用中,AI生成的虚假或误导性信息可能导致负面用户体验、错误传播和法律风险。为应对这些问题,研究者提出了两阶段检测方法(快速筛查+深入分析)和数据飞轮机制,通过持续的数据反馈和模型更新提升检测能力。这些方法在效率与准确性之间取得平衡,适用于大规模生产环境,并具有成本效益和可扩展性。未来,幻觉检测系统还需应对非结构化数据、常识推理等复杂挑战,同时考虑伦理问题,确保系统的负责任使用。

XianxinMao的博客 876

最新研究综述——探索基础模型中的“幻觉”现象

深度学习自然语言处理 原创作者:Winnie“幻觉”问题即模型生成的内容可能包含虚构的信息。它不仅在大语言模型(LLMs)中存在,也存在于图像、视频和音频等其他一系列基础模型中。针对这一问题,一篇最近的综述论文对目前所有基础模型的“幻觉”问题进行了第一次全面的调查,详细分类了各类基础模型中的幻觉现象,审视了现有的减轻幻觉问题的策略,并提出了一套用于评估幻觉程度的标准。Paper: A Survey...

zenRRan的博客 751

计算机视觉——利用AI幻觉检测图像是否是生成式算生成的图像

俄罗斯的新研究提出了一种非常规方法,用于检测不真实的AI生成图像——不是通过提高大型视觉-语言模型(LVLMs)的准确性,而是故意利用它们的。这种新方法使用LVLMs提取图像的多个“原子事实”,然后应用(NLI),系统地衡量这些陈述之间的矛盾——有效地将模型的缺陷转化为检测违背常识的图像的诊断工具。WHOOPS!数据集中两张图片与LVLM模型自动生成的陈述。左侧图片是真实的,导致描述一致,而右侧不寻常的图片导致模型产生幻觉,产生矛盾或错误的陈述。

知来者逆的博客 1669

大模型幻觉研究(中):如何检测幻觉

本文研究了大语言模型(LLM)生成内容中的"幻觉"问题,即模型输出包含虚构或不准确信息的情况。文章将幻觉分为事实性幻觉和忠实性幻觉两类,并提出了三种检测方案:基于外部知识的RAG检测、基于LLM内置知识的检测,以及基于token概率分布的检测。重点介绍了FactScore方案,该方案通过将长文本分解为原子事实并逐一验证来评估真实性。文章还详细分析了原子事实分解的质量评估指标,包括原子率、准确率、覆盖率和冗余率,并提供了实现Prompt。

New World 2107

揭秘RAG中的幻觉检测:多种方法全面基准测试,找出最优解!

在当前的 Retrieval-Augmented Generation (RAG) 应用中,幻觉问题依然是不可忽视的难题。模型生成的内容往往会出现与事实不符的情况,给用户带来困扰甚至误导。 因此,如何有效检测并避免这些幻觉,成了关键研究方向。今天我们将深入评估 4 个主流 RAG 数据集中的几种流行幻觉检测器。

qingkahui24689的博客 1351

大模型RAG技术精要:从Chunk切分策略到实体幻觉检测实战指南

本文系统梳理了RAG中的chunk切分策略,包括Pre/Post-Chunking两种方法及9种具体切分技术(Fixed-Size、Recursive等)。同时提出结合RAG与数据合成的实体幻觉检测方案:通过构建LongFact++数据集,利用Claude验证生成内容中的实体真实性;并开发线性探针和LoRA探针技术,通过分析大模型中间层激活值实现实时实体级幻觉检测。该方案通过数据增强和模型探针技术,有效提升了生成内容的可靠性。

优快云_430422的博客 1172
上一篇: 终结医疗AI乱象!ClinicalAgent多智能体框架:伦理合规+精准预测双杀,33.26%提升背后技术全拆解
下一篇: 彻底搞懂大模型!从零拆解LLM核心原理:海量文本统计+神经网络拟合,万字长文一篇通!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值