


❝
一句话概括,论文教你如何把ChatGPT调教成PUA大师:用强化学习给安慰话术标价,让每个’多喝热水’都经过长期回报精算
第一阶段:识别核心概念
论文的motivation分析
情感支持对话(Emotional Support Conversation,简称ESC)旨在通过有效的对话来缓解个体的情绪困扰。然而,当前的大语言模型(LLMs)在处理这类对话时,往往侧重于单轮回复的即时效果,缺乏对多轮对话的长期策略规划。这可能导致对话在初期看似合理,但随着对话的深入,无法有效地引导用户情绪向积极方向发展,甚至可能出现策略偏向(如反复使用同一种安慰方式)或无法平滑过渡到对话的不同阶段(如从探索问题到提供解决方案)。
真实的心理咨询或情感支持通常包含探索、安慰、行动等多个阶段,需要支持者根据求助者的状态和对话进展,动态调整支持策略。现有LLM直接进行端到端回复生成的方式,难以显式地控制和优化这种长期的策略转换。
因此,本文的动机在于,将强化学习中的Q-learning思想引入LLMs,使模型能够从“策略层面”进行规划,像一个价值驱动的策略规划器一样,根据对话的当前状态(用户的话语、情绪、历史)预测不同策略的长期回报(Q值),选择最优策略,并指导LLM生成最终回复,从而提升多轮情感支持对话的长期满意度和有效性。
论文主要贡献点分析
1. 提出策略级马尔可夫决策过程(MDP)的定义,并将LLM构建为基于文本输入的状态和策略的Q函数。* 关键技术/方法:将情感支持对话中的策略选择问题形式化为一个MDP。这意味着对话的每个时刻(状态)下,选择一个支持策略(动作)会导向下一个状态,并获得一个即时奖励。LLM被用来近似这个Q函数,即输入当前对话状态和候选策略,LLM输出这个策略的Q值(长期回报)。 * 显著性结果:这种定义使得可以应用强化学习(特别是Q-learning)的框架来优化策略选择,从而关注长期对话效果。
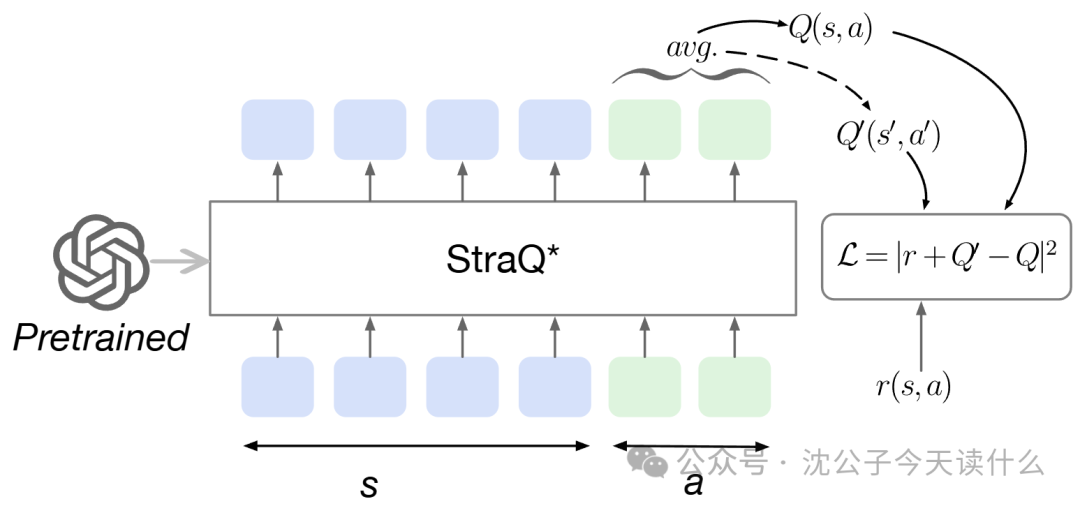
2. 实验证明预训练LLM可以通过贝尔曼方程进行微调,并收敛到最优回报,其中动作词元的平均logit作为q值。* 关键技术/方法:使用贝尔曼方程作为损失函数来微调LLM。具体地,LLM输出的动作(策略)词元的平均logit被用作的估计。通过最小化当前Q值与目标Q值(通过贝尔曼方程计算得到)之间的差异来更新LLM参数。 * 显著性结果:这表明LLM不仅能生成文本,还能通过微调学习到一种“价值评估”能力,能够预测特定策略在特定情境下的长期效果,将下一代币预测任务转换为下一策略预测任务。
3. 在ESConv和EmpatheticDialogues数据集上的大量实验表明,straQ*在回复质量和策略规划的合理性方面均优于多种基线方法。* 关键技术/方法:straQ框架(本文提出的方法)与直接推理、自优化、思维链、微调、有限状态机等多种方法进行对比。 * 显著性结果:straQ在策略准确性(Acc, Q)、偏好偏差(B)以及回复质量(Bleu-2, Rouge-L)等自动评估指标和人工评估指标上均取得了领先,证明了其有效性。
4. 设计了两种奖励机制:模仿(imitation)和蒸馏(distillation),前者在自动指标上表现更优,后者在人工评分和泛化能力上表现更佳。* 关键技术/方法: * 模仿奖励(straQ*-imit):将数据集中专家标注的(状态,策略)对视为正样本(奖励+1),随机采样其他策略作为负样本(奖励-1)。 * 蒸馏奖励(straQ*-distill):利用强大的基础模型(如GPT-4)对数据集中的(状态,策略)对产生的回复进行评分(0-5分),将此评分作为奖励。 * 显著性结果:提供了两种有效的奖励设计方案。模仿学习能更好地拟合训练数据分布,在自动指标上占优;而蒸馏学习则借鉴了更强模型的判断力,在人工评估(如流畅性、情感表达、满意度)和模型泛化到未见过的数据(OOD)时表现更好,因为它能避免学习数据集中本身可能存在的低质量回复。
理解难点识别
1. 策略级MDP(Strategy-level MDP)与LLM的Q函数化:* 关键概念:如何将一个连续的、开放域的对话过程,在“策略选择”这个层面抽象成一个MDP的状态(State)、动作(Action)、转移(Transition)和奖励(Reward)。 * 挑战部分:理解LLM如何被改造为一个Q函数。通常LLM用于生成文本,这里它需要接收状态(文本描述)和动作(策略的文本描述),然后输出一个标量Q值(通过对动作词元的logits取平均得到)。这种角色转变和实现方式可能较难直观理解。 * 需重点解释:LLM作为Q函数的具体实现,特别是Q值是如何从LLM的输出(logits)中计算出来的。
2. 贝尔曼方程在LLM微调中的应用:* 关键概念:Q-learning的核心是贝尔曼方程,它定义了Q值的递归关系。 * 挑战部分:如何将这个通常用于表格型或具有明确数值输出的神经网络的方程,应用于微调一个以生成文本为主要任务的LLM。损失函数如何基于贝尔曼方程构建,并作用于LLM的参数更新。 * 需重点解释:基于贝尔曼方程的损失函数如何指导LLM的参数更新,以学习到更优的策略评估能力。
3. 两种奖励机制(模仿与蒸馏)的设计与影响:* 关键概念:强化学习的效果高度依赖于奖励函数的设计。 * 挑战部分:理解模仿奖励和蒸馏奖励的具体设置方式,以及它们各自的优缺点,为什么它们会导致在不同评估维度上的性能差异。 * 需重点解释:两种奖励机制如何为LLM提供学习信号,以及它们对模型行为和最终性能的具体影响。
概念依赖关系
- 情感支持对话(ESC)的挑战 (是起点):首先需要理解当前LLM在ESC中面临的长期规划不足的问题。
- 策略级马尔可夫决策过程 (Strategy-level MDP) (核心抽象):基于ESC的挑战,引入MDP框架来形式化策略选择问题。这是后续方法的基础。
- Q-Learning 与贝尔曼方程 (核心算法理论):理解了MDP后,自然会想到用Q-learning求解。贝尔曼方程是Q-learning的数学核心,定义了Q值的学习目标。
- LLM 作为 Q函数 (关键实现):将Q-learning应用于LLM,需要让LLM能够输出Q值。这里,论文提出用动作词元的平均logit作为Q值。这是连接理论与实践的关键一步。
- 奖励机制 (模仿与蒸馏) (学习的驱动力):Q-learning需要奖励信号。论文设计的两种奖励机制为LLM的学习提供了具体的反馈。
- straQ* 框架 (整体解决方案):将以上所有概念整合起来,形成最终的straQ*框架,包括策略规划(基于Q值选择策略)和回复生成(基于选定策略指导LLM)。
解释的最佳切入点: 从“LLM在多轮情感支持对话中缺乏长期规划”这一痛点出发,引出“为何需要策略级的决策”,然后介绍如何将此问题形式化为“策略级MDP”。接着,解释如何用“Q-learning”来求解这个MDP,特别是“LLM如何扮演Q函数并利用贝尔曼方程进行学习”。最后,讨论“奖励信号”如何设计来驱动这个学习过程。
这样,读者可以先理解问题的本质和建模思路,再逐步深入技术细节。
第二阶段:深入解释核心概念
此阶段重点是引入比喻并将比喻和公式符号联系在一起
设计生活化比喻
想象你是一位新手心理辅导师(LLM),正在学习如何更好地帮助前来咨询的求助者。你的目标不是只说一句让求助者当下感觉舒服的话,而是希望通过几轮对话(多轮对话),真正帮助他们梳理情绪、找到应对方法,最终让他们感到满意和释怀(长期回报)。
-
求助者的状态(State, ):每次求助者说完话,你就需要评估他当前的情绪、他描述的问题、以及你们之前的谈话内容。这就是当前的状态。
-
辅导策略(Action, ):你面前有好几种辅导策略卡片,比如“提问澄清”、“表达共情”、“给予肯定”、“提供建议”等。你需要从中选择一张最合适的策略卡片。
-
策略的价值(Q-value, ):对于每张策略卡片,你心里需要估算一下:如果我现在用这张卡片上的策略,从长远来看(考虑到后续几轮对话直到咨询结束),能给求助者带来多大的帮助(比如最终求助者的满意度分数会是多少)?这个估算的分数就是Q值。
-
选择策略:你选择那张你认为Q值最高的策略卡片。
-
执行策略并回应(Response Generation):选好策略卡片后,你就按照卡片上的指引(比如“提问澄清”),结合求助者具体说的话,组织语言给出回应。
-
获得反馈(Reward, ):求助者听了你的回应后,可能会有一些反应。比如,他可能会说“你这么一说我感觉好多了”(正向反馈),或者他可能显得更困惑(负向反馈)。在训练时,我们可能会有一个“资深督导(比如GPT-4)”来给你的这次回应打分,这个分数就是即时奖励。
-
学习与调整(Q-learning Update using Bellman Equation):
-
- 你观察到,用了某个策略后,获得了即时奖励,并且求助者进入了一个新的状态。
- 你再想,如果进入新状态后,我继续使用最优策略,又能获得多大的长期价值呢()?
- 那么,当前策略的“真正”价值应该是“即时奖励 + 未来可持续获得的价值(折扣后的)”。
- 你会比较这个“真正”价值和你之前对的估算。如果估算不准,你就调整自己的估算标准(更新LLM的参数),争取下次估算得更准。这个调整过程就是基于贝尔曼方程的Q学习。
通过不断地“评估状态 -> 选择策略 -> 观察反馈 -> 学习调整”,这位新手辅导师(LLM)会越来越懂得在什么情况下使用什么策略,才能最好地帮助求助者,实现长期的情感支持目标。
建立比喻与实际技术的对应关系
| 比喻中的关键元素 | 实际技术概念 | 为什么对应关系合理 |
|---|---|---|
| 新手心理辅导师 | 大语言模型 (LLM) | LLM是执行情感支持任务的主体,通过学习提升能力。 |
| 求助者 | 用户 (Seeker) | 用户是情感支持服务的对象。 |
| 求助者的当前情况和谈话历史 | 状态 (State, ) | 对话的上下文信息(包括用户情绪、描述、历史对话)构成了决策的基础。 |
| 辅导策略卡片 | 策略集合 (Action space, ) | 预定义的几种支持策略(如提问、共情)是LLM可以选择的“动作”。 |
| 估算策略的长期帮助程度 | Q值 () | Q值代表在状态下采取策略能带来的累积期望回报,衡量策略的长期有效性。 |
| 选择Q值最高的策略卡片 | 最优策略选择 () | 强化学习的目标是找到能最大化长期回报的策略。 |
| 按照策略卡片组织回应 | 基于策略的回复生成 | LLM根据选定的策略来指导其生成具体的对话回复。 |
| 资深督导的打分 | 奖励 (Reward, ) | 奖励是对LLM当前策略选择和回复的即时反馈,指导其学习方向。论文中对应GPT-4评分(蒸馏)或专家演示匹配(模仿)。 |
| 学习调整估算标准 | Q学习更新 (Bellman Equation) | LLM通过贝尔曼方程不断修正其对Q值的估计,使其更接近真实的长期回报,从而优化策略选择能力。 |
| 多轮对话直到咨询结束 | 多轮情感支持对话 (Multi-turn ESC) | 目标是优化整个对话过程中的情感支持效果,而非单轮。 |
| 未来可持续获得的价值 | 折扣后的未来最大Q值 () | 贝尔曼方程考虑了即时奖励和未来潜在奖励。是折扣因子,表示未来奖励的重要性。 |
深入技术细节
论文的核心是将LLM转化为一个价值规划器,这主要通过Q-learning实现。
1. LLM作为Q函数论文中,LLM 被用来近似Q函数 。这意味着给定当前状态 (由对话描述、用户情绪、对话历史等文本构成)和候选策略 (也是文本描述,如“Question”),LLM需要输出一个标量值,表示该策略的长期价值。 实现方式是:将状态 和策略 通过一个指令模板 拼接起来,即 ,然后输入给LLM。LLM会对这个输入序列生成每个词元的logits。论文提出,策略 对应的词元的平均logits被用作 的估计。 公式 (5):
❝
原版数学形式:
(where means to average the action logits)
❝
符号替换版本:某个策略在当前状态下的估算长期价值 = 语言模型处理(包含当前状态的指令 拼接上 这个策略的文本描述)后,针对策略文本部分输出的词元信心分数(logits)的平均值
2. 通过贝尔曼方程训练Q函数Q-learning的目标是学习一个最优Q函数 ,它满足贝尔曼最优方程: 公式 (1):
❝
原版数学形式:
❝
符号替换版本:在状态s下采取策略a的最优长期价值 = 采取策略a后立即获得的奖励 + 折扣因子 × 在下一个状态s’下采取所有可能策略a’中能得到的最大最优长期价值
在深度Q网络(DQN)中,使用两个网络:一个Q网络 和一个目标Q网络 (参数 定期从 复制而来,以稳定训练)。训练的目标是最小化Q网络预测值与贝尔曼方程给出的目标值之间的差异。 损失函数 如公式 (2) 所示:
❝
原版数学形式:
(论文中实际写的是 ,这意味着 是通过某种方式(如从 中贪心选择,或从数据集中来)确定的,这里我们假设是 以对应贝尔曼最优方程,或者 就是数据集中的下一动作,则目标Q值是 ) 严格按照论文图2,它是 ,而 并没有明确写 ,但结合Q-learning的上下文,通常目标Q网络会用于估计 处的最大未来回报。为简化,我们假设 指的是在 处根据目标网络选择最优动作后的Q值。
❝
符号替换版本:当前Q网络的学习误差 = ( 即时奖励 + 折扣因子 × 由目标Q网络估算的下一个状态s’的最佳策略能带来的长期价值 - 当前Q网络对当前状态s和策略a的长期价值估算 ) 的平方
通过最小化这个损失 ,LLM的参数 被更新,使其能更准确地预测策略的长期价值。
关键步骤实现:
-
输入构建:将对话状态 (包含用户情绪、对话历史、背景描述)和候选策略 填入预设的指令模板 。
-
Q值计算:将上述拼接文本输入LLM,取策略 部分词元的平均logits作为 。
-
策略选择(推理时):选择具有最大Q值的策略 。
-
回复生成:将选定的策略 和状态 输入给(可以是同一个或另一个)LLM,生成回复。
-
训练:
-
- 收集经验 。 来自模仿奖励或蒸馏奖励。
- 使用贝尔曼方程计算目标Q值 。
- 计算损失 。
- 通过梯度下降更新Q网络参数 。
- 定期将Q网络参数 复制到目标Q网络参数 。
将技术细节与比喻相互映射
| 技术步骤/概念 | 在“心理辅导师”比喻中的体现 | 比喻如何帮助理解 |
|---|---|---|
| LLM 作为 Q函数 (公式 5) | 辅导师(LLM)在看到求助者的情况(状态s)和一张策略卡片(策略a)时,在心里快速评估“这张卡片用下去,长期效果好不好?”这个评估分数就是Q值。LLM通过分析“状态+策略”的文本描述,给出这个分数。 | 将抽象的Q函数实例化为一个“评估系统”,LLM通过理解文本来打分,而不是直接进行数学运算。 |
| 贝尔曼方程 (公式 1) | 辅导师思考:“这次辅导(策略a)的直接效果(奖励r)加上后续如果我继续做得很好能带来的总效果(未来最大Q值),才是我这次策略选择的真正价值。” | 强调了决策的长期性和迭代性。辅导师不是只看眼前,而是会考虑这一步对后续整个辅导过程的影响。 |
| 损失函数 (公式 2) | 辅导师发现自己对某个策略的长期效果预估()与“实际发生的即时效果+后续最佳效果预估”()有差距,于是反思并调整自己的判断标准(更新参数 )。 | 让学习过程更具体:当辅导师的“预判”与结合了实际反馈的“后验判断”不一致时,就需要学习和修正。 |
| 状态 (文本描述) | 求助者说的每一句话、他的表情、之前聊过的内容等,都是辅导师需要考虑的“当前情况”。 | 将对话的复杂信息打包成一个整体的“情境”。 |
| 策略 (文本描述) | “提问”、“共情”、“给建议”这些写在卡片上的具体行动指南。 | 将抽象的“动作”具体化为可操作的指导方针。 |
| 奖励 (模仿/蒸馏) | 辅导结束后,求助者的反馈,或者资深督导对这次辅导环节的评分。 | 提供了学习的直接动力和方向。好的反馈鼓励辅导师继续这么做,不好的反馈则促使其改进。 |
| 折扣因子 | 辅导师认为“眼前能解决的问题很重要,但也不能为了眼前完全牺牲长远目标”。 代表了对未来有多看重。 | 平衡了即时满足和长远规划。如果 小,辅导师更“急功近利”;如果 大,则更“深谋远虑”。 |
| 更新LLM参数 | 辅导师通过不断实践和反思,经验越来越丰富,判断策略效果的能力也越来越强。 | LLM的学习过程就像人的经验积累和能力提升。 |
比喻的局限性:
- Q值的精确计算:比喻中辅导师“心里估算”Q值,而实际LLM是通过复杂的神经网络计算和平均logits得到,这个过程比“估算”更具体和数学化。
- 奖励的来源:比喻中奖励来自“求助者反馈”或“督导打分”,这简化了模仿奖励(基于专家数据匹配)和蒸馏奖励(GPT-4评分)的复杂性。
- 状态和动作的离散化:在真实对话中,状态和策略的界限可能模糊,比喻将其清晰化为“当前情况”和“策略卡片”,这是一种简化。
- LLM的内部工作:比喻未涉及LLM内部的Transformer结构、注意力机制等。
总结
-
核心联系:无论是心理辅导师学习辅导技巧,还是LLM学习情感支持策略,核心都是通过经验(对话交互)、反馈(奖励) 和 对未来的预期(未来Q值) 来不断优化当前的 决策(选择哪个策略),以达到 长期目标(求助者满意/情感缓解)。
-
帮助理解的关键点:比喻将强化学习中的抽象概念(状态、动作、奖励、Q值、贝尔曼方程)转化为辅导师学习过程中的具体思考和行为,使得这些概念不再是冰冷的符号,而是有实际意义的步骤。
-
关键数学原理的总结 (用比喻):
-
- 贝尔曼方程 (公式 1):辅导师的智慧在于,“一个好策略的价值 = 这一下能带来的立竿见影的好处 + 之后继续用好策略能带来的所有好处的总和(打点折)”。
- Q学习的损失 (公式 2):辅导师要进步,就要看“自己对一个策略效果的预估”和“实际发生的好处加上对未来的最佳预期之和”差了多少,差得越少,说明预估越准,辅导水平越高。
第三阶段:详细说明流程步骤
1. 论文整体流程概述
论文提出的straQ*框架旨在将LLM转化为一个基于价值的策略规划器,用于情感支持对话(ESC)。其核心流程可以概括为在对话的每个回合中,先使用一个Q网络(由LLM实现)来评估不同候选策略的长期价值,选择最优策略,然后指导另一个(或同一个)LLM基于该策略生成回复。在训练阶段,通过Q-learning和特定设计的奖励机制来优化这个Q网络。
整体流程步骤:
-
状态表征 (State Representation):
-
- 输入:当前用户的对话(query)、用户的情绪(emotion)、对话历史(history)、以及对话的背景描述(description)。
- 处理:将这些信息整合成一个文本形式的状态 。
-
策略价值评估与选择 (Strategy Valuation and Selection):
-
- 对于每个候选策略 ,构建输入 (其中 是包含状态信息的指令模板)。
- 将该输入送入straQ*的Q网络(一个微调后的LLM),计算策略 的Q值:,该Q值通过取 对应词元的平均logits得到。
- 选择具有最高Q值的策略作为最优策略:。
-
- 输入:当前状态 和一个预定义的策略集合 (例如:提问、复述、共情等)。
- 处理 (Q-network):
-
回复生成 (Response Generation):
-
- 输入:当前状态 和选定的最优策略 。
- 处理:将状态 和策略 输入到一个回复生成LLM(可以是Q网络本身,也可以是另一个LLM),该LLM被prompted以根据策略 和上下文生成回复。
- 输出:支持者的回复 。
-
奖励计算 (Reward Calculation - 训练时):
-
- straQ-imit (模仿)*:如果 与专家数据集中的标注一致,则 ;否则,如果 是一个随机采样的非专家策略,则 。
- straQ-distill (蒸馏)*:使用一个强大的教师模型(如GPT-4)评估基于 生成的回复的质量,给出一个分数(例如0-5),此分数即为奖励 。
-
- 输入:状态 ,选择的策略 ,生成的回复 。
- 处理:根据预设的奖励机制计算奖励 。
-
Q网络更新 (Q-Network Update - 训练时):
-
- 使用目标Q网络 计算下一个状态的最大Q值:。
- 计算TD目标 (TD Target): (其中 是折扣因子)。
- 计算当前Q网络的预测Q值:。
- 计算损失:。
- 通过梯度下降更新Q网络 的参数。
- 定期将Q网络 的参数同步到目标Q网络 。
-
- 输入:经验元组 ,其中 是对话在支持者给出回复 且用户给出下一轮query后的新状态。
- 处理:
-
循环:重复以上步骤进行多轮对话。在推理(部署)时,仅执行步骤1、2、3。
2. 关键子流程及输入输出示例
子流程1: 状态构建与策略价值评估
-
输入:
-
- 用户最新发言: “Well my husband recently got his hours cut and we are struggling.”
- 用户情绪: “anxiety”
- 对话历史: “Supporter: Hi! Hope you are doing well? \n Seeker: Hi, yes am doing well \n Supporter: How can I help you today?”
- 背景描述: (可能为空或提供一些通用背景)
- 候选策略列表: [“Question”, “Restatement or Paraphrasing”, “Reflection of Feelings”, …]
-
处理:
-
-
将上述信息组合成一个详细的文本状态 。
-
对每个候选策略 ,构建如附录A.2中所示的MCQ格式的prompt:
You are a psychological consultant...
Emotion: anxiety
Description: ...
History: ...
Seeker's current query: Well my husband recently got his hours cut and we are struggling.
Based on the above context, please select the most appropriate response strategy from the following options:
strategy #(1) Question
strategy #(2) Restatement or Paraphrasing
...
Please provide your selection in the format of (1) through (k). Your selection is:
(注意:这里是MCQ格式用于策略选择的prompt,Q值计算基于 的logits平均。论文中MCQ prompt用于推理,而Q值计算的 是更底层的形式。) 更准确地说,对于Q值计算,输入是 ,例如,是去掉了选项和"Please provide your selection…"部分的状态描述,然后直接拼接策略文本如 “Question”。
-
LLM () 对每个 计算 词元的平均logits作为 。
-
-
输出:
-
- 最优策略 : “Question” (假设其Q值最高,如图1所示)
子流程2: 回复生成
-
输入:
-
- 状态 (同上)
- 选定策略 : “Question”
-
处理:
-
-
构建回复生成prompt (如附录A.2所示):
You are a psychological consultant... Emotion: anxiety Description: ... History: ... Seeker's current query: Well my husband recently got his hours cut and we are struggling. The current response strategy is: Question Based on the current response strategy and other information, please act as a supporter and provide the best response... -
LLM (回复生成模型) 基于此prompt生成回复。
-
-
输出:
-
- 回复 : “I am so sorry to hear that. Will either of you be getting any other jobs?” (如图1所示)
子流程3: 奖励计算 (以straQ*-distill为例)
-
输入:
-
- 状态
- 选定策略 : “Question”
- 生成的回复 : “I am so sorry to hear that. Will either of you be getting any other jobs?”
-
处理:
-
-
构建GPT-4评分prompt (如附录A.2末尾所示):
You are a psychological consultant... Emotion: {e} (anxiety) Description: {desp} History: {h} Seeker's current query: {query} Please evaluate whether the response is appropriate: {resp} (I am so sorry to hear that...) Based on the information above, evaluate whether the response is suitable. Please remember to respond with a single integer number from 1 to 5... -
GPT-4 输出评分和解释。
-
-
输出:
-
- 奖励 : 假设GPT-4评分为 4。则 。
子流程4: Q网络更新
-
输入:
-
- 当前状态 ,选择的策略 ,奖励 。
- 假设用户下一轮回复 “No, not at the moment, we are looking.”, 情绪仍为 “anxiety”。由此构成新状态 。
- 折扣因子 。
-
处理:
-
- 从目标网络 获取 下的最佳Q值: 对于所有可能的 ,计算 ,取最大值,比如 。
- 计算TD目标: (注意:这里的奖励的尺度和Q值的尺度可能需要对齐,论文中Q值是logits的平均,可能在不同范围。如果奖励是0-5,Q值是logits,则需要归一化或使用value head将logits映射到奖励尺度,但论文提到平均logits作为Q值,所以可能存在尺度问题,或者Bellman更新时奖励信号也经过了某种变换。此处为简化说明,假设它们尺度兼容。)
- 获取当前Q网络对 的预测: 。
- 计算损失: 。
- 根据损失 更新 的参数。
-
输出:
-
- 更新后的Q网络参数 。
3. 伪代码示例
# 论文 StraQ* 框架伪代码 (简化版)

class StraQ_Star_Model:
    def __init__(self, llm_q_network_path, llm_response_generator_path, gamma, strategy_list):
        self.q_network = load_llm(llm_q_network_path) # LLM_theta
        self.target_q_network = load_llm(llm_q_network_path) # LLM_phi, initially same as q_network
        self.response_generator = load_llm(llm_response_generator_path) # Can be same as q_network
        self.gamma = gamma
        self.strategy_list = strategy_list # e.g., ["Question", "Affirmation", ...]
        self.replay_buffer = []
        self.optimizer = AdamOptimizer(self.q_network.parameters())

    def _get_q_value(self, network, state_text, strategy_text):
        # state_text: "Emotion: sad. History: ... Query: ..."
        # strategy_text: "Question"
        # prompt_template_q_value = "Context: {state}. Proposed Strategy: {strategy}. What is the Q-value?" (Simplified)
        # Actual method: avg logits of strategy tokens from LLM(I(s) XOR a)  <- paper uses \oplus for this
        # For simplicity, assume network(state_text, strategy_text) returns a scalar Q-value
        input_for_q_net = build_q_input_prompt(state_text, strategy_text) # I(s) XOR a
        # This part is crucial: how logits are averaged for the strategy tokens
        # output_logits = network.get_logits(input_for_q_net)
        # q_value = average_logits_for_strategy_tokens(output_logits, strategy_text)
        return network.predict_q_value(input_for_q_net, strategy_text) # Placeholder for actual logit averaging

    def select_strategy(self, state_text, network_to_use="q_network"):
        # state_text is the full context (emotion, history, query, desc)
        best_strategy = None
        max_q = -float('inf')

        current_network = self.q_network if network_to_use == "q_network" else self.target_q_network

        for strategy in self.strategy_list:
            q_val = self._get_q_value(current_network, state_text, strategy)
            if q_val > max_q: # Assuming standard comparison, no LaTeX >
                max_q = q_val
                best_strategy = strategy
        return best_strategy, max_q

    def generate_response(self, state_text, strategy_text):
        prompt_for_response = build_response_prompt(state_text, strategy_text)
        response_text = self.response_generator.generate(prompt_for_response)
        return response_text

    def get_reward(self, state_text, strategy_text, response_text, reward_type="distill"):
        if reward_type == "distill":
            # Use GPT-4 or strong teacher model to score the response
            # prompt_for_scoring = build_scoring_prompt(state_text, strategy_text, response_text)
            # score = teacher_model.generate(prompt_for_scoring) # e.g., "4"
            return get_gpt4_score(state_text, strategy_text, response_text) # Placeholder
        elif reward_type == "imit":
            # Check if (state_text, strategy_text) is expert demonstration
            if is_expert_demonstration(state_text, strategy_text):
                return 1.0
            else: # Assume it's a negatively sampled action
                return -1.0
        return 0.0 # Default

    def store_experience(self, state, action, reward, next_state, done):
        self.replay_buffer.append((state, action, reward, next_state, done))
        # Keep buffer size limited if necessary

    def train_step(self, batch_size):
        if len(self.replay_buffer) < batch_size: # standard <
            return None # Not enough samples

        minibatch = random.sample(self.replay_buffer, batch_size)
        total_loss = 0

        for state, action, reward, next_state, done in minibatch:
            # Get Q(s,a) from current Q-network
            current_q = self._get_q_value(self.q_network, state, action)

            # Get max Q(s',a') from target Q-network for TD target
            if done:
                target_q_next_max = 0.0
            else:
                _, target_q_next_max = self.select_strategy(next_state, network_to_use="target_q_network")

            td_target = reward + self.gamma * target_q_next_max

            # Calculate loss (e.g., Huber loss or MSE)
            loss = (td_target - current_q) ** 2
            total_loss += loss

        # Update Q-network
        self.optimizer.zero_grad()
        average_loss = total_loss / batch_size
        average_loss.backward()
        self.optimizer.step()

        return average_loss.item()

    def update_target_network(self):
        # Periodically copy weights from q_network to target_q_network
        self.target_q_network.load_state_dict(self.q_network.state_dict())

# --- Main training loop (simplified) ---
# model = StraQ_Star_Model(...)
# target_update_frequency = 10
# training_steps = 500

# for step in range(training_steps):
#     # Simulate a turn or get data from dataset
#     current_state_text = get_current_dialogue_state()
#     chosen_strategy, _ = model.select_strategy(current_state_text, network_to_use="q_network")
#     response = model.generate_response(current_state_text, chosen_strategy)
#     reward = model.get_reward(current_state_text, chosen_strategy, response)
#     next_state_text, done = get_next_dialogue_state_and_status(current_state_text, response)

#     model.store_experience(current_state_text, chosen_strategy, reward, next_state_text, done)

#     loss = model.train_step(batch_size=64)
#     if loss is not None: print(f"Step {step}, Loss: {loss}")

#     if step % target_update_frequency == 0:
#         model.update_target_network()

# --- Inference ---
# current_state_text = "User says: I feel so down today."
# optimal_strategy, q_val = model.select_strategy(current_state_text, network_to_use="q_network")
# final_response = model.generate_response(current_state_text, optimal_strategy)
# print(f"Optimal Strategy: {optimal_strategy}, Q-value: {q_val}")
# print(f"Generated Response: {final_response}")
注意: 上述伪代码为了清晰和简洁,做了一些简化:
_get_q_value中实际的logits平均过程未详细展开。build_..._prompt函数是占位符,实际需要根据附录A.2中的prompt格式实现。- 奖励获取
get_gpt4_score和is_expert_demonstration是高级抽象。 - LLM的加载和推理 (
load_llm,network.predict_q_value,network.generate) 是通用接口。 - 训练循环中的数据获取 (
get_current_dialogue_state,get_next_dialogue_state_and_status) 依赖于具体数据集和环境。
然而,这个伪代码结构展示了straQ*框架如何结合策略选择、回复生成、经验存储和Q学习更新的核心逻辑。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 591


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


