一文搞懂多模态理解(图像描述 + 视频描述 + 视觉问答)

多模态算法在视频理解中的应用 现阶段视频分类算法,主要聚焦于视频整体的内容理解,给视频整体打上标签,粒度较粗。较少的文章关注时序片段的细粒度理解,同时也从多模态角度分析视频。本文将分享使用多模态网络提高视频理解精度的解决方案,并在youtube-8m 数据集中取得较大提升。实验表明,上述几种方法均有不同程度的提高,尤其以多模态和图卷积提升比较明显。我们希望在未来探索更多的标签依赖关系。GCN 网络也被证明在这项任务中很有用,我们认为值得我们做更多的实验,将 GCN 网络与其他最先进的视频分类网络结合起来。 阅读详情

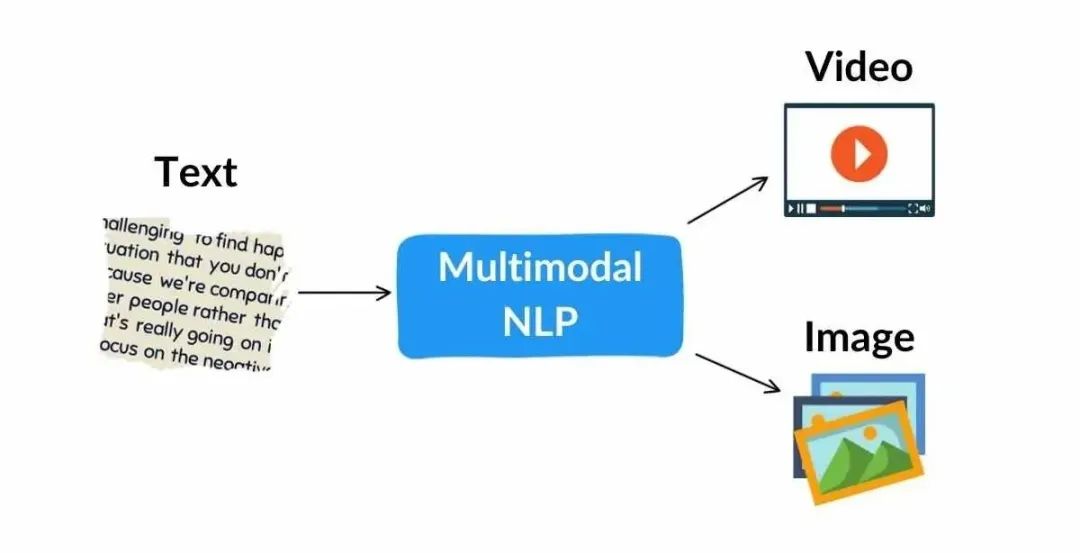
多模态理解是指从视觉、听觉、语言等多个不同模态的数据中提取并融合信息,以实现对数据含义的深入理解和推断的能力。多模态理解借助深度学习与计算机视觉(CV)和自然语言处理(NLP),将视觉信息转为自然语言,应用于图像描述、视频描述及视觉问答,显著扩展AI应用并提升智能。

*图像描述是**将视觉信息转换为连贯自然语言文本**的过程,**提升图像检索效率**;视频描述则进一步处理连续帧时序与动态,生成连贯视频内容描述,**应用于视频摘要、检索及监控等领域**;视觉问答(VQA)**结合图像理解与自然语言解析**,**挑战计算机感知、理解与语言生成能力,推动AI发展**。***
img

一、图像描述

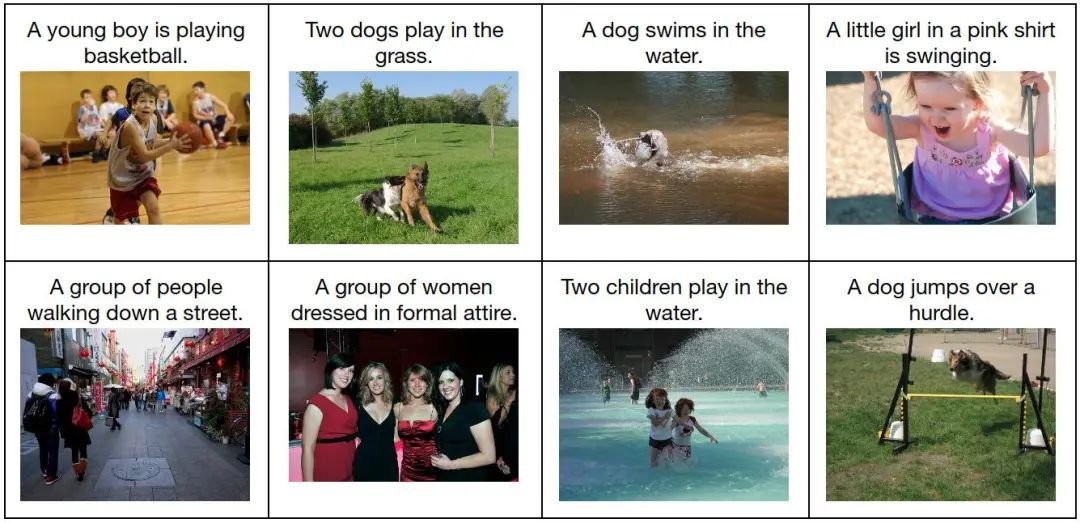
*什么是**图像描述(Image Captioning)?*图像描述任务要求模型能够准确识别图像中的物体、场景以及它们之间的关系,并用自然语言生成一段简洁、流畅且富有信息量的描述****。**
img

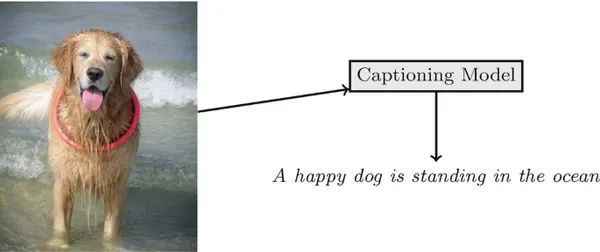
图像描述旨在让计算机能够根据给定的图像自动生成一段描述性文字,这类似于人类日常生活中的“看图说话”。但对计算机而言,这项任务极具挑战性,需要结合计算机视觉(Computer Vision, CV)与自然语言处理(Natural Language Processing, NLP)技术,实现图像与文本跨模态融合,让计算机自动生成描述性文字的高级应用。
img

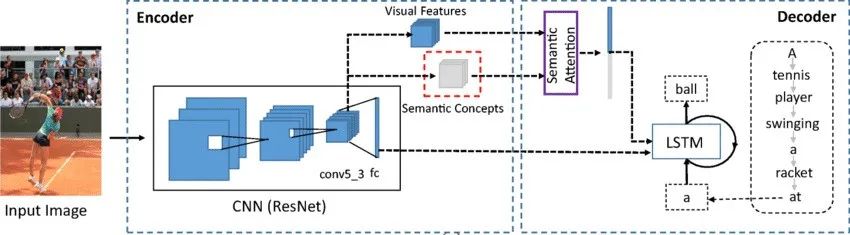
受机器翻译领域中编码器-解码器(Encoder-Decoder)模型的启发,图像描述可以通过端到端的学习方法直接实现图像和描述句子之间的映射,将图像描述过程转化成为图像到描述的“翻译”过程。
img

这一过程通常使用卷积神经网络(CNN)来提取图像中的视觉特征,如颜色、纹理、形状等;然后利用循环神经网络(RNN)或其变体(如长短期记忆网络LSTM、门控循环单元GRU)或Transformer架构来捕捉这些特征之间的时序依赖关系,并生成对应的自然语言描述。
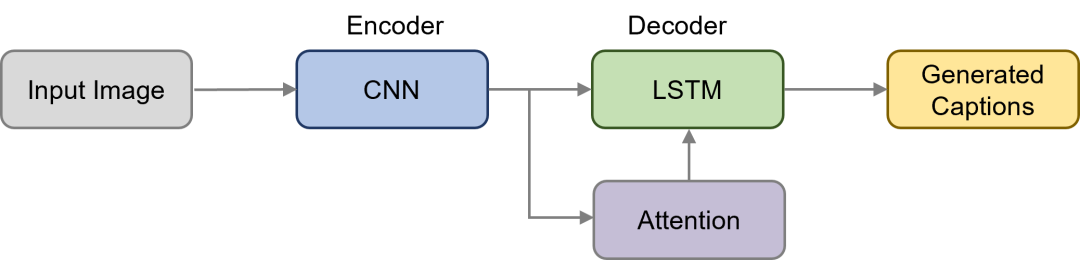
img

*在生成描述的过程中,还可能采用注意力机制来增强模型对图像关键区域的关注度,从而提高描述的准确性和相关性。注意力机制并非简单地将输入图像编码成一个固定的特征向量,而是通过引入上下文向量,对每个时间步的解码过程进行动态调整,以此增强图像区域与生成单词之间的相关性,从而捕捉并表达更多的图像语义细节。*
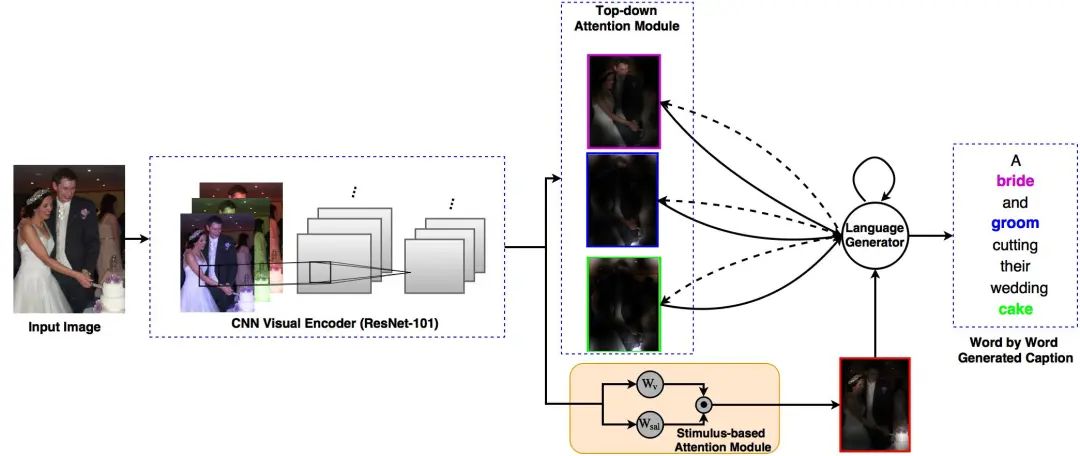
img

二、视频描述

什么*是视频**描述(Video Captioning)**?视频描述是指通过机器**自动生成视频内容的描述语句**的技术,**旨在将视频中的视觉和听觉信息转化为易于理解的自然语言文本,从而帮助用户快速了解视频内容。*
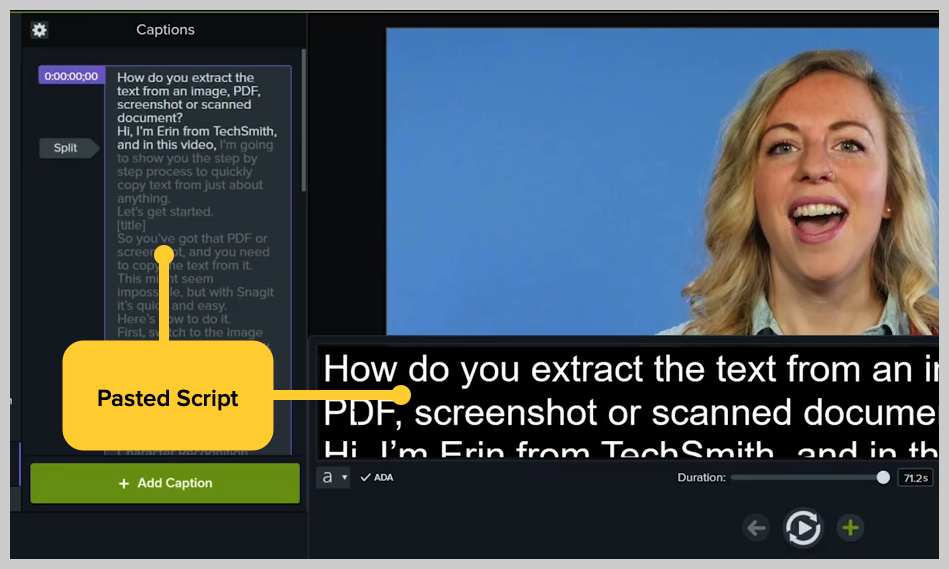
img

*为了实现视频描述,可以通过卷积神经网络(CNN)提取视频帧中的关键视觉特征,结合循环神经网络(RNN)及其变体捕捉时序信息,再融合音频特征和文本信息等多模态数据,最后利用序列到序列(Seq2Seq)模型和注意力机制将这些特征转化为自然、准确的语言描述。*
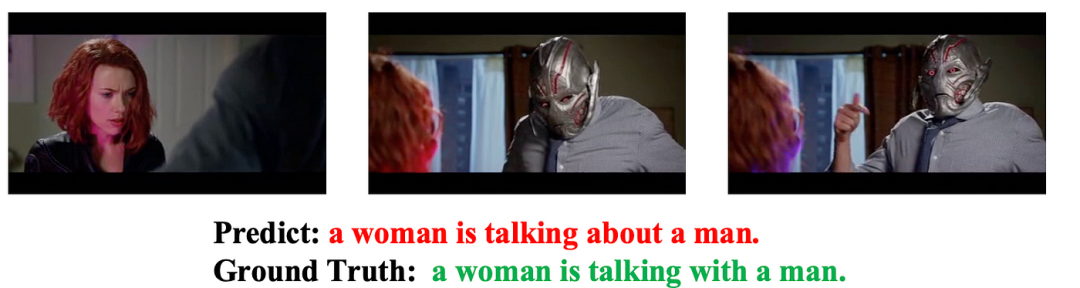
img

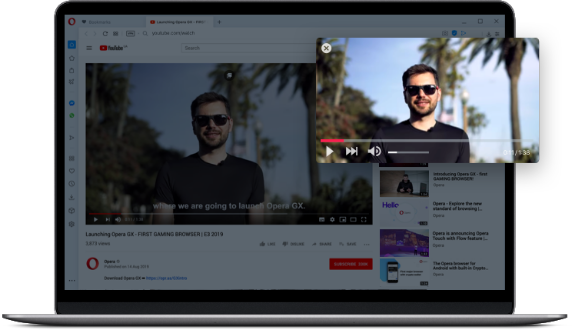
在视频描述任务中,还可以应用视频定位(Video Localization)技术来精准标记视频关键元素或事件的位置及时间点。借助目标检测与跟踪,实时定位物体、人物;时间标注则记录关键事件或场景变换的具体时刻,两者协同工作,实现对视频内容的深度解析。
img

三、视觉问答

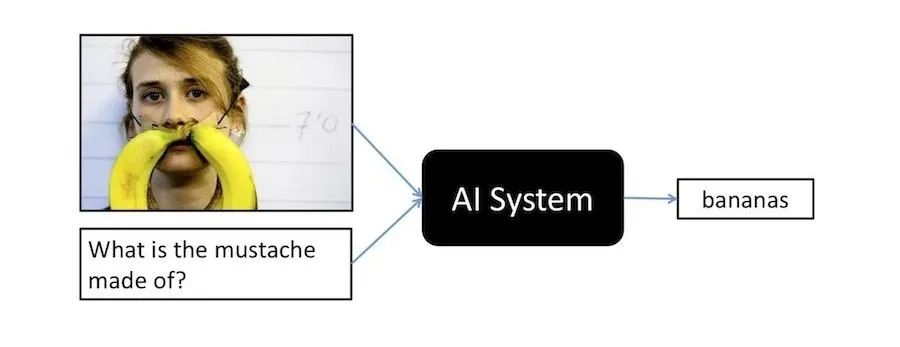
什么是视觉问答*(Visual Question Answering,VQA)*?视觉问答系统接收一张图像和一个关于这张图像的自然语言问题作为输入**,经过系统处理后,输出一个准确的自然语言答案。**
img

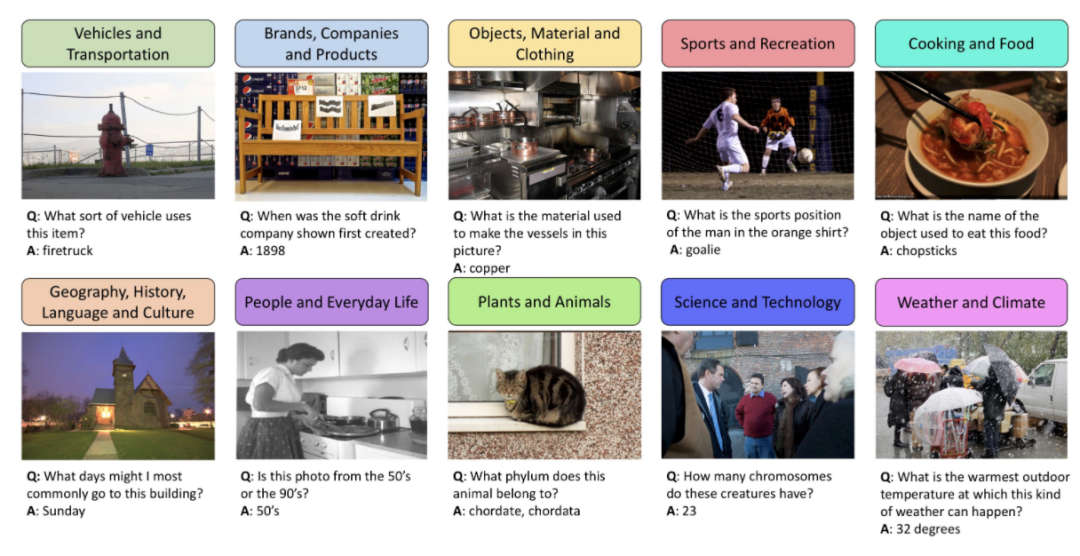
为了实现视觉问答,需要通过预训练的卷积神经网络提取图像特征,利用自然语言处理技术转化问题为特征向量,进而采用联合嵌入、注意力机制或多模态融合等方法将图像与问题特征有效结合,并在特征融合的基础上,运用分类器或生成式模型生成与问题紧密相关的自然语言答案。
img

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

MAX96712在车载摄像头系统中的带宽分配与传输能力计算解析 在计算摄像头带宽与传输接口的关系时,需要考虑视频流的像素分辨率、帧率、颜色深度等因素。以 MAX96712 这种 GMSL2 产品为例,它支持每个链路在正向方向以 3Gbps 或 6Gbps 的固定速率工作。 阅读详情

相关推荐

医学影像弹性形变处理

这段代码的主要流程是:读取 DICOM 医学影像,尝试使用 MONAI 进行弹性形变(根据版本适配),如果失败则使用 OpenCV 实现,最后可视化并保存处理结果。这样可以在不同环境下灵活处理医学影像的弹性形变需求。后面会写一篇解释弹性变形方法的短文。

wh_xia_jun的专栏 777

一文彻底搞懂多模态 - 多模态理解

看图说话”

m0_59164520的博客 4295

Silvaco Atlas从头开始(四)——定义材料参数和模型

这部分是关于定义材料参数和模型。

qsz1425AWD2121的博客 4647

视频理解多模态大模型(大模型基础、微调、视频理解基础)

多模态大模型(大模型基础、微调)

ZhengrongYue的博客 3万+

【电商风控】电商风控标注是什么

本篇文章给大家谈谈。

866

restbed编译笔记

Restbed 可以构建出基于asio库的restfulAPI服务,Restbed 4.7版本使用了1.12.0版本的asio(其他版本编译不通过),可直接访问github下载:https://github.com/chriskohlhoff/asio/tree/asio-1-12-0。另外Restbed还依赖openssl库(可直接下载exe的安装包,安装后取出lib库及头文件放到到restbed\dependency\openssl中即可,https://slproweb.com/download/W.

mahong100的博客 2106

<<计算机视觉NeurIPS>>2022:GLIPv2: Unifying Localization and VL Understanding

建立一个通用的,可以同时处理任务(image classification、object detection和segmentation等等)和任务(VQA和image captioning等等)的在过去一两年广为关注,这需要模型能够有效的统一和任务。然而,这两种任务有很大的区别:localization是仅视觉的任务,需要细粒度的输出(例如,bounding boxes或pixel masks),而VL understanding强调不同模态信息之间的融合。

金克丝的博客 1605

WiFi基本概念(六)(L-STF,L-LTF)

L-STF它由10个OFDM symbol(1,0,1,0,1,0,1,0,1,0)构成,每个symbol是0.8us,GI是0.2us,总计10us。Symbol的长度是正常长度的1/4,因此称为Short training field,主要用于快速进行信号检测,信号同步,自动增益控制,接收天线选择(Diversity Selection)。 由于symbol长度是正常的1/4,子载波的宽度是正常的4倍,能进行初略的信道估计,其使用了-24, -20, -16, -12, -8, -4, 4, 8, 1

reekyli的专栏 6859

5分钟理解什么是多模态

简单来说,多模态指的是数据或者信息的多种表现形式。比如,我想把"我有一个苹果"这个信息传递给你,我可以用文字写出来,也可以用语言说出来,也可以用图片画出来,甚至我还可以拍成视频告诉你。这就是典型的一种信息,多种存在形式上的多模态。我们可以这么理解,文本是一种模态,图像也是一种模态,甚至两种不同的语言,比如中文和英文,也各是一种不同的模态。之所以相同的信息有那么多模态,是因为人类有多种感官来处理信息:比如听觉、嗅觉、视觉、触觉、味觉等,它们都可以获取并且处理不同形式的信息。

通俗易懂的 AI 技术 5万+

YOLOv11-Pose部署RK3588实战:人体姿态识别精度翻倍,边缘推理速度突破瓶颈

本教程从YOLOv11-pose模型的姿态识别训练,到RK3588的边缘量化部署,为你打造了一套“高精度+高实时性+低成本”的人体姿态分析解决方案。无论是健身动作纠正、智能安防行为检测,还是工业人员姿态监控,这套技术都能直接复用——你只需替换数据集与业务逻辑,即可快速落地专属的边缘AI姿态识别系统。如果你在实践中遇到任何卡点,欢迎随时交流。记住,人体姿态识别的价值在于“关键点准、推理快、部署易”,而这三者的平衡,正是你通过本教程能掌握的核心能力。

m0_64661770的博客 138

基于Simulink的超级电容快速响应特性建模与仿真

本文介绍了基于Simulink的超级电容快速响应特性建模与仿真方法。主要内容包括:超级电容的工作原理、一阶RC等效电路模型及其动态电压方程;通过Simulink搭建超级电容模型的两种方法(Simscape Electrical推荐方案和基础模块透明教学方案);仿真100A×100ms放电脉冲下的电压响应特性,并与锂电池进行动态对比;分析超级电容在混合储能系统中的功率分配优势。文章还提供了工程实践要点和扩展方向,如电压均衡、温度影响评估以及与DC-DC变换器集成等。通过建模实践,验证了超级电容在毫秒级响应、高

xiaoheshang_123的博客 98

一文彻底搞懂多模态 - 多模态理解+视觉大模型+多模态检索

最近这一两周看到不少互联网公司都已经开始秋招发放Offer。不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中的那些弯弯绕绕。。更多实战和面试交流,文末加入我们。

2401_84033492的博客 1万+

LLM评测框架Ragas:测试RAG的性能出现TimeoutError()的解决办法(Ragas+langchain+ollama)

无奈之下,自己找到了一个解决办法,在ragas支持的llm类库中加了一个如下的类,支持ollama、langchian_ollama使用ragas测试报错的问题。可以将如上的库放到你的ragas的系统库的llms目录下,然后修改__init__.py如下。最近用ragas测试rag的性能,发现老出现TimeoutError()的错误。这是一个临时的解决办法,具体等待官方给出最终的解决方案。后来发现官方也没有尽快支持的计划。然后就可以用如下代码进行一些验证。

Criss@陈磊 665

【万字长文】一文搞懂VLM视觉语言模型:从原理到实践的完整指南(2025)

视觉语言模型(VLM)是融合计算机视觉与自然语言处理的多模态AI技术,通过视觉编码器、语言模型和连接模块实现图文理解。本文系统解析了VLM的工作原理、推理逻辑(Prefill/Decode阶段)、优化方法(KV Cache、量化等)、评测体系及视觉幻觉等挑战,为开发者提供了从理论到实践的全面指导,助力掌握这一推动AI发展的重要技术。

2401_85375151的博客 1万+

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

一文彻底搞懂多模态 - 多模态推理

知识图谱(

m0_59164304的博客 3508

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

一文彻底搞懂多模态:多模态推理

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 3248

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

一文搞懂多模态视觉-语言模型:Qwen2.5-VL

《多模态视觉-语言模型的认知优势与技术演进》摘要 当前多模态视觉-语言模型(如Qwen2.5-VL)相比纯文本模型展现出更强的理解能力,其核心优势在于跨模态语义对齐。这类模型通过视觉编码器(ViT)和文本编码器(Transformer)提取特征,并通过交叉注意力机制实现图文融合。技术发展经历了四个阶段:从早期的图文分类(CLIP)、图文翻译(LLaVA),到当前的视觉原生处理(支持任意分辨率输入),最终将迈向多模态Agent时代(视觉与语言统一处理)。Qwen2.5-VL作为第三代代表,采用窗口注意力机制和

Aifuyao的博客 1627

一文搞懂基于知识图谱的多模态推理

知识图谱是一种结构化的知识库,它以图的形式表示和存储现实世界中的实体、概念及其相互关系。这些实体可以是具体的人、地点、事物,也可以是抽象的概念或思想。

老皮的博客 1968

一文搞懂什么是多模态大模型?为什么需要多模态大模型?

“ 多模态大模型,就是支持多种数据格式的模型” 很多人都听说过多模态,也知道多模态大模型,但如果让你介绍一下什么是多模态大模型,它有什么优点和缺点,以及为什么需要多模态,这时可能就有点傻眼了。‍‍ 从应用角度来说,垂直应用的大模型才应该是未来的趋势,那么为什么还要研究多模态大模型呢?‍‍‍‍‍‍‍‍‍‍ 今天我们就来了解一下什么是多模态大模型,以及为什么需要多模态大模型。‍‍

Gaga246的博客 1073

一文搞懂什么是多模态大模型?为什么需要多模态大模型?看完这一篇就知道了!!

本文详细介绍了多模态大模型的概念、关键技术及广泛应用场景。多模态大模型能同时处理文本、图像、音频等多种数据格式,通过数据对齐、融合和统一标识技术,实现更智能的任务处理。相比单模态模型,多模态大模型能提供更全面的信息、增强任务表现、实现更自然的人机交互,是推动AI技术发展和实现通用人工智能(AGI)的关键路径。

Android23333的博客 652
上一篇: 大模型量化技术(Quantization)可视化指南
下一篇: AI智能体的概念和应用场景
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值