Meta开源Llama3.3-70B:大模型后训练佳作,400万美元训练成本,性能接近4050亿参数的Llama3.1-405B

最新开源:Meta 开源 Llama 3.3:更小规模、更高性能!谷歌新一代视觉语言模型PaliGemma 2! 对硬件资源的要求大幅降低。(Vision Tower):基于 Siglip Vision Transformer,它通过将图像分割为 14×14 的小块(称为图像 patch),并为每块生成特定的嵌入(embedding),最终提取图像的整体语义。的表现超过了谷歌的 Gemini 1.5 Pro、OpenAI 的 GPT-4o 和亚马逊的 Nova Pro,展现出了强大的竞争力。技术,通过整合分组查询注意力(GQA)机制,Llama 3.3 提升了推理时的可扩展性和性能,进一步优化了模型的应用能力。 阅读详情
AI摘要

本文介绍了Meta新开源的Llama3.3-70B-Instruct模型,它参数700亿,在多项评测中超越众多模型,训练成本约430万美元且支持免费商用。此外,还分享了大模型AI学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段,并提供了免费学习资料。

Llama系列大语言模型一直是开源领域的大模型标杆,Llama3系列大模型自从开源之后一直在不断更新。最早的Llama3模型于2024年4月开源,此后,几乎每个三个月都有一个新版本发布。就在昨天,Meta开源了最新的Llama3.3-70B模型,这是Llama3.3系列目前唯一开源的模型。尽管该模型的参数规模仅仅700亿,但是在多项评测基准上已经超过了4050亿参数规模的Llama3.1-405B,后者是Llama系列模型中参数规模最大的一个,也是业界开源模型中参数规模最高的模型之一。
  • Llama3.3-70B-Instruct简介

  • Llama3.3-70B-Instruct的评测结果

  • Llama3.3和其它Llama3系列模型的关系

  • Llama3.3-70B-Instruct的训练成本和开源情况

Llama3.3-70B-Instruct简介

Llama3.3-70B-Instruct是目前Llama3.3系列中唯一开源的模型,且没有基座大模型,仅开源了指令优化版本的模型。

根据官方的介绍,Llama3.3-70B-Instruct是经过预训练以及指令微调的模型,参数规模700亿,是一个纯文本的大语言模型,这意味着它不支持多模态的输入和输出,仅支持文本的输入和输出。不过Llama3.3-70B-Instruct是多语言大模型,支持英语、德语、法语、意大利语、葡萄牙语、印地语、西班牙语和泰语共8种语言,不支持中文(这里非常奇怪的是,汉语作为广泛使用的语言,一直不在Llama系列的支持范围,哪怕欧洲的Mistral都开始支持汉语了,这个模型也不支持,小扎这位同志觉悟有点问题啊~)。

Llama3.3-70B-Instruct在15万亿tokens上训练,支持128K上下文输入。知识日期是截止2023年12月份。

该模型效果的提升主要依赖于对齐训练技术和强化学习的进步。Meta官方简单提了是基于合成数据,做了在线偏好优化,可以在训练过程中,基于反馈结果实时优化模型。

此外,Llama3.3-70B-Instruct支持GQA,即Grouped-Query Attention,GQA 减少了注意力机制的计算复杂度,这对于像 Llama 3.3 这样的 700亿参数大模型尤为重要。在推理阶段,它使得模型能够以更高的速度生成文本。

Llama3.3-70B-Instruct的评测结果

Llama3.3-70B-Instruct在多项行业基准测试中超越了许多开源和闭源的聊天模型,展现了卓越的性能。

特别是Llama3.3-70B-Instruct的参数规模700亿左右,但是各项评测指标约等于4050亿参数规模的Llama3.1-405B模型!这意味着Llama3.3-70B-Instruct可以用更少的资源,更快地生成文本,但是性能与近6倍参数规模的大模型差不多!

下图展示了Llama3.3-70B-Instruct模型和业界其它模型的对比结果:
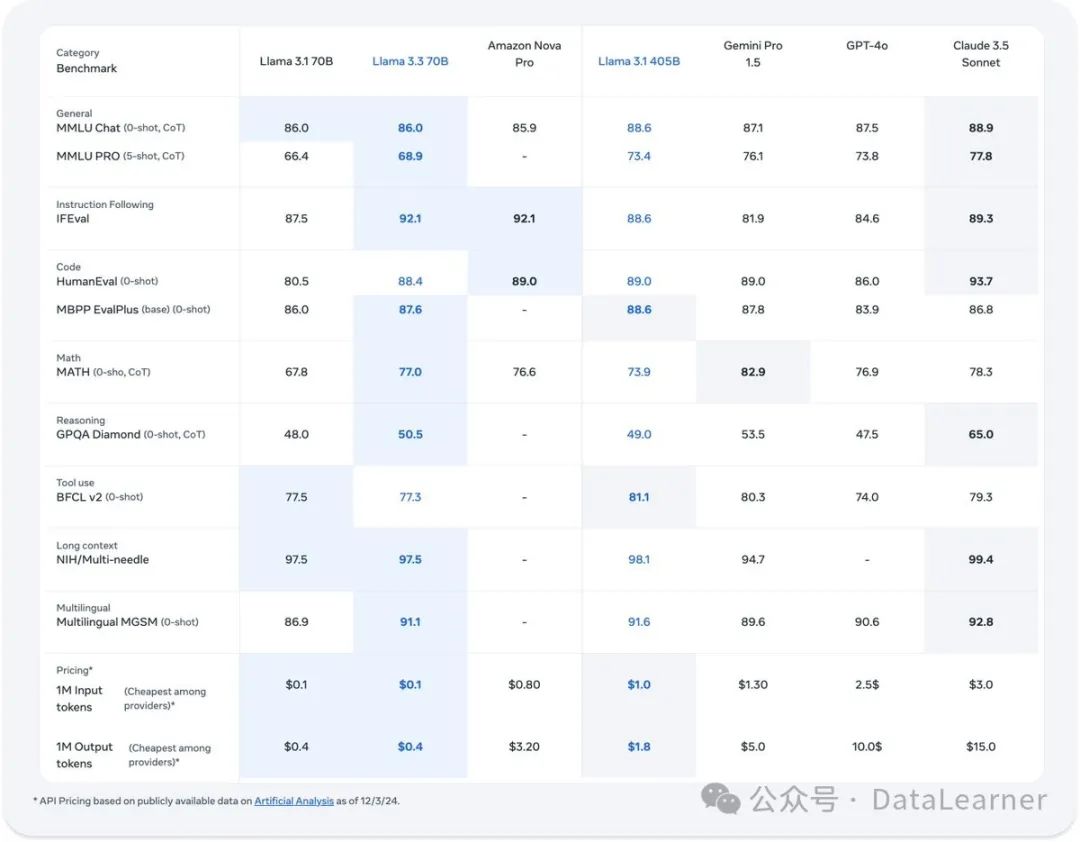
可以看到,该模型在多个测试中均取得了最优的结果,甚至不低于GPT-4o的水平。

在DataLearnerAI收集的全球大模型排行榜中,按照MMLU排序,Llama3.3-70B-Instruct模型排名第九,超越了Amazon Nova Pro,略低于Qwen2.5-72B模型,但是在数学逻辑上它的得分77分,远超同类型模型,比Qwen2.5-72B模型也高很多。
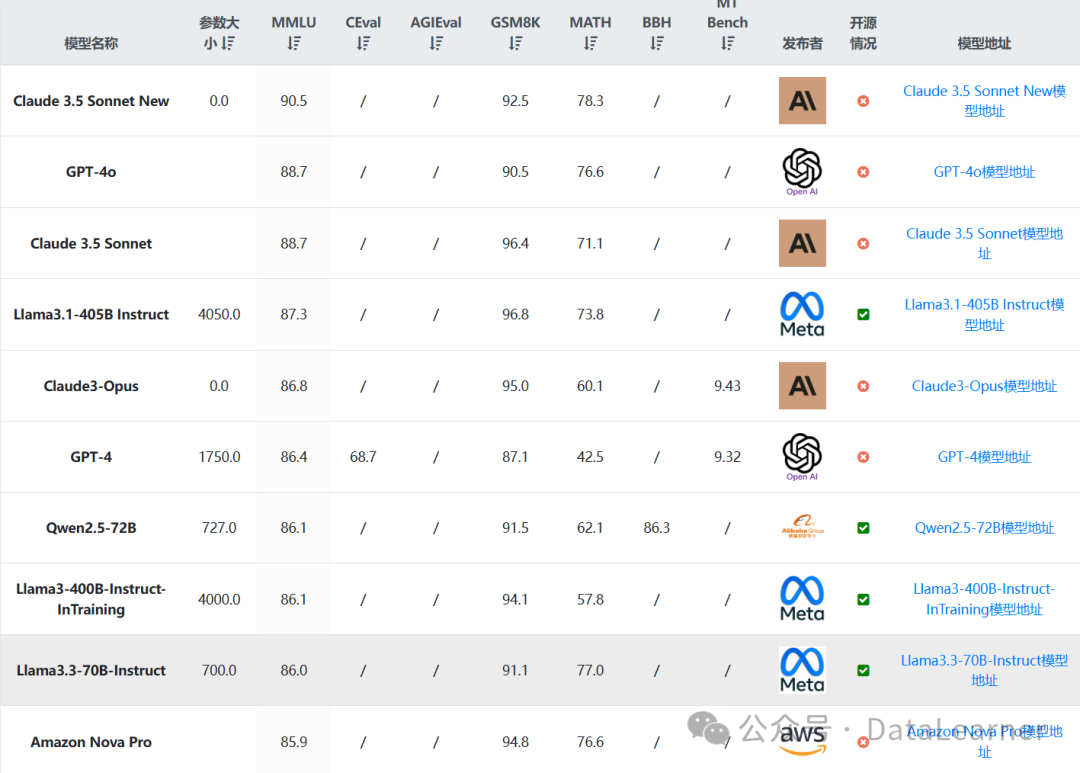
数据来源:https://www.datalearner.com/ai-models/leaderboard/datalearner-llm-leaderboard

Llama3.3和其它Llama3系列模型的关系

这里简单介绍一下Llama3系列的模型发布版本和节奏。大家就能理解Llama3.3-70B-Instruct在Llama系列的地位和目标。

目前,Llama3系列包含了4个不同的版本,分别是2024年4月份发布的Llama3系列、2024年7月份发布的Llama3.1系列、2024年9月份发布的Llama3.2系列以及2024年12月初发布的这个3.3系列。

但是,其实Llama3和Llama3.1算是比较正常的大版本节奏,因为这两个系列都包含了最小80亿参数,最大700亿以及4050亿参数规模的多个不同版本模型。

而Llama3.2系列其实只发布了1B和3B的小规模纯文本语言模型以及11B和90B的多模态版本,基本上算是Llama3.1的补充。

本次发布的Llama3.3-70B-Instruct官方也介绍说是后训练技术的迭代,这意味着其基座模型可能还是Llama3.1-70B,只是用不同的后训练或者指令微调技术迭代获得的。

Llama3.3-70B-Instruct的训练成本和开源情况

Meta公布的信息显示,Llama3.3-70B-Instruct模型训练花费了700万个GPU小时。主要是在H100-80G上训练,按照AWS的价格,这个成本大约430万美元了!

实话说,这不是一般人搞得起来的。不过好消息是Llama3.3-70B-Instruct开源,且支持免费商用。具体情况参考DataLearnerAI的模型信息卡地址:https://www.datalearner.com/ai-models/pretrained-models/llama3_3_70B_instruct

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

云平台一键部署【Llama3.3-70B-Instruct】 前几天 Meta 宣布推出一款新的 Llama 系列生成式 AI 模型:70亿参数的 Llama 3.3、又称 Llama 3.3 70B。CEO 扎克伯格在旗下社交媒体 Instagram 称,这是今年最后一次 AI 大模型更新,下一步就是明年 Llama 4 亮相。 阅读详情

相关推荐

Llama 3.3:Meta AI 开源新的纯文本语言模型,专注于多语言对话优化

Meta AI推出的Llama 3.3是一款70B参数的纯文本语言模型,支持多语言对话,具备高效、低成本的特点,适用于多种应用场景,如聊天机器人、客户服务自动化、语言翻译等。

士多啤梨先生の博客 697

Meta 推出更高效的新型 Llama 3.3 70B 模型

在 X 上的帖子中,Meta 的生成式人工智能副总裁 Ahmad Al-Dahle 表示,纯文本 Llama 3.3 70B 以更低的成本提供了 等效于 Meta 最大 Llama 模型 Llama 3.1 405B 的性能。例如,根据 Meta 的数据,Llama 的下载量已超过 6.5 亿次。扎克伯格在今年 8 月的 Meta 第四季度财报电话会议上表示,为了训练下一套主要的 Llama 模型(Llama 4),公司需要的计算能力将是训练 Llama 3 所需的计算能力的 10 倍。

weixin_41446370的博客 1465

Meta 发布 Llama 3.3:一个性能和效率均有所提升的多语言模型

上下文窗口,并对架构进行了改进以提高效率,在推理、编码和多语言任务的基准测试中表现出色。采用了强有力的拒绝策略来应对潜在的有害提示,并在响应中保持了平衡的语气。它通过将监督学习和基于人类反馈的强化学习相结合来进行微调,确保在各种任务中的出色表现,同时保持有用性和安全性。Meta 发布了 Llama 3.3,这是一款多语言大语言模型,旨在支持研究和行业中的一系列人工智能应用。:Llama 3.3 在具有挑战性的 GPQA 推理基准上,准确率达到了 50.5%,与其前身相比,有所改进。

1万+

Llama3 中文版本地环境搭建和部署实战

这两天科技新闻中Llama 3消息刷爆了,中国时间 2024 年 4 月 19 日 0 点 0 分,Meta Llama 3 发布。模型以开源形式提供,包含 8B 和 70B 两种参数规模,涵盖预训练和指令调优的变体。Llama 3 支持多种商业和研究用途,并已在多个行业标准测试中展示了其卓越的性能。Llama 3 在超过 15 万亿个标记上进行训练,比 Llama 2 的数据集大 7 倍多。它大大降低了错误拒绝率,并提供了更高的响应一致性和多样性。

m0_59235699的博客 2429

低成本实现webhook接收端[python]

Webook本质上也是API,只不过是反向调用,即前端不主动发送请求,完全由后端推送。简单来说,Webhook是一个接受HTTP POST或是GET,PUT,DELETE的URL,一个实现了Webhook的API提供商就是在当事件发生的时候会向配置的URL发送信息,与请求-响应式不同,使用Webhook可以实时接收到变化。Ps:Webhook可能会发出大量的请求,确保接受的URL不被泄露或者应用能及时处理这些请求。

锡城小凯的博客 1万+

平衡电桥检测高压绝缘电阻的原理

检测绝缘漏电的高压拓扑如下:BMU需要连接BAT+,BAT-和PE线,并测量电池总压(Ubatt)和负母线电压(Un),并计算出正母线电压(Up)。

booksyhay的专栏 1万+

开源大模型新王者Llama 3.3 70B,用Ollama跑起来

大家好,Meta公司新近推出的Llama 3.3 70B模型,为大型语言模型带来了新突破。这款模型不仅支持多语言,性能强劲,而且具备成本效益,有望彻底改变企业和科研人员利用AI的方式。本文带大家深入解析Llama 3.3 70B。

csdn1561168266的博客 2691

微信小程序 “net::ERR_CONNECTION_REFUSED” 报错大揭秘与破解之道

在微信小程序开发与运行过程中,“net::ERR_CONNECTION_REFUSED” 报错是开发者常遇难题。该错误意味着小程序与服务器连接建立失败,会导致功能无法使用、数据加载异常等问题,严重影响用户体验和业务运转。本文系统剖析此错误,从网络环境不佳、服务器异常、小程序配置有误等常见触发场景入手,提供网络、服务器、配置、代码等多维度排查步骤,给出针对性解决策略,如修复网络、处理服务器故障、修正配置与代码错误,还提出开发与运维阶段的预防措施,助力开发者高效解决该报错问题。

邓邓子的博客 6147

没有网络限制!超简单本地部署 Llama3 的方法

没有网络限制!超简单本地部署 Llama3 的方法

AAI666666的博客 2028

#systemverilog# 之 event region 和 timeslot 仿真调度(三)Verdi 辅助查看

通过今天的学习,我们知道:event region 是event sequence 的全集。我们打开了 event region feature 也就开启了event sequence 的功能。

那么菜的博客 1368

近五年体内微/纳米机器人赋能肿瘤精准治疗综述:以 GBM 为重点

摘要 微/纳米机器人在实体瘤治疗领域展现出突破性潜力,通过主动运动能力解决传统纳米药物递送效率低、渗透不足等核心问题。2021-2025年间形成三条技术路线:1) 磁驱、声驱等运动增强递送实现深层渗透;2) 与免疫治疗融合实现原位免疫唤醒;3) 针对胶质母细胞瘤开发跨屏障递送系统。研究重点从单一运动性能转向"运动-分布-疗效"的系统评价,需建立标准化指标评估运动学参数、肿瘤分布均匀性和安全性。未来挑战在于临床转化的可制造性、闭环操控及生物相容性优化,特别是对血脑屏障穿透等复杂场景的系统集

AllenLV的博客 5223

LLMs之Llama-3:Llama-3.3的简介、安装和使用方法、案例应用之详细攻略

​ LLMs之Llama-3:Llama-3.3的简介、安装和使用方法、案例应用之详细攻略 目录 相关文章 Llama-3.3的简介 Llama-3.3的安装和使用方法 Llama 3.3的案例应用 相关文章 LLMs之LLaMA:LLaMA的简介、安装和使用方法、案例应用之详细攻略 LLMs之LLaMA:LLaMA的简介、安装和使用方法、案例应用之详细攻略_chinese_calendar每年手动更新-优快云博客 LLMs之LLaMA-2:LLaMA 2的

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 3476

车载ECU底软测试:方法与技术的深度解析

底软是运行在 ECU 硬件平台上的基础软件,它为上层应用程序提供了硬件驱动、操作系统服务、通信协议栈等功能。底软的主要功能包括:硬件驱动:负责与 ECU 的各种硬件外设进行通信和控制,如 GPIO、UART、SPI、CAN 等。操作系统服务:提供任务调度、内存管理、中断处理等功能,确保系统的实时性和稳定性。通信协议栈:实现 ECU 与其他 ECU 或外部设备之间的通信,如 CAN、LIN、FlexRay 等。诊断服务:负责对 ECU 的故障进行诊断和处理,并将故障信息存储在故障码存储器中。

天赐好车的博客 1431

小学生也能听得懂的大模型 - Transformer 1

参考 [小学生也能听得懂的大模型 Transformer 1]

2401_85325557的博客 1739

服务部署之配置WSUS更新服务(基于Windows配置 Server 2022)

服务部署之配置WSUS更新服务(基于Windows配置 Server 2022)

2301_77192876的博客 2216

基于Python的海关进出口数据爬取与贸易关系分析

本文介绍了如何使用Python爬虫技术获取海关进出口数据,并基于这些数据进行贸易关系分析。文章详细阐述了数据采集、清洗、存储和分析的全过程,使用了最新的爬虫技术和数据分析方法,为国际贸易研究提供数据支持和技术参考。关键词:Python爬虫、海关数据、贸易分析、数据可视化、Selenium、Scrapy。

2201_76125261的博客 546

我如何在笔记本运行GPT-4级别的模型

Meta的新模型Llama 3.3 70B是一个真正的GPT-4级别的大型语言模型,它可以在我的笔记本电脑上运行。仅仅在20个月前,我还在为能在同一台机器上运行感觉达到GPT-3级别的模型而感到惊讶。在过去的两年里,能够在消费级硬件上访问的模型质量有了巨大的提升。我的笔记本电脑是一台64GB的MacBook Pro M2,我在2023年1月购买的——这是在ChatGPT最初发布两个月后。我所有在笔记本电脑上运行大型语言模型(LLM)的实验都使用了这台机器。

python12345_的博客 1287

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

深入理解LLaMA, Alpaca, ColossalChat 系列模型

知乎:紫气东来https://zhuanlan.zhihu.com/p/618695885一、从 LLaMA 到 Alpaca:大模型的小训练1.1 LLaMA 概要与实践LLaMA(Large Language Model Meta AI) 是由 Meta AI 发布了一款全新的大型语言模型,共有7B、13B、33B、65B 四种版本,其模型参数如下表所示:与原始的 transformer De...

zenRRan的博客 1万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【速成】LLM大模型学习路径指南

大家好!整理了一些我的大模型学习路线和参考资料,供初学者入门了解和实践LLM大模型算法学习路径LLM发展历程入门系列进阶系列计算资源云服务器:t讯云/a里云/火s引擎 GPU云服务器资源,按量每小时约10元本地服务器:单卡/多卡训练,最低6G显存,4090可媲美A100显卡项目应用实践SFT微调:QA数据集构建、Chat基座微调RAG知识库问答:知识库解析、向量检索、LLM生成Agent智能体:workflow定义、tools构建、function call模型训练。

m0_63171455的博客 1321

【Llama-3】从SFT到RLHF训练,易如反掌

推荐下朋友【知乎/小红书:小冬瓜AIGC】原创的LLM+RLHF视频课程,他在知乎和小红书也分享了很多关于LLM相关的技术文章和笔记,原创不易,感兴趣的朋友可以关注下。作者是小冬瓜AIGC,原创超长文知识分享原创课程已帮助多名同学上岸LLM赛道知乎/小红书:小冬瓜AIGC基于Llama-3-8B预训练模型全参SFT微调中文问答轻松秒了ruozhiba经过DPO/PPO强化学习训练便可胜任代码生成...

baidu_25854831的博客 1030

LLaMA 70B Mac部署使用,解决 wrong shape; expected 8192 x 8192 小bug

mac在关闭显示器的时候,总是会自动进入睡眠,这样在下载大模型的时候,网络一中断,就无法继续下载。通过显示器-显示器能耗设置-能耗(显示器关闭时,防止自动进入睡眠),就可以防止系统睡掉。

auto_star的博客 1200

LeCun狂赞:600刀GPT-3.5平替! 斯坦福70亿参数「羊驼」爆火,LLaMA杀疯了

视学算法报道编辑:编辑部【新智元导读】Meta的LLaMA模型开源,让文本大模型迎来了Stable Diffustion时刻。今天,斯坦福发布了一个由LLaMA 7B微调的模型Alpaca,训练3小时,性能比肩GPT-3.5。一觉醒来,斯坦福大模型Alpaca(草泥马)火了。没错,Alpaca是由Meta的LLaMA 7B微调而来的全新模型,仅用了52k数据,性能约等于GPT-3.5。关键...

zandaoguang的博客 925

【AI学习】LLaMA模型的微调成本有几何?

以LLaMa 7B模型的训练来说,总训练时长=2710,按照前面“在8个80GB A100 上训练了3个小时,不到100美元”的成本折算,成本应该小于11300美金 13B模型,总训练时长=5100,成本应该小于21250美金 70B模型,总训练时长=21340,成本应该小于88920美金

bylander的博客 1773

深度解析为什么Deepseek v3的成本这么低?

DeepSeek V3的训练总共才用了不到280万个GPU小时,而Llama 3 405B却用了3080万GPU小时。用训练一个模型所花费的钱来说,训练一个DeepSeek V3只需要花费557.6万美元,相比之下,一个简单的7B Llama 3模型则需要花费76万美元。

huang9604的博客 4526

最简单的LLaMa3中文大模型安装步骤

史上最强开源AI大模型——Meta的LLaMa3一经发布,各项指标全面逼近GPT-4。它提供了8B和70B两个版本,8B版本最低仅需4G显存即可运行,可以说是迄今为止能在本地运行的最强LLM。

u011024436的博客 2398

英伟达开源最新大模型Nemotron 70B后,只有OpenAI o1一个对手了

在训练细节上,该模型在 Llama-3.1-70B-Instruct 基础上使用了 RLHF 技术(主要是 REINFORCE 算法),并采用了 Llama-3.1-Nemotron-70B-Reward 和 HelpSteer2 偏好提示作为初始训练策略。想要尝试的小伙伴跟着官方给出的步骤进行部署即可。除了 Llama-3.1-Nemotron-70B-Instruct 之外,英伟达还开源了另一个 Llama-3.1-Nemotron-70B-Reward 模型。

AIBigModel的博客 1250
上一篇: Fox-1:3T token训练出1.6B的高性能小模型 | AIOLI: 让AI训练更高效,新型数据混合算法击败所有传统方法
下一篇: AAAI2025 清华大学-通过大语言模型解决RL奖赏值分配难题!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值