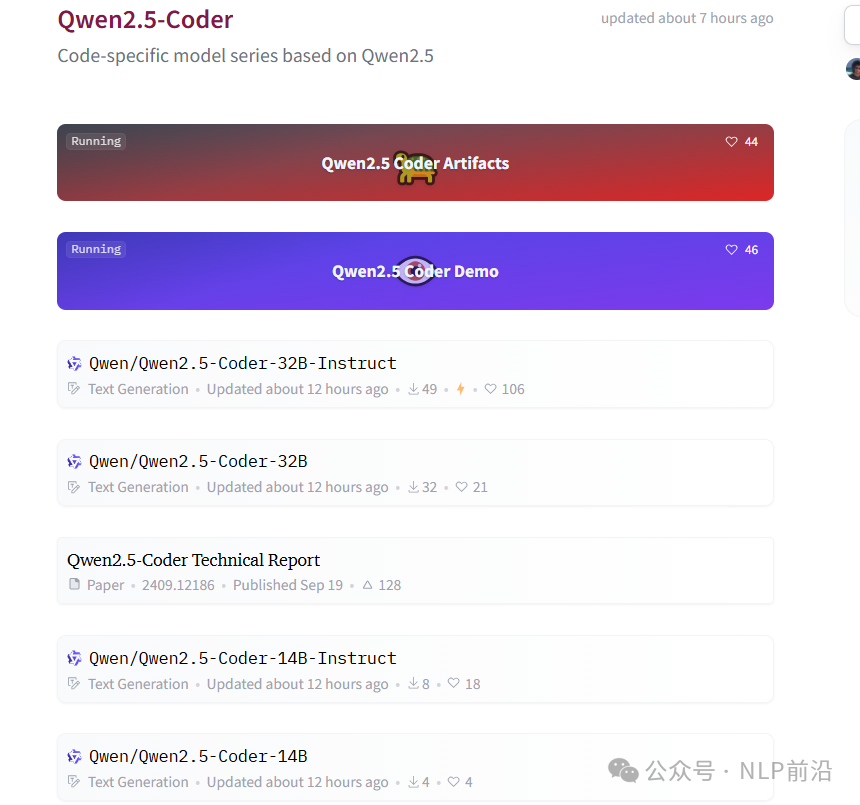
Qwen新作,代码界的王!

从小白到专家:DeepSeek 模型硬件配置完全指南 DeepSeek是由深度求索(DeepSeek)推出的一系列大语言模型,涵盖从轻量级到超大规模的不同版本。高效性:优化了推理和训练效率,适合多种应用场景。灵活性:支持从单机到分布式集群的部署方式。多场景适配:适用于文本生成、代码补全、对话系统等任务。为了充分发挥DeepSeek模型的性能,合理的硬件配置至关重要。以下是针对不同规模模型的具体硬件需求。 阅读详情

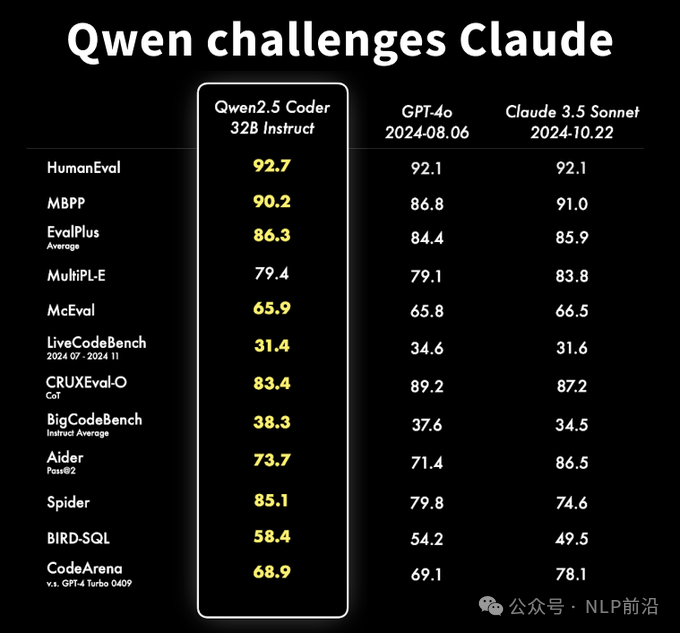
Qwen2.5-Coder-32B-Instruct!它来了!benchmark已杀疯~
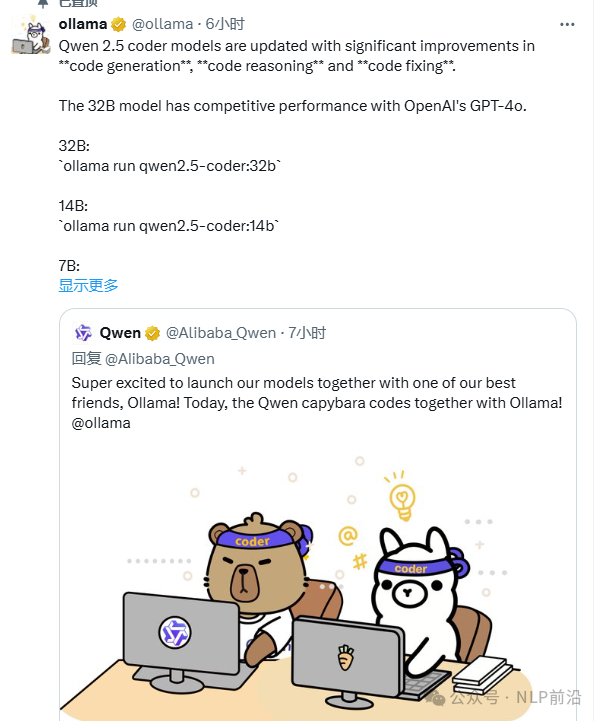
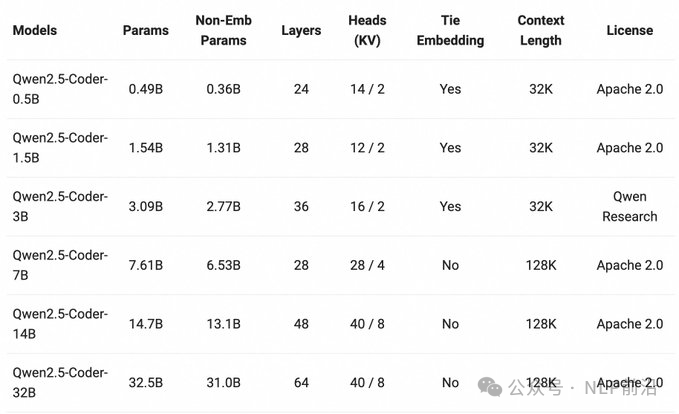
Ollama第一时间支持,几个系列的模型
大多数模型都是 Apache 2.0 协议!
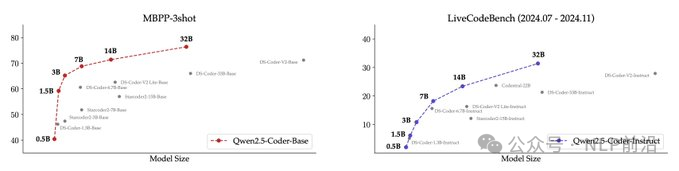
除了 32B ,小尺寸的模型在其模型尺寸上也表现出了了最先进的性能!
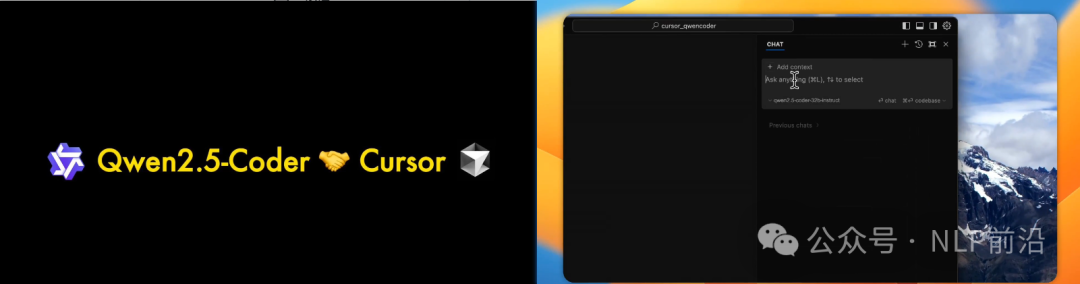
除了基准分数,cursor可以接入最新版Qwen模型了!
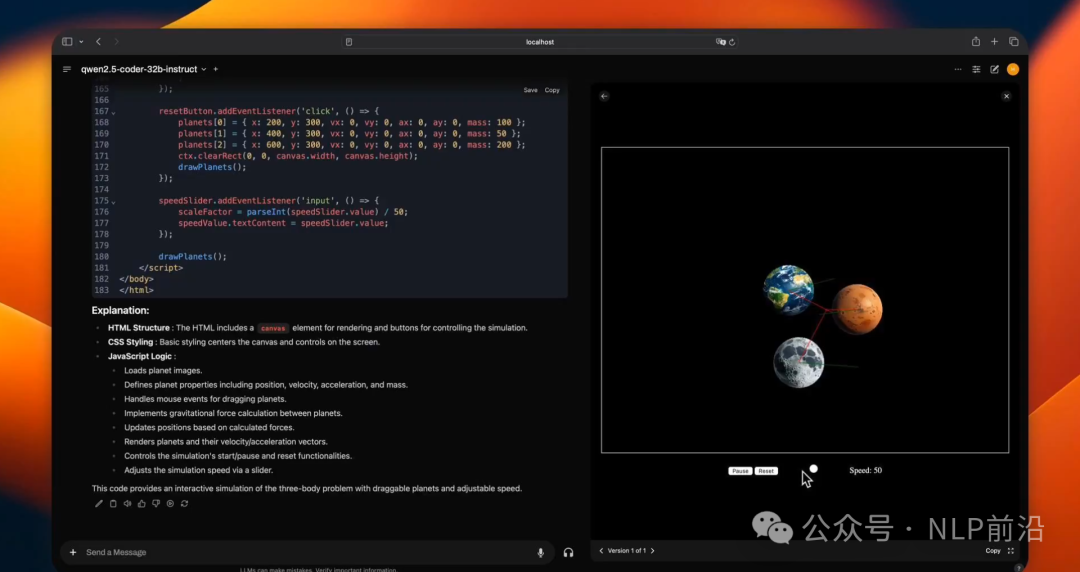
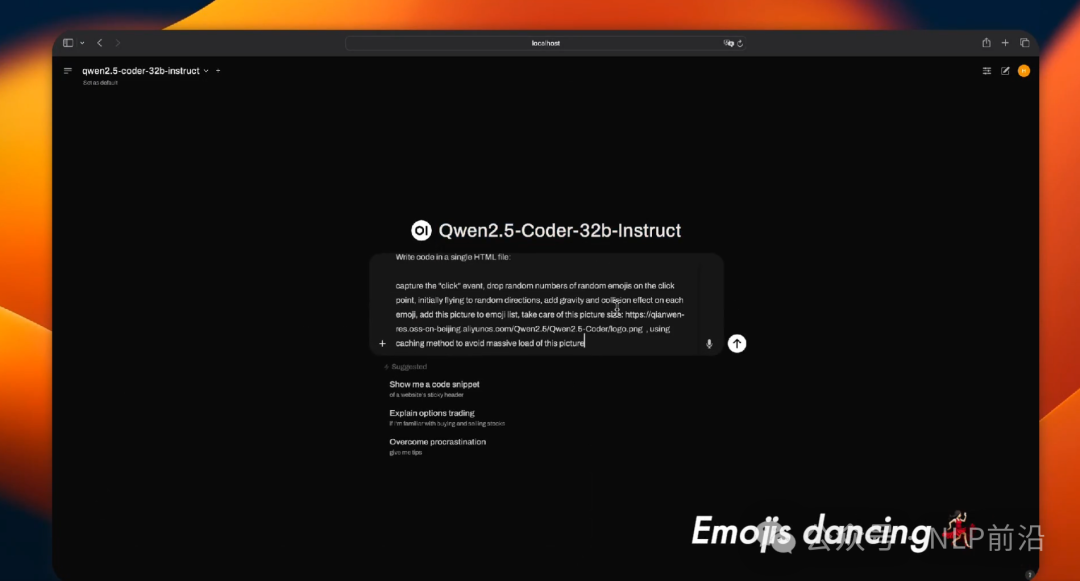
Qwen2.5-Coder-32B-Instruct & OpenWebUI
最后 Qwen 牛逼!
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Qwen-Agent智能体框架:阿里又一开源王炸!附详细教程 阅读详情

相关推荐

DeepSeek R1本地化部署与联网功能实战指南:从零搭建智能对话系统

在人工智能技术快速发展的今天,如何将先进的对话模型DeepSeek R1部署到本地环境并赋予其联网能力,成为许多开发者和企业关注的重点。本文将深入讲解完整的本地化部署流程,并通过实例代码演示如何为模型添加实时网络访问功能。

理论都是虚的,代码才是王道。 7万+

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3943

未来已来?2026最新国内15家AI大模型应用盘点(附体验网址,持续更新)

未来已来?国内15家AI大模型盘点及体验网址,一起来看看吧!

Code_流苏:在代码中寻诗意,在实践中觅真知 12万+

本地部署DeepSeek大模型电脑配置推荐

针对本地部署DeepSeek大模型的配置需求,需根据模型规模(如7B/13B/70B参数)和量化方案进行区分。

huang9604的博客 3万+

《雷达入门课 》系列文章(5)线性调频连续波雷达基本原理(第1讲)

S=B/Tc,是调频斜率。这里的混频公式推导过程比较简单,具体的混频过程如果感兴趣可以看下面粗略的推导,混频的本质就是频谱搬移,分为上变频和下变频,一般我们用下变频,即差频信号,因此需要一个低通滤波器即可滤出我们所需要的信号。答案就是因为中频信号能够映射出目标的距离信息,换句话说就是目标的距离不一样,返回的时间τ也就不一样,因此中频信号的频率大小也就不一样,可以说距离和中频信号是成映射关系的。中频只是表示信号频段的程度词,不是表示信号的状态词,意思就是说中频是指信号的频率不是很高,正好处于中间的地位。

【调皮连续波】雷达技术领域知识博主 6026

动态库加载失败终极指南:从libbz2.so.1错误看Linux依赖管理本质

本文以经典的libbz2.so.1加载错误为例,深入剖析Linux动态链接库管理的核心机制。文章不仅提供从ldd检查、符号链接创建到LD_LIBRARY_PATH设置等实战解决方案,更系统性地讲解了动态链接器的寻库路径、版本管理及依赖问题预防策略,帮助开发者从根本上理解和掌握Linux依赖管理本质。

weixin_29212429的博客 451

Qwen3-Coder保姆级安装教程,开源界的“卷王”,把AI编程卷出新高度!

随着开源AI终端代理爆火。继Gemini CLI 之后,最近AI编程圈被一款国产开源模型Qwen3-Coder给“卷”疯了!这玩意儿太厉害了,直接把那些收费的、闭源的AI编程工具给比下去了,甚至把行业标杆、闭源的Claude Sonnet 4都给秒了!这可不是吹牛,它用实力证明了开源也能吊打闭源,而且还完全免费!这下,那些每个月花200块钱买Claude Code的开发者们,估计要后悔得拍大腿了。

longzhutengyue的博客 2655

Robocup 仿真2D 学习笔记(二) 球队代码编译和上场

环境的一些问题 最近在使用rcssserver 和 rcssmonitor时可能会遇到./configure失败的问题,可以检查一下文件夹是否有makefile文件,如果是编译后的包直接sudo make install,如果还不行,还可以源码下载编译 rcssserver: https://sourceforge.net/projects/sserver/files/rcssserver/...

markchalse的博客 6016

Cline 免费插件 + Qwen2.5 大模型,零经验也能开发“对联王”微信小程序

本文详细介绍了如何利用免费的 Cline 插件辅助开发一款名为“对联王”的微信小程序,特别适合希望在春节期间创作春联的用户。文章不仅比较了 Cline 与 Cursor 两款工具的优缺点,还分享了作者实际操作中的经验和建议。通过具体步骤演示,即使是编程新手也能跟随指导,结合微信开发者工具,完成自己的小程序开发,享受创作的乐趣……

老牛啊 1881

【WRF-Urban】Registry.EM_COMMON文件概述及urban有关变量

Registry.EM_COMMON文件概述及urban有关变量

WW、forever的博客 1596

199、影像技术 roadmap 规划:未来移动影像的技术趋势与芯片算力展望

本文探讨了未来移动影像技术的发展趋势与芯片算力规划。作者从实际案例出发,指出影像技术演进需平衡传感器、ISP、算力和功耗。文章分为三部分:1)传感器将从堆像素转向提升信息密度,重点关注双层晶体管结构、混合快门和多光谱技术;2)ISP架构将向可编程计算单元转型,强调神经网络加速、硬件化多帧融合和语义处理;3)芯片算力瓶颈在于数据搬运,需优化存算一体架构、专用DMA和统一内存。最后给出五点建议:避免盲目追高像素、重视持续功耗、平衡ISP灵活性、预留算力余量、加强传感器与ISP协同设计。作者强调,影像技术的突破在

sundong_81的博客 60

Qwen3-Embedding-8B:文本嵌入界的“卷王”,多语言检索新标杆!

先来个官方介绍:Qwen3-Embedding-8B,是Qwen家族的最新专有嵌入模型,专为文本嵌入和排序任务设计,参数量高达8B(80亿),支持100+自然语言和多门编程语言,继承Qwen3系列的长文本理解、多语言、推理能力。但光说这些,怕你没感觉。文本嵌入,就是把一段文字变成一串“高维向量”,让机器能“理解”文本之间的相似关系。比如你问“北京是中国的首都吗?”,它能把“北京是中国的首都”这句话和你的问题变成很接近的向量,方便检索、排序、聚类、分类等一系列操作。8B参数量。

许泽宇的技术分享 6463

移位寄存器——用Verilog实现串入串出、串并和并串转换并进行Modelsim仿真

用Verilog实现串并转换 首先我们先要了并串和串并转换的原理 并串转换:先将八位数据暂存于一个八位寄存器器中,然后左移输出到一位输出端口,这里可以通过一个“移位”来实现,相当于实现了移位寄存器的功能。 串并转换:新输入的位值成为原来数据的最低位,将原来数据的最高位舍去,这里可以通过一个简单的“连接符”来实现。 我们这里采用两种方式来进行串并转换 一:lsb优先 Least Significant Bit,最低比特,最低位优先 二:msb优先 Most Significant Bit,最高比特,

H19981118的博客 2万+

如何搭配通义灵码中的推荐模式和推荐模型(qwen3-coder、Qwen3-Thinking、Qwen2.5-Max)来高效的写出王炸代码呢?

通义灵码提供三种AI交互模式:智能问答(纯咨询)、文件编辑(精准代码修改)和智能体(全自动任务执行)。模型选择建议:Qwen3-Coder专攻代码开发,是智能体模式的核心驱动;Qwen3-Thinking擅长复杂逻辑推理;Qwen2.5-Max作为通用备选。开发者最优组合:日常使用Qwen3-Coder+智能体模式实现端到端开发,精修代码时切换文件编辑模式,解决复杂算法问题则选用Qwen3-Thinking进行深度推理。该方案覆盖了从常规开发到疑难问题解决的全场景需求。

liwenxiang629的博客 2541

基于点云数据的统计滤波算法改进

随着三维视觉和点云处理技术的发展,点云数据在机器人、自动驾驶、增强现实等领域得到了广泛应用。而点云数据中常常包含着各种噪声和异常点,这些噪声和异常点会影响后续的数据处理和分析任务。因此,对点云数据进行滤波处理是必不可少的一步。在点云滤波算法中,统计滤波(Statistical Filtering)是一种常见且有效的方法。它通过对点云数据进行统计分析,将噪声和异常点剔除或修复,从而得到更为准确和可靠的点云数据。本文将介绍一种改进的统计滤波算法,并提供相应的源代码实现。

QfcaLinux的博客 293

UG NX二次开发(C++)-UIStyler-指定平面的对象和参数获取

在采用NXOpen C++进行二次开发时,采用Menu/UIStyler是一种很常见的方式,这样可以制作精美的界面,而且常用的块对象也集成了快速编程的代码,我们可以快速的利用这些块来定制我们需要的界面。但是,对于很多初学者可能对选择对象的获取不是很熟悉,我们本文以选择“指定平面”来讲一下如何获取选择的对象和对象的参数。另外,由于我们的UG NX二次开发学习讨论群QQ一群已满,有希望参与学习的有志之士加入我们的QQ二群:683566590。

GimiGimmy 1093

体验了最新的Qwen3之后,端侧之王果然没有让我失望!

一觉醒来,Qwen3 果然如期而至!并且从来不像某CloseAI,雷声大雨点小!Qwen3这次推出了两大系列模型,让我眼前一亮:Dense模型(常见的GPT风格)和MoE模型(混合专家模型,效率更高)。旗舰型号Qwen3-235B-A22B(2350亿总参数,220亿激活参数)表现惊艳!在代码、数学、通用能力等测试中,它能与DeepSeek-R1、o1、o3-mini、Grok-3、Gemini-2.5-Pro这些顶尖模型平起平坐,不得不佩服国产大模型的进步速度。

m0_59235945的博客 1871

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

亲测!Qwen3-Coder就是最强开源编程王

AI编程助手大战正酣!阿里Qwen3-Coder强势登场,实测表现超越Claude3.7,媲美Claude4。该模型能快速生成简历网页、宇宙绘画工具、碰撞音乐生成器等多样化应用,1分钟内即可完成开发。目前可通过QwenChat或阿里云百炼API调用,支持多种第三方工具接入。文章还附带了大模型学习资料包,含学习路线图、视频教程等技术资源。Qwen3-Coder的推出为国内开发者提供了新的高性能选择。

2401_85390073的博客 2169

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

阿里开源最新Qwen模型,开源圈的新王,超K2~

近期,阿里开源了两个最新Qwen模型:Qwen3-235B-A22B-Instruct-2507,Qwen3-Coder-480B-A35B-Instruct,热度很高!效果上,超过DeepSeek V3和Kimi K2,以及闭源Claude4。妥妥的开源圈新王,卷起来。

weixin_58753619的博客 911

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

一文通透Qwen LLM系列——从Qwen、Qwen1.5、Qwen2、Qwen2.5到Qwen3(融合了chat和推理)、Qwen3 MoE

通义千问Qwen3系列大模型在架构、训练和数据方面实现全面升级。该系列包含6个稠密模型和2个MoE模型,其中2350亿参数的旗舰模型Qwen3-235B-A22B在多项基准测试中超越同类产品。模型采用分组查询注意力、SwiGLU等先进架构,通过三阶段预训练(通用、推理、长上下文)处理36万亿token的多语言数据。后训练创新性地引入"思维控制"和"强到弱蒸馏"技术,显著提升模型推理能力和训练效率。相比前代Qwen2.5,新模型在参数效率、多语言支持和长文本处理等方面均

结构之法 算法之道 1万+

一文详解阿里最新发布Qwen3,直接王炸!

Qwen3是由阿里云通义团队(Qwen team, Alibaba Cloud)开发的大型语言模型系列。它是继Qwen2.5之后的最新一代模型,汲取了团队在构建QwQ(思维模式)和Qwen2.5的经验。这次发布包含了多种不同规模的模型,并且对模型的权重进行了公开,遵循 Apache 2.0 开源许可协议。这意味着更多开发者和研究人员可以免费使用和研究这些前沿的模型。阿里巴巴发布的Qwen3系列大型语言模型,无论在模型能力、使用灵活性还是开源开放方面,都代表了阿里在****AI领域又一次重大进步。

weixin_72959097的博客 2154

Qwen3.5+OpenClaw王炸组合!2026最强本地AI助手来了

你有没有想过,为啥市面上的 AI 助手总是差点意思?用 ChatGPT 吧,数据得传云端,心里总不踏实;用 Claude 吧,网页聊两句还行,让它帮你整理电脑里的文件、发个邮件、操作个表格,立马歇菜。说白了,这些云端大模型就像个"云管家",看得见摸不着,想让它进你的电脑干活?门儿都没有。直到我挖到了这对组合:阿里刚发布的 Qwen3.5 系列,配上硅谷最近火到离谱的开源项目 OpenClaw(前身叫 Clawdbot/Moltbot)。

人工智能AI技术 2339

国产之光!阿里开源 Qwen3-Coder 新王炸来了~

整体使用下来和 Claude Code 的能力差距还不小,我使用了一下午 Qwen 开发,和之前 Claude Code 的开发速度,还是蛮大的,遇到了一下问题,单纯开发前端网页,一个全新的,Claude Code 几乎每次都是可以成功运行的,Qwen 则需要调试几下在使用 Qwen Cli 的时候,没有生成 to do list ,又跑偏的情况虽然整体上还和 Claude Code 有些差距,但是终于看到了希望,希望阿里的大佬尽快升级!

zzling2024的博客 1368
上一篇: PureML:大模型革新数据处理,能够自动进行数据清洗和特征工程
下一篇: Nature | 新型多模态触觉模拟方法及智能穿戴设备
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值