ECCV2024|GalLoP:多模态提示学习——视觉-语言模型的全局和局部提示

Prompt SRC(论文解读)Self-regulating Prompts: Foundational Model Adaptation without Forgetting 提示学习已经成为微调基础模型(CLIP)适应下游任务的有效替代方法。传统的方法使用任务特定的目标,即交叉熵损失进行训练,提示往往会过拟合到下游数据分布上,并且很难从冻结的CLIP中捕捉到任务无关的通用特征。这就导致了模型原本泛化能力的损失。为了解决这个问题,本文引入了一个自正则化的提示框架,称为Prompt SRC(带有自我调节约束的提示)。 阅读详情
AI摘要

本文介绍了GalLoP方法,它利用全局和局部视觉特征学习多种不同提示,在领域泛化和OOD检测方面表现出强鲁棒性。此外,还分享了大模型AI的学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段,并提供了相关学习资料的免费领取方式。

论文链接:

https://arxiv.org/pdf/2407.01400

简介

提示学习已被广泛采用来有效地适应视觉语言模型(VLM),例如CLIP,用于少量图像分类。尽管取得了成功,但大多数学习方法都需要在分类准确性和鲁棒性之间进行权衡,例如用于域泛化或分布外(OOD)检测。作者引入了全局局部提示(GalLoP),利用全局和局部视觉特征来学习多种不同的提示。局部提示的训练依赖于具有增强的视觉文本对齐的局部特征。为了仅关注相关特征,这种局部对齐与局部特征选择中的稀疏策略相结合。此外,使用新的“提示dropout”技术和局部提示的多尺度策略来强制提示集的多样性。 GalLoP 在领域泛化和 OOD 检测方面都表现出很强的鲁棒性,甚至优于专用的 OOD 检测方法。

论文贡献

(1)有效的局部提示学习。在 GalLoP 中,将局部提示与 k 个图像区域的稀疏子集对齐,从而实现捕获细粒度语义的文本到图像匹配。为了使视觉表示适应下游数据集,采用适合少数镜头学习的简单线性投影来细化视觉局部特征的文本对齐。

(2)强化整体多样性。学习与整个图像一致的全局提示和局部空间定位提示,并加强它们之间的多样性以改善它们的组合。引入新的“提示dropout”策略通过随机化引入多样性,这在学习多个提示时增强了泛化能力。此外,作者采用多尺度策略将局部提示与不同大小的图像区域对齐,捕获概念语义的不同视觉方面。

GalLoP方法

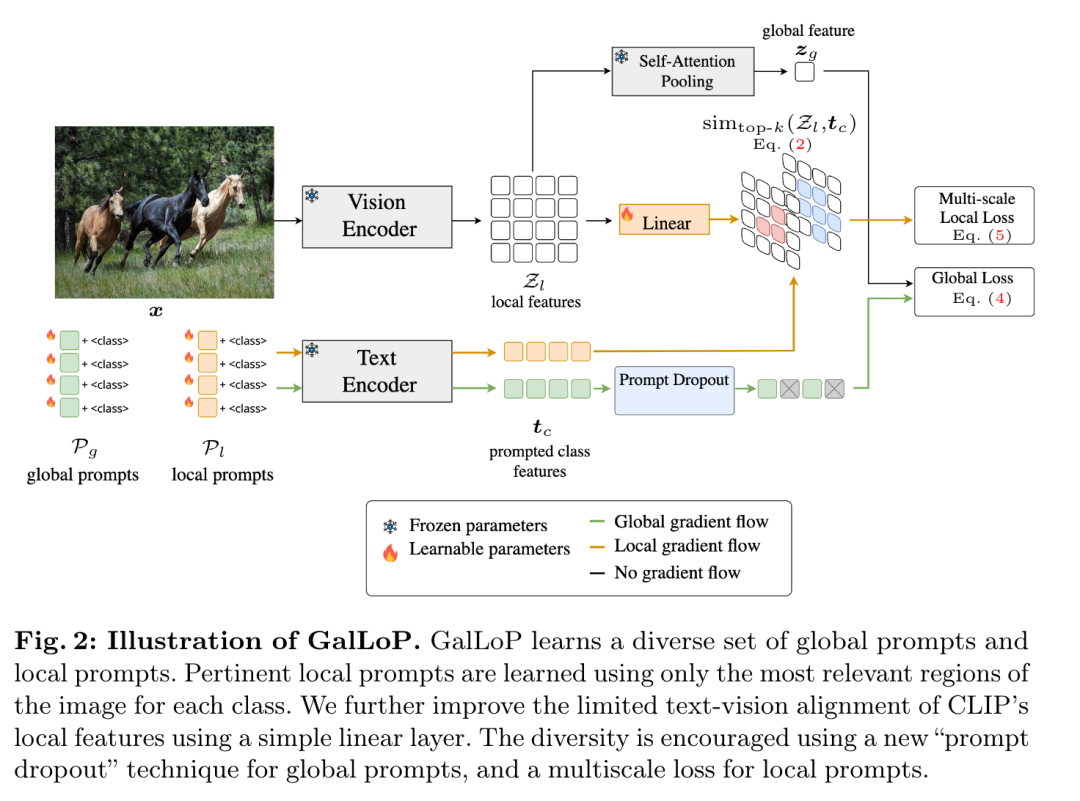
GalLoP旨在从全局和局部 CLIP 的视觉表示中学习不同提示的集合。如图 2 所示,GalLoP 学习两组专门的提示:从全局视觉表示接收信号的“全局提示”,以及仅使用局部特征训练的“局部提示”。
考虑一组 个可学习的局部提示 和一组 个可学习的全局提示 这些提示 中的每一个都由 个可学习的嵌入组成,即 ,并添加到类名嵌入 之前以执行分类。令 表示下游数据集,其中 是图像, 是其类别,令 和 分别表示 CLIP 的文本和视觉编码器。文本编码器生成第 c 类的标准化文本表示 。给定输入图像 ,视觉编码器生成视觉表示 。 可以是用于学习全局提示的全局向量,即 CLIP 已预训练的全局视觉特征。对于本地提示, 将是编码器输出的一组本地化特征。根据其视觉表示 ,图像 被分类到类 的概率可以表示为:
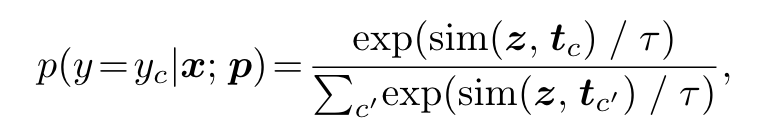
其中 是相似度的度量,是固定的温度缩放参数。使用标准交叉熵损失 训练提示。

为了训练全局提示,使用图像 x 的全局视觉表示,即 。全局向量 和提示之间的相似度简化为余弦相似度,即 ,全局提示 可以通过最小化以下损失函数来训练:

从局部视觉表征中学习提示

本文暂时考虑单个局部提示。在这种情况下,考虑的视觉表示 z 是视觉局部特征的集合,即 。定义向量集为 和第 c 个类的文本表示之间的相似性,

稀疏局部相似性。获得所有区域的单一相似性的一种简单方法是将每个空间位置与类的文本表示的相似性进行平均。然而,局部特征的很大一部分与类别无关,例如来自背景区域的特征,这可能会引入噪声并扰乱学习过程。为了解决这个问题,作者采用稀疏方法,仅保留与类语义相关的局部特征来执行分类。如图3所示,选择与提示类文本表示相似度最高的top-k局部特征,并对它们的相似度进行平均以测量。
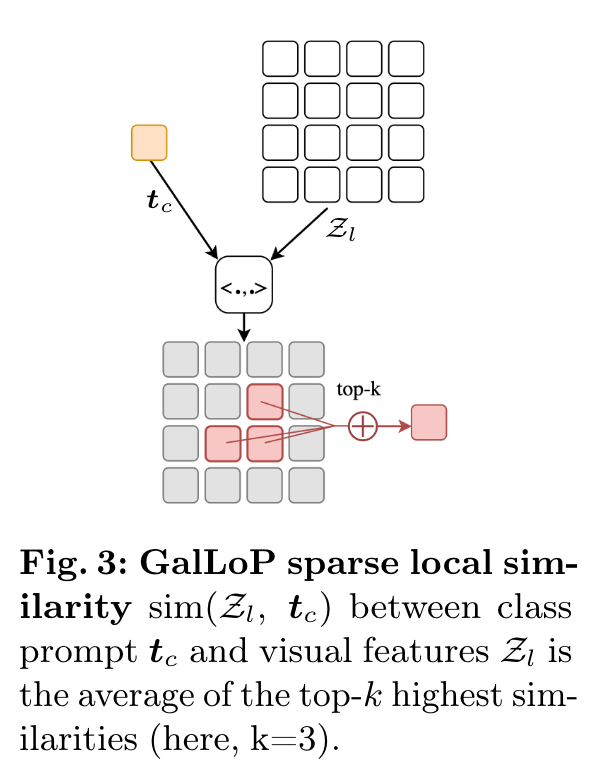
将提示 和视觉特征集 之间的相似度定义为 k 个最相似区域的平均相似度:

改善局部文本视觉对齐。将 CLIP 局部视觉特征与下游数据集的类标签的文本表示重新对齐来提高 CLIP 局部视觉特征的判别能力。使用简单的线性投影 θ。为了简化学习过程,将线性层 θ 初始化为恒等式,以便初始特征接近 CLIP 的表示。此后,使用一组线性变换的局部视觉特征θ 来计算分类:
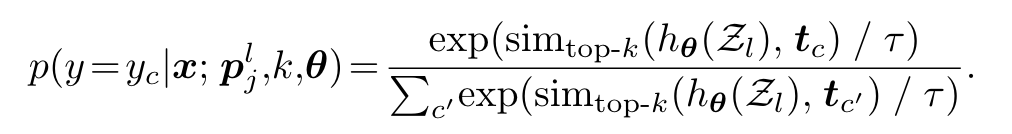
因此,可以通过利用交叉熵损失最大化该概率来优化局部提示。 GalLoP 中的这些设计能够针对局部特征训练强大的分类器:稀疏性有助于关注图像中最相关的区域并消除潜在的背景噪声,而线性投影则增强了文本视觉对齐并提高了精细度。

学习多样性提示

除了利用不同的信息源(全局信息源和视觉信息源)之外,作者还引入了两种增加多样性的机制:“提示dropout”和多尺度训练.

提示dropout。在“提示dropout”中,随机屏蔽批次中每个图像的提示子集。或者,从每个提示的角度来看,选择该批图像的不同子集,从而通过输入随机化在提示的学习过程中引入多样性。

全局提示集的训练是在以下损失的情况下进行的:
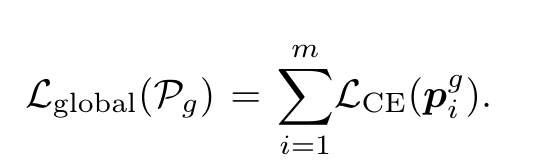
多尺度训练。为提高局部提示的多样性,文中为每个局部提示选择不同数量的特定于类的视觉补丁(尺度)。通过这种方式,专用于小尺度的提示将从与小视觉概念相对应的类中获得更多信号,例如“雏菊花”或“尾青蛙”,而以较大尺度学习的提示将从具有更广泛概念的图像中接收更多信号,例如“城堡”或“山谷”。更正式地,令 表示一组递增尺度,其中 为第一个尺度,Δk 为扩展因子。每个局部提示 都将以其相关的尺度 来学习。

然后,通过优化概率来训练 n 个局部提示,每个提示具有不同的尺度,即 k 的值:
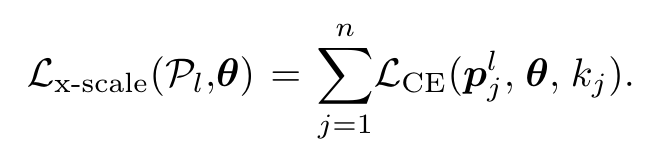
训练提示集的总体损失 是局部多尺度损失和全局损失的总和:
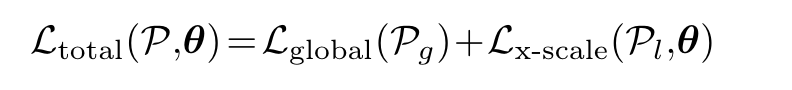
实验

如表 1 所示,在 11 个数据集上将 GalLoP 与 ViT-B/16 主干进行比较。平均而言,GalLoP 的表现远超之前的方法,与排名第二的 PromptSRC▷ 相比,高出 +1.5 分。此外,GalLoP 在大多数数据集上表现良好,在提示学习方法中达到了最佳水平。例如,在大规模 ImageNet 数据集上,它的表现比 PLOT 高出 +2.5 pt,比 PromptSRC▷ 高出 +1.9 pt。在某些数据集上,例如 FGVC Aircraft,GalLoP 的表现远超排名第二的方法,与 PromptSRC▷ 相比,高出 +7.5 pt。
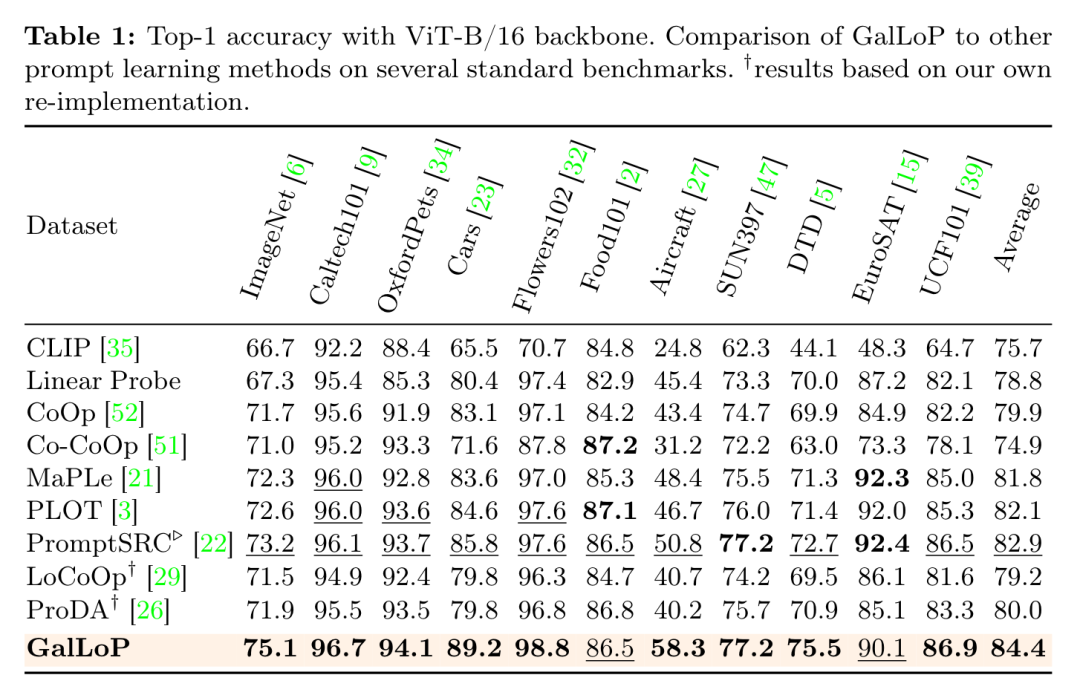
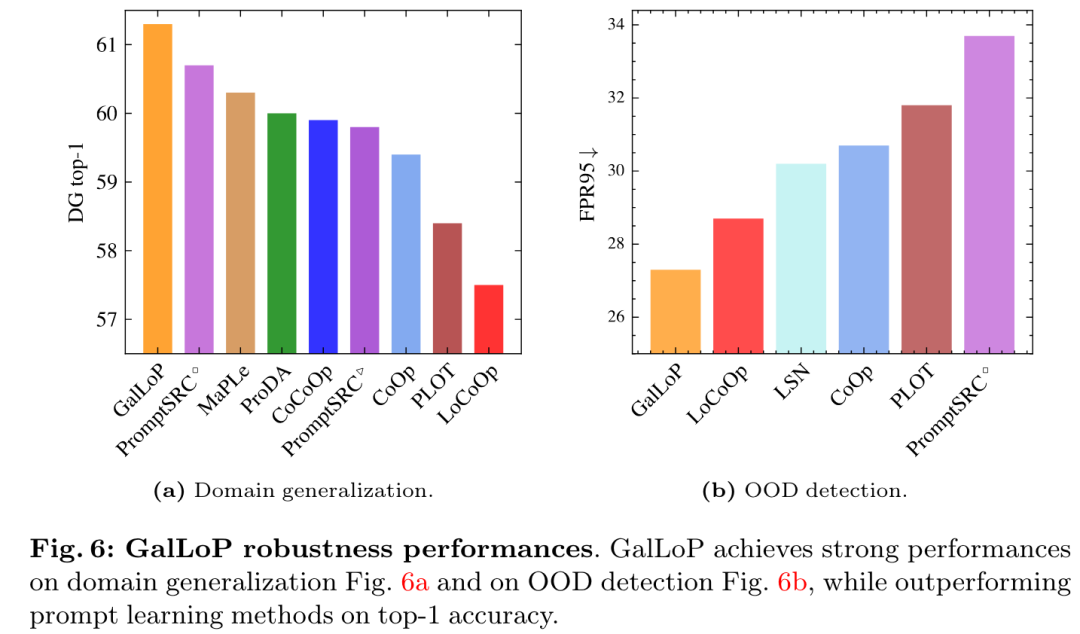
图 6a 比较了 GalLoP 与其他提示学习方法的域泛化性能。在 ImageNet(16 个镜头)上进行训练后,模型针对与 ImageNet 具有相同类别的不同域(即 ImageNet-V2、ImageNet-Sketch、ImageNet-A,ImageNet-R)进行 top-1 精度评估。 GalLoP 平均优于域泛化特定方法 PromptSRC⋄ +0.5pt,在 ImageNet 上比它高出 4.9pt。这说明了 PromptSRC 在 top-1 精度和域泛化之间进行的权衡。事实上,GalLoP 的性能优于 PromptSRC▷(专为 ImageNet 精度而设计),在 ImageNet 上高出 1.9 pt,在领域泛化方面平均高出 1.5 pt。 GalLoP 在 top-1 性能和域泛化之间实现了最佳权衡。
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

论文笔记--视觉语言模型(VLP)综述 A Survey of Vision-Language Pre-Trained Models 视觉语言模型(VLP)综述 A Survey of Vision-Language Pre-Trained Models论文笔记 阅读详情

相关推荐

深度剖析Tim Sort - Pyhon及Chrome引擎v8使用的高效排序算法

你有没有好奇过,Array.sort()方法的背后,浏览器跑的是什么算法呢? 提到排序算法,我们的第一反可能是冒泡排序、插入排序、快速排序、归并等经典排序算法。推荐一篇很棒的博客,里面列举比较了10大排序算法(附有很棒的动图),这里就不多说了。 Chrome浏览器引擎v8使用的则是不属于任何经典排序算法的Tim Sort。2002年Python的主要贡献之一的Tim Peters为这门最近非常热门的编程语言创造了这个高效的混合算法。它是根据现实中大量的数据分析,决定在什么情况下用什么算法组合达到大概率最优解

蛋黄酱来一勺 925

简述视觉语言模型(Vision-Language Models, VLMs)

视觉语言模型是一种能够同时处理图像和文本数据的多模态神经网络模型。其核心任务是通过跨模态的表示学习,理解和生成与视觉内容相关的语言信息,或者从语言信息中生成与之对应的视觉内容。相比于传统的单模态模型,视觉语言模型的优势在于它能够结合视觉信息和语言信息进行多方面的推理和生成。例如,在图像描述任务中,视觉语言模型需要理解图像中的对象、场景、动作等信息,并通过语言生成准确的描述。反之,在图像问答任务中,模型需要根据自然语言问题从图像中提取相关信息,并给出准确的答案。

m0_61789994的博客 5873

视觉提示学习(Prompt Learning):CV领域的GPT时刻?

视觉提示学习(Prompt Learning):CV领域的GPT时刻? ,人工智能,计算机视觉,大模型,AI,在人工智能技术不断演进的今天,计算机视觉(Computer Vision,CV)作为人工智能领域的重要分支,始终致力于让机器 “看懂” 世界。从早期基于传统特征工程的图像识别方法,到深度学习时代卷积神经网络(Convolutional Neural Networks,CNN)的崛起,CV 领域经历了多次重大变革。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 4万+

盘点 2024 年的视觉语言模型VLMs

视觉语言模型(Vision Language Models, VLMs)是一类生成模型,能够同时从图像和文本中学习以解决多种任务。视觉语言模型被广义定义为能够从图像和文本中学习的多模态模型。这类生成模型以图像和文本为输入,生成文本(或图像)作为输出。大型视觉语言模型在零样本学习中表现出色,具有良好的泛化能力,并能够处理多种类型的图像,包括文档、网页等。

xx_nm98的博客 2783

MaPLe: Multi-modal Prompt Learning

CLIP等预先训练的视觉语言(V-L)模型对下游任务表现出了出色的泛化能力。但是,它们对输入文本提示的选择很敏感,需要仔细选择提示模板才能执行良好的操作。受自然语言处理(NLP)文献的启发,最近的CLIP自适应方法学习提示作为文本输入,以微调CLIP用于下游任务。我们注意到,在CLIP的单个分支(语言或视觉)中使用提示来调整表示是次优的,因为它不允许在下游任务上动态调整两个表示空间的灵活性。在这项工作中,我们提出了视觉和语言分支的多模式提示学习(MaPLe),以提高视觉和语言表征之间的一致性。

c_cpp_csharp的专栏 732

AS5600磁编码器选型与安装避坑指南:磁铁形状、间隙距离到底怎么选?(附实测数据)

本文详细解析了AS5600磁编码器的选型与安装要点,包括磁铁形状、间隙距离等关键参数的选择,并附有实测数据支持。特别针对Arduino和I2C接口的应用场景,提供了硬件选型和机械安装的实用指南,帮助开发者避免常见陷阱,提升系统精度和稳定性。

weixin_27038245的博客 290

ECCV2024论文解析|GalLoP Learning Global and Local Prompts for Vision-Language Models-water-merged

本文提出了一种新的提示学习方法GalLoP,旨在通过利用全局和局部视觉特征来学习多样化的提示,以提高视觉语言模型(VLMs)在少样本图像分类中的表现。尽管现有的提示学习方法在分类精度和鲁棒性之间存在权衡,GalLoP通过引入“提示丢弃”技术和多尺度策略,增强了局部特征的视觉-文本对齐,进而提高了模型的准确性和鲁棒性。实验结果表明,GalLoP在11个不同的数据集上超越了现有的提示学习方法,并在领域泛化和分布外(OOD)检测中表现出色,显示出其强大的泛化能力和鲁棒性。

SJ_HP的博客 898

电路课设-音响分频器电路设计

(一)题目简介 1.一阶分频器电路设计 假定高音和低音扬声器均等效为 16 欧姆电阻,设计如图 2 的简单分频器电 路,要求高低频分界(两个滤波器的截止频率)为 5kHz。 1) 写出高音扬声器和低音扬声器电压对于 vs 的传递函数,确定电路中电 容 C 和电感 L 的元件值;2)利用 AC 频率扫描分析求出两个扬声器电压的频率响应曲线,验证计算 结果。用包含高低频成分的电压 vs 激励进行测量验证。 3)计算并利用 EWB 仿真证明从 vs 看进去的阻抗为一常数 16 欧姆。

weixin_53507617的博客 1万+

视觉语言模型详解【VLM】

视觉语言模型被广泛定义为可以从图像和文本中学习的多模态模型。它们是一种生成式模型,可以接受图像和文本输入并生成文本输出。大型视觉语言模型具有良好的零样本能力,具有良好的泛化能力,并且可以处理多种类型的图像,包括文档、网页等。用例包括谈论图像、通过指令进行图像识别、视觉问答、文档理解、图像字幕等。一些视觉语言模型还可以捕获图像中的空间属性。当系统提示检测或分割特定主题时,这些模型可以输出边界框或分割掩码,也可以定位不同的实体或回答有关其相对或绝对位置的问题。

新缸中之脑 3万+

从零开始:Doherty功率放大器的ADS仿真实践指南

本文详细介绍了Doherty功率放大器在ADS中的仿真设计流程,从基础原理到实际工程应用。通过负载调制技术,Doherty结构显著提高了功率放大器的效率,特别适合处理高峰均比信号。文章包含ADS环境搭建、对称与非对称设计、常见问题调试等实用内容,为射频工程师提供全面的实践指南。

weixin_29313547的博客 692

快手did did_gt edid的注册过程

接口 https://gdfp.ksapisrv.com/rest/infra/gdfp/report/kuaishou/android did 是本地生成的16进制 或者 获取的 android_id did_gt 是did生成时间戳 1595073601970 public static final Random f16237a = new Random(System.currentTimeMillis()); public static long m19668a() {  &n

HURUWO的技术博客 1万+

视觉语言模型:融合视觉与语言的未来

视觉语言模型(Vision-Language Models, VLMs)是能够同时处理和理解视觉(图像)和语言(文本)两种模态信息的人工智能模型。这种模型结合了计算机视觉和自然语言处理的技术,使得它们能够在视觉问答、图像描述生成、文本到图像搜索等复杂任务中表现出色。它是将transformer架构应用到计算机视觉领域的成功案例。具体来说就是将传统CNN中图像特征提取的全局替换为注意力机制。视觉语言模型在多个领域展示了巨大的潜力,包括图像检索、生成式AI、图像分割、医疗诊断和机器人技术。

m0_56022510的博客 3142

【vivado PG学习】1 PG168:7 Series FPGAs Transceivers官方配置方法学习笔记

介绍: The 7 series FPGAs Transceivers Wizard LogiCORE™ IP 自动创建配置7系列fpga 收发器的HDL封装。向导可以配置一个或多个支持行业主流标准的高速串行收发器。或者从零开始支持各种自定义协议。 功能: 创建配置7系列fpga 收发器的HDL封装。 自动对模拟设置进行配置。 预定义了提供Aurora 8B/10B, Aurora 64B/66B, CEI-6G,DisplayPort, Interlaken, Open Base StationAr..

w0shishabi的博客 5万+

视觉语言模型究竟能帮助我们完成哪些工作?

​视觉语言模型利用视觉和语言数据之间的协同作用来执行各种任务,从而彻底改变了该领域。虽然目前已有的文献中已经引入了许多视觉语言模型,但CLIP(对比语言-图像预训练)仍然是最知名和最广泛使用的模型。​通过在同一向量空间中嵌入图像和标题,CLIP模型允许进行跨模式推理,使用户能够以良好的准确性执行诸如零样本图像分类和文本到图像检索等任务。并且,CLIP模型使用对比学习方法来学习图像和标题的嵌入。​对比学习使得CLIP模型可以通过在共享向量空间中最小化图像之间的距离来学习将图像与其相应的标题相关联。

java_cjkl的博客 1271

洪水风险图制作全流程:HEC-RAS 与 ArcGIS 的耦合应用

本文系统介绍HEC-RAS水动力模拟软件在水利工程中的应用技术。内容涵盖:1)软件理论与安装;2)一维地形数据导入与河网构建;3)恒定流/非恒定流计算及模型调试要点;4)构筑物建模技术(桥梁、堰闸等);5)二维水动力模拟与溃坝分析;6)洪水风险图绘制。重点讲解水面线调试、糙率选取、报错分析等实操难点,通过案例教学实现从基础到工程应用的全流程技术掌握。该培训适用于防洪评价、河道治理等水利工程数值模拟需求。

2403_89974123的博客 1053

98DX3236内核编译过程小结

0.条件(1)Marvell技术支持提供的压缩文件:GNU EABI:arm-mv5sft-linux-gnueabi_SW3.2.tar.bz2.tar.bz2armebv7-marvell-linux-gnueabi-softfp_i686_201201.tar.bz2CPSS代码:Cpss-PP-DxCh-4.2_012.zipLinux内核文件:lsp-4.2_012.zipLSP-Uni...

snaking616 1806

论文解读:(PromptSRC)Self-regulating Prompts: Foundational Model Adaptation without Forgetting

对于各种下游任务,提示学习已经成为对基础模型(如CLIP)进行微调的有效替代方法。传统上使用特定于任务的目标进行训练,即交叉熵损失,提供的提示倾向于过度拟合下游数据分布,并且发现从冻结的CLIP中捕获与任务无关的一般特征具有挑战性。这导致了模型原有泛化能力的丧失。为了解决这个问题,我们的工作引入了一个名为PromptSRC(带有自我调节约束的提示)的提示自正则化框架。

weixin_50917576的博客 3290

大模型安全-生成检测-事实核查-攻击-防御-思考-记忆-融合-语音相关研究 2025年版

本文整理了关于大模型安全领域的综合性资源,包括7篇综述论文、9个安全数据集以及5篇强化学习相关的安全研究论文。主要涉及大模型的对抗攻击、隐私保护、安全评估等方向,涵盖TruthfulQA、ToxiGen等知名数据集和TrustLLM、HarmBench等关键研究。资源包括知乎博主分享、arXiv预印本和顶会论文,并附有详细的中文讲解链接,为研究者提供了系统性的安全研究参考。

CSPhD-winston的博客 3593

【视觉提示学习】3.28阅读随想

CoOp通过,这些向量可以用随机值或预训练的词嵌入进行初始化(见图2)。我们提供了以处理不同性质的任务:一种是基于统一上下文(unified context),它与所有类别共享相同的上下文,并且在大多数类别上表现良好;另一种是基于类别特定上下文(class-specific context),它为每个类别学习一组特定的上下文标记,并且发现在某些细粒度类别上更为合适。在训练过程中,我们只需通过最小化与可学习上下文向量相关的交叉熵损失来优化预测误差,同时保持整个预训练参数固定不变。

2402_83131238的博客 1178

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

CVPR 2024 | PromptKD:基于提示的视觉语言模型蒸馏

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【扩散模型和多模态】交流群添加微信:CVer444,小助手会拉你进群!扫描下方二维码,加入CVer学术星球,可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文搞科研,强烈推荐!作者:Zheng Li(已授权转载)https://zhuanlan.zhihu.com/p/684269...

阿木寺的博客 1184

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

一文看懂!视觉语言模型VLM

视觉语言模型(Visual-Language Models, VLMs)是一种融合视觉信息与语言信息的多模态人工智能模型。它旨在通过同时处理图像、视频等视觉数据以及文本、语音等语言数据,实现对复杂场景的深度理解和生成。这种模型的核心在于打破视觉与语言之间的模态壁垒,使机器能够像人类一样综合运用视觉和语言能力来完成各种任务。在人工智能的发展历程中,视觉和语言一直是两个相对独立的研究领域。计算机视觉专注于图像和视频的识别与理解,而自然语言处理则致力于文本和语音的处理与生成。

u012374012的专栏 2854

视觉语言模型的提示学习:探索高效适配新领域

视觉语言模型的提示学习:探索高效适配新领域 CoOpPrompt Learning for Vision-Language Models (IJCV'22, CVPR'22)项目地址:https://gitcode.com/gh_mirrors/co/CoOp 在快速发展的AI界,视觉与语言的融合成为了一大热点。今天,我们向大家推荐一个前沿的研究项目——Prompt Learning for V...

gitblog_00618的博客 775

【提示学习论文六】MaPLe: Multi-modal Prompt Learning论文原理

这篇文章于2023年发表在CVPR(Conference on Computer Vision and Pattern Recognition),作者是Muhammad Uzair Khattak,Hanoona Rasheed,Muhammad Maaz,Salman Khan,Fahad Shahbaz Khan。研究发现Clip的问题:在单个分支(语言或视觉)中使用prompt来调整表示是次优的,它不能在下游任务上灵活地动态调整两个表示空间。

weixin_51293984的博客 3981

【多模态】13、Vision-Language 模型在视觉任务中的调研

本文主要介绍了 vision-language 模型在视觉任务中的使用

呆呆的猫的博客 3431

视觉语言模型——原理、模型架构、训练方法

近年来深度学习在计算机视觉(CV)和自然语言处理(NLP)等单模态领域都取得了十分优异的性能。随着技术的发展,多模态学习的重要性和必要性已经慢慢展现。视觉语言学习作为多模态学习的重要部分,得到国内外研究人员的广泛关注。得益于Transformer框架的发展,越来越多的预训练模型被运用到视觉语言多模态学习上,相关任务在性能上得到了质的飞跃。

小拉拉的博客 5622

多模态学习

作者:张致远 #mermaid-svg-bqinfdlcry278edQ .label{font-family:'trebuchet ms', verdana, arial;font-family:var(--mermaid-font-family);fill:#333;color:#333}#mermaid-svg-bqinfdlcry278edQ .label text{fill:#333}#mermaid-svg-bqinfdlcry278edQ .node rect,#mermaid-svg-..

TSINGHUAJOKING 1万+
上一篇: 最新热点!融合创新!Transformer+并行网络:局部特征+全局特征;时序特征+空间特征!小白也会用的分类预测程序!
下一篇: 代码角度,深度解析 Qwen2-VL 模型结构
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值