RAG系统进阶:query rewrite高手必备的三大技巧,附代码实现

RAG之query改写优化 RAG系统涉及到对用户query做检索召回,好的query更有利于召回正确的结果。所以query analysis要做的就是对输入query做一个改写,让其语义更完善或格式更清晰。基于query改写好的文档如下,然后我们可以分别基于query和文档做检索。 阅读详情

一个好的RAG系统需要一个好的检索模块,而一个好的检索模块需要一个好的query理解模块。这个博客,主要介绍3个常见的query改写方式。

Sub-Question

示例图:
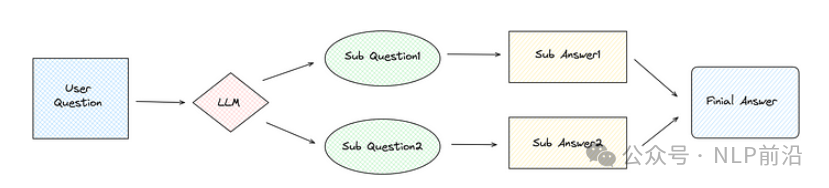
流程:

  1. 子问题策略使用 LLM 根据用户查询生成多个子问题。

  2. 然后,每个子问题经过RAG过程以获得自己的答案(检索生成)。

  3. 最后,将所有子问题的答案进行合并,得到最终的答案。

代码示例

    ##  默认流程   from llama_index.core import VectorStoreIndex, SimpleDirectoryReader      question = "Harley Quinn和Thanos 是复仇者联盟中的正义人物吗?"   documents = SimpleDirectoryReader("./data").load_data()   node_parser = VectorStoreIndex.from_documents(documents)   query_engine = node_parser.as_query_engine()   response = query_engine.query(question)   print(f"base query result: {response}")      # Output   base query result: 不,Harley Quinn和Thano在《复仇者联盟》系列中并没有被描绘成正义的人物。         ## Sub-Question   from llama_index.core.tools import QueryEngineTool, ToolMetadata   from llama_index.core.query_engine import SubQuestionQueryEngine      query_engine_tools = [       QueryEngineTool(           query_engine=query_engine,           metadata=ToolMetadata(               name="Avengers",               description="漫威电影《复仇者联盟》",           ),       ),   ]   query_engine = SubQuestionQueryEngine.from_defaults(       query_engine_tools=query_engine_tools   )   response = query_engine.query(question)   print(f"sub question query result: {response}")      # Output   Generated 2 sub questions.   [Avengers] Q: Harley Quinn 在复仇者联盟电影中扮演什么角色?   [Avengers] Q: Thanos play 在复仇者联盟电影中扮演什么角色?   [Avengers] A: 在《复仇者联盟》电影的背景介绍中,并没有提到Harley Quinn。   [Avengers] A: Thanos是《复仇者联盟》电影中的主要反派。他是一位强大的军阀,试图按照自己的设想重塑宇宙。Thanos被描绘成一个强大而无情的敌人,对复仇者联盟和整个宇宙构成了重大威胁。   sub question query result: 复仇者联盟电影的背景中并未提及Harley Quinn。Thanos是复仇者联盟电影的主要反派,被描绘成一个强大而无情的敌人。    

HyDE

示例图:
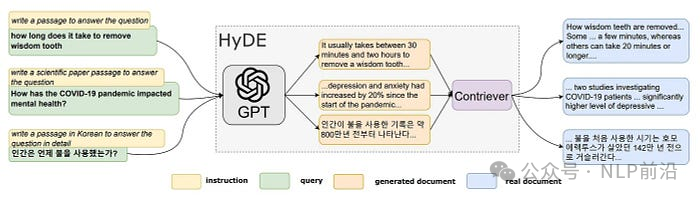
原理:

HyDE(Hypothetical Document Embeddings)的本质是利用LLM生成假设文档。这些文档是根据 LLM 本身的知识生成的,可能包含错误或不准确之处。但是,它们与 RAG 知识库中的文档相关联。然后,利用这些假设文档来检索具有相似向量的真实文档,提高检索的准确性。

代码示例:

from llama_index.core.indices.query.query_transform import HyDEQueryTransform      question = "Loki为了征服地球使用了什么神秘物品?"   hyde = HyDEQueryTransform(include_original=True)   query_bundle = hyde(question)   print(f"query_bundle embedding len: {len(query_bundle.embedding_strs)}")   for idx, embedding in enumerate(query_bundle.embedding_strs):       print(f"embedding {idx}: {embedding[:100]}")      # Display result   query_bundle embedding len: 2   embedding 0: Loki 利用宇宙立方(又称宇宙魔方)试图征服地球。这个神秘的...   embedding 1: Loki 为了征服地球使用了什么神秘物品?      from llama_index.core.query_engine import TransformQueryEngine      hyde_query_engine = TransformQueryEngine(query_engine, hyde)   response = hyde_query_engine.query(question)   print(f"hyde query result: {response}")      # Display result   hyde query result: Loki 曾试图利用宇宙立方征服地球。这件强大的神器也被称为...      

注:HyDE 生成的假设文档基于 LLM 的知识,可能包含错误或不准确之处。HyDE 可能会误导查询并引入偏差,因此在实际应用中使用时应谨慎。

Step-Back Prompting

示例图
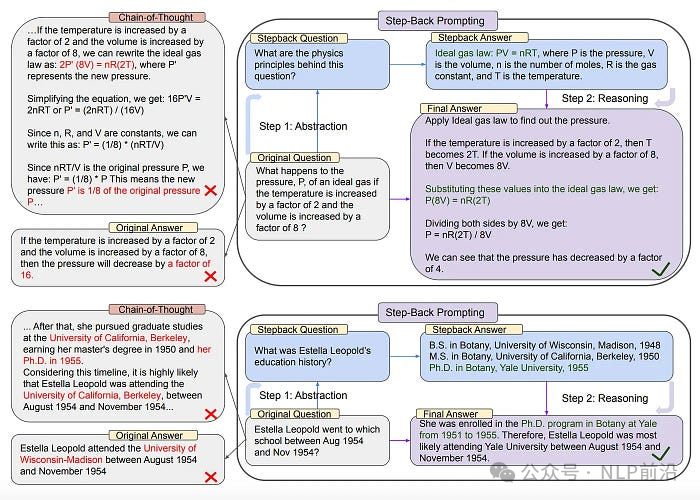
步骤

Step-Back Prompting是一种引导LLM通过从用户查询中提取高级概念和基本原理,并用这些概念和原理来指导推理的方法。可以显着提高LLM遵循正确推理路径解决问题的能力。

以上图中的第一个问题为例,原来的问题是求给定温度和体积的压力。左边的答案中,无论是原来的答案还是思路链的答案,结果都是错误的。然而,通过后退提示,首先在原始问题的基础上生成更广泛的问题,例如寻求问题背后的底层物理公式。然后,从更广泛的问题中获得答案,最后将更广泛的问题的答案和原始问题一起提交给LLM,从而获得正确的答案。

代码示例:

from llama_index.core import PromptTemplate   from openai import OpenAI      client = OpenAI()   examples = [           {               "input": "1968 年至 1974 年期间安娜·卡琳娜的配偶是谁?",               "output": "安娜·卡琳娜的配偶是谁?",           },           {               "input": "1954 年 8 月至 1954 年 11 月期间,埃斯特拉·利奥波德 (Estella Leopold) 就读于哪所学校?",               "output": "埃斯特拉·利奥波德 (Estella Leopold) 的教育历史是怎样的?",           },       ]       few_shot_examples = "\n\n".join(           [f"human: {example['input']}\nAI: {example['output']}" for example in examples]       )       step_back_question_system_prompt = PromptTemplate(           "你是世界知识方面的专家。"   "你的任务是退一步,将问题解释为更通用的退一步问题,"   "这更容易回答。以下是几个例子:\n"           "{few_shot_examples}"       )       completion = client.chat.completions.create(           model="gpt-3.5-turbo",           temperature=0.1,           messages=[               {                   "role": "system",                   "content": step_back_question_system_prompt.format(                       few_shot_examples=few_shot_examples                   ),               },               {"role": "user", "content": question},           ],       )       step_back_question = completion.choices[0].message.content       print(f"step_back_question: {step_back_question}")          retrievals = retriever.retrieve(question)   normal_context = "\n\n".join([f"{n.text}" for n in retrievals])   retrievals = retriever.retrieve(step_back_question)   step_back_context = "\n\n".join([f"{n.text}" for n in retrievals])         step_back_qa_prompt_template = PromptTemplate(           "Context information is below.\n"           "---------------------\n"           "{normal_context}\n"           "{step_back_context}\n"           "---------------------\n"           "Given the context information and not prior knowledge, "           "answer the question: {question}\n"       )      completion = client.chat.completions.create(           model="gpt-3.5-turbo",           temperature=0.1,           messages=[               {                   "role": "system",                   "content": "一定要回答问题,即使上下文没有帮助。",               },               {                   "role": "user",                   "content": step_back_qa_prompt_template.format(                       normal_context=normal_context,                       step_back_context=step_back_context,                       question=question,                   ),               },           ],       )       step_back_result = completion.choices[0].message.content       print(f"step_back_result: {step_back_result}")          question: 泰坦星上发生过一场大战吗?   base result: 不,泰坦星上没有发生过大规模战争。泰坦星上没有发生过任何重大冲突或战争。   ====================================================================================================   step back question: 泰坦星上发生过什么重大事件吗?   step back result: 是的,在漫威电影宇宙中,泰坦星上发生过一场重大冲突。在《复仇者联盟:无限战争》中,泰坦星被描绘成灭霸被摧毁的家园,泰坦星上的战斗涉及一群英雄,包括钢铁侠(托尼·斯塔克)、蜘蛛侠(彼得·帕克)、奇异博士(史蒂芬·斯特兰奇)和银河护卫队,他们试图阻止灭霸实现他的目标。   

可以看到,没有Step-Back Prompting的结果是不正确的,但是使用Step-Back Prompting后,我们根据知识库文档得到了正确的答案。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

RAG 的是与非、Rewrite 和 Rerank 有时候,我觉得人类还真是种擅长画地为牢的动物,因为突然发现,当人们以文化/理念的名义形成团体/圈子的时候,其结局都不可避免地走向了筛选和区分的道路。或许,大家都不约而同地笃信,在成年人的世界里,那条不成文的社交潜规则——“与千百年前百家争鸣不同,团体/圈子间并不热衷于交流,倒像是一种标签化的分类方式,甚至是一种非黑即白的二元分类方式。比如,通常人们认为男性不能讨论女性主义,可我经常在女性主义视角下看到对男性的讨论。女性朋友们一致认为,女性种种不幸完全是由男性以及男性背后的父权造成的。 阅读详情

相关推荐

提升RAG系统效果:揭秘Rewrite技术及其关键优化策略,提高召回率与精确度

关于RAG的优化,前面我们讲过一篇是Rerank的优化,《揭开RAG重排序(Rerankers)和两阶段检索(Two-Stage Retrieval)的神秘面纱》,Rerank优化的目的是通过向量检索返回更多的top K结果,以提高召回率和精确度。上图,从左到右,我们展示了(a)标准的retrieve-then-read方法,(b)LLM 作为我们的 rewrite-retrieve-read管道的查询重写器,以及(c)带有可训练重写器的管道。例如,考虑使用个性化推送通知,提前告知粉丝直播的详细信息。

春华秋实 1144

Rag中的问题改写query rewriting

在rag的整个流程中,一般第一步就是对问题query进行改写,为什么需要改写呢,主要是用户在提问的时候,想要得到的答案和问题不匹配,为了得到想要的答案,不同的用户可能问的方式千变万化,这就需要对query进行改写,来提高rag系统的鲁棒性和扩展性。用户的query存在的问题,主要有两个方面,一是信息缺失,用户表达的不全面;一是噪声,用户query里面携带了很多不相关的东西。改写后query的质量,很依赖于prompt和大模型的能力。

sinat_28694519的博客 6017

24 Hybrid Search、Rerank、Query Rewrite:RAG 高级优化三件套

基础 RAG 答不准时,不要一上来堆所有优化。本文拆解 Query Rewrite、Hybrid Search 和 Rerank 三件套:分别解决用户问法不适合检索、纯向量检索漏掉精确词、候选结果排序不够准的问题,并给出渐进式接入顺序。

老于的笔记的专栏 238

RAG查询改写方法概述

在RAG系统中,用户的查询是丰富多样的,可能存在措辞不准确和缺乏语义信息的问题。这导致使用原始的查询可能无法有效检索到目标文档。因此,将用户查询的语义空间与文档的语义空间对齐至关重要,目前主要有查询改写和嵌入转换两种方法。查询改写的方法包括Query2Doc,Doc2Query,HyDE,Step-Back Prompting,Rewrite-Retrieve-Read,ITER-RETGEN,Multi-query。

qq_43814415的博客 4066

从零开始做一个AI Agent(七)检索系统:关键词检索、向量检索、query rewrite 和 rerank

这篇文章介绍了一个Java Web课程学习AI助手的实现过程,重点讲解了其检索系统的设计。该系统采用混合检索策略,结合关键词检索和向量检索,并引入LLM进行查询改写和结果重排序。文章详细说明了检索入口、结果处理、中文和代码友好的分词规则、关键词检索算法、向量检索实现方案比较(路线A/B/C)以及LLM重排序机制。这种混合检索设计特别适合处理课程资料中同时包含自然语言和代码内容的特点,能有效兼顾课程概念、实验步骤、代码文件等多种信息类型的检索需求。文章属于一个完整技术教程专栏的第7篇,该专栏从零开始构建一个R

echo的博客 442

LSTM cell结构的理解和计算

LSTM是传统RNN网络的扩展,其核心结构是其cell单元,网上LSTM的相关资料繁多,质量参差不齐,下面主要结合LSTM神经网络的详细推导和 Christopher Olah的blog两篇文章中的内容进行说明。主要介绍网络如何计算,为何这么算先不展开:)。前者一副图加上29个公式,简洁明了;后者娓娓道来,适合初学者。首先是LSTM cell最常见的结构图: 这是变形的版本(找不到更清晰的版本了),

songhk0209的博客 2万+

用十篇论文聊聊关于使用LLM做query Rewrite的问题

本文介绍了query改写。介绍了七种利用LLM进行query改写方式。包含了10余篇论文,论文有的出自微软、谷歌等大厂之手,还有北大,人大等高校。质量有所保障,对比了不同的query改写的效果。

Angus 1万+

深入解析ADC采样电容:从充电误差到LSB精度的关键设计

本文深入解析了ADC采样电容在模数转换中的核心作用,重点探讨了充电时间常数与采样误差的博弈关系。通过推导最小采样时间公式,揭示了精度、速度、源阻抗与内部电容之间的制约关系,并提供了从理论计算到外部驱动电路设计的实战指南,是确保ADC达到LSB精度的关键。

android的专栏 1104

如何为 RAG 构建 Query Rewrite 优化链路

构建 RAG 系统的 Query Rewrite 优化链路是一个迭代的过程,需要不断尝试不同的方法、调整 Pipeline 的参数、评估效果并进行优化。选择合适的 Query Rewrite 方法,构建 Query Rewrite Pipeline, 并进行效果评估,最终迭代优化,才能构建一个高效的 Query Rewrite 优化链路。希望这次讲座能够帮助大家更好地理解和应用 Query Rewrite 技术,构建更强大的 RAG 系统。

weixin_41455464的博客 1007

【数据降维】数据降维方法分类

数据降维基本原理是将样本点从输入空间通过线性或非线性变换映射到一个低维空间,从而获得一个关于原数据集紧致的低维表示。 数据降维工具箱drtoolbox中众多算法,这里简单做个分类。 因为很多并没有仔细了解,在此次只对八种方法做分类:主成分分析(Principal Component Analysis,PCA)、线性判别分析(Linear Discriminant Analysis,LDA)、等

小魏的修行路 6万+

2023年高教社杯 | 2023年高教社杯全国大学生数学建模思路(A题思路、C题思路)

2023年高教社杯 | 2023年高教社杯全国大学生数学建模思路(A题思路、C题思路)

前程算法屋的博客 624

当Query Rewrite遇见RAG:大模型时代检索系统的范式革命

本文探讨了Query Rewrite技术与RAG框架在大模型时代的结合,如何通过LLM的语义理解能力提升检索系统的效率。文章详细分析了Query Rewrite的技术演进、核心挑战及在RAG框架中的应用,包括HyDE、子问题分解和PRF技术,并提供了工业级解决方案的设计要点和典型应用场景。

weixin_29164185的博客 340

自动驾驶算法-滤波器系列(三)——不同运动模型(CV、CA、CTRV、CTRA)的建模和推导

CV & CA & CTRV & CTRA1. CV模型2. CA模型3. CTRV模型4. CTRA模型 1. CV模型 2. CA模型 3. CTRV模型 4. CTRA模型

weixin_41480034的博客 2万+

明明文档里有答案却搜不到?你的 RAG 可能少了一步 Query Rewrite

RAG系统落地时常因用户非标准查询而失效,尤其在多轮对话中表现不佳。本文提出Query Rewrite技术作为解决方案,在检索前对用户原始查询进行优化处理。文章分析了直接检索的三大问题:指代模糊、语义鸿沟和多重意图,并介绍了四种改写技巧:基础修补(指代消解)、扩容增效(多路径重写)、结构重组(问题拆分)和深度迭代(多步检索)。同时指出需权衡延迟、成本和过度改写等问题,建议采用轻量化模型处理重写任务。Query Rewrite作为连接用户表达与检索系统的桥梁,能显著提升RAG系统的准确性。

sinat_28916141的博客 1040

ISOLAR Autosar BSW 配置 之 Com

Autosar ISOLAR Bsw Configuration 之 Com

qq_42262743的博客 453

vectorCast——Probe point 功能实现故障注入,局部变量打印,断点调试。

选择一个测试用例,选择coverage窗口进行查看。点击edit probe point,如图所示绿色的小圆圈。 选代码中选择需要打断点的地方进行点击。黑色的小圆点都可以选。 点击黑色小圆点,小圆点变绿,表示打断点成功。 此时就可以根据自己的需求在打断点的位置编写一些C语言的命令语句。 点击编译,成功会弹出窗口显示编译成功,失败会在下方报错error,并显示错误的原因。 点击应用保存,选择yes to all就可以了。 点击用例执行就可以看到打断点情况下的执行结果了。

weixin_59334478的博客 2077

企业级RAG系统实战(2):为什么向量检索还不够?深入理解 Rerank 与 Query Rewrite

通过向量检索,我们已经可以从知识库中找到一批"语义上接近"的文档,然后把这些文档拼接进 Prompt,交给大模型生成回答。

python1234567_的博客 367

分立器件---电感介绍(7000字)

电感基础整理

HW-BASE的博客 2353

从「这东西坏了咋整」到精准召回:Query Rewrite 四种方法全解析

查询重写的核心目的,是弥合用户提问与文档表述之间的语义鸿沟,而这道鸿沟有不同的形态,需要不同的策略去填:口语化用直接改写,文体差异用 HyDE,问题太具体用 Step-back,角度单一用多 Query 扩展。理解了"为什么改写"和"每种方法各自解决什么问题",才算真正掌握这项技术——而不是把改写简单地等同于"口语转书面语"。Query 扩展。理解了"为什么改写"和"每种方法各自解决什么问题",才算真正掌握这项技术——而不是把改写简单地等同于"口语转书面语"。

一个coder的博客 3972

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

Advanced RAG 06:生成结果的相关性低? 快用 Query Rewriting 优化技术

HyDE 方法看起来是无监督的,这种方法没有通过标注过的数据来训练任何模型,包括 generative model(译者注:其主要任务是从数据中学习数据的分布,然后可以用来生成类似于训练数据的新数据样本,通常用于生成图片、文本、音频等类型的数据。) 这种方法中,新的 query 用 q+ 表示,是最初的 query(q)和 pseudo-documents(d’)的简单连接,用 [SEP] 分隔:q+ = concat(q, [SEP], d’)。)” 由于特定时间范围的限制,直接解决这一问题极具挑战性。

Baihai_IDP的博客 3336

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

从RAG落地失败到用户满意度提升90%:我们靠这一招Query Rewrite,收藏起来避免踩坑!

本文探讨了RAG系统落地实践中的核心问题与解决方案。研究发现直接使用用户原始问题检索效果不佳,因为用户提问通常存在口语化、指代不清等问题。通过引入Query Rewrite能力,将用户问题转化为系统可理解的检索查询,包括问题拆解和上下文补全,显著提升了系统命中率。文章指出RAG应是"理解→搜索→再生成"的过程,强调Query Rewrite作为理解层是不可缺失的一环。同时指出该技术不适用于明确关键词查询等场景,建议将其视为能力而非默认实现。最后提醒开发者应更关注用户问题是否适合直接检索这

优快云_224022的博客 554

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

混合RAG在Dify中“查得到却召不回”?深度拆解Query Rewrite失效、Chunk Overlap缺失、Embedding Normalization错配三大黑盒问题

解决Dify混合RAG“查得到却召不回”难题,聚焦Query Rewrite失效、Chunk Overlap缺失、Embedding Normalization错配三大根源,提供可落地的召回率优化与报错解决方法。适用于自建知识库场景,兼顾精度与鲁棒性,值得收藏。

LiteCode的博客 265

润色用户的 Query(Query Rewrite)

在现代智能问答与搜索体系中,Query Rewrite 绝非可有可无的语法润色,而是整个检索链路的第一道“调度中枢”。它在算法层打破了用户自然语言与机器倒排/向量数据之间的语义壁垒:面对多轮交互,它通过指代消解为信息补齐锚点;面对复杂多跳,它通过子查询拆解分而治之;面对长尾冷僻知识,它通过HyDE 假想生成实现升维对齐;面对工程限制,它通过Fast/Slow Path 动态分流实现延迟与质量的精准平衡。

2603_96126046的博客 635

34:Rerank与Query Rewrite的自动化Pipeline

本文深入探讨Rerank与Query Rewrite的自动化Pipeline,通过小模型实现Query改写、Cross-Encoder Rerank和Agentic判断,显著提升RAG系统的检索效果和准确性。包含完整的技术分析、实现方法、代码示例、部署方案、效果对比实验,以及实战案例。通过这种自动化Pipeline,显著提升RAG系统的检索质量和用户体验。

欢迎来到智能安全前线!这里是AI与信息安全交汇之地。我们以代码为武器,深入大模型攻防实战,破解系统漏洞。追踪OpenAI、Meta前沿动态,用红蓝对抗思维,锻造智能时代的坚盾与利矛。 287

《Advanced RAG》-06-探索RAG技术 Query Rewriting

详细阐述了多种查询重写技术,这些技术用于在检索增强生成(RAG)中优化查询和文档之间的语义匹配。

静愚AGI 2104
上一篇: 想用好一门技术,首先要弄明白它的边界:大模型的能力圈和局限性
下一篇: 大厂上来就手撕 Transformer,心凉了一半。。。
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值