


在人工智能的浪潮中,我们正从单纯的“对话式大模型”迈向“Agent(智能体)时代”。如果说大模型是 AI 的“大脑”,那么 Agent 就是赋予了大脑手脚、感官以及高级阅读策略的完整形态。
关于 AI Agent,我个人的看法可以总结为:基于 LLM 架构的 Agent 在处理复杂任务上已经足够强大,但正是这种强大的上下文处理能力,决定了高质量“数据”才是它真正的上限。
一、 底层逻辑:Decoder-only 模型的命门在于“上下文”
当前主流的大模型(如 GPT、Gemini 系列)大多采用 Decoder-only 架构。这类模型的本质是“文字接龙”——通过已经输入的上下文,去预测下一个最可能出现的 Token(词汇)。
这意味着,模型本身没有绝对的“常识”,它的输出方向完全取决于你给它铺垫了什么样的上下文。 想要让它输出贴近正确、高价值的结果,就必须在它的上下文窗口里填满精准、丰富、符合逻辑的信息。单靠一次性的 Prompt 提示词,很难引导模型完成极其复杂的专业任务。
二、 Agent 的破局点:渐进式披露与长文本驾驭
正是为了解决上述“上下文引导”的难题,Agent 的架构应运而生。目前的 Agent 已经足够强大,它的强大不只在于能调用工具,更在于它彻底改变了模型阅读和处理信息的方式:
-
渐进式披露(Progressive Disclosure): Agent 不再是一次性吞咽海量文本,而是像人类专家一样,先阅读摘要或目录,再根据当前任务的需要,逐步展开和检索更深层的信息。
-
长文本连续阅读与反思: 面对超长文档,Agent 能够自主进行分块阅读(Chunking)、提取关键信息存入“短期记忆”,并不断将新获取的信息放入当前对话的上下文中。它甚至能在阅读过程中自我反思:“这段信息对我解决当前问题有帮助吗?如果没有,我需要换个搜索词或阅读另一段材料。”
这种渐进式的上下文构建能力,让 Decoder-only 模型摆脱了“静态问答”的局限,开始具备动态推演的智力表现。它的智力水平,已经越过了生产力爆发的临界点。
三、 终局挑战:越强大的阅读框架,越需要“优质数据”
然而,Agent 在信息处理机制上的成熟,反而暴露了当前最大的瓶颈——数据。
Agent 就像一台装载了顶级涡轮增压引擎的跑车,它的“渐进式披露”和“长文本阅读”机制,赋予了它极强的数据吞吐和消化能力。但问题是,我们喂给它的是什么?
-
没有专业数据,Agent 只能“脑补”: 如果在医疗或金融这种垂直领域,Agent 无法通过工具检索到高质量的垂直行业数据、私有知识库或实时市场反馈,那么它的上下文里就只剩下互联网上泛泛而谈的废话。此时,强大的 Decoder-only 模型就会顺着这些废话,一本正经地输出“幻觉”。
-
动态数据决定了进化的方向: Agent 的魅力在于越用越聪明。它需要持续阅读用户行为数据、环境反馈数据来更新自己的“记忆库”。如果数据链路被切断,Agent 就只能原地踏步。
四、 结论:建立数据闭环才是护城河
AI Agent 的技术框架——无论是规划、记忆、还是渐进式的上下文处理——已经近乎成熟。它知道如何去阅读,也知道如何去推理。
但决定这个 Agent 最终能解决多大问题的核心,不再是算法逻辑的优化,而是你能为它提供多厚实、多精准的数据集。个人认为:对于企业和开发者而言,与其盲目追逐参数更大的底层模型,不如沉下心来,将业务流中的核心数据梳理成 Agent 易于阅读和检索的格式。谁掌握了高质量的私域数据流,谁可能就掌握了 Agent 时代的胜负手。
最后
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
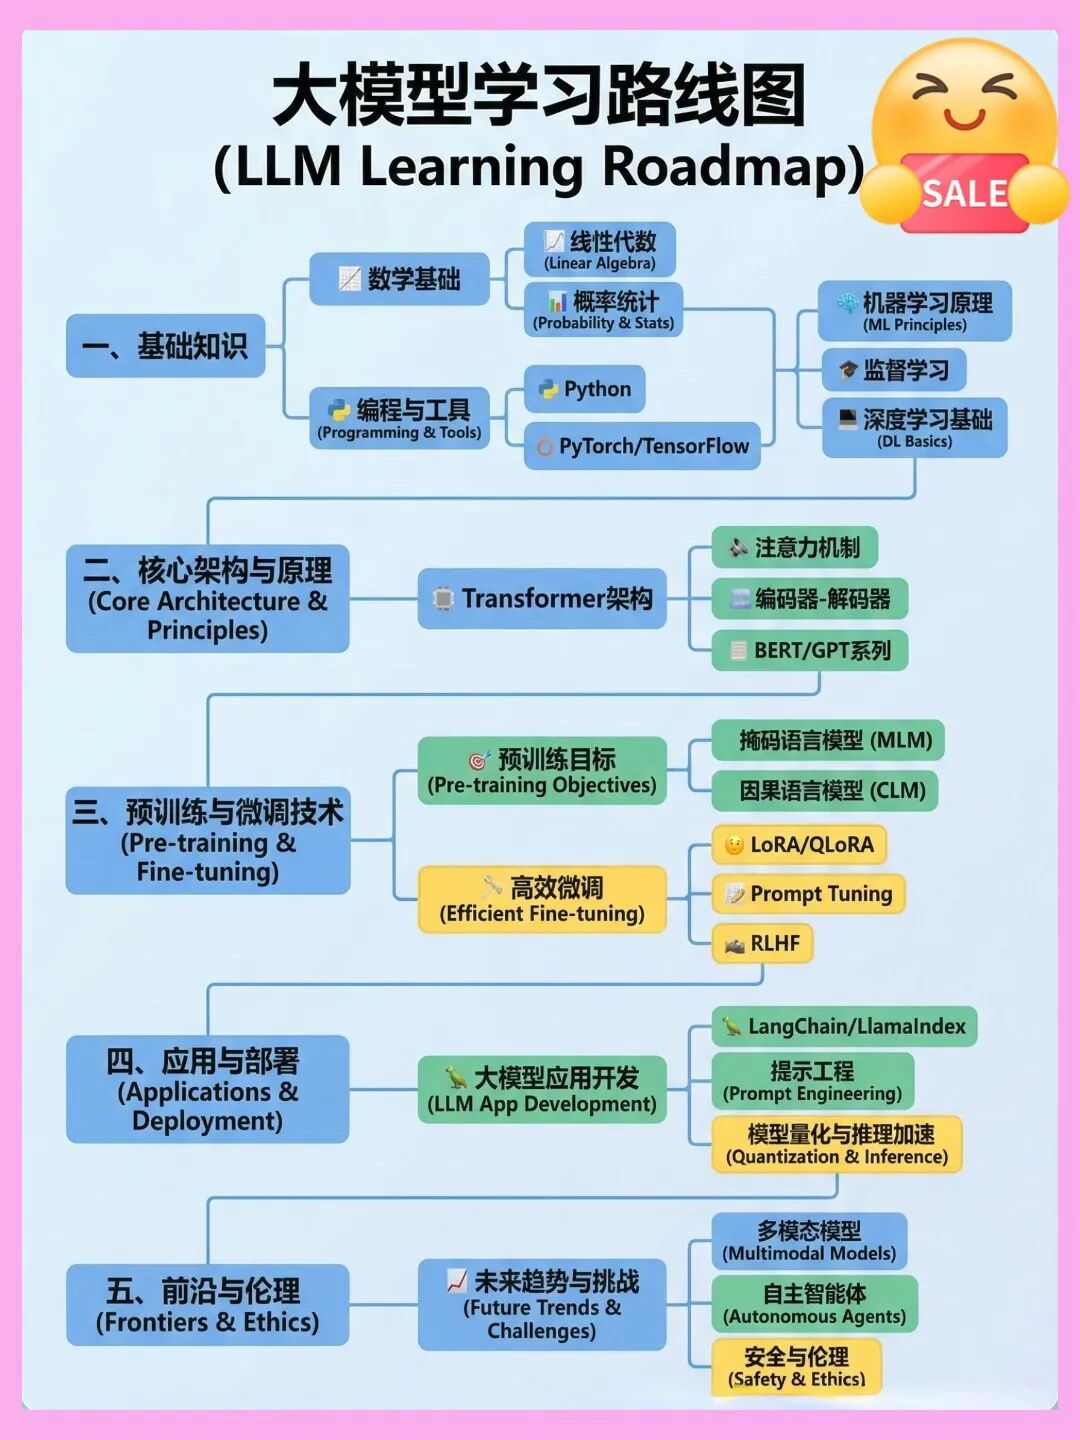
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取