


过去两年,大模型的迭代速度超出了所有人的预期。两年前的 ChatGPT 还分不清 1000 和 1062 谁更大,今年 2 月份的 DeepSeek 还会在 9.11 和 9.9 上犯迷糊。回想起来恍如隔世


如果说大语言模型(LLM)是AI时代的大脑,那么AI Agent就是给这个大脑装上了五官和四肢。
我们最关心的不仅是模型有多聪明,还有它能否在复杂的真实环境中闭环解决问题。今天我们将基于一篇深度综述,探讨如何构建一个自主的AI Agent。
01
AI Agent
AI Agent主要分为两个阶段:
-
Agent1.0时期,类似于工作流(Workflow)就像是一列火车。它的路线是设计者预先铺设好的(步骤A → 步骤B → 步骤C),非常适合处理重复性、高确定性的任务。它利用机器学习和 NLP 技术来做决策,能听懂人话,但缺乏主动性。但本质上还是“指令-响应”模式。
-
Agent2.0时期,Agentic AI则是一辆越野车。它没有预设的固定路线,只有一个明确的目的地。它依靠大模型来思考,通过环境反馈导航,遇到路障会绕路,走错了会倒车,甚至发现路不通时会自己开辟新路。它能动态生成策略,处理不可预测的挑战。主流代表应用就是曾经爆火的"Manus"。
一个成熟的AI Agent架构必须包含四个核心组件:

-
Perception(感知系统) —— 看懂世界
-
Reasoning(推理系统 ) —— 想清楚怎么做
-
Memory(记忆系统) —— 不断学习,不再忘性大
-
Action(执行系统) —— 真实动手,完成任务
02
感知系统
感知是AI Agent与世界交互的第一步。对于纯文本任务,LLM本身的处理能力已经足够。但在涉及GUI(图形用户界面)或物理世界的任务中,挑战主要在于“多模态对齐”。

现在的MM-LLM(多模态大模型)通过Vision Transformer(视觉编码器)和输入投影层(把视觉变成语言 token)大模型主体让 AI 具备视觉能力。
虽然能看懂图片,但它们往往缺乏一种“操作性知识”。比如,你给AI Agent一张网页截图,让它点击“提交”按钮。模型可能知道按钮在图里,但无法输出精确的 (x, y) 坐标,导致“看得见,摸不着”。

VCoder通过分割图、深度图增强 AI 的“空间理解”
为了解决这个问题,感知系统引入更精细的技术:
-
Set-of-Mark (SoM) 提示法:这就好比给近视眼戴上了眼镜。在把截图喂给模型之前,先用计算机视觉算法在所有可交互的 UI 元素上打上带编号的框。AI Agent 不再需要凭空猜测坐标,它只需要输出“点击编号 25 的盒子”。这极大提升了点击的准确率。
-
双重感知机制 (Dual Perception):除了看截图,AI Agent 还应结合 Accessibility Tree(辅助功能树) 或 HTML 源码。
图像提供视觉上下文(布局、颜色)。
代码/树结构提供精确数据(元素类型、层级、状态如 disabled)。
这种结合让AI Agent 能像自动化脚本一样精准,又像人类一样理解界面语义。
03
推理系统
如果感知是输入,推理就是处理。这是AI Agent的大脑,负责把模糊的目标拆解为可执行的步骤。
目前主流的思维链(CoT)和思维树(ToT)大家可能已经很熟悉了。但在构建复杂AI Agent时,DPPM架构也是很好的方式。

面对一个复杂任务,(如“策划一次公司年会”),单线程的思考容易顾此失彼。DPPM 的做法是:
Decompose(分解): 将大任务拆解为场地预定、餐饮安排、流程设计等子任务。
Plan in Parallel(并行规划): 多个Agent实例同时为这些子任务出方案。
Merge(合并): 汇总所有方案,检查冲突并形成总计划。
更重要的是“反思(Reflection)”机制。
很多AI Agent之所以“傻”,是因为它们是一条道走到黑。一个优秀的系统必须包含Self-Correction(自我修正)。当执行结果不符合预期时,它需要能像人类一样停下来思考“我是步骤错了,还是工具用错了?”甚至在行动前,可以引入“批评家”角色,进行前瞻性的反思,预判可能出现的错误。
04
记忆系统
LLM的上下文窗口(Context Window)再长也是有限的。要让AI Agent成为长期的合作伙伴,必须构建完善的记忆系统。
我们通常把记忆分为短期和长期。短期记忆依赖上下文窗口,而长期记忆则需要依赖外部存储。除了大家熟知的 RAG(检索增强生成) 用于存储文档知识外,还有一种常被忽视的记忆类型:经验记忆。
为什么它总是在同一个坑里跌倒?因为AI Agent会记不住之前的教训。在设计Memory模块时,不仅要存储成功的案例,更要结构化地存储“失败的轨迹”。当AI Agent下次遇到类似任务时,它应该能检索到:“上次我尝试用方法A失败了,这次我应该尝试方法B。”
此外Agent Workflow Memory 也是一个值得关注的方向。它能从历史操作中提炼出通用的内容,让AI Agent越用越顺手,形成类似人类“肌肉记忆”的高效反应。
05
执行系统
无论规划多完美,无法落地都是空谈。能不能执行任务是 Chatbot 和 AI Agent 的根本分界线。
目前最强大的执行方式之一是代码生成。相比于预定义的工具调用(Tool Use),让AI Agent自己写Python脚本来解决问题具有极高的灵活性。比如在数据分析场景下,预定义的工具很难覆盖所有需求,但一段动态生成的Pandas代码几乎可以处理任何数据清洗任务。
工具调用(Function Calling / API)是目前最通用、最成熟的执行方式。通过定义好的接口,它可以像程序员一样调用 Python 库、操作数据库、读写文件、发送邮件,甚至调用外部模型来辅助决策。这种方式的输入输出通常是结构化的(如JSON),因此稳定性极高是构建企业级Agent的基石。
多模态行动(GUI )是实现“通用智能体”的必经之路。让AI像人一样,直接操作任意软件界面。最近大热的豆包手机助手,采用了GUI的形式。
但在执行层,我们面临的最大挑战是安全性与幻觉。AI Agent可能会“一本正经”地生成一段危险的代码,或者调用错误的API。因此,在执行系统中必须引入Sandbox(沙箱)环境和Guardrails(护栏机制)。在代码真正运行前,通过静态分析或人工介入(Human-in-the-loop)进行最后一道把关。
如何抢占先机,拥抱 大模型?
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
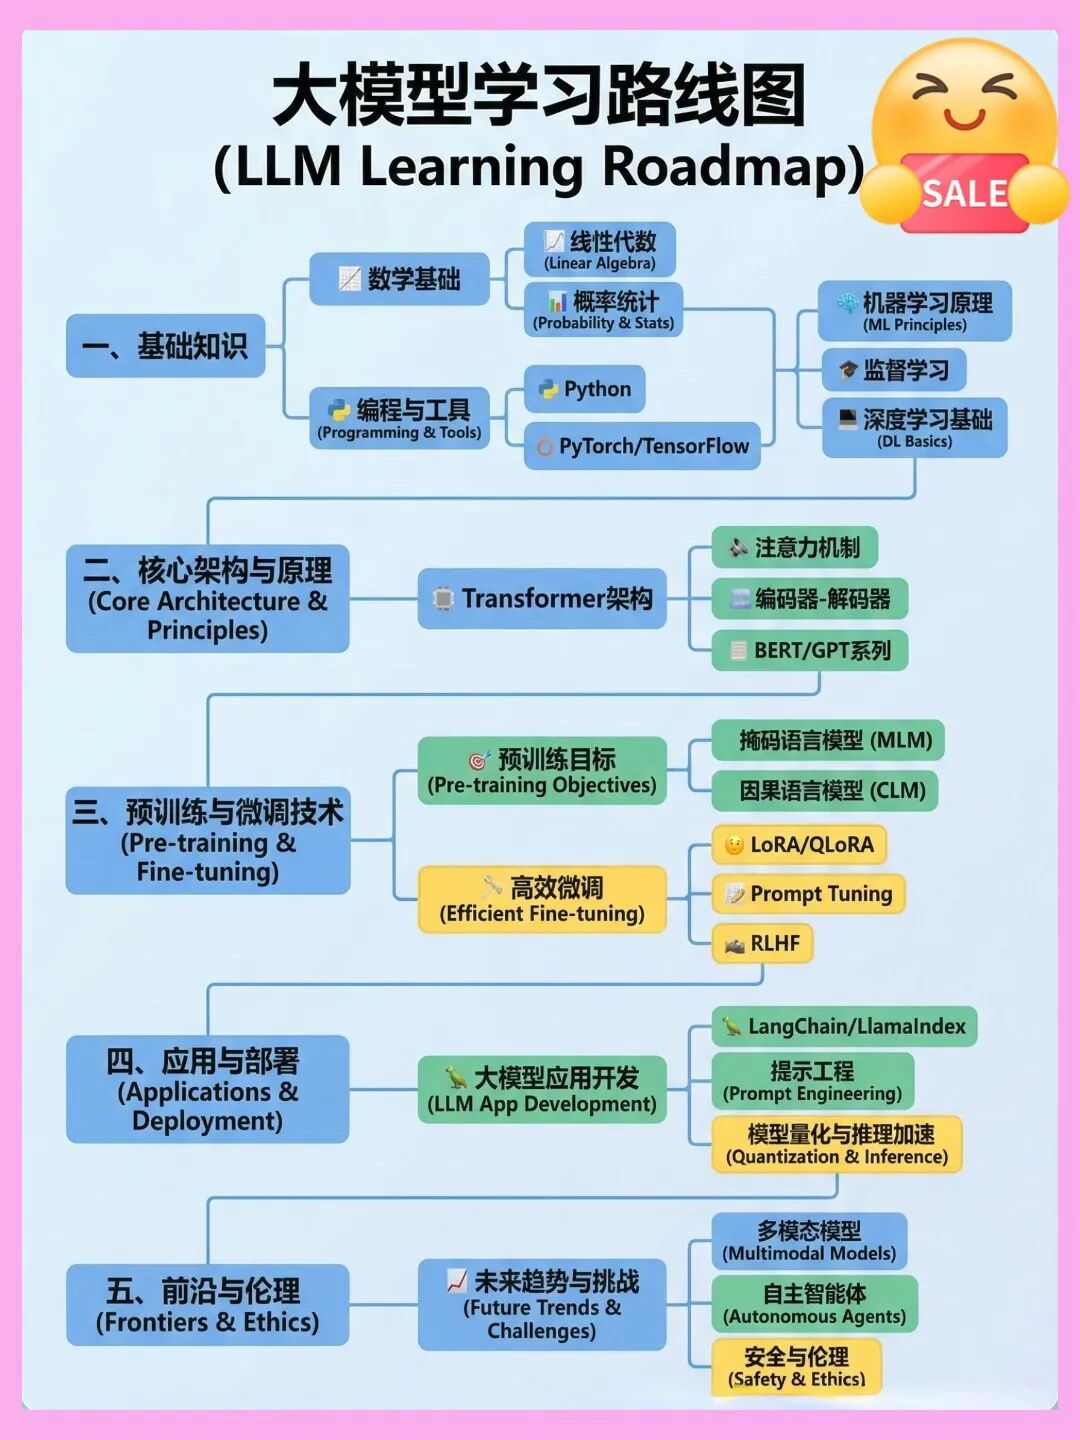
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取