不学算法也能看懂人工智能大模型基础知识!!!

火山引擎大模型语音合成双向流式API实战:Python实现与优化指南 本文详细介绍了如何利用火山引擎大模型语音合成双向流式API,通过Python实现低延迟、实时的语音合成应用。文章从核心协议解析入手,提供了完整的Python客户端实现代码,并分享了连接复用、错误重试、与LLM流式输出集成等实战优化技巧,帮助开发者快速构建智能客服、实时语音助手等AI应用。 阅读详情

过去几年里,人工智能领域出现了一批引人瞩目的“大模型”,例如可以对话问答的 ChatGPT。这些大模型凭借仿佛“能听会说、能写会算”的本领,引发了广泛关注和讨论。那么,大模型本质上在做什么呢?简单来说,大模型就是一个超大规模的人工神经网络,通过学习海量数据来预测最可能出现的下一段内容。也就是说,当你向它提问时,它会根据已经见过的知识和模式,计算出一个最有可能的回答。值得注意的是,它并不像人类一样真正“思考”,而更像是在基于统计模式进行回答。

#01.神经网络的启发来源:

模拟人脑的感知机

人脑存在两个系统,“快系统”与“慢系统”:

“慢系统”是我们能够有意识觉察的思维过程,依靠逻辑推理与分析;

“快系统”则是无意识地运作,以惊人的速度处理信息,能够瞬间形成直觉判断。

大模型的核心原理源自对人脑的启发。大脑拥有约1000 亿 个神经元并行工作,这赋予了人类惊人的快速感知能力。
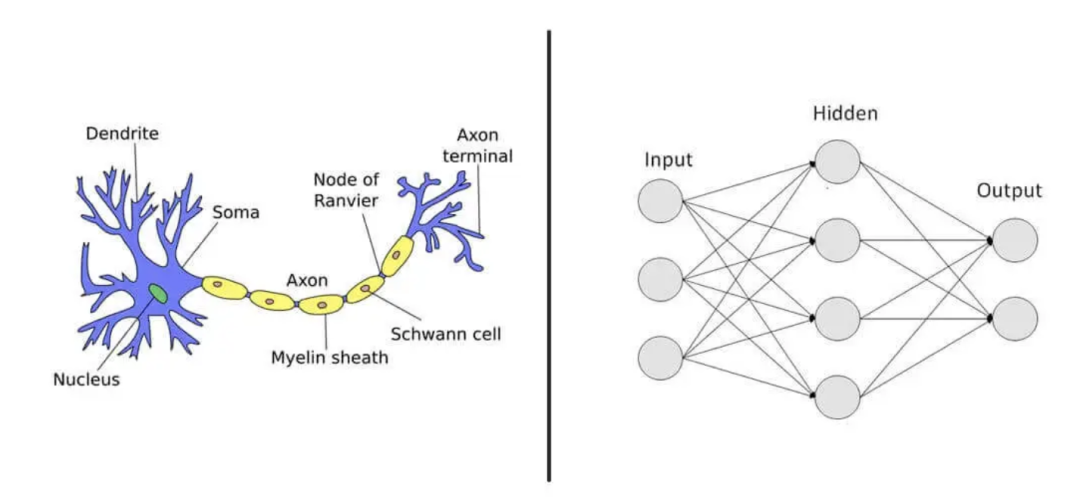
受到大脑启发,计算机科学家在上世纪中叶提出了人工神经网络的概念,并设计出感知机(Perceptron) 模型来模拟生物神经元的工作方式。生物神经元会从其他神经元接收大量信号,将所有输入累加,若超过某个“激活阈值”,就会触发输出信号(类似自动门感应到足够压力才打开)。
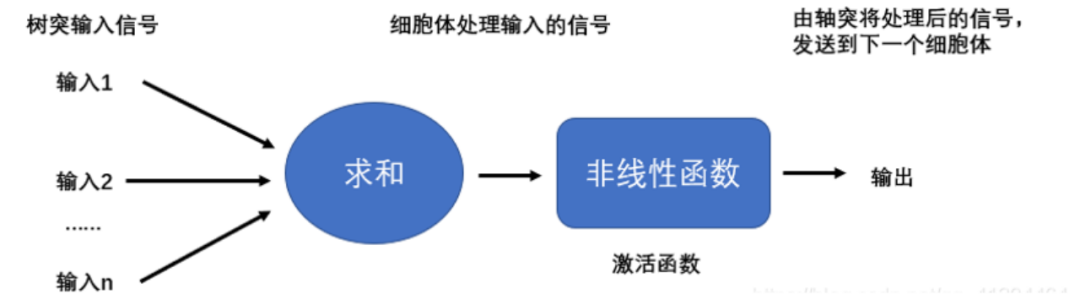
感知机的阈值可人为设置,也可以由感知机通过自身学习获得。
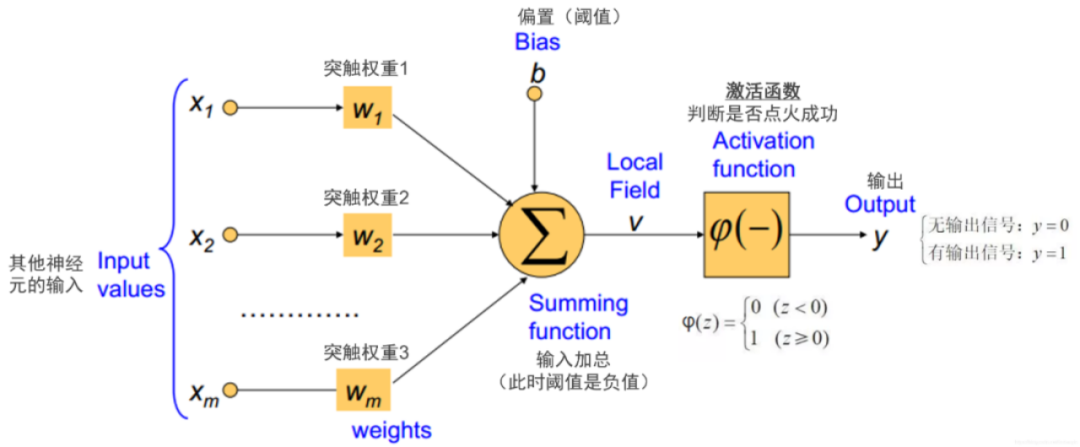
通过大量训练数据反复调节权重和偏置,感知机可以不断提高判断的准确性。这种训练过程本质上是一个数学优化:给定一批已知输入及其期望输出,自动找到一组最优参数使模型尽可能给出正确结果。感知机是最简单的神经网络,而大模型则是由成千上万个此类单元层层连接构成的“巨无霸”网络,参数规模提升了无数倍。感知机与大模型的关系类似于第一台计算机与现代超级计算机的关系——前者是后者的理论基础和原始雏形。
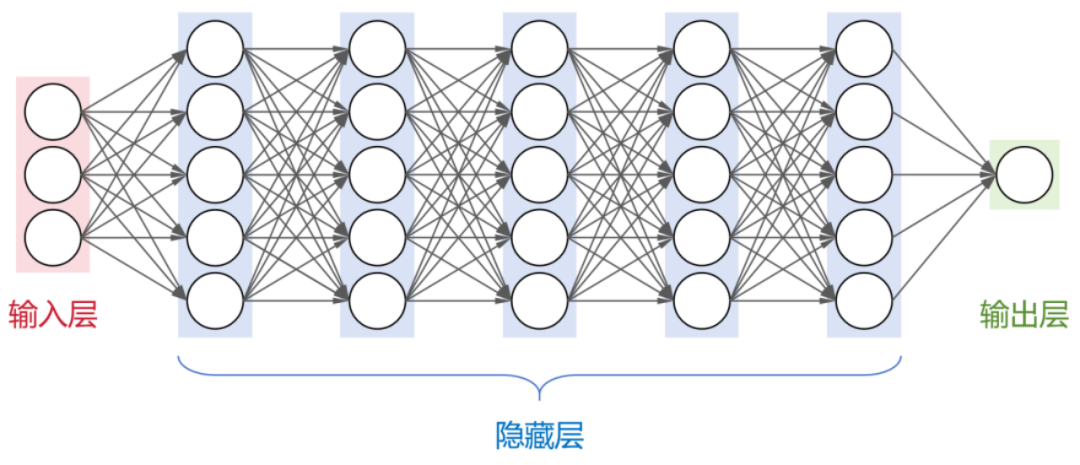
如今的大模型拥有数百亿甚至上千亿的参数。例如,GPT-3 就有约 1750 亿 参数。庞大的参数量让模型能够拟合极其复杂的模式,从而胜任各种任务。
#02.大模型的核心机制:

参数如何赋能

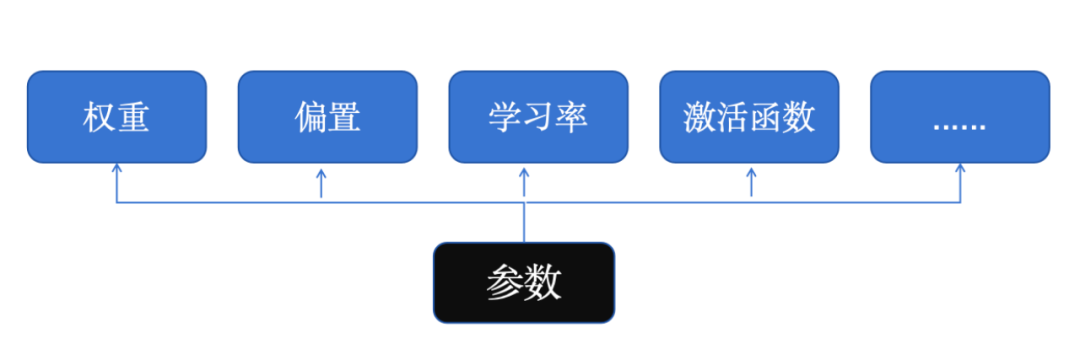
了解了神经元和感知机,我们再来看看支撑大模型运转的核心机制。简单来说,就是前面提到的参数(包括权重和偏置)在幕后发挥作用。正是这些海量参数的组合,让大模型具备了强大的学习和表示能力。

权重(Weights):决定各输入特征对最终结果的影响力,是模型训练中重点优化的对象。

偏置(Biases):可以看作模型的初始激活阈值,它调节模型对输入累积信号的“敏感度”,让模型在拟合数据时更加灵活、高效。

有了权重和偏置,大模型就像搭建起了无数互联的小单元共同工作的庞大网络。每个神经元单元各司其职,把输入逐层转换为更抽象的特征表示,最终得到输出结果。

例如:想象在期末评分时,一位老师坐在办公桌前翻阅学生的考试成绩单、作业记录和课堂表现评估,准备计算每个人的总成绩。她会先给每个学生一个基础分(例如50分),作为所有人都具备的“起评分”,体现了老师的打分风格——无论学生表现如何都先得到这一固定分数。接着,老师根据每个学生在不同方面的表现赋予不同比重:她认为期末考试最重要,可能占总成绩的50%(权重0.5),平时作业占30%(权重0.3),课堂表现占20%(权重0.2),这些权重反映了各项成绩在总评分中的相对重要性。就好比在神经网络中,“权重”决定每个输入对输出结果的影响程度。“偏置”则相当于这位老师额外给予的50分起始分数,它提供了一个整体上的分值偏移,让即便各项成绩偏低的学生也能获得一定的基础得分。最终,她将各项成绩按照上述权重相加,再加上之前的基础分,得到学生的总成绩。例如,一个学生的总评计算公式可能是:总评= 0.5×考试成绩 + 0.3×作业成绩 + 0.2×课堂表现 + 50。这里面的0.5、0.3、0.2就是不同评分项目的“权重”,而额外加上的50分就是“偏置”,相当于每位学生都带有的起始分数。这个例子形象地对应了神经元的计算公式y = w1x1 + w2x2 + … + b:其中w(权重)用于调节各输入因素的相对重要性,b(偏置)提供一个固定的加分或减9分的基准,将整体分数向上或向下平移,影响神经元激活的基础线

#03.涌现能力与泛化能力:

AI“开窍”的关键

当模型的规模(参数数量)和训练数据不断扩大时,往往会出现一些出乎意料的新能力。这就是所谓的大模型“涌现”现象。涌现能力指模型在训练中自动学会了更高层次的规律,表现出训练前无法预知的复杂技能。通俗来讲,大模型不再只是机械地记忆和重复训练集里的知识点,而是对知识有了一定程度的“理解”,能够融会贯通、触类旁通,仿佛突然间“开窍”了一样。比如,一些小模型只能机械地套用规则回答问题,而更大的模型却能在没有明确教导下学会常识推理等复杂技能——这些本领都是从海量数据中涌现出来的。

与涌现能力密切相关的是泛化能力。所谓泛化(Generalisation),可以理解为模型将从过去学到的知识迁移应用到新问题的能力。我们希望AI 不仅记住训练过的例子,还能举一反三,在陌生场景下给出合理的回应。大模型之所以备受期待,很大程度上就是因为其泛化能力强:即使遇到从未见过的问题,也能根据已有知识做出推理判断。这就像博学多识的人即使没接触过某个新的领域,也能基于已有知识框架得出合理推断。泛化能力是 AI “聪明”的关键指标,也是区分“死记硬背的书呆子”和“触类旁通的智者”的重要标准。

#04.从记忆到顿悟:

“Grokking”现象与过拟合的故事

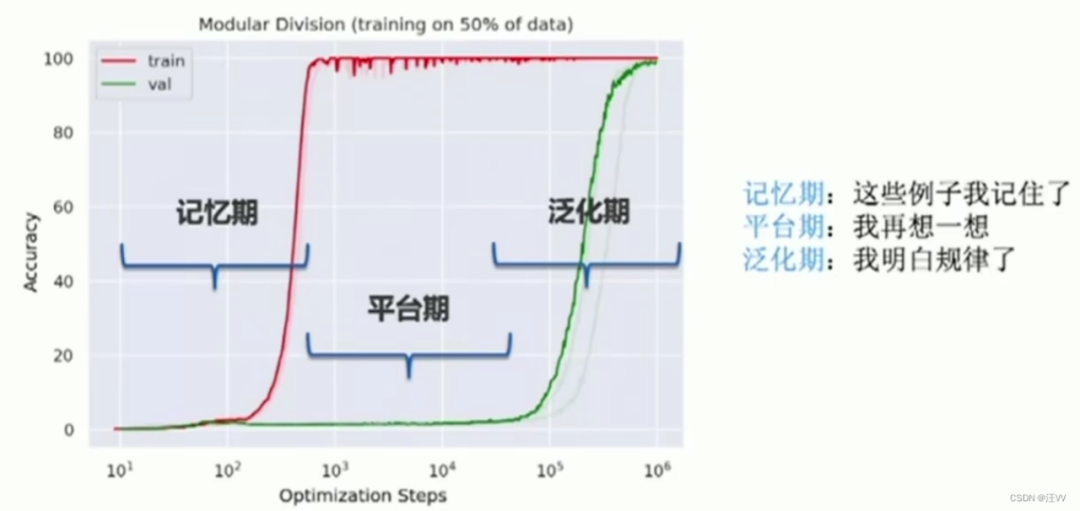
人们发现模型在训练中有时会经历先记忆后顿悟的现象:一开始模型拼命记忆训练数据,对稍有变化的新数据毫无头绪;而经过足够迭代后,模型的测试表现会突然跳跃式提升,显示它终于领悟了一般规律。这种延迟泛化的现象被称为Grokking。
类似的现象也能在大型语言模型上观察到。在经典逻辑谜题“蓝眼睛岛”的测试中,GPT-4 展现出矛盾的能力:原题它能 100% 正确解答(显然记住了标准答案),但当题目稍作改动时却频频出错,暴露出 过拟合 倾向。即使将故事中的“蓝眼睛”主角改成类似情形的“绿眼睛”,模型仍常被原有记忆干扰,难以灵活应对细微变化。值得庆幸的是,当谜题用完全不同的表述方式重述后,GPT-4 给出了正确推理。这说明模型其实掌握了推理方法,而不仅是死记硬背答案。由此可见,大模型有时会陷于记忆套路,但在脱离既有记忆时又能发挥出泛化推理能力。理想的 AI 应该两者兼备:既拥有庞大的知识储备,又能融会贯通地运用知识。

#05.模型越大越好吗?

能力与资源的权衡

面对大模型在诸多领域的惊艳表现,一个直观的问题是:参数越多、模型越大,是否就一定更厉害?从能力上看,的确随着模型参数规模增加,性能往往水涨船高。更大的模型拥有更多“记忆容量”和“表达能力”去拟合复杂模式,因此通常在语言理解、图像识别等任务上表现更好。这也是为什么从最初的几层小网络一路发展到上百层、千亿参数的大模型,AI 效果出现了质的飞跃。

然而,“更大”也带来了巨大的代价和挑战。首先是资源消耗 急剧增长:训练一个千亿级参数模型需要海量计算资源,往往要使用成百上千块GPU 服务器连续运行数周甚至数月,背后是巨大的电力和硬件投入。同样地,部署和使用大模型也需要强大的算力支持,一次生成长文本的推理可能就耗费不少计算资源。因此,大模型的成本和能耗远高于小模型,不可能无限制地一味做大。

其次是模型变大的风险。参数暴增后,模型可能过度记忆训练数据中的细枝末节噪音,出现我们前面提到的过拟合 问题——变成只会死记硬背、不善融会贯通的“书呆子”。这样一来,模型在训练集上表现完美,但遇到新问题反而退步。所以,让模型变“大脑袋”容易,但要让它变“聪明”还得精心平衡:既发挥大规模模型带来的优势,又通过更好的正则化、更多元的训练数据等手段降低过拟合风险。

因此,在很多场景下盲目追求最大的模型并非最佳方案。业界也在探索更高效的模型架构和训练方法,争取在能力与成本之间取得更好的平衡。未来的AI 发展很可能不会只是简单地“堆参数”,而会更加注重效率与效果的兼顾。

#06.提示词工程入门:

解锁大模型的使用技巧

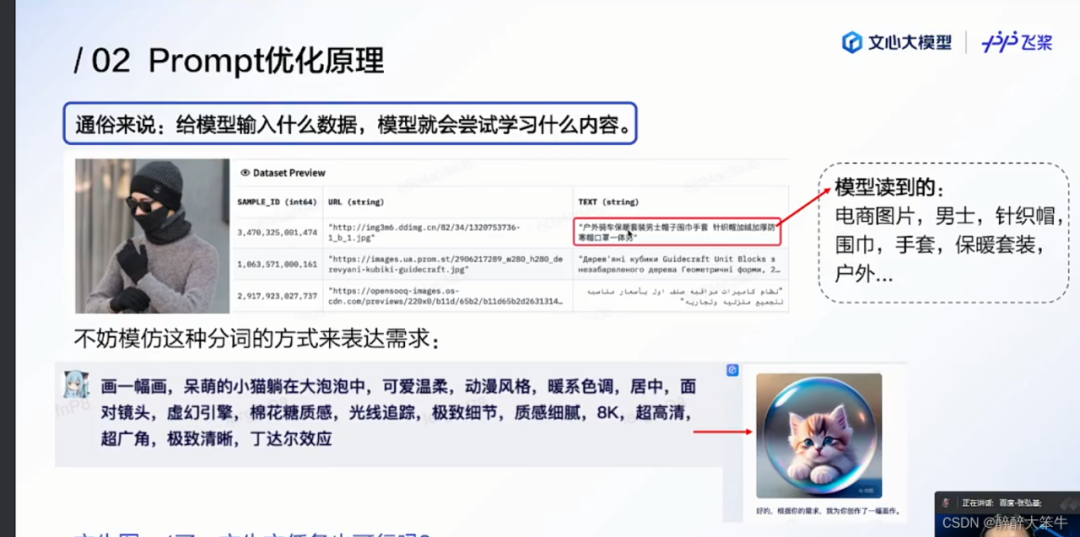
即便有了强大的大模型,如何用好它也是一门学问。所谓提示词工程(Prompt Engineering),指的就是设计和优化与模型交互的输入,以引导模型产出更理想的结果。在与聊天类模型打交道时,我们经常听到“零-shot”、“单-shot”、“少-shot” 等术语。“零-shot”是指不提供任何示例,直接提问;“单-shot”是在提问前先给出一个示例;“少-shot”则提供几个示范让模型参考。一般来说,适当地提供示例有助于模型理解我们想要它怎样回答。
此外,如果可以直接调用模型的底层接口,还可以调整一些生成参数来影响输出结果。常用的几个参数也可以看作控制大模型输出风格的“旋钮”。例如,Max Tokens 参数设定输出内容的长度上限,太短会截断回答,太长则浪费资源并可能导致模型啰嗦;Temperature(温度) 控制输出的随机性,低温度让回答更保守稳定,高温度则使回答更加活泼多样但出错风险也增大;Top-K 和Top-P 则限定生成时考虑的候选词范围,降低这两个值会让输出更严谨集中,调高则增加内容的多样性和新奇度。不同参数组合会带来不同效果,没有万能的固定设置,只能针对具体需求不断调试。一般来说,想要答案稳定就降低温度并收紧Top-K/P 范围,追求创意发散就提高温度并放宽Top-K/P 限制。
#07.总结与展望

总之,大模型本质上是由无数参数连接而成的巨型神经网络,通过学习海量数据来进行预测。规模的膨胀带来了非凡能力(如复杂技能的涌现和强大的泛化能力),但也伴随高昂的资源代价和过拟合等风险,因此在追求更强AI 时必须平衡好 能力 与效率。

如何学习AGI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

SIC知识(8)--碳化硅的制备难点 6. 器件制造难点:碳化硅器件制造过程中的掺杂步骤需要在高温下完成,且需要采用高温离子注入的方式,这与传统硅基器件的扩散工艺不同。这些步骤需要精密的设备和严格的工艺控制,以确保器件的结构和功能。综上所述,碳化硅的制备难点相较于传统硅基器件主要在于更高的制备温度、更慢的生长速度、晶型控制的复杂性、后加工的难度、外延工艺的低效率以及器件制造的特殊要求和较高的成本。- **数据管理**:需要有效的数据管理系统来跟踪和记录生产过程中的每一个步骤,包括原料的批次、生长条件、加工参数等,以确保产品质量的可追溯性。 阅读详情

相关推荐

基于Quartus II软件的FPGA综合实验——多功能数字钟

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录前言一、设计要求二、设计原理三、设计过程1.数码管扫描模块2.计时模块3.闹钟模块4.闹钟响铃模块5.数码管显示模块6.整点报时功能7.模式选择模块(计时器主控电路)四、实验中遇到的困难及解决方案五、总结 前言 FPGA综合实验——多功能数字钟 基于Quartus II软件 一、设计要求 设计一个能进行时、分、秒计时的十二小时制或二十四小时制的数字钟,并具有定时与闹钟功能,能在设定的时间发出闹铃音,能非常方便地对小时、分钟和秒进.

qq_53022342的博客 2万+

计算机视觉:超大规模视觉通用感知模型

计算机视觉:超大规模视觉通用感知模型

博学而笃志,切问而近思。 2767

QGIS实用功能:加载天地图与下载指定区域遥感影像

本文聚焦 QGIS 软件实用功能,详细介绍在 QGIS 中加载天地图及其他常用底图(如 Google Maps、Bing Maps)的完整流程,涵盖天地图插件安装、密钥获取与配置、插件拓展使用等操作。同时,以 上海市瑞金二路街道为例,分步讲解下载指定区域遥感影像的方法,包括图层选择、坐标系设置、分辨率调整等关键参数配置。此外,还介绍了影像精准裁剪技巧,为 GIS 数据获取与处理提供实用指导,助力用户高效使用 QGIS 开展地理信息相关工作。

weixin_43679228的博客 7449

大模型如何像人类一样感知与行动?揭秘最近爆火的大模型Agent智能体

大模型 Agent,作为一种人工智能体,是具备环境感知能力、自主理解、决策制定及执行行动能力的智能实体。简而言之,它是构建于大模型之上的计算机程序,能够模拟独立思考过程,灵活调用各类工具,逐步达成预设目标的智能存在。Agent 是 AI 大模型应用的主要新形态,在技术架构范式也发生了很大的变化,从面向过程的架构变成了面向目标架构。

m0_48891301的博客 1507

SRAM故障排查实战:如何用Nano Prober定位6T存储单元的异常点

本文详细介绍了在SRAM故障排查中,如何运用Nano Prober(纳米探针)技术精准定位6T存储单元的内部异常。面对传统方法难以发现的电性参数漂移(如晶体管阈值电压偏移)或微小物理缺陷,Nano Prober能直接对单个6T单元内的晶体管进行I-V特性测量,结合失效模式分析,有效解决读写错误等疑难问题,是芯片失效分析的关键工具。

v5w6x的博客 668

Python实战:ERA5风场数据区域提取与风向合成可视化全流程解析

本文详细解析了使用Python处理ERA5风场数据的完整流程,包括NC文件读取、特定区域数据提取、u/v分量合成风向风速的计算,以及利用Matplotlib进行风场时空演变可视化。内容涵盖从环境搭建、数据获取到高级绘图与性能优化的实战经验,为气象数据分析、风能评估及气候研究提供了一套清晰、可操作的技术指南。

swift5iosmith的博客 305

想了解大模型但不会算法?这篇就是为你准备的入门课!

大模型就是一个超大规模的人工神经网络,通过学习海量数据来预测最可能出现的下一段内容。也就是说,当你向它提问时,它会根据已经见过的知识和模式,计算出一个最有可能的回答。值得注意的是,它并不像人类一样真正“思考”,而更像是在基于统计模式进行回答

2401_85375186的博客 896

MRI脑影像分析从哲学到技术:一文搞懂VBM预处理基本原理(全网最详细解析)

   分析大脑解剖学差异最常用方法之一是基于体素的形态学方法(voxel-based morphometry, VBM)。 VBM的基本思想是测量大脑组织,尤其是灰质的局部浓度的差异。在大脑的每个体素处进行操作,然后在两个或多个实验组之间进行统计比较,从而在受调查的组之间建立特定大脑区域中脑组织浓度的统计学显着差异。 VBM分析基于(高分辨率)MRI脑部扫描,涉及大量处理步骤,主要是空间归一化,分割,平滑和统计分析,最终结果是统计图,显示了各组之间组织类型明显不同的区域[^1]。 参考 [^1] ..

意疏的学习笔记 3万+

【收藏必看】大模型智能体的四大核心模块详解:从感知到行动的全解析

本文详细解析了大模型驱动的智能体的四大核心模块:感知模块负责接收和理解外界信息;规划模块制定行动方案;记忆模块存储短期和长期经验;工具使用模块实现与外部世界的互动。这四大模块协同工作,使智能体能够从理解世界到与世界互动,为开发者构建更强大的人工智能系统提供理论基础。

2401_85325726的博客 2040

camera QXXX架构

This article introduces the QCX camera architecture for Qualcomm’s latest automotive chips including SA8650. It elaborates the layered camera stack under QNX, HGY and HQX systems, covering client applications, stream manager, CamX components and hardware d

qq_39257814的博客 4547

【数据集】全球湿度数据集总结

【数据集】全球湿度数据集总结

WW、forever的博客 1662

多模态大模型下的具身智能!全面汇总:感知、交互、推理和仿真

具身人工智能(Embodied AI)对于实现通用人工智能(AGI)至关重要,并且是连接网络空间和物理世界的各种应用的基础。最近,由于多模态大模型(MLMs)和世界模型(WMs)在感知、交互和推理能力方面表现突出,它们受到了广泛关注,成为了具身智能体大脑的潜在架构。然而,在MLMs时代,尚没有针对具身人工智能的全面综述。在本综述中,我们对具身人工智能的最新进展进行了全面探讨。我们的分析首先通过具身机器人和模拟器的代表性前沿工作,全面了解研究重点和局限性。

m0_59235699的博客 2万+

【C语言】一文带你拿捏分支和循环语句(一万字详细讲解)

if/switch语句、while/fo/do...while循环语句、goto语句详解

StackFrame 1235

【AI大模型】不学算法也能看懂人工智能大模型基础知识!!!

过去几年里,人工智能领域出现了一批引人瞩目的“大模型”,例如可以对话问答的 ChatGPT。这些大模型凭借仿佛“能听会说、能写会算”的本领,引发了广泛关注和讨论。那么,大模型本质上在做什么呢?简单来说,大模型就是一个超大规模的人工神经网络,通过学习海量数据来预测最可能出现的下一段内容。 也就是说,当你向它提问时,它会根据已经见过的知识和模式,计算出一个最有可能的回答。 值得注意的是,它并不像人类一样真正“思考”,而更像是在基于统计模式进行回答。

2401_85327249的博客 806

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

大模型基础知识 | 不学算法也能看懂!零基础小白建议收藏!!

脑存在两个系统,“快系统”与“慢系统”: “慢系统”是我们能够有意识觉察的思维过程,依靠逻辑推理与分析; “快系统”则是无意识地运作,以惊人的速度处理信息,能够瞬间形成直觉判断。 人类具备快速且无意识的感知能力,是因为人类的大脑有 1000 亿个神经元。神经生物学家们已对斑胸草雀、果蝇的大脑进行3D重建,即使只有一立方毫米的脑组织,也可以产生超过 1000TB 的数据。模仿人脑中神经元的工作方式,计算机科学家构建了感知机。

Gaga246的博客 842

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

不学AI大模型你就要落后了

在科技日新月异的今天,人工智能(AI)已经不再是遥不可及的未来科技,而是逐渐渗透到我们生活的每一个角落。特别是AI大模型的出现,不仅引领了新一轮的技术革新,更是成为推动社会进步的重要力量。在这个背景下,不学AI大模型,你就可能会落后于这个时代。AI大模型,如GPT-4、BERT等,是人工智能领域的重要突破。它们通过深度学习技术,能够处理海量的数据,并从中提取出有价值的信息。这些模型不仅在自然语言处理、图像识别等领域取得了显著成果,还在医疗、金融、教育等多个行业展现出巨大的应用潜力。

2401_84495725的博客 756

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

现身说法,AI小白的大模型学习路径,都快2025年了,你还不学大模型吗?

不得不说,是22年底chatGPT的发布让人工智能再次被得到广泛关注。chatGPT所有人都听过,最初我听到它只粗浅的知道它是一个对话工具,好像很厉害,对GPT的认知也以为只是一个简单的品牌代号,就跟AMG、BMW这种类似,没去想会有啥意思。但当后来认真了解了chatGPT每一个字母的详细释义之后,才发现原来人家取名并不是随便取的,在GPT命名的时候就已经告诉我们大模型的一些突出特点了。chatGPT:chat——会聊天的G——generative,生成式P——pre-trained,预训练。

2401_85375151的博客 1311

零门槛入门大模型:不学算法也能掌握人工智能核心概念

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

2401_85325726的博客 888

2025 神仙开源 AI 教程,还不学你真就落后了

大家好,如果说国内想要学习 AI 开发的教程, Datawhale 出品的课程不得不推荐大家了。置顶仓库都是关于 AI 学习的。

DEVELOPERAA的博客 978

高考志愿填报热潮中的冷思考|人工智能大模型专业,真的适合你的孩子吗?

高考志愿填报热潮中的冷思考|人工智能大模型专业,真的适合你的孩子吗?

2401_82469710的博客 1164

小白能看懂的AI大模型系列一引言

大模型一般是指参数了超过1B的模型,还有一些比较小的模型,比如bert模型,可能总共几百M,算是GPT3.5、qwen、DeepSeek之前的优秀模型了,大家刚开始玩的时候,可以先用bert模型试一试。

DEVELOPERAA的博客 541

AI大模型爆发,你还不学就晚了!抓住时代机遇,快速入门指南!

在一个阳光明媚的午后,小李坐在自己的工位上,眼前的代码如同繁星般繁多。他是一名资深的软件工程师,但在最近的技术浪潮中,他却感到了一丝不安。他的朋友圈里,不断有人分享关于AI大模型的最新成果,那些曾经遥不可及的科技前沿,如今似乎触手可及。就在上周,一家名为xAI的初创企业突然宣布获得了60亿美元的巨额融资,估值更是高达240亿美元。这家企业的背后,站着的是科技界的巨星——马斯克。他的投资眼光向来精准,而这次对xAI的青睐,无疑让AI大模型成为了市场瞩目的焦点。AI大模型投资。

m0_70486148的博客 818

AI 工程化实战:不学算法也能用好的 LLM 指南

本文全面介绍了大模型相关知识,包括大模型(LLM)、提示词工程(PE)、检索增强生成(RAG)、工具调用(Function Calling)、模型上下文协议(MCP) 等,适合零基础小白入门。

『一枫说码』的博客! 994

还不学大模型,连外包都卷不过了!JAVA的就业市场太难了!

2025全面进入大模型时代,一场颠覆性的生产力革命

大模型教程的博客 1170

AI开发的未来已来,不学就真的晚了!

开发AI智能应用,就下载InsCode AI IDE,一键接入DeepSeek-R1满血版大模型! 标题:AI开发的未来已来,不学就真的晚了! 引言 在当今科技飞速发展的时代,人工智能(AI)已经成为推动社会进步的重要力量。无论是企业还是个人开发者,都面临着一个不可忽视的事实:掌握AI技术不再是选择,而是生存的必要条件。本文将探讨如何通过智能化工具和大模型API快速上手AI开发,并以实际案例展示其...

TurquoiseSea98的博客 730

JAVA就业太难,连外包都卷不过?还不学大模型!

大模型正引发生产力革命:AI已生成40%代码(GitHub Copilot),重复开发工作被自动化取代。技术栈重构催生新岗位(如Prompt工程师、大模型训练师),掌握AI工具的程序员薪资高出40%-60%。职业危机显现——拒绝AI的中级工程师面临淘汰风险,而“AI+新人”组合效率更具优势。学习路径分为七大阶段:从系统设计、提示词工程到微调开发、多模态应用,涵盖电商、物流等场景实战。掌握大模型技术将提升全栈能力,实现跨行业突破。

2401_84495872的博客 495
上一篇: 9个DeepSeek隐藏技巧,让打工人效率翻倍
下一篇: 深入浅出AI大模型(LM/LLM)知识要点
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值