如何估算大模型训练所需算力?(非常详细)从零基础入门到精通,收藏这篇就够了

全网最全面详细的Cursor使用教程,一篇就够了,让开发变成聊天一样容易 阅读详情
AI摘要

文章聚焦大模型训练所需算力的估算,以GPT系列为例说明算力需求随模型迭代而增长,给出OpenAI经验公式并以LLaMA - 1模型为例计算训练时间。此外,还分享了2025最新大模型学习路线,涵盖四个阶段,同时提供经典PDF书籍、视频教程、项目实战和面试题等学习资源。

ChatGPT横空出世引发了“百模大战”,算力需求成为焦点, GPU卡一时洛阳纸贵。训练一个大模型,究竟需要多少张GPU卡呢?2023年初写了篇文章《训练GPT模型需要多少算力?》大致总结了一下,但没有提到推导过程,今天有空展开聊聊。

据估计,OpenAI训练GPT-4模型,很有可能应用了10000到20000张英伟达A100。按照马斯克的说法,GPT-5的训练可能需要3万到5万张H100,可见随着大模型的迭代发展,训练所需算力也呈爆发性增长。

早在2020年,OpenAI使用数千张V100卡训练GPT-3,花了1个月左右的时间才完成。Inflection公司基于超过3500张H100卡,在C4数据集下,仅用了不到11分钟就训练完 GPT-3模型。下图是不同参数量、数据量的训练时间。
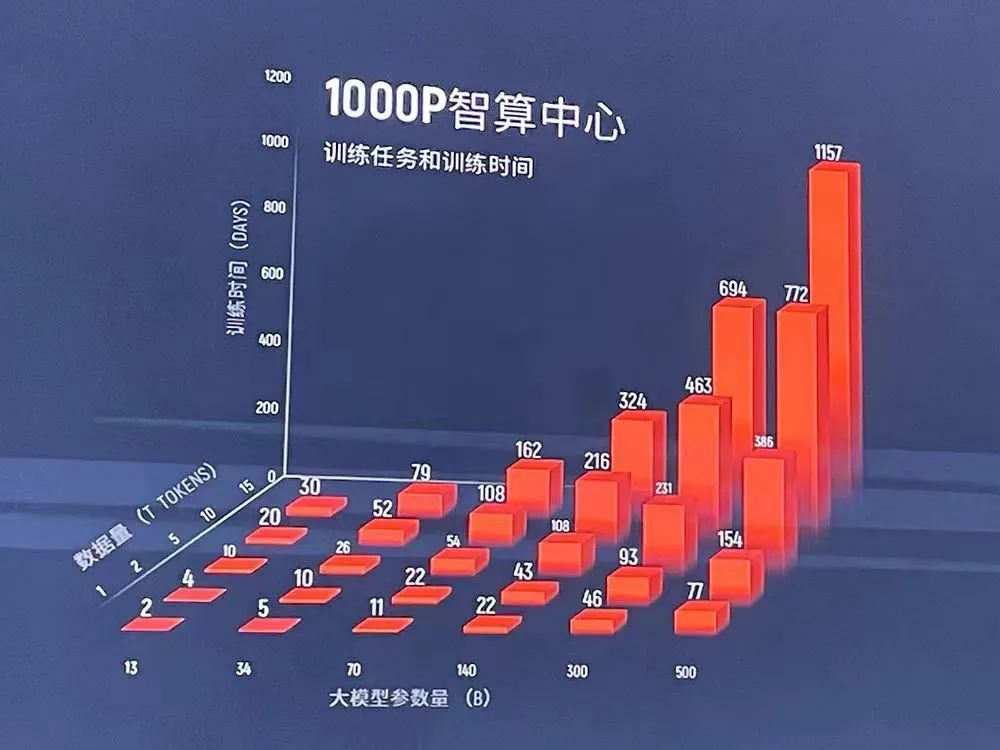
大模型训练需要的算力究竟是怎么计算出来的呢?OpenAI在Scaling Laws 论文中给我们提出了一个经验公式:C = rT ≈ 6*P*D

解释一下该公式:C是训练一个Transformer模型所需的算力,单位是FLOPS;

P是Transformer模型中参数的数量;

D是训练数据集的大小,也就是用多少tokens来训练;

r是训练集群中所有硬件总的算吞吐,单位是FLOPS,T是训练模型需要的时间,单位是秒。为什么系数是6?Scaling Laws论文对这个公式做了简单推导,在此不展开。

在计算所需算力的时候,我们刚才都是使用 FLOPS这个单位,即FLOP-seconds,其实使用 PFLOP-days更加直观。

以 Meta 年初开源的LLaMA-1模型为例。

假设参数65B,基于1.4T的tokens 数据集,使用了2048张A100 ,需要多长训练时间呢?

首先,计算训练该模型所需的算力:

C = rT ≈ 6*P*D

=6*65*109*1.4*1012

=546*10^21 FLOPS

然后,根据《A100白皮书》给出的BF16 Tensor Core的算力为312 TFLOPS,实际上算力单块A100的算力一般在130-180 TFLOPS之间,我们取中间值150,2048张卡的集群算力吞吐为:

r=2048*150*1012=300*1015 FLOPS,即300PFLOPS

最后,代入到上面提到的公式:C = rT,得出训练LLaMA-1模型所需时间为:

T=C/r=546*1021/(300*1015)

=1.82*10^6 seconds ≈ 21 days

这一计算结果和 LLaMA-1 在论文中得出的实际训练时间基本一致。
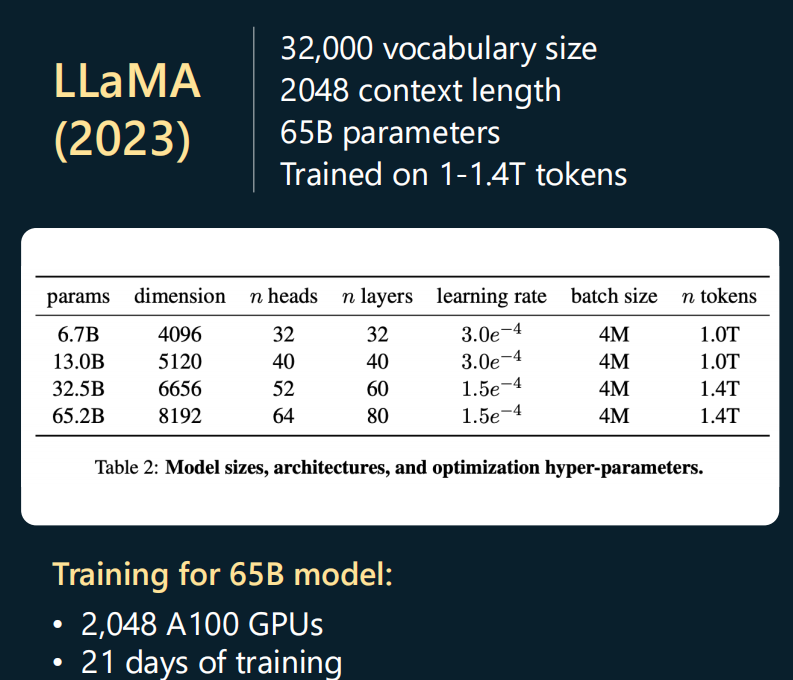
如果将A100换成H100,需要多长时间?

根据《H100白皮书》上给出BF16的性能参数是1979 TFLOPS(稀疏算力指标),实际稠密算力大约在1000 TFLOPS。对比A100,差不多有 3 倍的增长。

简单测算可得出结论:使用相同数量的H100卡训练LLaMA-1模型,训练时间可从21天减少到10天以内。

下面给大家分享一份2025最新版的大模型学习路线,帮助新人小白更系统、更快速的学习大模型!
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

模型算力需求估算 (Billion Parameters,简称B)和训练/推理的计算任务复杂度,结合硬件计算能力(例如每秒浮点运算次数,FLOPS)来估算。以下是详细的方法和公式说明,以及实际的计算示例。算力需求的估算依赖于参数量、模型架构及硬件性能,结合训练/推理场景的特定要求来计算。通过上述公式和示例,我们可以定量分析不同任务的算力需求,并合理配置硬件资源以优化运行效率。结论:推理任务相对较轻,单台H100可以在30秒内完成此任务。推理算力需求一般远低于训练,因为只需要执行前向传播。,可以将训练时间缩短到约。 阅读详情

相关推荐

AI大模型训练相关参数如何估算?大模型参数量计算有这一篇就够了

进行大模型训练时,每输入一个token,整个模型中的每个参数上就要进行6~8次的浮点数运算,按本文前面的计算,如果以300B tokens的数据集来训练一个175B的GPT3模型,那么GPT3训练的总计算量达3.1428 x 10²³Flops,而A100单卡算力只有312TFlops,不考虑单卡在集群中的性能折损,至少需要32年才能完成。由前面AI训练侧算力供需关系模型,可以看出,在模型参数、预训练数据量一定的情况下,对于给定型号的GPU,训练时长越短,所需的GPU数量就越多,建设成本也就越高;

大模型工程师老蓝的博客 2610

全网最全面详细的Cursor使用教程,让开发变成聊天一样容易

介绍超好用的AI辅助变成工具,让开发变成聊天,解放双手,释放生产力。

m0_68116052的博客 89万+

Cursor使用教程

全面详细的cursor使用教程!

CamilleZJ的博客 5万+

如何估算大模型训练所需算力?(非常详细)从零基础入门到精通,收藏这篇就够了

ChatGPT横空出世引发了“百模大战”,算力需求成为焦点, GPU卡一时洛阳纸贵。训练一个大模型,究竟需要多少张GPU卡呢?2023年初写了篇文章《》大致总结了一下,但没有提到推导过程,今天有空展开聊聊。据估计,OpenAI训练GPT-4模型,很有可能应用了10000到20000张英伟达A100。按照马斯克的说法,GPT-5的训练可能需要3万到5万张H100,可见随着大模型的迭代发展,训练所需算力也呈爆发性增长。

leah126的博客 2125

fscan

fscan是一款内网综合扫描工具,方便一键自动化、全方位漏扫扫描。支持主机存活探测、端口扫描、常见服务的爆破、ms17010、redis批量写公钥、计划任务反弹shell、读取win网卡信息、web指纹识别、web漏洞扫描、netbios探测、域控识别等功能。 下载地址:GitHub - shadow1ng/fscan 存活主机端口服务信息扫描 如下,默认会扫描存活主机、端口、漏洞等一些信息 fscan.exe -h ip或者网段 服务爆破

渗透之路,攻防之间皆学问 2万+

评估训练模型所需的算力

10亿参数模型:需约1-10 PetaFLOP/s-days(等效1万亿次浮点运算持续1天)千亿参数(如GPT-3):约3,000-5,000 PetaFLOP/s-days万亿参数模型:超过50,000 PetaFLOP/s-days。

happyAnger6的专栏 1732

如何估算大模型训练所需算力?零基础入门到精通,收藏这篇就够了

ChatGPT横空出世引发了“百模大战”,算力需求成为焦点, GPU卡一时洛阳纸贵。训练一个大模型,究竟需要多少张GPU卡呢?2023年初写了篇文章《》大致总结了一下,但没有提到推导过程,今天有空展开聊聊。据估计,OpenAI训练GPT-4模型,很有可能应用了10000到20000张英伟达A100。按照马斯克的说法,GPT-5的训练可能需要3万到5万张H100,可见随着大模型的迭代发展,训练所需算力也呈爆发性增长。

Javachichi的博客 4426

Windows 11 24H2 系统下,保姆级安装华为 eNSP 模拟器(含依赖软件下载与避坑指南)

本文提供Windows 11 24H2系统下华为eNSP模拟器的完整安装指南,涵盖系统配置调整、依赖软件安装及常见问题解决方案。特别针对新版系统的兼容性问题,提供详细的避坑步骤和优化建议,帮助网络工程师顺利完成eNSP模拟器的部署与使用。

weixin_42567752的博客 428

【2025版】大模型需要怎样的硬件算力,从零基础到精通,精通收藏这篇就够了!

背景2017年,《Attention Is All You Need》的一声惊雷,给世人带来了Transformer模型。2022年,以Transformer结构为核心的chatGPT,凭借其震惊世界的表现,掀起了“AI元年" 的序幕:从此,各方纷纷投入大模型领域,前赴后继,热情高涨。然而,随之而来地,大模型在软硬件基础设施、算法及数据集等多方面的挑战和困难也逐步显现;今天我们将从AI-Infra角度出发,带大家了解目前大模型在算力、存储、通信等多方面上硬件资源的挑战和瓶颈,并且提供相关指标的量化手段和选型

Python_0011的博客 3422

Unity线性空间下PSD透明贴图黑边问题:原理分析与三种解决方案

在计算机图形学中,颜色空间转换与Alpha混合是渲染管线的基础环节。伽马空间与线性空间的差异源于显示设备与人眼感知的特性,现代渲染引擎采用线性工作流以实现更真实的光照计算。然而,当图像处理软件(如Photoshop)导出的纹理数据与游戏引擎(如Unity)的预期格式不匹配时,就会引发技术问题,影响视觉保真度与开发效率。具体表现为,在线性空间下进行Alpha Blend混合时,带透明通道的纹理边缘常出现异常黑边或颜色失真,其核心根源在于纹理数据是否经过“预乘”处理与sRGB标记的解读冲突。这一问题的解决对于提

weixin_34198762的博客 380

三维重建笔记_光束平差法(Bundle Adjustment, BA)

目录 1 光束平差法(Bundle Adjustment, BA) 1.1 SFM (Structure‐from‐Motion) 定义 问题描述 1.2 重投影误差 (Reprojection Error) 目标函数 1.3 使用 Levenberg‐Marquardt Algorithm 进行优化 问题描述 简化目标函数 参考 Gauss‐Newton Method ...

惊鸿一博 2万+

AI大模型训练相关参数如何估算?有这一篇就够了

随着大模型时代的到来,模型参数量、训练数据量、计算量等各方面急剧增长。参数规模方面,在过去的几年里,语言模型的参数规模从数亿增长到数千亿,甚至达到万亿级别。例如OpenAI的GPT-3拥有175B参数,而GPT MoE参数规模到达了1.8T;数据量方面,训练一个大模型通常需要达到T级别tokens;另外,由于参数规模和数据量庞大,随之带来的是巨大的计算量。

python1234567_的博客 5603

H3C IPsec over GRE VPN 实验

配置 IPsec over GRE VPN 来连通两端内网

M建的博客 2468

小白必看:一文搞懂训练大模型,算力到底是什么?

小白必看:一文搞懂训练大模型,算力到底是什么?

2301_76168381的博客 1999

AI赋能数字人:打造与语音节奏完美匹配的高质量手势动画

想象一个场景:当你与一位数字人交谈时,它不仅能理解你的言语,还能恰到好处地挥动手臂、比划手势,就像真实的人类交流一样自然流畅。这正是当前AI技术致力于实现的目标——通过分析语音内容,自动生成与之相匹配的手势动作,为数字人赋予更加丰富的情感表达和非言语沟通能力。AI手势生成技术的出现,标志着数字人在模仿人类自然交流方式上迈出了重要一步。随着技术的不断成熟与应用场景的拓宽,未来我们可以期待更多富有表现力和情感互动的数字人出现在我们的日常生活中,开启人机交互的新篇章。

这里汇聚了前沿的技术分享与实用的开发技巧,带你探索从创意到企业的技术创业之路。 793

SPV1050低功耗微功率太阳能充电管理模块原理图设计,已量产

在物联网应用快速普及的今天,户外低功耗传感器(如土壤温湿度、环境光照、无线节点等)的供电始终是行业痛点 —— 传统锂电池不仅需要定期更换,维护成本高,还难以满足 “终身免维护” 的场景需求。为此,我们设计了一款专为 1V~3V 低电压小型太阳能板优化的微功率太阳能电源管理模块,结合 USB 备用充电路径,实现了低功耗传感器的长期自主供电。

不脱发的程序猿 444

大模型项目落地时,该如何估算模型所需GPU算力资源

大模型项目落地时,该如何估算模型所需GPU算力资源。在大模型项目落地前期沟通时,对于算力估算和采购方案许多小伙伴不太了解,在此对相关的算力估算和选择进行一些经验总结。

kcarly的专栏 6469

新政下的绿电直连项目经济性分析:模式创新与价值重构

随着全球气候治理与低碳转型进程不断加速,绿电直连作为新能源就近消纳的创新模式,正成为破解新能源消纳瓶颈、规避碳关税壁垒的核心路径。2025年9月,国家发展改革委、国家能源局发布《关于完善价格机制促进新能源发电就近消纳的通知》(1192号文),为绿电直连项目的经济性分析与效益测算提供了明确的政策依据。本文将基于新政框架,深入解析绿电直连项目的经济性影响因素、盈利模式与优化路径,并结合案例与量化模型,为项目投资决策提供系统参考。

getusushu的博客 140

企业大模型怎么搞?算力怎么算?看这篇就够了!

曾几何时,大模型开发好像是科技巨头的“私人领地”,但现在局面早已改写。中小企业也能通过,在智能化道路上飞速前进,提效、创新不再是难事。无论是升级客服系统、优化推荐引擎,还是构建图像识别模型,(比如)或其他高性能GPU,能为你提供“超燃”的算力支持,帮助企业像“巨头”一样快速响应市场需求,轻松提升竞争力。但问题来了:到底该怎么估算你需要的算力资源?不用着急,接下来,我们带你逐步解析的几个关键步骤,让你轻松掌握如何“用对力”!企业首先得弄清楚自己:是客服自动化,销售预测,还是图像分类?

weixin_59191169的博客 1462

零基础入门Simulink——基于Simulink的MIMO-OFDM系统仿真建模示例

MIMO概述MIMO技术利用多个天线进行信号发送和接收,通过空间复用来提高数据传输速率,或通过空间分集来增强信号的可靠性。OFDM概述OFDM是一种将高速率数据流分成多个低速数据流并行传输的技术,每个子载波都采用调制方式(如BPSK、QPSK),并通过IFFT/FFT变换实现串并转换。MIMO-OFDM优势结合了MIMO的空间分集增益与OFDM对抗多径效应的能力,适用于宽带无线通信系统。提供了更高的数据速率和更好的频谱效率,是现代无线通信标准(如4G LTE、5G NR等)的核心技术之一。

amy_mhd的博客 888

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

《AI大模型应知应会100篇》第15篇:大模型训练资源需求:算力、数据与成本分析

近年来,大模型(如Qwen、DeepSeek、GPT-4、BERT等)在自然语言处理领域取得了突破性进展。然而,这些模型的训练和部署需要巨大的资源投入,包括算力、数据以及高昂的成本。本文将深入探讨大模型背后的资源需求,揭示其训练与推理过程中的技术细节,并结合DeepSeek大模型技术的发展,通过实际案例帮助读者理解如何平衡性能与成本。

yweng18的博客 2923

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

大模型微调算力成本评估指南:收藏这篇,精准规划你的AI项目资源

本文系统化介绍大模型微调算力成本评估方法,从理论计算到实战验证,详细拆解显存消耗与训练时长估算流程。对比全量微调与PEFT(如LoRA/QLoRA)技术优劣,通过案例展示不同因素对算力影响,提供评估工具与优化建议。助读者精准规划资源,在效果与成本间找到最佳平衡点,实现高效、经济的大模型微调。

m0_59162559的博客 1385

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

大模型训练(非常详细)零基础入门到精通,收藏这一篇就够了!

大模型训练被分解成了预训练,监督调优,对齐等阶段。先看预训练,预训练,即Pre-training。预训练的目的是让模型学习语言的特性,主要是学习语言表达的流畅性和规则。至于具体的语言任务,比如对话,角色扮演,信息抽取,翻译,阅读理解,问答等,则需要放到监督调优。预训练是大模型的基础和核心,预训练阶段决定了模型的基础能力和上限。

Javachichi的博客 986

大模型训练需要多少GPU算力?从参数规模到成本的全面解析

本文探讨了大模型训练的算力需求及优化方案。大模型训练算力主要由参数规模、数据量和训练轮次决定,以GPT-3为例约需1000张A100运行30天。实际训练中,GPU利用率、网络带宽和存储性能是关键影响因素。不同训练阶段算力需求差异显著:预训练消耗最大,微调次之,推理相对较低。文章提供了算力估算公式和成本参考,并建议通过并行策略、混合精度训练等方法优化效率。最后强调专业GPU云服务(如蓝耘科技)可有效降低算力门槛,提供弹性资源和技术支持。

qq_39811991的博客 2178
上一篇: AI大模型算法工程师高薪就业方向,(非常详细)从零基础入门到精通,收藏这篇就够了
下一篇: 2025版最新开发转大模型难吗?(非常详细)从零基础入门到精通,收藏这篇就够了
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值