


目录
DeepSeek,全称 杭州深度求索人工智能基础技术研究有限公司 。DeepSeek 是一家创新型科技公司 ,成立于2023年7月17日,使用数据蒸馏技术 ,得到更为精炼、有用的数据 。由知名私募巨头幻方量化孕育而生 ,专注于开发先进的大语言模型(LLM)和相关技术 ,目标是实现通用人工智能(AGI)。它的核心技术包括创新的架构设计,如多头注意力机制(MLA)和混合专家模型(MoE),能够在降低计算资源消耗的同时提升处理长文本和多轮对话的能力。例如,其模型参数规模虽达6710亿,但每次任务仅调用370亿参数,显著提升了效率和成本效益。
与OpenAI的ChatGPT相比,DeepSeek在中文处理、低成本训练(仅558万美元,远低于GPT-4的10亿美元)和开源策略上具有差异化优势。例如,其翻译效果被用户认为优于DeepL,且无需复杂指令即可生成自然对话。
DeepSeek的AGI行业地位
首先,DeepSeek通过技术创新(如强化学习和FP8内存优化)大幅降低AI开发成本,以1/10的成本实现与GPT-o1相近的性能。这种“低成本高能效”模式挑战了传统AI巨头的垄断,推动技术普惠化,尤其为中小企业和开发者提供了平等的竞争机会。
DeepSeek-R1的技术创新是什么?
回答:
- 训练效率:DeepSeek-R1通过纯RL和冷启动策略,在更少的数据量下达到可比性能(如AIME 2024 Pass@1 79.8% vs. o1-1217 79.2%)。
- 开源生态:开放模型权重及蒸馏后的1.5B-70B系列,推动社区研究和应用。
- 多任务通用性:在非STEM任务(如AlpacaEval 2.0写作)中表现更优(87.6% vs. o1未公开)。
- 技术透明性:完整公开训练方法和失败案例(如PRM和MCTS的局限性),促进学术讨论。
科普:DeepSeek-R1不仅解题能力和OpenAI的模型差不多,还免费开放了代码和小型版本,让更多人能使用和改进。同时,它在写作文、答常识题等方面也更厉害。
其次,DeepSeek在多场景应用上也展现了巨大潜力。在专业领域,如医学、法律、金融等,DeepSeek可生成专业内容(如胎儿心脏超声科普),降低知识传播门槛。同时,其开源策略和低成本模型引发全球关注,促使微软、英伟达等巨头调整战略(如降低服务定价),加速AI技术民主化。
此外,DeepSeek的成功证明了中国在AI领域的竞争力,推动中美技术“并跑”格局。AI不仅能提升效率(如接管20%的重复性脑力劳动),还能通过精准预测房价、股市趋势等辅助个人与企业决策,成为“超级工具”。
DeepSeek的“硬核科技”(通过强化学习实现自主推理)标志着AI向更高阶智能迈进的可能性。尽管当前技术仍依赖统计规律而非因果逻辑,但其在情感表达、专业分析等场景的突破,已让AI从“工具”逐渐演变为“生活助手”甚至“创意伙伴”。
DeepSeek不仅是技术创新的代表,更是AI普惠化的里程碑。它通过低成本、高效率和场景化应用,重新定义了人机协作的边界,成为推动社会进步的重要引擎。而AI的重要性,正体现在其重塑行业、赋能个体、加速全球协作的无限潜力中。
从专业角度来看,DeepSeek的出现标志着数据挖掘技术进入了一个新的发展阶段。传统的数据挖掘方法往往依赖于人工设定的规则和特征,而DeepSeek则能够自动学习数据的特征表示,并在此基础上进行高效的数据挖掘。这种自动化的学习方式不仅大大提高了数据挖掘的效率,还使得挖掘结果更加准确和可靠。

最小的 Qwen-1.5B 模型在 AIME 上也达到了 28.9% 的准确率,这个成绩已经超过了一些大得多的基础模型。中等规模的 Qwen-7B 达到了 55.5% 的准确率,这意味着一个仅有 70 亿参数的模型就能解决相当复杂的数学问题。
而 Qwen-32B 在 AIME 上更是达到了 72.6% 的准确率,在 MATH-500 上达到了 94.3%,这些成绩都接近于原始的 R1 模型。这一发现具有重要的实践意义:它证明了我们可以通过知识蒸馏的方式,将大模型的高级能力有效地转移到更小的模型中,这为 AI 技术的实际应用提供了一条可行的路径。
目前,DeepSeek 已将模型完整开源,包括 DeepSeek-R1-Zero、DeepSeek-R1 以及基于 Qwen 和 Llama 的六个蒸馏模型(参数规模分别为 1.5B、7B、8B、14B、32B 和 70B)。这些模型均采用 MIT 许可(MIT License)发布在 Hugging Face 平台上,可以免费商用、允许任意修改和衍生开发、支持进行二次蒸馏训练。
蒸馏技术的核心目标是什么?为何小模型通过蒸馏能超越直接RL训练?
目标:将大模型(如DeepSeek-R1)的推理能力迁移到小模型(如7B参数),使其在有限计算资源下接近大模型性能。
- 数据效率:蒸馏直接复用大模型生成的800k高质量推理数据,而直接RL需从头探索,计算成本高。
- 知识继承:小模型通过模仿大模型的输出模式(如CoT结构),跳过RL的试错阶段。
- 实验验证:蒸馏后的Qwen-7B在AIME 2024达到55.5%,远超直接RL训练的Qwen-32B(47.0%)。
科普:蒸馏就像“学霸笔记”。小模型不用自己从头学解题,而是直接背学霸(大模型)的解题步骤和技巧,这样既省时间又考得更好。

DeepSeek的崛起,不仅打破了传统AI技术的壁垒,更推动了行业的快速发展。在医疗健康领域,它协助医生进行疾病诊断,提高了诊断的准确性和效率;在金融服务领域,它帮助金融机构进行风险评估和智能投顾,提升了金融服务的智能化水平。此外,DeepSeek还在自动驾驶、安防监控等领域展现出广泛的应用前景。
DeepSeek的技术突破
DeepSeek v3:核心技术三个方向
架构上:
DeepSeek v3 的架构以 Transformer 为基础,通过 MLA(多层次注意力)优化计算和表达,MTP(多任务预测)提升预测效能。它还融合了多种先进机制,从注意力到多词元预测,全方位增强模型能力。
工程上:
DeepSeek v3 的工程实现采用了 DualPipe 并行与内存优化协同,FP8 训练提升效率,推理部署精心规划。通过巧妙平衡计算通信,合理管控内存显存,精准把握精度和速度。
训练上:
DeepSeek v3 的训练过程中,预训练采用了多种优化数据和策略,后训练则通过 SFT(自监督学习)和 RL(强化学习)接力提升性能。从样本增强到强化学习,层层深化,持续锤炼模型能力。

总结了 DeepSeek R1 的整个训练流程,它有两个非常重要的亮点或价值。首先,DeepSeek R1 创造性地基于 DeepSeek V3 基座模型,通过大规模强化学习技术,得到了一个纯粹通过强化学习增强的强推理模型,即 DeepSeek-R1-Zero。这具有非常重要的价值,因为在历史上几乎没有团队能够成功地将强化学习技术很好地应用于大规模模型上,并实现大规模训练。DeepSeek 能够实现大规模强化学习的一个重要技术特点是其采用了基于规则(rule-based)的方法,确保强化学习可以规模化,并实现面向强化学习的扩展(Scaling),这是它的第一个贡献。
DeepSeek R1 的第二个重要贡献在于其强化学习技术不仅局限于数学、算法代码等容易提供奖励信号的领域,还能创造性地将强化学习带来的强推理能力泛化到其他领域。这也是用户在实际使用 DeepSeek R1 进行写作等任务时,能够感受到其强大的深度思考能力的原因。
这种泛化能力的实现分为两个阶段。首先,基于 DeepSeek V3 基座模型,通过增强推理过程的可读性,生成了带有深度推理能力的 SFT(Supervised Fine-Tuning,监督微调)数据。这种数据结合了深度推理能力和传统通用SFT数据,用于微调大模型。随后,进一步通过强化学习训练,得到了具有强大泛化能力的强推理模型,即 DeepSeek R1。
DeepSeek-R1-Zero如何通过纯强化学习(RL)实现推理能力的突破?
回答:DeepSeek-R1-Zero的核心创新在于直接从基础模型(DeepSeek-V3-Base)出发,完全依赖大规模强化学习(RL)提升推理能力,跳过了传统的监督微调(SFT)步骤。其采用GRPO(Group Relative Policy Optimization)算法,通过组内归一化奖励信号优化策略。具体来说,GRPO通过采样一组输出(组大小G=16),计算组内奖励的均值和标准差,生成优势函数(advantage),从而避免传统PPO中需要额外训练价值模型的高成本。这种纯RL训练促使模型自主探索长思维链(CoT)、自我验证和反思等复杂推理行为,最终在数学(AIME 2024 Pass@1从15.6%提升至71.0%)和代码任务中取得显著提升。
科普:想象你教一个机器人解数学题,传统方法是先给它看很多例题(监督学习),再让它自己练习(强化学习)。而DeepSeek-R1-Zero直接让机器人通过“试错”学习,不需要例题。它用一种聪明的算法(GRPO)来评估每次尝试的得分,自动调整策略,最终学会复杂的解题步骤,比如检查自己的答案是否正确,或者换一种思路重新尝试。

因此,DeepSeek R1 的重要贡献体现在两个方面:一是通过规则驱动的方法实现了大规模强化学习;二是通过深度推理 SFT 数据与通用 SFT 数据的混合微调,实现了推理能力的跨任务泛化。这使得 DeepSeek R1 能够成功复现 OpenAI o1 的推理水平。
为什么说 DeepSeek R1 能够取得如此全球性的成功呢?我们认为这与 OpenAI 采用的一些策略有非常大的关系。OpenAI 在发布 o1 之后,首先选择不开源,其次将 o1 深度思考的过程隐藏起来,第三是 o1 本身采用了非常高的收费。这使得 o1 无法在全球范围内让尽可能多的人普惠地感受到深度思考所带来的震撼。
而 DeepSeek R1 则像 2023 年初 OpenAI 的 ChatGPT 一样,让所有人真正感受到了这种震撼,这是 DeepSeek R1 出圈的非常重要的原因。如果我们进一步将 DeepSeek 发布的 R1 和之前的 V3 结合起来考虑,那么它的意义在于:在非常有限的算力资源支持下,通过强大的算法创新,突破了算力瓶颈,让我们看到即使在有限的算力下,也能做出具有全球意义的领先成果。
DeepSeek的核心技术
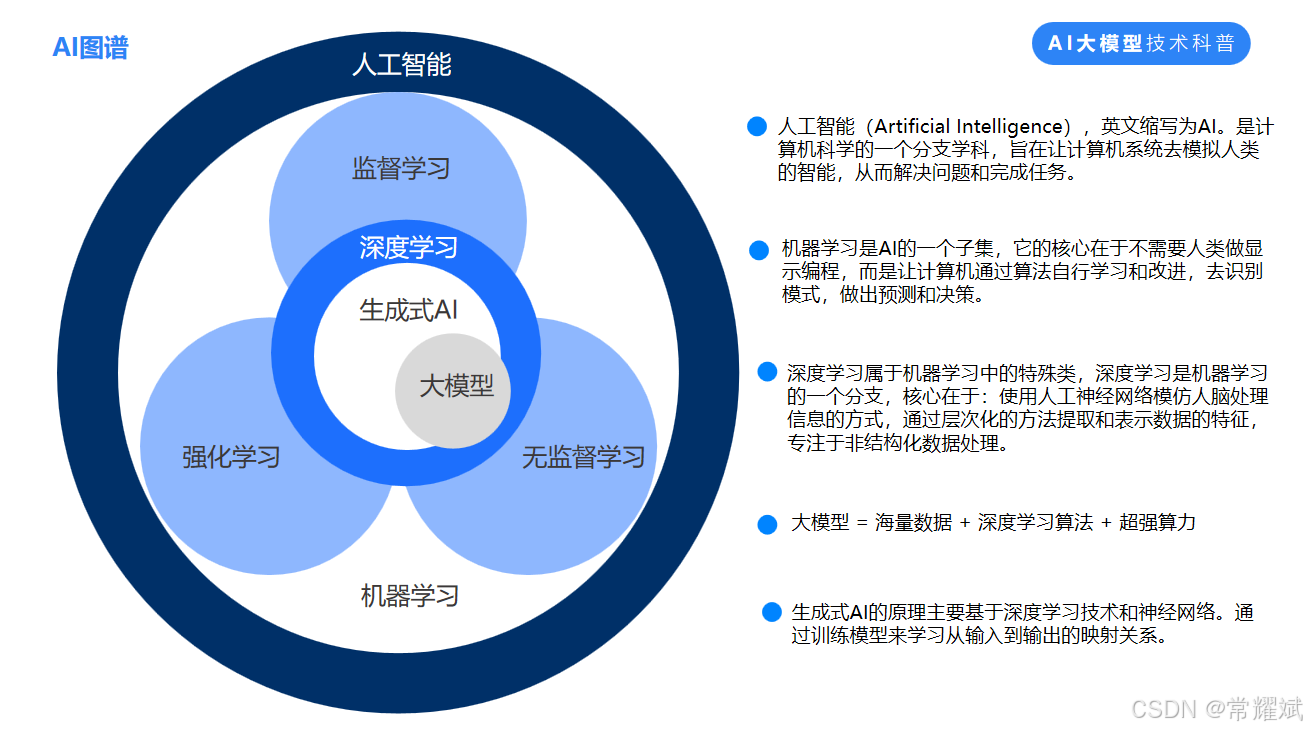
1. 深度学习(Deep Learning)
深度学习是一种基于神经网络的机器学习方法,通过多层网络结构(即深度网络)来自动从数据中提取特征,并逐层抽象出更高层次的特征。它与线性回归、决策树、支持向量机等传统机器学习算法在同一维度下,是一种特定的模型分类方法。
传统机器学习算法通常需要手动设计特征(例如线性回归或支持向量机),而深度学习的神经网络可以自动从原始数据中提取特征。这种特征学习能力使得深度学习在处理高维数据、图像、音频、文本等复杂数据时表现出色。深度学习是基于神经网络的一种技术,尤其是深度神经网络(DNNs)。它由多层的神经元组成,每一层负责提取输入数据中的不同层次特征。输入层接收原始数据,经过中间的隐藏层逐步提取更复杂的特征,最终通过输出层给出预测结果。尽管深度学习可以自动进行特征提取和学习,但由于网络结构复杂且参数众多,导致其可解释性较差,因此常被称为“黑盒模型”。这意味着我们很难准确解释模型做出某一预测的具体原因。
深度学习广泛应用于图像分类(如卷积神经网络 CNN)、自然语言处理(如循环神经网络 RNN 和变换器 Transformer)、语音识别、自动驾驶等领域。
2.强化学习(Reinforcement Learning)
强化学习是一种基于任务分类的机器学习方法,旨在通过与环境的交互来学习决策策略,从而使智能体在长期内获得最大化的累积奖励。它与有监督学习、无监督学习属于同一维度的任务分类方法。
有监督学习指的是在有标记的数据集上训练模型,目标是预测未知数据的结果。模型通过已知的标签调整参数,以便提高预测精度。无监督学习指的是没有标签的数据,模型从数据的分布和结构中发现潜在模式,如聚类或降维。不同于上述两者,强化学习中的数据并非来自静态的样本集合,而是通过智能体与动态环境的持续交互产生的。智能体根据环境反馈的奖励或惩罚(即奖惩机制)来调整其决策策略,最终目标是学会一套能最大化长期回报的策略。
强化学习中智能体的学习过程基于奖励函数。在每一步的决策后,智能体从环境中收到反馈,可能是正奖励(表示决策正确)或负奖励(表示决策错误)。智能体通过反复试探环境并不断调整行为策略,以期获得最大化的累积奖励。强化学习的核心是“试错学习”,智能体通过不断尝试不同的动作来探索最佳策略。此外,强化学习中往往存在“延迟奖励”,即智能体的某些行为的影响可能在未来才会体现,这增加了决策的复杂性。
3. 深度强化学习(Deep Reinforcement Learning)
深度强化学习是深度学习和强化学习的结合体,利用深度神经网络的强大表示能力来解决强化学习中状态空间和动作空间庞大的问题。传统强化学习算法(如 Q-learning 或策略梯度法)在处理高维连续状态或动作空间时表现有限,难以应对复杂的任务场景。深度强化学习通过引入深度神经网络来表示 Q 函数或策略函数,从而使智能体能够在大规模复杂的环境中进行学习。
在深度强化学习中,深度神经网络用于估计智能体在不同状态下的价值(或策略),从而引导智能体选择最优动作。这种方法使得强化学习可以处理更加复杂的问题,例如大规模图像输入或连续控制任务。 深度 Q 网络(DQN)是深度强化学习的代表算法之一,通过将 Q-learning 与卷积神经网络结合,使得智能体能够处理复杂的视觉输入。其他著名算法包括深度确定性策略梯度(DDPG)、近端策略优化(PPO)等。
将深度学习的感知能力和强化学习的决策能力结合在一起,就可以形成很多泛用的AI。深度强化学习在视频游戏、机器人控制、自动驾驶、推荐系统和金融市场分析等领域有重要应用。例如,Google DeepMind 的 AlphaGo 和 AlphaStar 通过深度强化学习在围棋和星际争霸等游戏中击败了人类顶尖玩家。
补充一下核心概念:
1. 专家混合架构(Mixture of Experts, MoE)
DeepSeek采用了“专家混合”(MoE)架构,这是其技术体系的核心亮点:
任务分解与专家分工:MoE将复杂问题分解为多个子任务,由不同的“专家”网络处理。这些专家是针对特定领域或任务训练的小型神经网络,例如语法、事实知识或创造性文本生成。
稀疏激活:与传统模型对每个输入激活所有参数不同,MoE仅激活与当前任务相关的专家。这种选择性激活大幅降低了计算成本,同时提升了效率。例如,尽管DeepSeek-V3拥有6710亿参数,但在任何给定任务中仅使用约370亿参数。
动态路由与负载均衡:通过“专家选择”(Expert Choice)路由算法,DeepSeek确保任务在各个专家间的负载均衡,避免某些专家过载或闲置。
这种架构使DeepSeek能够在资源有限的情况下实现大规模模型的高效运行,同时保持极高的性能和可扩展性。
2. 强化学习与奖励工程
DeepSeek在模型训练中广泛应用强化学习和奖励工程:
强化学习:通过试错机制和环境反馈优化模型的决策能力,特别是在推理和复杂问题解决方面。
规则驱动的奖励系统:相比传统的神经奖励模型,DeepSeek开发了一种基于规则的奖励系统,用于指导模型学习。这种方法不仅提升了训练效率,还增强了模型在逻辑推理任务中的表现。强化学习的概念,是AI通过与环境进行交互,并根据环境反馈的奖励信号来学习最优行为策略,以最大化长期累积奖励。强化学习有三个关键的概念,策略模型、价值模型和奖励模型。
一是,策略模型:策略模型是指AI在不同环境状态下应该采取的行动,或采取各个行动的概率分布。比如在游戏AI中,环境是整个游戏地图,策略模型就是游戏AI在地图的每个点上应该采取的行动,比如前进、后退、左转、右转等等。
二是,价值模型:价值模型用于评估AI在某个状态下的价值,表示AI从某个状态开始,遵循某种策略所能获得的长期累积奖励的估计值。比如在游戏AI中,游戏AI在某个点前进可能会遇到怪物,而右转可能会遇到宝箱。
三是,奖励模型:一种用于量化AI在环境中执行某个动作时所获得奖励的函数,简单来说,就是告诉AI什么样的行为可以获得更高奖励,而什么样的行为会得到惩罚。
AI在和环境交互的过程中,根据奖励模型输出的奖励信号,通过策略梯度等算法更新策略模型的参数,使得策略模型逐渐学习到能最大化长期累积奖励的最优策略。
3. 知识蒸馏与模型压缩
为了进一步降低计算需求,DeepSeek采用了知识蒸馏技术,将大型模型的能力压缩到更小规模的模型中。例如,其部分模型参数仅为15亿,但依然能够执行复杂任务。这种技术使得DeepSeek能够在硬件资源受限的情况下保持竞争力。
DeepSeek的工作流程
DeepSeek 的大语言模型的工作流程可以概括如下:
1.输入处理:
用户输入文本或代码片段后,DeepSeek 通过分词器将其转换为模型可处理的 token 序列。同时,系统会进行预处理,包括违法不良信息审核等。
2.专家选择与推理:
模型根据输入内容动态选择最适合的专家网络进行处理。例如,在处理代码生成任务时。DeepSeek-Coder-V2 会根据输入的代码片段或自然语言描述选择合适的专家网络。
3.模型推理:
经过预处理的数据输入到以 Transformer 为基础的深度神经网络中。模型基于注意力机制计算每个位置的重要性权重,根据语言的统计规律、知识和对齐要求进行推理和计算,预测下一个最佳词语等,逐步生成文本。
4.输出处理:
生成的文本或代码经过审核,确保内容符合规范和要求后,将结果输出返回给用户。在代码生成等任务中,模型会根据输入的提示和上下文信息,生成符合语法和逻辑的代码;在问答任务中,生成合理准确的答案。
DeepSeek的实现过程
1. 模型训练
数据收集与预处理:DeepSeek 从互联网、书籍、学术论文等渠道收集海量文本数据。对数据进行清洗、标注和分割,例如去除噪音数据、标记文本类别等。
模型架构设计:选择合适的 Transformer 变体,并根据需求进行改进,例如引入稀疏注意力机制和 MoE 架构。确定模型规模,根据计算资源和应用场景进行权衡。
分布式训练:使用 Kubernetes、TensorFlow Distributed 等工具搭建分布式训练框架。采用数据并行、模型并行和流水线并行等技术,提高训练效率。
混合精度训练:将模型参数和梯度转换为半精度浮点数,并使用损失缩放技术避免精度损失。
持续学习与微调:定期收集新数据并持续训练模型。针对特定任务进行微调,例如使用特定数据集对模型进行训练。
2. 模型推理
推理引擎:选择高效的推理引擎,例如 TensorRT、ONNX Runtime 等。使用模型压缩、量化等技术优化推理速度。
解码策略:DeepSeek 采用了自回归生成和编码器-解码器等方法进行文本生成。解码策略包括贪婪解码和束搜索等。
多模态交互:DeepSeek 支持多模态输入和输出,例如文本、图像、语音等。实现不同模态之间的联合理解和生成。
DeepSeek的算法贡献
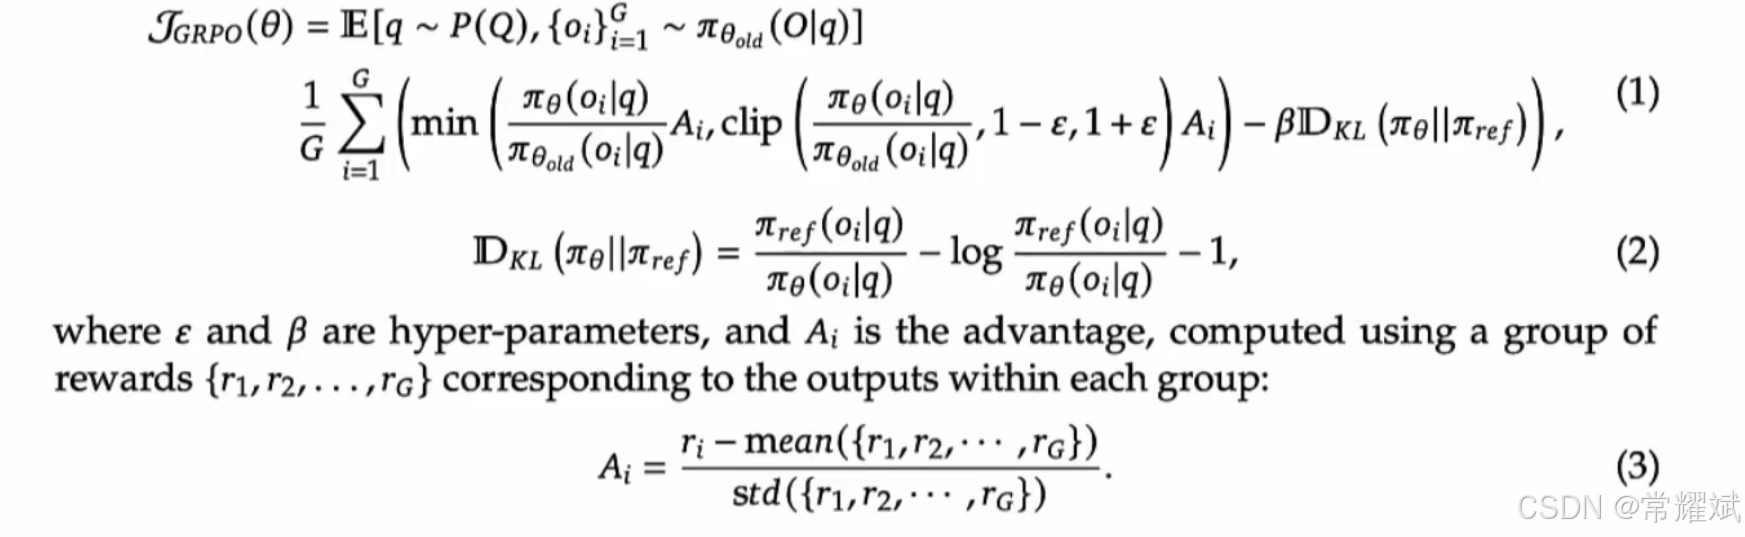
通俗易懂的例子来解释Group Relative Policy Optimization。
以足球比赛为例,把每个球员作为群体AI中的一员,外部环境就是足球场,每个球员的状态包括位置、速度、身高、控球等状况,传球、跑位、射门等动作构成了【策略网络】,球队进球得分就是【奖励】。
刚开始,每个球员会按照各自的习惯和基本战术踢球,这就是初始策略。比赛过程中,教练会观察每个球员的表现和球员之间的配合情况,相当于收集数据和分析相对关系,比如发现某个前锋太独,不和中场球员配合而导致浪费进攻机会,教练就会调整他的策略,这就是【策略优化】。通过在比赛中不断观察和调整,优化每个球员的策略和球队的整体战术,从而提升球队赢得比赛的概率。
强化学习(Reinforcement Learning,RL)作为一种模仿人类行为的学习方式,在很多复杂任务中得到了广泛应用。然而,如何在大规模任务中高效地优化策略,始终是一个值得探讨的问题。传统的强化学习方法通常依赖于一个额外的评论模型,该模型与策略模型一样大,负责评估当前策略的“好坏”程度。然而,评论模型的存在不仅增加了计算的开销,也导致了训练效率的低下。为了解决这一问题,**群体相对策略优化(GRPO)**应运而生。GRPO通过摒弃评论模型,利用更高效的群体样本来优化策略,从而显著提升了强化学习的效率。
1. 什么是 GRPO?
群体相对策略优化(Group Relative Policy Optimization, GRPO) 是一种旨在提升强化学习效率的优化方法。与传统的强化学习方法不同,GRPO不依赖于评论模型,而是通过群体样本来估算奖励,并根据这些样本来优化策略。GRPO 的关键创新在于,利用从旧策略生成的输出样本来进行奖励估算,并通过这些样本对策略进行优化,避免了评论模型带来的计算开销。
2. GRPO 与 PPO 的关系
GRPO 算法与PPO(Proximal Policy Optimization)算法有着密切的关系。PPO 是强化学习中非常流行的一种策略优化方法,它的核心思想是通过限制策略更新的幅度来避免过度的策略变化,从而保持训练的稳定性。PPO 使用了一个叫做**剪切目标(clipped objective)**的技术,通过限制策略更新的范围,防止策略出现过度优化的情况。
与 GRPO 类似,PPO 也采用了优势(Advantage) A AA 来衡量策略的优劣,并通过剪切目标来避免过大的更新。然而,PPO 依然需要一个评论模型来评估策略的好坏,而 GRPO 则完全依赖于群体样本来进行优化,没有评论模型的参与。
主要区别
评论模型:PPO 依赖评论模型来计算优势 A AA,而 GRPO 则通过群体样本的方式估算奖励。
训练效率:由于 GRPO 避免了评论模型,减少了计算开销,因此在大规模任务中,GRPO 更加高效。
3. 为什么 GRPO 有效?
GRPO 的有效性源于以下几个方面:
减少计算开销:传统的强化学习方法通常依赖于评论模型来评估策略,而 GRPO 则通过群体样本来估算奖励,避免了额外的计算开销。
高效的策略优化:通过群体样本的优势评估,GRPO 能够更快速地对策略进行优化,尤其在面对复杂的长期决策问题时,能够有效提高效率。
稳健的正则化:KL 散度项的引入使得 GRPO 更加稳健,能够在复杂任务中避免过拟合,保持良好的泛化能力。
GRPO 作为一种新的强化学习优化方法,通过摒弃传统的评论模型并利用群体样本来进行奖励估算,实现了更加高效的策略优化。与 PPO 相比,GRPO 在计算开销和训练效率上具有明显优势,尤其在大规模任务中展现出了卓越的性能。随着强化学习应用场景的不断扩展,GRPO 可能会成为解决复杂决策任务中的一种重要工具。
DeepSeek v3算法核心原理详解
1. FP8 运算与缩放策略
DeepSeek v3在深度学习模型中首次使用了FP8格式,采用E4M3(指数部分为4,尾数部分为3)进行前向和反向传播,而不是传统的E4M3用于前向,E5M2用于反向的方式。为了扩展值的范围,还进行了缩放:激活函数采用1x128的缩放,权重使用128x128的缩放。此过程中采用的是每个张量的缩放,而不是每行的缩放。
2. FP8 累加误差处理
DeepSeek论文指出,简单地累加FP8乘积会导致精度损失2%或更多。因此,每进行4次矩阵乘法时,会将结果加回到主FP32累加器中,以保持精度。
3. 潜在注意力机制(Latent Attention)
DeepSeek使用上下投影的巧妙方法来生成K和V矩阵。这意味着不再将K和V存储在KV缓存中,而是可以将一个小的C矩阵存储起来,C = X * D,Q = X * Wq,K = C * Uk,V = C * Uv。在解码和推理过程中,传统的注意力机制会为每个新token在K和V中添加新的一行,但DeepSeek只需对最后一行执行softmax,从而避免了每次都要重新计算softmax(QK^T / sqrt(d))V。由于MLP和RMSNorm等操作都是逐行进行的,因此只需要用下一层的KV缓存来代替。在推理过程中,上投影被合并到Wq中:
QK^T = X * Wq * (C * Uk)^T
= X * Wq * (X * D * Uk)^T
= X * Wq * Uk^T * D^T * X^T
= (X * (Wq * Uk^T)) * (D^T * X^T)
然后我们可以将这两个矩阵传递给Flash Attention。
4. MoE损失平衡策略
DeepSeek并没有加入MoE的损失平衡,而是为每个专家提供可调的偏置,这些偏置会被加入到路由计算中。如果某个专家负载过高,偏置会动态调整,以减少其负载。此外,还提供了序列长度的损失平衡,并将其加到损失函数中。
DeepSeek的未来前景
凭借出色的技术实力、开放的理念和广阔的应用场景,DeepSeek在近年来取得了令人瞩目的成就,未来的发展机会更是值得期待。它不仅具备丰富的语言理解能力,还能应对大量复杂的信息处理需求,展现出优秀的适应性与多样性。
在全球AI竞争日益加剧的背景下,DeepSeek的崛起无疑是一种新鲜的力量,其背后所代表的智能化发展趋势,也将为无数领域带来广阔的发展前景。通过积极探索与创新,DeepSeek有望在全球AI领域谱写出更加辉煌的篇章。
从技术到应用,DeepSeek正展现出它在全球AI生态中的重要性和独特魅力。在未来,相信随着其技术的不断提升和应用场景的多元化,DeepSeek将在人工智能行业中占据一席之地,引领科技发展的新潮流。
推荐清华社《深度学习和大模型原理与实践》,各网站有销售,【京东地址】:https://item.jd.com/10130571131098.html
推荐清华社《AI赋能企业数字化转型》,各网站有销售,【京东地址】:https://item.jd.com/10116537319380.html
 3927


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


