OmniMedVQA:大规模医学VQA评测数据集

2021:多任务预训练的跨模态自注意力的医学视觉问答Cross-Modal Self-Attention with Multi-Task Pre-Training for Medical VQA 摘要 由于缺乏标签的数据,现有的医学视觉问答往往依赖于转移学习获取图像特征表示,使用视觉和语言特征跨模态融合实现与问题相关的答案预测。这两个阶段单独执行,没有考虑预训练特征的跨模态融合的相容性和适用性。因此我们将图像特征预训练重新定义为一个多任务学习范式,迫使它考虑到特定图像理解任务中特征的适用性。此外,我们引入了一种跨模态自注意力模块(CMSA)有选择的捕捉长期的上下文相关性,以更有效的融合视觉和语言特征。实验结果表明该方法由于现有的先进方法。 代码 一、介绍 医学V... 阅读详情

在过去的两年里,计算机视觉领域涌现出了多种不同的多模态大模型(LVLM),如BLIP2, MiniGPT4等。这些大模型在多种不同的视觉任务上取得了亮眼的效果。为了准确评估多模态大模型的能力,许多研究人员从不同角度对模型进行了评测[1,2]。结果显示,LVLM在各种多模态任务中展示了卓越的能力。但是,这些评测工作大多只关注LVLM在通用视觉任务中的效果,它们在医学领域的潜力尚未被充分探索。这些多模态大模型能否较好地解决医学领域的问题,如何准确评估多模态大模型在医学领域的能力,仍然是一个未知的问题。

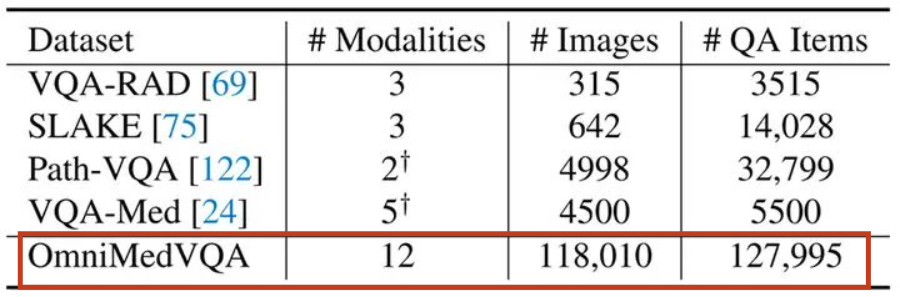
要准确评估多模态大模型在医学领域的效果,就需要构建全面的、涉及多种不同模态、覆盖人体多种不同位置的医学评测数据集。同时,对于多模态大模型而言,视觉问答能力(VQA)是其最基础且关键的能力之一。因此,要想准确评测医学大模型的能力,就需要一个全面的医学VQA数据集做支撑。但是,如图1所示。由于高质量医学数据的稀缺性,现有的医学VQA数据集不论是规模还是全面性都有所欠缺。因此,为了准确评估多模态大模型在医学领域的能力,构建一个大规模、全面的医学评测数据集十分重要。
图片
图 1 不同医学VQA数据集比较

Paper:

https://arxiv.org/pdf/2402.09181

代码与数据集下载): 

https://github.com/OpenGVLab/Multi-Modality-Arena

数据集构建

由于高质量医学数据的稀缺性,加之普通标注员很难处理医学数据,因此,构建高质量的医学VQA数据集是一个十分有挑战性的任务。为了解决这个问题,我们从医学分类数据集入手,基于数据集中的类别属性和其他延伸知识,构建VQA问题。

比如,对于一个肺结核患者拍摄的胸腔X-Ray影像。我们可以设计如下QA模版对:

Q:该图像是通过什么模态采集得到的  A:X-Ray

Q:该图像显示了什么部位的信息  A:胸部

Q:该图像呈现出何种疾病  A:肺结核

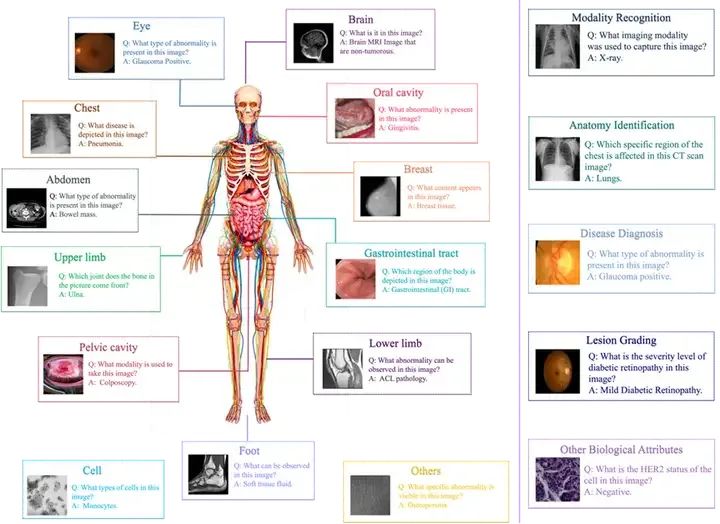
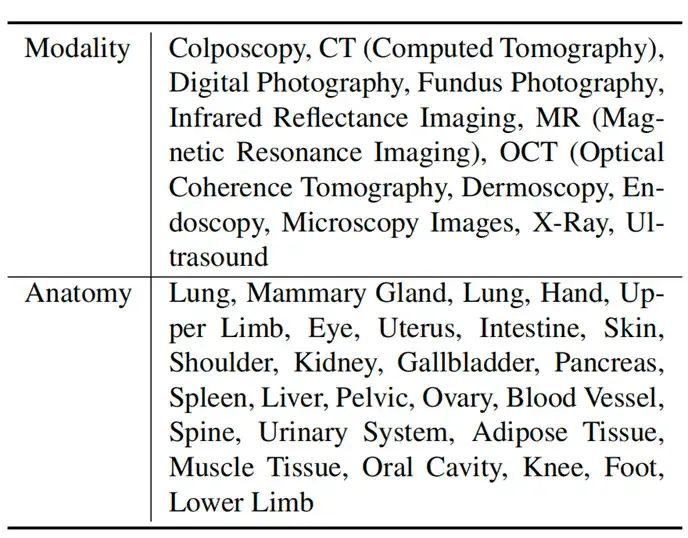
根据上述思路,我们以73个不同分类数据集为基础,拓展出了多种QA模版。我们基于这些QA对进行采样,得到了127995个不同的VQA条目。为了拓展OmniMedVQA数据集的多样性,我们通过GPT-4对QA模版进行复写。同时,为了便于评测,我们让GPT-4为每个条目配置错误答案,将其构造成选择题的形式。通过这种方式,在确保语义不变的前提下,使不同VQA条目的问答形式更多样。最终,我们的OmniMedVQA数据集包含118,010种不同图片,拥有12种不同模态,涉及超过20个人体不同的器官、部位。数据集概览如图2所示。图2右侧展示了OmniMedVQA的五种问题类型。图3反映了数据集包含的不同模态的影像和涉及的相关器官。
图片
图 2 OmniMedVQA数据集概览

图片
图 3 OmniMedVQA涉及的模态和器官

评测方法

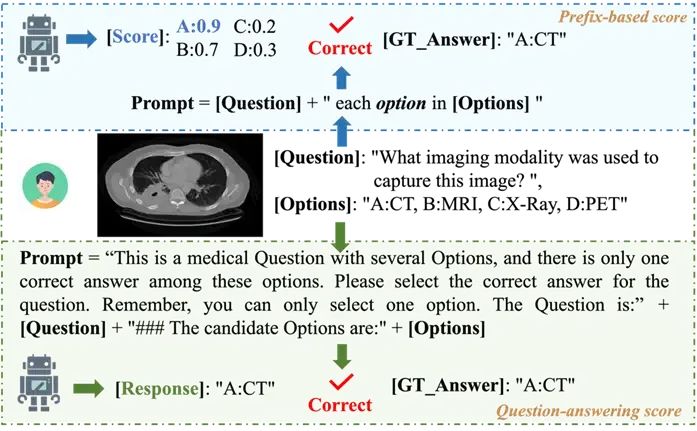
为了准确评测多模态大模型在医学领域的能力,我们设计了两种评测指标:Question-answering score和Prefix-based score。它们各自的流程如图4所示。Question-answering score以选择题的形式进行评测。我们将问题和选项作为文本输入,让多模态大模型结合图像进行回答,进而根据模型的输出结果判断是否回答正确。
图片
图 4 Question-answering score和Prefix-based score评测流程示意图

Prefix-based score则更关注模型内在的知识。具体来说,在多项选择问答任务中,给定输入图像和文本句子,我们首先分别提取视觉特征和question的文本特征。然后,将视觉特征与文本特征一起输入大语言模型,计算大语言模型输出各选项的可能性得分。这个得分被视为该图像-文本对的Prefix-based score,反映了模型生成相应文本内容的概率。对于每个测试条目中的所有选项,我们都通过此方式计算Prefix-based score。得分最高的选项意味着它是这个问题最可能的答案,我们将该选项与真实答案进行比较判断模型回答是否正确。

实验

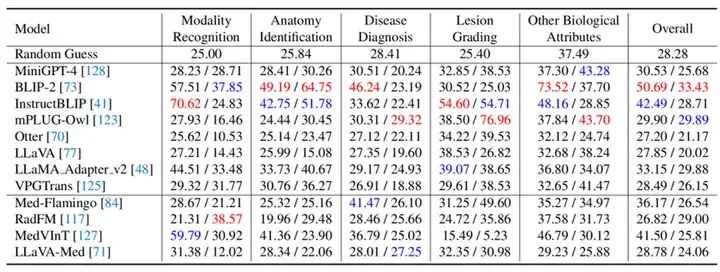
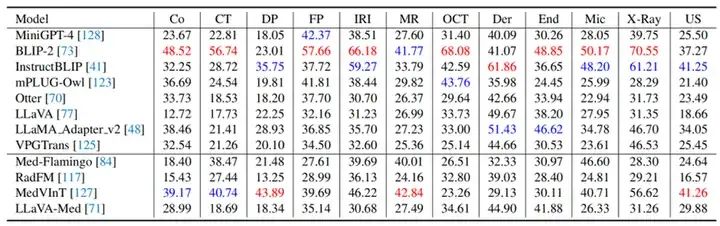
我们利用OmniMedVQA数据集,测试了8个通用多模态大模型:BILP2, MiniGPT-4, InstructBLIP, mPLUGOwl, Otter, LLaVA, LLama adapter v2, 和VPGTrans。以及四个医学多模态模型:Med-Flamingo, RadFM, MedVInT 和 LLaVA-Med。实验结果如图5和图6所示,它们分别按5种不同任务类型和12种不同模态体现了各模型的评测结果。表格中“/”左侧和右侧的数值分别是Question-answering Score 和Prefix-based Score。
图片
图 5按照5种不同问题类型分别计算的评测结果

图片
图 6按照12种不同模态分别计算的评测结果

从实验结果我们可以得到如下结论:

  • 让我们非常惊讶的是,在所有LVLM中,BLIP-2和InstructBLIP取得了最好的表现,远远超过许多医学LVLM。这说明现有医学LVLM并没有得到充分的训练,它们的表现还有很大的进步空间。

  • 医学领域迫切需要一个强大的模型来对齐图像-文本对,从而产生更多高质量数据用于训练LVLM。BLIP在通用数据集和我们的OmniMedQA中都展现出了较好的表现,因为它是使用各种视觉领域的大量高质量图像-文本对进行训练的。因此,开发通用医学LVLM的关键在于使用来自不同医学领域的大量高质量“图像-文本”数据对模型进行训练。由于医学数据的稀缺性和标注难度,如果有一个强大的图像-文本对齐模型,可以更好地由医学影像生成文本描述,为医学领域带来更多高质量数据。

  • MedVInT和Med-Flamingo在所有医学LVLM中取得了最优的表现,并且还超过了除BLIP2和InstructBLIP之外的许多通用LVLM。这种成功可能是因为他们在训练中接受了大量专门的医学知识。Med-Flamingo学习了超过4000本医学教科书,而MedVInT基于381K图像-标题对生成的QA数据进行训练。这表明,为了获得更好的性能,应该向LVLM注入更多的医学领域知识。

  • 从图6中我们可以发现,对于CT、MRI这种分布和自然图像有明显区别的影像,医学LVLM展现出了更好的表现。这是因为医学LVLM在训练中接触过更多CT、MRI数据,这些数据和自然图像有明显不同。因此,医学LVLM在这些数据上展现出了更好的表现。

结论

医疗是关系国计民生的大事,建立鲁棒的医学多模态大模型可以大大促进医疗人工智能的水平,带来重要的社会价值。但是,由于医疗安全的重要性,在现实医疗场景应用多模态大模型前,需要谨慎测评各模型的能力,确保鲁棒性和安全性。为此,我们建立了OmniMedVQA数据集,并对现有主流多模态大模型进行了全面评测。评测结果显示,现有主流多模态大模型面对很多医学问题仍然无法很好结果。同时,医学大模型的效果并没有明显优于通用大模型。为了训练更为鲁棒的医学LVLM,需要一个强大的图像-文本对齐模型提供更多高质量医学数据。同时,由于不同医学影像模态间的多样性和不同器官间的差异性,现阶段想直接建立一个通用的医学LVLM十分不易。因此,我们认为可以尝试从某一个器官的部分模态入手,建立一个针对某个科室或某几种疾病的专门化的医学LVLM。我们希望该数据集可以为未来医学多模态大模型的发展提供评测基准。

Paper:

https://arxiv.org/pdf/2402.09181

代码与数据集下载: 

https://github.com/OpenGVLab/Multi-Modality-Arena

参考文献

[1] Wenqi Shao, Yutao Hu, Peng Gao, Meng Lei, Kaipeng Zhang, Fanqing Meng, Peng Xu, Siyuan Huang, Hongsheng Li, Yu Qiao, et al. Tiny lvlm-ehub: Early multimodal experiments with bard. arXiv preprint arXiv:2308.03729, 2023.

[2] Peng Xu, Wenqi Shao, Kaipeng Zhang, Peng Gao, Shuo Liu, Meng Lei, Fanqing Meng, Siyuan Huang, Yu Qiao, and Ping Luo. Lvlm-ehub: A comprehensive evaluation benchmark for large vision-language models. arXiv preprint arXiv:2306.09265, 2023.

【论文阅读(八)】Adaptive Image Quality Assessment via TeachingLarge Multimodal Model to Compare 香港城市大学 ​NeurIPS 2024​概述:提出通过比较来自同一 IQA 数据集的图像来生成按比例放大的比较指令来灵活地整合不同的 IQA 数据集,开发了一种类似人类的视觉质量比较器。提出了一种软比较方法,该方法计算测试图像优于多个预定义锚图像的可能性。 阅读详情

相关推荐

(2024|MICCAI|微软,DermaVQA 数据集)皮肤病学多语言视觉问答数据集

本研究提出 DermaVQA 数据集,用于皮肤病学领域的 多语言视觉问答(VQA)任务。该数据集包含皮肤科相关的 用户生成的健康问题及配套图片,并提供了多个医生的回复,以支持多模态问答研究。

qq_44681809的博客 1124

【医学视觉大模型】HealthGPT:医学视觉的未来,理解与生成的完美融合

我们提出了一个强大的医疗大型视觉语言模型(Med-LVLM)HealthGPT,它在一个统一的自回归范式中整合了医疗视觉理解与生成能力。我们的引导原则是逐步适应异构的理解与生成知识到预训练的大型语言模型(LLMs)。这是通过一种新颖的异构低秩适配(H-LoRA)技术实现的,辅以定制的分层视觉感知方法和三阶段学习策略。为了有效学习HealthGPT,我们设计了一个全面的医疗领域特定理解与生成数据集,称为VL-Health。实验结果显示HealthGPT在医疗视觉统一任务中具有卓越的性能和可扩展性。

2401_84204207的博客 1690

【VQA文献阅读】VQA-Med: Overview of the Medical Visual Question Answering Task at ImageCLEF 2019

VQA-Med: Overview of the Medical Visual Question Answering Task at ImageCLEF 2019 文章地址:http://ceur-ws.org/Vol-2380/paper_272.pdf Abstract This paper presents an overview of the Medical Visual Ques- tion Answering task (VQA-Med) at ImageCLEF 2019. Particip

小哨的博客 2149

(2024|EMNLP|UNC,Med-LVLM,RAG,RULE)医学视觉语言模型中用于事实性的可靠多模态 RAG

本文提出 RULE,一种适用于 Med-LVLMs 的可靠多模态 RAG 方法。RULE 优化检索内容选择,并通过 偏好微调 使模型在检索信息与自身知识之间取得平衡。该方法在三个医学数据集上取得显著提升,平均提高 47.4% 的事实准确性

qq_44681809的博客 1518

【医疗视觉问答】Q2ATransformer: Improving Medical VQA via an Answer Querying Decoder

本文提出了一种半开放的医学VQA框架,该框架通过作者设计的机制将答案嵌入与融合的图像-问题特征相关联,成功地将答案语义信息纳入到答案类预测过程中,从而显著提高了准确率。它丰富了现有的封闭式和开放式医疗VQA框架,刷新了SOTA在两个基准上的性能,特别是对于开放式问题。

nbwjszd的博客 556

VQA_v2数据集预处理

数据集文件介绍 VQA官网上提供了数据集文件:VQA_v2数据集 image train:82783 val:40504 test:81434 question train:443757 val:214354 test:447793 answer train:4437570 val:2143540 大致理解一下 根据官网的question文件,可以先理解一下文件里包含的内容: { "info" : info, "task_type" : str, "data_type": str,

weixin_45339060的博客 1万+

医学视VQA——综述

医学视VQA——综述

weixin_44845357的博客 4867

C++游戏开发实战:从零构建局域网联机对战系统(附完整代码解析)

本文详细介绍了如何使用C++开发局域网联机对战游戏系统,涵盖从环境搭建到实战代码解析的全过程。重点讲解了Winsock库的应用、Socket通信原理、服务端与客户端开发技巧,以及性能优化和安全防护方案,帮助开发者快速掌握C++游戏开发的核心技术。

weixin_42524945的博客 446

VQA的应用(调研)

近期又有两个数据集VQA-RAD presented in Lau et al. (2018), and PathVQA described in He et al. (2020),他们提高了VQA训练和测试样本的多样性。广告和图像理解是密切相关的。最后还有利用VQA来做广告设计的,Zhou et al. (2020)提出了一种能够提取文本和图像相关信息的方法,并生成一个新的广告,他使用的是跨模态编码器(cross-modality encoder architecture)。比如多源VQA数据的融合;

weixin_44845357的博客 1410

使用 Python 获取实时港股行情数据

在本教程中,你将学习如何通过 Infoway API 获取港股实时行情数据,具体以腾讯控股(0700.HK)和汇丰控股(0005.HK)为例,使用 Python 进行数据请求和解析。

kk_stoper的博客 1518

将Matlab程序打包成.exe独立可执行程序

将Matlab程序打包成.exe独立可执行程序,在未安装Matlab的电脑上也能运行Matlab程序。

简简单单的学习笔记,致力于帮助更多前进路上的朋友~ 5万+

OmniMedVQA: 一个医疗领域的“视觉-语言”模型benchmark

医疗是关系国计民生的大事,建立鲁棒的医学多模态大模型可以大大促进医疗人工智能的水平,带来重要的社会价值。但是,由于医疗安全的重要性,在现实医疗场景应用多模态大模型前,需要谨慎测评各模型的能力,确保鲁棒性和安全性。为此,我们建立了OmniMedVQA数据集,并对现有主流多模态大模型进行了全面评测。评测结果显示,现有主流多模态大模型面对很多医学问题仍然无法很好结果。同时,医学大模型的效果并没有明显优于通用大模型。为了训练更为鲁棒的医学LVLM,需要一个强大的图像-文本对齐模型提供更多高质量医学数据。同。

Kakaxiii的博客 1539

杰理SDK UART 使用教程

本文介绍了JL701n芯片的UART串口通信使用教程,重点讲解了UART2的初始化配置、数据收发和中断处理功能。教程详细说明了代码结构、核心功能函数、配置参数和使用步骤,包括UART初始化、数据发送和接收中断处理等关键操作。同时提供了完整的API接口说明和注意事项,强调了中断处理限制、缓冲区管理、引脚配置等重要细节。最后给出了基本使用流程和高级任务处理示例,并针对常见问题提供了故障排除建议。本教程适用于需要在JL701n芯片上实现可靠串口通信的开发者。

qq_42014563的博客 1819

【CVPR24】OmniMedVQA: 一种新的医疗LVLM大规模综合评估基准

论文介绍论文: OmniMedVQA: A New Large-Scale Comprehensive Evaluation Benchmark for Medical LVLM代码: https://github.com/OpenGVLab/Multi-Modality-Arena会议与年份:CVPR24全文概述本篇论文介绍了针对医疗领域的视觉问答任务(Medical VQA)的新基准测试集——...

Gorgeous_wxd 1397

11、基于STM32的智能药盒

当今时代是一个新技术层出不穷的时代,在电子领域尤其是自动化智能控制领域,传统的分立元件或数字逻辑电路构成的控制系统,正以前所未有的速度被单片机智能控制系统所取代。嵌入式具有体积小、功能强、成本低、应用面广等优点,可以说,智能控制与自动控制的核心就是单片机。

行走的皮卡丘 6106

工商银行数据智能架构实践

工商银行大数据平台技术创新与实践摘要(149字): 工商银行构建了企业级大数据云基础设施,形成包含批量计算、流计算、联机分析等核心能力的技术架构。平台创新性地实现流批一体处理,将个人储蓄存款监测时效提升至分钟级;通过实时数仓技术将报送时效缩短至1-5分钟;融合内外部数据构建风控模型,债券违约预警准确率达100%。平台还支撑了"码上赢"精准营销和空间数据服务等创新应用,未来将向存算分离、实时数仓和云数智融合方向演进,持续提升数据价值转化能力。

银行信息系统应用架构详解 541

OpenBayes 一周速览丨首个云平台部署Cambrian-1教程来了,Lecun团队&谢赛宁新作!在线运行ComfyUI SD3工作流

这个项目的核心目标是探索和评估不同的视觉表征,以及它们如何与大型语言模型相结合,从而推动视觉表示学习的进步,并提供对模型和架构的新见解。这个数据集包含约 300k 条高质量的对话,是通过一个自动化的自合成过程生成的,该过程利用了对齐的 LLMs 的自回归特性来生成用户查询和相应的回复。每个条目都包含有关角色、媒体来源和涉及角色场景的详细信息。该数据集包含 118,010 张不同的图片,涵盖 12 种不同的模态,涉及超过 20 个不同的人体器官和部位,解决了现有医学图像数据集在多样性和真实性方面的不足。

OpenBayes的博客 961

VisionPro - 基础 - 模板匹配技术-Search/PMAlign/PatMax(6)-纹理屏蔽和重叠匹配

Note:对已经有了,1已经训练好的模板,2一组使能的自由度,3一个待测的实时图片,PatMax 就能模板匹配的给出变化的最佳描述。对一些综合的模板,这三个输入值往往是一起影响最后的变换结果信息。例如,如果我们训练了一个圆形的模板,然后搜索一个角度自由度包括一个圆,那么将会有无限个可能的角度满足要求。这些组合的模板匹配,被官方名为:退化系统,a degenerate system的结果被叫做a degenerate result 退化结果4.2 退化系统例子。

山云的专栏 1535

NeurIPs 2024.10 利用多模式判定原理​​增强医疗 VQAEnhancing Medical VQA with Multimodal Determination Rationales

在实际医疗环境中,当面临开放式查询时,我们提出的 MedVQA 模型仍然可以根据所学的医学知识生成明智的响应。2.2 思想链最近,语言模型 Raffel et al. [2020]、Chowdhery et al. [2023] 对 NLP 进行了显著转变。为了进一步增强语言模型的推理能力,之前的工作 Cobbe et al. [2021], Wei et al. [2022] 在训练或推理阶段加入了推理原理,指导模型生成最终预测。

Kakaxiii的博客 1377

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

AI大模型企业应用实战:Prompt让LLM理解知识

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

2401_84204413的博客 3215

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

大模型评估基准(Benchmark)概述

大模型评估基准概述

PeterClerk的博客 2884

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

21.5万张X光,78万个医学问题!医学视觉问答数据集Medical-CXR-VQA来了!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba和医学影像】交流群添加微信号:CVer111,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!转载自:新智元 | 编辑:LRST 好困【导读】多模态大语言模型(MLLM)在医学视觉问答(...

阿木寺的博客 939

MedVQA医学视觉问答论文通读1

医学视觉问答论文通读笔记

qq_45477639的博客 4585

探索医疗数据的未来:MIMIC-III Benchmarks

探索医疗数据的未来:MIMIC-III Benchmarks mimic3-benchmarksPython suite to construct benchmark machine learning datasets from the MIMIC-III ???? clinical database. 项目地址:https://gitcode.com/gh_mirrors/mi/mimic3-ben...

gitblog_00077的博客 572

视频质量评估最新综述:全面调研

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/多模态/扩散】交流群添加微信:CVer2233,助手会拉你进群!扫描下方二维码,加入CVer学术星球!可获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪必备!视频质量评估(Video Quality Assessment, VQA)旨在以高度符合人类感知的...

阿木寺的博客 4389
上一篇: DCNv4: 动态与稀疏操作的高效融合 | CVPR Highlight
下一篇: ICLR 2024|首个无损数据集蒸馏方法
OpenGVLab
博客等级 码龄2年 418粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值