


大模型技术在全球范围内加速演进,智能体能力不断深化,从多步执行走向多智能体协同,从辅助工具走向独立执行者,开始在跨平台、跨应用的真实场景中端到端地完成任务;推理能力在数学、科学等高难度任务上持续突破,可靠性进一步提升。模型的自进化能力亦在涌现,能够在执行中主动调整策略并迭代优化。长线程任务能力的增强,让模型得以在大型工程中稳步推进,承担起高度复杂的生产力任务。
司南持续关注全球大模型发展动态,不断更新闭源评测数据集,本次评测进一步纳入来自CompassArena大模型竞技场的真实用户提问、真实场景下的智能体任务以及高难度学科推理问题,增强评测题目的新颖性与挑战性,更贴近模型在真实环境中的实际表现。同时,为进一步提升评测结果的稳定性与可信度,本次智能体任务均重复评测三次,非智能体任务均重复评测四次,并以平均分作为最终结果。
现发布司南最新(4月)大语言模型评测榜单,本次榜单囊括了国内外共23个大语言模型,包含主流闭源模型和社区开源模型。
最新榜单解读
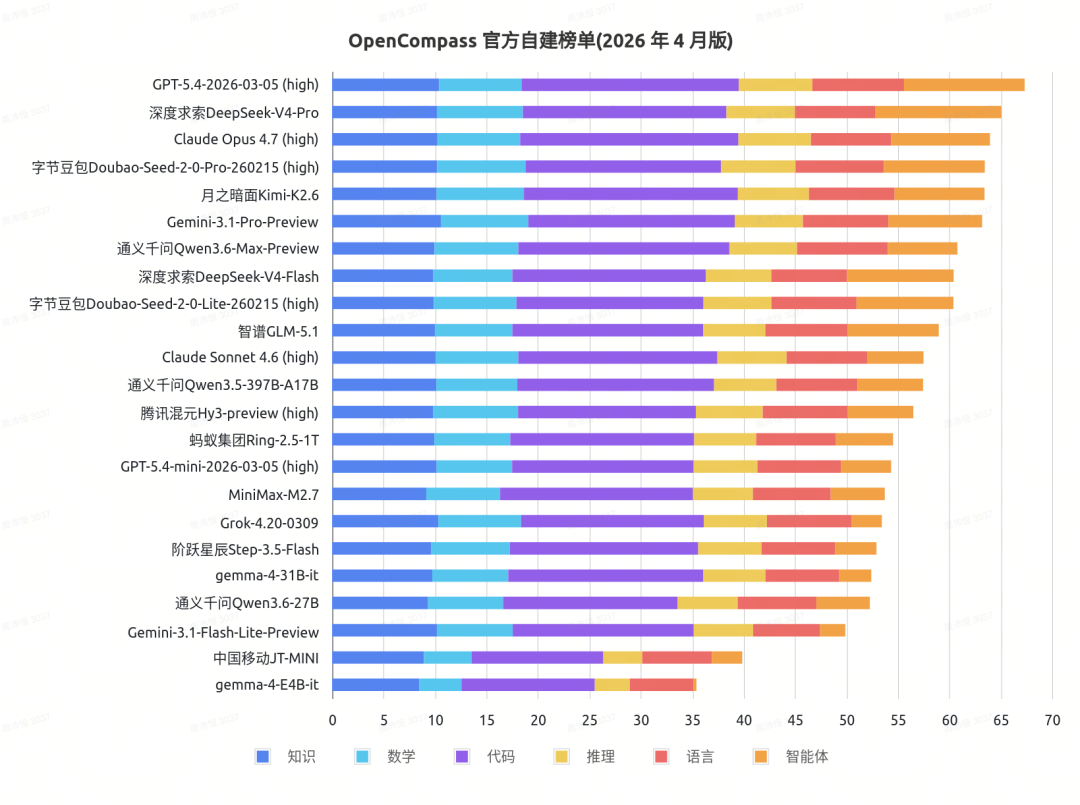
GPT-5.4-2026-03-05 (high)登顶榜首
在本次榜单评测中,来自OpenAI、Google、深度求索、字节豆包、通义千问、月之暗面、腾讯混元等多个厂商发布的模型在各个评测维度展开激烈的竞争。最终由OpenAI发布的 GPT-5.4-2026-03-05 (high) 以其在多个维度上表现出的强大能力,综合得分位列第一,成功登顶榜首。
模型强项各有千秋,头部赛道呈现错位竞争格局
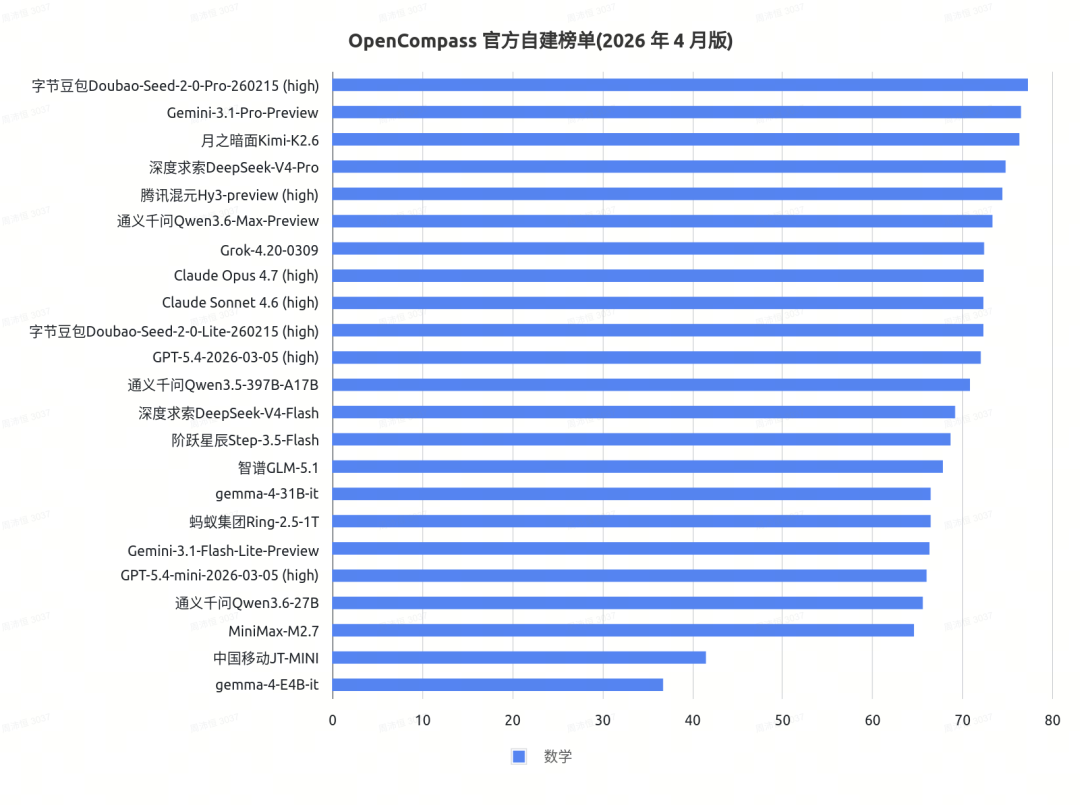
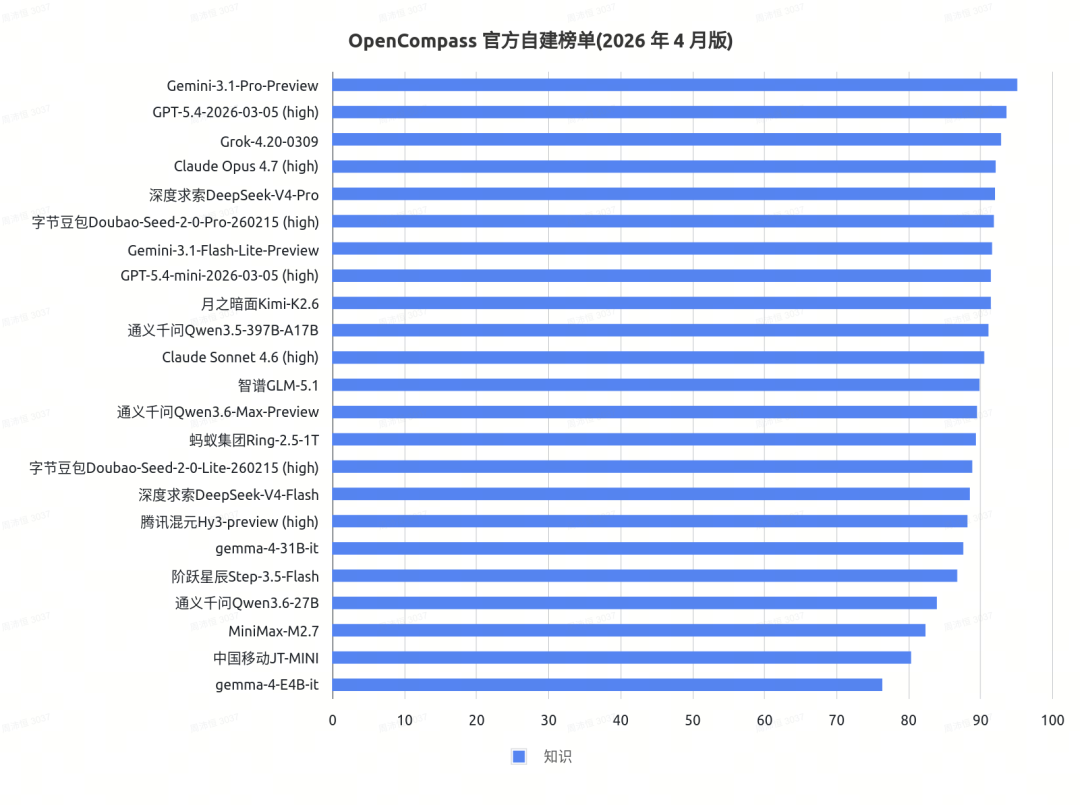
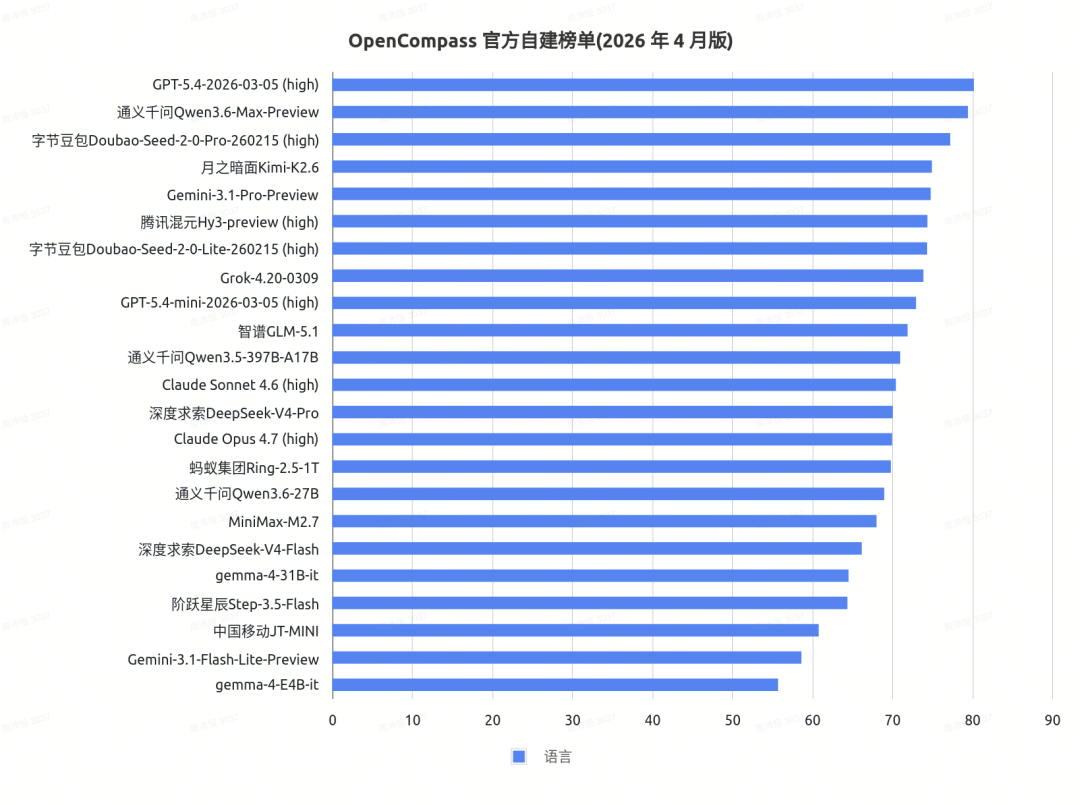
本次榜单评测中,头部梯队的整体领先差距正在收窄。各大头部模型在演进路线上呈现出一定程度上的“各擅胜场”态势,构建了差异化的能力护城河。具体而言,Doubao-Seed-2-0-Pro-260215(high)在逻辑推理与数学计算领域展现出优秀的能力;Claude Opus 4.7 (high)在综合代码能力上更胜一筹;GPT-5.4-2026-03-05 (high) 在语言维度上表现优异;Gemini-3.1-Pro-Preview具备最为广泛、准确的知识储备;DeepSeek-V4-Pro则在智能体能力方面表现最为亮眼。
智能体能力重要性稳步提升,模型竞争趋于白热化
大模型的 Agent 能力已全面跨越“能调用工具”的基础阶段,真正具备完成真实场景复杂任务的能力。开源阵营中,DeepSeek-V4-Flash、GLM-5.1、Kimi-K2.6 等多款模型在核心能力维度上已逼近甚至部分超越闭源竞品。当前行业竞争焦点,也正从“能不能做 Agent”,加速演进“能否将 Agent 做到真正可用、足够强大”,这一趋势在高难度通用工具调用与智能体编程两大关键方向上体现得尤为明显。
榜单更新说明
相较于2026年1月榜单,本次榜单新增模型如下:
GPT-5.4-2026-03-05 (high)、Gemini-3.1-Pro-Preview、Claude Opus 4.7 (high)、Grok-4.20-0309、Qwen3.6-Max-Preview、Doubao-Seed-2-0-Pro-260215(high)、JT-MINI等闭源模型,以及gemma-4-31B-it、DeepSeek-V4-Pro、Qwen3.5-397B-A17B、GLM-5.1、MiniMax-M2.7、Kimi-K2.6、Ring-2.5-1T、Hy3-preview(high)、Step-3.5-Flash等开源模型。
月度榜单评测基准
司南大语言模型官方自建评测榜单,综合评估商业API模型和开源模型在 语言、推理、知识、代码、数学、智能体六大能力维度,这些维度进一步细化为包括自然语言处理、理工科知识、学科推理、数学竞赛、多轮工具调用等十余项细分任务,以实现对行业开源模型和商业API模型进行全面评测分析。
不同能力维度会根据任务形式选用主观或客观评测方案。总分基于各能力维度加权获得: 语言(1/9)、推理(1/9)、知识(1/9)、代码(3/9)、数学(1/9)、智能体(2/9)。

最新榜单概览
综合榜单
子维度榜单
智能体

代码

推理

数学
知识
语言
评测题目示例
数学计算
某城市有10000 名市民与两个剧院, 每个剧院有 \(x\) 个座位, 每个市民独立等可能地选取一个剧院看戏. 若希望“某个市民来到剧院后因为没有座位不得不放弃看戏”的概率不超过0.01, 计算 \(x\) 的最小值. (参考数据: \(\Phi(2.05)=0.98\) , \(\Phi(2.17)=0.985\) , \(\Phi(2.33)=0.99\) ,\(\Phi(2.58)=0.995\) , \(\Phi\) 是标准正态函数.)

标准答案:5129
Doubao-Seed-2-0-Pro-260215(high)回复之一:
### 问题分析与求解过程
#### 步骤1:建立概率模型
设 \( X \) 为选择第一个剧院的市民人数,由于每个市民独立等可能选择两个剧院之一,因此 \( X \) 服从参数为 \( n=10000 \),\( p=0.5 \) 的二项分布,即 \( X \sim B(10000, 0.5) \)。选择第二个剧院的人数为 \( 10000 - X \)。
“有市民因无座位放弃看戏”的事件等价于**至少一个剧院超员**,即 \( \{X > x\} \cup \{10000 - X > x\} \),化简得 \( \{X > x\} \cup \{X < 10000 - x\} \)。题目要求该事件的概率不超过 0.01,即:
$$P(X > x \text{ 或 } X < 10000 - x) \leq 0.01$$
#### 步骤2:利用对称性简化概率
由于二项分布 \( B(10000, 0.5) \) 关于均值 \( np=5000 \) 对称,因此 \( P(X > x) = P(X < 10000 - x) \),且当 \( x \geq 5000 \) 时,\( \{X > x\} \) 与 \( \{X < 10000 - x\} \) 互斥。因此:
$$P(X > x \text{ 或 } X < 10000 - x) = 2P(X > x) \leq 0.01$$
即单侧尾部概率满足 \( P(X > x) \leq 0.005 \),等价于 \( P(X \leq x) \geq 0.995 \)。
#### 步骤3:正态近似
由于 \( n=10000 \) 很大,根据棣莫弗-拉普拉斯中心极限定理,二项分布 \( X \sim B(n,p) \) 可以用正态分布近似,即:
$$X \approx N(\mu, \sigma^2), \quad \mu = np = 5000, \quad \sigma^2 = np(1-p) = 2500$$
因此标准差 \( \sigma = \sqrt{2500} = 50 \),标准化后 \( Z = \frac{X - \mu}{\sigma} \sim N(0,1) \)。
#### 步骤4:分位数计算
要求 \( P(X \leq x) \geq 0.995 \),代入正态近似得:
$$\Phi\left( \frac{x - 5000}{50} \right) \geq 0.995$$
根据题目给出的参考数据 \( \Phi(2.58) = 0.995 \),且标准正态分布单调递增,因此:
$$\frac{x - 5000}{50} \geq 2.58$$
解得:
$$x \geq 5000 + 2.58 \times 50 = 5129$$
#### 步骤5:连续性修正验证
考虑到 \( X \) 是离散变量,使用连续性修正时,\( P(X \leq x) \approx \Phi\left( \frac{x + 0.5 - 5000}{50} \right) \),代入要求得:
$$\Phi\left( \frac{x + 0.5 - 5000}{50} \right) \geq 0.995$$
即 \( \frac{x - 4999.5}{50} \geq 2.58 \),解得 \( x \geq 5128.5 \),由于座位数为整数,因此最小 \( x=5129 \),与近似结果一致。
---
### 最终答案
\(\boxed{5129}\)
(若题目默认“单个市民选的剧院超员即视为该市民无座位”,即要求单侧超员概率≤0.01,则答案为 \(\boxed{5117}\)。但结合经典“两剧院容量设计”的问题背景,题目实际要求“所有市民都有座位的概率≥0.99”,因此更合理的答案为 5129。)
Grok-4.20-0309回复之一:
The number of citizens choosing the same theater as a given citizen is a random variable \(N = 1 + K\), where \(K \sim \text{Binomial}(9999, 1/2)\). Thus, \(N\) has mean \(\mu = 1 + 9999 \times (1/2) = 5000.5\) and variance \(\sigma^2 = 9999 \times (1/2) \times (1/2) = 2499.75\), so that \(\sigma \approx 50\).

The given citizen has to abandon watching if there are no seats available in the chosen theater, which occurs if \(N > x\). The requirement is that
\[
P(N > x) \leq 0.01.
\]
Since \(n = 10000\) is large, the central limit theorem implies that \(N\) is approximately distributed as \(\text{Normal}(5000.5, 50^2)\). Therefore,
\[
P(N > x) \approx 1 - \Phi\left( \frac{x - 5000.5}{50} \right).
\]
The inequality becomes
\[
1 - \Phi\left( \frac{x - 5000.5}{50} \right) \leq 0.01,
\]
or equivalently
\[
\Phi\left( \frac{x - 5000.5}{50} \right) \geq 0.99.
\]
From the given data, \(\Phi(2.33) = 0.99\), so it is required that
\[
\frac{x - 5000.5}{50} \geq 2.33.
\]
Solving for \(x\),
\[
x - 5000.5 \geq 2.33 \times 50 = 116.5, \quad x \geq 5000.5 + 116.5 = 5117.
\]
Since \(x\) must be an integer, the smallest value satisfying the inequality is \(x = 5117\).

To confirm it is minimal, consider \(x = 5116\):
\[
\frac{5116 - 5000.5}{50} = \frac{115.5}{50} = 2.31.
\]
Since \(\Phi(2.31) < \Phi(2.33) = 0.99\), it follows that \(P(N > 5116) > 0.01\), so \(x = 5116\) does not satisfy the requirement.

Thus, the minimal value of \(x\) is 5117.

\boxed{5117}-
在这道概率题中,Doubao-Seed-2-0-Pro-260215(high)准确建立了整体座位分配的概率模型,将“有人因剧院超员而无法入座”转化为两个剧院中至少一方超员的事件,正确求得最终答案。相比之下,Grok-4.20-0309在建模时只关注单个市民视角,将问题简化为单侧超员概率计算,从而使用了错误的分位点,导致结果错误。其主要问题在于对题目的理解不完整,未能从整体约束出发把握问题本质。
智能体能力
问题:
Which poetess, whose husband was also a poet and who was born sometime between 1720 and 1764—long after a famous poetess celebrated for her beauty—had many of her poem recordings placed in a dry well for safekeeping after her death?

标准答案:Arnimal
DeepSeek-V4-Pro轨迹行为简述:
该模型在面对非常规线索时,展现出较强的跨文化检索意识与线索过滤能力。

阶段一:线索拆解与初步检索
该模型开局进行结构化拆解: The user is asking about a poetess with these clues: 1. Her husband was also a poet 2. Born between 1720 and 1764 3. Born long after a famous poetess celebrated for her beauty 4. Many of her poem recordings were placed in a dry well for safekeeping after her death. 随后发起针对性搜索: search("poetess poems dry well safekeeping after death husband poet") search("dry well poems hidden after death poetess 18th century") 检索结果返回大量Instagram短视频链接,标题高度匹配题目原句。模型并未被社交媒体噪声干扰,而是敏锐提取出关键信息: Actually, the recurring Instagram posts about poetess recordings deposited in a dry well after her death suggest this is a known fact that people are posting about. Let me try searching for specific poetesses with poet husbands in the 18th century.

阶段二:排除干扰与拓宽文化视野
模型首先尝试西方主流18世纪女诗人,列举了验证过程: Anna Laetitia Barbauld (1743-1825) - husband Rochemont Barbauld, not a poet. Charlotte Smith (1749-1806) - husband Benjamin Smith, not a poet. Phillis Wheatley (c.1753-1784) - husband John Peters, not a poet. Hannah More (1745-1833) - never married. 发现西方候选人全部不符后,模型果断跳出英语文学框架: Wait, I just thought of something - could this be a Korean poetess? Korean gisaeng poetesses were known. Or what about an Indian poetess? Let me search more specifically for the well story.

阶段三:锁定地域线索与精准命中
模型调整检索策略,尝试多语言与非西方文学语境,并结合丈夫同为诗人的强约束进行交叉筛选。在检索到克什米尔文学相关片段后,迅速将线索与Arnimal的生平进行比对。确认其丈夫为诗人学者、出生年代吻合、枯井藏诗的地方记载与题目完全一致。最终输出正确答案Arnimal。

该模型的成功关键在于:不被西方文学名单局限,能根据线索矛盾点主动切换文化语境;对社交媒体噪声具备过滤能力;能正确解读recordings在历史语境中的实际含义。
gemma-4-31B-it轨迹行为简述:
该模型陷入典型的检索死循环与假设陷阱,未能输出正确答案。

阶段一:陷入术语纠结与无效循环
模型开局即对recordings一词产生强烈怀疑: Wait, poem recordings in the 18th century? That's impossible. Maybe the user means recorded poems or manuscripts. Or maybe recordings refers to something else. 随后发起大量宽泛检索: search("dry well safekeeping poems poetess husband") search("poetess dry well manuscripts safekeeping") search("born between 1720 and 1764 husband") 检索未返回直接结果后,模型开始机械罗列西方女诗人并逐一排除,反复猜测Anna Laetitia Barbauld、Charlotte Smith、Felicia Hemans、Emily Dickinson、Christina Rossetti等,均因年代或丈夫身份不符被否定。

阶段二:被无关文献带偏,产生路径依赖
模型在检索中偶然发现一条JSTOR文献片段: I found a snippet: thrust for safekeeping into a dry well in the house of a collateral descendant. This snippet was from a JSTOR review. Let me check what it was reviewing. 模型将此片段视为核心突破口,反复使用精确匹配搜索该短语,试图从中反推诗人身份。然而该文献实际描述的是意大利战乱时期某批古籍的保存轶事,与本题毫无关联。模型在此处消耗大量Token,陷入路径依赖。

阶段三:逻辑断裂与强行拟合
随着推理推进,模型始终无法解决recordings与18世纪的时间矛盾,也未考虑非西方文学可能性: Could the recordings be wax cylinders? If she was born in 1764, she'd have to be over 100. What if she was born in 1764 and died in 1870s? Maybe the recordings are just manuscripts? 模型试图用音频技术时间线强行解释历史文本,完全偏离文献检索常识。最终在多次无效重试后,未能输出有效答案。

该模型的失败根因在于:无法跳出预先的假设,导致检索空间被自我设限;对非常规表述缺乏历史语境转化能力;被无关高亮片段带偏,缺乏线索权重判断。
注意事项
-
大语言模型官方自建榜评测榜单每三月更新一次;
-
新模型厂商若想参与该月榜单评测,可在当月25日前发送邮件至opencompass@pjlab.org.cn申请评测申请加入司南OpenCompass月度评测榜单;
-
加入司南OpenCompass评测的结果默认公开;
-
仅支持开源或对外提供API服务商业化模型(内部迭代研发模型暂不支持评测);
-
为了确保公平性,司南通过公开采购的方式获取了商业API服务,其中包括使用OpenRouter、阿里云百炼、硅基流动等服务商API。然而,由于部分API的稳定性问题或敏感词过滤机制,可能会导致某些问题无法获得答案,特此进行说明。
了解更多
最新大语言模型评测榜单已同步上线至司南官网,欢迎大家访问查看更详细的评测数据!
https://rank.opencompass.org.cn
同时,司南评测体系中大模型评测过程中所用到的工具链均在GitHub开源,诚挚邀请您在学术研究或产品研发过程中使用我们的工具~

 4370


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


