全球最多下载的中文开源高质量数据集更新了!OpenCSG发布Fineweb-Edu-Chinese-V2.3

OSDU(Open Subsurface Data Universe,开放地下数据空间 / 开源地下数据生态系统) OSDU是由油气行业与云厂商共建的开源、云原生数据平台规范,旨在解决勘探开发领域数据孤岛、格式不统一、应用绑定等问题。其核心是“数据与应用解耦”,通过统一元数据模型、API及权限体系,实现跨云、跨项目的数据互通。平台支持地震、井筒、储层等专业数据管理,配套OpenVDS、ETP等标准,适配PB级体数据,支撑AI训练与数字孪生。虽为参考实现,非即用系统,但已成国际油气数字化底座趋势,国内三桶油正推进试点与国产化适配。 阅读详情

重磅更新

OpenCSG(开放传神)正式发布 Fineweb-Edu-Chinese V2.3 数据集。这是一份面向中文大模型训练、NLP 任务构建与多语言研究的高质量中文教育语料数据集,聚焦中文文本中的教育价值、内容质量与训练可用性,为中文大模型预训练、继续预训练和数据研究提供更可靠的数据基础。

V2.3 版本延续了 Chinese Fineweb Edu 系列在中文高质量语料建设上的方向:从海量中文 Web 内容中筛选更适合模型学习的教育类文本,而不是简单追求语料规模。对于中文大模型而言,真正稀缺的并不只是“更多中文文本”,而是信息密度更高、表达更清晰、结构更完整、能够支撑模型知识理解与语言能力提升的高质量数据。

在数据定位上,Fineweb-Edu-Chinese V2.3 继续面向中文教育语料场景,强调文本的可学习性和训练价值。它更适合作为中文模型训练中的高质量数据来源,可用于中文文本理解、知识问答、摘要生成、阅读理解、教育类 NLP 任务以及多语言研究中的中文语料补充。
版本演进
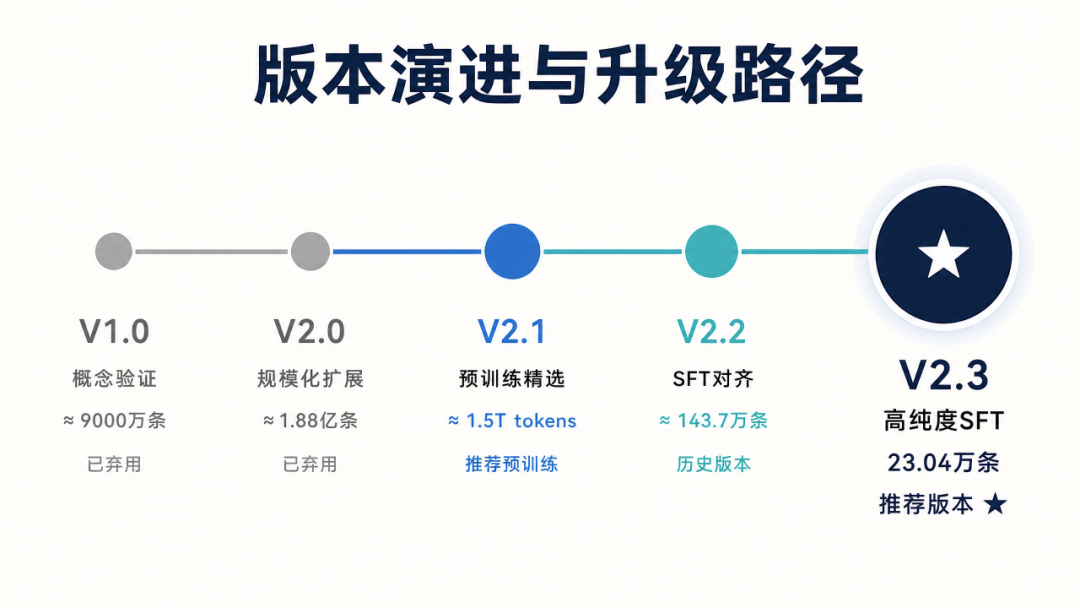
1 v1.0

核心定位:概念验证

数据规模:约 9000 万条,约 300GB

关键特性与改进:初代 Chinese Fineweb Edu 语料;BERT 打分模型;MinHash 去重;数据源包括 CCI2、SkyPile、Tele-AI

2 v2.0

核心定位:规模化扩展

数据规模:约 1.88 亿条,约 420B tokens

关键特性与改进:升级至 OpenCSG csg-wukong-enterprise V2 打分器;扩展 Industry2、wanjuan1.0、wudao 等数据源

3 v2.1

核心定位:预训练精选

数据规模:总计约 1.5T tokens

关键特性与改进:按分数分层组织;新增 map-cc、opencsg-cc;支持灵活预训练和课程学习

3 v2.2

核心定位:SFT与对齐

数据规模:约 143.7 万条高质量问答

关键特性与改进:将高质量教育语料转化为 SFT 问答数据;提供纯 QA 与上下文版本

3 v2.3

核心定位:更高纯度的 SFT 数据

数据规模:23.04 万条 QA pairs

关键特性与改进:升级 V2.2 的源文本选择和生成逻辑;强化证据对齐、质量过滤和多格式导出

Chinese Fineweb Edu Dataset V2.3

Fineweb-Edu-Chinese V2.3是 OpenCSG(开放传神)推出的高质量中文教育语料数据集,面向中文大模型训练、NLP 任务构建与多语言研究场景。Fineweb-Edu-Chinese V2.3 延续了 OpenCSG 在中文高质量数据集建设上的方向:从海量中文内容中筛选更具教育价值、更适合模型学习的语料,让中文大模型不只是“读到更多中文”,而是能够“学到更好的中文”
1 v2.3 的核心价值

中文教育 SFT 数据长期面临高质量公开数据稀缺、教育网页内容与可训练问答格式之间存在断层、合成数据容易重复空泛且难以验证等问题。

Fineweb-Edu-Chinese V2.3 的目标是提供一批更适合直接进入监督微调流程的中文教育问答数据。

v2.3 重点提升三类能力:

  • 更稳定的中文教育回答能力:数据覆盖概念解释、事实问答、结构化总结、步骤推理和面向学习者的清晰表达。
  • 更高纯度的 SFT 训练输入:筛选目标从“是否像教育内容”升级为“是否适合生成可回答、可追溯、可训练的 SFT 样本”。
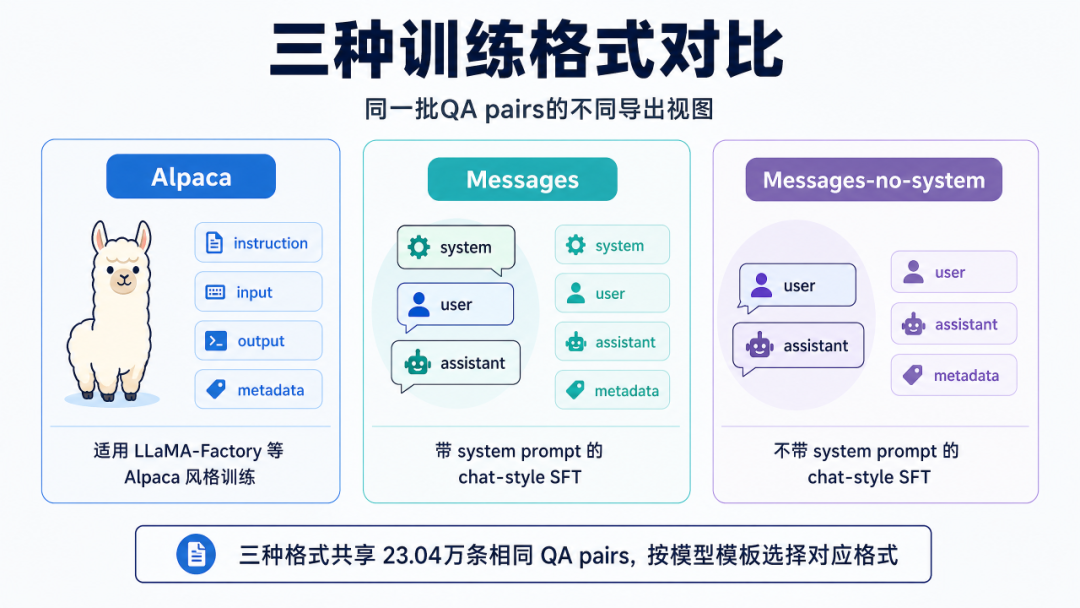
  • 更低接入成本的训练格式:同一批 QA pairs 同步提供 Alpaca、Messages、Messages-no-system 三种格式,方便直接接入常见训练框架。

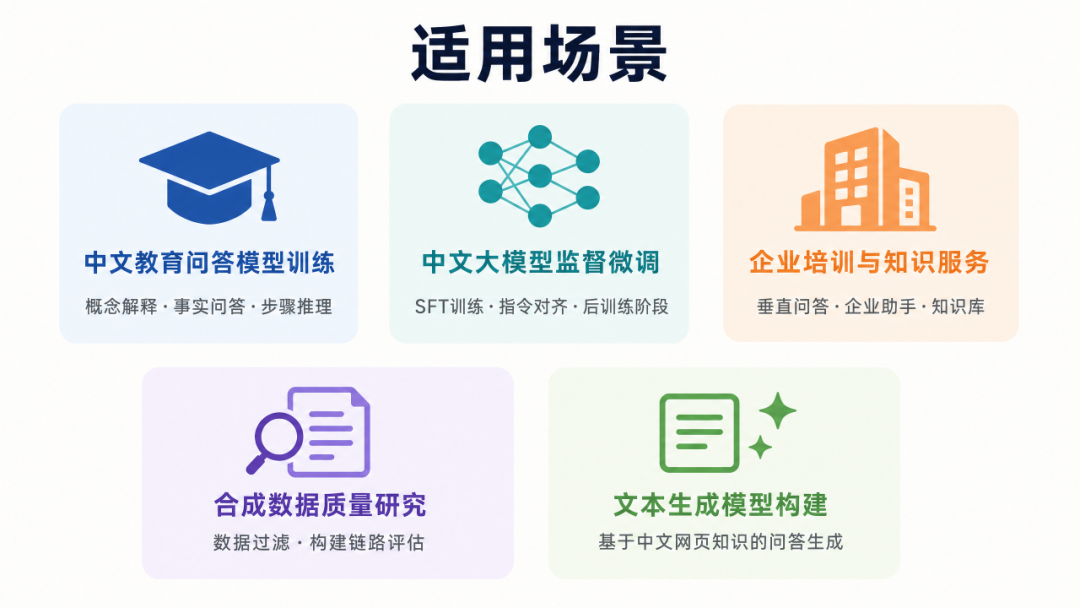
方便社区用户和产业团队直接接入常见训练框架,用于中文教育助手、知识服务、企业培训、垂直问答和文本生成模型建设。
2质量升级:规模更克制,筛选更严格

V2.2 将Fineweb-Edu-Chinese 系列从预训练语料推进到 SFT 问答数据,为社区提供了大规模中文教育问答样本;V2.3 则在此基础上进一步收紧质量门槛,更强调源文本选择、生成稳定性和训练可用性。

V2.3 的规模小于 V2.2,并不是因为数据能力下降,而是因为筛选标准更严格:系统不再只保留“看起来具有教育属性”的文本,而是进一步判断候选文本是否能够支撑稳定、清晰、有依据的 SFT 问答构造。

v2.3 加强了对长段回答重复句式、循环表达、异常中英文混入、乱码、网页模板、广告导航、弱证据样本和缺少来源约束回答的控制,让最终保留的数据更适合在后训练阶段提升模型回答质量。

3从源文本到可训练 QA pairs

V2.3 的筛选策略围绕一个核心目标展开:优先让更可能产出稳定、可回答、有教育价值问答的源文本进入后续构造流程。入选文本通常需要具备中文主体清晰、可读性强、语义连贯、结构完整、知识密度较高、信息相对自洽、能够为问题和答案提供明确依据、低重复低模板低噪声等特征。
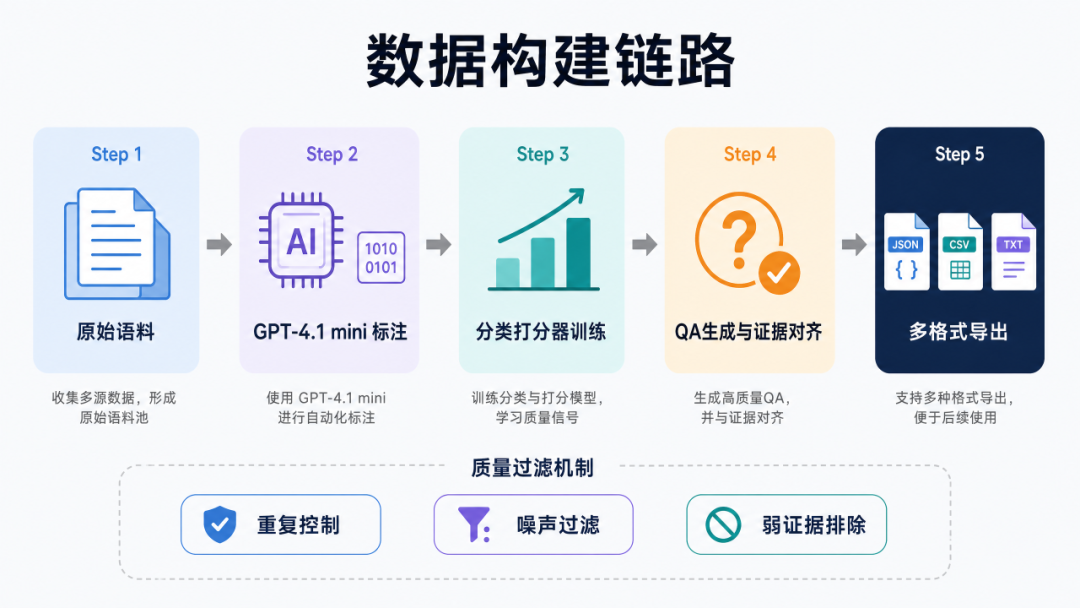
经过筛选的 selected source text 会进入 FineWeb-Edu-Ultra 数据构建链路,由 GPT-4.1 mini 生成问答,并经过证据对齐、格式校验和质量过滤后导出为训练格式。V2.3 的可复制难点不在于单次调用生成模型,而在于把大规模中文源语料治理、标注目标定义、筛选模型训练、问答生成和质量审计串成闭环,从源头判断哪些中文文本真正值得进入训练链路。

数据规格与仓库组织

同一批 QA pairs 同步提供 Alpaca、Messages、Messages-no-system 三种格式。由于同一问答会被导出为多种训练格式,实际训练时应根据模型模板选择对应 split。
真实样例

样例一:语文知识
Question
“什么是AABB结构成语?请结合摇摇摆摆、清清楚楚等例子说明其特点和表达作用,并举例说明正确与错误使用该类成语时可能带来的语义或语境差异。”
Answer
“AABB结构成语由两个相同的双字组成,例如“摇摇摆摆”、“恍恍惚惚”、“清清楚楚”等。这类成语通常用来形容某种状态或动作的持续性、反复性或强烈程度。以“摇摇摆摆”为例,它描述动作不稳或晃动的状态;“清清楚楚”则表示非常明白、明确。
通过填空练习,学生可以加深对这类成语构成和用法的理解与掌握。正确使用这类成语能够准确传递表达对象的特点,增强语言的生动性。例如:“树在风中摇摇摆摆”生动形象地描绘了树木的晃动。而错误使用可能导致语义模糊或语境不符,如将“清清楚楚”用于形容模糊的事物,会使表达产生矛盾,影响理解。
总之,掌握AABB成语的结构和语境适用,有助于提高语文表达的准确性和丰富性。”

样例二:工业自动化
Question
“组态软件如何利用实时多任务和多线程技术提升工业自动化中的数据采集与监控效率?其良好可靠性、可扩展性和封装性对系统性能和用户操作有哪些具体影响?请结合实例说明丰富的图形工具和设备驱动如何满足复杂工业需求。”
Answer
“组态软件通过采用多线程操作,实现了实时多任务处理,使其能够在工业自动化环境中快速响应各类数据采集与监控需求。多线程机制保证监控界面能够实时刷新,同时支持数据的及时输入与输出,从而提高了系统的响应速度和效率。
良好的可靠性依赖于稳定的硬件配置及供电系统配合,同时支持第三方程序接口,增强了软件与不同硬件及系统的兼容性,降低系统运行故障率。软件的可扩展性允许用户通过开发应用程序对控制系统进行微调和功能拓展,使系统能够适应不断变化的工业需求。封装性方面,组态软件将复杂的编程操作封装在图形化界面中,使非专业编程人员也能轻松通过图形界面完成系统配置,提高了用户操作的便利性和效率。
举例来说,丰富的图形工具和标准图形库支持用户快速创建直观的人机交互界面,便于实时监控生产过程。多样化的设备驱动程序则保障了不同硬件设备间的稳定通信,并支持自定义通信协议和驱动程序开发包,从而满足复杂工业自动化系统中多样化的设备接入与数据交互需求。总体而言,这些特性协同作用,有效提升了工业自动化系统的控制精度、运行稳定性及操作便捷性。”

快速开始

from datasets import load_dataset
ds_messages = load_dataset(
  "OpenCSG/Fineweb-Edu-Chinese-V2.3",
  split="train_messages",
)
  
ds_messages_no_sys = load_dataset(
  "OpenCSG/Fineweb-Edu-Chinese-V2.3",
  split="train_messages_no_sys",
)
  
ds_alpaca = load_dataset(
  "OpenCSG/Fineweb-Edu-Chinese-V2.3",
  split="train_alpaca",
)

OpenCSG全球开源生态

OpenCSG发布的FineWeb-Edu-Chinese作为全球下载量排名前三的中文预训练数据集,累计下载超百万次,其价值已经得到业界广泛认可:

  • 学术领域:被斯坦福大学、清华大学、中国人民大学高瓴人工智能学院、上海人工智能实验室、北京智源研究院等 20 余家顶尖机构的论文引用。旗下 Chinese Fineweb Edu 已成为中文 NLP 研究的核心数据资源,被 100 + 篇学术论文引用,在 NeurIPS、ACL、EMNLP、ICLR 等国际顶会及 Nature 子刊、JMLR 等权威期刊中作为核心实验数据集,支撑大模型预训练、指令微调等前沿研究,合作机构还包括鹏城实验室、西南电子技术研究所、西班牙国家级超算中心(Barcelona Supercomputing Center)及 Mozilla Data Collective等全球顶尖科研单位。
  • 产业应用:支撑 Llama3-Chinese、DeepSeek 等知名模型训练,并被中国移动、中国联通、英伟达(NVIDIA)、苹果公司(Apple Inc.)、OPPO、美团、阿里巴巴、蚂蚁集团、面壁智能(ModelBest)、Krafton等领军企业采用。Chinese Fineweb Edu 已从实验室走向产业场景,为创业公司到头部企业的研发团队提供可靠支撑,切实推动中文 NLP 应用从理论落地到生产实践。
  • 生态影响:下载数量累计超百万次,数据体量达 2.42TB,覆盖 9.57 亿条高质量文本,已孵化出 10 余个垂直领域微调模型。同时,OpenCSG 通过开源打分模型和完整工具链,输出数据治理方法论,带动行业从 “模型参数内卷” 转向 “数据基建完善”,显著降低中小开发者与研究机构的入门门槛。
  • 开源生态:OpenCSG 坚持“开源即文化”的理念,通过透明、共创、共享的社区文化,与全球开发者、工程师和 AI 原生企业共同构建智能体生态。

数据地址

OpenCSG社区:

https://opencsg.com/datasets/OpenCSG/Fineweb-Edu-Chinese-V2.3

Hugging Face社区:

https://huggingface.co/datasets/opencsg/Fineweb-Edu-Chinese-V2.3

魔搭社区:

https://www.modelscope.cn/datasets/OpenCSG/Fineweb-Edu-Chinese-V2.3

关于OpenCSG

OpenCSG 是全球领先的开源大模型社区平台,致力于打造开放、协同、可持续生态,AgenticOps是人工智能领域的一种AI原生方法论,由OpenCSG(开放传神)提出。AgenticOps是Agentic AI的最佳落地实践也是方法论。核心产品 CSGHub 提供模型、数据集、代码与 AI 应用的 一站式托管、协作与共享服务,具备业界领先的模型资产管理能力,支持多角色协同和高效复用。

探索中文大语言模型的未来:OpenCSG 中文语料库的构建与应用 OpenCSG 中文语料库包含一系列高质量的数据集,专门为 LLM 的预训练、后训练和微调而设计。这些数据集包括 Fineweb-edu-chinese、Fineweb-edu-chinese-v2、Cosmopedia-chinese 和 Smoltalk-chinese,每个数据集都有其独特的特点和应用场景。:专注于从多种中文网络来源筛选出的高质量内容。:在 v1 的基础上,数据量翻倍,并采用更严格的过滤标准。:提供合成的、教科书风格的数据,适用于知识密集型训练。 阅读详情

相关推荐

questasim的傻瓜式安装与仿真教程

一、安装 1、下载软件 链接:https://pan.baidu.com/s/1S05AnO_w-wy6RsAj_kdUXg 提取码:p2nt 2、根据电脑类型是32位还是64位,解压不同安装包。 解压得: 2、运行.exe文件,出现: 问题及解决办法: 这是杀毒软件造成的,因此在安装过程中关闭杀毒软件即可。关闭之后,再次运行.exe文件。 3、点击下一步,进入选择安装位置界面,如下:选择好安装位置后点击下一步。 4、点击同意 5、接下来等待安装结束即可,在安装过程中,会跳出来弹框,询问是否要添

树下等苹果的博客 3万+

全球最多下载中文开源数据集更新|OpenCSG持续打造中文高质量数据集开源底座

OpenCSG发布高质量中文教育数据集Fineweb-Edu-ChineseV2.2,包含1.5T预训练语料和143.7万条问答对,覆盖从预训练到监督微调全流程。该数据集通过DeepSeekV3.2从顶级语料中蒸馏生成,确保回答严格基于原文,有效减少模型幻觉。V2.2采用质量分层存储和课程学习策略,整合多个优质中文语料库,并引入OpenCSG评分模型筛选。该数据集已应用于高校、科研机构及企业,推动中文大模型研发。OpenCSG通过开源数据构建可持续的AI生态,遵循透明共享理念,提供从预训练到微调的全方位数据

OpenCSG的博客 1000

Unreal Engine鸿蒙移植实战:环境配置、构建流程与性能优化指南

游戏引擎移植是跨平台开发中的关键技术环节,其核心原理在于通过适配目标操作系统的底层接口和工具链,实现同一套代码在不同硬件和软件环境下的高效运行。这项技术的价值在于最大化代码复用率,降低多平台维护成本,并能让应用快速触达新兴生态系统的用户。在移动游戏和XR应用领域,随着鸿蒙HarmonyOS生态的快速发展,将成熟的商业引擎如Unreal Engine迁移至此平台,成为开发者探索新市场机会的重要路径。本文聚焦于Unreal Engine项目向鸿蒙系统的移植实践,详细解析了从环境搭建、源码适配到构建打包的全链路流

weixin_29011395的博客 404

OpenCSG开源数据贡献:构建AI时代的中文数据基石

OpenCSG的Chinese Fineweb Edu系列数据集,不仅仅是两个数据集的发布,更代表了一种以质量为先、以应用为导向的开源理念。从v1到v2的迭代,我们看到OpenCSG对数据质量的持续追求——从90M到188M条数据,从10万到100万条训练样本,从单一打分模型到更强大的V2版本。每一次升级,都是对"如何构建高质量中文教育数据"这一问题的深入探索。开源的力量在于共建共享。

OpenCSG的博客 702

【CUT&TAG分析-加了spike in的样品】

使用 Bowtie2 或 Subread (subjunc) 来构建大肠杆菌的索引。bowtie2比对时设置参数–local, 局部比对。

weixin_57975238的博客 1397

大模型风电功率预测:短期,超短期,中长期的完整实现与代码详解

本文全面介绍了基于深度学习大模型的风电功率预测方法,涵盖超短期(15分钟-1小时)、短期(1-6小时)和中长期(1天-1周)三种时间尺度。文章详细阐述了数据准备与特征工程,包括数据收集、预处理和可视化分析。针对不同时间尺度,分别介绍了Temporal Fusion Transformer (TFT)、Informer和N-BEATS模型的构建、训练与评估方法,并提供了完整的开源代码实现。此外,文章还探讨了模型部署与生产环境集成,包括模型保存与加载、实时预测API以及模型监控与再训练。最后,文章总结了关键创新

专注AI大模型,软件混淆,授权 1888

OpenCSG月度更新2026.2

2026年2月,OpenCSG在AI领域取得重大进展:产品方面发布AgenticHub v0.4和CSGHub v1.16.0-ce两大版本,新增图生视频、vGPU支持等功能;市场合作方面与数据堂、MemVerge达成战略合作,推出企业级OPC平台;生态建设上发布高质量中文数据集Fineweb-Edu-ChineseV2.2;社区精选推荐多款前沿开源模型。本月系列升级强化了OpenCSG在开源大模型与智能体生态的核心地位,推动企业AI规模化落地。

OpenCSG的博客 727

Unity Hololens2开发|(一)环境配置

开发过程中预览和调试应用:可以在电脑上的 Unity 编辑器中以播放模式本地运行应用,并将体验流式传输到 HoloLens2。将来自 HoloLens2 的输入(视线、手势、语音和空间映射)发送到电脑,在其中内容以虚拟沉浸式视图渲染。在HoloLens2设备中,打开Settings面板,依次选择Update & Security > For Developers,打开“Developer Mode”。在开发计算机中打开控制面板,依次选择“更新和安全> 开发者选项”,打开“开发人员模式”;

游戏开发小Y的博客 14万+

OpenCSG月度更新2026.1

2026 年 1 月,OpenCSG(开放传神)围绕产品迭代、市场落地、生态建设与社区运营四大核心方向稳步推进,各项工作取得丰硕成果。产品层面,平台功能持续打磨升级,AgenticHub v0.3、CSGHub v1.15.0-ce 两大核心版本重磅发布,社区功能、企业版专属能力同步优化,全面提升平台易用性、安全性与功能性;市场层面,成功落地新能源汽车、科研机构两大经典案例,以私有化 AgenticOps 平台助力产业与科研机构实现 AI 高效研发与安全合规;

OpenCSG的博客 936

手把手教你学simulink(31.17)--双向DCDC电源场景示例:基于simulink 的双向DCDC应用:车载充电器的pi控制

通过引入PI控制器,系统可以更精确地控制电压和电流,确保充电和放电过程的稳定性和高效性。

MHD0815的博客 205

Python爬虫实战:利用Playwright+Asyncio高效获取淘宝商品价格变化曲线

本文将详细介绍如何使用Python最新技术栈(Playwright+Asyncio)构建一个高效的淘宝商品价格监控爬虫系统。我们将从爬虫基础知识讲起,逐步深入到反爬应对策略、数据存储与分析,最终实现价格变化曲线的可视化展示。文章包含完整的代码实现和详细的技术解析,适合中高级Python开发者学习参考。关键词:Python爬虫、Playwright、Asyncio、淘宝价格监控、数据可视化支持多浏览器(Chromium, Firefox, WebKit)更快的执行速度更丰富的API。

2201_76125261的博客 244

当顶会论文揭示“好数据被浪费“,OpenCSG 中文数据基础设施的价值正在被看见

清华大学与鹏城实验室研究发现,大模型训练中高质量数据可能因学习率衰减而被"浪费"。研究指出,传统课程学习将高质量数据安排在训练后期时,衰减的学习率会限制这些数据的效用。论文提出三种改进策略:调整学习率衰减幅度、采用模型平均法(CMA)以及组合方案(CDMA),实验证明这些方法能提升模型性能1.2%-2%。该研究凸显了数据调度策略的重要性,表明大模型训练正从"数据量"转向"数据质量利用"。OpenCSG的中文教育数据集Fineweb-Edu-Chinese-V2.1因质量分层设计被用于相关研究,体现了高质量中

OpenCSG的博客 391

C#上位机实战:PLC与检测设备无缝对接,构建产品质量实时判定系统

本文分享了基于C#开发的汽车零部件质量检测系统实现经验。系统采用三层架构:设备层(PLC/视觉相机/三坐标)、通信层(OPC UA/SDK/串口)和应用层(数据采集/判定/存储)。重点解决了三大技术难点:1)通过OPC UA订阅模式将PLC通信延迟从500ms降至50ms;2)反编译厂商Demo破解视觉SDK对接难题;3)采用时间戳+产品ID实现多设备数据同步。系统上线后质检人员减少67%,误判率降至0.5%,数据追溯效率显著提升。文章强调工业场景下稳定性优先于技术复杂度,实用经验值得借鉴。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 799

开源密码管理与双因素认证工具离线镜像合集

本集合汇总等开源密码管理与双因素认证相关离线包。侧重密码箱与 2FA,与「安全审计/渗透扫描」合集错开。

225

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

百度开源文心5.5 Flash Base:280B MoE 只激活 14B,4 步部署 + 3 个坑,微调还是等指令版

百度开源文心 5.5 Flash 基座权重:280B MoE 每 token 激活 14B,1M 上下文,同尺寸开源 Base 30 项基准多数领先。4 步部署(vLLM/SGLang completions 链路)+ 3 个高频坑 + 动手前 6 点核对清单,并给出微调 Base 还是等指令版的判断线。

weixin_50937681的博客 246

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

GitHub 开源趋势日报 | 2026-11-08

每日精选 GitHub Trending 热门项目,聚焦 AI 与大模型、Agent 智能体领域,带你用一篇文章看懂开源风向。

weixin_45631123的博客 258

云捷EMS开源能源管理系统JAVA实战,好用的能源管理系统

云捷EMS是一款开源能源管理系统,覆盖物联网网关、数据采集、分析与可视化全链路,支持50余种工业协议,适配水、电、汽、光伏等多类能耗设备。系统基于微服务架构,采用SpringBoot+Vue3技术栈,支持MQTT、WebSocket双通道采集,具备低代码大屏配置、实时数据与预计算分析能力,助力企业实现能耗监测、节能降耗与碳管理数字化,可直接部署或二次开发,适用于工厂、园区等高耗能场景。

weixin_42648890的博客 223

【QT入门到晋级】用开源的自定义控件开发

直接点击mainwindow.ui文件是看不到quc控件的,关键步骤是右键点击mainwindow.ui,右键菜单选择【Qt Designer】,在UI设计器中才能找到“Quc Widget”。注意:以上是前端调用自定义控件的方式,需要编译动态库等操作,相对要麻烦一些。如果有自定义控件的源码.h和.cpp文件,直接加入到现有qt项目中,以后台方式直接调用即可,以下是我分享过一个手搓的自定义控件类【QT自定义2D控件】QGraphics绘制仪表盘_qt仪表盘控件-优快云博客。

ocy的博客 175

52万 Star 的“列表的目录”:sindresorhus/awesome 如何用一套治理规则,成为全球开源资源的信任锚点

awesome 是 Sindre Sorhus 维护的开源索引项目,无一行可运行代码,却以超 52 万 Star 长居 GitHub 第二。它作为“列表的目录”,通过严格治理(30 天考察期、awesome-lint 校验、CC0 许可、贡献者评审机制)筛选高质量资源清单,成为开发者寻找优质技术资源的可信入口。虽不保证内容实时性,但其“筛选即认证”的模式重塑了信息获取方式,推动形成整个 Awesome 生态规范。

下载资源或查看教程前,请务必阅读置顶的《免责声明》 416

skill-up阿里开源Agent-Skill评估工具详解

它把「Agent 行为」这个一直靠感觉和运气的东西,变成了可声明、可执行、可回归、可演进的工程对象。对开发者:写 Skill 终于有了「单元测试 + 回归测试 + CI」;对团队:Skill 质量从「个人手艺」变成「团队资产」;对生态:Anthropic 兼容的evals.json导入 + 多引擎支持,降低了迁移和对比成本。Apache-2.0 许可、Go 编写、Windows 友好、中英双语文档——对国内开发者来说几乎零门槛。

277

【FDE知识库】(4):企业知识库怎么选型,开源知识库分享几个,选择开源协议友好的版本,开发wiki-go项目

本文介绍企业内部搭建Wiki的主流开源项目,涵盖现代化(如Wiki.js、BookStack)、轻量级(MM-Wiki)、经典老牌(DokuWiki、XWiki、MediaWiki)及基于Git的文档即代码方案(Docusaurus等)。重点推荐将BookStack核心功能迁移至Go语言的Wiki Go项目,采用GoFrame框架实现单二进制部署,支持SQLite与本地文件存储,保留“书-章-页”结构与权限体系,架构清晰可扩展,适合中小团队快速私有化部署。

freewebsys的专栏 171

二十分之一的压缩比:Spatial Vivid 1.0 把 3DGS 全链路参考实现按 MIT 开源了

一个高斯点携带的属性是固定的:位置 3 个 float,不透明度 1 个,三个轴的尺度 3 个,旋转四元数 4 个,剩下全是球谐系数。MIT 覆盖的是这次公布的参考工具,标准文本本身和可能存在的必要专利,授权条件不在这次公告的范围内。主论坛上宣布的事,到 11 月 2 日才由 IT之家 的报道扩散开来:Spatial Vivid 1.0(空间菁彩影像)标准的参考工具开源,包括 EGSC 编解码工具、Web 渲染器工具、封装解封装工具在内的全链路参考实现,以 MIT 协议面向全球开发者开放。

weixin_43043455的博客 224

开源PonWrt:让光猫刷上开源固件`

弱电箱里的光猫,大多是运营商送的:能上网,想自己装插件、改配置,基本没门。想在光猫上跑 OpenWrt,前几年基本没谱;这几年 Airoha的盒子涌进二手市场,内存和闪存都不差,有的还带 2.5G 口。价钱从前年几十块炒上来,现在也不算便宜,才有人做开源固件。,社区常展开成 Passive Optical Network Wireless RouTer,简单说就是给这类 xPON 光猫用的开源固件。它基于(OpenWrt 系),专门补上 AN7581 / AN7583 的板级支持和 PON 能力。

buhuidage的博客 375

开源交易 Agent Vibe-Trading 本地部署+回测实战

一个 3.7 万 star 的开源交易 Agent,一条 pip 命令就能装好,号称能把问题直接变成回测报告。我在没有 Docker 的环境里把它跑起来后,第一件事就是怀疑它给出的回测结论——第一次跑出的策略收益好得离谱…

2301_80281820的博客 187

(开源)宠物共享平台实战指南 基于 Java + SpringBoot + Web + MySQL

这是一个基于 Java + SpringBoot + Vue + MySQL 构建的完整宠物共享平台(管理端为 Vue,用户端为纯静态 Web 站,由后端直接托管),功能持续优化中...用户登录 / 注册 宠物寄养管理 / 寄养审核 寻宠启事管理 / 认领审核 宠物视频管理 / 视频收藏 / 视频留言 感谢信管理 公告管理 轮播图信息管理 基础数据管理 用户管理 / 管理员管理 个人中心 其它...

小小码农身兼魔法师职位!除你武器~ 388

Rust重写开源版Photoshop来了,支持PSD编辑,还能让AI Agent直接操作图像

PhotoCraft 是一个基于 Rust 开发的开源专业图像编辑器,旨在以原生高性能架构重构 Photoshop 级工作流。它提供图层、蒙版、调整图层、矢量绘图、文字排版、智能滤镜以及高兼容性的 PSD 支持,同时通过 CLI、JSON 控制接口和 MCP Server 具备面向 AI Agent 的自动化能力。

Tony.Dong的专栏 243
上一篇: CSGLite v0.9.3版本更新
下一篇: 百万年薪、创始股权,OpenCSG招聘最懂AI的应届生
OpenCSG
博客等级 码龄3年 1679粉丝 575原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值