OpenCSG开源数据贡献:构建AI时代的中文数据基石

国内独家首发 | OpenCSG开源中文版fineweb edu数据集 这些数据涵盖了从2013年至2024年的网页内容,通过精心设计的处理流程,FineWeb提供了丰富且多样的高质量语料资源,为训练更强大、更精确的语言模型提供了高质量数据。通过实验结果可以发现,在训练的靠后阶段,可能是由于进入了第2个epoch,且学习率进入快速下降阶段,训练的效果开始逐渐涌现,此时,使用chinese-fineweb-edu训练的模型,准确率有了明显的上升,而使用随机抽取的数据训练,则一直处于较低水平。这种数据整合方式确保了模型在面对多样化的教育场景时,能够保持卓越的表现和高质量的输出。 阅读详情

引言:为什么大模型需要"好数据"?

在人工智能快速发展的今天,一个有趣的发现正在改变大模型的训练方式:LLM从教育内容中学习会更好更快。这并非凭空猜测,而是Llama3、Phi3等顶尖模型训练过程中验证的核心经验。

想象一下,如果让一个学生同时阅读教科书和充斥广告、垃圾信息的网页,哪种内容更能帮助他建立系统的知识体系?答案显而易见。对于大语言模型来说,道理完全相同。普通的互联网爬取内容价值参差不齐——奇怪的数据转储、广告垃圾邮件、无关的股票行情更新,这些"噪音"会分散模型的"注意力",影响其学习效果。

教育级数据的价值在于:它们结构清晰、逻辑连贯、知识密集,能够帮助模型更高效地学习推理能力和知识表达方式。正如AI大牛Andrej Karpathy所说,挑战在于从海量互联网内容中挑出"钻石"——那些真正有价值的教育内容。

OpenCSG正是基于这一理念,推出了Chinese Fineweb Edu系列数据集,为中文大模型提供了高质量的"教科书级"训练素材。

Fineweb系列的起源:开创性的教育数据筛选

HuggingFace的FineWeb-Edu

2024年5月,HuggingFace团队推出了FineWeb数据集——一个包含15万亿token(44TB磁盘空间)的大规模预训练数据集,源自96个CommonCrawl快照。更重要的是,他们在此基础上发布了FineWeb-Edu子集,这是一个专注于教育内容的1.3万亿token数据集。

FineWeb-Edu的创新之处在于:使用Llama-3-70B-Instruct大模型对50万条样本进行教育价值评分,然后训练一个专用分类器,将这一评估能力扩展到整个数据集。实验结果令人振奋:在MMLU基准测试上,使用FineWeb-Edu训练的模型准确率从33%提升到37%(相对提升约12%);在ARC推理基准上,性能从46%跃升至57%(提升24%)。

这一工作证明了教育数据筛选的巨大价值,也为OpenCSG团队提供了重要启发。

中文教育数据的空白

然而FineWeb-Edu主要针对英文内容。中文领域长期面临高质量教育数据稀缺的问题——虽然国内有CCI2-Data、SkyPile-150B等数据集,但质量参差不齐,缺乏系统的教育价值筛选。这一空白直接制约了中文大模型在教育、知识密集型任务上的表现。

OpenCSG算法团队决定填补这一空白,将FineWeb-Edu的成功经验引入中文领域,构建了Chinese Fineweb Edu系列数据集。
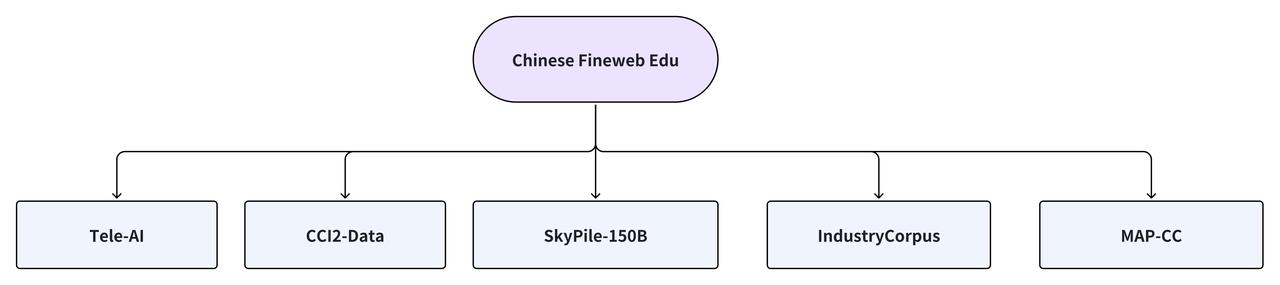
数据集整合了国内外优质中文网络资源:

Chinese Fineweb Edu v1:国内首个教育级预训练数据集

数据集核心特点

2024年9月,OpenCSG正式发布Chinese Fineweb Edu v1,这是国内首个对标国际标准的高质量中文教育预训练数据集。

核心指标:

  • 数据规模:约9000万条(90M)高质量中文文本

  • 总容量:约300GB精选内容

  • 数据来源:融合CCI2-Data、SkyPile-150B、IndustryCorpus、TeleChat-PTD、MAP-CC五大权威数据集

  • 教育价值:专为教育领域NLP任务和大模型预训练优化

为什么要做教育筛选?

教育内容vs普通网页的价值差异体现在:

教育内容的特征:

  • 结构清晰,逻辑连贯

  • 知识密集,信息价值高

  • 语言规范,表达准确

  • 适合系统性学习

普通网页的问题:

  • 充斥广告和宣传材料

  • 内容碎片化,缺乏深度

  • 大量重复和无关信息

  • 语言质量参差不齐

OpenCSG采用六级教育价值评分体系(0-5分),对每条数据进行精细评估:

  • 0分:无任何教育价值,完全由广告等无关信息组成

  • 1分:提供基本教育相关信息,但包含较多无关内容

  • 2分:涉及教育元素,但与标准不太吻合,内容浅显或不连贯

  • 3分:适合教育使用,介绍了与学校课程相关的关键概念,内容连贯但可能不全面

  • 4分:高度相关且有益于中学水平教育,写作风格清晰,提供大量教育内容,极少无关信息

  • 5分:教育价值卓越,完全适合小学或中学教学,推理详细,易于理解,提供深刻全面的见解

只有得分4分以上的数据才会被保留,这确保了数据集的高质量标准。

三层质量保障体系

Chinese Fineweb Edu v1采用“大模型+专用模型+去重”三层筛选机制:

第一层:大模型教育价值评估使用OpenCSG自研的csg-wukong-enterprise企业版大模型作为打分模型,对海量样本进行初步教育价值评分。从中选取约10万条高分样本作为种子数据。

第二层:专用BERT模型规模化筛选将10万条标注数据用于训练fineweb_edu_classifier_chinese专用BERT模型。这个轻量级模型继承了大模型的评判标准,可以高效处理TB级数据,仅保留得分>4的高质量内容。

第三层:MinHash去重处理采用MinHash算法对筛选后的数据进行去重,确保数据独特性和多样性,避免重复内容对模型训练产生负面影响。

如何用于模型训练?

Chinese Fineweb Edu v1主要应用于以下场景:

  1. 大模型预训练 作为预训练阶段的主要或辅助数据源,帮助模型建立扎实的知识基础和推理能力。相比使用普通网页数据,教育数据能让模型更快收敛,学到更系统的知识表达方式。

  2. 知识密集型任务 特别适合训练需要深度理解和推理的模型,如:教育问答系统、知识图谱构建、学术文本生成、智能辅导应用

  3. 领域迁移学习 当将通用模型微调到特定领域时,使用教育数据可以减缓模型"遗忘"通用能力的速度,保持推理能力的同时适应新领域。

训练效果验证:消融实验

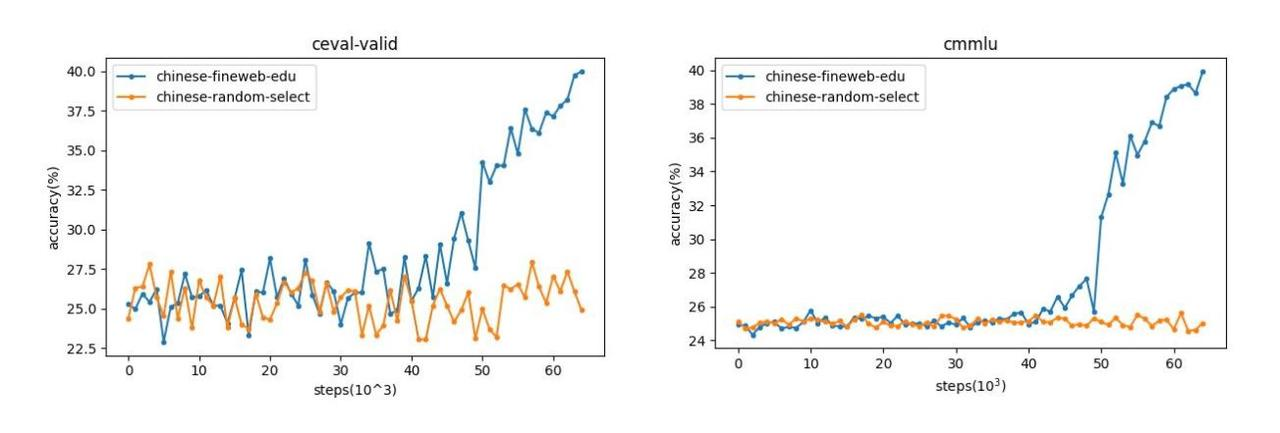
OpenCSG团队进行了严格的消融实验来验证数据集质量。实验设计如下:

实验设置:

  • 模型规模:2.1B参数

  • 训练步数:65,000步

  • 对比数据集:

    • 实验组:Chinese Fineweb Edu v1

    • 对照组:从五大数据集随机抽取相同比例样本(chinese-random-select)

  • 评测基准:CEval和CMMLU(两大中文评测标准)

实验结果:

在训练初期,两组数据表现相近。但进入训练后期(第2个epoch,学习率快速下降阶段),使用Chinese Fineweb Edu训练的模型准确率显著上升,而使用随机数据训练的模型停滞在较低水平。

这一结果清晰证明:Chinese Fineweb Edu具有更高的数据质量,能够在相同训练时间下更快提升模型的推理和知识能力。这与英文版FineWeb-Edu的表现完全一致,验证了教育数据筛选方法的有效性。

性能表现
使用Chinese Fineweb Edu v1训练的1.8B参数模型在多个中文基准测试上表现优异:

Chinese Fineweb Edu v2:数据规模与质量的双重飞跃

重磅升级亮点

2024年10月,OpenCSG推出Chinese Fineweb Edu v2,这是对v1的全面升级,实现了数据规模和质量的双重突破。

核心升级指标:

  • 数据规模:从90M条增至188M条,翻倍增长

  • Token数量:约420B tokens,是v1的显著提升

  • 数据来源:新增Industry2、CCI3、michao、wanjuan1.0、wudao、ChineseWebText等高质量数据集

  • 打分模型:升级为更强大的csg-wukong-enterprise V2

  • 训练数据:打分模型训练数据从10万条增至100万条,涵盖书籍、新闻、博客等多种文本类型,包含25%英文数据

更强大的打分模型

v2版本的核心突破在于打分模型的全面升级。新的csg-wukong-enterprise V2模型具有:

  • 更大参数量:提升语义理解深度

  • 更丰富训练数据:100万条多类型文本,覆盖面更广

  • 更精准评估能力:特别在中文文本理解和教育价值判断上表现出色

  • 更细致的分析:能够捕捉文本结构、内容质量和深层语义信息

这意味着v2的数据筛选更加精准,能够识别出更多真正具有教育价值的内容,同时过滤掉更多低质量数据。

Prompt优化与评分标准

v2版本对评分Prompt进行了优化,新的评分标准更加明确地强调了写作水平、教育价值和实用性三个维度:

评分过程会综合考虑:文本的结构化程度、知识的系统性和深度、语言的规范性和易理解性、内容对教育场景的适配性

通过csg-wukong-enterprise V2模型评分后,v2选取了3分以上的文本(相比v1的4分以上),这一调整在保证质量的同时,进一步扩大了数据规模,最终达到188M条数据、420B tokens的规模。

数据来源的大幅扩展

v2在v1的五大数据源基础上,新增了六个高质量数据集:

新增数据源:

  • Industry2:扩展的行业语料,覆盖更多垂直领域

  • CCI3:升级版的高质量安全数据

  • michao:专业领域数据补充

  • wanjuan1.0:多样化的中文语料

  • wudao:大规模知识图谱相关数据

  • ChineseWebText:优质中文网页文本

这种多源融合策略确保了数据集的广泛适用性和内容多样性,使模型能够学习到更全面的知识和更丰富的语言表达方式。

更智能的双模型评分系统

v2版本采用创新的双模型协同评分机制:

实际应用场景

Chinese Fineweb Edu v2的高质量和大规模特性,使其在多个实际场景中发挥重要作用:

教育AI应用:智能辅导系统、自动作业批改、个性化学习、推荐教育内容生成

知识服务:智能客服(教育、医疗、法律等专业领域)、知识问答系统、文档智能处理、内容摘要与理解

模型开发:中文大模型预训练、领域模型微调、多模态模型训练(配合视觉数据)、对话系统优化

模型训练价值:为什么选择教育数据?

提升推理和知识能力

使用Chinese Fineweb Edu系列训练的模型,在多个维度表现出显著优势:

  1. 知识密集型基准 在MMLU(大规模多任务语言理解)、ARC(AI2推理挑战)、CMMLU(中文多任务理解)等基准测试中,使用教育数据训练的模型准确率明显高于使用普通数据的模型。

  2. 推理能力增强 教育内容的结构化和逻辑性,帮助模型学习到更好的推理模式。模型不仅记住知识,更能理解知识之间的关联和推理路径。

  3. 知识表达规范 教育数据的语言规范性,使模型学会更准确、更专业的表达方式,减少生成内容的错误和不确定性。

教育场景的天然优势

教育数据与教育场景应用存在天然的契合:

智能客服:当用户咨询专业问题时,模型能够提供结构清晰、逻辑严密的回答,而不是碎片化的信息堆砌。

内容生成:无论是生成教学材料、解释复杂概念,还是撰写报告,模型都能保持教育内容应有的严谨性和系统性。

教育AI:从作业批改到学习路径规划,模型对教育内容的深度理解,使其能够更好地服务教育场景。

对比普通数据集的优势

维度普通网页数据Chinese Fineweb Edu
内容质量参差不齐,噪音多高质量,系统化
知识密度低,碎片化高,结构化
训练效率慢,易分散注意力快,学习更聚焦
模型性能基准测试表现一般显著提升推理和知识能力
应用适配通用但不精准特别适合教育和知识场景

消融实验的数据清楚展示:在相同训练资源下,教育数据能让模型更快达到更好的性能。这对于计算资源有限的团队和研究者来说,意义重大。

高校和业界的认可

Fineweb-Edu-Chinese-V2.1 的卓越品质和实用价值获得了全球顶尖学术机构与行业领导者的高度认可和广泛应用。以下是采纳机构名单:

高校与研究机构: 斯坦福大学(Stanford)、清华大学(Tsinghua)、中国人民大学高瓴人工智能学院、上海人工智能实验室(Shanghai AI Lab)、北京智源研究院(BAAI)等。

企业应用: 英伟达(NVIDIA)、面壁智能(ModelBest)、中国移动、中国联通等。

结语:开源赋能,共建中文AI未来

OpenCSG的Chinese Fineweb Edu系列数据集,不仅仅是两个数据集的发布,更代表了一种以质量为先、以应用为导向的开源理念。

从v1到v2的迭代,我们看到OpenCSG对数据质量的持续追求——从90M到188M条数据,从10万到100万条训练样本,从单一打分模型到更强大的V2版本。每一次升级,都是对"如何构建高质量中文教育数据"这一问题的深入探索。

开源的力量在于共建共享。OpenCSG不仅开源了数据集,还计划开源打分模型(fineweb_edu_classifier_chinese)和标注数据,为整个社区提供完整的工具链。这种开放态度,正是推动中文AI生态发展的关键。

未来的AI,需要更好的"教育"。当我们用高质量的教育数据训练模型时,我们不仅是在提升基准测试分数,更是在让AI真正学会如何系统地理解知识、如何准确地表达思想、如何有效地服务于教育和知识场景。

我们诚邀对AI和开源技术感兴趣的开发者、研究者加入OpenCSG社区。无论是使用这些数据集训练自己的模型,还是贡献改进建议,每一份参与都将推动中文AI生态向前发展。

让我们携手,为中文AI构建更优质的"教育基础"!


数据集下载地址:

  • Chinese Fineweb Edu v1:

  • huggingface地址:https://huggingface.co/datasets/opencsg/chinese-fineweb-edu

  • opencsg社区地址:https://opencsg.com/datasets/OpenCSG/chinese-fineweb-edu

  • Chinese Fineweb Edu v2:

  • huggingface地址:https://huggingface.co/datasets/opencsg/chinese-fineweb-edu-v2

  • Chinese Fineweb Edu v2.1:

  • huggingface地址:https://huggingface.co/datasets/opencsg/Fineweb-Edu-Chinese-V2.1

  • opencsg社区地址:https://opencsg.com/datasets/AIWizards/Fineweb-Edu-Chinese-V2.1

  • OpenCSG社区:https://opencsg.com

  • GitHub组织:https://github.com/OpenCSGs

关于 OpenCSG

OpenCSG (开放传神)是全球领先的开源大模型社区平台,致力于打造开放、协同、可持续生态,AgenticOps是人工智能领域的一种AI原生方法论,由OpenCSG(开放传神)提出。AgenticOps是Agentic AI的最佳落地实践也是方法论。核心产品 CSGHub 提供模型、数据集、代码与 AI 应用的 一站式托管、协作与共享服务,具备业界领先的模型资产管理能力,支持多角色协同和高效复用。

关于 CSGHub

CSGHub是由OpenCSG(开放传神)推出的企业级模型与数据资产管理平台,旨在为组织提供 Hugging Face 式的高效协作体验,同时满足本地化部署、数据安全与法规合规。

平台支持与 Hugging Face 工作流无缝兼容,并提供多源同步、私有镜像、全离线运行等特性,帮助企业在安全可控的环境中实现AI 研发与部署的全生命周期管理。

OpenCSG开源中文数据:AI时代的基石与挑战 在自然语言处理(NLP)领域,高质量数据集是模型训练的基础。中文数据因其独特的语言特性(如无空格分隔、丰富多义词)面临更大技术挑战,需要专门的分词和语义表示技术。开源项目OpenCSG通过分层架构(原始数据→清洗→标注)构建标准化中文语料库,覆盖法律、医疗等垂直领域。其价值在于降低AI应用门槛,例如仅用两周就能构建高精度电商情感分析系统。对于开发者而言,参与数据贡献或使用开源数据集,既能提升模型效果,又能推动中文AI生态发展。 阅读详情

相关推荐

OpenCSG:解决中文AI数据基建与模型微调的开源社区

在人工智能工程化实践中,数据质量是决定模型效果上限的核心因素。构建一条从采集、清洗到去重、过滤的高质量数据管道,已成为大模型训练的关键环节。与此同时,合成数据作为真实数据的有效补充,能够解决长尾分布与隐私合规的难题,从而降低数据获取成本。针对中文场景,标准化数据治理、可复用的模型微调工具以及开放协作的社区生态,正在成为降低AI落地门槛的重要支撑。OpenCSG作为中文AI基础设施的典型代表,将数据、模型与工具链一体化开放,覆盖数据处理、模型微调、推理部署等完整流程,帮助开发者快速构建稳定可靠的AI应用,推动

weixin_33402252的博客 241

重磅升级 | OpenCSG开源中文版fineweb edu v2数据集

这些数据涵盖了从2013年至2024年的网页内容,通过精心设计的处理流程,FineWeb提供了丰富且多样的高质量语料资源,为训练更强大、更精确的语言模型提供了高质量数据。通过实验结果可以发现,在训练的靠后阶段,可能是由于进入了第2个epoch,且学习率进入快速下降阶段,训练的效果开始逐渐涌现,此时,使用chinese-fineweb-edu训练的模型,准确率有了明显的上升,而使用随机抽取的数据训练,则一直处于较低水平。这一进步显著提高了数据筛选的可靠性,为后续的模型训练提供了更有力的保障。

OpenCSG的博客 2205

宏基因组功能注释实战:从CAZyme到VFDB的完整流程(含数据库下载与脚本优化)

本文详细介绍了宏基因组功能注释的完整流程,涵盖CAZyme、eggNOG、CARD和VFDB四大核心数据库的实战应用。从环境配置、数据库下载与预处理到注释流程执行与优化,提供了全面的操作指南和脚本优化建议,帮助研究人员高效完成宏基因组数据分析。特别针对CAZyme注释等关键步骤给出了参数优化方案和常见问题排查方法。

weixin_29289821的博客 294

OpenCSG开源数据贡献:中文AI数据的破局者

在人工智能快速发展的今天,高质量的训练数据已成为大模型性能的关键决定因素。然而,相较于英文领域丰富的数据资源,中文AI训练数据长期面临着"量大质低"的困境。国内虽有不少数据集,但质量参差不齐,难以支撑中文大模型的持续突破。在这样的背景下,OpenCSG作为全球领先的开源大模型社区,以其独特的开源理念和技术创新,为中文AI生态带来了突破性的数据贡献。

OpenCSG的博客 1116

【CVPR 2025】清华:注意力状态空间模块,Mamba与注意力的超强组合,即插即用!

MambaIRv2提出了一种创新的图像恢复模型,通过引入注意力状态空间模块(ASSM)解决了Mamba模型因果建模限制问题。该模型结合语义引导邻域机制和注意力状态空间方程,实现了非因果建模,有效缓解了长距离衰减问题。实验表明,MambaIRv2在图像超分辨率、JPEG压缩伪影减少和图像去噪等任务中表现优异,参数更少但性能超越现有方法。

qq_43303160的博客 3039

从一个过气考渣的角度看LLM智能化测试用例生成

根据业务需求生成测试用例,会涉及到相关上下文的召回、用例生成等场景。除了用例生成之外,也可以考虑应用LLM进行用例评审。因此,本文将涉及以下内容。

software_test010的博客 827

OpenCSG开源数据贡献:Chinese Fineweb Edu

OpenCSG的Chinese Fineweb Edu系列数据集,代表了一种以质量为先、以应用为导向的开源理念。从登顶Hugging Face数据榜,到赋能千行百业的实际应用,从被全球60+个国家和地区采用,到影响30+种语言的数据集建设,OpenCSG证明了中国开源力量在推动全球AI技术进步中的关键作用。每一次数据的迭代,都是对"如何构建高质量中文知识库"这一命题的深入解答。作为全球下载量排名前三的中文预训练数据集,Chinese Fineweb Edu已成为国际AI社区公认的基础设施标杆。

OpenCSG的博客 787

【Python爬虫系列】_005.浏览器开发者工具(详解)

Elements(元素)分析当前页面节点,用来辅助书写BS或者XPath这里面的数据与源代码有区别,不一定准确(避坑)Console(控制台)这个除了查看错误信息、打印调试信息(console.log())、写一些测试脚本以外,还可以当作Javascript API查看用例如我想查看console都有哪些方法和属性,我可以直接在Console中输入"console"并执行后续学js逆向的时候需要用到Sources(源代码)与在网页页面,鼠标右键——查看网页源代码 内容一致。

weixin_50296259的博客 422

Huggingface终于没忍住,OpenCSG坚持开源开放

全球AI竞争加剧,开源与闭源路径选择成为关键。HuggingFace转向"有限开源"以平衡商业与合规需求,而中国开源社区OpenCSG坚持"主权AI"理念,构建自主可控的AI基础设施。OpenCSG依托CSGHub平台托管超20万模型,并首创AgenticOps方法论,推动智能体全生命周期管理,已在金融、医疗等领域实现规模化应用。其开源开放策略不仅促进AI民主化,更为国家数字主权提供保障,展现中国在AI赛道的前瞻性。

OpenCSG的博客 1160

LPDDR6 Efficiency Mode 技术探讨

LPDDR6 Efficiency Mode 技术探讨

zilan23的博客 1156

5、Raspberry Pi CPU架构与多线程编程详解

本文详细介绍了Raspberry Pi的CPU架构(包括ARMv6Z、ARMv7-A和ARMv8-A),通过/proc/cpuinfo解析硬件信息,并深入探讨了多线程编程的核心技术。内容涵盖pthread库的使用,如线程创建、属性设置、等待与分离、线程同步机制(互斥锁),以及实际应用场景如多媒体处理和网络服务。同时强调了线程安全、死锁预防和资源管理等关键注意事项,帮助开发者在Raspberry Pi上构建高效稳定的多线程应用。

sre5engineer的博客 93

OpenCSG(开放传神)开源数据贡献解析:3大标杆数据集,筑牢中文AI基建

从填补中文高质量数据空白,到树立数据治理行业标准;从搭建一站式基础设施,到推动生态普惠,OpenCSG(开放传神)用每一项开源数据贡献,推动中文AI从“模型内卷”走向“基建完善”。对于AI开发者而言,OpenCSG的开源数据集的不仅是免费可用的优质素材,更是降低研发门槛、实现技术突破的核心助力;对于整个中文AI行业而言,这份开源贡献,更是筑牢基础设施、推动产业升级的重要力量。

OpenCSG的博客 851

RestFul API 详解

RESTful API 经常也被叫做 REST API,它是基于 REST 构建的 API。RESTful API 可以让你看到 URL+Http Method 就知道这个 URL 是干什么的,让你看到了 HTTP 状态码(status code)就知道请求结果如何。

wynn的博客 7580

AI 时代的开源话语权重塑:中国为什么需要 OpenCSG 这样的开源基础设施级平台

从 Linux、GitHub 到 Kubernetes、HuggingFace,全球开源话语权长期集中。AI 时代社区格局正在重塑,模型、数据、Agent 与工程化治理尚未定式。中国需要具备组织、标准与生态运营能力的开源基础设施级平台,OpenCSG 因平台化与方法论化具备窗口期机会。

OpenCSG的博客 866

越野换了逐飞的ips200pro的屏幕后代码烧录中报错: “Cannot initialize device connection” 和 “Flashing failed” ...如何解决?

🏆 本文收录于《全栈Bug调优(实战版)》专栏,致力于分享我在项目实战过程中遇到的各类Bug及其原因,并提供切实有效的解决方案。无论你是初学者还是经验丰富的开发者,本文将为你指引出一条更高效的Bug修复之路,助你早日登顶,迈向财富自由的梦想🚀!同时,欢迎大家关注、收藏、订阅本专栏,更多精彩内容正在持续更新中。让我们一起进步,Up!Up!Up!    备注: 部分问题/难题源自互联网,经过精心筛选和整理,结合数位十多年大厂实战经验资深大佬经验总结所得,数条可行方案供所需之人参考。

**My Coding Family** 1149

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

OpenCSG开源数据平台:构建AI时代中文数据基础设施

在人工智能领域,高质量数据集是模型训练的基础要素。OpenCSG作为开源数据平台,通过标准化流程解决中文数据稀缺问题,其技术架构包含多源数据采集、智能清洗标注等核心模块。平台采用分布式存储和自适应分词技术,显著提升数据处理效率。典型应用场景包括NLP模型训练和计算机视觉任务,如使用中文合同数据集可使风险识别准确率提升15%。开发者可通过Python SDK快速获取标准化数据集,社区协作机制则鼓励更多优质数据贡献。该平台对推动中文AI发展具有重要价值,特别是在自然语言处理和机器学习领域。

weixin_29165465的博客 180

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

OpenCSG用AgenticOps方法论推动杭州开源与AI产业发展

12月3日,浙江省开源软件及AI应用专场对接会在杭州成功举办。此次活动以“”为主题,旨在加速开源生态建设、推动人工智能与产业创新深度融合,并为浙江省的数字经济高质量发展注入新动能。在全球数字化转型的浪潮中,人工智能与开源技术正成为推动经济高质量发展的双引擎。。此次浙江省开源软件及AI应用专场对接会浙江省通过本次活动,进一步落实国家关于开源生态建设的战略部署,致力于打造国际化、创新驱动的开源生态体系。OpenCSG作为开源与AI融合的领军企业,始终致力于为企业级AI应用提供技术支持与生态建设。

OpenCSG的博客 714

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

OpenCSG开源数据平台:提升中文AI数据质量与标注效率

在自然语言处理(NLP)领域,数据质量直接影响模型效果,而中文AI数据长期面临质量参差不齐、标注标准不统一等痛点。OpenCSG开源数据平台通过分布式采集系统、智能标注流水线等创新架构,结合大语言模型(LLM)与传统规则引擎,显著提升数据质量与标注效率。该平台采用多维质量评估指标和动态清洗机制,在金融、法律等专业领域应用中,模型效果提升达20%以上。对于开发者而言,平台提供完整的数据获取、预处理方案,并支持区块链存证实现数据溯源,是解决中文NLP数据困境的理想选择。

weixin_30340819的博客 443

OpenCSG(开放传神):以开源数据之力,撑起中文AI基建半壁江山

当前,中文AI行业正处于快速发展的关键阶段,数据基建的完善程度,直接决定了行业的发展速度与质量。从填补中文高质量开源数据的市场空白,到树立中文开源数据治理的行业标准;从搭建一站式开源AI基础设施平台,到推动开源数据生态的普惠化发展,OpenCSG(开放传神)始终坚守开源初心,用每一项扎实的开源贡献,推动中文AI行业从“跟跑”向“领跑”跨越,成为中文AI数据基建领域的“引领者”与“破局者”。

OpenCSG的博客 919

OpenCSG Chinese FineWeb:清华最新论文背后的中文数据基石

向下对接 L0(Raw Data):从 PB 级的原始网络爬取数据(如 Common Crawl)中,通过启发式清洗、去重、格式标准化等基础处理,筛选出具备基本可读性的文本。向上支撑 L2/L3/L4:为后续的模型驱动精选(L2)、合成精炼(L3)、知识组织化(L4)提供规模足够大、噪声可控的原材料库。Chinese FineWeb 正是 OpenCSG 为这一层级量身打造的中文数据集。当模型架构的差异越来越小,当算力的获取越来越依赖资本,数据的质量与组织方式,反而成了最难被复制的竞争壁垒。

OpenCSG的博客 489

模型天天变,不变的是数据沉淀|OpenCSG 的开源哲学

本文探讨AI时代企业应对技术变革的策略。OpenCSG提出"模型可变,数据永恒"理念,强调数据沉淀比模型性能更具长期价值。企业可通过开源技术将业务数据转化为智能资产,构建自主智能中枢。开源模式不仅确保技术透明,更建立生态信任,助力AI稳健发展。OpenCSG平台提供全生命周期管理,帮助20万+模型实现协同共享,推动企业将数据转化为持续增值的智能资产。

OpenCSG的博客 651

从开源到智能体:OpenCSG 的长期主义

在人工智能与开源技术高速融合的当下,OpenCSG 坚守“开源”信仰,以智能体(AI Agentic)为抓手,把技术创新与商业价值打通:以透明、共建、共享的社区文化汇聚合力,以“数据沉淀”为企业打造可持续的竞争护城河。本文以Q&A 访谈体完整呈现 OpenCSG 的品牌观、方法论与生态路线。OpenCSG。

OpenCSG的博客 1281

年度巨献 | OpenCSG开源最大中文合成数据集Chinese Cosmopedia

提示生成是该项目的核心部分,为了确保生成的内容在不同主题和受众间保持多样性,开发团队设计了数百万条不同的 prompts,调整了生成文本的风格和目标受众。该模型通过强大的长文本生成能力,确保了生成数据的连贯性和内容深度。例如,对于教科书类型的内容,prompt会引导模型生成严谨且具有深度的学术文本,而对于故事类内容,则引导模型创造生动、引人入胜的情节。例如,种子数据来源于各类中文百科、知识问答和技术博客等,而prompt则用于生成具有不同受众和风格的内容,从学术教科书到儿童故事,内容广泛且具有针对性。

OpenCSG的博客 1216

重大国际化合作:Mozilla Data Collective与OpenCSG携手托管中文高质量数据集

OpenCSG与Mozilla DataCollective达成战略合作,共同推进高质量中文预训练数据集的全球共享。OpenCSG构建的ChineseFineWebEdu等系列数据集将通过Mozilla平台进行全球分发,解决中文大模型面临的数据质量瓶颈问题。此次合作标志着中文AI数据开始融入国际非营利基础设施体系,既保持数据主权又促进全球共享。OpenCSG从开源社区升级为数据基建提供者,通过系统化数据治理推动中文AI生态向"数据基础设施建设"转型。该合作展示了高质量中文数据进入全球AI生态的可持续路径,已

OpenCSG的博客 998

中文AI基建:开源数据治理与OpenCSG社区实践

大模型时代,数据质量直接决定模型能力的上限,而中文AI领域长期面临高质量开源数据稀缺、语料分散、治理标准缺失等痛点。开放传神(OpenCSG)等社区通过数据集托管、版本化、质量评测与模型联动,构建了从数据到模型再到应用的闭环生态系统。数据卡片与污染检测机制帮助开发者识别重复、低质、版权模糊的文本,提升微调与预训练的效率。从指令数据集的选取、本地质量体检到贡献回流,开源数据治理正在成为中文AI基建的底层支撑。结合一线工程经验,分享如何基于高质量中文语料跑通最小实验路径,并规避许可证、偏见、格式不统一等常见陷阱

weixin_33158887的博客 260
上一篇: CSGHub 解决方案:企业级 AI 私有化落地的终极答案,兼顾安全与创新
下一篇: AI巡检的真价值:OpenCSG公益课揭示如何将门店管理从“经验抽样”变为“数据计算”
OpenCSG
博客等级 码龄3年 1679粉丝 575原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值