

论文阅读:MedGAN:Medical image translation using GANs

Generating Multi-label Discrete Electronic Health Records using Generative Adversarial Networks阅读笔记 本文参考的原始论文地址https://arxiv.org/abs/1703.06490v1摘要      获取电子健康记录(EHR)数据推动了医学研究的计算进步。然而,各种对隐私的关注,会限制我们的访问和协作。共享综合EHR数据可以减少风险。该文提出了一种新的方法-医学生成对抗网络(MedGAN),来生成真实的综合EHRs。基于作为输入EHR数据集,medGAN可以通过自动编码器和生成对抗性网络的... 阅读详情
AI摘要

本文介绍了医学图像转换框架MedGAN,它结合对抗性框架与非对抗性损失,采用CasNet生成器增强输出清晰度。该框架应用于PETCT翻译、MR运动伪影校正和PET图像去噪等任务,优于现有转换方法,还对其架构、训练、实验评估等方面进行了阐述。

Abstract


背景:

图像到图像的转换被认为是医学图像分析领域的一个新的前沿领域。

工作:

提出了一种新的医学图像到图像的转换框架MedGAN:
将对抗性框架与非对抗性损失的新组合相结合;
生成器——CasNet,该结构通过编码器-解码器对的逐步细化来增强翻译后的医学输出的清晰度;
判别器——作为一个可训练的特征提取惩罚之间的差异转换医学图像和期望的模式;
利用风格传递损失将目标图像的纹理和精细结构匹配到转换后的图像;
应用于三个不同的任务:PETCT翻译、MR运动伪影校正和PET图像去噪。

结果:

MedGAN优于其他现有的转换方法。

1. Introduction


由于可能引入不切实际的信息,将输入图像模态转换为输出模态的任务具有挑战性。这显然会使合成图像不可靠,无法用于诊断目的。

1.1 Classical approaches


1.2 Generative models


1.3 Medical image translation


1.4 Contributions


MedGAN的主要目的不是诊断,而是进一步增强需要全局一致图像属性的技术后处理任务。

  • MedGAN通过结合对抗性框架和一种新的非对抗性损失组合,捕捉所需目标模态的高频和低频成分。
  • CasNet新生成器架构,将多个完全卷积的编码器-解码器网络通过跳跃连接链接成一个生成器网络。
  • MedGAN在三项具有挑战性的医学成像任务中的应用:从PET图像生成合成CT图像、PET图像去噪以及MR运动伪影。
  • MedGAN与其他对抗性翻译框架的定量和定性比较。
  • 从医学角度研究翻译后的医学图像的主观性能和保真度。

2. Materials and Methods


MedGAN架构:
image.png

2.1 Preliminaries


2.1.1 Generative adversarial networks


GANs 由两个主要部分组成:生成器和判别器。
生成器 G 接受来自先验噪声分布 pnoisep_{\text{noise}}pnoise​​(例如正态分布)的输入样本 z,并将其映射到数据空间 x^=G(z)\hat{x} = G(z)x^=G(z),从而诱导出模型分布 pmodelp_{\text{model}}pmodel​​ 。
判别器 D 是一个二元分类器,其目标是将真实数据样本 x∼pdatax \sim p_{\text{data}}x∼pdata​​ 分类为真实(D(x)=1),而将生成的样本 x^∼pmodel\hat{x} \sim p_{\text{model}}x^∼pmodel​​ 分类为虚假(D(x^)=0D(\hat{x}) = 0D(x^)=0)。
这两个网络相互竞争:生成器试图生成与真实样本无法区分的样本,即使 pmodel≈pdatap_{\text{model}} \approx p_{\text{data}}pmodel​≈pdata​​,从而欺骗判别器;与此同时,判别器的目标是通过学习更有意义的特征来避免被欺骗,更好地区分真实和生成的样本。

表现为:
min⁡Gmax⁡DLGAN\min_G \max_D L_{\text{GAN}}Gmin​Dmax​LGAN​
对抗损失:
LGAN=Ex∼pdata[log⁡D(x)]+Ez∼pnoise[log⁡(1−D(G(z)))]L_{\text{GAN}} = \mathbb{E}_{x \sim p_{\text{data}}} [\log D(x)] + \mathbb{E}_{z \sim p_{\text{noise}}} [\log (1 - D(G(z)))]LGAN​=Ex∼pdata​​[logD(x)]+Ez∼pnoise​​[log(1−D(G(z)))]

2.1.2 Image-to-image translation


将对抗网络从图像生成应用于转换任务的基本原理是将生成器网络替换为条件生成对抗网络 (cGAN)。

生成器的目标是通过映射函数 G(y,z)=x^∼pmodelG(y, z) = \hat{x} \sim p_{\text{model}}G(y,z)=x^∼pmodel​ 将源域图像 y∼psourcey \sim p_{\text{source}}y∼psource​​ 映射到其对应的真实目标图像 x∼ptargetx \sim p_{\text{target}}x∼ptarget​。这通常可以被视为两个共享相同底层结构但表面外观不同的域之间的回归任务。

cGAN 不是使用手动构建的损失函数来测量转换图像和目标图像之间的相似性,而是利用一个二元分类器——判别器来代替。
对抗损失:
LcGAN=Ex,y[log⁡D(x,y)]+Ez,y[log⁡(1−D(G(y,z),y))]L_{\text{cGAN}} = \mathbb{E}_{x,y}[\log D(x, y)] + \mathbb{E}_{z,y}[\log (1 - D(G(y, z), y))]LcGAN​=Ex,y​[logD(x,y)]+Ez,y​[log(1−D(G(y,z),y))]

判别器的目标是将源图像 y 和其对应的真实目标图像 x 的拼接视为真实(D(x, y) = 1),而将 y 和生成的图像 x^\hat{x}x^ 视为虚假(D(x^,y)=0D(\hat{x}, y) = 0D(x^,y)=0)。
仅依赖对抗损失函数的图像到图像翻译框架无法生成一致的结果。生成的图像可能不会与目标图像共享相似的全局结构。
为了解决这一问题,通常会加入像素重构损失,例如 L1 损失 。这可以通过计算目标图像与生成图像之间的平均绝对误差 (MAE) 来实现:
LL1=Ex,y,z[∥x−G(y,z)∥1]L_{L1} = \mathbb{E}_{x,y,z} [\|x - G(y, z)\|_1]LL1​=Ex,y,z​[∥x−G(y,z)∥1​]
最终训练目标:
min⁡Gmax⁡D(LcGAN+λLL1)\min_G \max_D (L_{\text{cGAN}} + \lambda L_{L1})Gmin​Dmax​(LcGAN​+λLL1​)

2.2 Perceptual loss


利用这种损失函数的转换框架往往会在保持全局结构的同时,导致图像失真和细节丢失。
为了捕捉图像中高频成分之间的差异,额外引入了感知损失。
这种损失是基于使用判别器网络作为可训练的特征提取器,提取中间特征表示。目标图像 x 和翻译图像 x^\hat{x}x^ 的特征图之间的平均绝对误差 (MAE) 被计算为:
Pi(G(y,z),x)=1hiwidi∥Di(G(y,z),y)−Di(x,y)∥1P_i (G(y, z), x) = \frac{1}{h_i w_i d_i} \|D_i (G(y, z), y) - D_i (x, y)\|_1Pi​(G(y,z),x)=hi​wi​di​1​∥Di​(G(y,z),y)−Di​(x,y)∥1​
其中 DiD_iDi​ 表示从判别器网络的第 i 个隐藏层提取的特征表示,hih_ihi​ 、 wiw_iwi​​ 和 did_idi​​ 分别表示特征空间的高度、宽度和深度。
感知损失:
Lperceptual=∑i=0LλpiPi(G(y,z),x)L_{\text{perceptual}} = \sum_{i=0}^{L} \lambda_{pi} P_i (G(y, z), x)Lperceptual​=i=0∑L​λpi​Pi​(G(y,z),x)
其中 L 是判别器的隐藏层数量,λpi>0\lambda_{pi} > 0λpi​>0 是一个调节超参数,表示第 i 层的影响。

稳定判别器的对抗训练,采用了谱归一化正则化,通过对判别器中每一层 i 的权重矩阵 θD,i\theta_{D,i}θD,i​​ 进行归一化来实现:
θD,i=θD,iδ(θD,i)\theta_{D,i} = \frac{\theta_{D,i}}{\delta(\theta_{D,i})}θD,i​=δ(θD,i​)θD,i​​
其中 δ(θD,i)\delta(\theta_{D,i})δ(θD,i​) 表示矩阵 θD,i​\theta_{D,i}​θD,i​​ 的谱范数。因此,判别器函数 D(x, y) 的 Lipschitz 常数将被限制为 1。
在实际操作中,为了计算谱范数,使用了功率迭代法的近似 δ^(Wi)\hat{\delta}(W_i)δ^(Wi​),而不是应用奇异值分解,以降低所需的计算复杂度。

2.3 Style transfer losses


用于损失计算的特征来自为图像分类任务预训练的特征提取器。
预训练网络的优势它能够从更大的感受野中提取丰富的特征,从而在增强转换图像的全局结构的同时,也增强精细的细节。
风格迁移损失可以分为两个主要组成部分:风格损失和内容损失。

2.3.1 Style loss


风格损失惩罚转换图像与其对应目标图像之间风格表示的差异。

特征的相关性通过每个卷积块的Gram矩阵 Grj(x)Gr_j(x)Grj​(x) 表示,该矩阵的形状为 dj×djd_j \times d_jdj​×dj​​,其元素通过特征图在高度和宽度维度上的内积计算得出:
Grj(x)m,n=1hjwjdj∑h=1hj∑w=1wjVj(x)h,w,mVj(x)h,w,nGr_j(x)_{m,n} = \frac{1}{h_j w_j d_j} \sum_{h=1}^{h_j} \sum_{w=1}^{w_j} V_j(x)_{h,w,m} V_j(x)_{h,w,n}Grj​(x)m,n​=hj​wj​dj​1​h=1∑hj​​w=1∑wj​​Vj​(x)h,w,m​Vj​(x)h,w,n​
Vj,i​(x)V_{j,i}​(x)Vj,i​​(x) 表示从输入图像 x 中通过特征提取网络的第 j 个卷积块和第 i 层提取的特征图。仅使用每个卷积块的第一层,并将在符号中省略。这些特征图的大小为 hj×wj×djh_j \times w_j \times d_jhj​×wj​×dj​​,其中 hj​h_j​hj​​ 、 wj​w_j​wj​​ 、 djd_jdj​​ 分别表示高度、宽度和空间深度。

风格损失计算为转换输出 x^\hat{x}x^ 和真实输入 x 之间的特征相关性差异的Frobenius范数平方:
Lstyle=∑j=1Bλsj14dj2∥Grj(G(y,z))−Grj(x)∥F2L_{\text{style}} = \sum_{j=1}^{B} \lambda_{sj} \frac{1}{4 d_j^2} \| Gr_j(G(y, z)) - Gr_j(x) \|_F^2Lstyle​=j=1∑B​λsj​4dj2​1​∥Grj​(G(y,z))−Grj​(x)∥F2​
λsj>0\lambda_{sj} > 0λsj​>0 是一个调整的超参数,表示第 j 个卷积块的贡献权重,B 是卷积块的总数。

2.3.2 Content loss


内容损失惩罚从特征提取网络中提取的特征表示之间的差异,不捕捉风格或纹理的差异。
起到了类似像素重构损失的辅助作用,通过增强低频分量并确保转换图像的全局一致性。

内容损失:
Lcontent=∑j=1Bλcj1hjwjdj∥Vj(G(y,z))−Vj(x)∥F2L_{\text{content}} = \sum_{j=1}^{B} \lambda_{cj} \frac{1}{h_j w_j d_j} \| V_j(G(y, z)) - V_j(x) \|_F^2Lcontent​=j=1∑B​λcj​hj​wj​dj​1​∥Vj​(G(y,z))−Vj​(x)∥F2​
其中,λcj>0\lambda_{cj} > 0λcj​>0 是一个超参数,表示第 j 个卷积块第一层的影响力。

2.4 MedGAN architecture


CasNet架构:
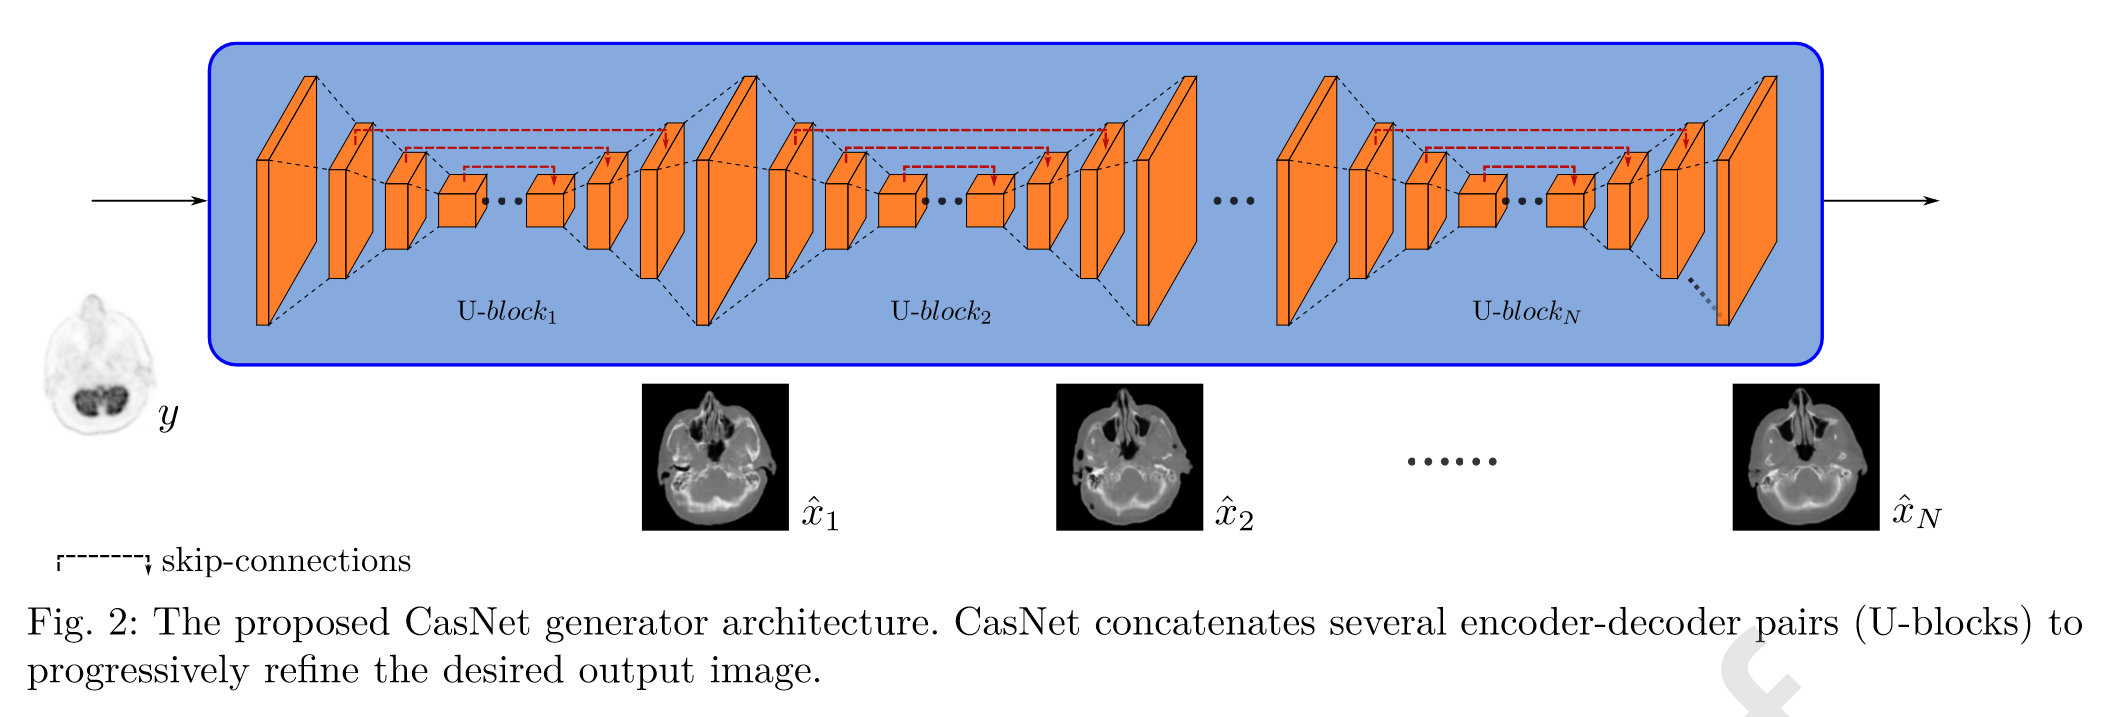
image.png

2.4.1 U-blocks


U-块是一个全卷积编码器-解码器网络。
编码路径将输入域中的图像(分辨率为256×256)映射到一个高级表示,该表示由8个卷积层堆叠而成,每个卷积层后面都跟着批量归一化和Leaky-ReLU激活函数。
卷积滤波器的数量分别为64、128、256、512、512、512、512和512,卷积核大小为4×4,步长为2。
解码路径与编码架构相对应,但使用分数步长反卷积,每层之后将分辨率放大两倍。
上采样路径的每层分别包含512、1024、1024、1024、1024、512、256和128个滤波器,这些层使用ReLU激活函数,但最后一层反卷积层使用Tanh激活函数。
U-块包含跳跃连接。

2.4.2 CasNet


CasNet通过端到端地连接多个U-块来增强MedGAN的生成能力。
通过这种网络深度的损失梯度反向传播可能导致梯度消失问题,但是,由于单个U-块内部使用了跳跃连接,这个问题得到了缓解。

2.4.3 Discriminator architecture


判别器采用了改进后的PatchGAN架构。
PatchGAN的设计不是为了将目标图像和输出图像分类为真实或虚假,而是具有减小的感受野,以便在分类之前将输入图像通过卷积分成更小的图像块,并对结果进行平均。
为了避免使用较小块大小时出现的典型平铺伪影,70x70块是常用的块大小。然而,实验发现,将较小的块与先前引入的非对抗性损失(如感知损失和风格迁移损失)结合使用,可以促进更清晰的结果,同时消除传统的平铺伪影。
通过结合两个卷积层(分别具有64和128个空间滤波器),随后是批量归一化和Leaky-ReLU激活函数,来实现16x16块的大小。
最后,为了输出所需的置信度概率图,使用了一个输出维度为1的卷积层和一个sigmoid激活函数。

2.5 MedGAN framework and training


MedGAN累计损失函数:
LMedGAN=LcGAN+λ1Lperceptual+λ2Lstyle+λ3LcontentL_{\text{MedGAN}} = L_{\text{cGAN}} + \lambda_1 L_{\text{perceptual}} + \lambda_2 L_{\text{style}} + \lambda_3 L_{\text{content}}LMedGAN​=LcGAN​+λ1​Lperceptual​+λ2​Lstyle​+λ3​Lcontent​
λ1\lambda_1λ1​、λ2\lambda_2λ2​ 和 λ3\lambda_3λ3​ 是平衡不同损失组件的超参数。
最终选择了 λ1=20\lambda_1 = 20λ1​=20 和 λ2=λ3=0.0001\lambda_2 = \lambda_3 = 0.0001λ2​=λ3​=0.0001 。

设置 λpi\lambda_{pi}λpi​​ 来使判别器的两层对损失的影响相等。
设置 λcj\lambda_{cj}λcj​​ 使除最深的卷积块外的所有卷积块对内容损失有影响。
对于风格损失,设置λsj\lambda_{sj}λsj​​ 被设定为仅包括预训练的VGG-19网络的第一个和最后一个卷积块的影响。

特征提取器使用一个深度的VGG-19网络,它是在ImageNet分类任务上预训练的。
使用ADAM优化器 ,动量值为0.5,学习率为0.0002。
使用实例归一化,批量大小为1。
每训练CasNet生成器三次时训练一次Patch判别器。
生成器的CasNet架构由N=6个U-block组成。

训练过程:
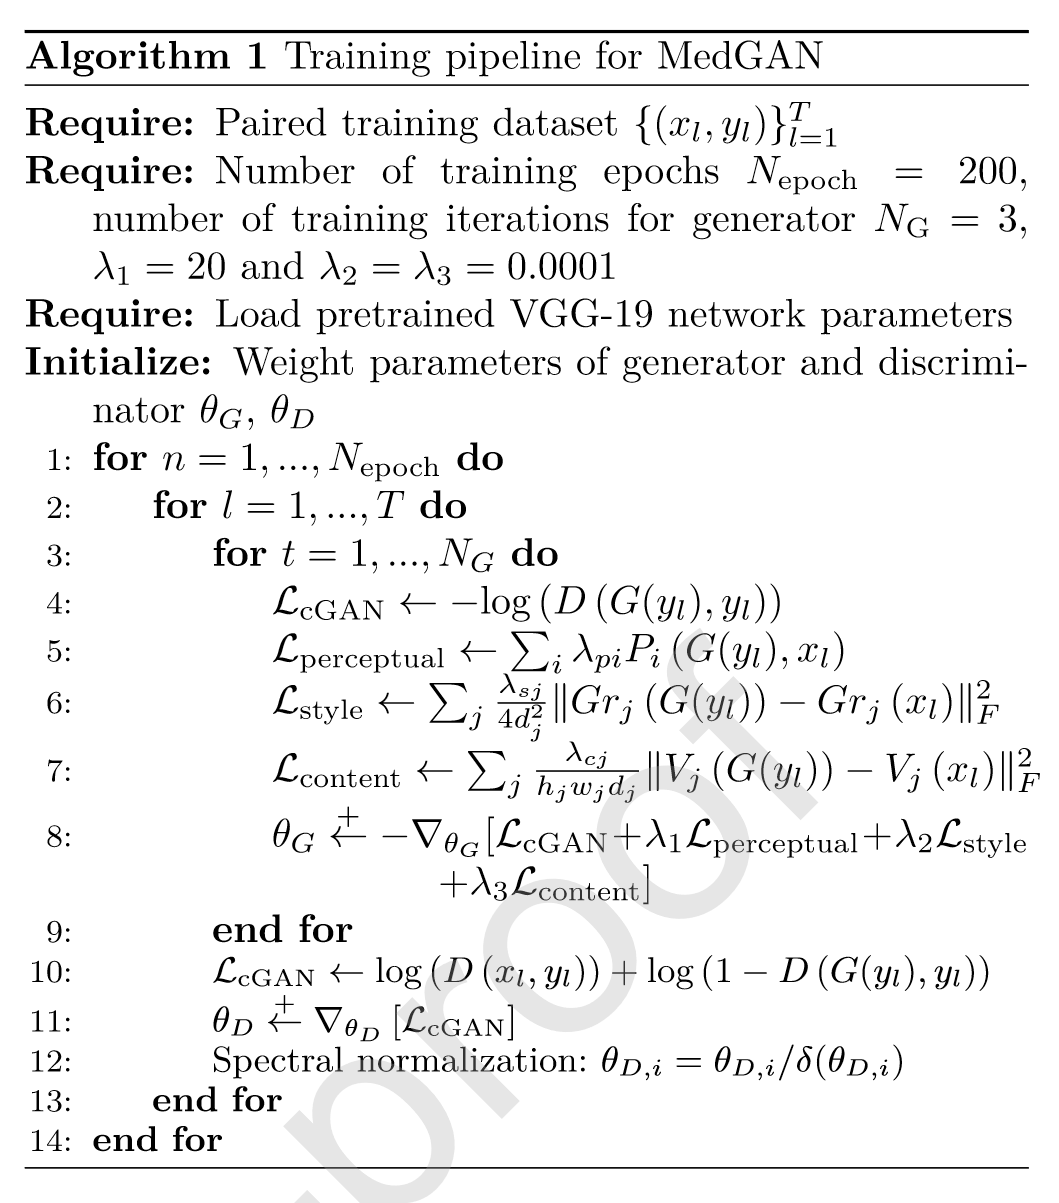
image.png

3. Experimental evaluation


3.1 Datasets


3.2 Experimental setup


3.2.1 Analysis of loss functions


3.2.2 Comparison with state-of-the-art techniques


3.2.3 Perceptual study and validation


3.3 Evaluation metrics


  • 结构相似性指数(SSIM)
  • 峰值信噪比(PSNR)
  • 均方误差(MSE)
  • 视觉信息保真度(VIF)
  • 通用质量指数(UQI)
  • 学习感知图像块相似性(LPIPS)

4. Results


4.1 Analysis of loss functions


4.2 Comparison with state-of-the-art techniques


4.3 Perceptual study and validation


5. Discussion


讨论MedGAN框架各个部分的性能,以及现有的不足。

6. Conclusion


MedGAN 将条件对抗框架与一种新型的非对抗性损失组合以及CasNET生成器架构相结合,以增强结果的全局一致性和高频细节。
未来的工作将致力于扩展MedGAN以支持3D多通道体积的处理,还将研究MedGAN在技术后处理任务中的性能。

Image Translation for Medical Image Generation Ischemic Stroke Lesion Segmentation——论文翻译 摘要 ​ 基于深度学习的疾病检测和分割算法有望改善许多临床过程。然而,此类算法需要大量带注释的训练数据,而由于数据隐私、法律障碍和非统一的数据获取协议,这些数据通常在医疗环境中不可用。带有注释病理的合成数据库可以提供所需数量的训练数据。我们以缺血性中风为例证明,基于深度学习的增强技术在病灶分割方面的改进是可行的。为此,我们训练不同的图像到图像的翻译模型,从语义分割图合成有和没有脑卒中病灶的脑体素磁共振图像。此外,我们训练生成对抗网络,以生成合成病变mask。随后,我们结合这两个组件来构建一个大的合成卒中图 阅读详情

相关推荐

51单片机STC8G1K08驱动ws2812记录

使用51单片机控制17个2812灯,这里选择STC8芯片,最大频率可以达到35M,参考网上的各种文章案例,使用定时器做的时候实测做不到规格书要求的245-345ns,STC8G1K08不带PWM,所以只能使用nop来做,好在单片机在这里只有做编程灯的功能,省略测试过程,下面是程序,使用的是24MHz内部晶振 //设置一个灯珠 void SendOnePix(unsigned char *ptr) { unsigned char i,j; unsigned char temp; fo...

的博客 7323

MedGAN——用GAN对医学成像进行迁移

该网络结构的论文是——MedGAN:Medical Image Translation using GANs MedGAN结构如下图所示: 一、 MedGAN由三部分组成: 1. 生成器(Generator)——选用一个CasNet(Fig.2)做生成器,输入为 y(如PET),输出为(如CT)。 2. 判别器(Discriminator)——用于区分真实图像 x 和转化图像,同时...

qq_34869928的博客 2906

锐捷交换机堆叠配置举例

一、组网需求: 1)四台S2628G进行堆叠; 2)设备在堆叠前先设置好优先级; 3)使用光口堆叠的设备如RG-S2928G-E相关配置 二、组网拓扑 三、配置要点: 普通堆叠设备不需要配置,只要把堆叠模块和线缆连接好即可 堆叠模块不支持热插拔,即插在模块连上线缆后不能立即生效,需要重启设备才生效。 如果拔掉堆叠插槽后,想再插上模块堆叠,那么必须重启设备才生效 设备堆叠需要协商参数,时间会比较久,请耐心等待 堆叠时设备建议是...

dongsheng_9234的专栏 8287

[Style Transfer]——MedGAN: Medical Image Translation using GANs

MedGAN: Medical Image Translation using GANs Author: Karim Armanious , Chenming Yang , Marc Fischer , Thomas K¨ ustner , Konstantin Nikolaou ,Sergios Gatidis , and Bin Yang Abstract 图像转换被认为是医学图像分析的下一个研究热点,但往往是根据特定应用设计特定的网络框架或者受限于有限的训练数据,本文提出的MedGAN则可以在

qq_37151108的博客 4150

Ubuntu20.04浏览器上网慢解决方法——体验优化

一、问题描述 ubuntu上网慢的原因可能有多种: 1.主机网络慢 2.客户机下载网络占用 3.域名解析慢 本文仅代表本人配置过程,网络配置需谨慎小心 二、使用本地DNS服务器解决问题 1.安装 dnsmasq sudo apt-get install dnsmasq 2.配置dnsmasq ——终端输入: sudo gedit /etc/dnsmasq.conf ——文本中查找 : #resolv-file= ——将之替换为: resolv-file=/etc/resolv.dnsm

nofear的博客 1万+

XSS漏洞之PDF生成:从XSS到服务端任意文件读取

XSS是最为常见的Web漏洞之一,多年来连续入选OWASP TOP10,相信大家都耳熟能详。 它是一种代码注入类的攻击,是一种客户端侧的攻击,攻击者通过在Web应用中注入恶意JavaScript代码,通过点击URL,最终在受害者浏览器端执行的一种漏洞。主要有反射型XSS、存储型XSS、基于DOM的XSS三类。XSS一些比较常规的危害大概有:重定向浏览器、窃取Cookie、浏览器劫持等。本文章侧重于发现XSS后的进一步利用。 主要介绍在某次实际测试过程中,发现XSS漏洞之后,如何进一步的利用,最终通过XSS达

计算机毕业论文源码,学生个人网页制作html源码。贴近用户做网络推广和互联网优化。 3780

医疗生成对抗网络(MedGAN): 电子健康记录的生成神器

医疗生成对抗网络(MedGAN): 电子健康记录的生成神器 项目介绍 MedGAN 是一个基于生成对抗网络(GAN)的先进框架,专为生成多标签离散型患者医疗记录设计。它能够生成包括诊断码、药物编码或程序代码在内的医疗代码,既支持二进制变量也支持计数变量。此项目灵感来源于一篇学术论文,详细介绍了如何利用GAN技术在保持隐私的同时合成真实的医疗数据集,对研究和开发工作具有重要价值。 项目快速启动 要...

gitblog_00592的博客 558

uniapp [全端兼容] - 实现连接蓝牙电子秤+监听数据转换并实时返回示例代码,uniApp实现BLE蓝牙连接多个电子秤设备、蓝牙通讯协议对接详细教程(全平台兼容H5、微信小程序、苹果安卓App)

uniapp连接蓝牙电子秤,uniapp如何连接电子秤蓝牙,蓝牙称重,实现监听数据转换并实时返回,多蓝牙,uni-app电子秤16进制蓝牙通讯协议对接,uniapp微信小程序蓝牙获取电子秤的值,uniapp蓝牙称重电子秤,蓝牙电子秤硬件,APP端连接蓝牙秤获取重量实时显示在页面上蓝牙秤,插件组件,蓝牙连接失败,uniapp安卓苹果ios连接蓝牙电子秤没反应,uniapp微信小程序 蓝牙低功耗连接发送数据监听接收,uni-app小程序蓝牙连接、读写数据全过程,uniapp连接蓝牙体脂秤,蓝牙搜索不到怎么办,如

🏆 前端领域优质创作者 1万+

GAN生成网络之medGAN源码解析

开更啦!下面是分析medGAN的笔记 所有的代码我都放在了自己的git上, 这是git该项目的地址 首先第一步是了解这个数据集,我们这里采用了MIT的MIMIC数据库,有关这个数据库的各种东西可以看这篇博客 感谢大佬的分享 在接下来的过程中,我们需要注意要用到的基本上只有DIAGNOSES_ICD 和 ADMISSION 这两个表 ...

skywf的博客 1126

8.5华为OD机试真题 新系统 - IPv4 等长子网划分与自动分配系统 (Java/Py/C/C++/Js/Go)

8.5华为OD机试真题 新系统 - IPv4 等长子网划分与自动分配系统 (Java/Py/C/C++/Js/Go)

算法大师! 526

【推荐100个unity插件】性能极高的逼真爆炸、火焰和烟雾效果——UNI VFX

这是一篇关于Unity中高性能GPU粒子特效插件UNI VFX的使用指南。文章介绍了该插件提供逼真的爆炸、火焰和烟雾效果,支持URP和HDRP渲染管线。主要内容包括:插件安装方法(需预先安装Visual Effect Graph和Shader Graph包)、事件系统使用方法(如create/loop/stop等事件控制)、特效分类(自动结束型和持续型特效)、检视面板配置技巧以及性能优化建议(特别提醒灯光特效对性能的影响较大)。文末还推荐了多个Unity开发相关的专栏内容。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 1492

探索医疗数据的未来:medGAN

探索医疗数据的未来:medGAN medganGenerative adversarial network for generating electronic health records.项目地址:https://gitcode.com/gh_mirrors/me/medgan 项目介绍 medGAN是一个创新性的生成对抗网络(Generative Adversarial Network),...

gitblog_00045的博客 452

Ollama本地大模型-个性化AI:训练自己的风格模型和数据投喂打造专属智能体验

之前我们使用Ollama下载了deepseek模型,现在我想将其训练成自己风格的模型,应该怎么做?

瑶山的博客 1783

Unsupervised Medical Image Translation with Adversarial Diffusion Models

通过源-目标模态转换对缺失图像进行补全可以提高医学成像方案的多样性。利用生成对抗网络(GAN)进行一次映射是一种普遍的目标图像合成方法。然而,隐式表征图像分布的GAN模型可能会受到样本保真度的限制。本文提出了一种基于对抗扩散建模的新方法SynDiff,以提高医学图像翻译的性能。为了捕获图像分布的直接相关性,SynDiff利用条件扩散过程,逐步将噪声和源图像映射到目标图像上。为了在推理过程中快速准确地进行图像采样,在反向扩散方向上采用对抗投影进行大扩散步长。

通街是密人有的博客 2222

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

计算机科学领域中,基于深度生成模型的合成数据集创建与在隐私保护机器学习中的应用

深度生成模型是一类能够从复杂的概率分布中抽样生成新样本的神经网络结构。它主要包括变分自编码器(VAE)、生成对抗网络(GAN)及其衍生版本等。

jie_kou的博客 934

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

翻译:Breaking the Dilemma of Medical Image-to-image Translation

摘要 监督Pix2Pix和非监督的Cycle-consistency是医学图像到图像转换领域的两种模式。但这两种模式都是不理想的。Pix2Pix模式具有出色的性能,但它需要像素级对齐的图像。像素级对齐的医学影像数据集很难获取,是因为通常两种模态的影像不是同时采集的,在此期间患者的呼吸运动、身体解剖结构的变化等都会导致两组图像的misalignment。Cycle-consistency模式对训练数据不那么严格,并且在像素未对齐的图像上效果很好,但它的性能可能不是最佳的。为了打破现有模式的困境,我们提出了一种

weixin_48335963的博客 1450

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

无监督医学图像翻译与对抗扩散模型| 文献速递-深度学习结合医疗影像疾病诊断与病灶分割

在本研究中,我们引入了一种新颖的对抗性扩散模型,用于医学图像在源和目标模态之间的翻译。为了合成模态A的目标图像ˆx A0,如图1b中的扩散模块所需,需要来自模态B的同一解剖结构的源图像y B的指导。显示了无条件合成任务的图像样本:a) IXI中的T1,b) BRATS中的T2,c) 盆腔数据集中的CT。通过捕获关于目标分布的信息,鉴别器同时指导生成器从源图像到目标图像的一次性映射,基于这种对抗机制,GAN在多种翻译任务中报告了最新的结果,包括跨MR扫描仪的合成,多对比MR合成,以及跨模态合成。

weixin_38594676的博客 1673

论文阅读——Deformable Medical Image Registration Using Generative Adversarial Networks

基于GAN实现可变医学图像配准 
from IBM Research 
ISBI2018 Abstract 常规的图像配准都采用迭代的方式,十分耗时。而近期深度学习技术可以在迭代中提取的深层特征进行图像配准。本文借助生成对抗网络从而避免了配准过程中耗时良久的迭代过程,直接生成配准后的图像。通过在GAN的损失函数中增加适当约束可以在一秒内生成精确的图像,在多模态的视网膜图像及心室MR图像中验证了本文方法的有效性。 Section I Introduction 图像配准是绝大多数医学图像分析的基础步骤,这方面的

qq_37151108的博客 2131

SF——Spatial-Frequency Dual Progressive Attention Network For Medical Image Segmentation

SF——Spatial-Frequency Dual Progressive Attention Network For Medical Image Segmentation (SF-UNet:用于医学图像分割的空频双渐进注意力网络 )

m0_74031986的博客 3155

【1】GAN在医学图像上的生成,今如何?

最初,GAN在被提出时,是一个无监督(无条件)的生成框架:例如在图像合成中,将随机噪声映射到逼真的目标图像。后来CGAN即条件GAN,输入加入了标签(或者图像特征)等先验信息而不是仅靠噪...

idol24的博客 3523

「Medical Image Analysis」Note on MedGAN

QQ Group: 428014259 Tencent E-mail:403568338@qq.com http://blog.youkuaiyun.com/dgyuanshaofeng/article/details/86483532 [1] MedGAN Medical Image Translation Using GANs 2018 [paper]

小锋子Shawn 480

ipA-MedGAN: INPAINTING OF ARBITRARY REGIONS IN MEDICAL IMAGING

提出了医学图像修复框架ipA-MedGAN,用以修复任一形状的缺失区域,并且无需事先对感兴趣区域进行定位。

hello_world_0001的博客 532

GAN Zoo:千奇百怪的生成对抗网络,都在这里了

自从Goodfellow2014年提出这个想法之后,生成对抗网络(GAN)就成了深度学习领域内最火的一个概念,包括LeCun在内的许多学者都认为,GAN的出现将会大大推进AI向无监督学习发展的进程。 于是,研究GAN就成了学术圈里的一股风潮,几乎每周,都有关于GAN的全新论文发表。而学者们不仅热衷于研究GAN,还热衷于给自己研究的GAN起名,比如什么3D-GAN、BEGAN、iGAN、S⊃2

1万+

GAN 论文大汇总

关于生成对抗网络(GAN)的新论文每周都会出现很多,跟踪发现他们非常难,更不用说去辨别那些研究人员对 GAN 各种奇奇怪怪,令人难以置信的创造性的命名!当然,你可以通过阅读 OpanAI 的博客或者 KDNuggets 中的概述性阅读教程,了解更多的有关 GAN 的信息。在这里汇总了一个现在和经常使用的GAN论文,所有文章都链接到了 Arxiv 上面。 GAN — Generative Advers

CoderPai的博客 1万+

医学图像配准综述学习

医学图像配准综述学习 目前针对医学图像配准的综述较少,笔者只找到了两篇: 一篇发表在《Machine Vision and Applications》-- Deep Learning in Medical Image Registration: A Survey 另一篇发表在《Physics in Medicine ans Biology》-- Deep Learning in Medical Image Registration: A Review PMB这篇相对新且全面,故下面只对该论文的内容做总结。

海绵宝宝强无敌的博客 4143

Pix2Pix-基于GAN的图像翻译

语言翻译是大家都知道的应用。但图像作为一种交流媒介,也有很多种表达方式,比如灰度图、彩色图、梯度图甚至人的各种标记等。在这些图像之间的转换称之为图像翻译,是一个图像生成任务。 多年来,这些任务都需要用不同的模型去生成。在GAN出现之后,这些任务一下子都可以用同一种框架来解决。这个算法的名称叫做Pix2Pix,基于对抗神经网络实现。

雨石 7万+
上一篇: 论文阅读:Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks
下一篇: 论文阅读:Wasserstein GAN
BulingQAQ
博客等级 码龄7年 335粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值