AI大模型入门指南2:微调技术

AI大模型微调训练营,全面解析微调技术理论,掌握大模型微调核心技能 本文全面解析了AI大模型微调技术理论,并介绍了如何通过AI大模型微调训练营掌握核心技能。通过选择合适的预训练模型、进行数据预处理、搭建微调框架、训练与评估以及模型部署与应用等步骤,我们可以充分利用大模型的优势,提升模型在新任务上的性能。希望本文能为读者在AI大模型微调领域的学习和实践提供有价值的参考。(全套教程文末领取哈)从大模型系统设计入手,讲解大模型的主要方法;在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统; 阅读详情

图片

“ 通用人工智能(AGI)作为 AI 发展的终极愿景,追求的是让智能系统具备像人类一样理解和处理各种复杂情况与任务的能力。正是由于Google公司在2021年提出的指令微调技术(Fine-Tuning)和OpenAI公司2022年提出的基于人类反馈的强化学习(RLHF)技术,才产生了以ChatGPT为代表的现代生成式人工智能(GAI)的诞生。”

AGI(通用人工智能)作为 AI 发展的终极愿景,追求的是让智能系统具备像人类一样理解和处理各种复杂情况与任务的能力。尽管大模型的起源追溯到2017年的论文“Attention is All You Need”(该论文将transformer大模型引入了自然语言处理(NLP)任务),但正是由于Google公司在2021年提出的指令微调技术(Instruction Tuning)和OpenAI公司2022年提出的基于人类反馈的强化学习(RLHF)技术,才促使了以ChatGPT为代表的现代生成式人工智能(GAI)的诞生。

通过前文AI|大模型入门(一),主要了解到我们常说的大模型指的是狭义上的大语言模型(Large Language Models):超大规模的预训练语言模型。

因为根据重要的经验性法则是扩展定律(Scaling Law),随着模型参数规模和预训练数据规模的不断增加,模型能力与任务效果将会随之改善。模型参数规模达到千亿量级,语言大模型能够展现出多方面的能力跃升(这种现象称之为涌现)。

但是其学习目标主要通过预测下一个单词实现,仍不能很好地遵循人类指令,甚至会输出无用的、有害的信息,难以有效对齐人类的偏好。因此,大模型(此处指超大规模的预训练语言模型)只是一个基座模型,并不能直接使用。针对这些问题,主要有两种大模型改进技术,包括指令微调(Fine-Tuning)以及基于人类反馈的强化学习 (Reinforcement Learning from Human Feedback, RLHF) ,这两种技术都是微调技术(fine-tuning)的一种。

微调(Fine-Tuning)

一、什么是微调?

微调(Fine-tuning)是一种在自然语言处理(NLP)中使用的技术,用于将预训练的语言模型适应于特定任务或领域。Fine-tuning的基本思想是采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续训练它。

Fine-tuning的概念已经存在很多年,并在各种背景下被使用。Fine-tuning在NLP中最早的已知应用是在神经机器翻译(NMT)的背景下,其中研究人员使用预训练的神经网络来初始化一个更小的网络的权重,然后对其进行了特定的翻译任务的微调。

经典的fine-tuning方法包括将预训练模型与少量特定任务数据一起继续训练。在这个过程中,预训练模型的权重被更新,以更好地适应任务。所需的fine-tuning量取决于预训练语料库和任务特定语料库之间的相似性。如果两者相似,可能只需要少量的fine-tuning。如果两者不相似,则可能需要更多的fine-tuning。

在NLP中,fine-tuning最著名的例子之一是由OpenAI开发的OpenAI GPT(生成式预训练变压器)模型。GPT模型在大量文本上进行了预训练,然后在各种任务上进行了微调,例如语言建模,问答和摘要。经过微调的模型在这些任务上取得了最先进的性能。

图片

二、微调技术有哪些?

常见的微调技术有Instruction Tuning、BitFit、Prefix Tuning、Prompt Tuning、P-Tuning、Adapter Tuning、LoRA、RLHF等:

图片

本文仅介绍前两种非常重要的微调技术:指令微调和RLHF。

指令微调(Instruction Tuning)

指令微调是一种用有标记的指令提示和相应输出数据集对大型语言模型(LLM)进行微调的技术。它不仅在特定任务上提高了模型的性能,而且在一般情况下提高了模型的性能,从而有助于将预训练的模型适应实际使用。

指令微调是用于调整预先训练的基础模型的更广泛的微调技术类别的子集。从样式自定义到补充预训练模型的核心知识和词汇到优化特定用例的性能,因此可以对基础模型进行微调。尽管微调并不是任何特定领域或人工智能模型体系结构的独特之处,但它已成为LLM生命周期不可或缺的一部分。

指令微调可以被视为有监督微调(Supervised Fine-Tuning,SFT)的一种特殊形式。但是,它们的目标依然有差别。SFT是一种使用标记数据对预训练模型进行微调的过程,以便模型能够更好地执行特定任务。而指令微调是一种通过在包括(指令,输出)对的数据集上进一步训练大型语言模型(LLMs)的过程,以增强LLMs的能力和可控性。指令微调的特殊之处在于其数据集的结构,即由人类指令和期望的输出组成的配对。这种结构使得指令微调专注于让模型理解和遵循人类指令。

指令微调与其他微调技术并不是互斥的。例如,聊天模型经常从人类反馈(RLHF)中进行指导调整和强化学习,这是一种微调技术,旨在提高诸如帮助和诚实之类的抽象素质;用于编码的模型经常进行指令调整(以广泛优化以下说明的响应),以及对特定于编程的数据进行其他微调(以增强模型的编码语法和词汇的了解)。

图片

指令微调的作用与大多数微调技术一样,在于预训练的大模型没有针对对话或指令执行进行优化。从字面意义上讲,大模型不会根据提示词回答问题,它们只是根据提示词向其添加生成的文本。指令调优有助于使大模型的回答更有用。

基于人类反馈的强化学习(RLHF)

基于人类反馈的强化学习 (Reinforcement Learning from Human Feedback, RLHF) ,思想就是使用强化学习的方式直接优化带有人类反馈的语言模型。RLHF 使得在一般文本数据语料库上训练的语言模型能和复杂的人类价值观对齐。

RLHF 是一种特殊技术,用于与其他技术(例如有监督学习和无监督学习)一起训练人工智能系统,使其更加人性化。首先,将模型的响应与人类的响应进行比较。然后,人类会评测不同机器响应的质量,对哪些响应更人性化进行评分。分数可以基于人类的内在品质,例如友善、适当程度的情境化和心情。

RLHF 在自然语言理解方面表现得非常突出,但也可用于其他生成式人工智能应用程序。

RLHF 是一项涉及多个模型和不同训练阶段的复杂概念,一般会分为三步,这也是一个生成自己大模型所必需的:

第一步是监督微调(Supervised Fine Tuning,SFT),即用数据集进行模型微调,预训练一个语言模型 (LM);

第二步是训练一个奖励模型,它通过对于同一个 prompt 的不同输出进行人工排序,聚合问答数据并训练一个奖励模型 (Reward Model,RM);

奖励基于三个原则:

  • 有用性(Helpful):判断模型遵循用户指令以及推断指令的能力。

  • 真实性(Honest):判断模型产生幻觉(编造事实)的倾向。

  • 无害性(Harmless):判断模型的输出是否适当、是否诋毁或包含贬义的内容。

第三步则是用强化学习算法(RL) 方式微调 LM。

下图为RLHF学习过程的概述。

图片

Takeaways

  • 超大规模的预训练语言模型的学习目标主要通过预测下一个单词实现,仍不能很好地遵循人类指令,甚至会输出无用的、有害的信息,难以有效对齐人类的偏好。因此,它只是一个基座模型,并不能直接使用。

  • 解决这些问题,需要进行微调改进,其中主要有两种大模型改进技术,包括Google公司在2021年提出的指令微调(Fine-Tuning)以及OpenAI公司2022年提出的基于人类反馈的强化学习 (Reinforcement Learning from Human Feedback, RLHF) 。

  • 正是因为这两项微调技术才促使了以ChatGPT为代表的现代生成式人工智能(GAI)的诞生。

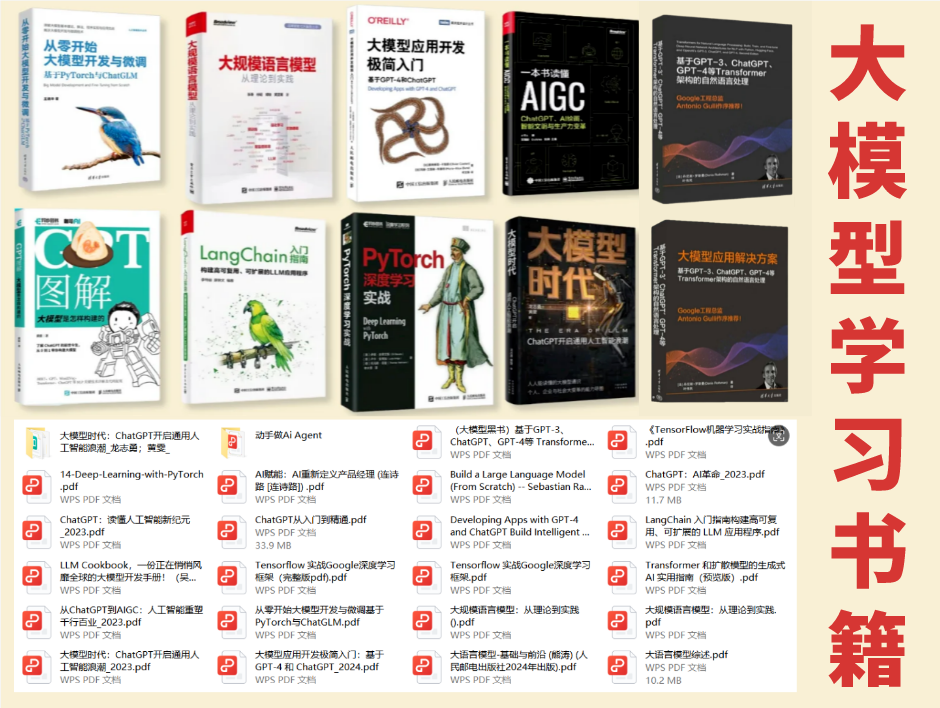
学习书籍文档

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
在这里插入图片描述

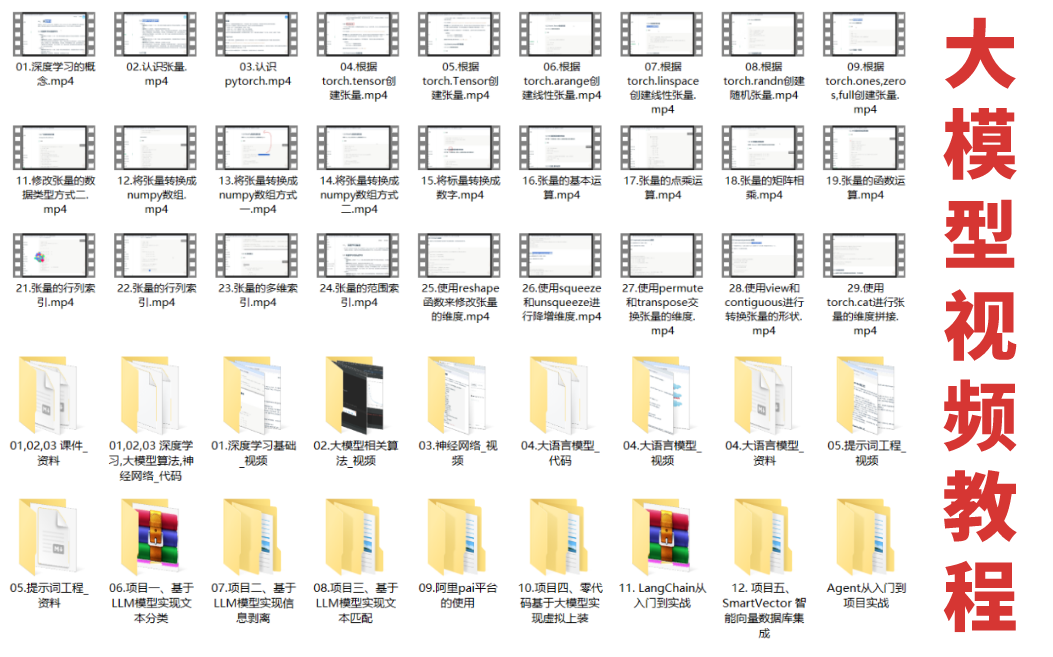
学习视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
在这里插入图片描述

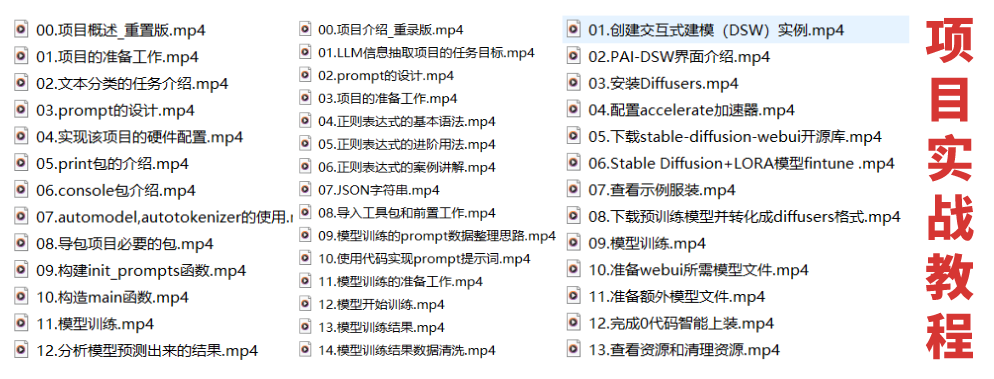
项目实战源码

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
在这里插入图片描述

大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
图片

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取 

参考文献:

1. Illustrating Reinforcement Learning from Human Feedback (RLHF):

https://huggingface.co/blog/rlhf

2. https://www.ibm.com/topics/instruction-tuning

3. https://zhuanlan.zhihu.com/p/682082440

LoRA新手入门指南:用低资源微调大模型 LoRA(Low-Rank Adaptation)是一种高效微调大模型的技术,通过仅训练少量新增参数(通常<1%),实现与全量微调接近的效果。假设你要修改一篇论文,LoRA就像只修改关键段落(新增参数),而不是重写全文(全量训练)。A:在大多数场景下效果接近,但复杂任务(如数学推理)可能需要更高秩或全量训练。A:部署时需同时加载基础模型和LoRA参数,或合并为全量模型(需额外显存)。通过实践,你将在2小时内掌握LoRA的核心逻辑。A:LLaMA模型通常选择。(适合零基础模型开发者) 阅读详情

相关推荐

人工智能_大模型006_CPU微调ChatGLM大模型_Prefix-Tuning微调原理_Prompt-Tuning/P-tuning微调原理_微调_001---人工智能工作笔记0141

上面是prompt-tuning 和p-tuning的区别,可以看到其实,一个就是仅仅添加训练后的向量提示词,一个就是,直接把prompt-tuning的提示词再进行使用BiLSTM和MLP进行编码,编码以后把编码后的提示词,直接融入到模型本身的参数权重中去,这样消耗算力就多.如果是一组固定的,可读的文字,或者自然语言,那么他对,结果的影响是非常大的,那么这个时候,一般用第二种 方法,softprompt,叫做连续prompt,这个就是向量了,就是向量空间优化出来的提示.

添柴程序猿的专栏 885

AI模型进行微调

【代码】AI模型进行微调。

qq_30796747的博客 786

OCR开发车架号识别vin码识别系统

一、vin码识别车架号识别系统简介   vin码识别车架号识别系统,结合VIN码主机厂数据库及自身多年文字识别经验,针对机动车配置参数等信息的查询及采集业务推出的一款VIN码自动识别产品。   车架号识别vin码识别,主要应用在智能手机IOS与Android两个平台中。前端扫描查询模式,无需联网,只需扫描汽车前挡风玻璃右下角的VIN玛(车架号),即可轻松识别出车辆产地、品牌、车

OCR13512721355的博客 1433

AI大模型入门:微调技术

微调(Fine-tuning)是一种在自然语言处理(NLP)中使用的技术,用于将预训练的语言模型适应于特定任务或领域。Fine-tuning的基本思想是采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续训练它。Fine-tuning的概念已经存在很多年,并在各种背景下被使用。Fine-tuning在NLP中最早的已知应用是在神经机器翻译(NMT)的背景下,其中研究人员使用预训练的神经网络来初始化一个更小的网络的权重,然后对其进行了特定的翻译任务的微调。

2301_82275412的博客 1458

RAG——RAG 索引(文档解析技术)

本文介绍了RAG系统中文档解析的关键技术,重点分析了如何通过LangChain的Document Loaders处理多种格式文档。文章指出高质量文档解析对RAG系统效果的决定性作用,并详细讲解了PDF、TXT、Word等常见格式的解析方法。作者提供了代码示例和Gitee开源项目链接,特别强调了PDF解析的深入方案,同时介绍了相关依赖库的安装配置。文章还展示了如何定义通用文档加载方法,为开发者提供了实用的技术参考。

小志的博客 753

Immich vs Nextcloud照片管理实测:自建私有云相册到底选哪个?

本文深度评测了Immich与Nextcloud在私有云相册管理中的表现,涵盖核心功能、性能基准、本土化实践及进阶功能。Immich凭借微服务架构和AI优化在照片管理、移动端体验上表现优异,而Nextcloud则强在生态整合。文章还提供了Docker部署优化和国内网络适配方案,帮助用户根据需求选择最佳方案。

seed的博客 329

AI大模型(LLM)微调并不复杂,数据才是关键:3个实例详解数据准备

微调(Fine-tuning)是一种通过调整预训练模型,使其更好地适应特定任务的技术。它是迁移学习(Transfer Learning)的一种形式,在这一过程中,预训练模型的知识被重新利用并进一步调整,以满足新的数据需求。微调的核心在于利用现有的预训练模型,并通过新的数据调整权重,使其更好地执行目标任务。案例分析: 一个成功的微调案例是,它基于排名19的微调,最终在排名第10,并在聊天、数学和编程任务中表现优异。因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。

2401_85325557的博客 1496

Claude Code 接入 DeepSeek-V4 教程

本文介绍Claude Code的安装配置流程:1) 安装Node.js 18+和Git(Windows);2) 通过npm全局安装@anthropic-ai/claude-code;3) 配置DeepSeek API环境变量(需替换API Key);4) 启动Claude Code或配置VSCode插件。重点包括Linux/macOS和Windows的环境变量设置方法,以及VSCode插件的settings.json配置项。完成配置后即可在终端或VSCode中使用Claude Code功能。

培根芝士的专栏 2011

人工智能领域的微调指的是什么?

微调是AI模型开发中的一个重要步骤,通过将预训练好的模型在特定任务或领域的数据上进行再训练,模型可以在特定任务中展现出更好的效果。它不仅提高了模型的适应性,还能节省大量的计算资源,广泛应用于自然语言处理、计算机视觉、语音识别等领域。

AngelCryToo的专栏 1793

Simscape Multiboby学习笔记1——跟着官网学Multibody

文章目录一. 引言二. Simscape Multibody自学之路三. 本教程的目录 一. 引言 最近在倒腾Matlab的动力学仿真,起因是看到有人推荐Matlab的multbody模块,一经了解之下简直惊为天人。作为一名Matlab的小粉,看到这么好用的模块简直不要太开心,之前用simulink搭飞行器的仿真模型,虽然能够仿真看到六自由度位移,毕竟不能可视化,还是很不够直观,而且simulink仿真(以及更费力的脚本文件仿真)需要精确建模,模型不精确计算也是天差地别。而Multibody在具备其他动力学

qq_30267617的博客 8241

【雕爷学编程】Arduino动手做(111)---震动提醒模块

37款传感器与执行器的提法,在网络上广泛流传,其实Arduino能够兼容的传感器模块肯定是不止这37种的。鉴于本人手头积累了一些传感器和执行器模块,依照实践出真知(一定要动手做)的理念,以学习和交流为目的,这里准备逐一动手尝试系列实验,不管成功(程序走通)与否,都会记录下来---小小的进步或是搞不掂的问题,希望能够抛砖引玉。

雕爷学编程 1898

【大模型微调】什么是大模型微调?微调新手入门全流程友好指南!

在 AI 快速发展的当下,大模型已广泛应用于自然语言处理、计算机视觉等领域。但通用大模型如同万能钥匙,面对特定精细化任务时难以满足需求。大模型微调技术由此诞生,它能让模型更好适配特定任务,显著提升性能。如果你是想入门大模型微调的新手,这份全流程指南将助你一臂之力。接下来,让我们开启探索之旅。

m0_48891301的博客 1549

【ComfyUI】SDXL + 单LoRA 房屋平面图渲染装修

本文介绍了一种基于ComfyUI的室内平面设计图自动生成效果图的工作流。该流程通过导入房屋平面图,结合SDXL室内设计模型与北欧风格LoRA模块,快速生成多房间效果展示。工作流包含图像输入、文本处理、模型加载和图像生成等环节,支持风格化渲染和细节补充,适用于建筑设计、家装展示、房地产营销等场景。核心采用SDXL通用室内设计模型和北欧极简LoRA,通过节点衔接实现自动化批量生成,能在短时间内将平面方案转化为逼真的三维效果图。该技术可提升设计呈现效率,辅助客户决策,并应用于教学研究领域。

Mr数据杨 3659

大模型微调:概念、技术与实践指南

本文系统介绍了大语言模型微调技术,包括全参数微调和参数高效微调(PEFT)两类方法。重点阐述了LoRA、适配器等技术原理,并提供了中文GPT-2模型微调为对话系统的完整实践案例,涵盖数据准备、训练配置到模型评估的全流程。针对显存限制问题,提出了混合精度训练、梯度累积等优化策略,并比较了不同微调方法的适用场景。最后总结了过拟合、灾难性遗忘等常见问题的解决方案,为开发者定制大模型提供了实用指导。

Q2024107的博客 1837

彻底解决Win11锁屏界面黑屏或者图片不变化

windows锁屏后黑屏

renkai721的专栏 1万+

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

大模型入门:微调技术全解

微调(Fine-tuning)是一种在自然语言处理(NLP)中使用的技术,用于将预训练的语言模型适应于特定任务或领域。Fine-tuning的基本思想是采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续训练它。Fine-tuning的概念已经存在很多年,并在各种背景下被使用。Fine-tuning在NLP中最早的已知应用是在神经机器翻译(NMT)的背景下,其中研究人员使用预训练的神经网络来初始化一个更小的网络的权重,然后对其进行了特定的翻译任务的微调。

大模型训练 955

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【大模型微调】一文读懂大模型微调:新手入门全流程保姆级指南!

在 AI 快速发展的当下,大模型已广泛应用于自然语言处理、计算机视觉等领域。但通用大模型如同万能钥匙,面对特定精细化任务时难以满足需求。大模型微调技术由此诞生,它能让模型更好适配特定任务,显著提升性能。如果你是想入门大模型微调的新手,这份全流程指南将助你一臂之力。接下来,让我们开启探索之旅。

AI大模型的博客 2647

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

这一篇带你入门大模型微调,大模型微调从入门到精通,收藏这篇就够了!

分解成两个低维度(矩阵运算 m * r * r * n =m* n),上图中数据 x 都要给原来的模型和分解后的模型(的 r 矩阵,也就是 Lora 矩阵) 训练,用的时候要合并。

h1453586413的博客 1401

【大模型微调】LoRA入门指南,教你低成本微调大模型超实用方法!

LoRA 是一种高效微调大模型的技术方案。不改原模型,只在关键层插入极少量可训练参数,通过这部分“小打小闹”的优化,就能获得和全量训练相近的效果。可以这样理解:如果全量微调是一篇论文的“通篇重写”,那 LoRA 就只是“修改几段关键内容”,成本低、效率高,而且效果还不差。

m0_63171455的博客 5850

初学者入门AI大模型微调,从入门到进阶指南!看完这篇你就懂了!

很多AI新手在接触大模型时都会被"微调"二字劝退。想实战没有环境?自己根本玩不转?本文带你用一杯咖啡的时间,了解大模型的微调技术,无需高端显卡,用魔塔社区免费资源即可实战体验,在实战中理解微调技术,感受薅羊毛的快乐!

2401_85325726的博客 1342

【大模型入门指南 12】LISA微调技术解析 - 大模型低显存全参训练技术

LISA是Layerwise Importance Sampling for Memory-Efficient Large Language Model Fine-Tuning的简写。这个技术可以把全参训练的显存使用降低到之前的三分之一左右,而使用的技术方法却是非常简单的。例如,全参训练一个7b模型大约需要80G显存(相当于一张完整的A100显卡),但使用LISA训练后却可以使显存降低到30G左右,这使得使用40G A100显卡甚至是24G A10或者RTX 3090成为可能,且它的显存占用更低、训练速度更

一个程序猿的AI转型之路 2078

Qwen2大模型微调:从零开始的全面指南

Qwen2是通义千问团队最近开源的大语言模型,由阿里云通义实验室研发。以Qwen2作为基座大模型,通过指令微调的方式做高精度文本分类,是学习LLM微调的入门任务。在本文中,我们会使用 Qwen2-1.5b-Instruct 模型在 复旦中文新闻 数据集上做指令微调训练,同时使用SwanLab监控训练过程、评估模型效果。采用了Lora方法,所以显存要求不高,10GB左右就可以跑。代码:完整代码直接看本文第5节 或 Github,Jupyter Notebook。

2401_84204207的博客 2075

大模型入门之微调技术

微调(Fine-tuning)是一种在自然语言处理(NLP)中使用的技术,用于将预训练的语言模型适应于特定任务或领域。Fine-tuning的基本思想是采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续训练它。Fine-tuning的概念已经存在很多年,并在各种背景下被使用。Fine-tuning在NLP中最早的已知应用是在神经机器翻译(NMT)的背景下,其中研究人员使用预训练的神经网络来初始化一个更小的网络的权重,然后对其进行了特定的翻译任务的微调。

大模型教程的博客 1181

AI大模型底层技术——LoRA微调

是一种针对大型预训练语言模型 (LLMs) 的高效微调技术。它旨在解决全参数微调所带来的计算和存储成本问题。冻结预训练模型的原始参数,并通过引入少量可训练的低秩矩阵来模拟参数更新。这样,在微调过程中,只需要优化这些低秩矩阵的参数,而不需要修改原始模型的参数,从而大大减少了需要训练的参数量。

HUANGXIN9898的博客 1833

什么是大模型微调?如何对大模型进行微调?大模型入门到精通,收藏这篇就够了

从GPT-3到ChatGPT,再到GPT-4和GitHub Copilot,微调在这些过程中发挥了重要作用。什么是微调?微调能解决哪些问题?LoRA又是什么?如何进行微调?本文将解答上述问题,并通过代码示例展示如何使用LoRA进行微调。微调的技术门槛不高,对于规模不超过100亿参数的模型,所需的硬件成本也不高(100亿参数的模型并非玩具,许多实际应用中会使用这种规模的模型)。即使是非专业的算法人员,也可以尝试微调自己的模型。除了ChatGPT和GitHub Copilot,微调还可以应用于许多其他领域。

Python单行客的博客 1823

大模型入门必看系列:微调技术

微调(Fine-tuning)是一种在自然语言处理(NLP)中使用的技术,用于将预训练的语言模型适应于特定任务或领域。Fine-tuning的基本思想是采用已经在大量文本上进行训练的预训练语言模型,然后在小规模的任务特定文本上继续训练它。Fine-tuning的概念已经存在很多年,并在各种背景下被使用。Fine-tuning在NLP中最早的已知应用是在神经机器翻译(NMT)的背景下,其中研究人员使用预训练的神经网络来初始化一个更小的网络的权重,然后对其进行了特定的翻译任务的微调。

2301_76168381的博客 1302
上一篇: AI大模型入门指南1:概念
下一篇: AI大模型入门指南3:提示工程
AI小模型
博客等级 码龄6年 6863粉丝 487原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

AI小模型

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值