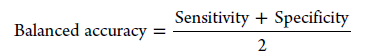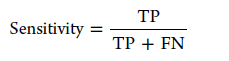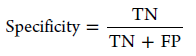AI4S: 利用机器学习探究铝合金缓蚀剂的结构-性能关系

损失函数与优化器:从「梯度是怎么被造出来的」到「梯度是怎么被用掉的」 本文揭示损失函数与优化器本质一体:优化器仅依赖损失产生的梯度,而损失决定梯度的方向、尺度与噪声特性。错误的损失选择(如分类用MSE)会导致梯度失衡,使优化器失效;不同损失(如Huber、Focal)通过调控梯度分布影响优化过程。实测表明,归约方式、标签结构与损失配对直接决定梯度行为,进而影响收敛性与泛化。核心观点:选对损失,才是让优化器“看得懂”的前提。 阅读详情

解决方案摘要:

有机缓蚀剂在替代传统防护技术方面发挥着至关重要的作用,因为传统防护技术存在严重的毒性问题,比如用重金属无机盐作为腐蚀抑制剂。然而,为什么一些有机化合物能抑制腐蚀,而另一些则不能,其中的机理至今仍不清楚。

本案例测试了不同的机器学习(ML)方法,以区分常用的铝合金高效缓蚀剂。研究成果可以大大有助于在未来自动搜索新的更高效的防腐解决方案:

(i) 确定了一种ML算法,该算法能够正确地分类有效抑制剂(即,效率超过50%)和非抑制剂(即,效率低于或等于50%),即使在同一数据集中包含了不同pH下不同合金的信息,这可以显著增加可用来训练模型的信息;

(ii) 对与分子自关联相关的新描述符进行了评估,但对模型的预测能力的改进有限;

(iii) 确定了抑制剂和非抑制剂的描述符的平均差异,有可能作为选择潜在抑制分子体系的指南。

该案例表明ML可以作为一种工具来执行分子的初始虚拟筛选,从而显著加快该领域的研究。

引言

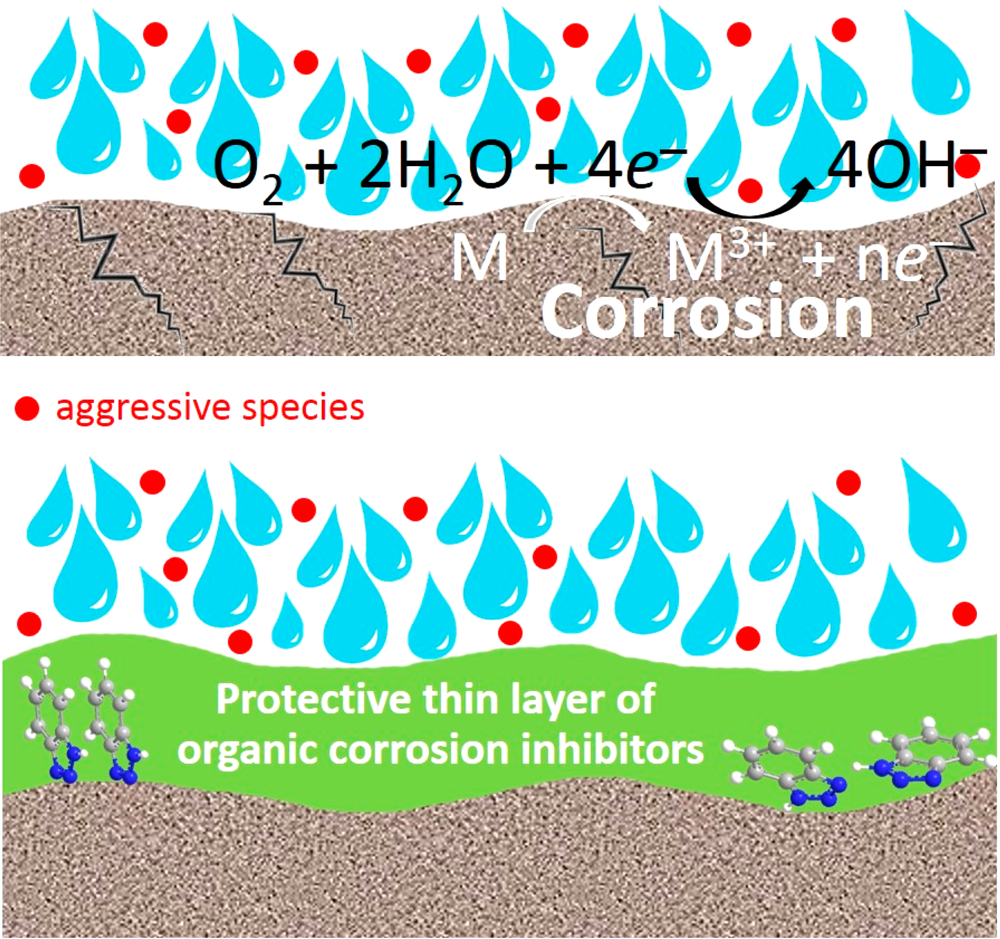
金属露在腐蚀介质中(水环境和氧气),金属腐蚀通常是氧化还原电化学反应的结果,即氧气的还原和金属的氧化。当金属表面有缓蚀剂保护膜时,缓蚀剂吸附在金属表面形成一层致密的保护膜,有效阻碍了腐蚀介质与金属的直接接触,从而起到抑制腐蚀电化学的反应。
P1.png

图1 铝表面的腐蚀电化学过程,包括阴极和阳极反应(上图),以及典型缓蚀剂(如1,2,3-苯并三唑)的吸附,以取代水分子并保护表面免受腐蚀性物种的侵害。

为了快速地筛选出高效的铝合金缓蚀剂分子,本案例采用机器学习方法对缓蚀剂的结构-性能关系进行研究,并对不同的ML算法进行比较分析,以区分铝合金的缓蚀剂和非缓蚀剂化合物的分类。这项工作有助于更好地理解每种算法的优缺点,从而预测有机化合物的缓蚀潜力。案例还提供与缓蚀剂最简单形式的自缔合有关的新描述符,即二聚化焓和二聚化吉布斯能。这些描述符是分子之间相互作用的强度的一个粗略的近似值,以在金属表面上形成粘性薄膜。这种薄膜还可以演变成多层,防止或至少减少侵略性物种与金属表面的相互作用。虽然二聚化能的计算通常比获得电子量子特性的计算要求更高,但它提供了与机械过程(保护膜形成过程中分子的自相互作用)更紧密的并行性,而仅通过将抑制效率与电子特性联系起来是无法实现的。

建立AI预测模型

1、 数据和描述符

本文共研究了102个有机化合物,其中主要包括芳香族基团和/或氨基、羧基、羟基和硫醇基团,涉及到两种铝合金AA2024和AA7075,以及弱酸性(pH4)和碱性(pH10)条件,总共有408个数据条目。

描述符种类:分子量、分子折射率、辛醇/水分配系数、极性表面积、分子体积、分子面积、极性体积、给体原子数、环数(芳香族或非芳香族)、疏水基团数、受体原子数和旋转键数、AA2024_pH4抑制效率、AA2024_pH10抑制效率、AA7075_pH4抑制效率、AA7075_pH10抑制效率、二聚化焓和二聚化吉布斯能。

2、 方法

机器学习方法:K近邻、决策树、带Boosting的决策树、定义错误代价的决策树、Bagging、随机森林、分类规则、人工神经网络和支持向量机。

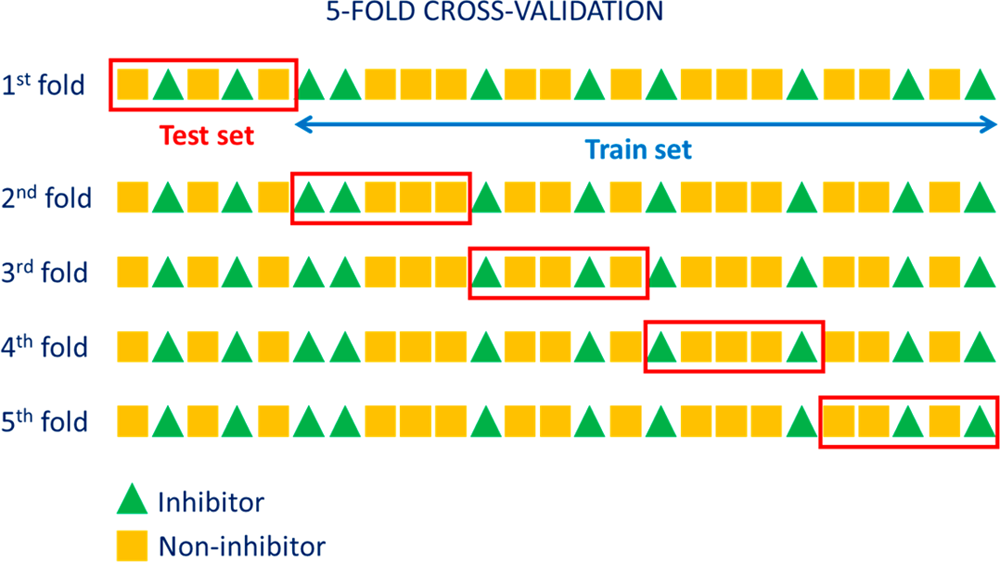
为了评估预测模型,案例采用了5倍交叉验证方法(图2)。
P2.png

图2 举例说明本工作中采用的5倍交叉验证统计方法。

结果与讨论

1、探索性数据分
P3.png

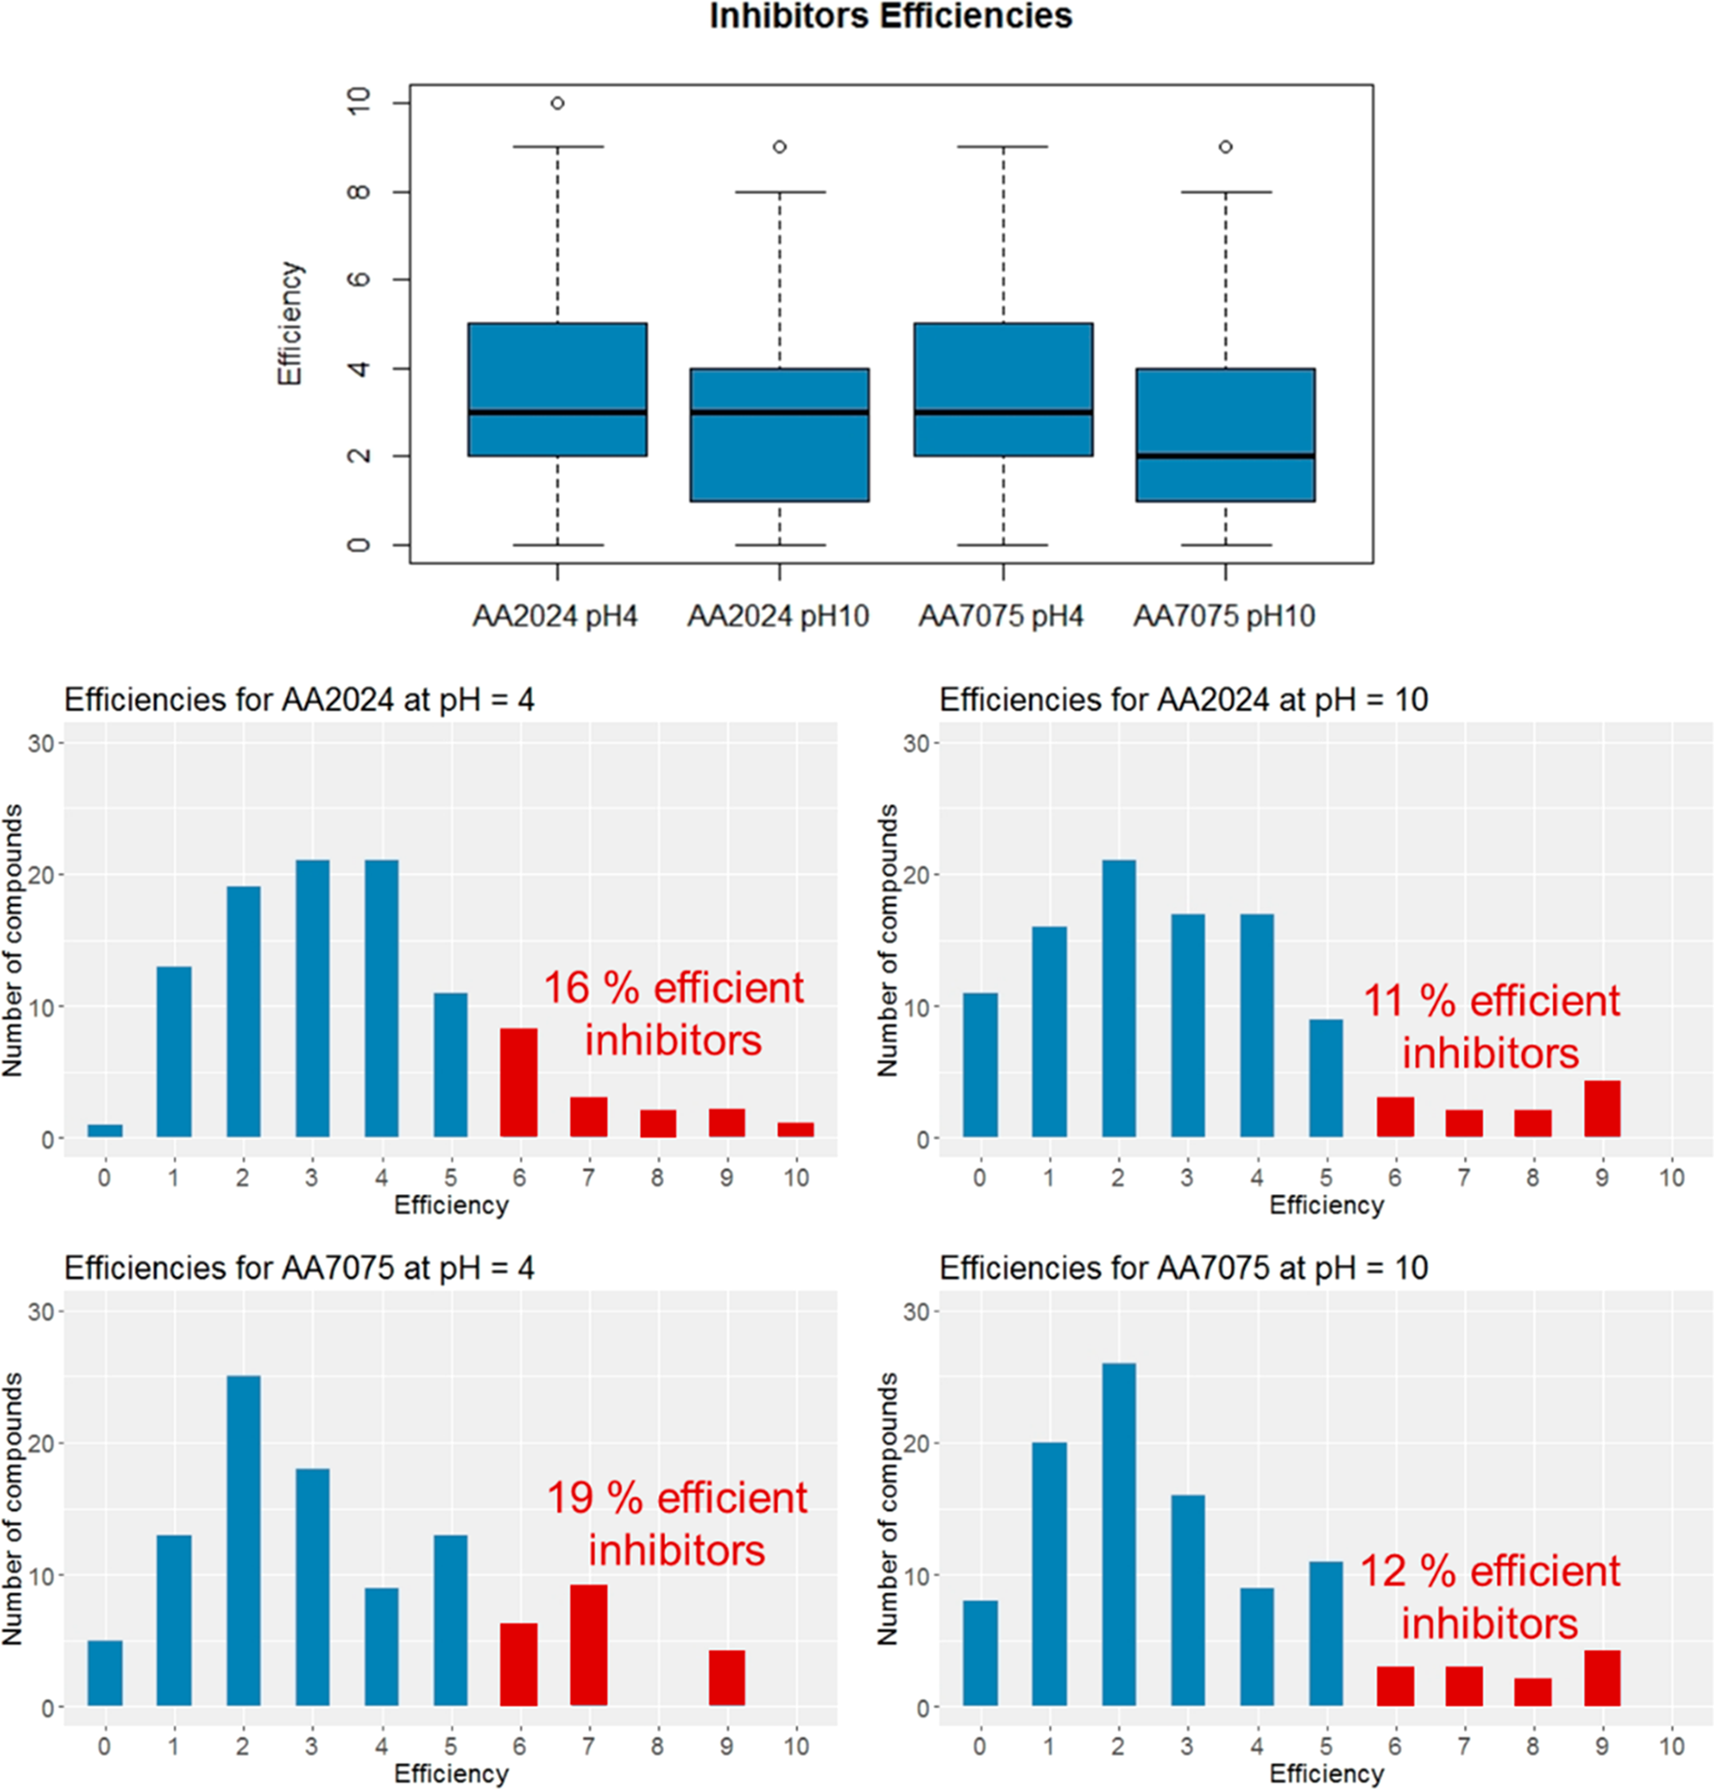
图3 显示了本案例中评估的不同条件下实验抑制效率(方框图和条形图,纵坐标0表示没有缓释作用)

根据箱形图可看出碱性条件下抑制剂的效率低于酸性条件下的效率。从柱状图可以看出,有效缓蚀剂的数量比弱缓蚀剂和非缓蚀剂的数量要少得多,这使得ML算法更难了解数据并正确识别化合物为缓蚀剂。
P4.png

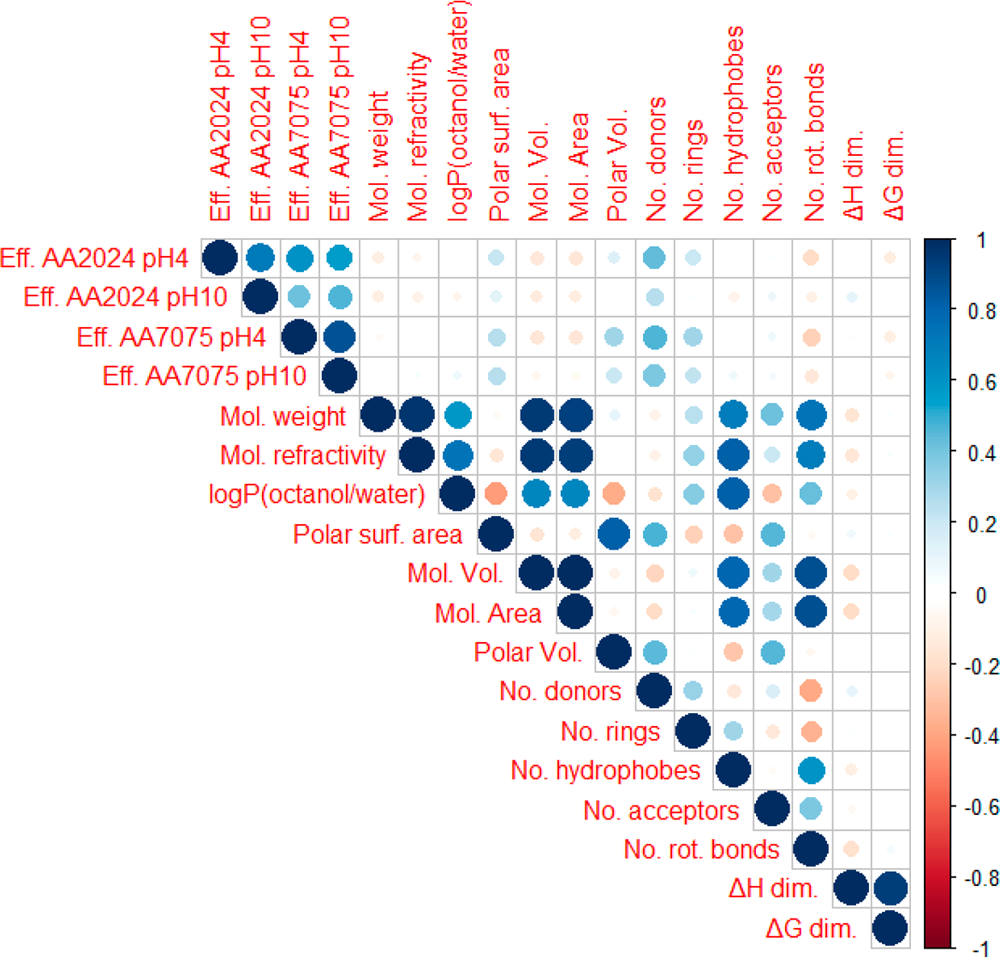
图4 抑制效率和描述符回归分析得到的线性相关图(蓝色表示正线性相关,而红色表示负线性相关。圆越大表示绝对线性相关值越高,而圆越小或没有则表示绝对相关值越低或线性相关为零)。

图4研究结果表明只有氢键供体原子数与抑制效率有较好的相关性,其次是极性表面积、极性体积和环数。这表明,能够作为缓蚀剂的分子结构的识别是一个高度非线性的问题,线性回归是没有用的。

2、 不同机器学习方法的对比
P5.png

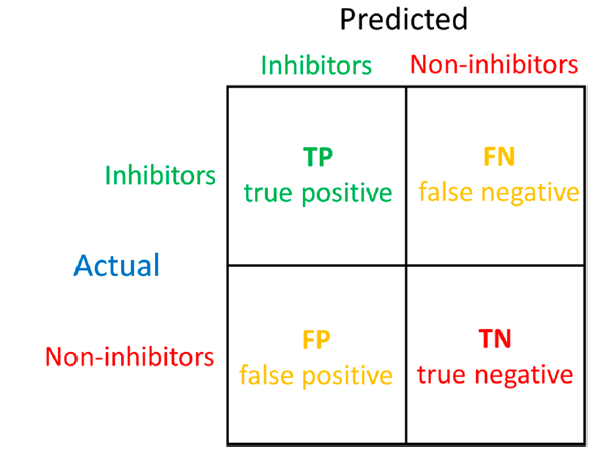
图5 抑制剂和非抑制剂分类的四种可能结果。

GS1.png

GS2.png

GS3.png

对于分类任务,性能指标考虑测试集的类别。感兴趣的类别(此处为缓蚀剂)称为正类别,而另一类非缓蚀剂称为负类别。两类缓蚀剂之间的关系如图5所示,包括四种可能的结果:(i)真阳性(TP),正确分类的缓蚀剂;(ii)真阴性(TN),正确分类的非腐蚀抑制剂;(iii)误报(FP),被归类为缓蚀剂的化合物,实际上是非缓蚀剂;(iv)假阴性(FN),被归类为非缓蚀剂但实际上是缓蚀剂的化合物。公式1、2和3定义的平衡准确性、灵敏度和特异性被用作分类的性能指标。
P6.png

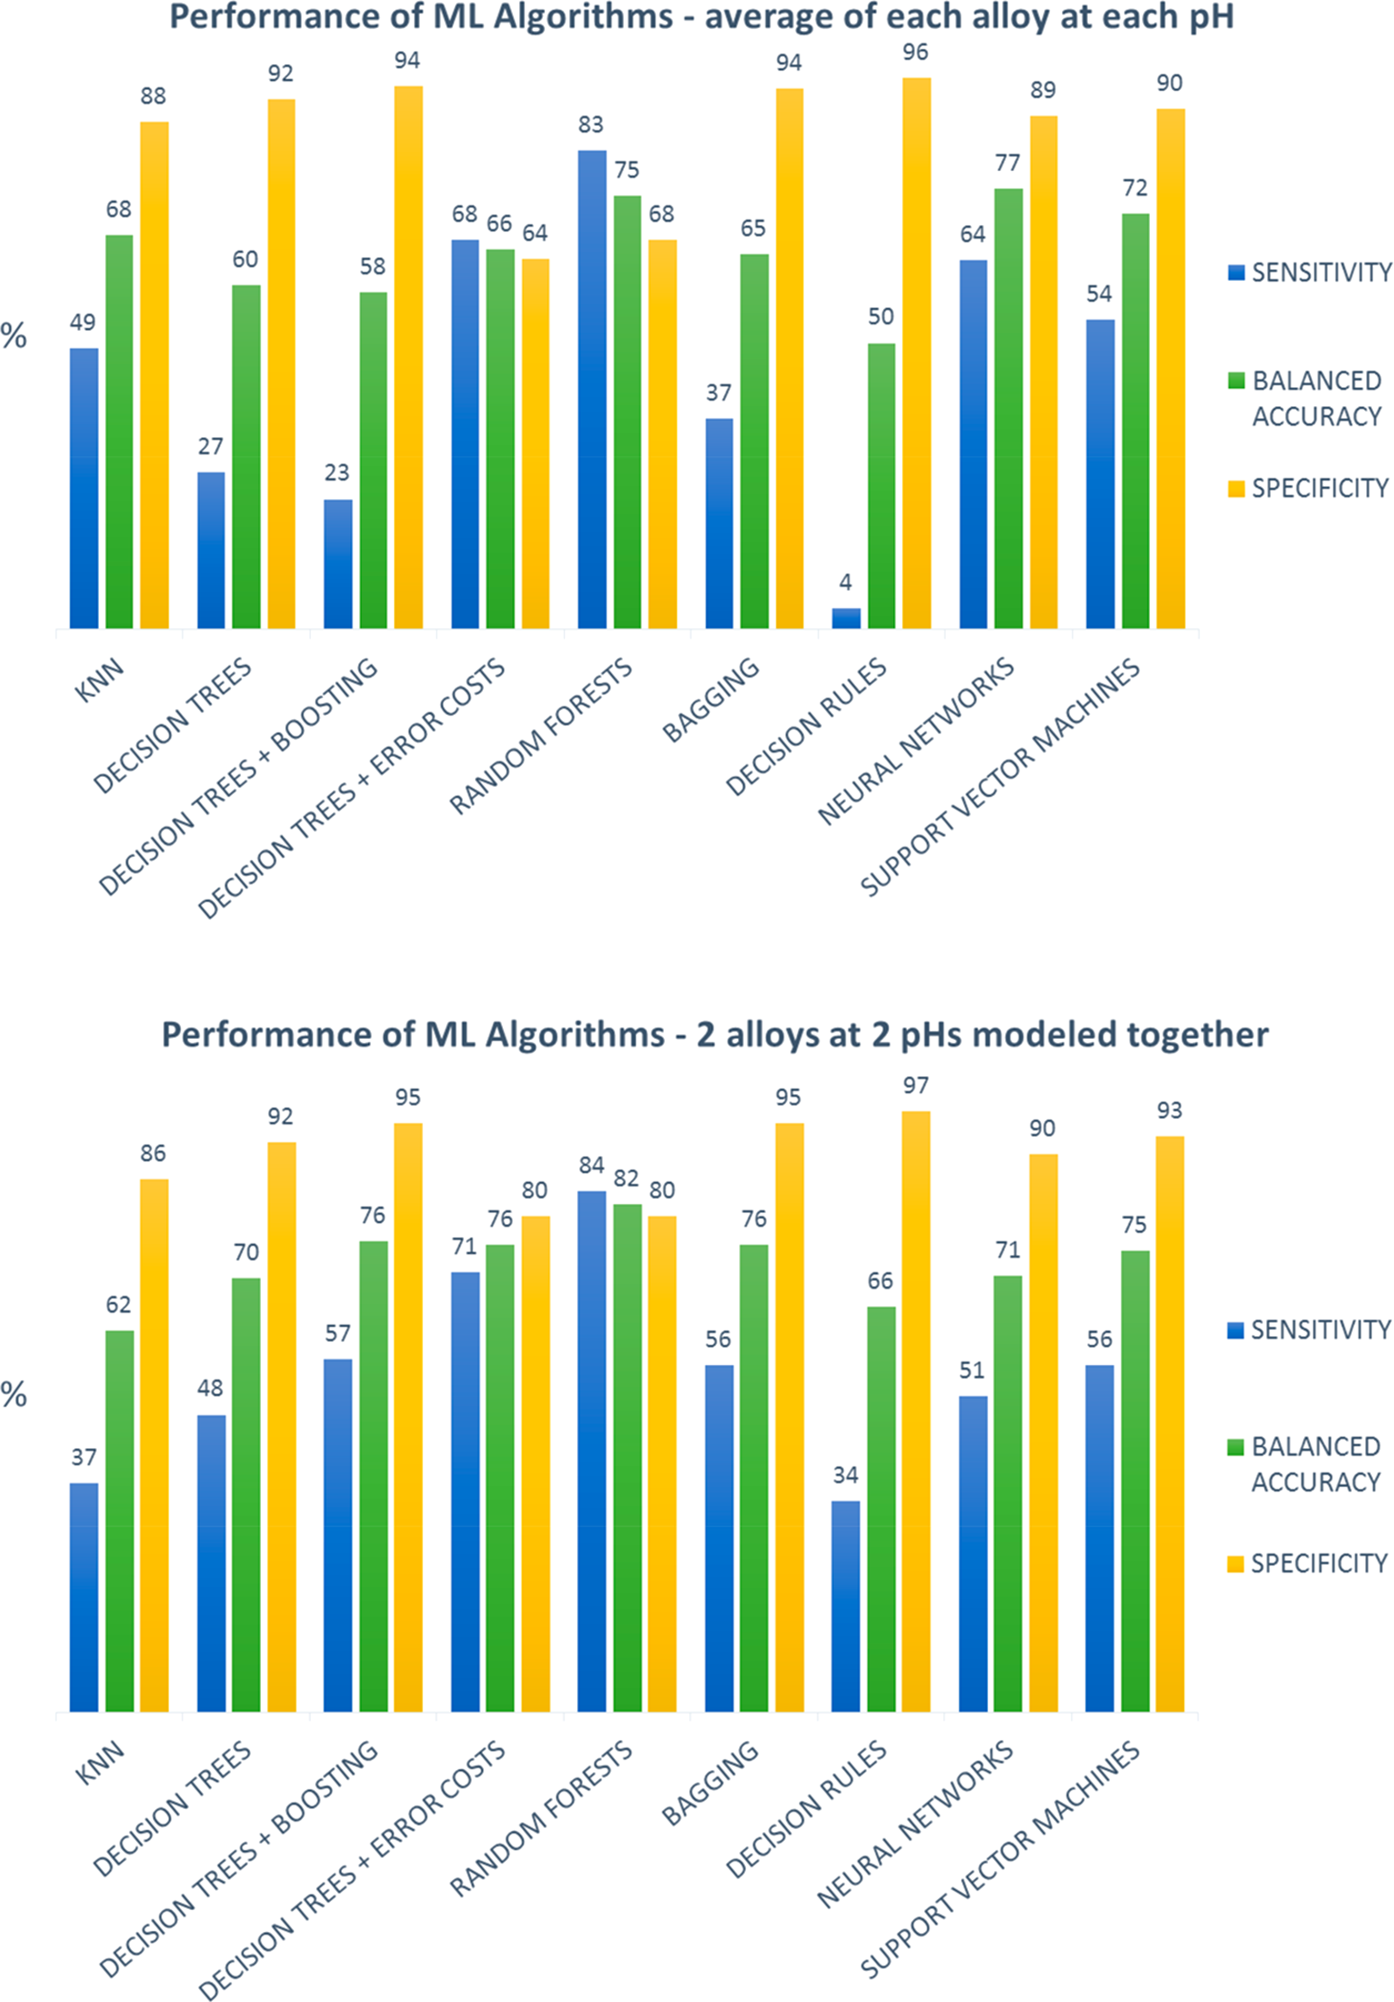
图6 (上图)ML算法分别研究两种合金在不同pH条件下的数据集的性能,(下图)ML算法研究同时包含两种合金在不同pH条件下的数据集的性能。

图6研究结果表明大多数方法的特异性接近90%,甚至更高。然而,高特异性(正确识别非抑制剂的概率)可能是由于数据集中非抑制剂的数量较多。因此,在统计上,他们的正确识别更可能是偶然的。另一方面,灵敏度是指正确分类真正抑制剂的概率,这些抑制剂的数量较少,并且也是具有本研究所关注条件(缓蚀)的化合物。在本研究中使用的数据集中,只有10−20%的化合物的缓蚀效率高于50%(标记为缓蚀剂);因此,80−90%的化合物的缓蚀效率等于或低于50%(标记为非缓蚀剂)。因此,例如,如果某个特定算法预测每种化合物都是非缓蚀剂,则其特异性将达到100%,但其性能仍然不令人满意,因为它无法正确识别任何缓蚀剂。因此,最重要的参数是平衡精度,由于数据集中缓蚀剂和非缓蚀剂的数量不平衡,本研究中使用的精度与其他文献类似,50和灵敏度是正确识别的真实缓蚀剂的比率。当考虑到在两种pH条件下对应于两种合金的四个独立数据集的平均平衡精度时,算法的性能顺序如下:分类规则<带boosting的决策树<决策树<bagging<定义错误代价的决策树<k近邻<支持向量机<随机森林<人工神经网络。关于灵敏度(正确识别真正的缓蚀剂),以下三种方法对单个数据集具有最佳性能:具有误差成本的决策树<人工神经网络<随机森林。神经网络是本研究中针对单个数据集测试的最平衡的方法,在灵敏度和平衡精度之间具有最佳折衷,而随机森林具有最高的灵敏度。

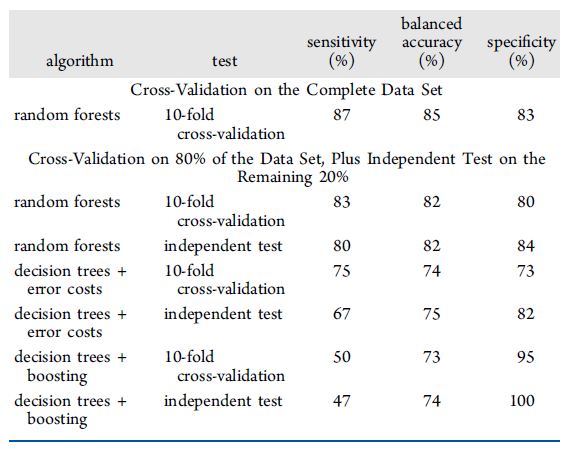
为了为算法的训练阶段收集更多数据,将对应于两种合金的四个子数据集(各102个示例)混合在一个数据集中,每个数据集分别测试两个pH值,共包含408个数据点。执行此测试的目的是,如果成功,它将打开构建更大数据集的大门,其中包含对应于不同合金、条件以及(期望的)不同金属的实验测试。表1研究结果表明,特别是随机森林,具有平衡的准确性和82%的特异性,以及84%的灵敏度,从更复杂的数据集(包括其他因素和条件,例如不同类型的金属、抑制剂浓度和腐蚀环境类型)中识别缓蚀剂看起来非常令人鼓舞。

表1 在两种合金和pHs一起建模的情况下,对复合数据集进行性能测试的灵敏度、准确性和特异性,这三种方法具有最高的灵敏度。
T1.png

3、缓蚀剂的主要特征

P7.png

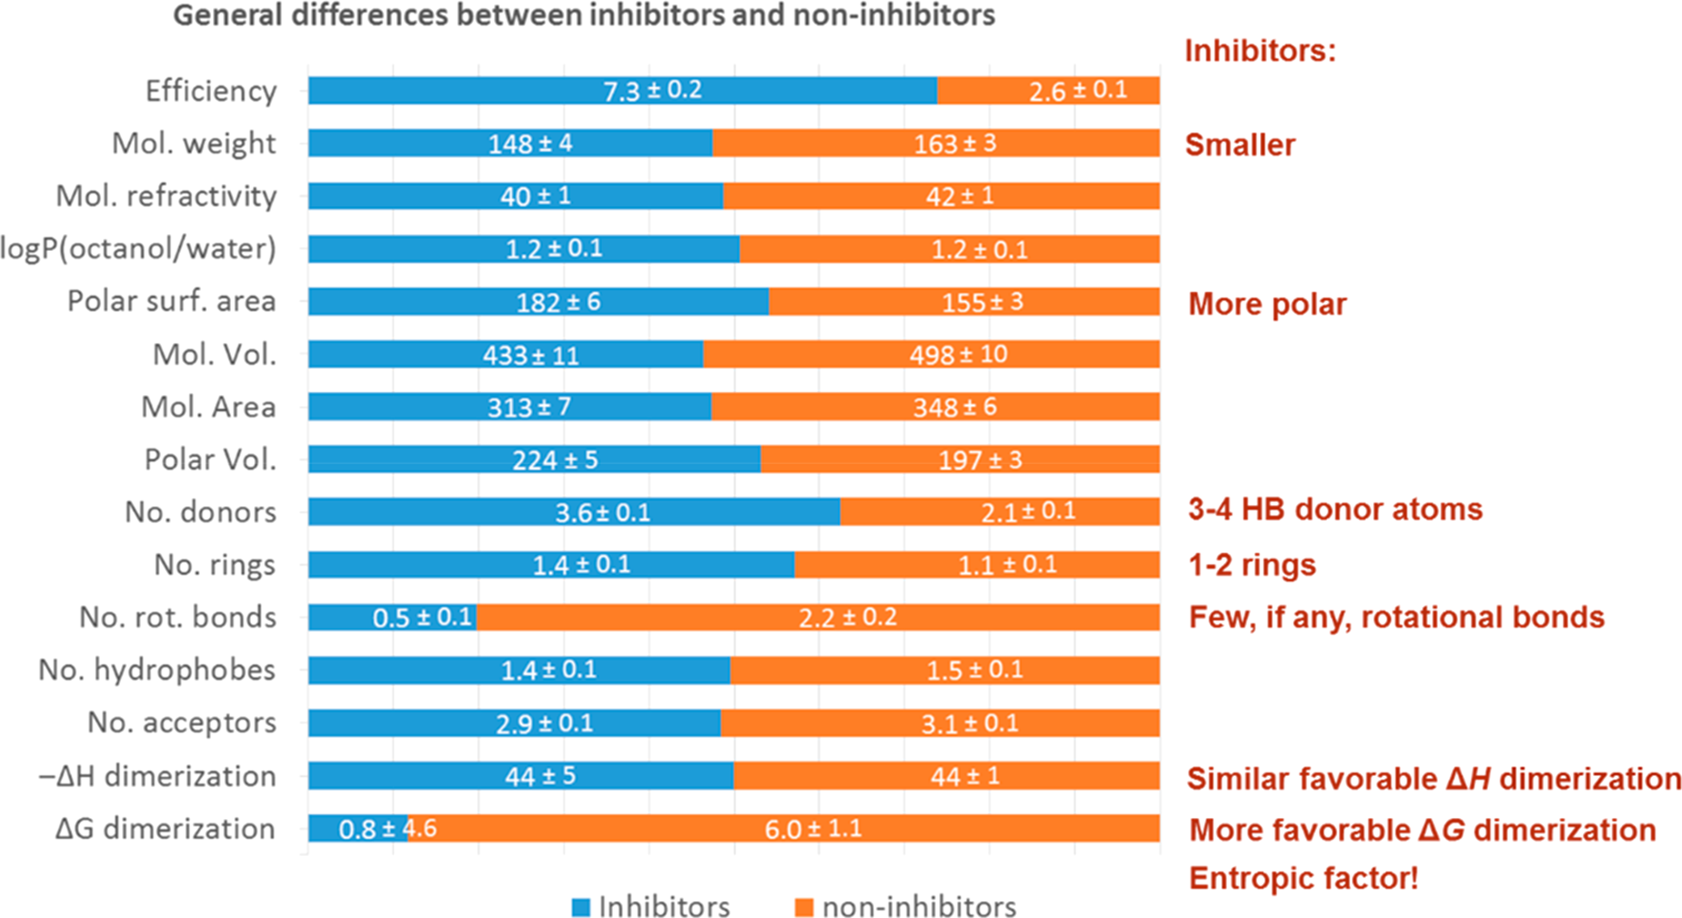
图7 缓蚀剂的主要特征

为了进一步了解区分抑制剂和非抑制剂的特性,获得了整个可用数据的平均值。结果表明,缓蚀剂具有一个或两个芳香环,旋转键很少或没有(大量旋转键不利于缓蚀)。它们的极性也更强,有3到4个氢键供体原子,并且具有更有利的二聚化吉布斯能;

尽管二聚化焓也是有利的,但抑制剂和非抑制剂的二聚化焓是相同的。更有利的吉布斯能和相似的二聚焓也表明了熵项对二聚体形成的重要性,这也与更高的抑制效率有关。

结论

1、通过该研究提供了一种不需要用实验方法评价缓蚀剂的效果,并且该研究发现,随机森林是最成功的方法。

2、对于四个独立的数据集(AA2024和AA7075,在pH 4和pH 10下),随机森林的平均准确率为68%,同时能够正确识别83%的抑制剂。这表明在未来,分析数据不仅包括不同类型的合金和pH,还可能包括其他电解质条件,如腐蚀性阴离子浓度、抑制剂浓度,甚至金属类型。

3、引入二聚焓和吉布斯能作为保护膜形成过程中分子间相互作用的间接衡量指标。

4、对抑制剂和非抑制剂性能的平均值进行了统计分析,表明抑制剂具有一个或两个旋转键很少或没有旋转键的芳香环。此外,大量的旋转键似乎阻碍了缓蚀。抑制剂的极性更强,结构中有3到4个氢键给体原子,并且具有更有利的二聚化吉布斯能,尽管二聚化焓也很有利,但抑制剂和非抑制剂的二聚化焓相同,这表明二聚化熵是保护机制的重要因素。

参考文献:

J. Phys. Chem. C 2020, 124, 5624−5635. https://dx.doi.org/10.1021/acs.jpcc.9b09538

CFturbo 2024保姆级教程:从流量扬程到三维叶轮,手把手搞定离心泵水力设计 本文提供CFturbo 2024离心泵水力设计的全流程实战指南,从流量扬程参数输入到三维叶轮模型导出,详细解析设计步骤与优化技巧。涵盖叶轮尺寸确定、子午面型线设计、叶片角度调整等关键环节,帮助工程师高效完成CAE辅助的离心泵水力设计,提升设计质量与效率。 阅读详情

相关推荐

低温ECR-MOCVD生长(002)GaN:椭偏仪测厚与电学性能

本研究用ECR-MOCVD在Si(111)和蓝宝石衬底上低温生长GaN薄膜,蓝宝石1.0SCCM、2h样品呈完全(002)择优取向,椭偏仪测厚32.81nm,迁移率10.42cm²/(V·s)。文章梳理了生长温度、TMGa流量与生长时间对结晶取向、膜厚、粗糙度、光学带隙和电学性能的影响。

Flexfilm_的博客 383

Ubuntu 24.04.3 LTS 安装 OpenClaw 图文版

OpenClow安装指南

qq_17204557的博客 2554

从认识人工智能到理解机器学习:我的 AI 入门第一课

正式开始学习人工智能之前,我对 AI 的认识其实比较模糊:知道 ChatGPT、知道大模型,也知道现在很多岗位都在谈 AI,但如果有人问我“人工智能到底是什么”“机器是怎么学会识别一只猫的”,我未必能从头到尾讲清楚。上午的课程更偏向行业全景:人工智能的发展、研究方向、NLP、岗位分工、学习路线和 AI Coding 工具。下午的课程更偏向技术基础:机器学习的原理、有监督学习、深度学习、模型训练和评估方法。

chh563的博客 493

安卓app逆向破解脱壳教程

From:Hook 神器家族的 Frida 工具使用详解:https://blog.youkuaiyun.com/FlyPigYe/article/details/90258758 详解 Hook 框架 frida (信抢红包):https://www.freebuf.com/company-information/180480.html APP逆向神器之Frida【Android初级篇】:https://www.jianshu.com/p/2d755beb1c54 frida 官网文档:https://fr..

sinat_28371057的博客 2万+

基于江协科技STM32创建HAL库工程模板

基于江协科技STM32入门教程创建的HAL库工程模板

2401_82728381的博客 1136

Hugging Face:成为机器学习界的“Github”

以下文章来源于OneFlow,作者OneFlow社区五年前,AI领域的知名研究者Andrej Karpathy发文称,传统人工编程属于“软件1.0”,“软件2

2601_96798011的博客 144

YOLOv改进 | YOLOv11更换主干Backbone之MobileNetV2(轻量化主干网络结构--高效轻量移动模型)

本文提出将YOLOv11的主干网络替换为轻量化的MobileNetV2,以提升模型在移动端设备的部署效率。MobileNetV2通过倒残差结构和线性瓶颈层,显著减少了计算量和参数量(降至1M~3M),同时保持多尺度特征提取能力。实验表明,改进后的模型在移动设备上可实现20-30 FPS的实时检测,适用于手机APP、无人机和工业监控等场景。核心代码展示了倒残差块的实现,通过深度可分离卷积和通道扩展/压缩实现高效特征提取。

走向CTO的路上... 1461

机器学习基础|监督学习、标签、回归

网约车预估等待时长依赖监督学习中的回归任务。平台利用历史订单数据,以司机实际到达耗时为标签,通过上车点、时间、运力、路况等特征训练模型。模型不断优化预测值与真实耗时的误差,最终对新订单输出连续的预估等待时间,实现精准预测。

weixin_43971465的博客 264

Qualcomm Camera 启动优化实战:Preview、Snapshot、ZSL 路径控制与时延剖析

在移动终端上,Camera 的“启动速度”与“抓拍响应”是决定用户体验的关键指标。以 Qualcomm Snapdragon 平台为代表,Camera Stack 涉及 HAL 初始化、Session 配置、ISP 路径激活、Buffer 分配、图像流启动等多个异步流程,稍有设计不当将导致 Preview 启动缓慢或抓拍延迟明显。本文基于高通平台架构与 CamX 实战经验,详细剖析 Preview 与 Snapshot 启动路径,重点分析 ZSL 模式下的全链路优化策略,给出具体时延测量方法与调试参数建议。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1585

matlab处理las点云(1)——las/laz格式解析【2024最新版】

matlab中的las/laz格式解析。博客长期更新,本文最近一次更新时间为:2024年11月9日。

点云侠的博客 8460

机器学习——混淆矩阵(待更新)

二元: true表示真实==预测,positive表示预测值=1.

m0_61175448的博客 170

【PostgreSQL数据分析实战:从数据清洗到可视化全流程】5.2 数据分组与透视(CUBE/ROLLUP/GROUPING SETS)

【PostgreSQL数据分析实战:从数据清洗到可视化全流程】5.2 数据分组与透视(CUBE/ROLLUP/GROUPING SETS)

kngines 1838

LoRA的低秩数学与QLoRA实现

本文系统解析了LoRA及其进阶版QLoRA在十亿参数模型微调中的高效机制。通过低秩假设,将权重更新量ΔW近似为低秩矩阵积,显著压缩可训练参数与显存占用;QLoRA进一步将基座模型量化至4比特(NF4),结合双重量化与分页优化器,实现65B模型单卡微调。文章详解了B初始化为零、缩放系数α/r设计、挂载位置选择等关键实操细节,并给出可运行代码。实践表明:4比特基座+高精度LoRA在多数任务上媲美全参微调,且训练效率极高。超参方面,r不宜过大,学习率需上调,数据质量重于数量。最后强调:LoRA适用于风格适配与领域

2601_96733043的博客 318

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Spark06_MLlib机器学习

本文是《PySpark 从入门到实战》系列收官篇,带你用 Spark MLlib 走通机器学习全流程:从三要素与 7 步标准流程讲起,剖析 KNN、朴素贝叶斯、决策树三大算法原理,再以 KNN 手写、垃圾短信分类、决策树分类、逻辑回归鸢尾花(准确率 96.67%)、K-Means 聚类(轮廓系数 0.7345)五个案例落地,最后详解 TF-IDF 文本特征与余弦相似度。全文代码可直接运行,适合有 RDD 与 Spark SQL 基础的开发者快速上手。

2301_80420058的博客 469

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

AI小白入门|无监督学习到底是什么?

很多新手看完无监督学习的定义只会死记硬背。本文避开复杂公式,从真实业务场景切入,对比监督学习,讲清楚无监督学习的核心价值、适用场景、底层逻辑和容易踩坑的认知误区,帮你理解它在机器学习链路里的定位。

weixin_43971465的博客 194

机器学习01,KNN使用与简单数学原理

个人笔记

qq_59247073的博客 273

SVM支持向量机通俗解析:找到机器学习的“最优分界线”

一、爆款钩子:同样是画分界线,为何SVM能成为机器学习的“王者选手”?做机器学习的人,几乎都绕不开一个问题:如何给混乱的数据“分家”?有人用逻辑回归,有人用KNN,但有一个算法

2601_96798737的博客 147

机器学习03,端到端02

个人笔记

qq_59247073的博客 274

GaN 动态导通电阻测试专题:电流崩塌从哪来,测量窗口怎么选

但器件装到实际电路上跑一段时间,或者用双脉冲台架模拟开关工况再测导通压降,数值往往明显高于手册静态值,而且关断应力越强(母线电压越高、应力保持越久),抬升越明显;:使用钳位电压探头,把示波器通道的工作区间限制在低电压区(常见做法是钳位在 1.5V 附近的导通压降区),应力高压段由钳位电路吸收,导通段以高分辨率采样。台架搭建相对简单,是器件表征最常用的方案。双脉冲台的难点不在发脉冲,而在采样:漏源电压要从几百伏的应力电平瞬间跌落到毫伏至伏级的导通压降,示波器单一量程难以兼顾"扛住高压"和"分辨毫伏"。

Namisooft的博客 257

《机器学习sklearn实战教程》02|Python机器学习开发环境搭建

2.1 为什么要先搭环境很多人学机器学习,卡住的第一步不是算法,而是环境。代码明明照着教程敲了,却一运行就报错。不是缺包,就是版本冲突。最常见的情况是,昨天还能跑,今天装了个新库

2601_96798011的博客 148

CAGR 21.8%:GaN功率器件封装材料市场从3.23亿美元迈向12.77亿美元

随着氮化镓(GaN)功率半导体在消费快充、AI服务器电源及车载电源领域的加速渗透,GaN功率器件封装材料作为实现芯片贴装、电气互连、热量传导和长期可靠性保障的核心功能性材料,正迎来爆发式增长期。根据LP Information(路亿市场策略)初步调研,2025年全球GaN功率器件封装材料市场规模约为3.23亿美元,2026年预计约3.91亿美元,2032年将达到12.77亿美元,2026—2032年复合增长率(CAGR)高达21.8%。

LPIHelen的博客 193

《机器学习》笔记

知道特征工程是什么:利用专业背景知识和技巧处理数据,让机器学习算法效果最好。这个过程就是特征工程。数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已。理解特征提取的作用:原始数据中提取与任务相关的特征,构成特征向量。新数据 = 特征提取(原数据)理解特征预处理的作用:特征对模型产生影响,因量纲(单位)问题,有些特征对模型影响大,有些影响小。有两种思路,归一化和标准化(重点),归一化公式为:(当前值-最小值)/(最大值-最小值),使映射的值域在(0~1)之间。

weixin_51781852的博客 232

GaN HEMT 的“第三层“:电流崩塌与动态导通电阻,是怎么被造出来的

所以 Fe 浓度、缓冲层厚度、以及沟道层与缓冲层之间的间距,需要在"缺陷抑制"和"动态性能"之间精细折中。轻载效率看起来还不错(电流小、功耗小),一旦上到中大电流,导通损耗 P = I²·R 就会突然抬头,效率曲线出现"塌陷",客户会得出"GaN 也就那样,不如用 Si 超结"的错误结论。当器件工作在高频开关状态,漏极到源极的电压切换得非常快,边缘电场、漏极边缘电场会向缓冲层"注入"电子,这些电子被陷阱俘获,形成带负电的空间电荷区,把缓冲层"撑开",同时把耗尽层从势垒层向下挤压到 2DEG 里面去。

weixin_64228887的博客 166

机器学习04,端到端03工程整合

个人笔记

qq_59247073的博客 152

【AI】机器学习评估与模型选择——混淆矩阵、交叉验证与偏差-方差

规则设计者面对的是一个经典的评估问题——你有一个干预手段(限制芯片出口),你想知道它是否“有效”,但你只能观察到有限时间窗口内的有限指标,而且这些指标受到无数混杂因素的影响。这个权衡在大模型中对应的就是“模型容量选择”和“正则化强度选择”——DeepSeek 的共享专家、OpenAI 的模型分层、Anthropic 的原则粒度,本质上都是在各自的架构约束下寻找这个 U 形曲线的底部。这个一致性的度量,就是排序质量(AUC 的视角)与特定阈值下的准确率(混淆矩阵的视角)之间的区别。

CAINIAOdaDIDI的博客 331

EEG机器学习解码:分的是模式,不只是波幅

本文系统阐述任务态EEG解码的流程与实践要点,强调多变量模式分析(MVPA)需警惕伪迹、条件混杂、试次不平衡、交叉验证泄漏及多重比较等问题。指出分类准确率仅表明信息可区分,不等于神经机制解释;建议结合ERP、个体差异与组水平统计,合理选择Searchlight、时间泛化、RSA等方法,确保结果可靠。核心在于控制混杂因素、保障训练测试独立性,并依据科学问题选择适配分析策略。

u011661076的博客 305
上一篇: AI4S :利用人工智能预测不同复合材料的疲劳寿命
下一篇: 工信部定调:研发的“指挥权”交给AI4S!“先建系统,后上AI”的时代结束了
Lab_AI4S
博客等级 码龄1年 8粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值