机器学习辅助提升材料基因组方法设计含硅芳基乙炔树脂

损失函数与优化器:从「梯度是怎么被造出来的」到「梯度是怎么被用掉的」 本文揭示损失函数与优化器本质一体:优化器仅依赖损失产生的梯度,而损失决定梯度的方向、尺度与噪声特性。错误的损失选择(如分类用MSE)会导致梯度失衡,使优化器失效;不同损失(如Huber、Focal)通过调控梯度分布影响优化过程。实测表明,归约方式、标签结构与损失配对直接决定梯度行为,进而影响收敛性与泛化。核心观点:选对损失,才是让优化器“看得懂”的前提。 阅读详情

摘要:含硅乙炔树脂作为一种有机-无机杂化耐高温树脂,具有广阔的应用前景。然而,其加工性能仍需进一步改善,以满足低粘度的加工要求。本文提出了一种材料基因组方法来设计和筛选具有优良加工性能和耐热性的含硅乙炔树脂。为了高通量筛选有前途的树脂,建立了机器学习模型来预测其加工性能和耐热性。筛选了10种潜在树脂,以验证材料基因组方法。结果表明,筛选后的树脂加工性能明显改善,保持了良好的耐热性。这项工作为含硅乙炔树脂的经济高效的数据驱动设计提供了一种新方法。

Ref:Chemical Engineering Journal 448 (2022) 137643

链接:https://doi.org/10.1016/j.cej.2022.137643

1、研究背景

近年来,航空航天、电子信息等领域的发展提高了对耐热聚合物的需求,耐热聚合物及其复合材料的研究备受关注。由于含硅乙炔树脂(PSA)具有良好的热稳定性,研究人员对其越来越感兴趣。

PSA树脂是一种由含硅基团和乙炔基基团组成的无机-有机杂化聚合物。固化后,PSA树脂形成高交联网络,并表现出优良的性能,如耐热性和介电性能,显示出作为先进聚合物复合材料基质的高潜力。

由于热稳定性和可加工性的相互制约,PSA树脂的研究进展受到限制。一般来说,树脂热稳定性的提高伴随着加工性能的下降。通常,耐热性优异的树脂具有较高的粘度,但不适合加工和生产高性能复合材料,特别是树脂成型加工方面。

因此,PSA树脂的改进集中于在不失去热稳定性的情况下易于加工和制造。这种性能的改善需要在热稳定性和加工性能之间进行权衡。含硅乙炔树脂的设计,由于研发周期长,通常采用试错法,效率较低。

材料基因组法(MGA)是解决这一问题的有效途径。材料研究经历了实验观察、理论模型和计算科学三种范式。利用数据来驱动材料的研发是MGA提出的第四个范式。MGA旨在通过创建材料创新基础设施来加速新材料的发现、设计和部署。MGA首先定义材料的“基因”,然后对“基因”进行组合,最后通过性能预测筛选出首选材料。

在本工作中,首次建立了用于评价PSA加工性能和耐热性的机器学习(ML)模型。然后,利用这些ML模型提出了一种MGA来进行树脂的高通量筛选,并在不牺牲耐热性的前提下过滤出一系列具有最佳加工性能的PSA树脂。

2、研究方法 

2.1 建立机器学习模型

为了能够预测聚合物耐热性能和加工性能,从Polymer Genome database数据库中收集94组耐热性数据,从PubChem database中收集了882组粘度数据,建立了multi-layer perceptron (MLP)神经网络模型,最后利用机器学习模型建立分子结构与性质之间的对应关系。

2.2 材料基因组方法

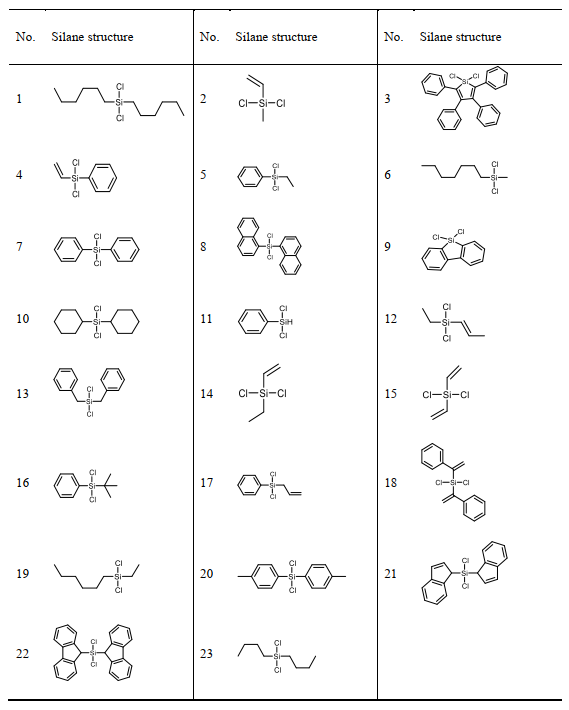
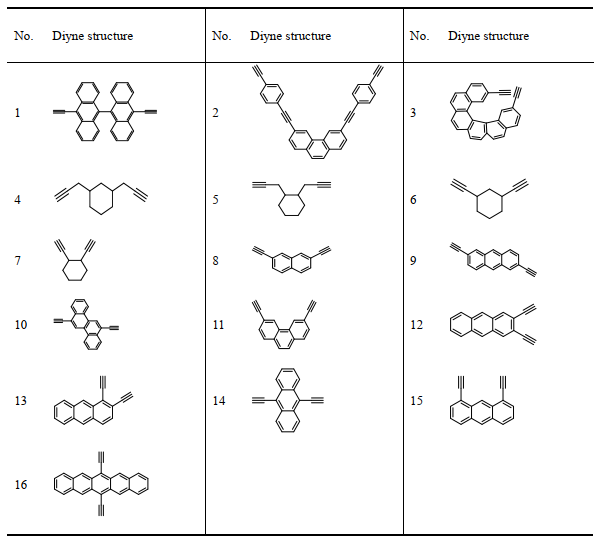
首先定义聚合物的基因,乙炔基结构和硅基结构分别为聚合物的基因,如表1和表2所示。通过基因之间的组合形成虚拟聚合物,共368种树脂。

表1 16种乙炔基结构
170686953310387466HG.png

表2 23种硅基结构

图片2.png

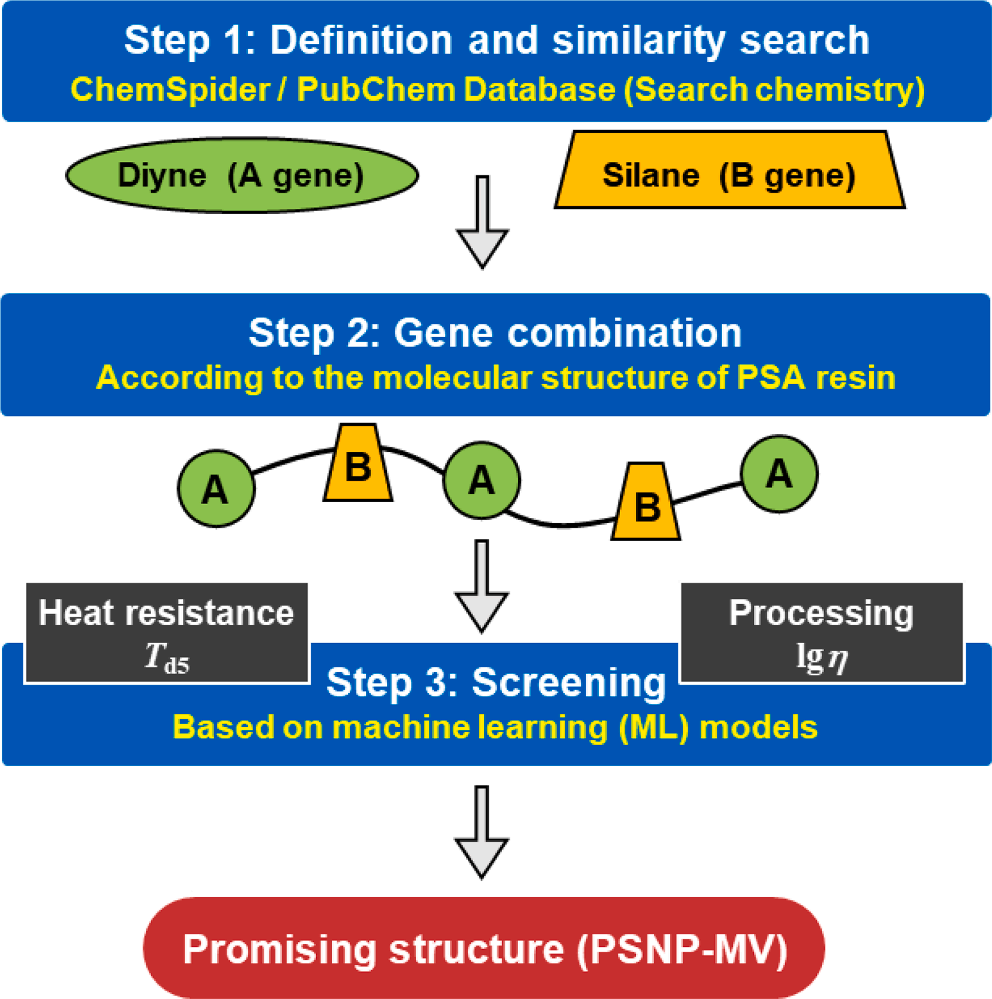
2.3 材料基因组方法与机器学习设计筛选聚合物流程图

通过基因组合方法获得聚合物树脂虚拟材料,利用机器学习模型对虚拟材料进行耐热性能和粘度的预测;最后筛选出综合性能优良的聚合物。
1706869599368089ThDR.png

图1 材料基因组方法设计耐热性和优异加工性聚合物树脂

3、结果与讨论 

3.1 机器学习模型

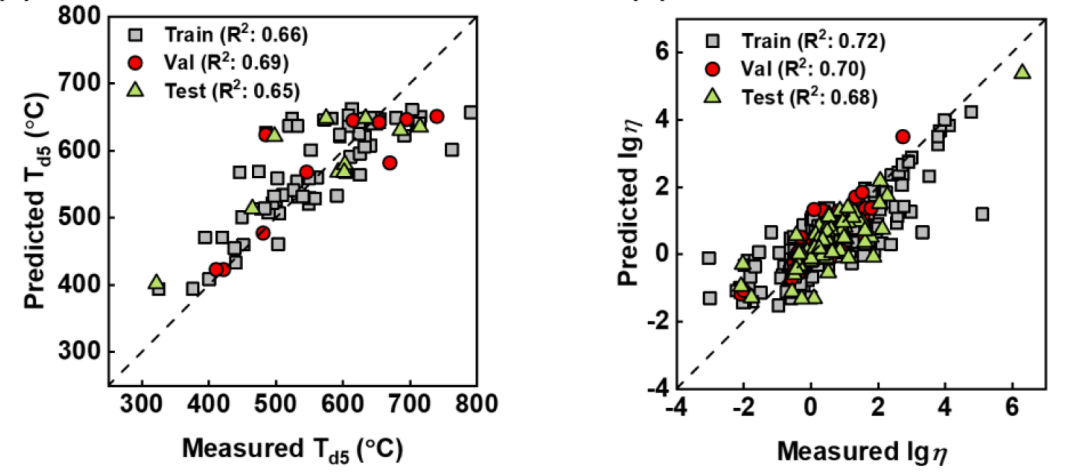
本工作中使用氮气氛中的Td5来表示耐热性,并选择室温下的lgη来表示加工性能。ML被用来构建化学结构和这些性质之间的关系。通过耐热性能预测模型和粘度预测模型的训练集、验证集和测试集的R2可以评判这两个性能预测模型是可靠的,如图2所示。
1706869658233627KfEs.png

图2 机器学习模型对耐热性能与粘度预测的表现

3.2 材料基因组方法筛选易加工耐热的树脂材料

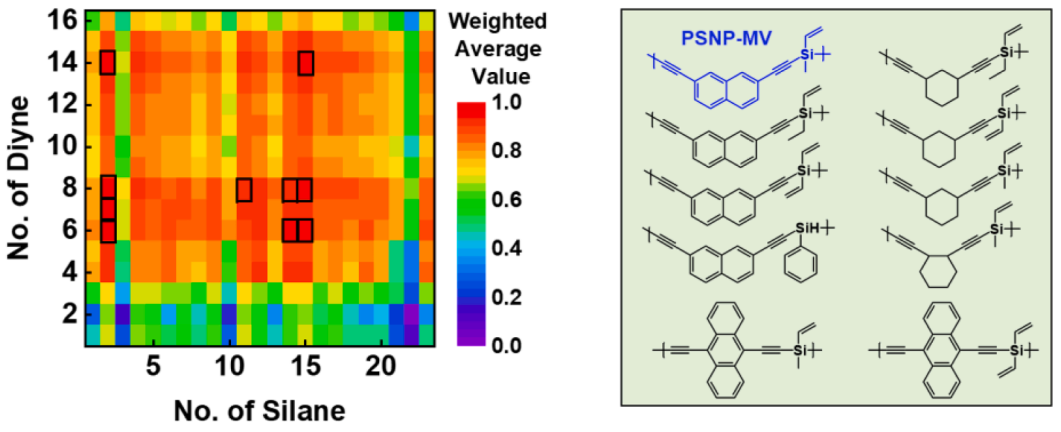
进一步可以通过两个ML模型来评估候选树脂的性能。通过ML模型分别预测了368种候选树脂的加工性能和耐热性的lgη和Td5。然后,作者设置了筛选树脂的标准:1)耐热性和加工性能的预测值映射到0到1的范围内,其中1表示树脂的加工性能或耐热性最好,0表示树脂最差。2) 每个属性都有其重要性的权重系数,并根据权重系数计算加权平均值。考虑到这两种性质的同等重要性,将加工性质(或耐热性)的权重系数设置为0.5。图3左图显示了368种候选树脂的加权平均值,其中黑色矩形表示加权平均值排前十的最佳树脂。这十种树脂的分子结构如图3右图。作者选择了PSNP-MV(蓝色)的分子进行验证,因为其易合成性。
17068696849752681c3N.png

图3 耐热与粘度综合性能热力图和前十种综合性能优异的分子结构

3.3 实验验证

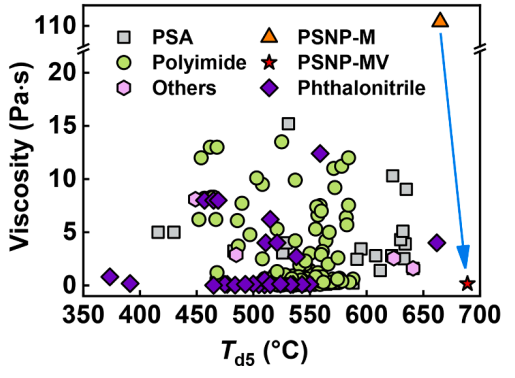
通过实验方法对筛选出来的PSNP-MV进行合成与性能的测试,得到该聚合物具有非常好的耐热性能和较低的粘度,如图4,从而证明该聚合物同时满足耐热性和加工性能的需求。
图片6.png

图4 不同聚合物树脂耐热性和粘度性能

4、总结

建立了两个可靠的机器学习模型来评价通过材料基因组获得的虚拟聚合物树脂的加工性能和耐热性,并通过高通量筛选具有耐高温和优良加工性能的含硅芳基乙炔树脂。

对机器学习筛选出来的树脂进行合成与性能分析,实验和理论模拟结果表明,PSPN-MV树脂具有较低的粘度和良好的耐高温性能,验证了材料基因组筛选的结果。

从这项研究中获得的结论可能有助于加快新的耐热树脂的开发,并减少时间成本,比传统试错的方式具有更大的优势。

MaXFlow在高分子材料研究领域的应用

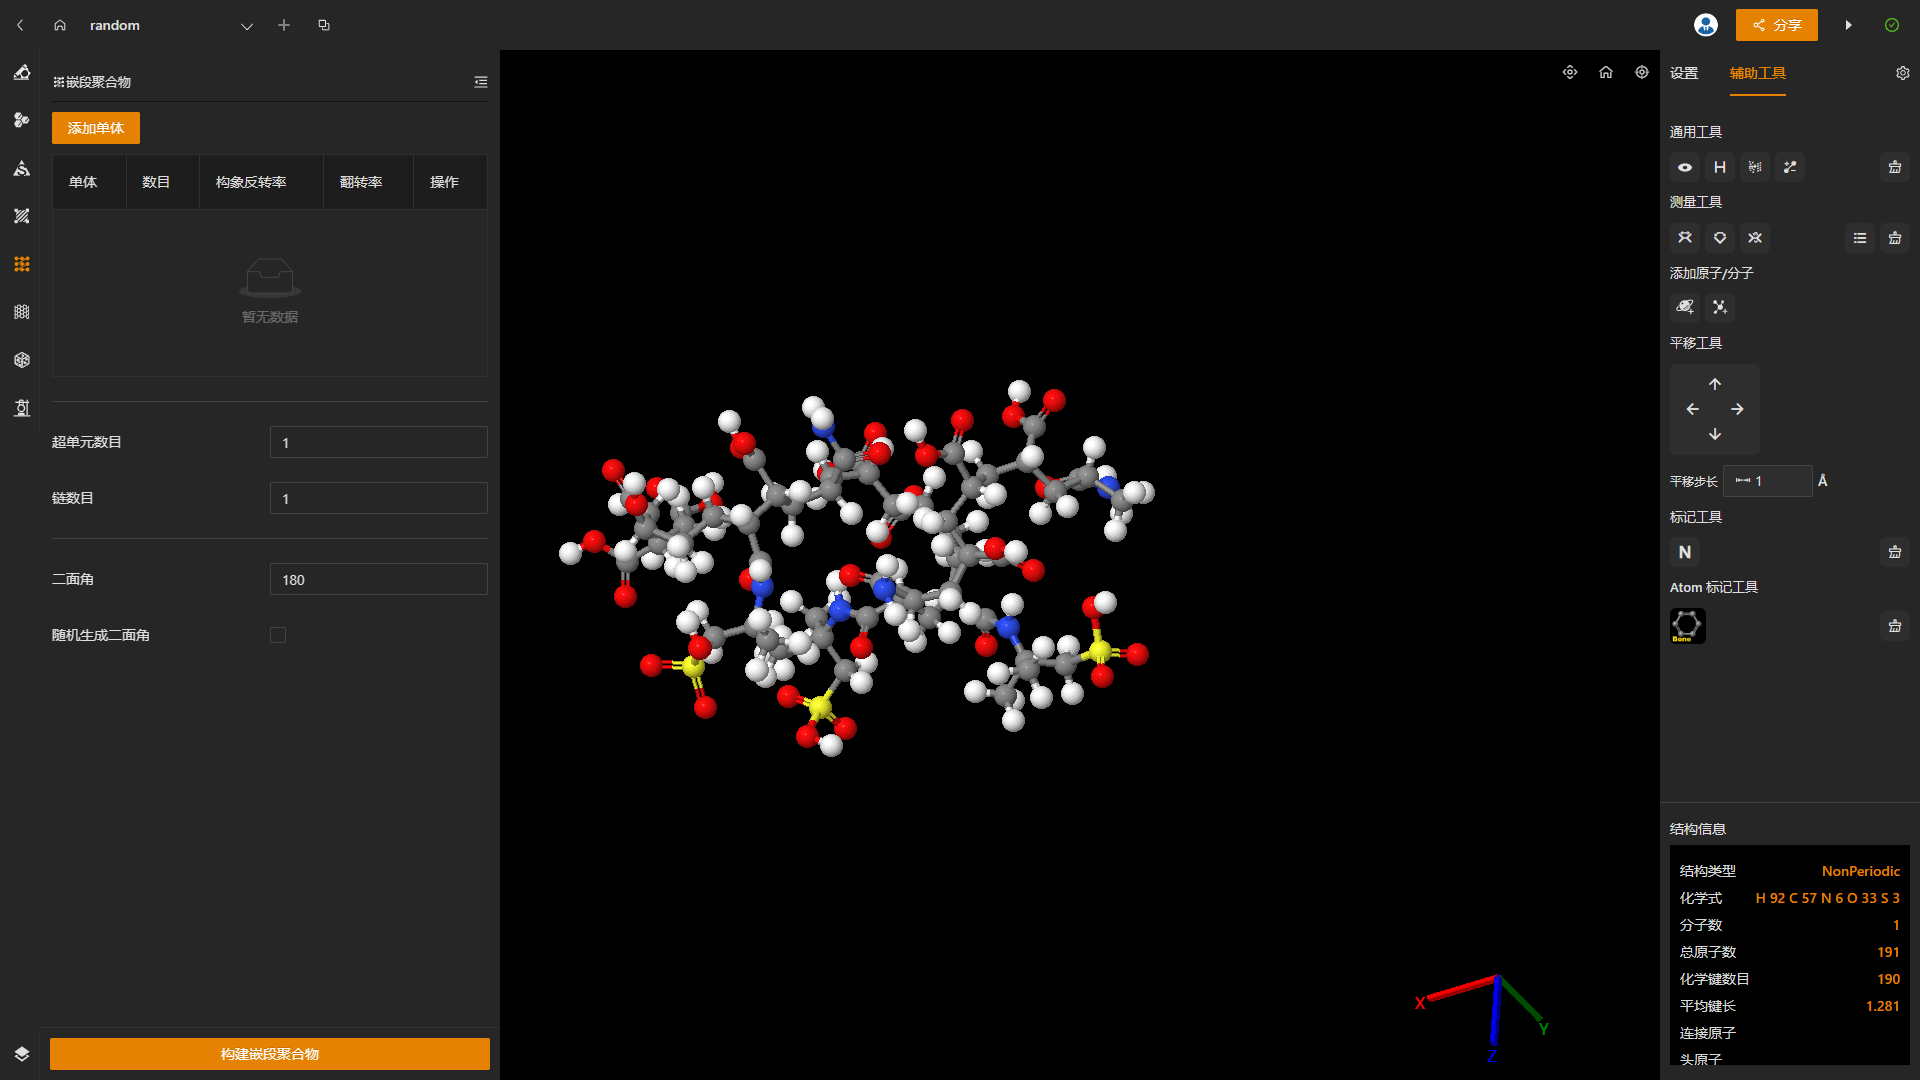
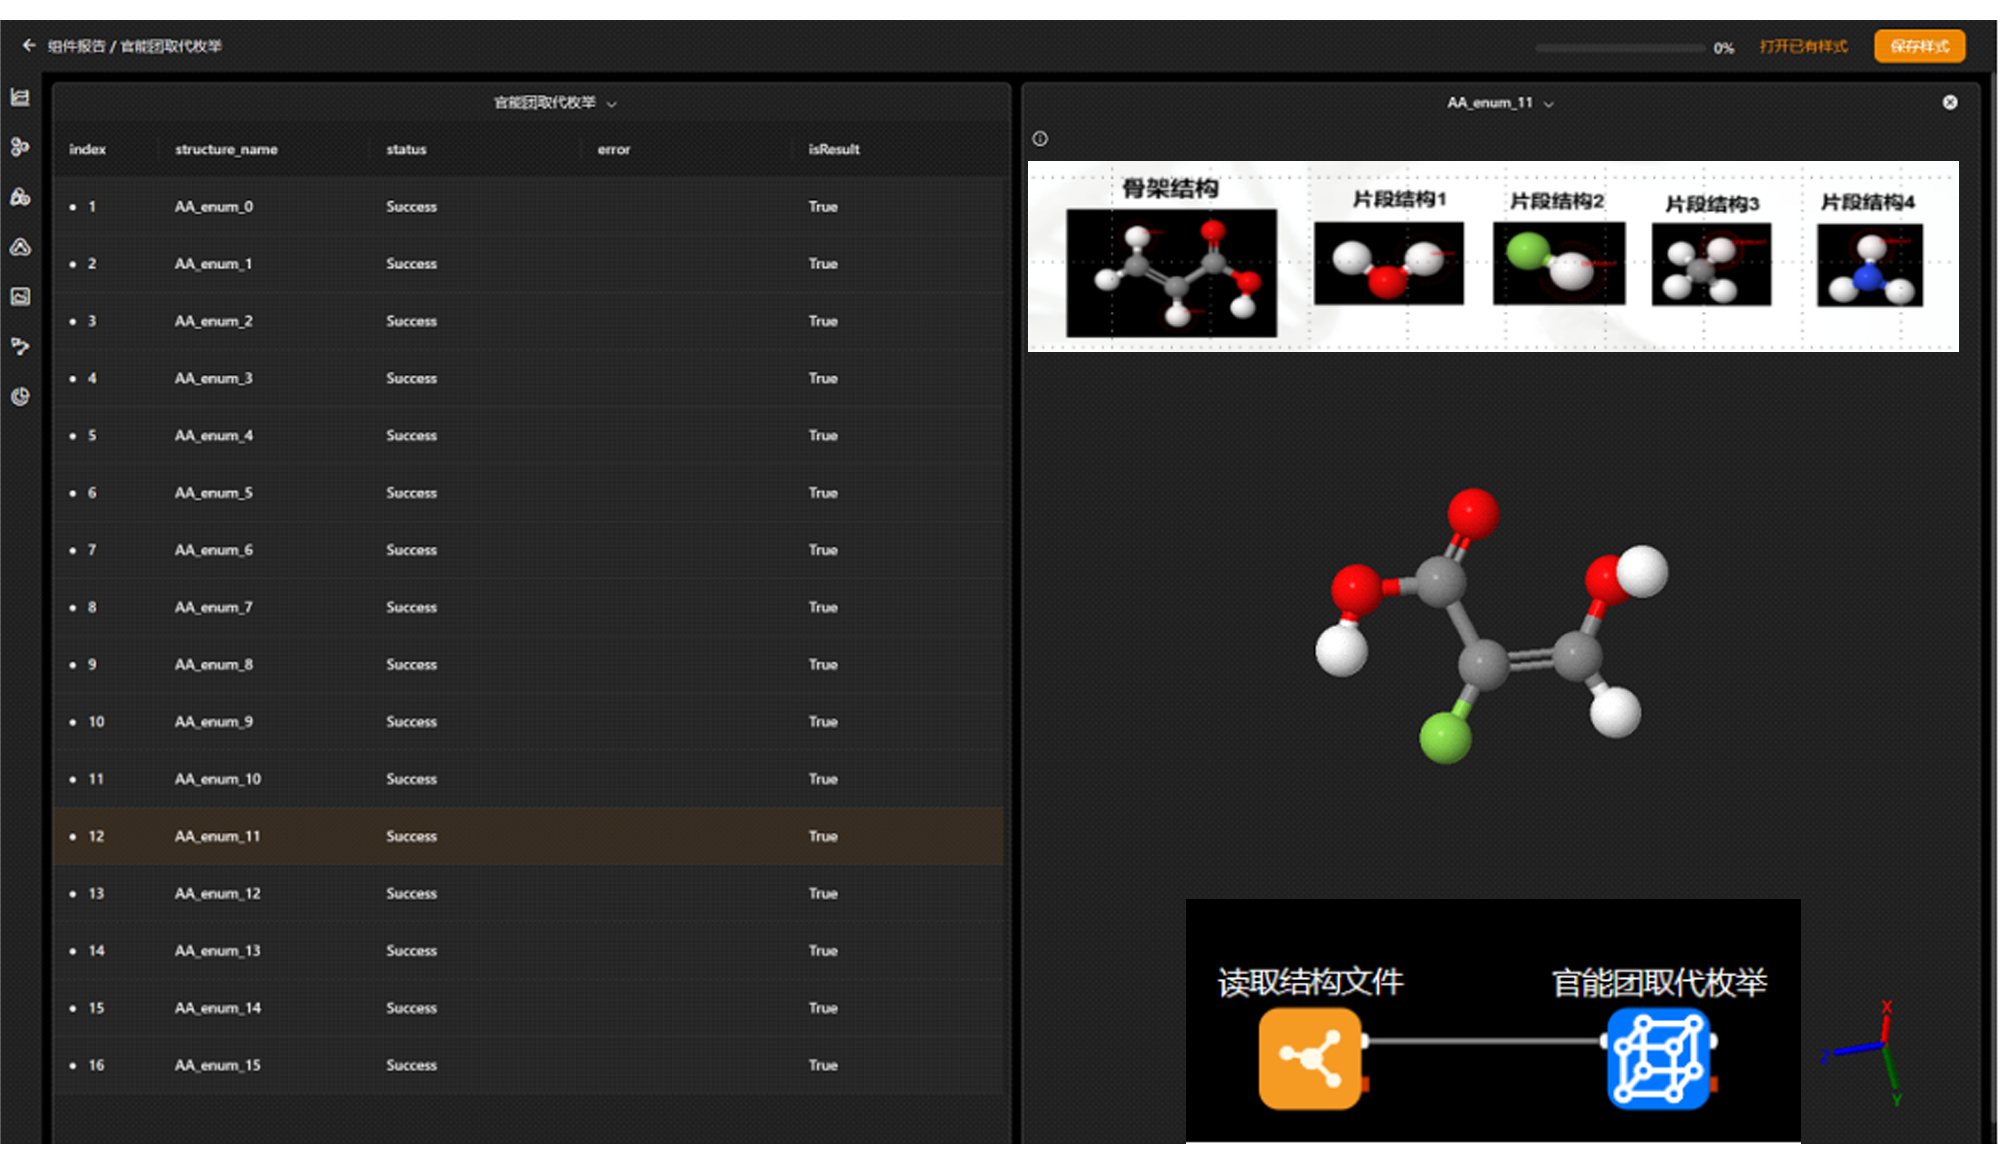
1、聚合物单体设计及聚合物分子链构建
1706869770264578mUHa.png

分子枚举高通构建聚合物单体结构库

1706869804463060sbmJ.png

在线可视化界面构建聚合物分子链

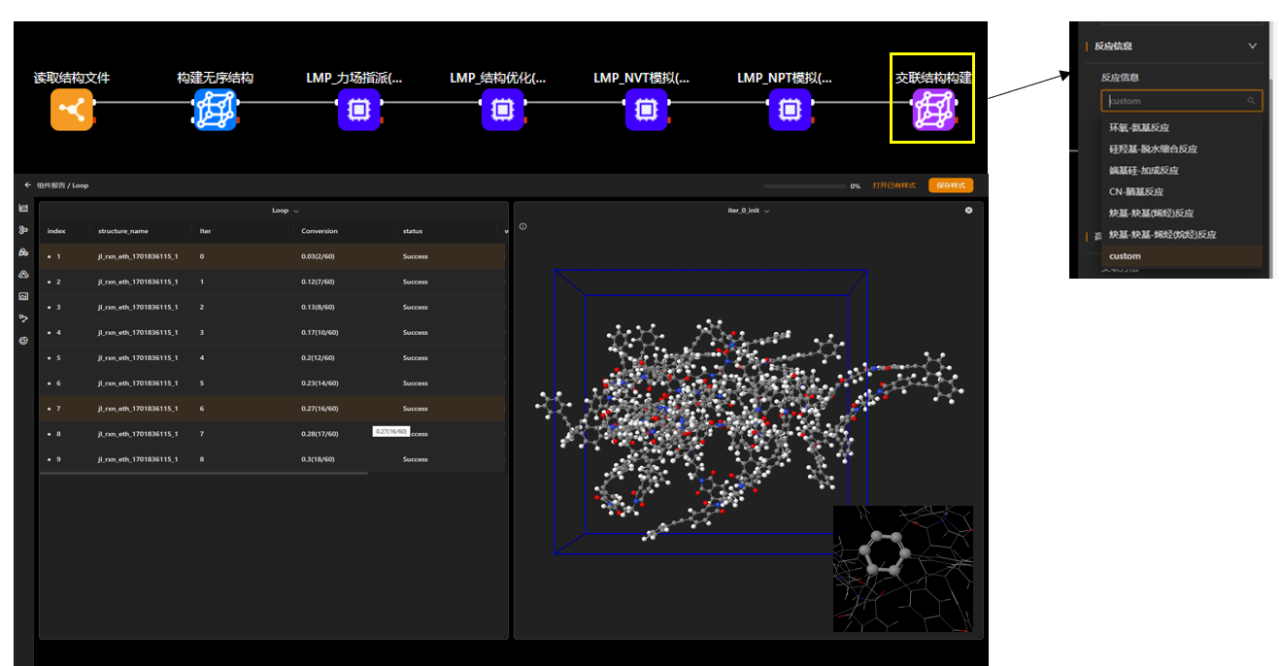
2、交联结构搭建

1706870094838195js0K.png

支持选择已有机理及自定义反应机理进行交联结构的搭建

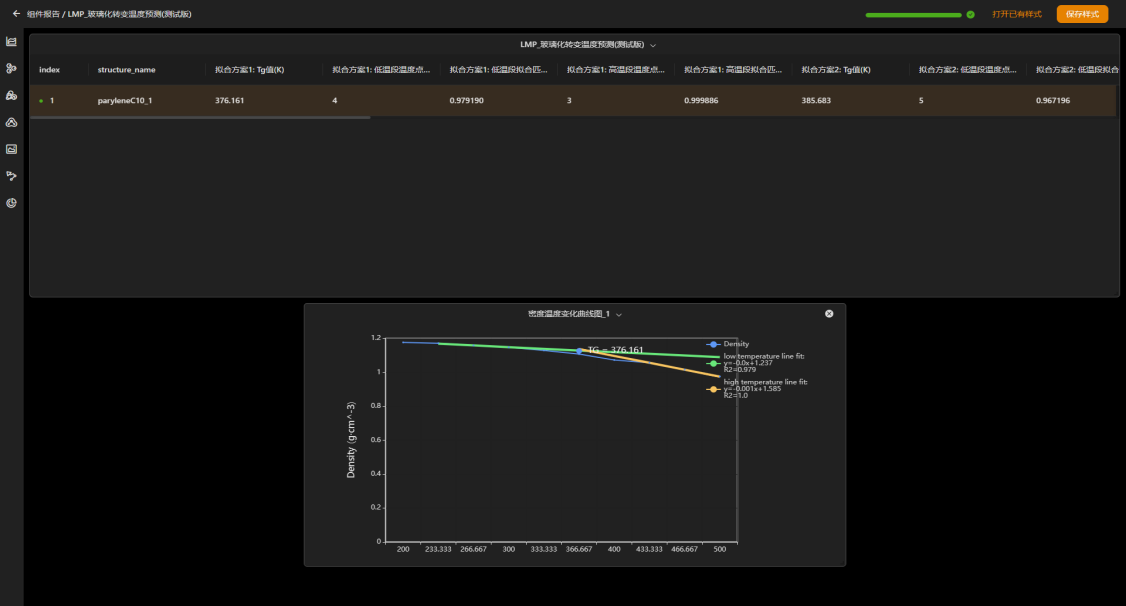
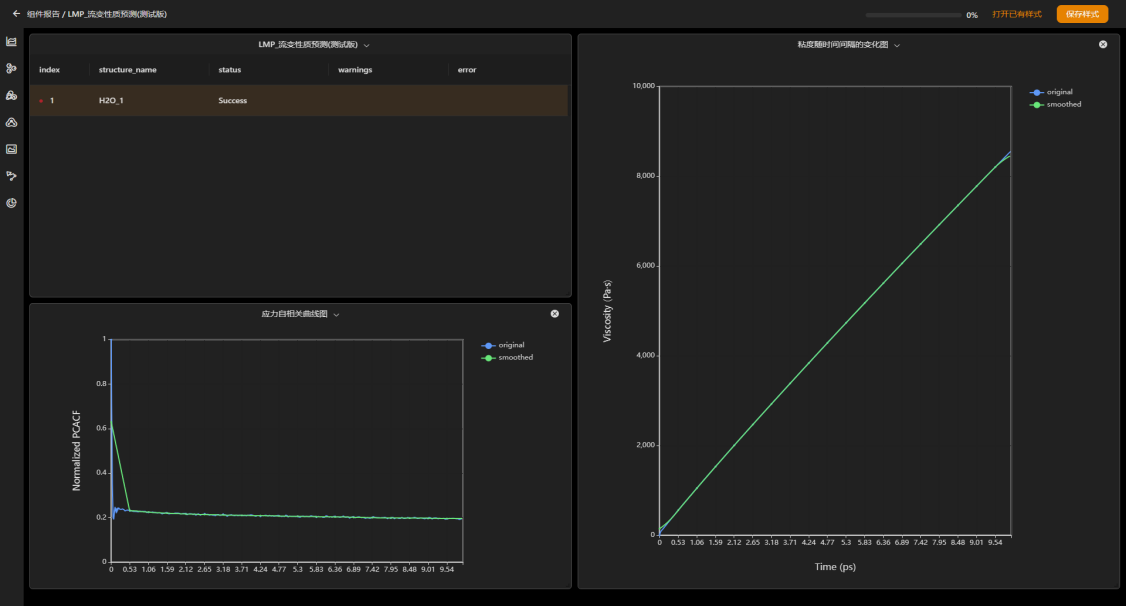
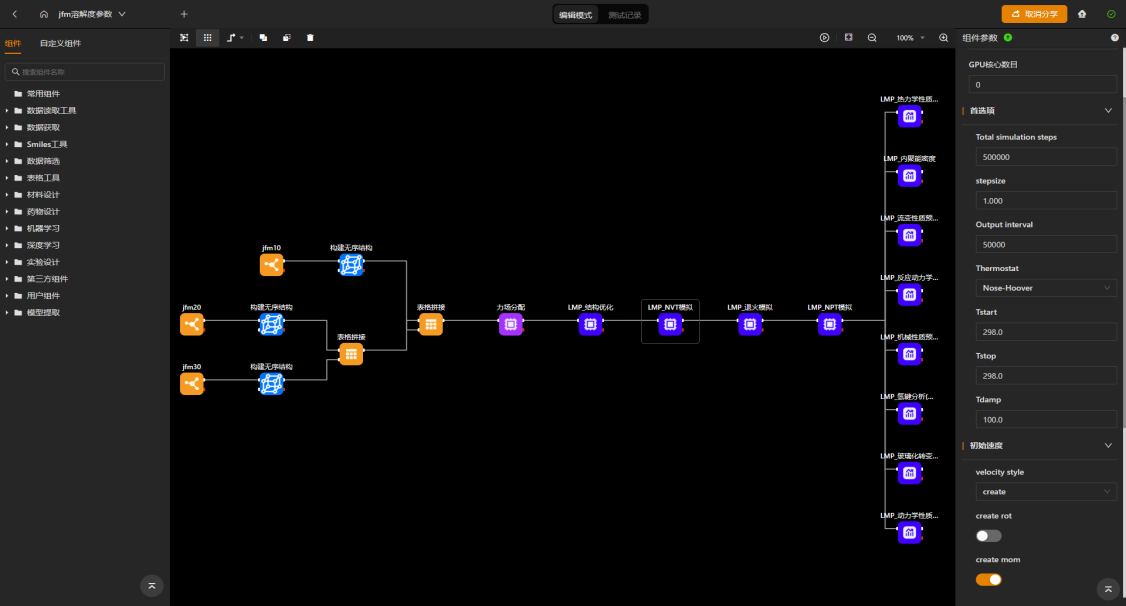
3、 玻璃化转变温度、粘度等性质的计算
1706869870311490RPit.png

分子力学、动力学计算工作流展示

1706869910333687UWh6.png

玻璃化转变温度计算结果展示

17068699435202003492.png

粘度计算结果展示

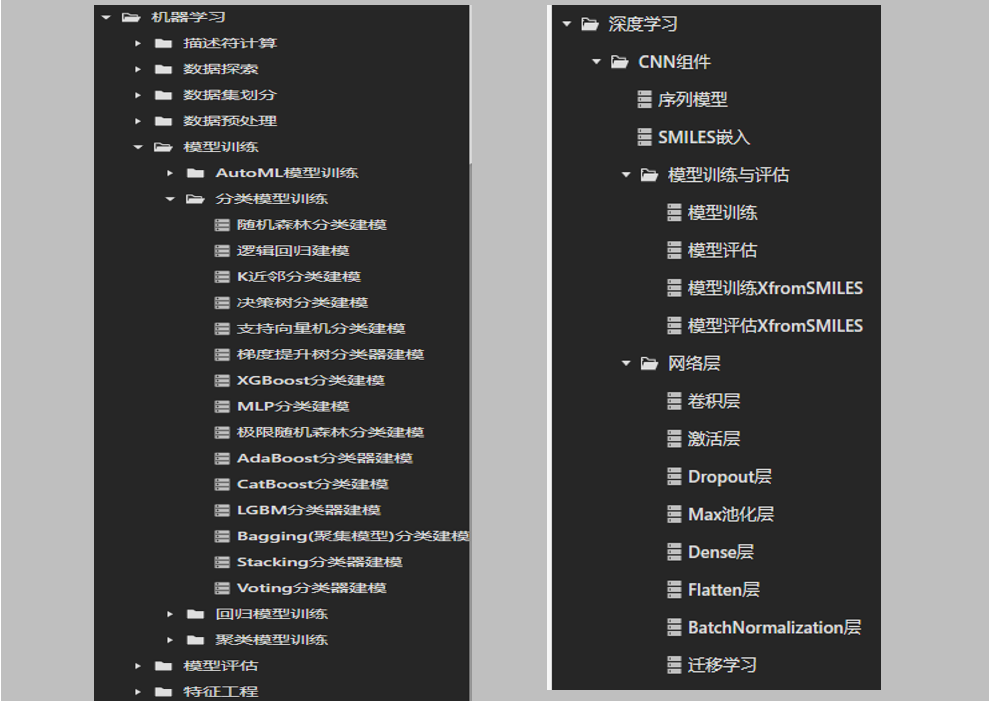
4、AI模型的自动化建立

1706870210252366sjAS.png

机器学习和深度学习

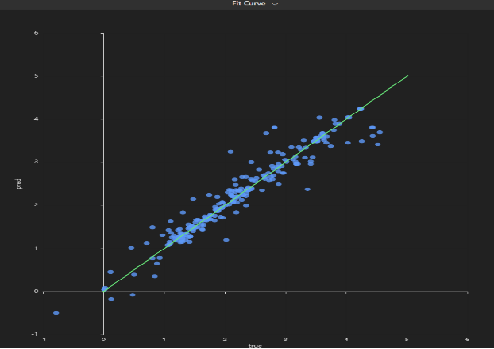
根据实验数据进行AI建模

模型评估和优化

重要特征权重展示

【信息科学与工程学】【物理/化学科学和工程技术】知识体系04 热学 系列二01 尺度与速率:都涉及微纳尺度的热传递,并追求对热过程的快速、精确控制(RTP:秒级;芯片:毫秒级;NIL:秒级)。温度均匀性:是所有领域的核心目标。芯片要求空间温度均匀以保证性能与可靠性;RTP要求片内温度均匀以保证工艺一致性;热NIL要求大面积温度均匀以保证图案保真度。测量与控制的闭环:都严重依赖高精度、实时的温度测量(红外、热偶、噪声)和先进控制算法(PID、MPC、前馈)。材料的热响应:都涉及材料(硅、聚合物、界面材料)热物性(k, c_p, α, η)的精确表征及其对温度/过程的依赖性。多物理场耦合。 阅读详情

相关推荐

最终篇——SWAT模型的建立

同理,Soil Data也是同样的方法导入,在Soil Database Options的选项中,选择UserSiol,用同样的方法导入土壤类型,进行重分类。打开窗口后,只定义HRU Thresholdes,其余两个不用设置,设定各数据单元的计算率,这里的10%的意思是计算精度,即分成级HRU计算单元太小,小于平均计算单元的10%,我们就不对这HRU单元进行计算(也就是说太破碎的计算单元不进行计算),若选择0%意味着全部进行计算,需要耗费大量的内存和时间,对计算机要求较高,不建议。

m0_72556434的博客 5623

从认识人工智能到理解机器学习:我的 AI 入门第一课

正式开始学习人工智能之前,我对 AI 的认识其实比较模糊:知道 ChatGPT、知道大模型,也知道现在很多岗位都在谈 AI,但如果有人问我“人工智能到底是什么”“机器是怎么学会识别一只猫的”,我未必能从头到尾讲清楚。上午的课程更偏向行业全景:人工智能的发展、研究方向、NLP、岗位分工、学习路线和 AI Coding 工具。下午的课程更偏向技术基础:机器学习的原理、有监督学习、深度学习、模型训练和评估方法。

chh563的博客 484

深入STM32 USB OTG FS:从官方MSC例程到实战双存储设备移植全记录

本文详细解析了STM32 USB OTG FS在双存储设备开发中的实战应用,从协议栈底层机制到SD卡/SPI Flash同步挂载的实现。通过优化SDIO接口和SPI Flash驱动,结合USB MSC类的关键实现,提供了完整的解决方案和性能优化策略,适合嵌入式开发者参考。

weixin_28366475的博客 371

低温ECR-MOCVD生长(002)GaN:椭偏仪测厚与电学性能

本研究用ECR-MOCVD在Si(111)和蓝宝石衬底上低温生长GaN薄膜,蓝宝石1.0SCCM、2h样品呈完全(002)择优取向,椭偏仪测厚32.81nm,迁移率10.42cm²/(V·s)。文章梳理了生长温度、TMGa流量与生长时间对结晶取向、膜厚、粗糙度、光学带隙和电学性能的影响。

Flexfilm_的博客 382

【WILEY】从Revision到Online:一次投稿的完整状态演进与关键节点实战解析

本文详细解析了从Revision到Online发表的完整投稿流程,包括修改稿准备、回复信撰写、状态跟踪等关键节点。特别针对Wiley期刊,提供了实用的操作技巧和常见问题解决方案,帮助作者高效完成论文修改与发表。

weixin_29219189的博客 362

基于Java的高校学生信息管理系统的设计与实现(论文+源码)

可以对本系统的数据进行良好的封装,Java可以对不想被访问的数据进行良好的隐藏,具备平台无关性,可移植,更加可靠与安全,具备多线程支持,进行网络交互更容易。它支持本系统的B/S模式。开发效益方面,本系统一旦开发成功并且面向社会,就会让大多数的学生教师体会到便利办公的乐趣,随之促进提高本系统的使用率和经济利润,所以在经济方面,对于零成本开发且高利润的学生管理系统是可行的。学生可以在学生端进行选课,查看自己的成绩,教师可以在教师端查看所任课程的选课情况,对学生成绩进行录入,对所任的课程进行结课等操作。

2402_82389843的博客 1094

机器学习基础|监督学习、标签、回归

网约车预估等待时长依赖监督学习中的回归任务。平台利用历史订单数据,以司机实际到达耗时为标签,通过上车点、时间、运力、路况等特征训练模型。模型不断优化预测值与真实耗时的误差,最终对新订单输出连续的预估等待时间,实现精准预测。

weixin_43971465的博客 262

小米CyberGear微电机驱动代码(CAN总线驱动,含开源地址)

小米CyberGear微电机驱动代码(ROS下的CAN总线驱动,含开源地址)

2302_80751833的博客 4444

Hugging Face:成为机器学习界的“Github”

以下文章来源于OneFlow,作者OneFlow社区五年前,AI领域的知名研究者Andrej Karpathy发文称,传统人工编程属于“软件1.0”,“软件2

2601_96798011的博客 142

将指定文件夹下每张用LabelImg标注的图片中标注部分抠出来保存到指定文件夹下。

将指定文件夹下每张用LabelImg标注的图片中标注部分抠出来保存到指定文件夹下。

weixin_44119674的博客 440

把数据库事务边界握在手里:ABAP 里的 COMMIT CONNECTION 与 ROLLBACK CONNECTION 深度拆解

与表面是两条很短的语句,背后却牵动了连接管理、数据库 LUW、SAP LUW、隐式提交、游标生命周期、GTT 平台差异等一整片工程现实。把它们用对,你就能在不破坏主业务事务的前提下,实现跨库写入、审计落库、隔离型日志、数据集成落地等一系列“看似矛盾”的目标;用错了,它们也会悄无声息地制造一致性缺口,让问题在高峰期以 dump 或数据异常的方式爆出来。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1842

机器学习——混淆矩阵(待更新)

二元: true表示真实==预测,positive表示预测值=1.

m0_61175448的博客 168

移动支付APP(仿支付宝)

Toast.makeText(PayActivity.this, "支付失败:" + payResponse.getMsg(), Toast.LENGTH_SHORT).show();Toast.makeText(PayActivity.this, "支付失败:" + t.getMessage(), Toast.LENGTH_SHORT).show();Toast.makeText(PayActivity.this, "支付失败", Toast.LENGTH_SHORT).show();

寒寒豆豆软件公司的博客 136

机器学习必修课:经典算法与Python实战

《机器学习必修课:经典算法与Python实战》是一门系统性与实战性兼顾的课程,旨在帮助学习者从零基础掌握机器学习核心算法与Python编程应用。

2601_96797912的博客 161

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

AI 是怎样从数据中学习的?训练、验证、测试与推理

泛化能力(Generalization)指模型面对训练过程中没有见过的新数据时,仍然能够做出合理预测的能力。这是判断模型是否具有实际应用价值的重要标准。例如:一个用户流失预测模型,在历史数据上表现很好,但面对新上线的用户群体时,预测准确率明显下降。这可能说明模型学到的规律无法适应新的用户群体。泛化能力不仅取决于模型本身,也与训练数据是否具有代表性有关。训练数据只包含老用户,没有新用户。训练数据主要来自某个地区,实际业务却覆盖不同地区。过去的用户行为与当前用户行为已经发生变化。

dshizixu的博客 325

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Spark06_MLlib机器学习

本文是《PySpark 从入门到实战》系列收官篇,带你用 Spark MLlib 走通机器学习全流程:从三要素与 7 步标准流程讲起,剖析 KNN、朴素贝叶斯、决策树三大算法原理,再以 KNN 手写、垃圾短信分类、决策树分类、逻辑回归鸢尾花(准确率 96.67%)、K-Means 聚类(轮廓系数 0.7345)五个案例落地,最后详解 TF-IDF 文本特征与余弦相似度。全文代码可直接运行,适合有 RDD 与 Spark SQL 基础的开发者快速上手。

2301_80420058的博客 469

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

AI小白入门|无监督学习到底是什么?

很多新手看完无监督学习的定义只会死记硬背。本文避开复杂公式,从真实业务场景切入,对比监督学习,讲清楚无监督学习的核心价值、适用场景、底层逻辑和容易踩坑的认知误区,帮你理解它在机器学习链路里的定位。

weixin_43971465的博客 194

机器学习01,KNN使用与简单数学原理

个人笔记

qq_59247073的博客 273

SVM支持向量机通俗解析:找到机器学习的“最优分界线”

一、爆款钩子:同样是画分界线,为何SVM能成为机器学习的“王者选手”?做机器学习的人,几乎都绕不开一个问题:如何给混乱的数据“分家”?有人用逻辑回归,有人用KNN,但有一个算法

2601_96798737的博客 146

机器学习03,端到端02

个人笔记

qq_59247073的博客 272

GaN 动态导通电阻测试专题:电流崩塌从哪来,测量窗口怎么选

但器件装到实际电路上跑一段时间,或者用双脉冲台架模拟开关工况再测导通压降,数值往往明显高于手册静态值,而且关断应力越强(母线电压越高、应力保持越久),抬升越明显;:使用钳位电压探头,把示波器通道的工作区间限制在低电压区(常见做法是钳位在 1.5V 附近的导通压降区),应力高压段由钳位电路吸收,导通段以高分辨率采样。台架搭建相对简单,是器件表征最常用的方案。双脉冲台的难点不在发脉冲,而在采样:漏源电压要从几百伏的应力电平瞬间跌落到毫伏至伏级的导通压降,示波器单一量程难以兼顾"扛住高压"和"分辨毫伏"。

Namisooft的博客 254

基于有效Token规模化的大模型预训练数据配方与工程体系研究——基于唐杰《高级机器学习》课程演讲

在此背景下,本文系统梳理GLM系列模型数据迭代轨迹,纠正数据墙认知偏差,分析天然数据与合成数据的互补机制,并完整构建支撑高质量Token挖掘的全链路数据工程体系,为大模型数据规模化建设提供理论与工程参考。早期小模型训练场景下,数据总量远大于算力可消化量,核心策略为择优筛选少量高质量数据。基于唐杰公开演讲核心观点、GLM数据迭代、数据墙、合成数据、清洗解析工具链、分层架构图、自研工程壁垒),完整重构成一篇结构严谨、逻辑连贯、标准期刊论文风格全文,预留精准图片插入位置,可直接定稿、查重、发表、结课提交。

interpromotion的博客 284

茶叶病虫害目标检测数据集

目标检测 yolo 目标检测数据集 茶叶病虫害目标检测数据集

DL_data_set的博客 399

CAGR 21.8%:GaN功率器件封装材料市场从3.23亿美元迈向12.77亿美元

随着氮化镓(GaN)功率半导体在消费快充、AI服务器电源及车载电源领域的加速渗透,GaN功率器件封装材料作为实现芯片贴装、电气互连、热量传导和长期可靠性保障的核心功能性材料,正迎来爆发式增长期。根据LP Information(路亿市场策略)初步调研,2025年全球GaN功率器件封装材料市场规模约为3.23亿美元,2026年预计约3.91亿美元,2032年将达到12.77亿美元,2026—2032年复合增长率(CAGR)高达21.8%。

LPIHelen的博客 192

《机器学习》笔记

知道特征工程是什么:利用专业背景知识和技巧处理数据,让机器学习算法效果最好。这个过程就是特征工程。数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已。理解特征提取的作用:原始数据中提取与任务相关的特征,构成特征向量。新数据 = 特征提取(原数据)理解特征预处理的作用:特征对模型产生影响,因量纲(单位)问题,有些特征对模型影响大,有些影响小。有两种思路,归一化和标准化(重点),归一化公式为:(当前值-最小值)/(最大值-最小值),使映射的值域在(0~1)之间。

weixin_51781852的博客 230

GaN HEMT 的“第三层“:电流崩塌与动态导通电阻,是怎么被造出来的

所以 Fe 浓度、缓冲层厚度、以及沟道层与缓冲层之间的间距,需要在"缺陷抑制"和"动态性能"之间精细折中。轻载效率看起来还不错(电流小、功耗小),一旦上到中大电流,导通损耗 P = I²·R 就会突然抬头,效率曲线出现"塌陷",客户会得出"GaN 也就那样,不如用 Si 超结"的错误结论。当器件工作在高频开关状态,漏极到源极的电压切换得非常快,边缘电场、漏极边缘电场会向缓冲层"注入"电子,这些电子被陷阱俘获,形成带负电的空间电荷区,把缓冲层"撑开",同时把耗尽层从势垒层向下挤压到 2DEG 里面去。

weixin_64228887的博客 152
上一篇: 治疗阿尔茨海默病的查尔酮-O-氨基甲酸酯衍生物的设计
下一篇: 单原子催化剂:电催化活性新突破
Lab_AI4S
博客等级 码龄1年 8粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值